
MySQL:日志体系、主从复制原理与分库分表
一、MySQL 日志系统(Log System)
(一)错误日志(Error Log)
1. 定义
错误日志是 MySQL 的核心诊断日志,记录数据库运行过程中的关键事件,如 启动、关闭、崩溃、权限异常、表损坏、主从复制错误等。遇到任何 MySQL 服务不可用的情况,第一步永远是看 Error Log。
默认存储位置
/var/log/mysqld.log
或在某些系统中:
/var/log/mysql/error.log
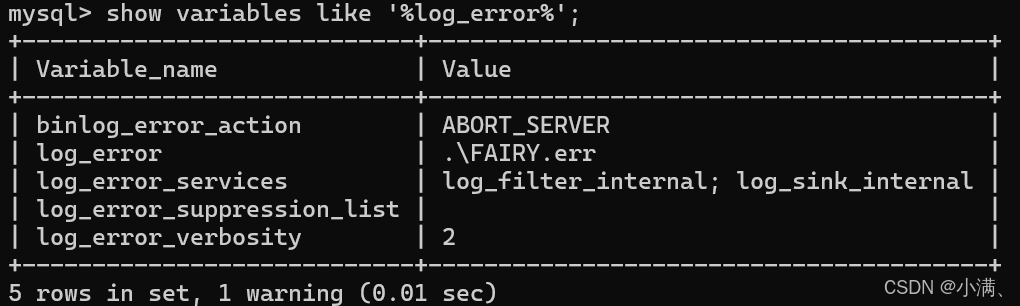
日志路径可能被自定义,因此建议使用 系统变量检查实际位置:
SHOW VARIABLES LIKE '%log_error%';
2. 错误日志中常见内容与定位作用
| 日志内容类型 | 场景说明 | 能定位的问题 |
|---|---|---|
| 启动/关闭信息 | 启动失败、异常重启、强制 kill | 配置错误、端口冲突、数据文件被占用 |
| InnoDB 运行异常 | 表崩溃、Buffer Pool 损坏、回滚段异常 | 数据损坏、未正常关闭 |
| 权限认证失败 | 用户无法登录、连接失败 | 账号密码错误、host 限制 |
| 主从复制异常 | Slave IO/SQL thread 报错 | 主从断链、延迟、binlog 损坏 |
| 插件或存储引擎报错 | MyISAM 崩溃、插件启动失败 | 表损坏、存储引擎不兼容 |
3. 经典错误示例与分析
[ERROR] InnoDB: Unable to lock ./ibdata1
| 可能原因 | 处理建议 |
|---|---|
| 系统中已有 MySQL 实例运行 | 检查 `ps -ef |
| MySQL 上次异常退出,文件锁未释放 | 执行 service mysqld stop 后手动清理 lock |
| 数据目录权限不足 | chown -R mysql:mysql /var/lib/mysql |
该报错属于 启动失败常见类型,通常伴随 mysqld 无法启动。
MySQL 无法启动排查指南
排查顺序
① 查看 Error Log → 判断是否是配置/权限/端口问题
② 检查 3306 是否被占用
③ 检查目录权限、磁盘空间
④ 检查 ib_logfile / ibdata 损坏
排查示例步骤
| 排查动作 | 命令示例 | 目的 |
|---|---|---|
| 查看错误日志(必做) | tail -100f /var/log/mysqld.log | 找到第一现场报错信息 |
| 检查端口占用 | lsof -i:3306 / `netstat -anp | grep 3306` |
| 检查 mysqld 进程 | `ps -ef | grep mysql` |
| 检查目录权限 | ls -l /var/lib/mysql | 错误常见于迁移或手动拷贝数据目录 |
| 修复表损坏 | mysqlcheck --repair --all-databases | MyISAM 表损坏恢复第一手段 |
如日志出现 InnoDB: corruption detected,需考虑 ibdata 损坏,可能需要内存恢复 / 数据迁移 / binlog 回放等方式救援。
MySQL 崩溃后你如何排查?
先查看 error log 定位启动失败原因
→ 再排查端口占用 / 权限问题 / 数据损坏
→ 如果是 InnoDB 表损坏,可先备份再修复
→ 必要时借助 binlog 做数据恢复
(二)二进制日志(BINLOG)
1. 定义与作用
Binlog 是 MySQL 最重要的日志之一,用于记录所有会对数据产生修改的操作(INSERT / UPDATE / DELETE / DDL),但 不包含只读 SQL(SELECT、SHOW)。
只要会改动数据,就一定进 binlog
其核心价值包含 三大用途:
| 作用 | 说明 |
|---|---|
| 数据恢复 | 可通过 binlog 进行 point-in-time recovery(PITR) |
| 主从复制依赖 | Slave IO 线程拉取 binlog 写入 relay log 从而同步 |
| 审计回放 | 可还原谁在什么时候改了什么数据 |
查询 Binlog 是否启用:
SHOW VARIABLES LIKE '%log_bin%';
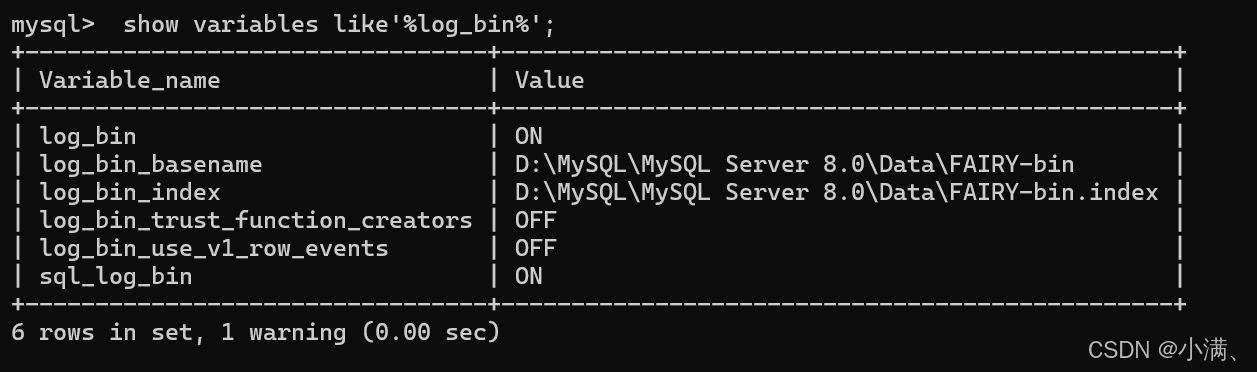
正式环境必须开启,否则 无法做主从、无法增量恢复,风险极高
(1)Binlog 三种记录格式
| 格式 | 记录内容 | 优点 | 适用场景 | 缺点/陷阱 |
|---|---|---|---|---|
| STATEMENT | 原始 SQL | 体积最小、性能最高 | 历史系统、低写入量业务 | NOW()、UUID、LIMIT 等非确定性语句可能导致主从数据不一致 |
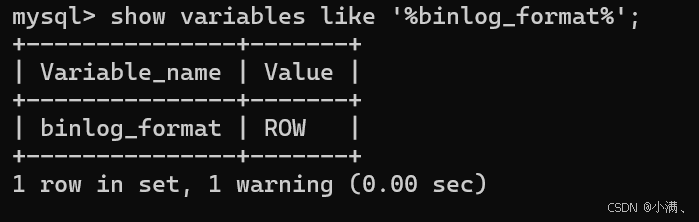
| ROW(默认) | 每行变更前后镜像 row event | 最可靠、可完全恢复 | 金融、支付、电商核心库 | 日志量巨大、大事务可能撑爆磁盘 |
| MIXED | S + ROW 动态切换 | 兼顾体积&安全 | 中大型业务通用 | 较难排查某条用的是哪种 |
查看当前格式:
SHOW VARIABLES LIKE '%binlog_format%';
为什么行格式安全?
因为它记录的是“变更后的真实数据”,而不是 SQL 描述,不受函数、随机数影响,因此主从永不产生逻辑偏差。
(2)Binlog 查看 / 分析 / 恢复
二进制不可直接读 → 使用 mysqlbinlog 工具解析:
mysqlbinlog -vv binlog.000123 > log.txt
常用参数:
| 参数 | 含义 |
|---|---|
-vv | 输出更详细注释,包含 row-based 修改前后值 |
-d dbname | 仅解析某个库的操作 |
--start-datetime / --stop-datetime | 精确恢复某时间区间 |
--start-position / --stop-position | 适用于恢复某事务范围 |
误删数据如何救?
假设执行了:
DROP DATABASE prod;
恢复流程:
1) 确保有 recent binlog(未过期)
2) 将 Drop 之前的 binlog 解出
3) 回放除 DROP 外所有 SQL
示例命令:
mysqlbinlog --start-datetime="2025-01-01 10:00:00" \
            --stop-datetime="2025-01-01 12:00:00" \
            binlog.000125 | mysql -uroot -p
专业场景通常还会配合全量备份 + 增量 binlog 做 PITR 精准恢复到秒级
(3)Binlog 清理与 MySQL 8.0 优化机制
因为 Binlog 可能非常大(Row 格式下尤甚),必须设置自动清理,否则产生磁盘爆满 → MySQL 直接挂掉!
手动清理:
PURGE BINARY LOGS TO 'binlog.000200';
PURGE BINARY LOGS BEFORE '2025-02-01';
但更推荐 MySQL 8.0+
SHOW VARIABLES LIKE '%binlog_expire_logs_seconds%';
SET GLOBAL binlog_expire_logs_seconds = 604800; -- 7天
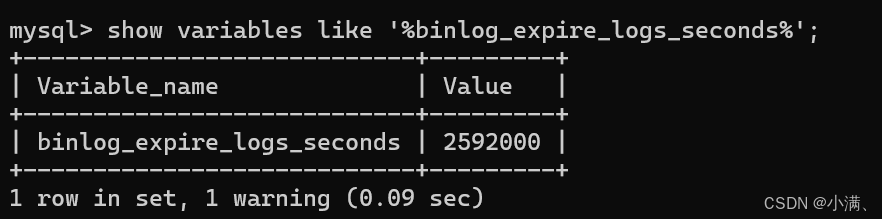
经验建议:主库保留 7-30 天,备库可更长
有归档需求可 scp 拉取冷存
(三)查询日志(General Log)
1. 定义
General Log 记录所有客户端发送给 MySQL 的 SQL,包括查询、连接请求、管理命令。
它是最完整、最暴力的 SQL 审计方式,但 性能开销巨大,因此 默认关闭。
查看配置:
SHOW VARIABLES LIKE '%general%';
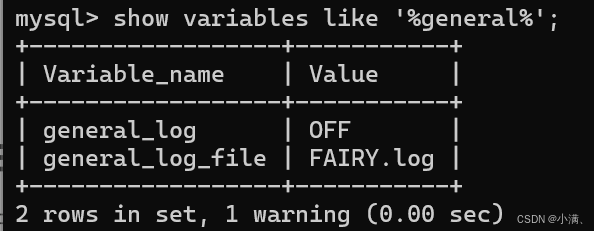
启用方式:
general_log=1
general_log_file=/var/log/mysql/general.log
一旦开启,每条 SQL 都会写磁盘 → TPS 直接下降
只建议排查问题时短暂使用
使用场景:
| 使用场景 | 价值 |
|---|---|
| 某接口执行了什么 SQL? | 用于排查 ORM 框架生成 SQL |
| 判断是否有扫描、慢语句来源 | 结合 slow log 定位性能热点 |
| 安全审计/违规操作分析 | 找出误删数据的操作者、语句来源 |
若需长期 SQL 审计,更推荐替代方案:ProxySQL、Audit Plugin、Binlog 解析流式存储
(四)慢查询日志(Slow Log)
1. 定义
慢日志用于记录执行时间超出阈值(long_query_time 默认 10s)的 SQL,是性能优化必须开启的日志。
slow_query_log=1
long_query_time=1             -- 建议生产 ≤1s
log_queries_not_using_indexes=1
log_slow_admin_statements=1
日志位置:
SHOW VARIABLES LIKE '%slow_query_log_file%';
如何分析慢日志?
推荐工具:Percona pt-query-digest
pt-query-digest /var/log/mysql/slow.log > report.txt
可输出:
| 项目 | 说明 |
|---|---|
| 最耗时语句 | 优先优化 Top N! |
| 执行次数最多的语句 | 高频低效 → 必须建索引或优化 SQL |
| 平均耗时/锁等待时间 | 判断是否是索引失效 or 竞争阻塞 |
生产场景优化思路
慢日志定位后需分析:
是否缺索引?
是否走全表扫描?
是否存在回表与排序成本?
是否具有不必要的运算(函数、计算列)?
是否大事务或批量写入导致锁等待?
优化手段:
| 问题 | 处理方式 |
|---|---|
| 没索引 / 索引未使用 | 建索引 + 避免对索引列做计算 |
| 回表严重 | 改覆盖索引(SELECT t.col1,t.col2),避免 SELECT * |
| 排序/分组慢 | 加合适索引 / 使用分页优化方案 |
| 大事务 | 拆分 batch / 控制单次提交量 |
二、主从复制(Replication)
(一) 主从复制核心目的
主从复制不仅是数据同步手段,更是企业级 MySQL 架构优化和高可用的核心组件。
| 价值 | 说明 & 企业意义 |
|---|---|
| 读写分离,提高并发性能 | 主库负责写,从库分担读压力(电商类场景显著) |
| 容灾容错,提高可用性 | 主库宕机,从库快速接管,减少停服时间 |
| 备份不影响业务 | 在从库执行备份任务,不干扰线上请求 |
| 数据审计、安全追踪 | Binlog 作为业务操作的不可抵赖数据来源 |
注意:复制本身 不是备份,仅提供数据冗余和同步机制,仍需定期做全量 + 增量备份。
(二) 主从复制底层原理(核心三阶段 + Thread 机制)
主从复制流程:
Client → Master → Binlog → Slave IO Thread → Relay Log → SQL Thread → Apply
| 阶段 | 执行位置 | 核心操作 | 关键点 | 底层原理 |
|---|---|---|---|---|
| ① 主库提交事务写入 Binlog | Master | 所有变更记录 event | 仅提交成功才写入,保证一致性 | 事务成功提交后写 binlog(同步到磁盘/缓冲区),保证 ACID |
| ② 从库 IO Thread 拉取 Binlog | Slave | 传输并落盘为 Relay Log | 默认异步,不阻塞主库 | TCP 异步复制,网络 + 磁盘 flush |
| ③ SQL Thread 回放 Relay Log | Slave | 将 event 转换为真实 SQL 执行 | 单线程回放 → 延迟瓶颈来源 | row/statement 格式 event 回放,事务大时耗时显著 |
1. 为什么必须先提交成功才写入 Binlog?
事务若失败,不应被复制到从库,否则会导致数据冲突。这体现了 ACID 的一致性原则。
2. 为什么主从复制会延迟?
延迟表现:主库写入成功 → 从库可见延迟 1s、10s,甚至分钟级。
根因:
A. SQL Thread 单线程回放成为瓶颈(核心本质)
主库可能多个并发事务写入 binlog
从库 SQL Thread 却只能串行执行 → 堵塞累积
示例:
Master: T1、T2、T3 并行提交
Slave: T1 未完成 → T2 阻塞 → T3 堵塞
B. 大事务/批量写入放大积压
1条超过10万行 UPDATE 就能让从库落后数分钟
优化建议:
| 现象 | 解决方案 |
|---|---|
| 大批量写入导致延迟 | 分批小事务提交;使用 LIMIT 分片更新 |
| 大表 DDL(ALTER)阻塞回放 | 使用 pt-online-schema-change 或 gh-ost 避免长锁 |
C. IO、CPU、磁盘性能不足
Relay Log 写入慢 → 延迟
SQL 回放慢 → 表缺索引、CPU 瓶颈
优化:SSD + RAID10、增加从库实例、SQL 优化
3. 解决主从延迟的工程级方案
| 方案 | 原理 | 适用场景 |
|---|---|---|
| 多线程复制(MySQL 5.7+) | 按库或事务并行回放 | 多 schema、事务独立性高 |
| MTS-Enhanced 并行事务执行(MySQL 8.0) | 基于事务提交顺序并发执行 | 单库事务多、并发提升明显 |
| 强制 binlog group commit | 批量提交提高写入吞吐 | 写入压力大、电商高峰期 |
| 提升硬件/多从库分担 | SSD + RAID10 + xtrabackup备份 | 高负载场景必配 |
延迟不是偶发现象,而是架构本质,需要通过 并发复制 + 多从库 对抗。
(三)MySQL 8.0 GTID复制
GTID 是什么?
GTID(Global Transaction ID) = 事务级唯一编号
格式示例:
UUID:transaction_id
3E11FA47-71CA-11E1-9E33-C80AA9429562:23
相比传统基于 binlog_file + pos 的复制方式:
| 传统复制 | GTID复制 |
|---|---|
| 需要指定文件 + 位置 | 只需执行到下一个事务 GTID |
| 主故障切换需要手工调整同步位点 | 从库自动寻找位置并追上主库 |
| 切主复杂,一旦错位难恢复 | GTID 极大降低故障切换成本 |
优点
无需关心 binlog 位置
宕机后从库可自动补偿缺失事务
做主从切换、故障恢复极其方便
启用配置(生产推荐 MySQL8.0):
gtid_mode=ON
enforce_gtid_consistency=ON
(四)复制模式比较
| 复制模式 | 特点 | 评价 |
|---|---|---|
| 异步复制(默认) | 主不等待从库,最快 | 高性能 ,但可能丢数据 |
| 半同步复制 | 主至少等待 1个从确认 | 强一致性更高但延迟上升 |
| MGR(Group Replication) | 多主协议,自动选主 | 分布式一致性最高但配置复杂 |
企业级推荐:
读多写少 → 异步 + 多从库
写敏感强一致性 → 半同步 or MGR
(五)主从切换/故障迁移
手动切换示例:
STOP REPLICA;
RESET SLAVE ALL;
CHANGE MASTER TO ...
START REPLICA;
企业生产通常使用自动 HA 工具:
| 工具 | 作用 |
|---|---|
| MHA (Master High Availability) | 自动切主,恢复binlog位置 |
| Orchestrator | GitHub开源,可视化拓扑 & 智能切换 |
| MGR | 自带共识算法,不依赖第三方 |
生产最佳实践:
一主多从 + MHA/Orchestrator + GTID
→ 最佳平衡方案
(六)主从复制配置示例(MySQL8.0)
主库 my.cnf:
server-id=1
binlog-do-db=db01
从库 my.cnf
server-id=2
read-only=1
从库建立复制连接:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='xx.xx',
  SOURCE_USER='itcast',
  SOURCE_PASSWORD='123',
  SOURCE_LOG_FILE='binlog.000001',
  SOURCE_LOG_POS=120;
启动复制:
START REPLICA; # MySQL8.0+
查看状态:
SHOW REPLICA STATUS\G
关注:
| 参数 | 是否正常 | 含义 |
|---|---|---|
| Replica_IO_Running | YES | 从库成功获取主库 binlog |
| Replica_SQL_Running | YES | 从库 relay log 回放成功 |
主从复制:MySQL 复制通过 IO Thread 拉取 Binlog 写入 Relay Log,再由 SQL Thread 回放并执行。延迟本质来自从库回放单线程瓶颈,MySQL 8.0 支持基于提交顺序的并行复制,配合 GTID 可实现自动定位事务,故障切换无需关心 Position,大幅简化运维复杂度。生产建议开启 ROW 格式 + 多线程复制 + binlog 清理策略,必要时接入 Orchestrator/MHA 做高可用。
三、分库分表
(一)背景问题
在高并发、大数据量的应用场景下,单库单表很容易出现性能瓶颈,主要表现为:
| 性能瓶颈 | 说明 | 底层原理 |
|---|---|---|
| IO 不足 | 热点数据频繁访问,磁盘频繁读写 | 磁盘寻址速度有限,随机访问多时 I/O 队列成为瓶颈 |
| CPU 顶满 | 大量复杂查询(JOIN、聚合) | 查询解析、优化器生成执行计划以及执行引擎计算消耗 CPU |
| 单表数据过大 | 索引膨胀,查询退化为全表扫描 | B+Tree 索引页数膨胀,随机访问增加,缓存命中率下降,导致回表成本上升 |
示例:
假设 order 表存储了 5 年的订单数据,单表有 10 亿行。使用 SELECT * FROM order WHERE user_id = 123 查询时,如果没有合适的分库分表,数据库需要扫描整个索引,导致查询延迟数秒甚至十秒以上。
“当系统单表数据量过大或热点数据集中时,单机数据库无法承受高并发访问,容易出现 I/O 和 CPU 瓶颈,同时索引效率下降,查询退化为全表扫描,这是分库分表的主要驱动力。”
(二)分库分表方案对比
分库分表主要分为垂直拆分和水平拆分两种方式:
| 拆分方式 | 特点 | 适用场景 | 底层原理 | 示例 |
|---|---|---|---|---|
| 垂直分库 | 按业务模块拆分 | 订单库、用户库、商品库独立 | 每个库独立运行,IO/CPU 隔离 | DB_user、DB_order、DB_product |
| 垂直分表 | 按字段拆分表 | 宽表拆分成基本信息表和扩展信息表 | 减少单表列数,降低回表成本 | user_base + user_profile |
| 水平分库 | 数据按某字段拆入不同库 | 高并发、数据量大 | 通过中间件或应用路由请求到对应库 | DB_user_0、DB_user_1 |
| 水平分表 | 数据按某字段拆入同库多表 | 核心高并发场景 | 减少单表数据量,保持索引效率 | user_00、user_01、user_02 分片字段:user_id % 4 |
示例:
假设有 1000 万用户,要查询用户信息:
水平分表方案:user_id % 4 → user_0、user_1、user_2、user_3 四张表,每张表约 250 万行,单表查询更快。
垂直分库方案:订单数据放在 DB_order,用户信息放在 DB_user,写入/查询操作互不干扰。
“垂直拆分主要解决不同业务模块之间的隔离问题,水平拆分主要解决单表数据量过大导致的性能问题。常用水平分片字段为用户 ID 或订单 ID,通过取模或哈希将请求路由到对应表/库。”
(三)技术选型
常用中间件:
| 中间件 | 优点 | 缺点 | 底层原理 |
|---|---|---|---|
| ShardingJDBC | 性能高,可灵活定制 | 需改代码,侵入性强 | 基于 JDBC 层拦截 SQL,解析逻辑表 → 路由到物理表/库,支持读写分离、分片 |
| MyCat | 可直接当 MySQL 使用 | 性能逊色于 JDBC,配置复杂 | 作为数据库代理,接收 SQL 并路由到不同库表,内部维护分片规则和连接池 |
MyCat 核心配置文件理解
| 文件 | 内容 |
|---|---|
| schema.xml | 定义逻辑库、逻辑表及节点分布 |
| rule.xml | 定义分片算法、路由策略 |
| server.xml | 配置用户权限、端口、线程池等 |
示例配置:
逻辑表 user,4 个分表:
<table name="user">
    <rule>user_rule</rule>
</table>

<rule name="user_rule" class="hash">
    <columns>user_id</columns>
    <shards>DB_user_0.user_0,DB_user_1.user_1,DB_user_2.user_2,DB_user_3.user_3</shards>
</rule>
当应用执行 SELECT * FROM user WHERE user_id=123,中间件会根据 user_id % 4 将请求路由到 DB_user_3.user_3。
“分库分表可通过中间件实现透明路由。ShardingJDBC 基于 JDBC 层拦截 SQL,MyCat 作为数据库代理实现分片。核心是根据分片键计算路由,并将逻辑表映射到物理表,保证应用无感知地访问分表。”
更多推荐



 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)