
【推荐系统】手写ALS算法:基于矩阵分解的协同过滤(附Python源码)
在推荐系统中,矩阵分解(Matrix Factorization, MF)是一种非常经典且有效的协同过滤算法。本文将详细介绍其中最常用的求解方法之一——交替最小二乘法(Alternating Least Squares, ALS),并提供一份纯Python手写(不依赖高级深度学习框架)的完整代码实现与详细解析。
一、 算法原理
1.1 矩阵分解的核心思想
推荐系统的核心数据通常是用户对物品的评分矩阵 R R R( m m m 个用户, n n n 个物品)。由于用户不可能对所有物品评分,这个矩阵是非常稀疏的。
矩阵分解的目标是将高维、稀疏的评分矩阵 R R R,分解为两个低维、稠密的矩阵的乘积:
- 用户矩阵 U U U:维度为 k × m k \times m k×m(代码中实现为列向量形式),表示 m m m 个用户在 k k k 个隐向量维度上的特征。
- 物品矩阵 V V V:维度为 k × n k \times n k×n,表示 n n n 个物品在 k k k 个隐向量维度上的特征。
预测评分
r
^
u
i
\hat{r}_{ui}
r^ui 计算公式为:
r
^
u
i
=
u
u
T
⋅
v
i
\hat{r}_{ui} = u_u^T \cdot v_i
r^ui=uuT⋅vi
其中
u
u
u_u
uu 是用户
u
u
u 的特征向量,
v
i
v_i
vi 是物品
i
i
i 的特征向量。
1.2 目标函数(Loss Function)
我们要最小化预测评分与真实评分之间的误差平方和(RMSE):
J
=
∑
(
u
,
i
)
∈
R
(
r
u
i
−
u
u
T
v
i
)
2
J = \sum_{(u,i) \in R} (r_{ui} - u_u^T v_i)^2
J=(u,i)∈R∑(rui−uuTvi)2
(注:实际生产中通常会加入
λ
\lambda
λ 正则化项以防止过拟合,但在本代码实现的简化版本中主要关注最小二乘法的核心逻辑)
1.3 ALS(交替最小二乘法)流程
由于 U U U 和 V V V 都是未知的,直接求解非凸函数非常困难。ALS 采用一种迭代的思想:
- 固定物品矩阵
V
V
V,求解最优的用户矩阵
U
U
U。此时问题转化为标准的最小二乘问题。
- 导数为0可得解: u u = ( V V T ) − 1 V r u u_u = (V V^T)^{-1} V r_u uu=(VVT)−1Vru
- 固定用户矩阵
U
U
U,求解最优的物品矩阵
V
V
V。
- 同理可得解: v i = ( U U T ) − 1 U r i v_i = (U U^T)^{-1} U r_i vi=(UUT)−1Uri
- 交替重复上述两步,直到RMSE收敛或达到最大迭代次数。
1.4 原理示意图
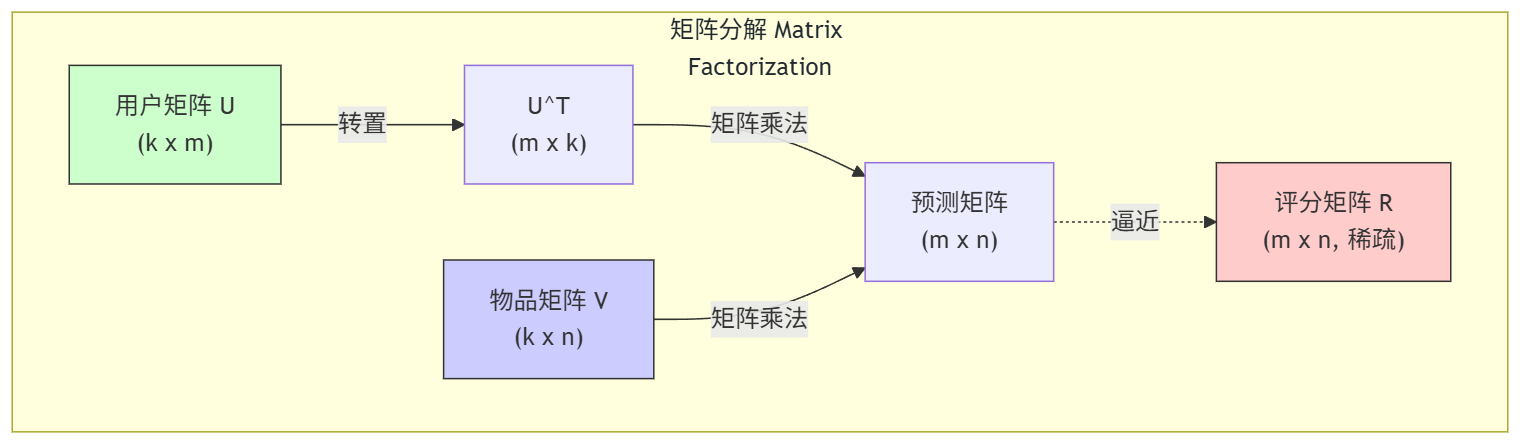
二、 Python代码实现与详细注释
本代码包含两个类:
Matrix:手写实现的线性代数库,包含矩阵乘法、转置、求逆(高斯消元法)等。ALS:基于上述矩阵库实现的推荐算法核心逻辑。
from itertools import product, chain
from copy import deepcopy
import pandas as pd
import numpy as np
import random
from collections import defaultdict

# ==========================================
# 1. 基础矩阵运算类 (类似于简易版NumPy)
# ==========================================
class Matrix(object):
    def __init__(self, data):
        """初始化矩阵"""
        self.data = data
        self.shape = (len(data), len(data[0]))

    def row(self, row_no):
        """获取矩阵的某一行,返回Matrix对象"""
        return Matrix([self.data[row_no]])

    def col(self, col_no):
        """获取矩阵的某一列,返回Matrix对象"""
        m = self.shape[0]
        return Matrix([[self.data[i][col_no]] for i in range(m)])

    @property
    def is_square(self):
        """判断是否为方阵"""
        return self.shape[0] == self.shape[1]

    @property
    def transpose(self):
        """矩阵转置 T"""
        data = list(map(list, zip(*self.data)))
        return Matrix(data)

    def _eye(self, n):
        """生成 n x n 的单位矩阵 (内部辅助函数)"""
        return [[0 if i != j else 1 for j in range(n)] for i in range(n)]

    @property
    def eye(self):
        """获取与当前矩阵同维度的单位矩阵"""
        assert self.is_square, "The matrix has to be square!"
        data = self._eye(self.shape[0])
        return Matrix(data)

    def _gaussian_elimination(self, aug_matrix):
        """
        高斯消元法:将增广矩阵的左侧变为单位矩阵
        这是求矩阵逆的核心步骤
        """
        n = len(aug_matrix)
        m = len(aug_matrix[0])

        # 从上到下消元,构建上三角矩阵
        for col_idx in range(n):
            # 如果对角线元素为0,寻找下方非0元素行进行交换或加和
            if aug_matrix[col_idx][col_idx] == 0:
                row_idx = col_idx
                while row_idx < n and aug_matrix[row_idx][col_idx] == 0:
                    row_idx += 1
                for i in range(col_idx, m):
                    aug_matrix[col_idx][i] += aug_matrix[row_idx][i]

            # 消去当前列下方的元素
            for i in range(col_idx + 1, n):
                if aug_matrix[i][col_idx] == 0:
                    continue
                k = aug_matrix[i][col_idx] / aug_matrix[col_idx][col_idx]
                for j in range(col_idx, m):
                    aug_matrix[i][j] -= k * aug_matrix[col_idx][j]

        # 从下到上消元,构建对角矩阵
        for col_idx in range(n - 1, -1, -1):
            for i in range(col_idx):
                if aug_matrix[i][col_idx] == 0:
                    continue
                k = aug_matrix[i][col_idx] / aug_matrix[col_idx][col_idx]
                for j in chain(range(i, col_idx + 1), range(n, m)):
                    aug_matrix[i][j] -= k * aug_matrix[col_idx][j]

        # 将对角线元素归一化为1
        for i in range(n):
            k = 1 / aug_matrix[i][i]
            aug_matrix[i][i] *= k
            for j in range(n, m):
                aug_matrix[i][j] *= k

        return aug_matrix

    def _inverse(self, data):
        """求解矩阵的逆:[A|I] -> [I|A^-1]"""
        n = len(data)
        unit_matrix = self._eye(n)
        # 构造增广矩阵
        aug_matrix = [a + b for a, b in zip(self.data, unit_matrix)]
        ret = self._gaussian_elimination(aug_matrix)
        # 截取右半部分即为逆矩阵
        return list(map(lambda x: x[n:], ret))

    @property
    def inverse(self):
        """获取逆矩阵"""
        assert self.is_square, "The matrix has to be square!"
        data = self._inverse(self.data)
        return Matrix(data)

    def _row_mul(self, row_A, row_B):
        """向量点积"""
        return sum(x[0] * x[1] for x in zip(row_A, row_B))

    def _mat_mul(self, row_A, B):
        """辅助函数:行与矩阵相乘"""
        row_pairs = product([row_A], B.transpose.data)
        return [self._row_mul(*row_pair) for row_pair in row_pairs]

    def mat_mul(self, B):
        """矩阵乘法 A * B"""
        error_msg = "A's column count does not match B's row count!"
        assert self.shape[1] == B.shape[0], error_msg
        return Matrix([self._mat_mul(row_A, B) for row_A in self.data])

    def _mean(self, data):
        """计算均值"""
        m = len(data)
        n = len(data[0])
        ret = [0 for _ in range(n)]
        for row in data:
            for j in range(n):
                ret[j] += row[j] / m
        return ret

    def mean(self):
        return Matrix(self._mean(self.data))

    def scala_mul(self, scala):
        """标量乘法"""
        m, n = self.shape
        data = deepcopy(self.data)
        for i in range(m):
            for j in range(n):
                data[i][j] *= scala
        return Matrix(data)


# ==========================================
# 2. ALS 推荐算法实现类
# ==========================================
class ALS(object):
    def __init__(self):
        self.user_ids = None      # 用户ID列表
        self.item_ids = None      # 物品ID列表
        self.user_ids_dict = None # 用户ID到索引的映射
        self.item_ids_dict = None # 物品ID到索引的映射
        self.user_matrix = None   # 分解后的用户矩阵 U (k x m)
        self.item_matrix = None   # 分解后的物品矩阵 V (k x n)
        self.user_items = None    # 记录用户已看过的物品,用于过滤
        self.shape = None         # 评分矩阵大小
        self.rmse = None          # 均方根误差

    def _process_data(self, X):
        """
        数据预处理:将原始的三元组数据转换为稀疏映射字典
        Input: X (user_id, item_id, rating)
        Output: ratings (user->item), ratings_T (item->user)
        """
        # 提取并去重用户ID和物品ID
        self.user_ids = tuple((set(map(lambda x: x[0], X))))
        self.user_ids_dict = dict(map(lambda x: x[::-1], enumerate(self.user_ids)))

        self.item_ids = tuple((set(map(lambda x: x[1], X))))
        self.item_ids_dict = dict(map(lambda x: x[::-1], enumerate(self.item_ids)))

        self.shape = (len(self.user_ids), len(self.item_ids))

        # 构建稀疏矩阵的字典表示
        ratings = defaultdict(lambda: defaultdict(int))     # {user_id: {item_id: rating}}
        ratings_T = defaultdict(lambda: defaultdict(int))   # {item_id: {user_id: rating}}
        for row in X:
            user_id, item_id, rating = row
            ratings[user_id][item_id] = rating
            ratings_T[item_id][user_id] = rating

        return ratings, ratings_T

    def _users_mul_ratings(self, users, ratings_T):
        """
        更新 Item 矩阵时的辅助计算步骤
        公式逻辑:Item_matrix = (U * U^T)^-1 * U * R
        此函数主要负责计算 U * R 部分(处理稀疏性)

        Arguments:
            users {Matrix} -- k * m matrix (用户矩阵)
            ratings_T {dict} -- {item_id: {user_id: rating}}
        Returns:
            Matrix -- Item matrix (k * n)
        """
        def f(users_row, item_id):
            # 获取评价过该物品的所有用户ID和评分
            user_ids = iter(ratings_T[item_id].keys())
            scores = iter(ratings_T[item_id].values())
            col_nos = map(lambda x: self.user_ids_dict[x], user_ids)
            # 获取这些用户对应的特征向量片段
            _users_row = map(lambda x: users_row[x], col_nos)
            # 向量点积:用户特征 * 评分
            return sum(a * b for a, b in zip(_users_row, scores))

        # 遍历每一个特征维度 k 和每一个物品 n
        ret = [[f(users_row, item_id) for item_id in self.item_ids] for users_row in users.data]
        return Matrix(ret)

    def _items_mul_ratings(self, items, ratings):
        """
        更新 User 矩阵时的辅助计算步骤
        公式逻辑:User_matrix = (V * V^T)^-1 * V * R^T
        此函数主要负责计算 V * R^T 部分

        Arguments:
            items {Matrix} -- k * n matrix (物品矩阵)
            ratings {dict} -- {user_id: {item_id: rating}}
        Returns:
            Matrix -- User matrix (k * m)
        """
        def f(items_row, user_id):
            item_ids = iter(ratings[user_id].keys())
            scores = iter(ratings[user_id].values())
            col_nos = map(lambda x: self.item_ids_dict[x], item_ids)
            _items_row = map(lambda x: items_row[x], col_nos)
            return sum(a * b for a, b in zip(_items_row, scores))

        ret = [[f(items_row, user_id) for user_id in self.user_ids] for items_row in items.data]
        return Matrix(ret)

    def _gen_random_matrix(self, n_rows, n_colums):
        """生成随机初始化矩阵"""
        data = np.random.rand(n_rows, n_colums)
        return Matrix(data)

    def _get_rmse(self, ratings):
        """
        计算均方根误差 (RMSE) 以评估模型当前性能
        RMSE = sqrt( sum((r - r_hat)^2) / N )
        """
        m, n = self.shape
        mse = 0.0
        n_elements = sum(map(len, ratings.values())) # 总评分数
        for i in range(m):
            for j in range(n):
                user_id = self.user_ids[i]
                item_id = self.item_ids[j]
                rating = ratings[user_id][item_id]
                if rating > 0:
                    # 获取当前分解出的用户向量和物品向量
                    user_row = self.user_matrix.col(i).transpose
                    item_col = self.item_matrix.col(j)
                    # 计算预测分
                    rating_hat = user_row.mat_mul(item_col).data[0][0]
                    square_error = (rating - rating_hat) ** 2
                    mse += square_error / n_elements
        return mse ** 0.5

    def fit(self, X, k, max_iter=10):
        """
        模型训练入口 (ALS 核心逻辑)
        X: 训练数据 [[user, item, rating], ...]
        k: 隐向量维度 (latent features)
        max_iter: 最大迭代次数
        """
        ratings, ratings_T = self._process_data(X)
        self.user_items = {k: set(v.keys()) for k, v in ratings.items()}
        m, n = self.shape

        error_msg = "Parameter k must be less than the rank of original matrix"
        assert k < min(m, n), error_msg

        # 1. 随机初始化用户矩阵 U (维度 k * m)
        self.user_matrix = self._gen_random_matrix(k, m)

        # 2. 随机初始化物品矩阵 V (这一步在第一次循环中通过计算得到)
        # 本代码实现中,item_matrix 也是 k * n

        for i in range(max_iter):
            if i % 2:
                # 奇数次迭代:固定 Item 矩阵,更新 User 矩阵
                # 公式推导:U = (V * V^T)^-1 * (V * R^T)
                items = self.item_matrix
                # items.mat_mul(items.transpose) -> V * V^T (结果为 k * k)
                # .inverse -> 求逆
                # .mat_mul(items) -> * V
                # _items_mul_ratings -> * R^T (利用稀疏性计算)
                self.user_matrix = self._items_mul_ratings(
                    items.mat_mul(items.transpose).inverse.mat_mul(items),
                    ratings
                )
            else:
                # 偶数次迭代:固定 User 矩阵,更新 Item 矩阵
                # 公式推导:V = (U * U^T)^-1 * (U * R)
                users = self.user_matrix
                self.item_matrix = self._users_mul_ratings(
                    users.mat_mul(users.transpose).inverse.mat_mul(users),
                    ratings_T
                )

            # 每次迭代计算 RMSE
            rmse = self._get_rmse(ratings)
            print("Iterations: %d, RMSE: %.6f" % (i + 1, rmse))

        self.rmse = rmse

    def _predict(self, user_id, n_items):
        """单用户推荐预测"""
        # 获取该用户的特征向量
        users_col = self.user_matrix.col(self.user_ids_dict[user_id])
        users_col = users_col.transpose

        # 预测所有物品的评分: user_vector * item_matrix
        items_col = enumerate(users_col.mat_mul(self.item_matrix).data[0])
        items_scores = map(lambda x: (self.item_ids[x[0]], x[1]), items_col)

        # 过滤掉已经看过的物品
        viewed_items = self.user_items[user_id]
        items_scores = filter(lambda x: x[0] not in viewed_items, items_scores)

        # 排序并返回 Top-N
        return sorted(items_scores, key=lambda x: x[1], reverse=True)[:n_items]

    def predict(self, user_ids, n_items=10):
        """批量用户推荐预测"""
        return [self._predict(user_id, n_items) for user_id in user_ids]

# ==========================================
# 3. 运行示例
# ==========================================
def format_prediction(item_id, score):
    return "item_id:%d score:%.2f" % (item_id, score)

def load_movie_ratings(file_name):
    """
    加载数据函数
    假设csv格式: userId,movieId,rating,timestamp
    """
    try:
        f = open(file_name)
        lines = iter(f)
        # 跳过表头
        col_names = ", ".join(next(lines)[:-1].split(",")[:-1])
        print("The column names are: %s." % col_names)
        # 解析每一行
        data = [[float(x) if i == 2 else int(x)
                 for i, x in enumerate(line[:-1].split(",")[:-1])]
                for line in lines]
        f.close()
        return data
    except FileNotFoundError:
        print(f"Error: 文件 {file_name} 未找到,请确保文件存在。")
        # 返回模拟数据以保证代码可运行
        return [
            [1, 101, 5.0], [1, 102, 3.0], [1, 103, 2.5],
            [2, 101, 2.0], [2, 102, 2.5], [2, 103, 5.0],
            [2, 104, 2.0], [3, 101, 2.0], [3, 104, 4.0],
            [3, 105, 4.5], [3, 107, 5.0], [4, 101, 5.0],
            [4, 103, 3.0], [4, 104, 4.5], [4, 106, 4.0],
        ]

print(">>> 开始使用ALS算法...")
model = ALS()

# 1. 数据加载 (请确保当前目录下有 ratings_small.csv,或者使用内置模拟数据)
X = load_movie_ratings('./ratings_small.csv')

# 2. 模型训练
# k=3 表示将用户和物品映射到3维的隐空间中
print(">>> 开始训练...")
model.fit(X, k=3, max_iter=5)

# 3. 产生推荐
print(">>> 对用户进行Top-N推荐...")
# 获取数据集中前2个用户ID进行测试
test_user_ids = list(model.user_ids)[:2]
predictions = model.predict(test_user_ids, n_items=2)

for user_id, prediction in zip(test_user_ids, predictions):
    _prediction = [format_prediction(item_id, score) for item_id, score in prediction]
    print("User id:%d recommendation: %s" % (user_id, _prediction))
三、 代码关键点解析
-
矩阵求逆与高斯消元:
代码中Matrix类完全手写,核心难点在于_gaussian_elimination。在更新 U U U 或 V V V 时,公式涉及求逆运算 ( V V T ) − 1 (V V^T)^{-1} (VVT)−1。这是利用最小二乘法求解线性方程组的关键步骤。 -
交替迭代逻辑 (
fit函数):- 偶数次迭代:认为 U U U 是已知的常量,根据 R R R 去优化 V V V。
- 奇数次迭代:认为 V V V 是已知的常量,根据 R R R 去优化 U U U。
- 代码巧妙地使用了
i % 2来切换更新主体,避免了重复写极其相似的更新代码。
-
稀疏矩阵处理:
在_users_mul_ratings和_items_mul_ratings中,代码并没有将评分矩阵 R R R 还原成巨大的二维数组(这会爆内存),而是利用dict结构只遍历有评分的数据点。这体现了协同过滤处理海量稀疏数据的核心技巧。 -
预测与过滤:
推荐不仅仅是计算分数高低,更重要的是过滤。_predict函数中filter(lambda x: x[0] not in viewed_items, items_scores)这一行确保了系统不会给用户推荐他已经看过的电影。
四、相关资源
百度网盘:https://pan.baidu.com/s/1Cckqv7oNlKegzFXaV8kCgQ?pwd=6ixs
更多推荐


 24
 0
- 0


 已为社区贡献5条内容

所有评论(0)