
基于情感分析的音乐推荐系统
基于从社交网络提取的用户情感的音乐推荐系统
摘要
近年来,情感分析已被多种互联网服务用于根据人类情绪推荐内容,这些情绪通过用户在社交网络上发布的非正式文本来表达。然而,当前情感分析中使用的情感度量仅将句子分类为正面、中性或负面强度,无法根据用户画像检测情感的细微变化。针对这一问题,本文提出了一种基于情感强度指标的音乐推荐系统,该指标名为增强型情感度量(eSM),它将基于词典的情感度量与基于用户画像的修正因子相结合。该修正因子通过在实验室环境中进行的主观测试获得。根据实验结果,构建出修正因子并用于调整最终的情感强度。用户的情绪从其在社交网络上发布的句子中提取,音乐推荐系统通过一个适用于移动设备的低复杂度框架实现,根据用户当前的情感强度进行歌曲推荐。此外,该框架的设计考虑了可用性的人机工程学标准。所提出的框架性能通过众包方法对远程用户进行评估,用户满意度评分为91%,优于随机分配歌曲推荐所达到的65%用户满意度。此外,论文还表明,该系统在处理和内存感知方面对能耗、网络和延迟的影响较小,在消费电子领域展现出显著优势。
索引术语
— 推荐系统,社交网络,移动设备,情感分析
一、引言
人们使用互联网来表达自己,社交网络已成为分享信息、想法和经验的流行方式。人们通过社交网络撰写带有正面、负面或中性情绪的句子,表达他们的感受;在此背景下,关于情感强度的研究开始出现。了解一个句子的情感强度有助于收集有用的信息,并有助于更深入地了解一个人对事件、产品或内容的表达。
情感分析是一种自然语言处理和文本分析技术,可应用于电子学习、电子商务[1],和多媒体[2]等多个领域。然而,其在推荐系统中的应用仍面临挑战;人们以不同的方式表达他们的感受,这使得基于情感[3]创建可靠的推荐变得困难。
情感分析开始在音乐推荐系统中得到探索,以根据个人的情绪状态推荐特定歌曲,因为歌曲与个人当前的情绪和感受密切相关。目前存在基于生理信号[4],[5], 、主观情绪评估[6], 、基于标签的提取[7],[8], 、网络语义 [9],[10],以及机器学习(如支持向量机(SVM)及其衍生方法[11])和基于词典的技术(如ANEW [12])的情感分析研究。
音乐推荐系统中的用户可以手动选择其情绪状态[6],通过使用表情符号或在音乐推荐系统中使用生理传感器[5]来实现。然而,这种情绪的收集使系统依赖于用户输入和设备。因此,拥有一个独立且自动化的推荐系统是理想的。
基于标签的推荐和基于词典的技术[13]旨在根据词汇提取情绪,而未区分一个人是否更具情绪化。因此,当前研究在人们如何以更强或更弱的情感强度表达自己方面仍存在空白。
人们在一天中的特定时间使用社交网络[14],了解他们的习惯和行为可能对多种应用程序有用;因此,在日志中记录这些数据非常重要。通过实现日志,可以针对定制时间段开发推荐。例如,某人通常在周一和周二上午9点至10点阅读财经新闻,并倾向于在周六阅读娱乐新闻[14]。
推荐系统可以持续收集数据并向用户分发大量信息,但这会给系统及其用户带来不便,此外还会消耗更多的处理能力、带宽和消费电子设备的内存资源。因此,在用户便携式设备数量增加的情况下,广泛使用的应用程序必须消耗更少的资源。
本文是对提出个性化音乐推荐系统的工作[2]的扩展性贡献,使用一种名为eSM的新型基于词典的情感度量指标,该指标结合了Sentimeter‐Br2[2]指标和基于用户画像的新型修正因子,应用于情感分析。
Sentimeter‐Br2指标是一个词汇词典,包含相应的正负值情感强度,该指标考虑了n‐元语法和副词,去除了对句子情感无贡献的停用词。此外,该指标根据动词时态区分情感值,其中过去时的动词情感值低于现在时的动词情感值。Sentimeter‐Br2基于Sentimeter‐Br [1]。
本文的主要目标是证明,基于词典的情感强度指标结合修正因子,能够通过一种低复杂度解决方案提升音乐推荐系统的性能,并为消费电子设备带来优势。该修正因子利用了可从社交网络中轻松提取的个人特征。因此,新提出的指标eSM能够提供更准确的情感值。
此外,提出的推荐系统考虑了可用性方面的人机工程学因素,以提升用户的体验质量。
本文的其余部分结构如下。第二部分介绍了相关工作。第三部分提出了用于确定eSM的情感强度模型。第四部分展示了基于情感的提出的推荐系统架构。第五部分给出了包括提出的推荐系统与eSM性能评估在内的实验结果。最后,第六部分给出了结论。
II. 相关工作
本节首先回顾了关于情感分析的主要研究,其次探讨了使用情感分析指标的推荐系统。
A. 情感分析
情感分析可以采用三种方法进行,如图1所示:使用机器学习的语料库为基础的方法[15], 、使用词汇词典的基于词典的方法[16] ,以及结合这两种方法的混合方法[17]。
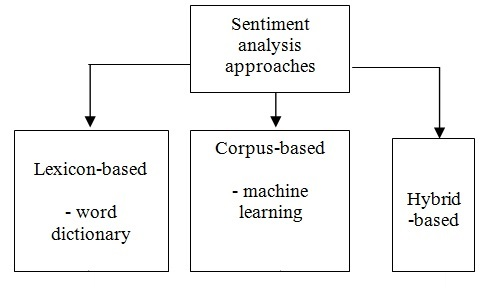
这些方法用于进行情感分析。然而,请注意,机器学习的使用需要大量数据才能获得可靠的情感分析结果,因为异常的句子可能会在情感计算中引入噪声。
本研究聚焦于使用词汇词典的基于词典的方法,用于定义情感强度指标。许多情感分析研究试图改进该指标,以更准确地找出文本的情感强度。人工词典包含词汇,其中每个词汇都有相应的分类,例如从+1到+5的正向量表或从‐1到‐5[12]的负向量表,如表I所示。情感语言词典 [18]采用包含大量情绪词汇的强度量表。WordNet 是另一个可用于情感分析的词汇词典。在本研究中,同时使用了 SentiStrength [19] 和 Sentimeter‐Br2 指标,因为二者均支持葡萄牙语,并可对其性能进行比较。
| Word | 情感强度值 |
|---|---|
| bad | -2 |
| like | +2 |
| 战斗 | -3 |
| 美丽 | +3 |
在定义了要使用的词典后,便可构建情感强度指标。获取句子情感的基本指标通常是通过计算词典中每个词汇的情感值的算术和得到的。例如,在(1)中,FSentiment 表示句子F的总体情感,变量value dictionary是构成该句子的每个词汇 iW在词典中定义的情感值。
$$
F_{Sentiment} = \sum_{i=1}^{m} value_{dictionary}(W_i)
\quad (1)
$$
在句子“I like beautiful shoes”中,只有词汇“like”和“beautiful”在基于词汇的词典中具有情感强度值,分别为+2和+3。根据公式(1),该句子总体情感的计算结果(2)等于+5;因此,该句子具有正面情感强度值。
$$
F_{Sentiment} = (+2) + (+3) = 5
\quad (2)
$$
为了计算更复杂句子的情感强度,有必要识别动词时态,副词和n‐元语法。本研究使用基于[1]的情感指标,因为该指标考虑了不同的词汇、语法类别和动词时态。
情感分析正开始在许多领域中被探索,但仍有许多问题有待研究,例如用户的个人资料是否真的会影响情感度量,必须考虑其特征,以及如何实现用户画像与情感强度指标之间的关联。例如,Thelwall et al.[20]指出情感强度可能因性别而异,但尚未定义其与指标的关联。
在对情感分析指标进行上述总体回顾之后,可以得出结论:基于词典的度量不会根据性别、年龄或其他用户特征来区分情感。
B. 推荐系统
推荐系统有三种方法:基于内容的、协同的和基于混合的。基于内容的方法通过关联项目描述与用户画像来工作,项目的推荐基于用户的偏好。协同的方法分析用户行为和偏好,并探索人与人之间相似的偏好[21],[22]。混合方法则结合了这两种方式。
推荐系统部署在包含用户偏好或历史记录数据库的服务器[23]上。采用服务器部署的优势在于,由于客户端应用复杂度低,不会因数据而使用户设备的内存过载。客户端与服务器之间存在数据传输流,但当前的数据网络已不像过去那样受限。
在推荐系统中,情感分析开始被探索用于根据个人的情绪和感受推荐更新的内容。
基于标签的推荐 [7],[8],[13] 侧重于音乐使用建议,通过搜索词汇并统计词频来为用户推荐包含这些词汇的歌曲。然而,这种推荐仅基于用户已搜索过的词汇,限制了新词汇的建议。
Web语义推荐利用句法相似性度量来提供相似的偏好。然而,需要更智能的技术以更灵活的方式提供内容,这些内容应与用户的偏好和语义关联相关 [10]。基于内容的推荐考虑词汇与本体之间的关系来推荐内容,而不是根据用户的感受变化来进行内容推荐。
在多媒体等特定领域的推荐系统需要根据个人的当前情绪、情绪和感受来推荐内容,因为个人会根据其当前情绪和感受选择特定的电影或歌曲。
任何推荐系统中的用户反馈都是一个需要考虑的重要工具。专注于数字电视或音乐推荐的研究会根据建议为了更有效地获取用户反馈[24]。用户通常不喜欢撰写手动反馈,因此使用自动技术来收集用户反馈非常重要。情感分析是一种自动收集用户满意度反馈的方法。
用户画像也是推荐系统中必须包含的另一个重要因素,这些信息可通过问卷或评分[1],[24]收集。在社交网络上,可以自动获取一些用户画像信息,例如性别、年龄、教育水平和出生城市。93.8%的人填写了性别类别[25],近70%的人在社交网络上填写了他们的国家、教育程度和年龄[26]。
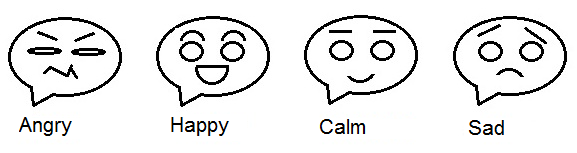
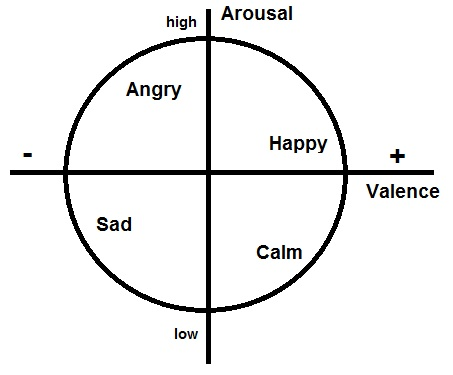
基于情绪的音乐推荐系统研究[6]通常依赖于通过表情符号对情绪进行手动评估来推荐歌曲,如图2所示。然而,为了使系统能够表示一个人一天中的情绪波动,用户必须每天在上午、下午和晚上手动选择他们的情绪状态[20]。
通过传感器[4],[5]可以自动获取用户的情绪。用于测量情绪的设备包括脑电图信号以及用于采集外周生理信号的电极[5]。然而,人们通常并没有配备用于测量生理参数并通过互联网持续传输该信息的传感器。
理想情况下,当前的推荐系统会计算从真实社交网络中提取的句子的情感强度,而不是从特定可信网络中提取句子 [27]。
如前所述,大多数推荐系统会根据用户历史和用户画像这两个变量来发送建议,但如今,推荐系统开始探索更多基于情感分析的建议。通过识别一个人是快乐还是悲伤,并根据其当前情绪状态推荐相应内容,有助于发现用户更愿意接受建议的时机,使用户不会感到被泛泛的或过时的建议所淹没。
III. 所提出的 情感强度度量
本节介绍了提出的的情感模型。该模型表明,如果情感度量未考虑用户画像,则该指标无法生成真实的情感强度值。需要根据用户的个人资料,应用通过主观测试发现的修正因子。
A. 在实验室环境中使用主观测试的初步研究
在此阶段,以葡萄牙语为母语的评估者在实验室环境中进行了初步的主观测试。通过测试,可以涵盖更多样化的评估者个人资料,例如出生地区(巴西北部、东北部、中部、东南部和南部)、宗教、种族、教育水平等其他通过图3所示的网页界面问卷获得的特征。此外,问卷中还询问了评估者根据其情绪状态(悲伤、快乐和平静)偏好的音乐类型;被试者可选择一个或两个音乐类型选项。
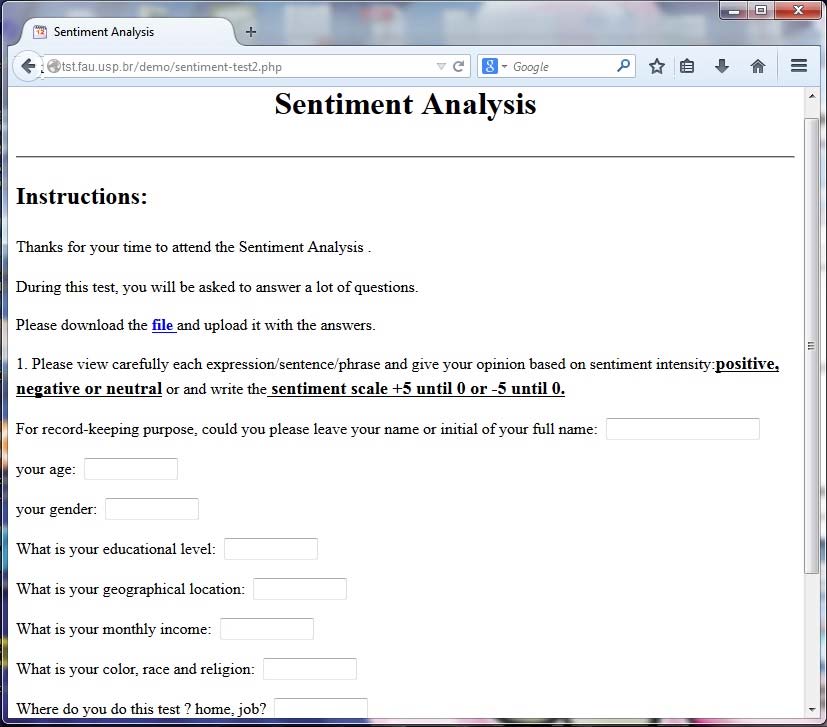
从图3中提取的初始特征有助于了解哪些人的特征可能影响情感度量。
评估者的回答被收集,并将与年龄对应的领域分为四组。研究由200名评估者完成,其中包括100名女性和100名男性;每位参与者写下自己的音乐偏好,并填写了包含个人资料的问卷。随后,每个人在社交网络上发布句子,这些句子由一个脚本自动捕获。这些句子随后由发布句子的本人以及Sentimeter‐Br2指标进行分析。在测试的第一阶段,该人使用从+5到‐5的情感量表对每个句子进行评价。
对评估者进行了监控,以确保他们在3周的测试周期内每小时收集自己在社交网络上发布的所有句子。第一天之后,由于人们无法在测试期间连续数小时待在实验室,测试便远程进行。社交媒体用户名已知,脚本会自动捕获用户句子。3周后,所有捕获的句子均由Sentimeter‐Br2和发布句子的评估者进行分析。
在为期3周的实验结束时,评估者再次前往实验室测试该框架的性能。在15天期间,每位评估者选择一天通过标准手机进行测试,以评估该应用程序。
总共从社交网络中提取了19,600个句子,并使用表II所示的量表进行评估。在19,600个句子中,仅有652个句子被丢弃,因为它们被认为是垃圾信息。
收集了访问日志以研究用户习惯。在实验中观察到,每位用户在社交网络上访问和发布句子都有一个自定义时间段,时间窗口为5到20分钟;例如,用户A倾向于在晚上10:00前后15分钟的时间窗口内发布句子,之后,用户A通常在晚上9:45至10:15之间发布更多句子。
将社交网络的平均访问时间添加到音乐推荐框架中,以捕捉每个用户的句子。该信息有助于在定制时间段内捕捉句子,而不是随机且持续地捕捉句子。该框架因此节省了更多的处理内存和能源资源。
基于用户画像,通过主观测试获得了情感校正因子。该数学模型表示一个应用于传统情感度量的修正因子。
B. 通过用户个人资料获得的提出的修正因子
初始研究通过主观测试得到的结果有助于创建用于调整Sentimetr‐Br2的提出的修正因子(CF)数学模型,从而得到新的eSM指标,如图4所示。
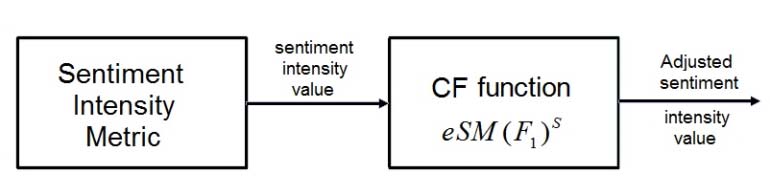
句子F的 $ S_{eSM}^{(1)}(F) $ 值由公式(3)给出。$ S_{eSM}^{(1)}(F) $ 表示句子F的情感强度值。该值来源于主观测试结果,代表评估者给出的情感强度值。$ S_{eSM}^{(1)}(F) $ 是由Sentimeter‐Br2指标确定的句子的情感强度值。
$$
S_{eSM}^{(1)}(F) = S_{eSM}^{(1)}(F) * \exp(C + a_1
A_1 + a_2
A_2 + … + a_n
A_n + g_1
M + g_2
F + e1
G + e2*nG)
\quad (3)
$$
其中:C 为比例常数;a1…an 是与年龄范围相关的二元因素,若其中一个等于1,则其余为0;A1…An 是每个年龄范围的权重因子。本文考虑了四个年龄范围;g1 和 g2 是与性别相关的二元因素,若其中一个等于1,则另一个为0;M 和 F 分别是男性和女性性别的权重因子;e1 和 e2 是与教育水平(是否接受高等教育)相关的二元因素;G 和 nG 分别是教育水平(是否接受高等教育)的权重因子。
值得注意的是,表II中列出的所有参数均未在(3)中考虑,因为主观测试结果表明它们不会影响 $ S_{eSM}^{(1)}(F) $。测试了线性和指数函数,最后的函数呈现出最低的平方误差。
本文考虑了指标 Sentimeter‐Br2,但可以使用任何情感强度指标来计算 (3) 中的 $ S_{eSM}^{(1)}(F) $。
IV. 提出的基于情感的推荐系统
本节介绍了基于eSM情感度量的提出的音乐推荐系统的详细信息和方法——系统架构在图5中进行了介绍。
将(3)中获得的数学模型应用于提出的推荐系统,以根据用户在定制时间段内的情感来推荐音乐。
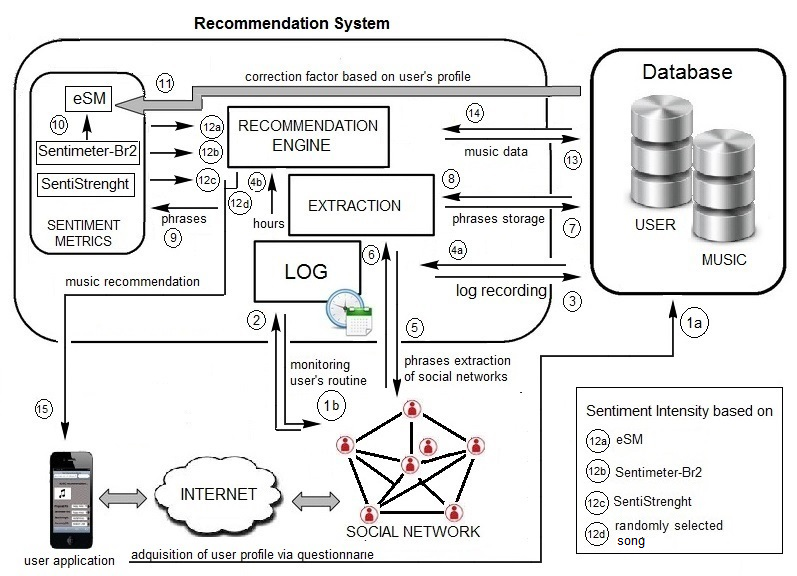
推荐系统拥有一个用户档案数据库,其中包含用户的音乐偏好、个人资料参数(如年龄、性别、教育水平)、基于其情绪状态的音乐偏好,以及首次在系统中完成问卷的人的社交媒体用户名。最初,系统会捕获该人发布的每一条句子;经过几周以来,该系统已记录了此人通常使用社交网络的一天中的时间。因此,系统仅在该一天中的时间或一周中的时间捕获句子,时间窗口为±20分钟。
如图5所示,该框架遵循四种推荐系统模型。首先,进行用户画像获取,并将数据发送到数据库(1a);用户日常行为监控开始(1b)和(2),其中时间和日期被记录在日志中,并发送到数据库(3)以及推荐引擎(4a)和(4b);从社交网络中提取用户的句子(5),并将这些句子发送到提取模块引擎(6);随后,句子被存储在数据库中(7),并发送至指标模块以计算情感强度(8)和(9)。情感强度值由指标计算得出,并与用户画像相关联的情感一起使用(11)。eSM通过(10)和(11)计算得出。三种情感强度指标(12a)、(12b)、(12c)以及随机选择的歌曲(12d)被发送到推荐引擎,推荐引擎需要(13)选定的歌曲并接收它们(14)。最后,这些歌曲推荐被发送到用户应用程序(15)。
如果用户未在社交网络上发布任何句子,则推荐其偏好风格的歌曲。
A. 实验室环境中的主观测试
评估者前往实验室,测试由个人单独进行,无干扰噪音。测试开始时,会进行说明,要求每位评估者填写一份问卷,内容包括其用户画像、发布句子并对每个句子进行评分。3周结束后,评估者应评估该框架的性能。
图8展示了在(3)中考虑的每个参数的权重。结果表明,性别和年龄参数是情感强度指标中最具影响力的因素。请注意,推荐系统需要提取简单的用户特征,例如基于用户情绪的年龄、性别、教育水平和歌曲偏好。该应用程序不需要提取复杂的用户特征,例如月收入、宗教和种族,因为这些特征不影响情感分析。因此,该研究不违反任何隐私规则,可在任何国家应用。
评估者对在电子设备上运行的推荐系统应用程序的感知消耗资源进行了评估,并在表III中给出结果。评分基于五点量表,其中评分为5表示极好质量且无明显中断,评分为1表示差的质量或非常烦人的中断。
表III中参数的较高平均值表明,该用户认为应用程序在电子设备上消耗较少资源。
| 性能关于 | 参数 | 感知平均值 | 值 |
|---|---|---|---|
| 推荐的延迟 | 系统的总体 | 4.2 | |
| 推荐系统的能耗 | 推荐系统应用程序 | 4.2 | |
| 明显的网络资源消耗 | 4.5 |
推荐系统应用程序使用带有无线保真接口(Wi‐Fi)的移动设备在客户端和服务器之间传输数据进行测试。设备特性如表IV所示。
该应用程序设计为在1.6 GHz八核的单核处理器上运行,因为它是应用于推荐系统中的简单代码。
评估者还针对该框架分析了一些考虑了外在和内在属性的可用性参数[34][35]。这些参数的五点量表平均值如表V所示。这些可用性属性表达了框架操作界面[36]的透明度。
| 规格 | 数值 |
|---|---|
| 电池容量 | 2,600 毫安时 |
| 触摸屏 | Yes |
| 显示分辨率 | 1080 x 1920 像素 |
| 显示屏尺寸 | 5.0 英寸触摸屏 ‐ 全高清 |
| 颜色 | 1600万色 |
| 处理器 | 1.6 GHz八核 |
| 随机存取存储器(RAM) | 2Gb |
| 内部数据存储 | 16Gb |
在所提出的框架中测试的可用性参数包括:(1)提示参数,指系统在呈现多个操作时帮助用户识别备选方案的所有手段;(2)即时反馈,指系统对请求事务中提供的信息作出快速响应;(3)可读性,屏幕上显示的信息必须便于阅读;(4)简洁性,涉及单个输入或输出的感知工作量;(5)用户控制,系统的用户应始终能够控制系统的运行;(6)灵活性,反映实现特定目标的可能方式;(7)用户体验,指系统中可用于考虑用户经验水平的手段;(8)错误保护,用于检测和防止一般性错误;(9)一致性,指信息的呈现方式以及访问菜单选项的操作流程应始终保持一致。
| 可用性参数 | 感知价值 |
|---|---|
| 提示 | 4.9 |
| 即时反馈 | 4.6 |
| 可读性 | 4.8 |
| 简洁性 | 4.2 |
| 用户控制 | 4.1 |
| 灵活性 | 4.4 |
| 用户体验 | 3.9 |
| 错误保护 | 4.1 |
| 一致性 | 4.7 |
在应用程序评估中使用可用性参数的目的是表明,一个应用程序必须考虑可用性的人机工程学标准,同时不消耗电子设备的大量资源。因此,人机工程学参数对于向用户提供有用且易于操作的系统平台非常重要。
B. 提出的推荐系统性能评估
提出的推荐系统的性能评估由远程评估人员进行。
表VII显示了用户对推荐系统的满意度水平的结果。回答选项依据基于形容词的李克特量表[37],分别为:非常好、好、中性、差和很差。该量表代表一种定性测量方法,并已广泛应用于许多研究[38],[39]。
用户使用eSM指标对推荐系统进行了积极评价。使用提出的指标eSM,该框架的用户满意度达到了91%用户满意。
| 随机地 已分配 song 建议 (no 情感 指标) | Sentimeter‐Br2 | SentiStrengh | eSM (提指出标的) | |
|---|---|---|---|---|
| 非常好 | 65% | 78% | 70% | 91% |
| Good | 15% | 13% | 16% | 7% |
| 中性 | 10% | 6% | 4% | 1% |
| Poor | 8% | 2% | 8% | 1% |
| 很差 | 2% | 1% | 2% | 0% |
最初应用于Sentimeter‐Br2指标以获得eSM的修正因子(如公式(3)所示),也被应用于SentiStrengh指标。结果如表八所示。值得注意的是,也可以使用其他情感强度指标。
| eSM (使用 SentiStrengh 指标) | eSM (使用 Sentimeter‐Br2 指标) | |
|---|---|---|
| 非常好 | 84% | 91% |
| Good | 9% | 7% |
| 中性 | 5% | 1% |
| Poor | 2% | 1% |
| 很差 | 0% | 0% |
VI. 结论
主观测试结果突显了在情感度量中考虑用户画像的重要性。因此,实验室环境中的测试揭示了可能影响句子最终情感强度的参数。基于这些结果,得到了一个依赖于年龄、教育水平和性别的修正因子。该修正因子被用于获得更真实的情感强度值。
新的情感强度指标eSM改进了音乐推荐系统,表明情感可能随用户的个人资料而变化。测试表明,eSM中使用的权重因子可以应用于其他情感度量,例如 SentiStrengh指标。
远程主观测试中,针对eSM的用户满意度达到91%,相比之下,未考虑情感强度的随机歌曲推荐满意度为65%,而仅考虑情感强度指标Sentimeter‐Br2时,用户满意度为78%。
对用户画像的分析结果显示,78%的用户倾向于收听与其当前情绪状态相似的音乐类型,而只有22%的用户倾向于收听与其当前情绪状态不同的音乐类型。例如,如果一个人处于悲伤情绪状态,则此人更倾向于收听更加忧郁的歌曲。
该解决方案不包含复杂编程语言;因此,所提出的解决方案对当前电子设备的资源消耗较少。评估者认为电子设备上资源消耗带来的中断无明显影响。
该框架在可用性方面的感知参数表现出良好结果,并表明将所有这些参数集成到框架中的重要性,以成为一个完整的工具。
该研究展示了将情感分析应用于音乐推荐系统;然而,情感度量也可应用于许多其他领域。
更多推荐

 29
 0
- 0


 已为社区贡献4条内容

所有评论(0)