
最优化逻辑-vivado hls第四十九章
一、控制运算符operation的流水线化
1.vivado hls会自动判定内部运算的流水线化级别
2.将resource和-latency选项配合使用,可以显式指定流水线阶段的数量,表示可以指定操作是几级流水线
3.rtl综合可以使用多个额外流水线寄存器来帮助改善布局布线后可能导致的时许问题
4.如果使用latency添加的时延比vivado hls判定的时延多一个时钟周期,vivado hls会向运算输出添加新的输出寄存器
5.如果使用latency添加的时延比vivado hls判定的时延多2个时钟周期,vivado hls会向运算符输出和输入侧都添加新的输出寄存器
6.如果指定的时延比由 Vivado HLS 判定的时延多 3 个或 3 个以上周期,Vivado HLS 会向运算的输出以及运算的输入侧添加寄存器。Vivado HLS 会自动判定任何附加的寄存器的位置。
7.以下配置指定随 DSP48 核实现的所有运算均采用流水线化,且时延设置为 3,这是该核允许的最大时延
config_core DSP48 -latency 3
8.以下配置指定随 RAM_1P_BRAM 核实现的所有块 RAM 均采用流水线化,且时延设置为 3
config_core RAM_1P_BRAM -latency 3
二、最优化逻辑表达式
1.enhance_balance表达式平衡来优化资源和速度
三、接口综合要求
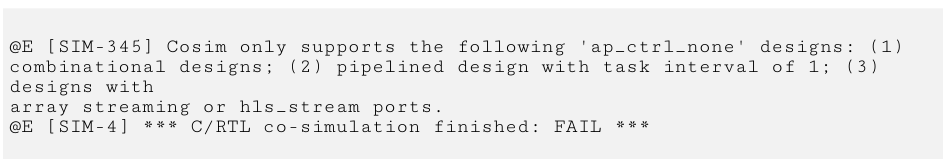
使用C/RTL协同仿真来验证RTL设计,必须要满足以下至少一项条件:
1.使用ap_ctl_hs或者ap_ctrl_chain块级接口综合顶层函数(至少满足一项条件)
2.使用纯组合逻辑来进行设计(至少满足一项条件)
3.顶层函数启动的时间间隔必须为1(至少满足一项条件)
4.接口包含的数组必须全部使用 ap_hs 或 axis 接口模式来进行流传输和实现(至少满足一项条件)
注意:hls::stream 变量作为 ap_fifo 接口自动实现
如果上面的条件全部不满足,那么c/rtl协同仿真就会失败
四、注意
1.如果设计指定为使用块级 I/O 协议 ap_ctrl_none 且设计包含采用非阻塞行为的任意 hls::stream 变量,则无法保证完成 C/RTL 协同仿真
2.如果任意顶层函数实参指定为 AXI4-Lite 接口,则函数返回也必须指定为 AXI4-Lite 接口。
更多推荐



 5
 0
- 0


 已为社区贡献14条内容

所有评论(0)