
【树、二叉树、堆】比特杭哥精讲板书+代码+课件汇总
树、堆、二叉树
开场白:写代码写到什么程度算一名合格的码农呢?
1、正确;可以跑通的代码
2、高效:代码的效率高。时间空间开销等等维度考虑。
3、优美:少冗余代码,复用性更高,好维护,该逻辑只需要改一段,其次是别人更容易看懂,命名要好。
4、提高调试代码、分析代码问题能力
初始的时候去公司是不会给大家github的提交权限和老员工合作维护代码的,3个月到半年左右的锁定期,大家的代码经审核打一个patch给导师来检查后上传~,哈哈毕竟你的代码出事故了,风险是一个组的一起承担,扣奖金也是哦。
树的概念及结构
1、树的概念
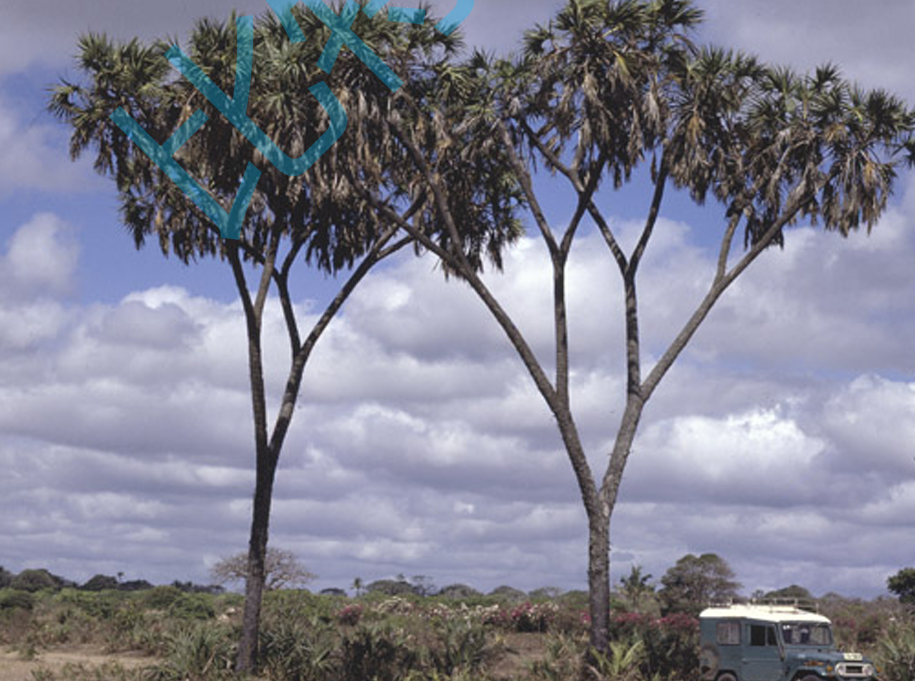
树是一种非线性的数据结构,它是由n(n>=0)个有限结点组成一个具有层次关系的集合。
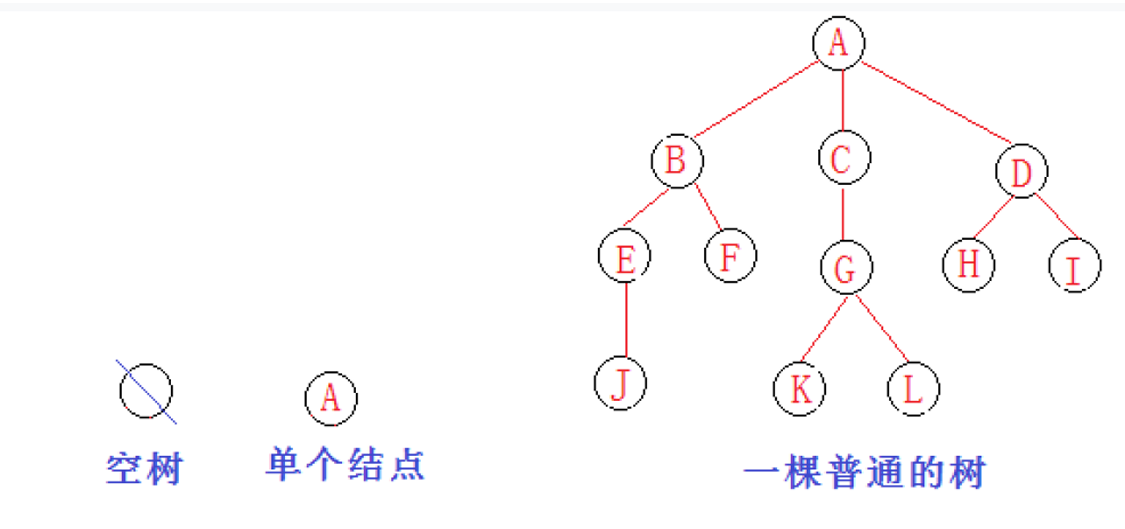
- 树是递归定义的:把它叫做树是因为它看起来像一棵倒挂的树,也就是说它是根朝上,而叶朝下的。
- 有一个特殊的结点,称为根结点,根节点没有前驱结点
- 除根节点外,其余结点被分成M(M>0)个互不相交的集合T1、T2、……、Tm,其中每一个集合Ti(1<= i <= m)又是一棵结构与树类似的子树。每棵子树的根结点有且只有一个前驱,可以有0个或多个后继。
1、树与非树
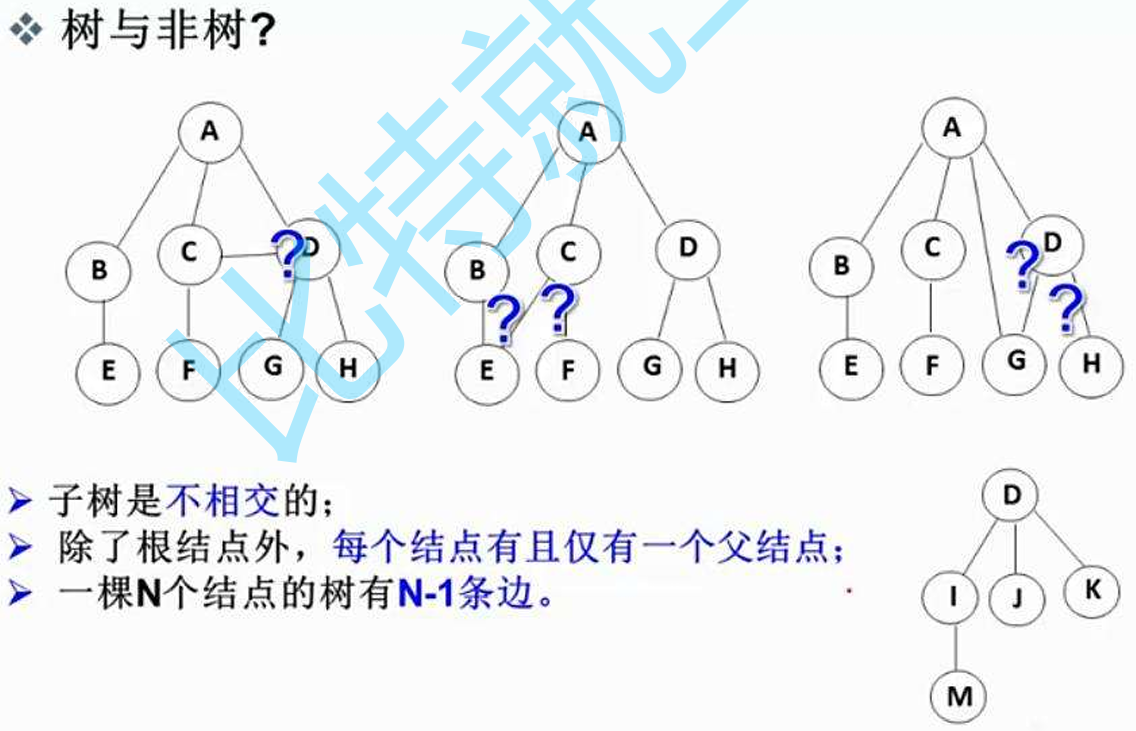
- 子树不相交:如果相交就可能造成重复遍历或者是死循环。这种回路的可以使用图表示 。
- 除根节点以外每个节点都有一个双亲节点
- 一颗n个节点的树有n-1个边(根节点不连着边,其余的点各连着一个边)
- 树的节点间的关系是一对多的,层次、递进关系的。
2、树的一些概念
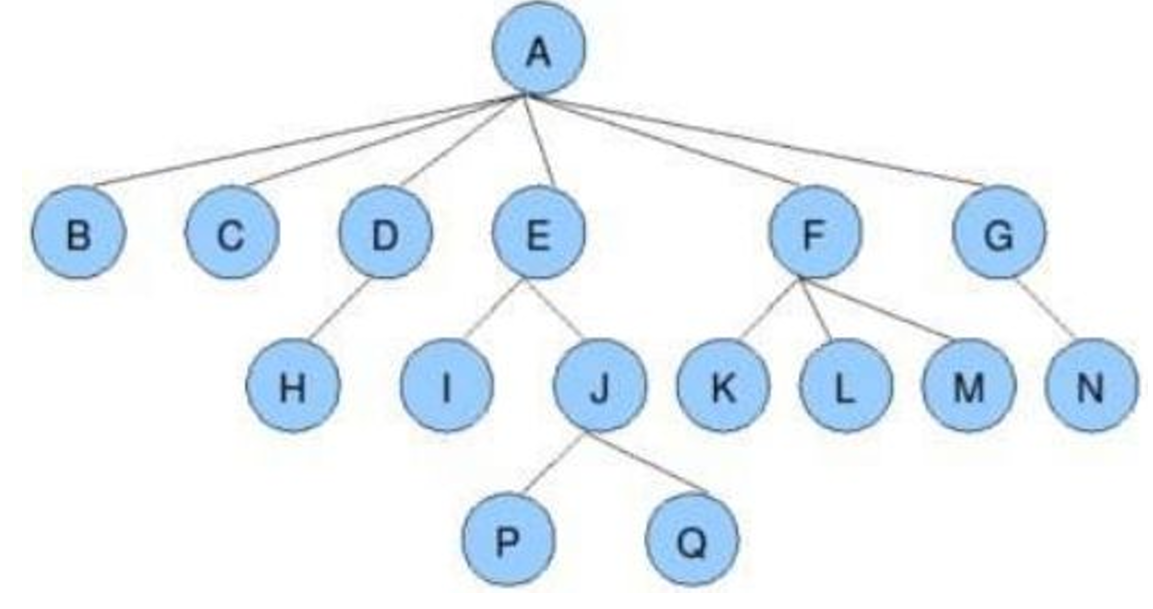
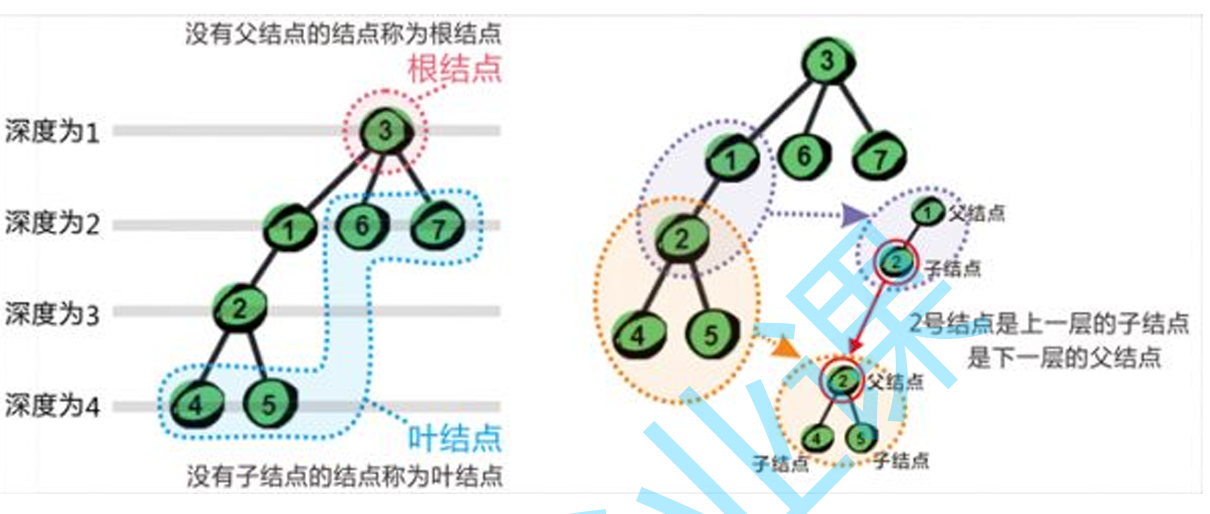
- 节点的度:一个节点含有的子树的个数称为该节点的度,也就是该节点的分支数; 如上图:A的为6
- 叶节点或终端节点:度为0的节点称为叶节点; 如上图:B、C、H、I…等节点为叶节点
- 非终端节点或分支节点:度不为0的节点; 如上图:D、E、F、G…等节点为分支节点
- 双亲节点或父节点:若一个节点含有子节点,则这个节点称为其子节点的父节点或是双亲节点; 如上图:A是B的父节点。
- 孩子节点或子节点:一个节点含有的子树的根节点称为该节点的子节点; 如上图:B是A的孩子节点。
- 兄弟节点:具有相同父节点的节点互称为兄弟节点; 如上图:B、C是兄弟节点
- 树的度:一棵树中,最大的节点的度称为树的度; 如上图:树的度为6
- 节点的层次:从根开始定义起,空树为第0层,根为第1层,根的子节点为第2层,以此类推;有的地方会认为从根开始是第0层,空树就是-1,依次类推;
- 树的高度或深度:树中节点的最大层次; 如上图:树的高度为4
- 节点的祖先:从根到该节点所经分支上的所有节点;如上图:A是所有节点的祖先
- 子孙:以某节点为根的子树中任一节点都称为该节点的子孙。如上图:所有节点都是A的子孙。
- 森林:由m(m>0)棵互不相交的多颗树的集合称为森林;(数据结构中的学习并查集本质就是一个森林)。-----与后面学的并查集相关性大。
树的结构定义:
可以使用链式也可以使用数组形式。
1、已知树的度数为N
就知道最多是N个指针指向他的孩子。
#define N 5
struct TreeNode
{
	int val;
	struct TreeNode* childs[N];
	//孩子指针数组,数组中存放着N个指向孩子的指针
	//这块的[]优先级更高,所以childs是一个数组,N代表存放N个元素
	//TreeNode* 代表存放元素的类型是树节点指针。
	int child;

}
int (*p)[n];//是一个数组指针,()优先级最高
//p是一个指针,[n]是一个有n个元素的数组,每个元素都是int整形类型
//p指向[n]
- 但是这样会存在一定的空间浪费,如果一棵树,其中一个节点的度数是100,其余节点的度数都是1。
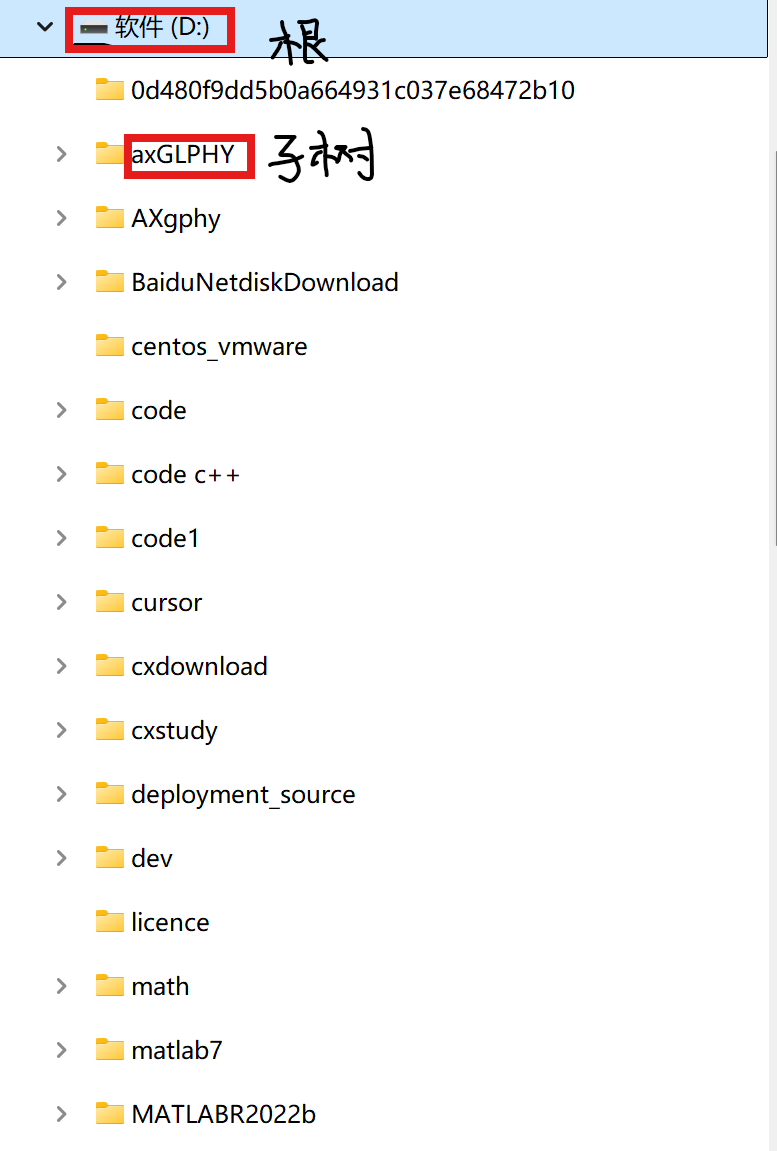
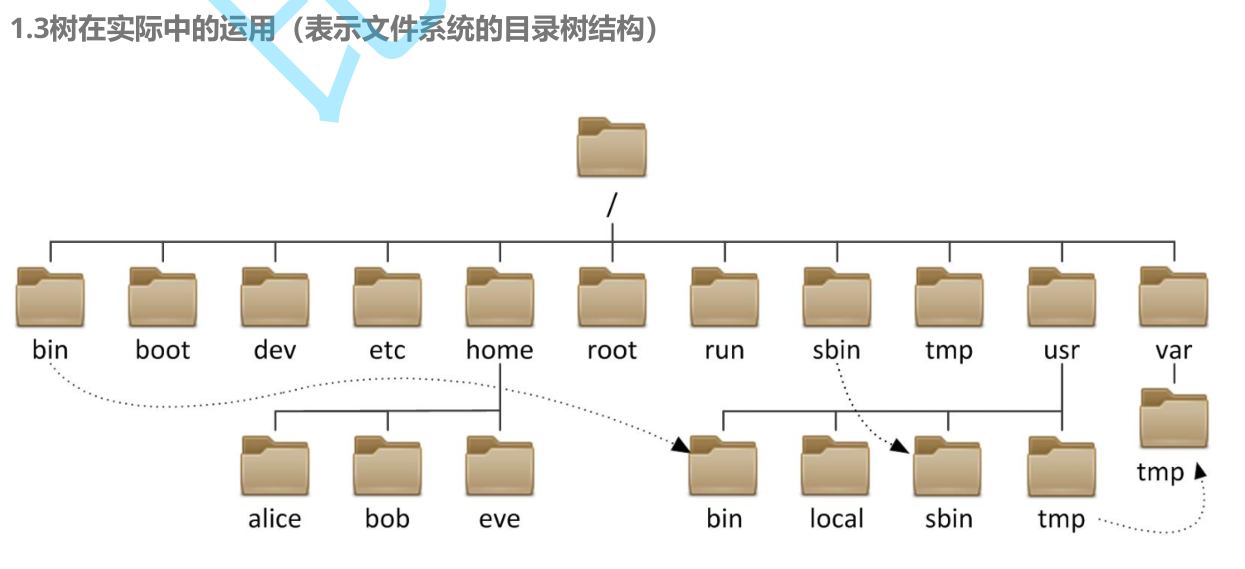
- 这种结构还存在弊端,如果不告诉你树的度呢?比如这种目录的结构就是树形结构,在这个子目录结构中里面也没有规定说文件只能限定多少个。
2、存放顺序表
typedef int DataType;
typedef struct TreeNode
{
	DataType val;
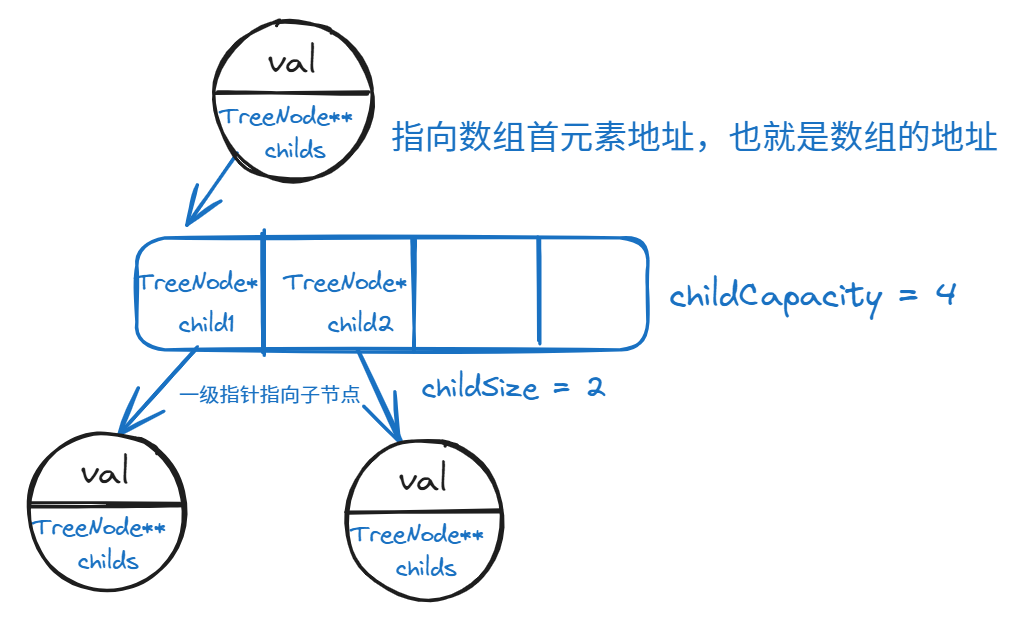
	struct TreeNode** childs;//存放孩子节点指针的顺序表
	int childSize;// 当前子节点数
	int childCapacity;// 数组容量
}TreeNode;
这里老师说如果有了c++的模版vetor会更方便,等我学到了,会出一篇笔记~
使用二级指针的原因:
- 一级指针TreeNode* 只能指向一个节点,如果有多个孩子没办法表示。
- TreeNode** 指向的是一个指针数组,指向 [TreeNode*, TreeNode*, …] 的指针数组。
初始化:
TreeNode* InitTreeRoot(int val,int initCapacity)
{
	TreeNode* Node =(TreeNode*) malloc(sizeof(TreeNode));
	Node->val = val;
	Node->childs = (TreeNode** )malloc(initcapacity*sizeof(TreeNode*))
	Node->childSize = 0;
	Node->childCapacity = initCapacity;// 数组容量
	return Node;
};
添加子节点:
void addChild(TreeNode* parent,TreeNode* child)
{
	int newCapacity = parent->childCapacity*2;
	//如果空间不够就需要增容
	if(parent->childSzie == parent->childCapacity)
	{
		parent->childs = realloc(parent->childs,newCapacity * sizeof(TreeNode*));
	}
	//将孩子节点的地址存储在childs指向的指针数组中
	parent->childs[childSize++] = child;
	//这里无论是child1,还是child2,第几个孩子都无所谓,因为存储的是地址,不是孩子的变量名。
}
内存释放
void freeTree(TreeNode* root)
{
	if(!root)//树为空直接返回
		return;
	for(i=0;i<root->childSzie;i++)//将节点一个一个的释放
	{
		free(root->childs[i]);//释放节点
	}
	free(root->childs);//释放指针指针数组
	free(root);//最后释放根节点
}
3、左孩子、右兄弟(最好)
这种存储方式基于链式存储,树的节点存在两个指针,一个数据。左指针存放孩子节点的地址,右指针存放兄弟节点的地址。
注意:只有双亲节点一样的才能叫做兄弟节点,F和G节点不叫兄弟节点。
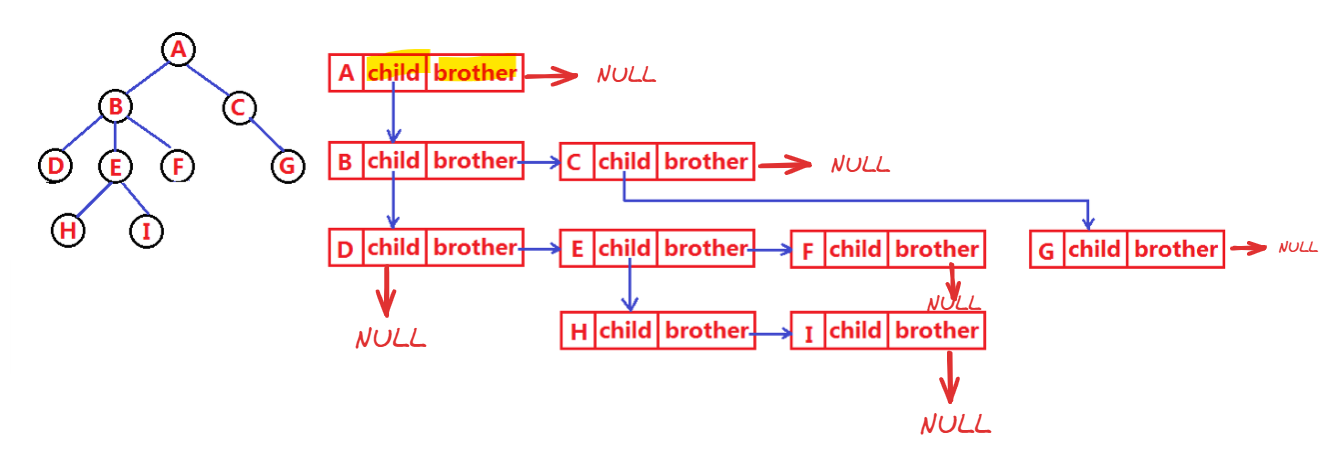
父亲指向左边第一个孩子,孩子之间使用兄弟指针链接起来
4、数组表示法
由于树形结构是一对多的,每个孩子节点只有一个双亲节点,数组中存放该节点的双亲的下标,这个经常在森林的并查集的时候使用。
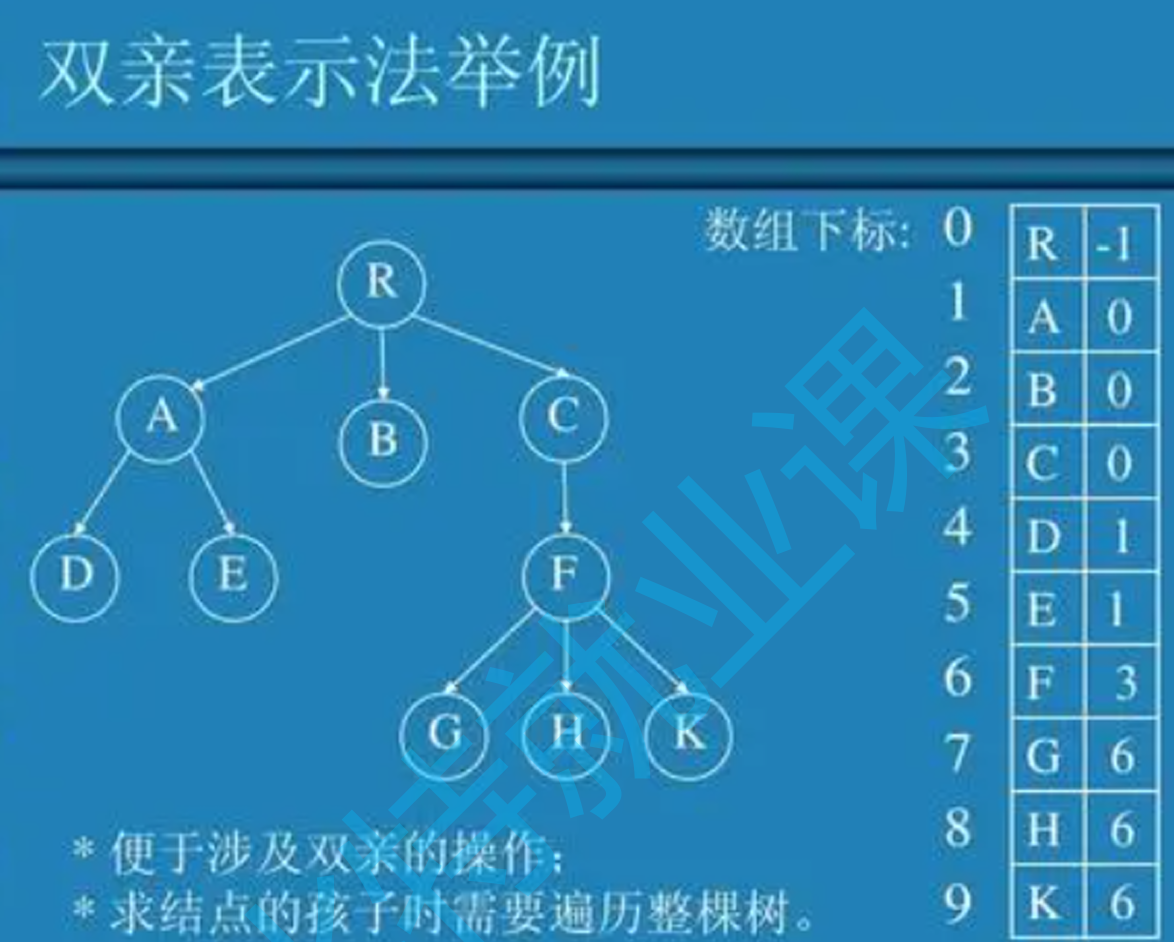
- 这种方法查找节点双亲很便利,通过下标查找即可。
- 查找孩子不容易,需要遍历整个树。
二叉树
1、概念
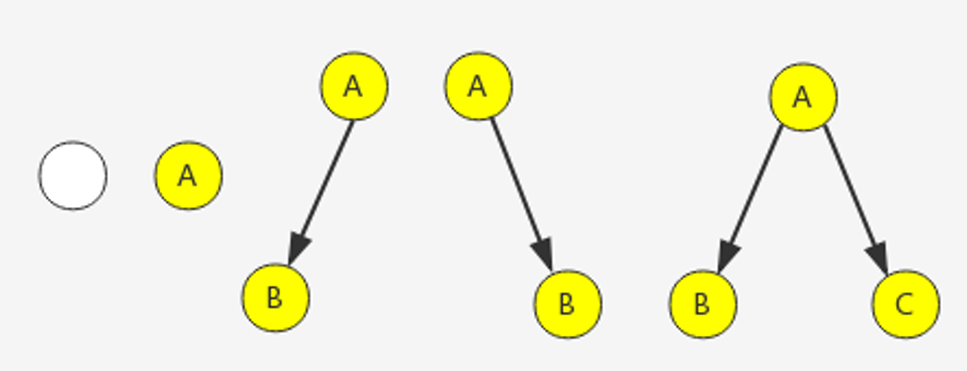
一棵二叉树是结点的一个有限集合,该集合或者为空,或者是由一个根节点加上两棵别称为左子树和右子树的二叉树组成。
树的度最大是2,0<n<=2
- 二叉树的几种形态:空,一个节点,树的度数为1,树的度数为2
二叉树的特点:
- 每个结点最多有两棵子树,即二叉树不存在度大于2的结点。
- 二叉树的子树有左右之分,其子树的次序不能颠倒。
2、特殊的二叉树
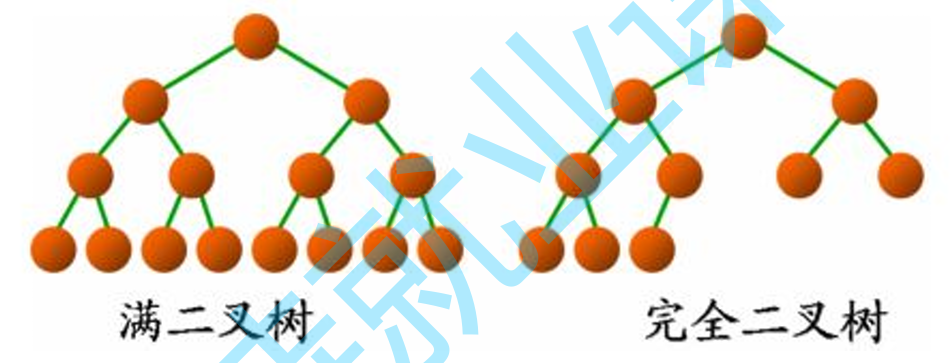
1、满二叉树:一个二叉树,如果每一个层的结点数都达到最大值,则这个二叉树就是满二叉树。也就是说,如果一个二叉树的层数为h,且结点总数是(2^h) -1 ,则它就是满二叉树。(除了叶子节点以外,所有的节点的度数都是2)。
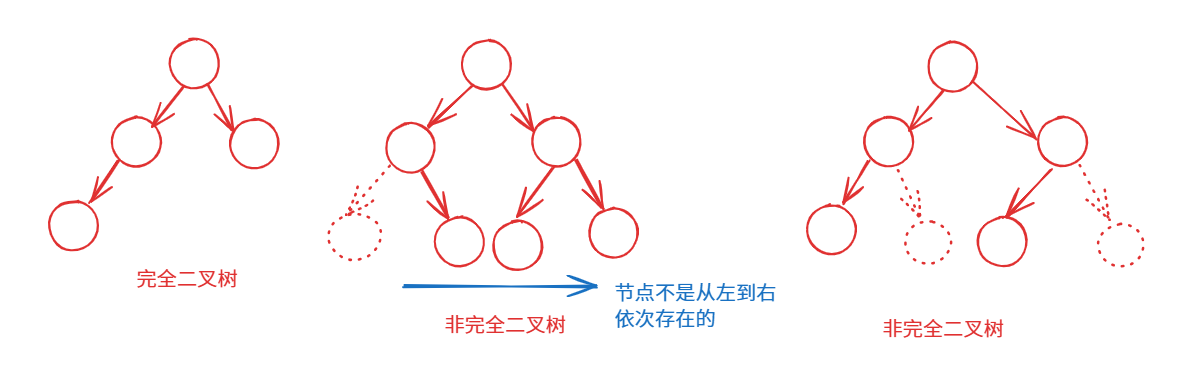
2、完全二叉树:前k-1层是满的,最后一层第k层的节点是连续的,当然也可以是满的。(满二叉树是完全二叉树,完全二叉树不一定是满二叉树)
- 连续的意思是值节点是从左到右依次存在的,不可以跳节点。
3、二叉树的存储结构
二叉树一般可以使用两种结构存储,一种顺序结构,一种链式结构。
顺序结构:
适合于完全二叉树,数组里存放的就是一层一层的节点(中序的顺序存储)。但是非完全二叉树就会造成很多的空间浪费。
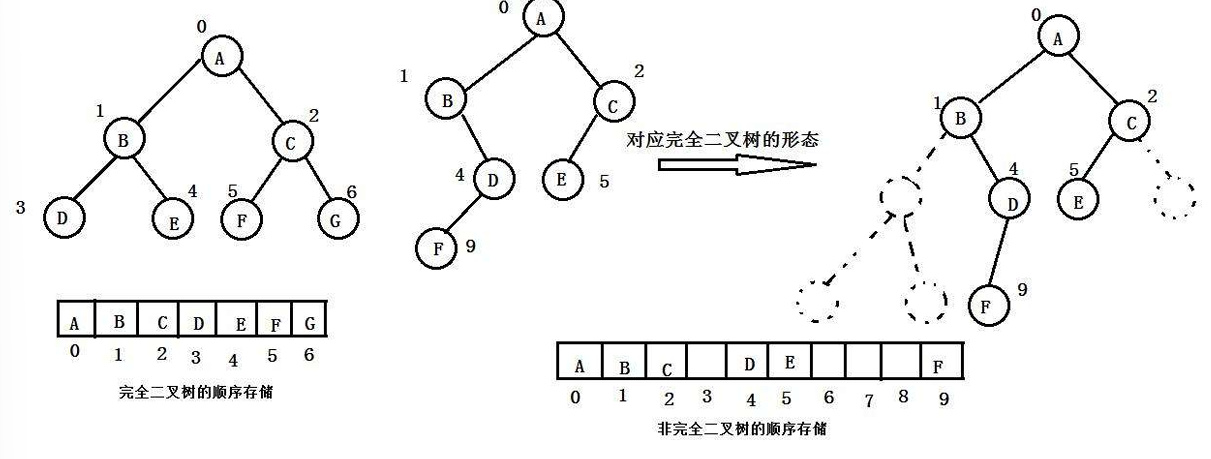
孩子和双亲下标之间的关系:
- 双亲节点的下标是i,左孩子的下标是2*i +1,右孩子的下标就是2*i + 2;
- 孩子节点下标是i,双亲节点下标是(i-1)/2。
链式结构(后面讲)
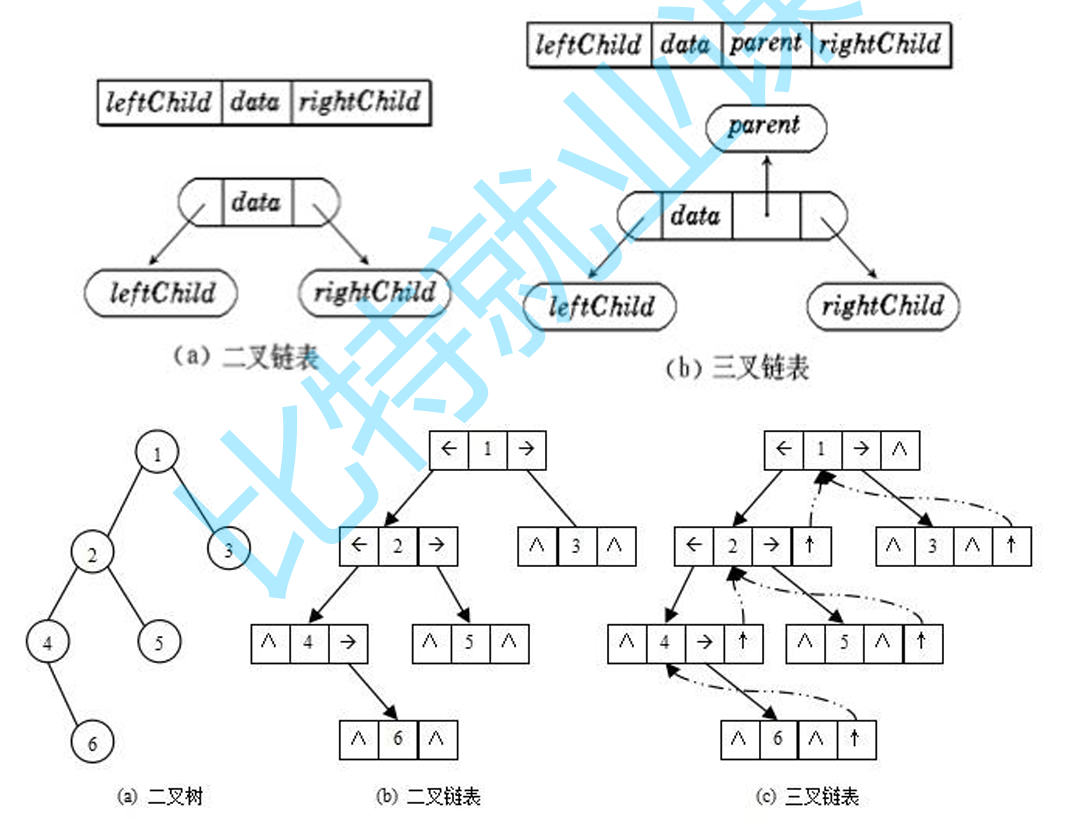
二叉树的链式存储结构是指,用链表来表示一棵二叉树,即用链来指示元素的逻辑关系。
- 通常的方法是链表中每个结点由三个域组成,数据域和左右指针域,左右指针分别用来给出该结点左孩子和右孩子所在的链结点的存储地址,没有孩子的地方使用空指针 。
- 链式结构又分为二叉链和三叉链,当前我们学习中一般都是二叉链,通过父亲找孩子使用指针很方便,通过孩子找父亲不方便
- 后面课程学到高阶数据结构如红黑树等会用到三叉链。这个结构就右一个双亲指针,找双亲就方便了。
// 二叉链
struct BinaryTreeNode
 {
 struct BinaryTreeNode* pLeft;
// 指向当前节点左孩子
struct BinaryTreeNode* pRight; // 指向当前节点右孩子
BTDataType _data; // 当前节点值域
}
 // 三叉链
struct BinaryTreeNode
{
 struct BinaryTreeNode* pParent; // 指向当前节点的双亲
struct BinaryTreeNode* pLeft;
// 指向当前节点左孩子
struct BinaryTreeNode* pRight; // 指向当前节点右孩子
BTDataType _data; // 当前节点值域
};
4、二叉树的性质:
推理过程:
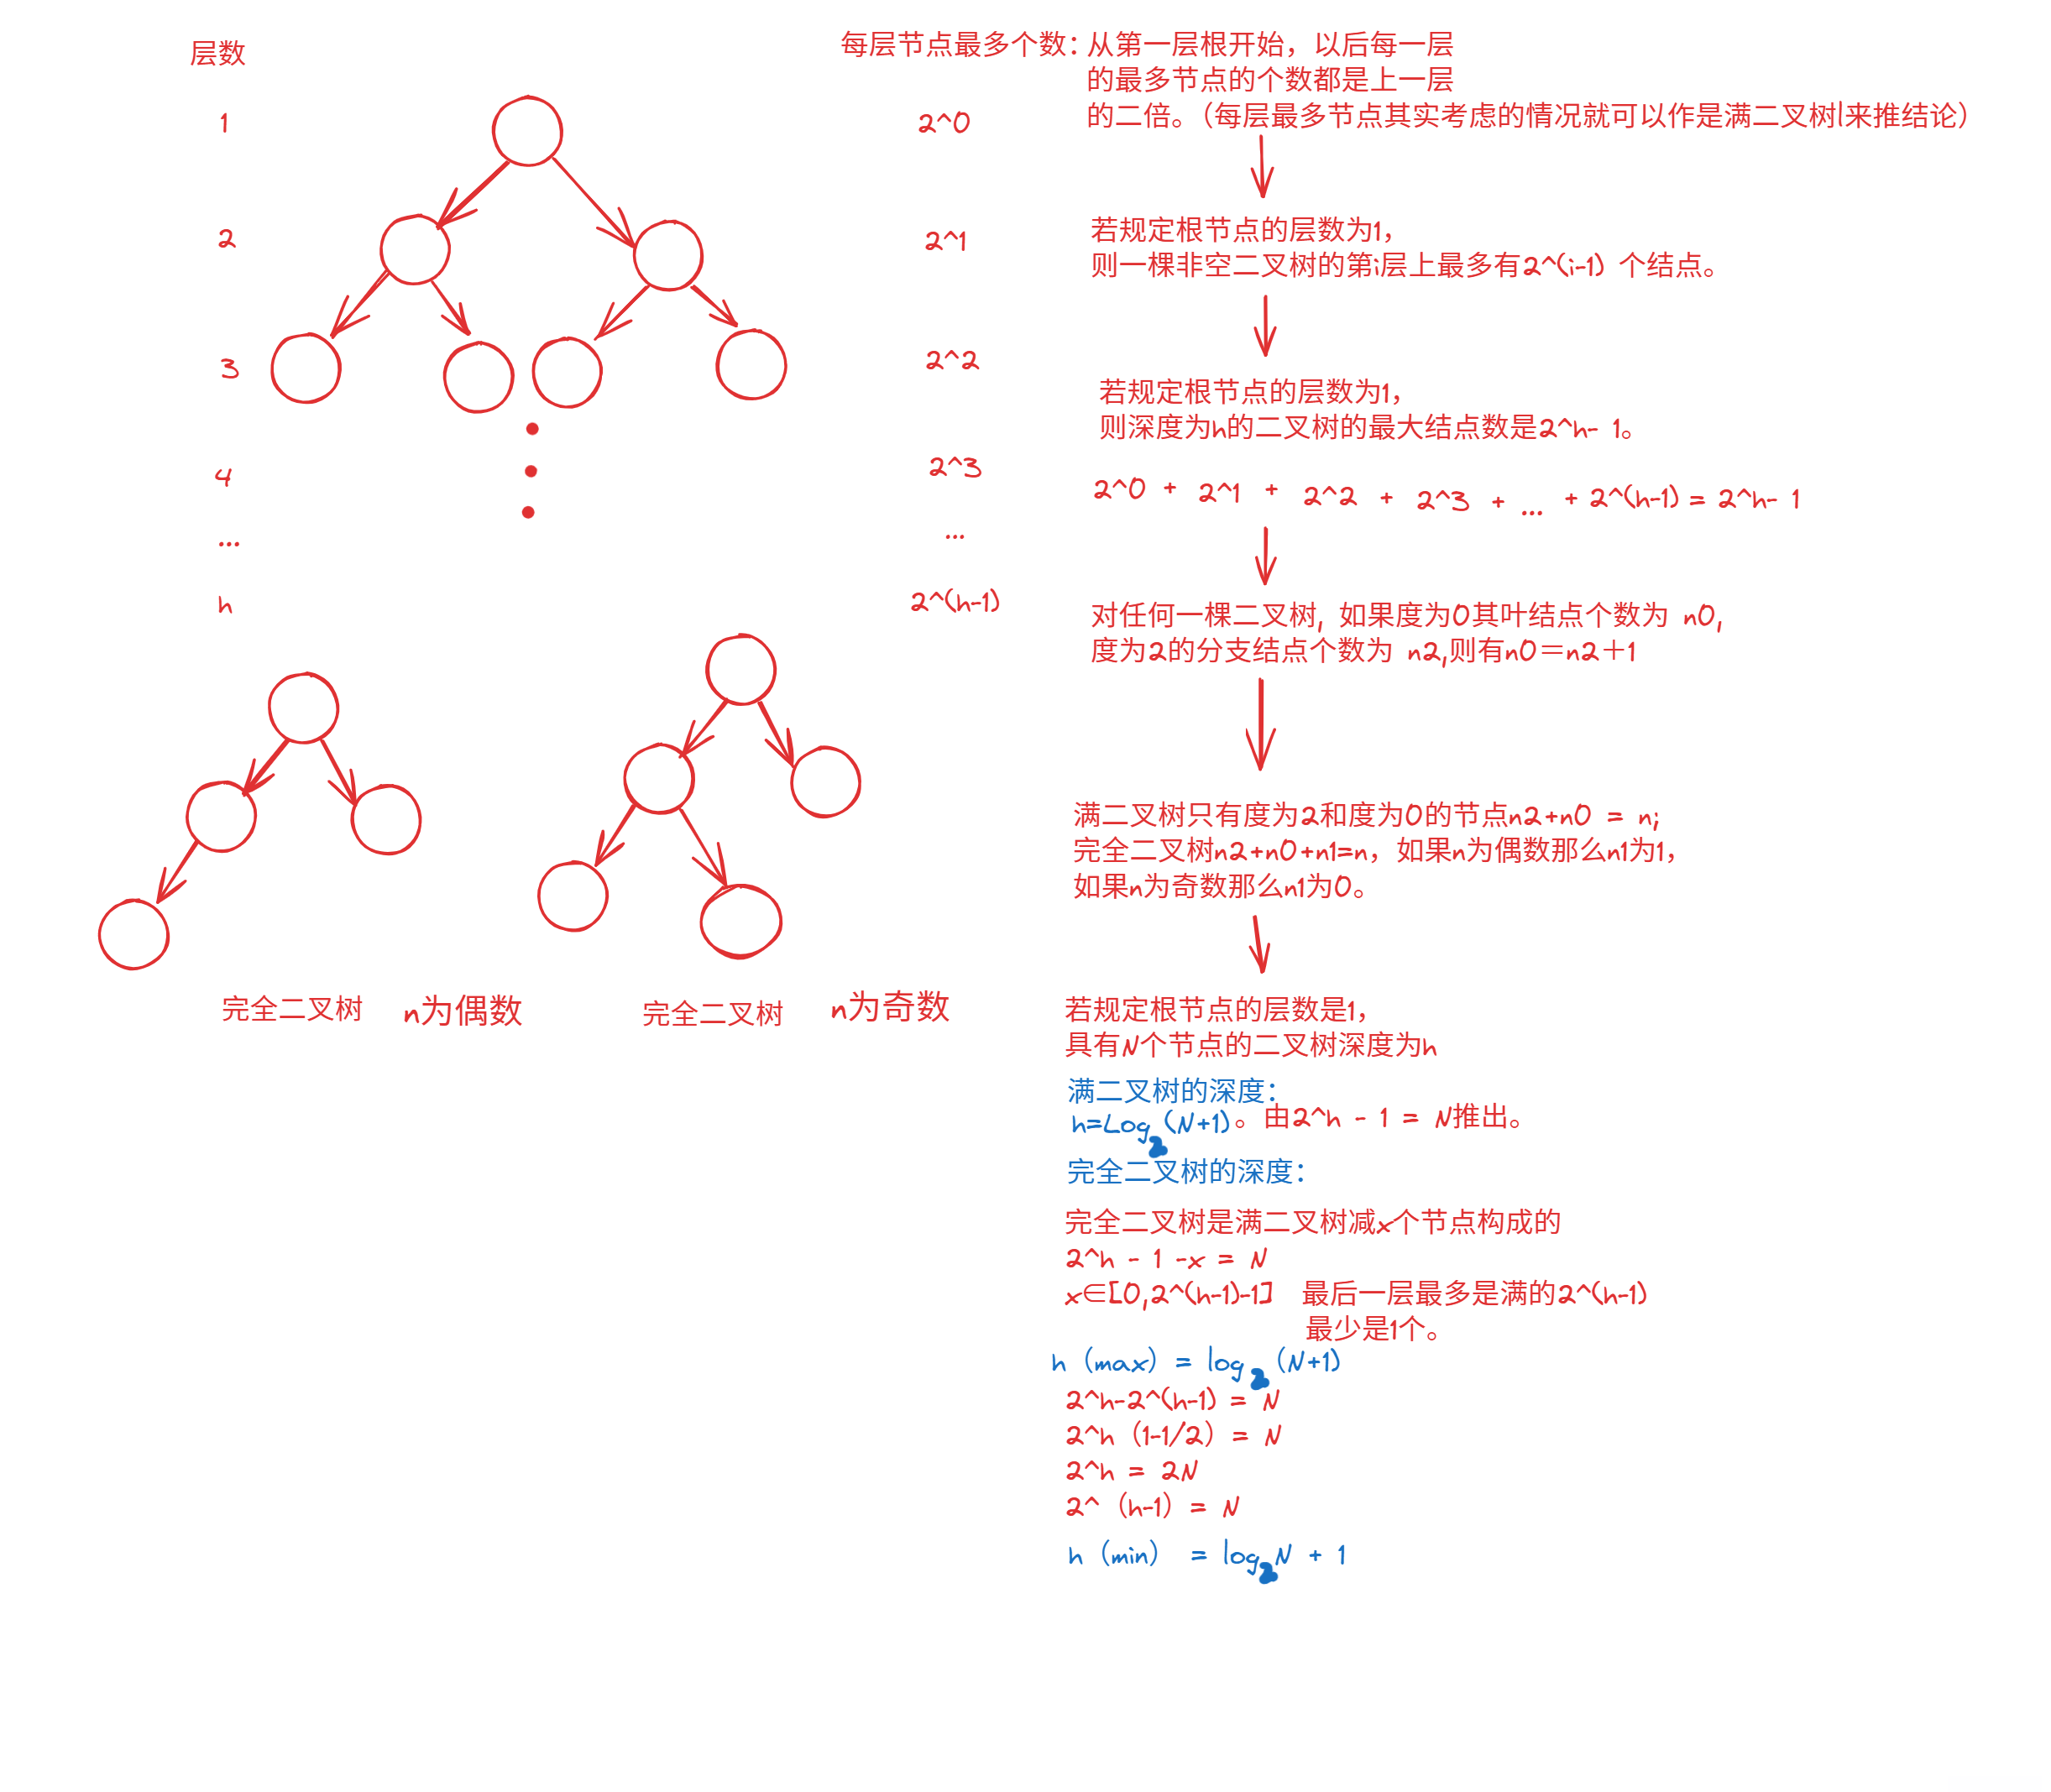
总结:
-
若规定根节点的层数为1,则一棵非空二叉树的第i层上最多有2^(i-1) 个结点。
-
若规定根节点的层数为1,则深度为h的二叉树的最大结点数是=2^h - 1。
-
对任何一棵二叉树, 如果度为0其叶结点个数为 n0, 度为2的分支结点个数为 n2,则有n0=n2+1
-
满二叉树只有度为2和度为0的节点n2+n0 = n;完全二叉树n2+n0+n1=n,如果n为偶数那么n1为1,如果n为奇数那么n1为0。
-
若规定根节点的层数为1,具有N个结点的二叉树,高(深)度为h
满二叉树的深度,h = Log₂(N+1)。
完全二叉树的深度范围,log₂N + 1<=h<=log₂(N+1),若已知有k层,则节点个数范围是2(k-1) 到2k-1个。
5、二叉树和树的利用价值
后面介绍的堆:
借助上面性质来选树,堆是一个完全二叉树,最多走高度次能选出一个树。时间复杂度就是O(logN)。
O(logN)效率很高
可以想二分查找,他的F(n) = O(logN)。在1000个数中找一个数需要找10次,210 = 1024; 在1000000个数中找一个数需要找20次,210 × 210 = 220 ,在10亿个数中查找一个数需要30次,这个效率是很高的。把我们国家所有人存进这样的满二叉树中,找一个人只需要31次。
后面还会讲到搜索二叉树:
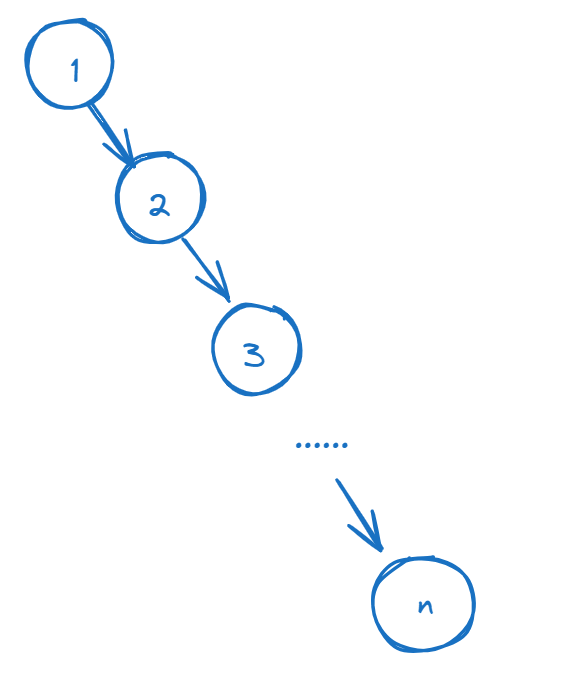
每个树及其子树的左孩子都比它小,右孩子都比它大。那么搜索一个值不需要挨个查找了,最多就是高度次。那么如果是这样的二叉树,搜索效率也很低:
平衡二叉搜索树
最难的数据结构之一,将搜索树旋转而来,对搜索二叉树优化。
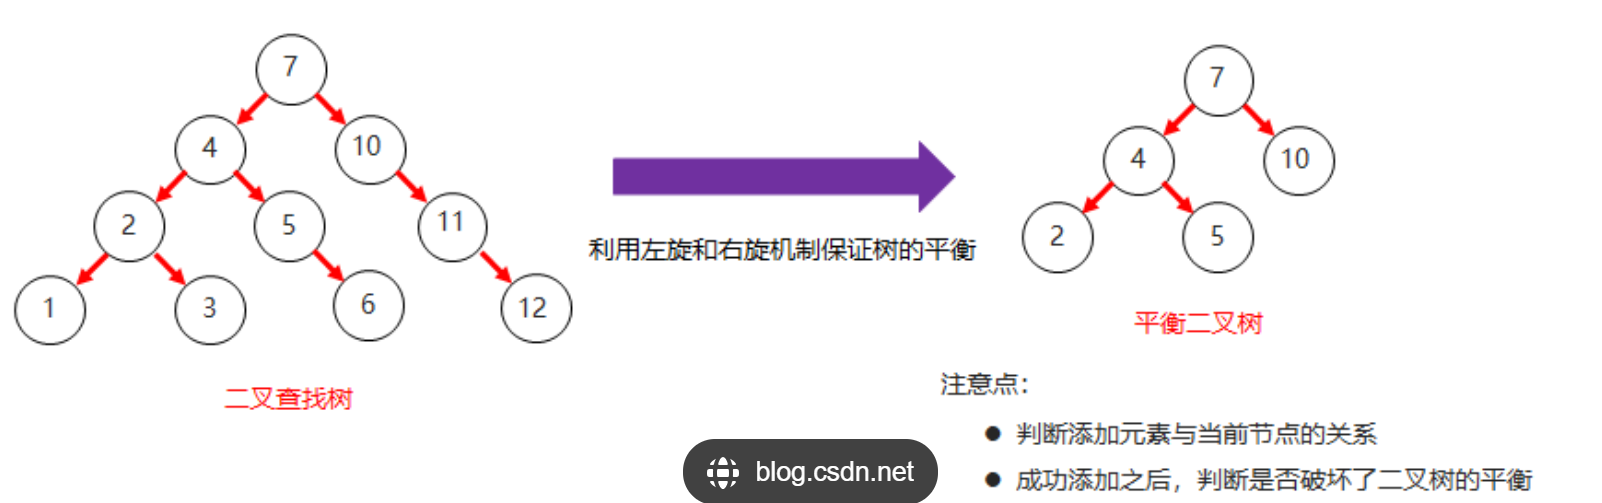
搜索查找最好构建的结构
所以我们最好把一颗树控制成完全二叉树,满二叉树不好构建,节点个数太规范了。完全二叉树的高度是可控的,如果利用上述结构进行查找,时间复杂度都是logN,那么查找一个元素是很方便的。
堆
由于堆就是个完全二叉树,所以使用顺序结构存储更适合。
物理结构:数组形式
逻辑结构:完全二叉树
大堆/大根堆
- 完全二叉树
- 每个父亲都大于等于孩子。
- 根/堆顶:最大值
小堆/小根堆
- 完全二叉树
- 每个父亲都小于等于孩子。
- 根/堆顶:最小值
但是并没有规定孩子节点和孩子节点之间的大小关系,选树:当前根节点是子树中最大或者最小的节点。----堆排序
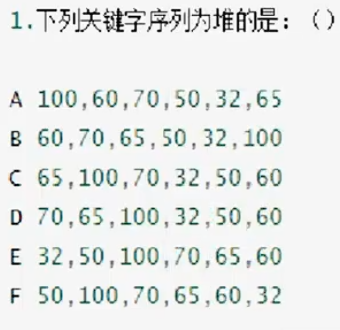
做法:将其分成完全二叉树,判断双亲和孩子的关系,这里举一例,后续大家自己做一做,答案是A
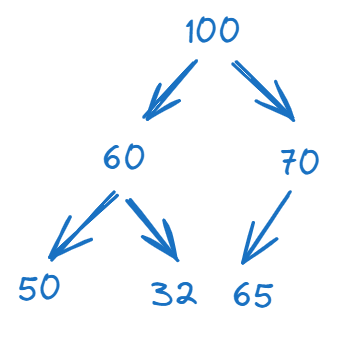
至此先简单理解一下堆,后续在代码中继续讲解
1、创建文件
Heap.c
Heap.h
test.c
2、堆结构定义
typedef int HPDataType;//int可以换成其他类型比如char也适用

typedef struct Heap
{
	HPDataType* _a;//堆空间:_a成员指向HPDataTpye类型数据空间,指向什么类型元素的空间就是使用什么类型指针。
	int size;//元素个数
	int capacity;//容量
}Heap;
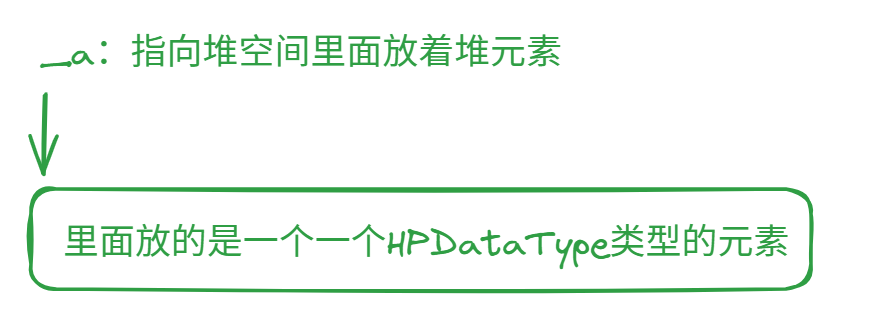
定义之后就需要实现接口了,先把接口列在头文件中:
#pragma once
#include<stdio.h>
#include <memory.h>//后面初始化需要用到这个头文件的memmove
#include<stdlib.h>//后面malloc需要这个头文件
typedef int HPDataType;

typedef struct Heap
{
	HPDataType* _a;//堆空间:_a成员指向HPDataTpye类型数据空间
	int size;//元素个数
	int capacity;//容量
}Heap;

//初始化:习惯上是外面传进来一个数组,我们把数组拷贝到自己的数组空间上来,然后构建堆。
void HeaPInit(Heap* php, HPDataType* a, int n);

//销毁堆
void HeapDestory(Heap* php);

//入堆
void HeapPush(Heap* php);

///出堆
void HeapPop(Heap* php);

//提取堆顶元素
HPDataType HeapTop(Heap* php);
接着讲这些方法赋值到源文件Heap.c中来实现:去掉分号,加上大括号,让我们一起实现方法把~
#define  _CRT_SECURE_NO_WARNINGS 1
#include"Heap.h"

//初始化:习惯上是外面传进来一个数组,我们把数组拷贝到自己的数组空间上来。
void HeaPInit(Heap* php, HPDataType* a, int n);

//销毁堆
void HeapDestory(Heap* php);

//入堆
void HeapPush(Heap* php);

///出堆
void HeapPop(Heap* php);

//提取堆顶元素
HPDataType HeapTop(Heap* php);
3、初始化堆
//初始化:习惯上是外面传进来一个数组,我们把数组拷贝到自己的数组空间上来,然后构建成堆。
void HeaPInit(Heap* php, HPDataType* a, int n)
{
	//n方便我们计算需要开开辟的空间,我们一般将数组传进函数的时候都会传地址和元素的个数
	//首先给自己的堆开和传进来的数组一样大小的空间
	HPDataType* tmp = (HPDataType*)malloc(sizeof(HPDataType) * n);
	if (tmp == NULL)
	{
		perror("HeapInit::malloc");
		exit(-1);
	}
	php->_a = tmp;
	//进行内存拷贝,将传进数组中的值拷贝到自己的数组上
	//关于为什么不用memcpy请看https://blog.csdn.net/2401_87219716/article/details/148843882?spm=1001.2014.3001.5502
	memmove(php->_a, a, n * sizeof(HPDataType));
	php->size = n;
	php->capacity = n;
	//想一想之后应该干什么?
}
这里初始化后的空间确实是满了,满了可以增容的,堆和我们之前实现的数据结构不太一样,它是一堆一堆元素插进的,比如大众点评,某个区的外卖排名找出TOP10前十的外卖,这里就需要实现topK问题可以找到,对应的就是新开了几家外买,我们就需要将这几家的评分添加到数组中,而且不需要频繁增容,因为扩容一次就扩了2倍,空间还是会很大的。
结论性语言可以先看完构建大堆和小堆之后再来看
需要将数组中的值调整成大堆或者小堆
实现小堆:向下调整法,将小元素向上扶,最多调整每个子树的高度次,每次每个子树都沿着一条线把小元素向上扶。
实现大堆:向下调整法,将大元素向上扶,最多调整该子树的高度次,每次每个子树都沿着一条线把大元素向上扶。
向下调整法
向下调整法:小根堆使用条件为根的左子树和右子树均为小根堆。根节点这棵树不确定,如果是大根堆就把这里所有的小换成大,小于换成大于。
做法:
- 将双亲和左右孩子中较小的孩子比较,如果孩子值小于双亲,将他们的值交换。
- 然后继续将孩子的下标赋值给双亲,然后计算新的较小孩子的下标值,继续比较。
- 直到较小孩子下标越界了停止。
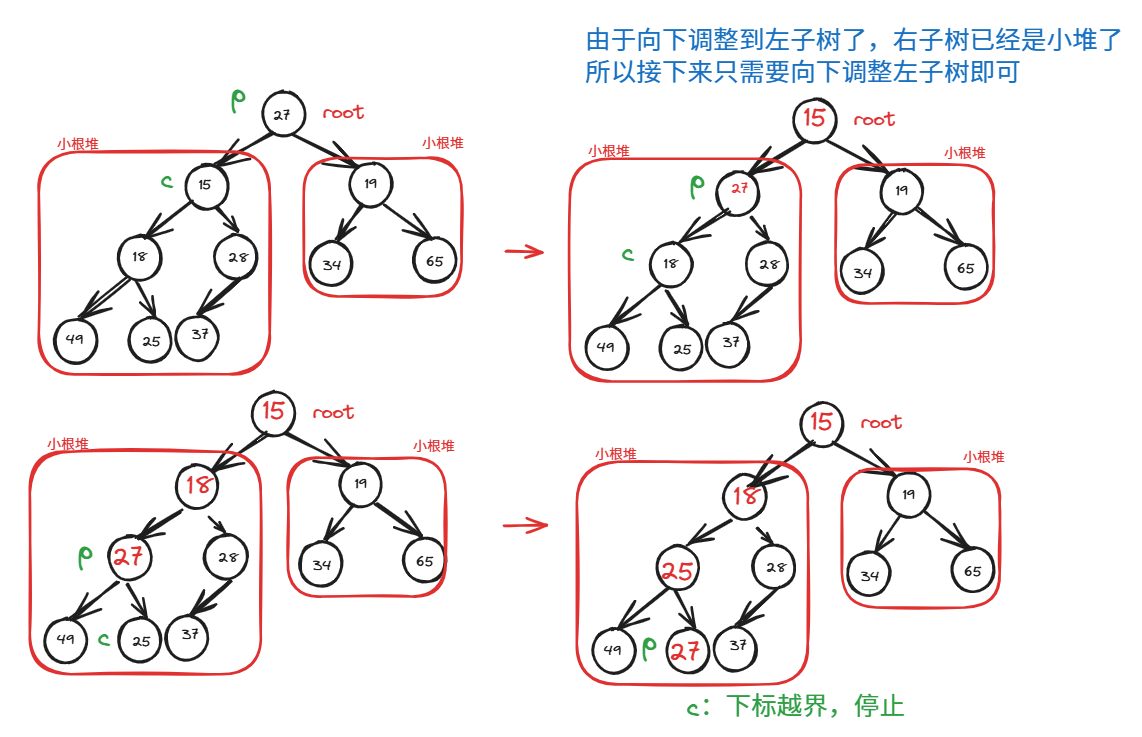
放到数组中的向下调整法
大根堆就将小于全部换成大于,大于换成小于即可。
双亲下标:i
左孩子下标:2*i+1
右孩子下标:2*i+2
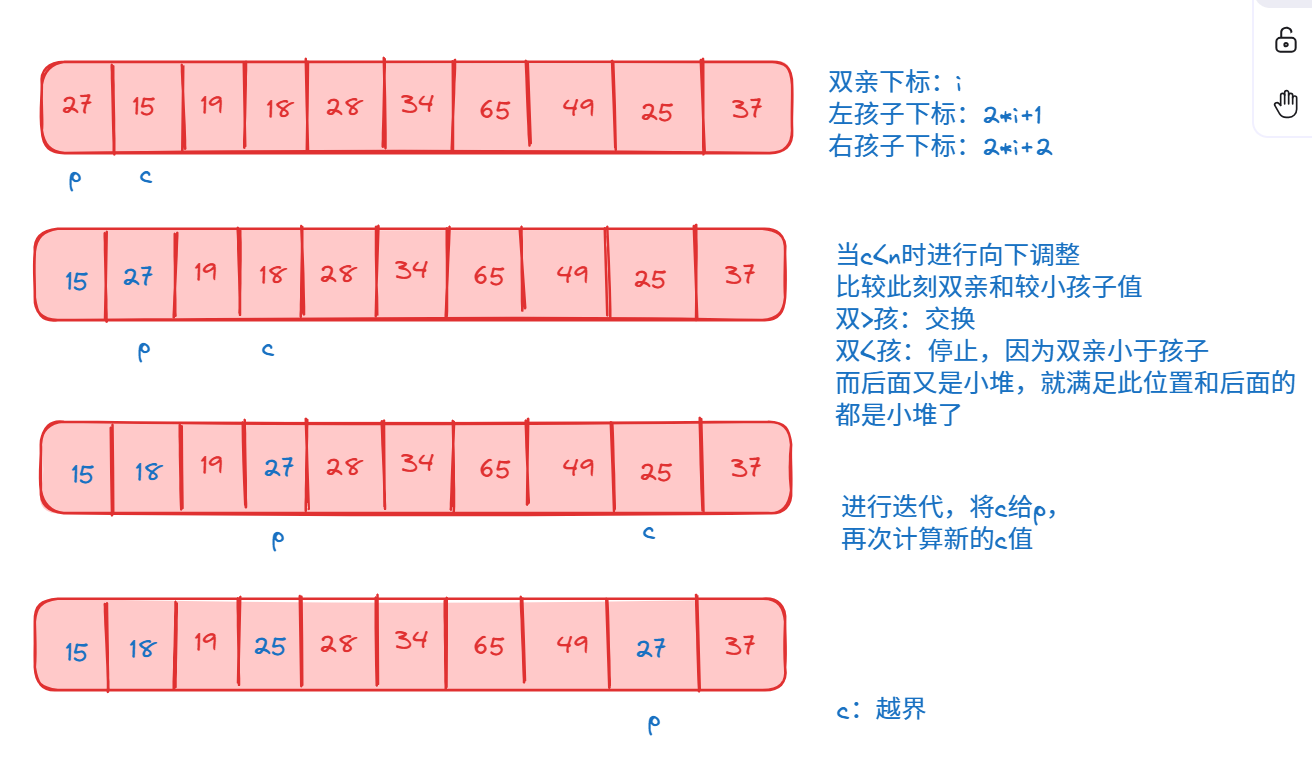
可以写出代码:
由于后面经常使用到交换,将它写成一个函数
//交换
void Swap(HPDataType* p1, HPDataType* p2)
{
	HPDataType tmp = *p1;
	*p1 = *p2;
	*p2 = tmp;
}
//小根堆向下调整法
void AdjustDownSmall(HPDataType* a, int n, int root)
{
	//n方便我们判断孩子的下标是否越界,越界就停止调整。
	// root是告知需要从哪个子树开始调整的。
	int parent = root;
	int child = parent * 2 + 1;//默认左孩子是较小的孩子
	while (child < n)//较小孩子下标不越界
	{
		if (a[child + 1] < a[child])//如果右孩子比较小就让child是右孩子
			child++;
		if (a[child] < a[parent])//双亲大于孩子,交换
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else//以下都是小根堆,此时如果双亲还小于孩子,就满足是小堆了,不用继续向下调整了
		{
			break;
		}
	}
}
代码还存在一定的问题:
如果p和c是这样的关系:
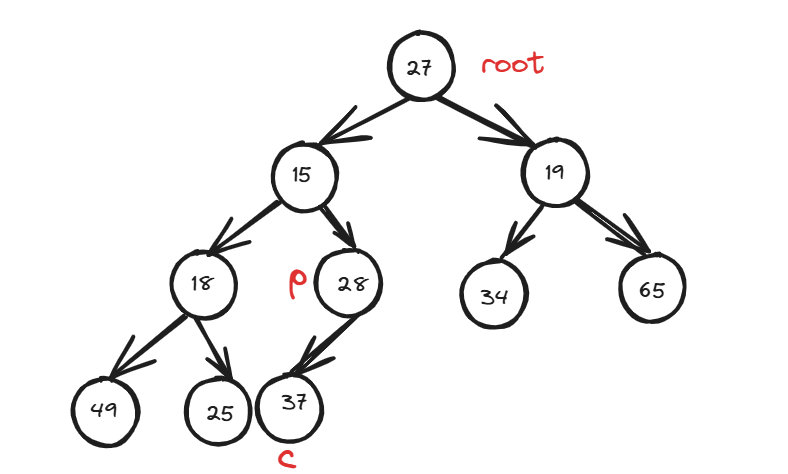
这里child并不越界,但是child+1越界了,执行if (php->_a[child + 1] < php->_a[child])这句代码就会越界,需要加上判断条件child+1 < n,此时就不需要比较左右孩子。
//小根堆向下调整法
void AdjustDownSmall(HPDataType* a, int n, int root)
{
	//n方便我们判断孩子的下标是否越界,越界就停止调整。
	// root是告知需要从哪个子树开始调整的。
	int parent = root;
	int child = parent * 2 + 1;//默认左孩子是较小的孩子
	while (child < n)//较小孩子下标不越界
	{
		if (child + 1 < n && a[child + 1] < a[child])//如果右孩子比较小就让child是右孩子
			child++;
		if (a[child] < a[parent])//双亲大于孩子,交换
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else//以下都是小根堆,此时如果双亲还小于孩子,就满足是小堆了,不用继续向下调整了
		{
			break;
		}
	}
}
如果是大根堆,代码只需要改符号即可:
void AdjustDownBig(HPDataType* a, int n, int root)
{
	//n方便我们判断孩子的下标是否越界,越界就停止调整。
	// root是告知需要从哪个子树开始调整的。
	int parent = root;
	int child = parent * 2 + 1;//默认左孩子是较大的孩子
	while (child < n)//较大孩子下标不越界
	{
		if (child + 1 < n && a[child + 1] > a[child])//如果右孩子比较大就让child是右孩子
			child++;
		if (a[child] > a[parent])//双亲小于孩子,交换
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else//以下都是大根堆,此时如果双亲还大于孩子,就满足是大堆了,不用继续向下调整了
		{
			break;
		}
	}
}
使用向下调整法构建堆
同上:以小根堆为例讲解,大根堆只需要小于变大于,大于变小于。
给一个完全二叉树,使用向下调整法构建小根堆
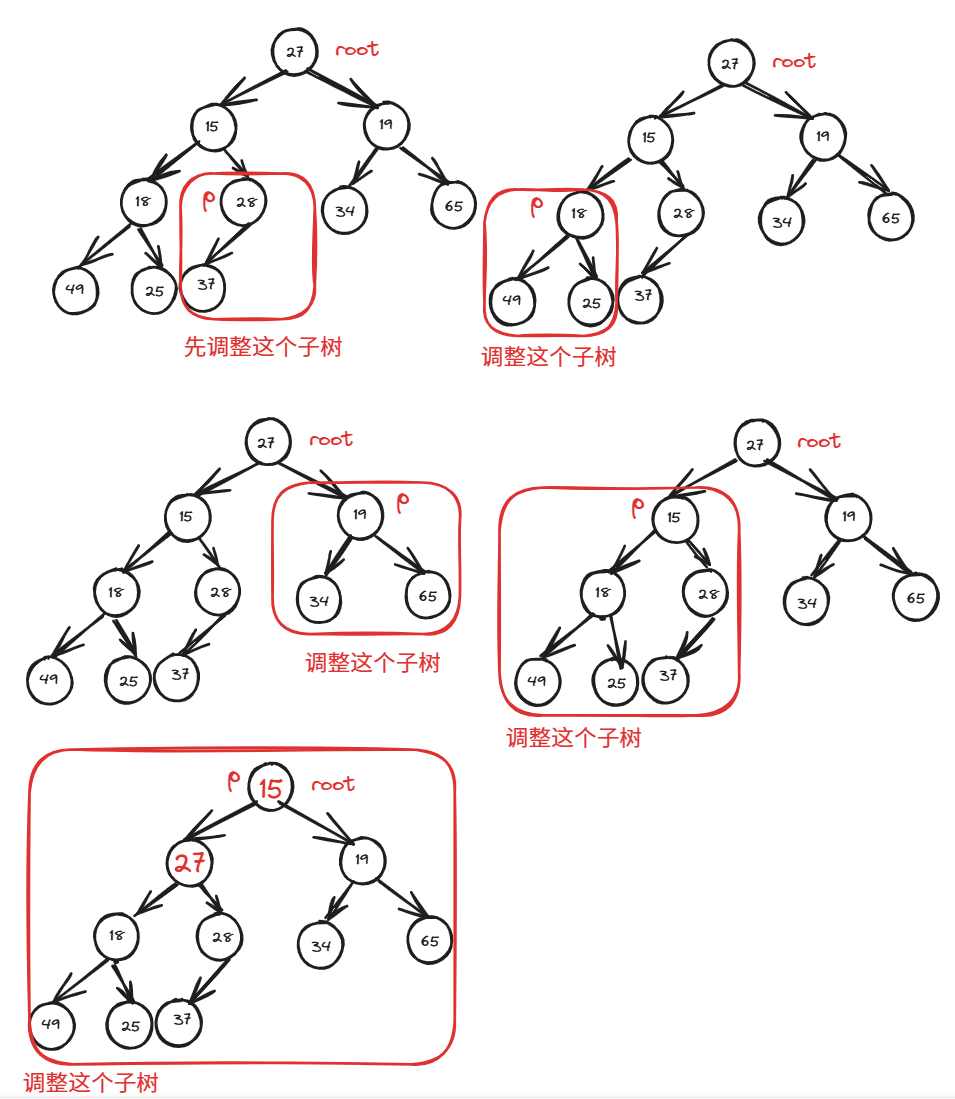
虽然不能保证整棵树的根左右子树都是小根堆,但是可以确定的是叶子结点可以被认为是大根堆或者小根堆都可以,因为它们没有孩子所以将它们看作根的话,孩子可以比他大也可以比他小,但是他们本身不需要调整。叶子节点全部不用调整,只需要从第一个不是叶子结点的开始就可以,它也是最底层第一颗子树。
方法:从最后一个叶子结点的双亲节点(下标是:(n-1-1)/2,其中n-1是最后一个节点下标也是孩子,它的双亲-1除2即可得到)开始调整,每次下标减1的调整此刻的子树,直到调整到树的根节点,这样每次调整子树的时候都能满足向下调整法的条件,根的左右子树都是小跟堆(之前都调整过),根不确定。
完整代码
//初始化:习惯上是外面传进来一个数组,我们把数组拷贝到自己的数组空间上来。
//初始化成小根堆
void HeaPInitSmall(Heap* php, HPDataType* a, int n)
{
	//n方便我们计算需要开开辟的空间,我们一般将数组传进函数的时候都会传地址和元素的个数
	//首先给自己的堆开和传进来的数组一样大小的空间
	HPDataType* tmp = (HPDataType*)malloc(sizeof(HPDataType) * n);
	if (tmp == NULL)
	{
		perror("HeapInit::malloc");
		exit(-1);
	}
	php->_a = tmp;
	//进行内存拷贝,将传进数组中的值拷贝到自己的数组上
	//关于为什么不用memcpy请看https://blog.csdn.net/2401_87219716/article/details/148843882?spm=1001.2014.3001.5502
	memmove(php->_a, a, n * sizeof(HPDataType));
	php->size = n;
	php->capacity = n;
	//构建小根堆:从最后一个叶节点的双亲节点开始调整子树,直到根节点
	for (int i = (n-1-1)/2; i >= 0 ; i--)
	{
		AdjustDownSmall(php->_a,php->size,i);//这里我刚开始不怎么明白为什么是php->size
	}
}
//初始化成大根堆
void HeaPInitBig(Heap* php, HPDataType* a, int n)
{
	//n方便我们计算需要开开辟的空间,我们一般将数组传进函数的时候都会传地址和元素的个数
	//首先给自己的堆开和传进来的数组一样大小的空间
	HPDataType* tmp = (HPDataType*)malloc(sizeof(HPDataType) * n);
	if (tmp == NULL)
	{
		perror("HeapInit::malloc");
		exit(-1);
	}
	php->_a = tmp;
	//进行内存拷贝,将传进数组中的值拷贝到自己的数组上
	//关于为什么不用memcpy请看https://blog.csdn.net/2401_87219716/article/details/148843882?spm=1001.2014.3001.5502
	memmove(php->_a, a, n * sizeof(HPDataType));
	php->size = n;
	php->capacity = n;
	//构建大根堆:从最后一个叶节点的双亲节点开始调整子树,直到根节点
	for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDownBig(php->_a, php->size, i);//这里我刚开始不怎么明白为什么是php->size
	}
}
我刚开始不怎么明白为什么是php->size
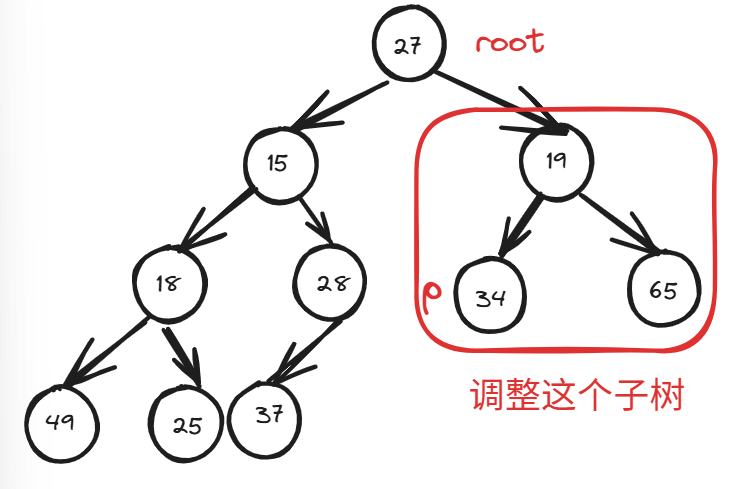
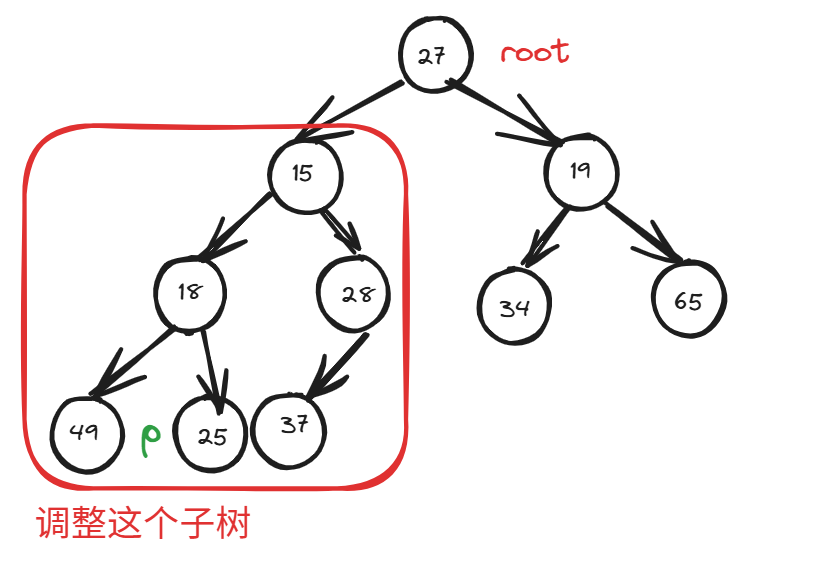
我们可以将这个值带进去,发现一直是10,而每个子树最坏的情况(最多次调整)最后会调整到叶子节点截止,此时双亲就是这个叶子节点,而每个叶子结点的孩子下标一定是超出数组的范围的。所以拿数组下标做越界条件是最合适的,可以有效判停。
如果p走到叶子节点了,比如下面的这两个子树,可以计算一下他们的孩子下标,发现都超出数组下标范围。
4、测试一下初始化
test.c:
#define  _CRT_SECURE_NO_WARNINGS 1
#include"Heap.h"

int main()
{
	HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
	int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
	Heap hp;
	HeaPInitSmall(&hp, a, sz);//小根堆初始化
	Heap* php = &hp;
	for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	printf("\n");
	HeaPInitBig(&hp, a, sz);//大根堆初始化
	for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	return 0;
}
打印的结果和我们逻辑上推导的一样哦~:
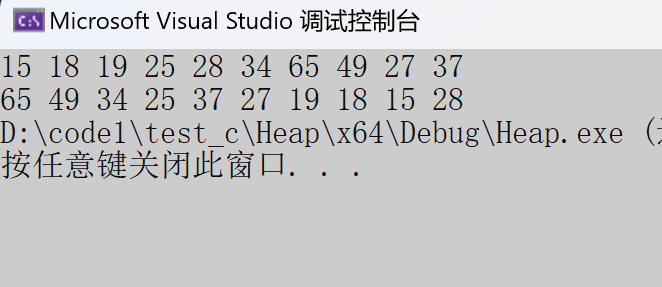
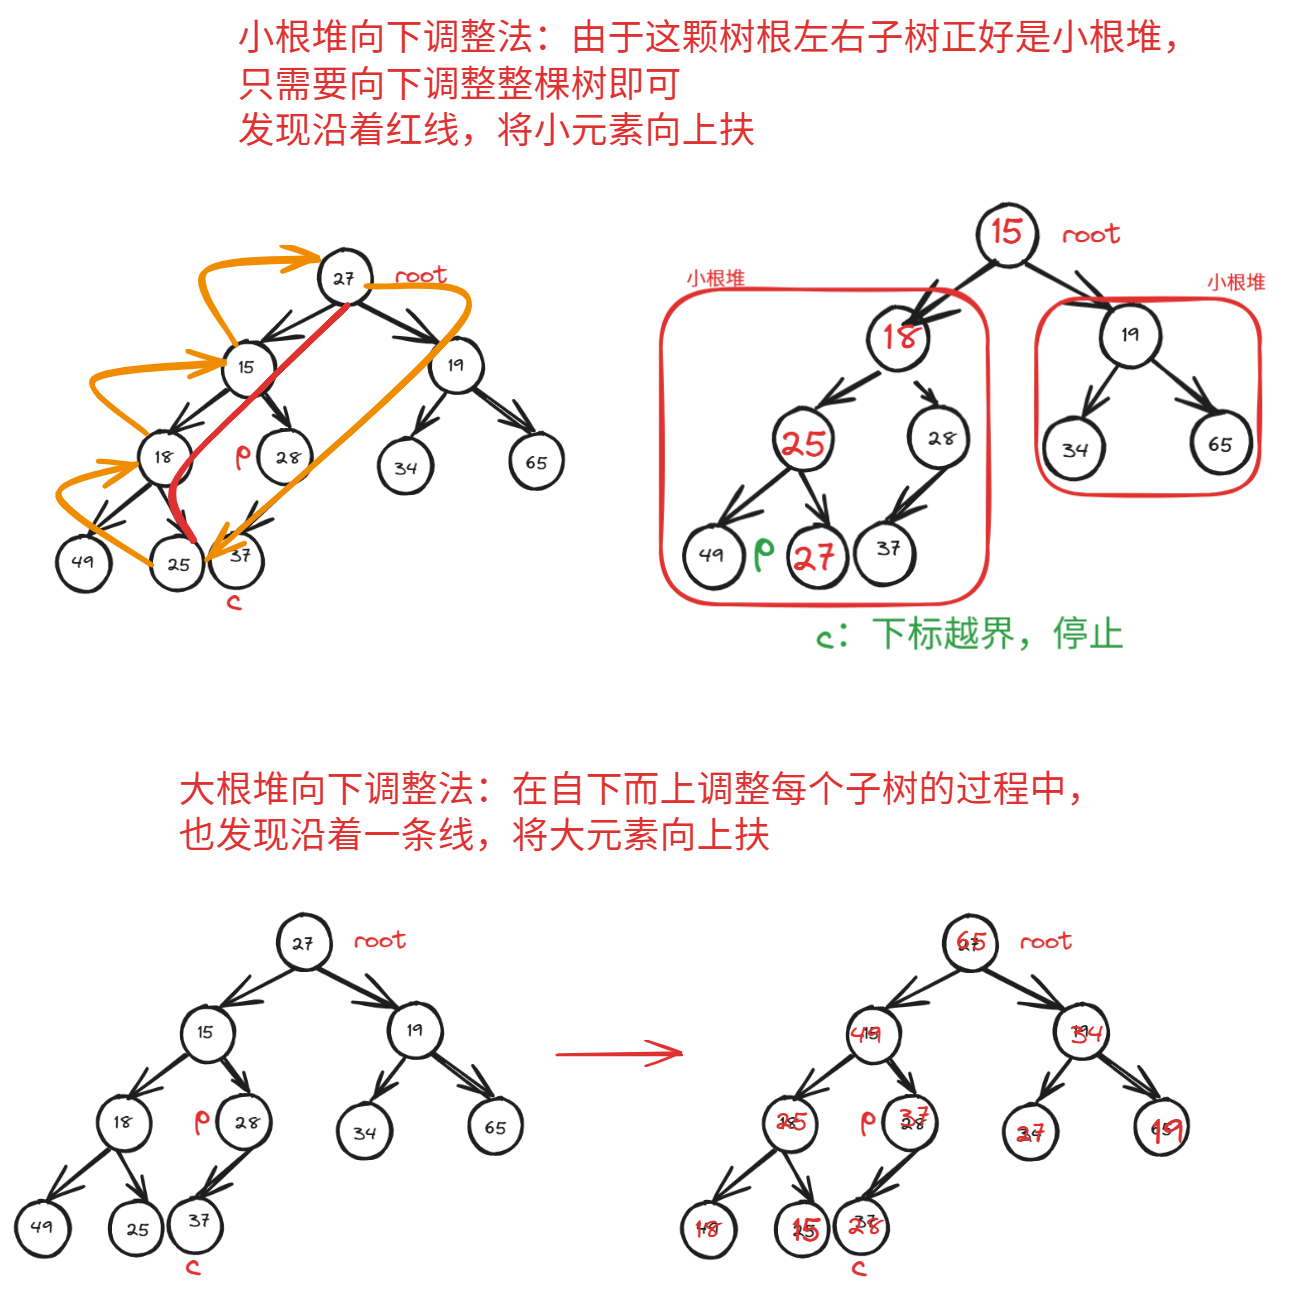
现在你可以看那个结论性语言啦~:
实现小堆:向下调整法,将小元素向上扶,最多调整每个子树的高度次,每次每个子树都沿着一条线把小元素向上扶。
实现大堆:向下调整法,将大元素向上扶,最多调整该子树的高度次,每次每个子树都沿着一条线把大元素向上扶。
5、建堆的时间复杂度—O(N)
建议大家经常默写这个算法代码,有助于加深理解。
建堆的代码:
for(int i = (n-1-1)/2;i >= 0;i--)//(n-2)/2次  时间复杂度O(n)
{
	AdjustDownSmall(a,n,i);//a是数组,n是数组元素个数,i是调整的根。
	//AdjustDownBig(a,n,i);//时间复杂度是多少?
}
向下调整代码:时间复杂度为O(logN)–>最坏的情况调整高度次为以2为底N+1的对数。
void AdjustDownSmall(HPDataType* a,int n,int root)
{
	int parent = root;
	int child = parent * 2 + 1;
	while(child < n)
	{
		if(child+1<n && a[child+1]<a[child])
			child++;
		if(a[parent]>a[child])
		{
			Swap(&a[parent],&a[child]);
		}
		else
		{
			break;
		}
	}
}

void AdjustDownBig(HPDataType* a,int n,int root)
{
	int parent = root;
	int child = parent * 2 + 1;
	while(child < n)
	{
		if(child+1<n && a[child+1]>a[child])
			child++;
		if(a[parent]<a[child])
		{
			Swap(&a[parent],&a[child]);
		}
		else
		{
			break;
		}
	}
}
建堆的时间复杂度是O(N*logN)吗?
其实不是,原因是:
AdjustDownSmall(a,n,i);
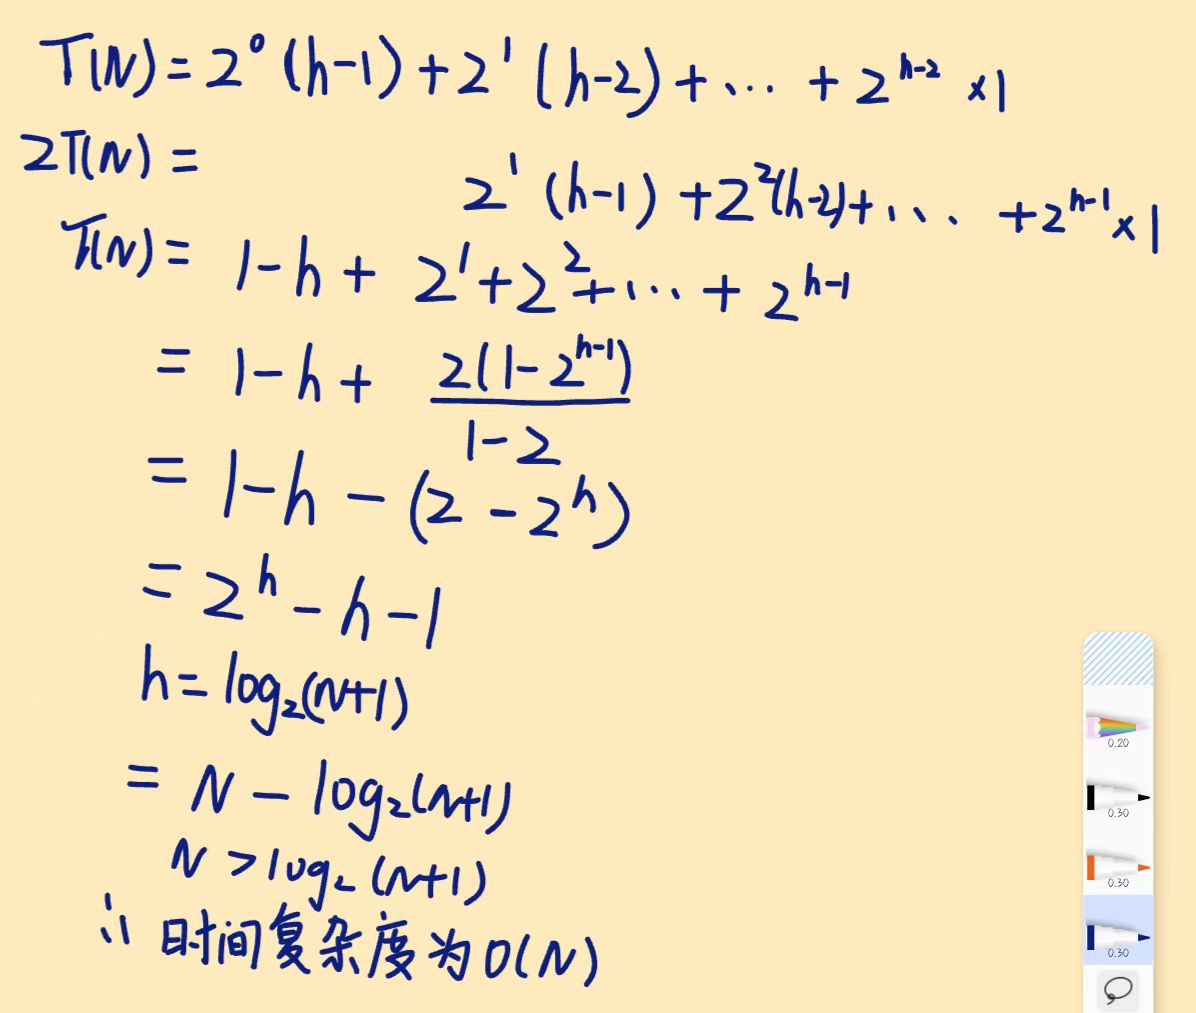
这句代码并不是每次都执行整棵树的高度次,所以时间复杂度不是O(logN),因为i是调整子树的根,i从最底下的那颗树开始调整的,其实最终调整次数是除了最后一层节点的其他层节点作为根的子树的高度次之和。由于每一层节点的高度是一样的,可以列出每一层节点数乘当前调整次数之和。
那么我们可以列出这样的式子:(满二叉树比较好算,我们以此为例,因为它每一层的节点数都是固定的)
第一层最多有20个节点最多调整了h-1次,想象元素交换的场景,高度为h,最多交换h-1次…依次类推…
T(N) = 20 *(h-1)+21 *(h-2)+…+2(h-2) * 1
这是一个等差乘等比,需要用到错位相减法。
运算过程是:
故时间复杂度为O(N)
6、堆排序
很多同学有个误区,建小堆的话,最小的元素已经选出来了,那接着选次小的不就好了?
-
将剩余元素接着建堆,每次建堆都选出一个最小的,建堆为O(N),一共有N个元素,总时间复杂度为O(N*N)。与冒泡排序相当。
-
直接遍历选择最小值的复杂度也是O(N*N),(定义minimum变量,遍历数组更新最小值,每次选出一个当前最小值)没运用上堆的优势。
-
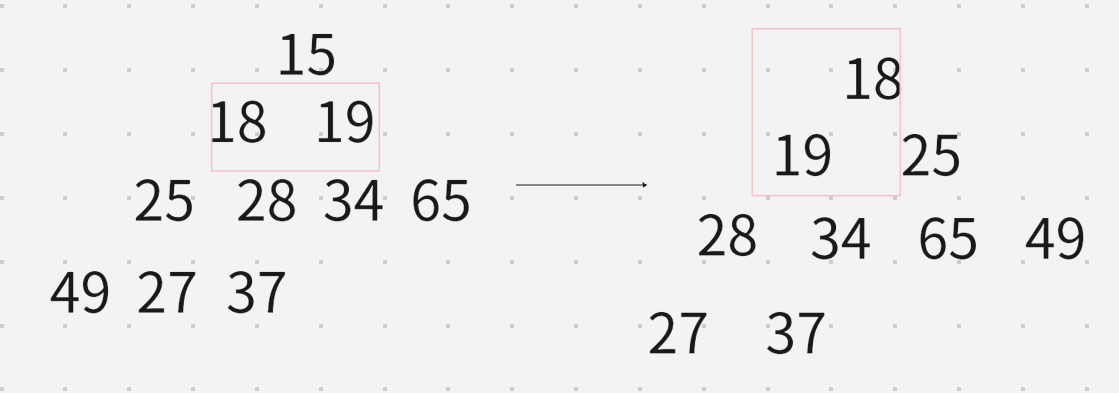
每次选出最小值后,移动数组覆盖这个最小值----会破坏堆的元素关系,父子变兄弟,兄弟变父子了。又要重新构建堆,再找出最小值,很麻烦。
-
这里有没有同学和我一样刚开始以为,从原堆的下一层选一个不就是最小的,其实不是的。
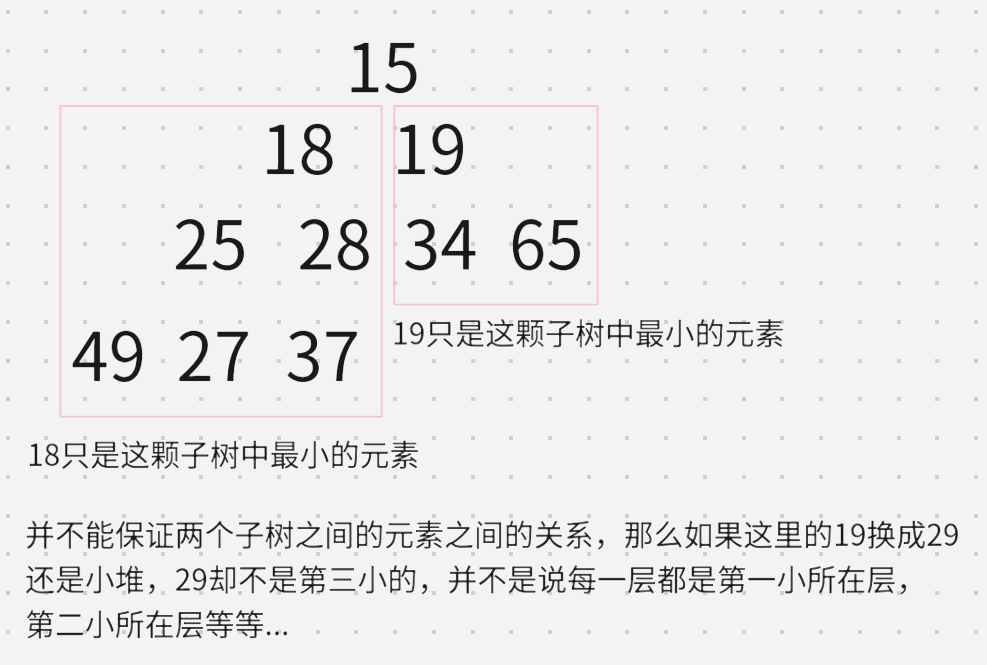
- 小堆只保证父子关系,不保证兄弟节点间的顺序关系
正确使用方式:升序:建大堆,降序:建小堆
- 选择正确方法:升序:建大堆,降序:建小堆
- 每次将堆顶元素与末尾元素交换
- 对前n-1个元素进行向下调整
- 重复上述步骤直到排序完成
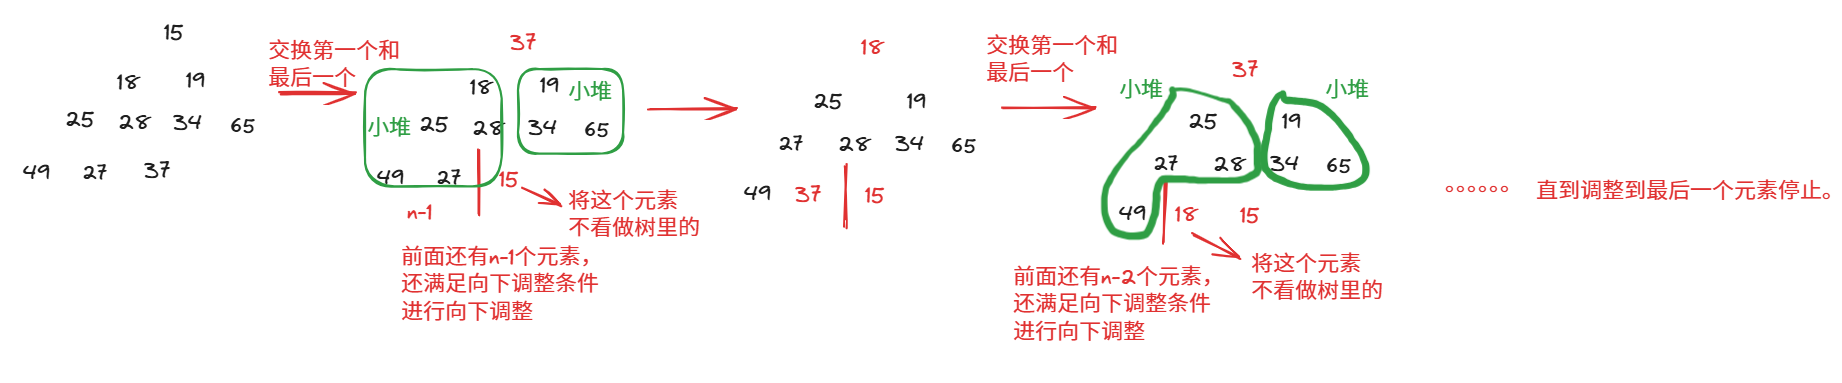
- 其实相当于选择排序,每一次都选择当前最小的放在最后,只不过借助了堆的性质来选出最小。
放在堆中真正实现是这样的:
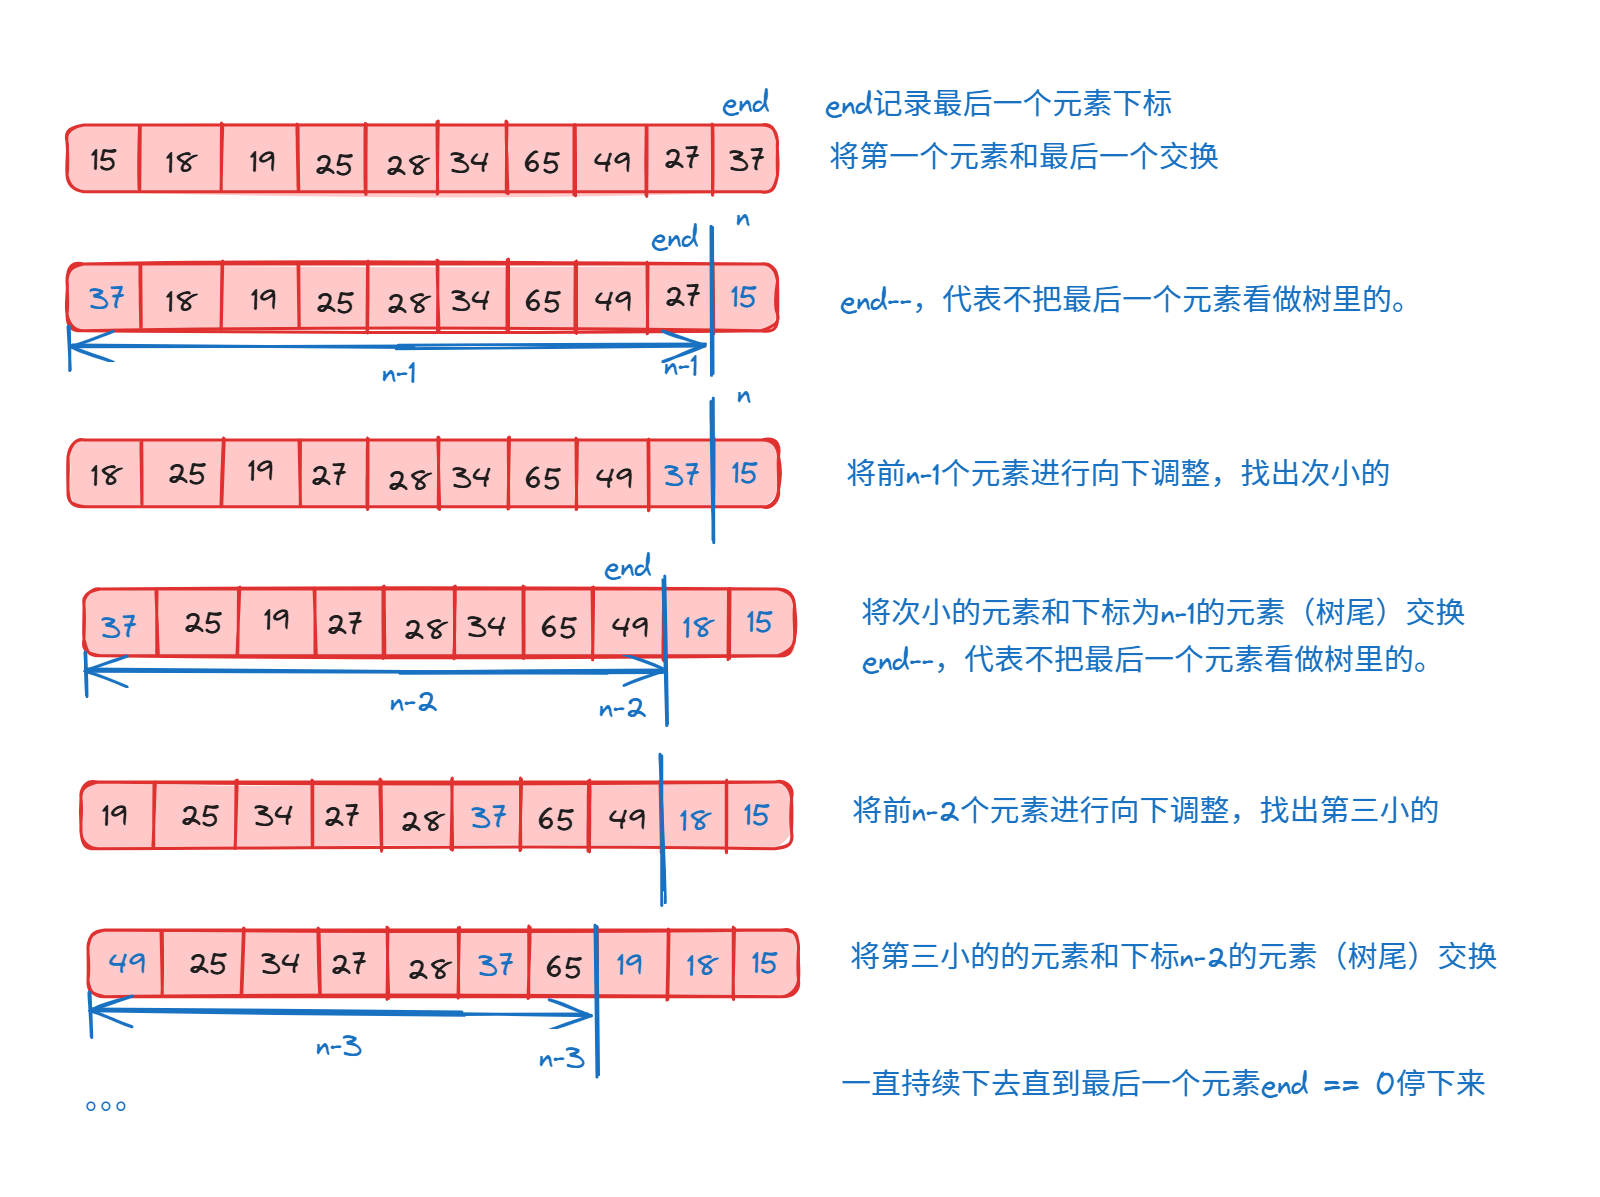
堆排序时间复杂度解析----O(N*logN)
建堆:O(N)
向下调整为O(logN)
交换:O(N)
一共需要进行n/2次交换,建堆需要建n-1次,向下调整需要进行n-1次
所以时间复杂度:(n-1)* N + (n-1)*logN+n/2
那么最终时间复杂度为O(N*logN)。
其实这个复杂度已经是最快的排序算法之一了,对比一下O(N*N)和O(N*logN)
当N=1000时,O(N*N)需要100万次操作,O(N*logN)需要1万次
当N=100万时,O(N*N)需要1万亿次操作操作,O(N*logN)需要2000万次。
…会发现N越大性能差距越明显。
堆排序代码
//堆排序---升序大根堆
void HeapSortBig(HPDataType* a, int n)
{
	//首先先建大根堆
	for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDownBig(a, n, i);
	}
	//排升序
	int end = n - 1;//记录当前数组中最后一个元素,是变化的用变量存储
	while (end > 0)//end==0走到最后一个元素了
	{
		//将第一个元素和end下标元素交换
		Swap(&a[0], &a[end]);
		//去掉当前找到的最大元素
		end--;
		//进行向下调整
		AdjustDownBig(a, end, 0);//每次都将end个元素从根开始进行向下调整找到最小的元素。
	}
}

//堆排序---降序小根堆
void HeapSortSmall(HPDataType* a, int n)
{
	//首先先建小根堆
	for (int i = (n - 1 - 1) / 2; i >= 0; i--)
	{
		AdjustDownSmall(a, n, i);
	}
	//排降序
	int end = n - 1;//记录当前数组中最后一个元素,是变化的用变量存储
	while (end > 0)//end==0走到最后一个元素了
	{
		//将第一个元素和end下标元素交换
		Swap(&a[0], &a[end]);
		//去掉当前找到的最大元素
		end--;
		//进行向下调整
		AdjustDownSmall(a, end, 0);//每次都将end个元素从根开始进行向下调整找到最小的元素。
	}
}
测试代码:
int main()
{
	HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
	int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
	Heap hp;
	//HeaPInitSmall(&hp, a, sz);//小根堆初始化
	//Heap* php = &hp;
	//for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	//{
	//	printf("%d ", php->_a[i]);
	//}
	//printf("\n");
	//HeaPInitBig(&hp, a, sz);//大根堆初始化
	//for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	//{
	//	printf("%d ", php->_a[i]);
	//}
	//测试堆排升序:
	HeapSortBig(a, sz);
	printf("升序:");
	for (int i = 0; i < sz; i++)
	{
		printf("%d ", a[i]);
	}
	printf("\n");
	printf("降序:");
	//测试堆排降序
	HeapSortSmall(a, sz);
	for (int i = 0; i < sz; i++)
	{
		printf("%d ", a[i]);
	}
	return 0;
}
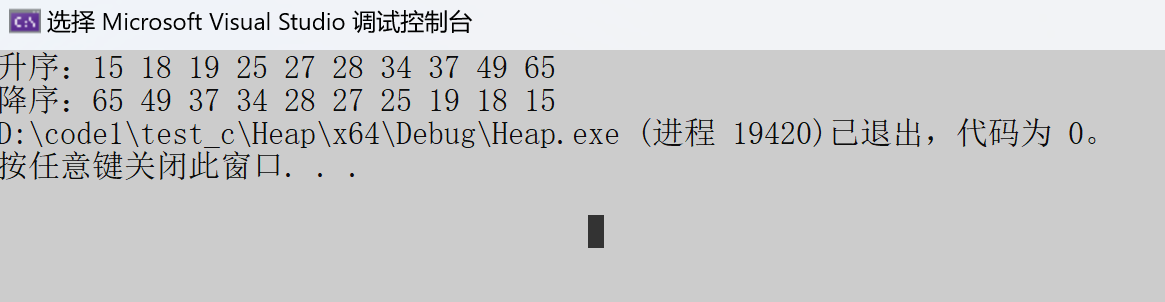
运行发现正确:
排序算法分类
较慢算法:冒泡排序、插入排序、选择排序(后续课程讲解)
较快算法:堆排序(已讲)、归并排序、快速排序
为什么会有这么多排序呢?
其实排序在生活中的应用场景很多:
- 购物软件中:
评价排序:查看商品口碑
销量排序:选择热门商品
价格排序:筛选性价比商品
综合排序:多维度评估- 网络搜索与马太效应
搜索习惯: 用户基本不会查看搜索结果第二页之后的内容
马太效应: 排序靠前的内容获得更多曝光,形成"强者愈强"的循环
比如淘宝直通车,给的钱多,店家就会出现在越前面,获得更多的曝光和浏览量。
接着完成堆的其他接口
1、销毁堆
//销毁堆
void HeapDestory(Heap* php)
{
	free(php->_a);
	php->_a = NULL;
	php->capacity = php->size = 0;
}
这里的销毁和我们做的OJ题不一样,OJ题中一般是会让我们将数据结构都malloc出来,因为leetcode的接口型OJ题给的是一个函数,如果你是创建一个静态栈区结构体,那么出函数就会销毁这块空间,也就没办法获得这块空间来操作了。
比如之前写的用栈实现队列,我们就是这样操作的:
这里的队列我们就是malloc出来的,在leetcode的后台会帮我们释放掉。
typedef struct {
    ST pushStack;
    ST popStack;
} MyQueue;
MyQueue* myQueueCreate() {
    //申请栈空间
    MyQueue* q = (MyQueue*)malloc(sizeof(MyQueue));
    //将栈初始化
    StackInit(&q->pushStack);
    StackInit(&q->popStack);
    return q;
}
我们销毁需要先销毁这种数据结构里面的,然后在销毁整个外面的大数据结构,比如链表:先销毁一个一个的节点,在销毁整个申请的链表空间。这个就先销毁队列里的两个栈,再销毁队列,因为队列也是malloc出来的:
void myQueueFree(MyQueue* obj) {
    //先释放两个栈空间
    StackDestroy(&obj->pushStack);
    StackDestroy(&obj->popStack);
    //释放结构体
    free(obj);
}
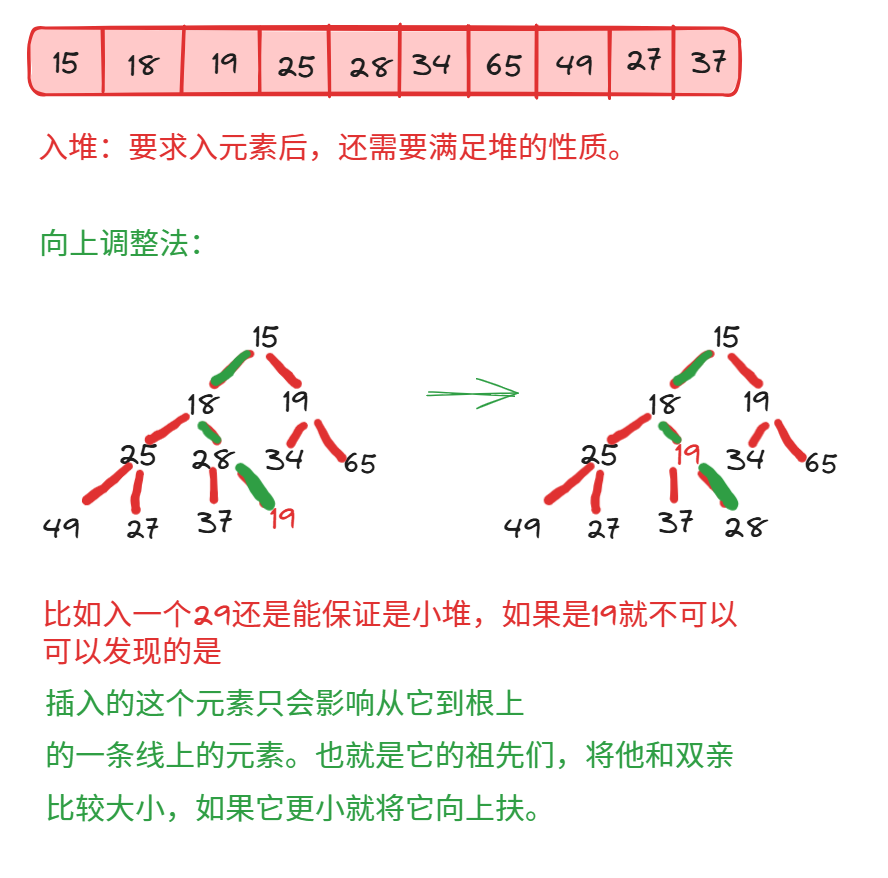
2、入堆(向上调整法)
以小根堆为例:大根堆就把大的元素向上扶。
代码
向上调整法:
//向上调整法--小根堆
void AdjustUpSmall(HPDataType* a,int child)
{
	int parent = (child - 1) / 2;
	//while(parent >= 0)有的同学可能认为双亲下标越界就终止了,实际上双亲下标是不可能越界的,因为
	//parent = (child - 1) / 2;//这里下标是不会为负的。所以循环终止不了
	//但是走到最后恰好到child==0,parent == 0,走到else也会终止。最合适的写法是child的
	while (child > 0)//孩子==0就终止了
	{
		if (a[child] < a[parent])//如果孩子小于双亲,就将孩子也就是小元素向上扶,构成小堆
		{
			Swap(&a[child], &a[parent]);
			child = parent;//将child向上移到双亲上
			parent = (child - 1) / 2;//这里下标是不会为负的
		}
		else
		{
			break;
		}
	}
}

//向上调整法--大根堆
void AdjustUpBig(HPDataType* a,int child)
{
	int parent = child * 2 + 1;
	//while(parent >= 0)有的同学可能认为双亲下标越界就终止了,实际上双亲下标是不可能越界的,因为
	//parent = (child - 1) / 2;//这里下标是不会为负的。所以循环终止不了
	//但是走到最后恰好到child==0,parent == 0,走到else也会终止。最合适的写法是child的
	while (child > 0)//孩子==0就终止了
	{
		if (a[child] > a[parent])//如果孩子大于双亲,就将孩子也就是大元素向上扶,构成大堆
		{
			Swap(&a[child], &a[parent]);
			child = parent;//将child向上移到双亲上
			parent = (child - 1) / 2;//这里下标是不会为负的
		}
		else
		{
			break;
		}
	}
}
入堆:
//入堆--小堆
void HeapPushSmall(Heap* php, HPDataType x)
{
	assert(php);
	if (php->size == php->capacity)//如果堆满了就增容
	{
		php->capacity *= 2;
		HPDataType* tmp = (HPDataType* )realloc(php->_a, sizeof(HPDataType)* php->capacity);
		if (tmp == NULL)
		{
			perror("HeapPush::realloc");
			exit(1);
		}
		php->_a = tmp;
	}
	//将新的元素插入到尾部
	php->_a[php->size++] = x;
	//只需要调整这个元素连接到根上的一条线上的元素,再次构成小堆
	AdjustUpSmall(php->_a,php->size-1);
}

//入堆--大堆
void HeapPushBig(Heap* php, HPDataType x)
{
	assert(php);
	if (php->size == php->capacity)//如果堆满了就增容
	{
		php->capacity *= 2;
		HPDataType* tmp = (HPDataType*)realloc(php->_a, sizeof(HPDataType) * php->capacity);
		if (tmp == NULL)
		{
			perror("HeapPush::malloc");
			exit(1);
		}
		php->_a = tmp;
	}
	//将新的元素插入到尾部
	php->_a[php->size++] = x;
	//只需要调整这个元素连接到根上的一条线上的元素,再次构成大堆
	AdjustUpBig(php->_a, php->size - 1);
}
测试:
#define  _CRT_SECURE_NO_WARNINGS 1
#include"Heap.h"

int main()
{
	//HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
	//int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
	//Heap hp;
	//Heap* php = &hp;
	//HeaPInitSmall(php, a, sz);//小根堆初始化

	//for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	//{
	//	printf("%d ", php->_a[i]);
	//}
	//printf("\n");
	//HeaPInitBig(&hp, a, sz);//大根堆初始化
	//for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	//{
	//	printf("%d ", php->_a[i]);
	//}
	////测试堆排升序:
	//HeapSortBig(a, sz);
	//printf("升序:");
	//for (int i = 0; i < sz; i++)
	//{
	//	printf("%d ", a[i]);
	//}
	//printf("\n");
	//printf("降序:");
	////测试堆排降序
	//HeapSortSmall(a, sz);
	//for (int i = 0; i < sz; i++)
	//{
	//	printf("%d ", a[i]);
	//}
	HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
	int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
	Heap hp;
	Heap* php = &hp;
	HeaPInitSmall(php, a, sz);//小根堆初始化
	printf("小堆初始化:");
	for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	printf("\n");
	//测试入小堆
	printf("13入小堆:");
	HeapPushSmall(php, 13);
	for (int i = 0; i < php->size; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	printf("\n");

	HeaPInitBig(php, a, sz);//大根堆初始化
	printf("大堆初始化:");
	for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	printf("\n");
	//测试入大堆
	printf("100入大堆:");
	HeapPushBig(php, 100);
	for (int i = 0; i < php->size; i++)//看初始化完成后的堆中的值。
	{
		printf("%d ", php->_a[i]);
	}
	return 0;
}
运行结果:
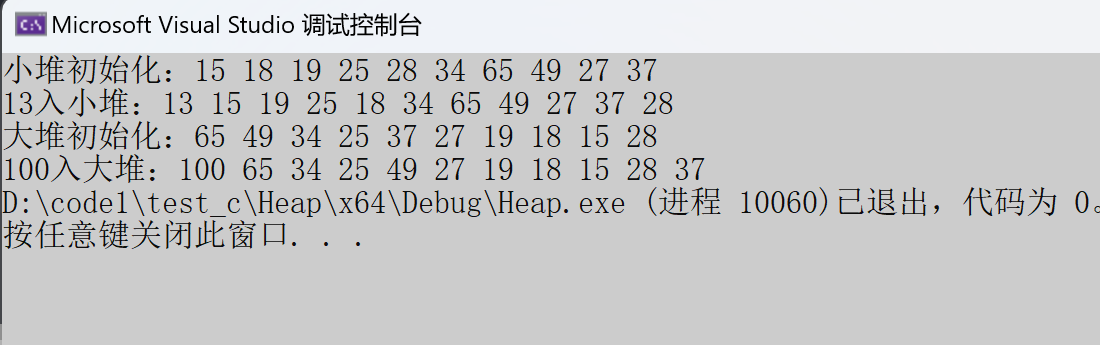
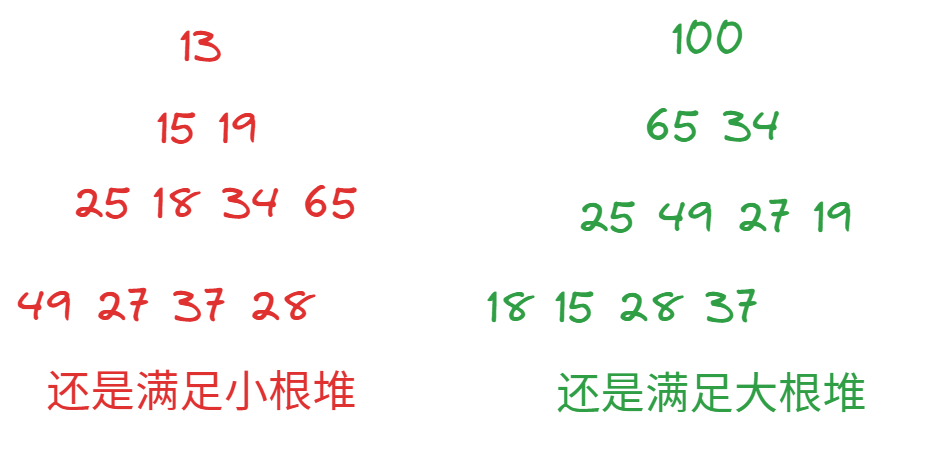
3、出堆
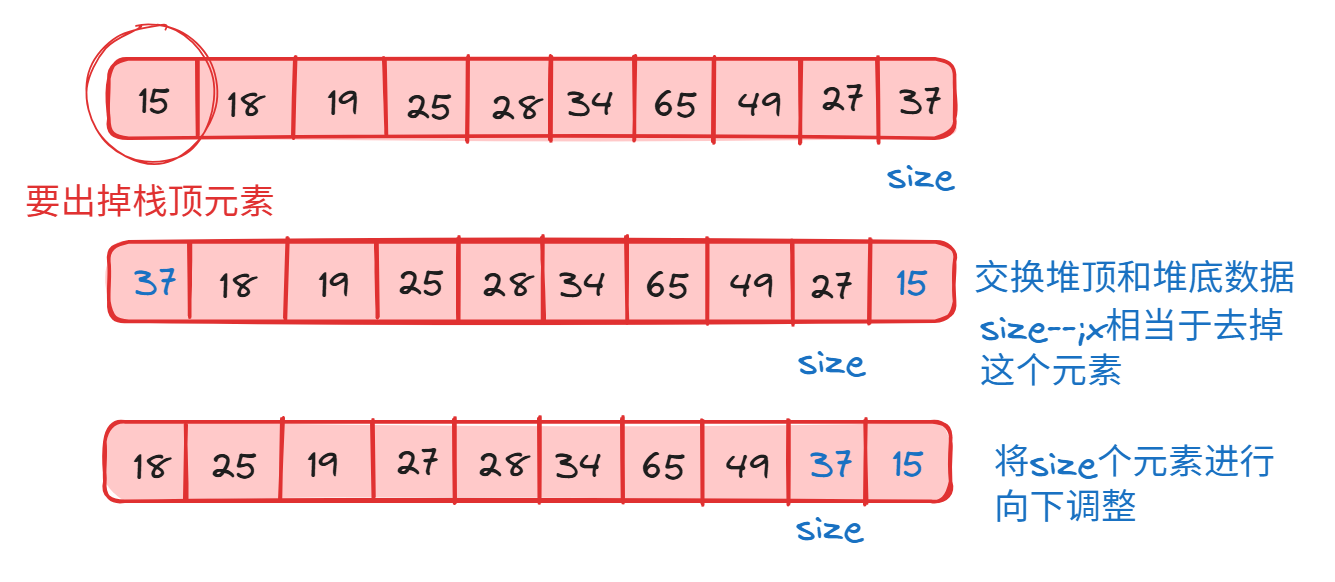
操作图解
需要出掉堆顶元素,当然并不是移动与元素覆盖堆顶元素。
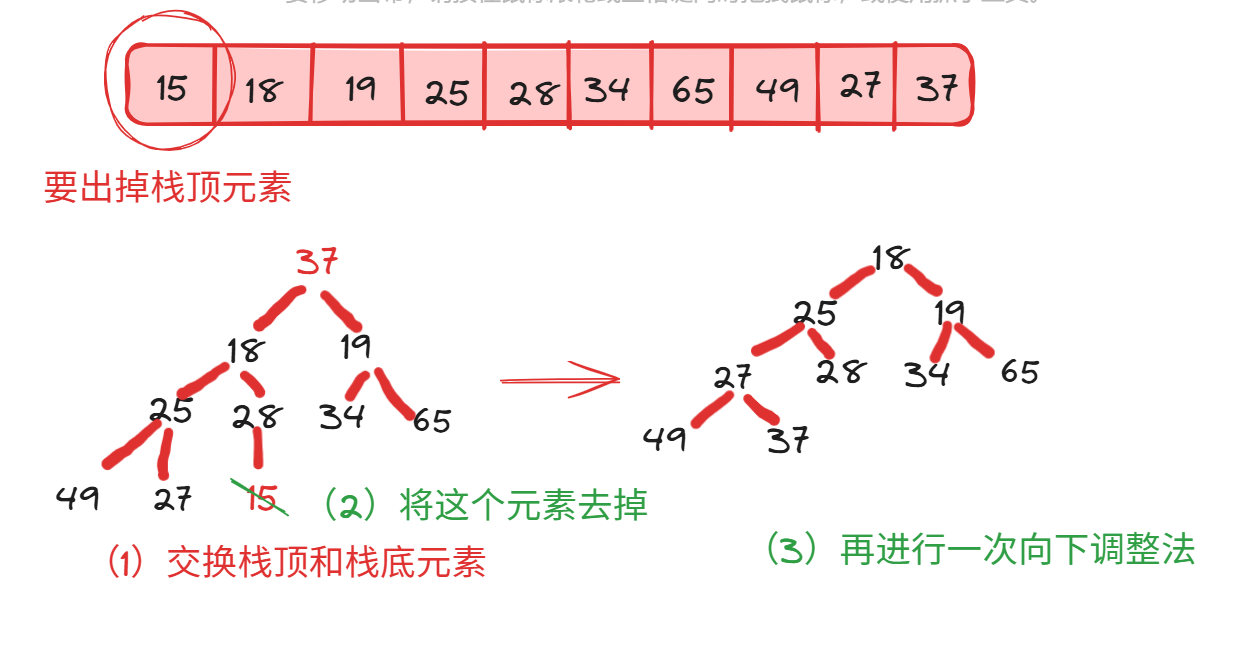
- 交换栈顶和栈底元素
- 将这个元素去掉
- 再进行一次向下调整法
在数组中是这样的:
代码
//出堆
void HeapPopSmall(Heap* php)
{
	assert(php);
	assert(php->size);
	Swap(&php->_a[0], &php->_a[php->size - 1]);//将第一个元素和最后一个元素交换
	php->size--;
	//进行向下调整,n-1个元素
	AdjustDownSmall(php->_a, php->size, 0);
}
///出堆
void HeapPopBig(Heap* php)
{
	assert(php);
	assert(php->size);
	Swap(&php->_a[0], &php->_a[php->size - 1]);//将第一个元素和最后一个元素交换
	php->size--;
	//进行向下调整,n-1个元素
	AdjustDownBig(php->_a, php->size, 0);
}
测试:
HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
Heap hp;
Heap* php = &hp;
printf("大堆初始化:");
HeaPInitBig(php, a, sz);//小根堆初始化
for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
{
	printf("%d ", php->_a[i]);
}
printf("\n");
//出堆顶元素
HeapPopBig(php);
printf("大堆出堆顶:");
for (int i = 0; i < php->size; i++)//看初始化完成后的堆中的值。
{
	printf("%d ", php->_a[i]);
}
printf("\n");


printf("小堆初始化:");
HeaPInitSmall(php, a, sz);//小根堆初始化
for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
{
	printf("%d ", php->_a[i]);
}
printf("\n");
//出堆顶元素
HeapPopSmall(php);
printf("小堆出堆顶:");
for (int i = 0; i < php->size; i++)//看初始化完成后的堆中的值。
{
	printf("%d ", php->_a[i]);
}
printf("\n");
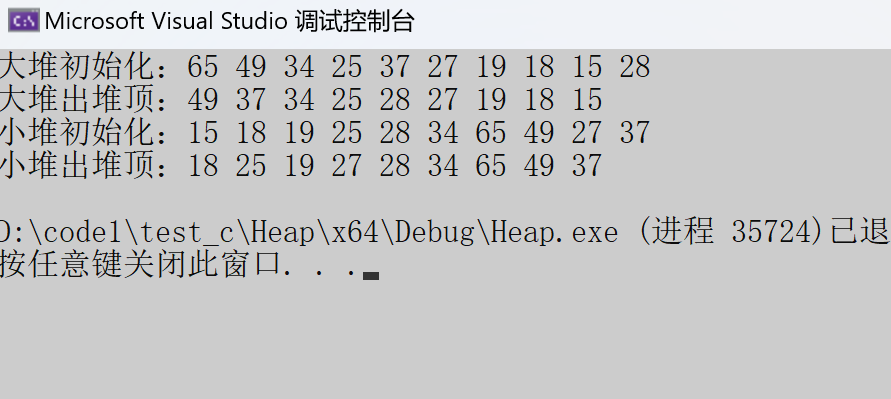
运行结果:
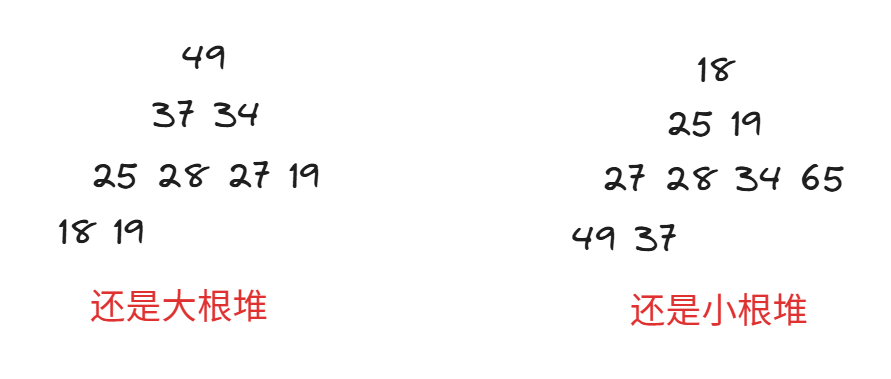
验证:
4、取出堆顶元素
//提取堆顶元素
HPDataType HeapTop(Heap* php)
{
	assert(php);
	assert(php->size);
	return php->_a[0];
}
测试:
//测试取堆顶元素
HPDataType a[] = { 27,15,19,18,28,34,65,49,25,37 };//传进区的数组
int sz = sizeof(a) / sizeof(HPDataType);//计算数组的元素个数
Heap hp;
Heap* php = &hp;
printf("大堆初始化:");
HeaPInitBig(php, a, sz);//小根堆初始化
for (int i = 0; i < sz; i++)//看初始化完成后的堆中的值。
{
	printf("%d ", php->_a[i]);
}
printf("\n");
HPDataType ret = HeapTop(php);
printf("取出堆顶元素:%d\n",ret);
return 0;
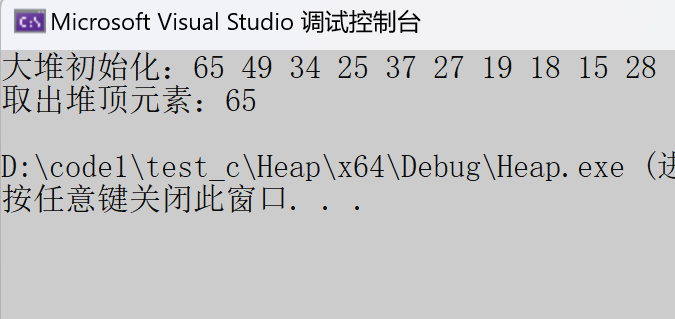
运行结果:
5、TOPK问题
TOPK经典问题在大厂考题中是热门题,它的全名叫做在给定N个元素中找到最大或者最小的前K个元素。
方法:
- 堆排序,可以找到最大/最小的前K个元素。时间复杂度为O(N*logN)。
弊端:
1、后面的N-K个元素没必要排序。
2、如果给定的N很大,在内存中放不下,比如给1亿个元素,相当于4亿个字节,在内存中无法放下,只能在磁盘文件中操作,也是可以搞定的,但是效率相比在内存中很低。
2、建N个数的堆,接着HeapTop和HeapPop这样搭配上(k-1)次找到最大或最小前10个元素。(每次将先取出首元素,然后首元素与末尾交换,然后–size丢弃该元素,再将剩下的元素进行向下调整还原大堆或者小堆,重复这个步骤k-1次即可)时间复杂度:
F(N)=N(建堆)+(K-1)* log(N+1)(向下调整K-1次)+N/2(交换N/2次元素)),故为O(K*log(N))。
这个方法其实就是堆排的前几个步骤,只不过是只排序找到前k个最大或最小元素而已。
3、最佳方法:
- 找N个数中最小(最大的)的前K个数,取出数组前K个数,构建K个数的大堆(小堆)
- 然后从第K+1个数(下标为k)的元素开始和堆顶的数进行比较,如果小于(大于)堆顶的元素就入堆,进行向下调整法,恢复堆的性质,重复这过程继续比较,直到最后一个数,最终k个数的堆就是结果。
- 时间复杂度为F(N)=(N(建堆)+N*log(K+1)(每次最多调整高度次)),最终时间复杂度为O(N*logK)。
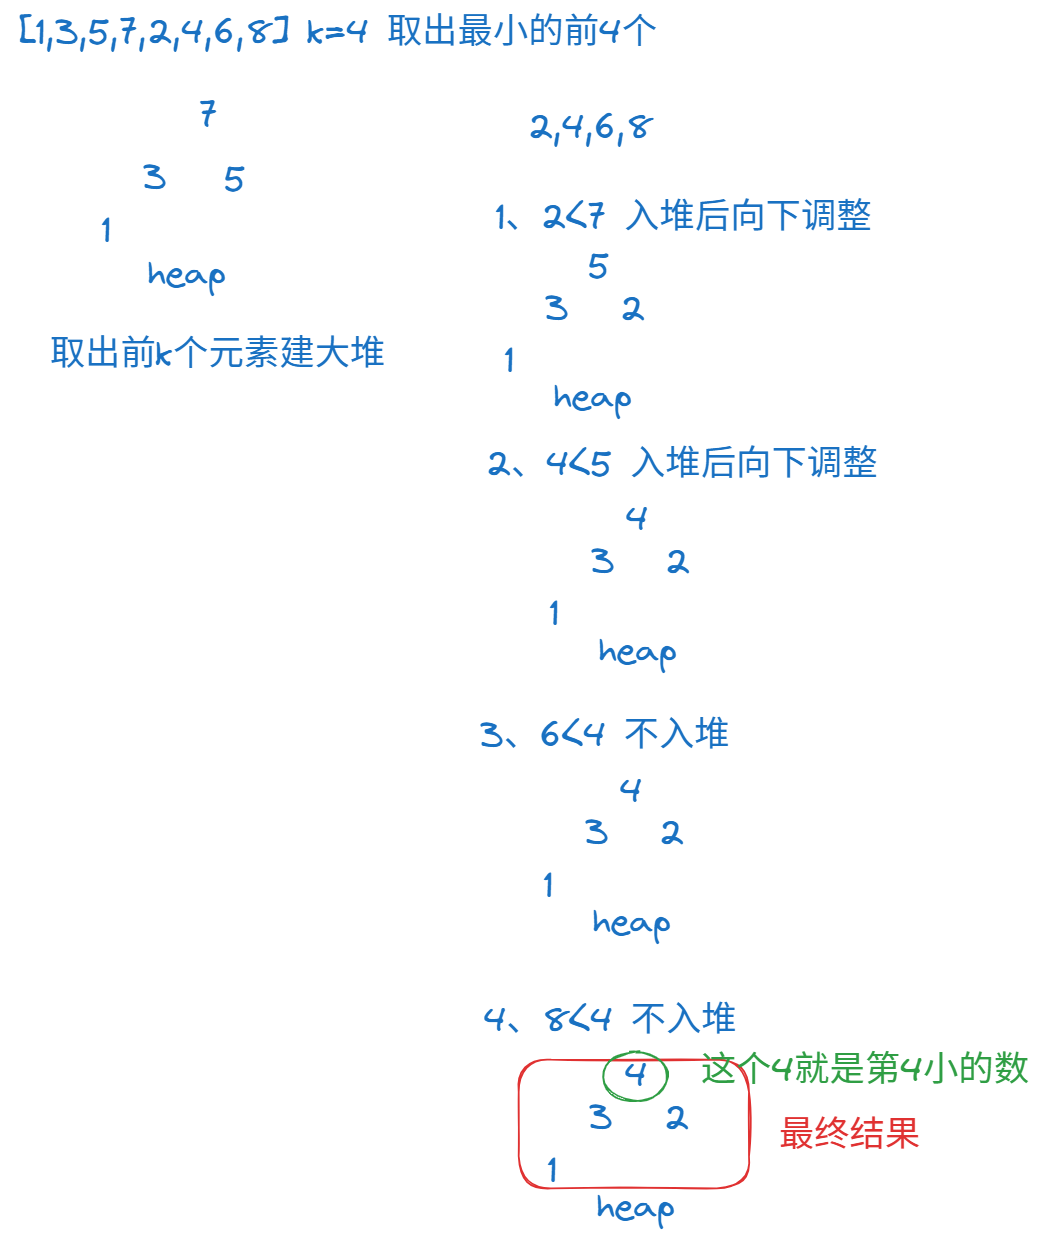
- 由于最小的前k个元素是这些数中最小的,每次都会顶替到一个堆顶的大元素,然后入堆。
- 向下调整会将当前最大的元素浮上来,将小元素沉在堆底。
- 接着比较,最终将大元素全部顶替,将小元素全部沉在堆里,最终保证堆里全是小元素,个数正好是k个。
- 想求第K小的数,堆中第K小的就是这K个小数里面最大的,而这个还是大堆,所以堆顶就是这些大数里最大的,也就是第K小的。其他的元素排序未知,想知道还得排个序,或者Top一下求次小,或者剩下元素再建小堆求次小的。
6、相关OJ题
7、最小的前K个数
最小的前K个数
思路就是上面讲的那个最佳方法:
/**
 * Note: The returned array must be malloced, assume caller calls free().
 */
 void AdjustDown(int* a,int n,int root)
 {
    int parent = root;
    int child = parent*2+1;//默认左孩子为较大的孩子
    while(child < n)
    {
        if(child+1 < n && a[child+1] > a[child])//如果右孩子值更大,就用右孩子比较
            child++;
        if(a[parent] < a[child])//如果双亲小于孩子,将孩子(大的元素)向上扶
        {
            int tmp = a[parent];//交换值
            a[parent] = a[child];
            a[child] = tmp;
            parent = child;//parent走到child上
            //变量更新位置
            child = parent * 2 + 1;//重新计算child的值
        }
        else
        {
            break;
        }
    }
 }
int* smallestK(int* arr, int arrSize, int k, int* returnSize) {
    if(k==0)
        return NULL;
    //首先先malloc出一个堆空间
    int* heap = (int*)malloc(sizeof(int)*k);
    if(heap == NULL)
    {
        perror("smallestK::malloc");
        return NULL;
    }
    //取数组的前k个元素
    for(int i = 0;i<k;i++)
    {
        heap[i] = arr[i];
    }
    //建大堆
    for(int j = (k-1-1)/2;j >= 0;j--)
    {
        AdjustDown(heap,k,j);
    }
    //从第k+1个数,下标为k的数开始和k这个堆的堆顶元素进行比较
    for(int m = k;m < arrSize;m++)
    {
        if(arr[m] < heap[0])//比堆顶小就入堆
        {
            heap[0] = arr[m];//入堆
            AdjustDown(heap,k,0);//向下调整
        }
    }
    * returnSize = k;
    return heap;
}
最大的前k个数改一些符号就好了:
/**
 * Note: The returned array must be malloced, assume caller calls free().
 */
 void AdjustDown(int* a,int n,int root)
 {
    int parent = root;
    int child = parent*2+1;//默认左孩子为较小的孩子
    while(child < n)
    {
        if(child+1 < n && a[child+1] < a[child])//如果右孩子值更小,就用右孩子比较
            child++;
        if(a[parent] > a[child])//如果双亲大于孩子,将孩子(小的元素)向上扶
        {
            int tmp = a[parent];//交换值
            a[parent] = a[child];
            a[child] = tmp;
            parent = child;//parent走到child上
            //变量更新位置
            child = parent * 2 + 1;//重新计算child的值
        }
        else
        {
            break;
        }
    }
 }
int* BiglestK(int* arr, int arrSize, int k, int* returnSize) {
    if(k==0)
        return NULL;
    //首先先malloc出一个堆空间
    int* heap = (int*)malloc(sizeof(int)*k);
    if(heap == NULL)
    {
        perror("smallestK::malloc");
        return NULL;
    }
    //取数组的前k个元素
    for(int i = 0;i<k;i++)
    {
        heap[i] = arr[i];
    }
    //建小堆
    for(int j = (k-1-1)/2;j >= 0;j--)
    {
        AdjustDown(heap,k,j);
    }
    //从第k+1个数,下标为k的数开始和k这个堆的堆顶元素进行比较
    for(int m = k;m < arrSize;m++)
    {
        if(arr[m] > heap[0])//比堆顶大就入堆
        {
            heap[0] = arr[m];//入堆
            AdjustDown(heap,k,0);//向下调整
        }
    }
    * returnSize = k;
    return heap;
}
8、数组中第K个最大的元素
先看TOPK问题的解法,这个就会了,这个就是TOPK,多了一步取堆顶元素。
想求堆中第K大的数,堆中第K大的就是这K个大数里面最小的,而这个还是小堆,所以堆顶就是这些大数里最小的,也就是第K大的。其他的元素排序未知,想知道还得排个序,或者Top一下求次大,或者剩下元素再建大堆求次大的。
数组中第K个最大的元素
void AdjustDown(int* a,int n,int root)
{
    //找到双亲和孩子的下标
    int parent = root;
    int child = parent * 2 + 1;//默认左孩子是较小的孩子
    while(child<n)//孩子下标不越界
    {
        if(child+1<n && a[child+1]<a[child])//右孩子更小就拿右孩子和双亲比较
            child++;
        if(a[child] < a[parent])//孩子的值更小就把小元素往上扶,所以交换双亲和孩子
        {
            int tmp = a[child];
            a[child] = a[parent];
            a[parent] = tmp;
            //双亲走到孩子的位置处
            parent = child;
            //重新计算新的孩子,继续向下调整
            child = parent * 2 + 1;
        }
        else//如果当前双亲小于孩子了,它的左右子树目前都能保持小堆的情况下,就不需要调整了,整个堆就是小堆
        {
            break;
        }
    }
}
int findKthLargest(int* nums, int numsSize, int k) {
    //就是先TOPK问题,然后堆中的就是前K个最大的数,第K大的数就是这K个大数里面最小的,而这个还是小堆
    //所以堆顶就是这些大数里最小的,也就是第K大的。其他的元素排序未知,想直到还得排个序,或者Top一下,或者再建堆求次小的。
    //首先malloc一个堆空间
    int* heap = (int*)malloc(sizeof(int)*k);
    for(int i = 0;i<k;i++)//前K个数入堆
    {
        heap[i] = nums[i];
    }
    //求最大的前K个数,建小堆
    for(int j = (k-1-1)/2;j>=0;j--)
    {
        AdjustDown(heap,k,j);
    }
    //将接下来的numsSize-k个数和堆顶比较,从下标为k的地方开始,也就是第k+1个元素开始和堆顶比较
    //比堆顶大的入堆,最终在堆中的都是前K大的元素
    for(int m = k;m<numsSize;m++)
    {
        if(nums[m] > heap[0])//大于堆顶的元素
        {
            heap[0] = nums[m];  //大数顶替堆顶的小数
        }
        //再次进行向下调整,保持最小的元素浮在上面
        AdjustDown(heap,k,0);
    }
    //最终的heap的堆顶元素就是我们想要的第K大的数
    return heap[0];

}
二叉树的链式结构(续)
如果是非完全二叉树,用数组存储是很不合适的,会有很多空间的浪费。所以采用链式结构来存储是很合适的。
1、遍历方式
任何一颗二叉树,都可以被看做是三个部分,根,左子树,右子树。
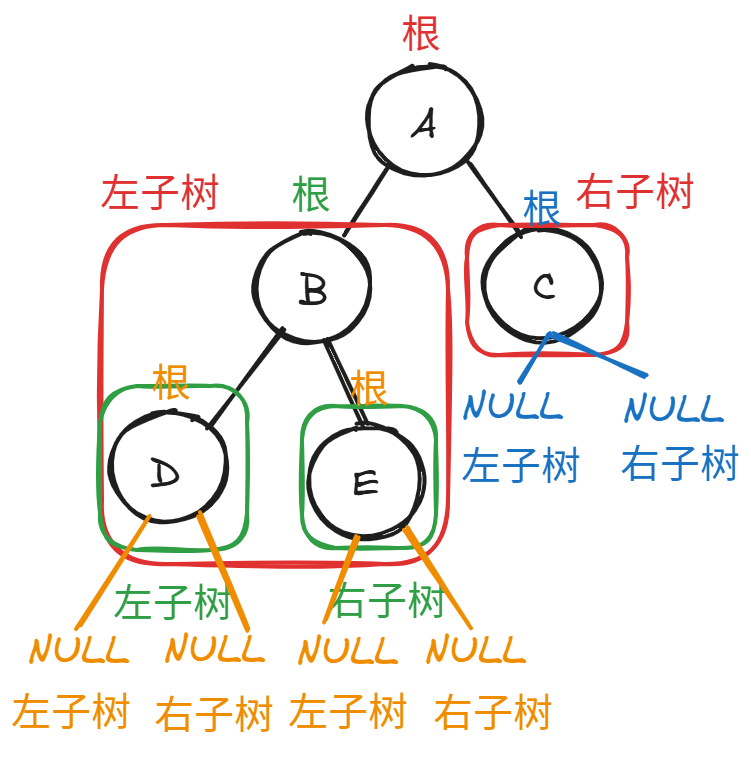
- 前序遍历(先序遍历): 根、左子树、右子树
- 中序遍历:左子树、根、右子树
- 后序遍历:左子树、右子树、根
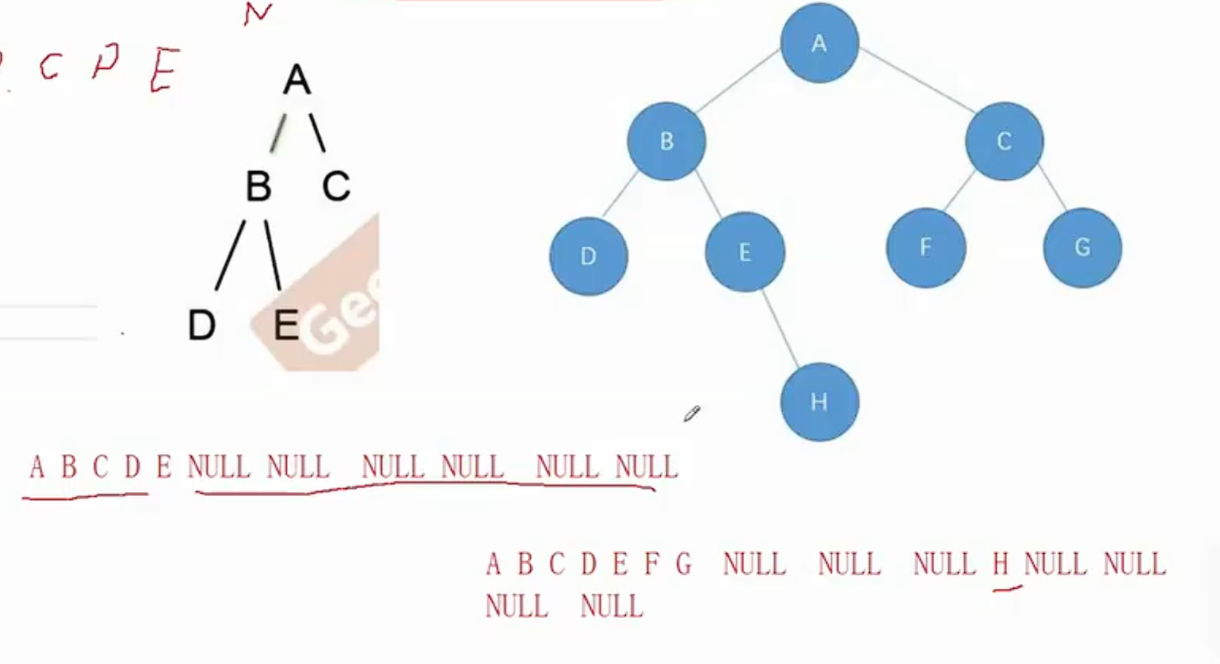
- 层序遍历:一层一层遍历ABCDENULL NULL NULL NULL NULL NULL
如何判断一棵树是不是完全二叉树:
如果他的层序遍历序列中节点是连续的,NULL是连续的,就说明他是完全二叉树
注意:由于树是递归定义的,这里的根、左子树、右子树,是递归遍历的。
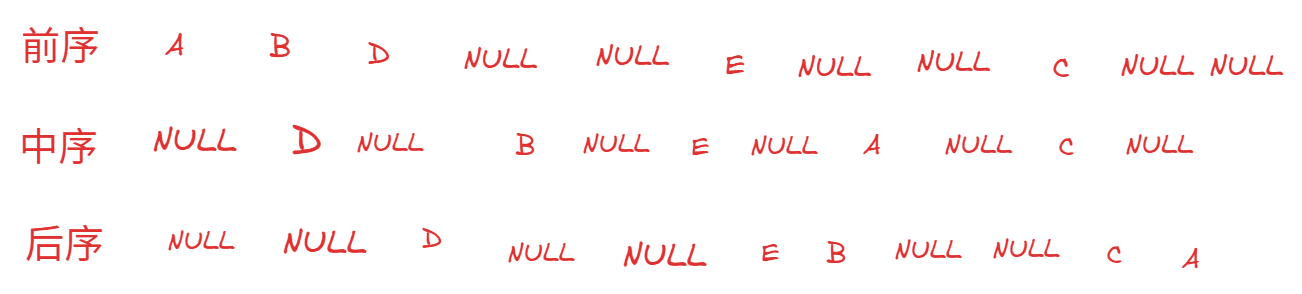
这里我讲一个前序理解过程:
结合代码打印值一起理解(递归定义):
首先定义一个二叉树结构节点结构:
typedef char BTDataType;
typedef struct BinaryTreeNode
{
	BTDataType _val;
	struct BinaryTreeNode* _left;
	struct BinaryTreeNode* _right;
}BTNode;
先序、中序、后序
//先序遍历
void preOrder(BTNode* root)
{
	if (root == NULL)//如果遇到空节点开始返回作为递推的返回条件
	{
		printf("NULL ");//返回前先打印一下NULL,更好的理解递归运行的过程以及子树的遍历顺序
		return;
	}
	printf("%c ", root->_val);//根
	preOrder(root->_left);//左子树
	preOrder(root->_right);//右子树
}
//中序遍历
void InOrder(BTNode* root)
{
	if (root == NULL)//如果遇到空节点开始返回作为返回的条件
	{
		printf("NULL ");//返回前先打印一下
		return;
	}
	InOrder(root->_left);//左子树
	printf("%c ", root->_val);//根
	InOrder(root->_right);//右子树
}
//后续遍历
void postOrder(BTNode* root)
{
	if (root == NULL)//如果遇到空节点开始返回作为返回的条件
	{
		printf("NULL ");//返回前先打印一下
		return;
	}
	postOrder(root->_left);//左子树
	postOrder(root->_right);//右子树
	printf("%c ", root->_val);//根
}
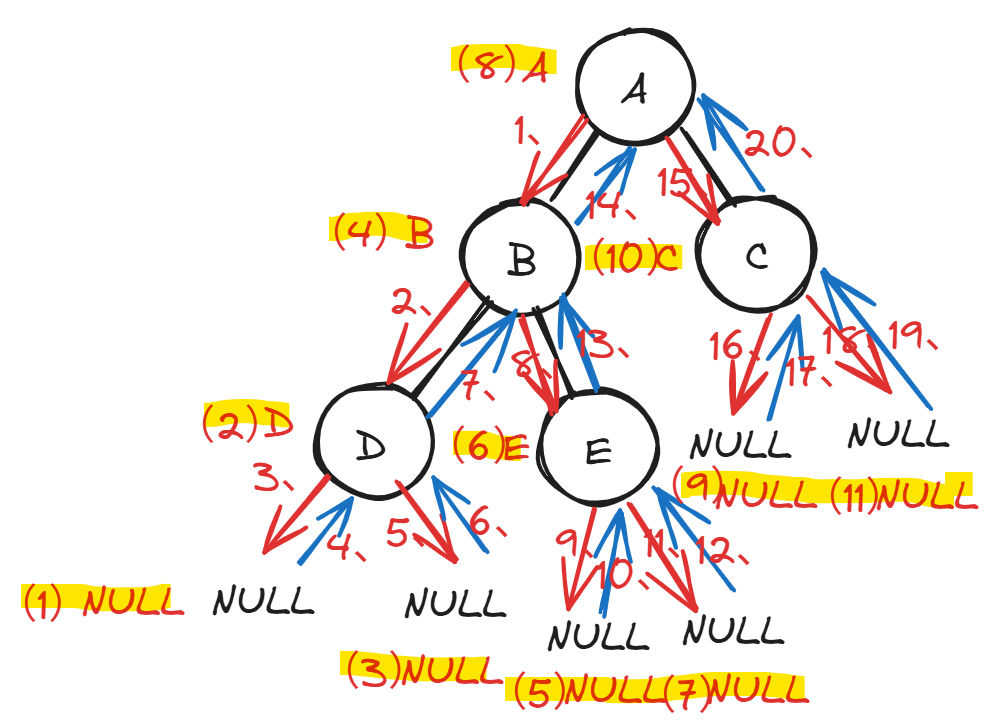
先序代码运行过程:(可以自己模拟画一画中序和后序)
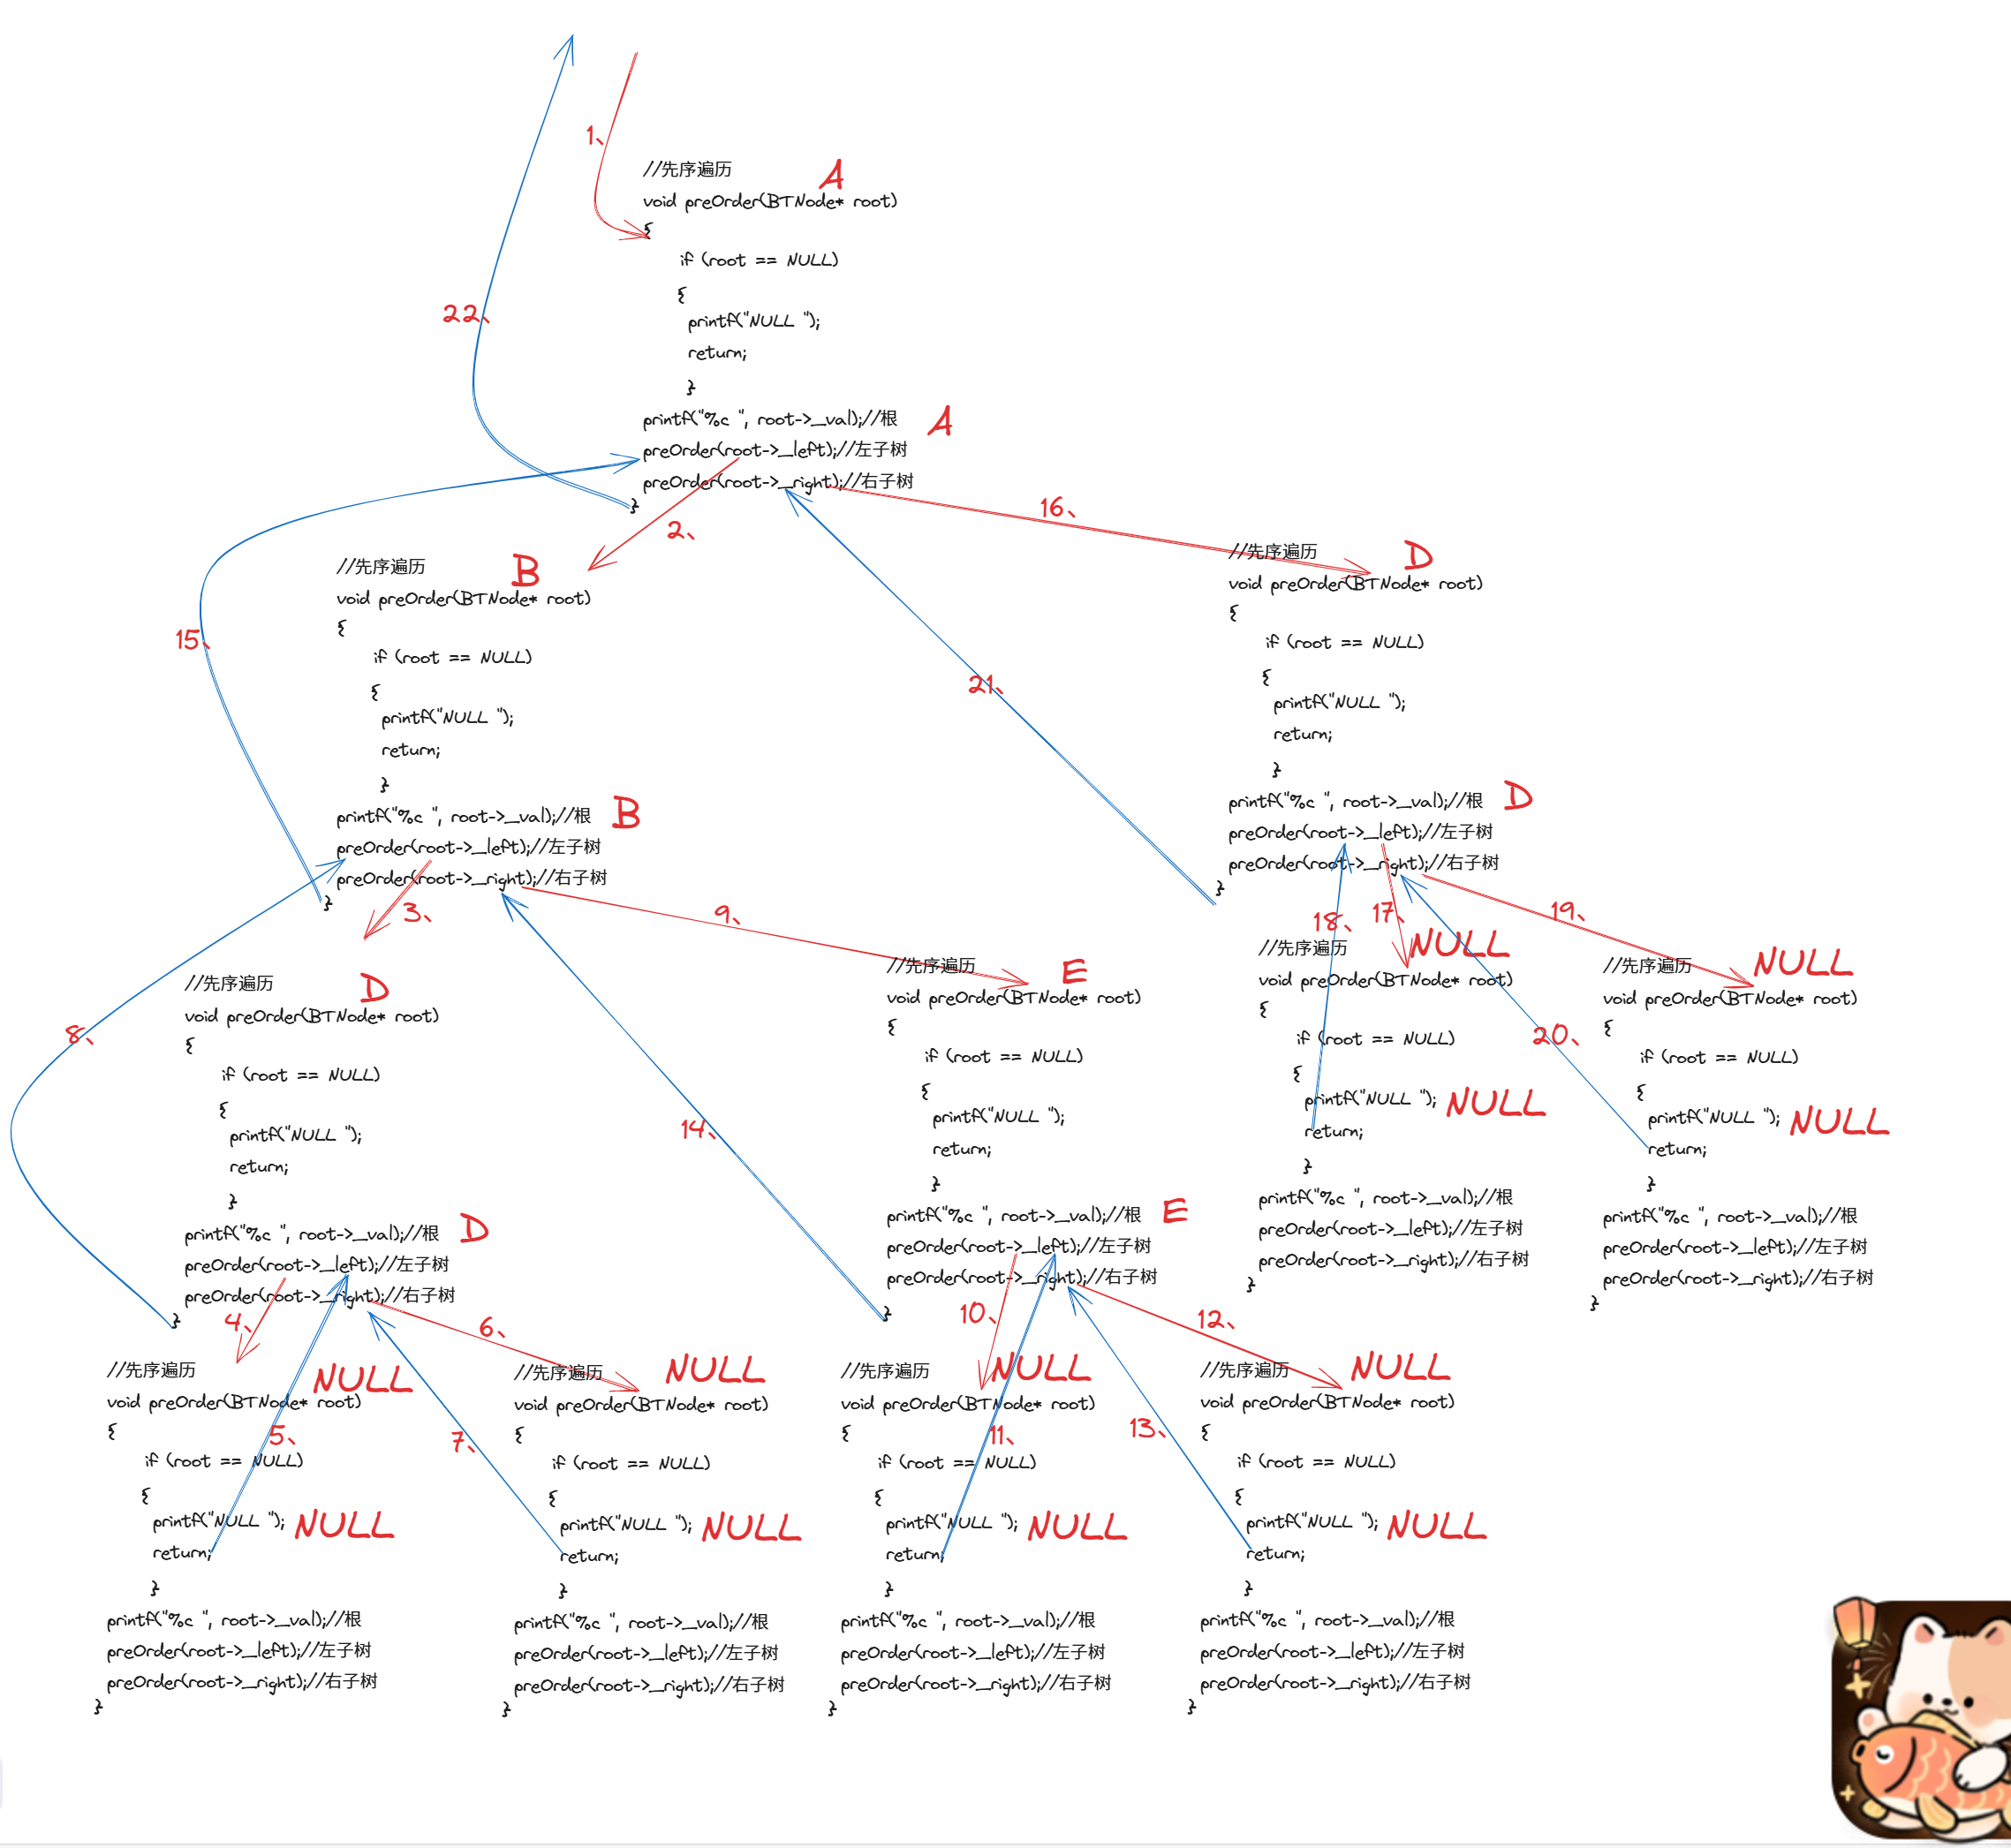
对应图例讲解:
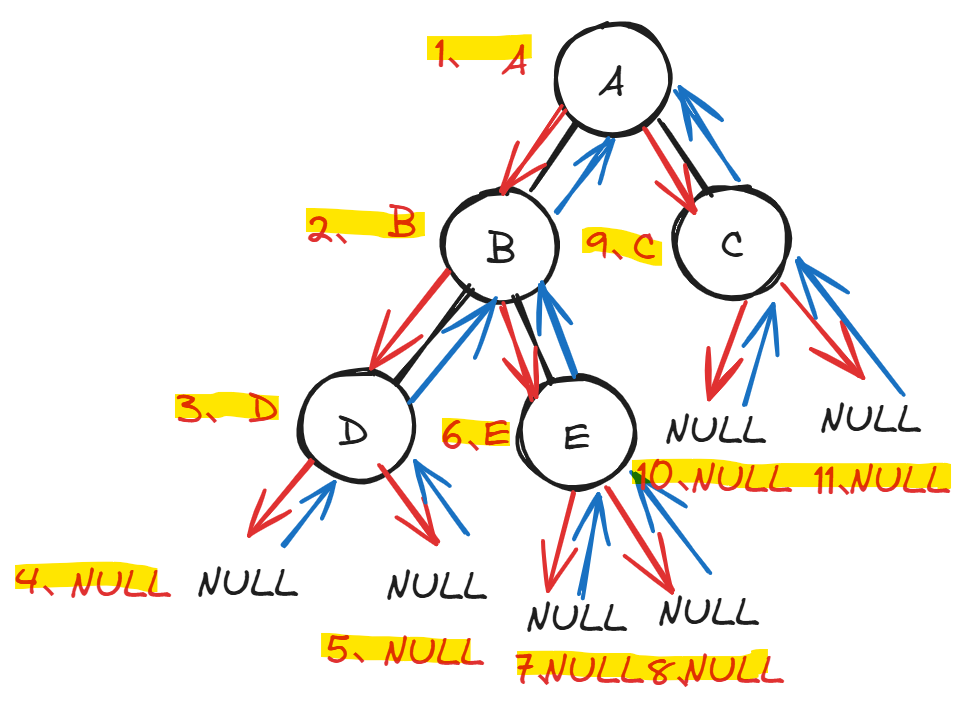
注:红箭头递推
蓝箭头是回归
黄色标注是打印
- 以A作为根(访问了根,打印A)再找它的左子树,是以B为根的树(A的左子树没完不能返回值,必须一条路走到黑,走到结尾为NULL值才可以开始返回,这里的原因是,递推是有终止条件的,必须满足终止条件才可以开始回归)
- 继续以B为根(访问到了根,打印B),找他的左子树,是以D为根的树。
- 继续以D为根(打印D),它的左子树为NULL,满足递推终止条件,可以开始返回了(打印NULL并返回)
- 返回到D根,现在D的根左都访问完了,开始访问它的右,也为空,(打印NULL并返回),D作为B的左子树访问完成了,返回到根B。
- 开始访问B的右,是以E为根的树(打印E),访问左子树为NULL,(打印NULL并返回),访问右子树为NULL,(打印NULL并返回),E作为B的右子树被访问完了,接着以B为根的树作为A的左子树访问完了,返回到根A。
- 开始访问A的右子树,是以C为根(打印C)的子树,访问它的左子树为NULL(打印NULL并返回),右子树为空(打印NULL并返回)。至此C作为A的右子树被访问完了,整棵树访问完毕,每棵子树的访问顺序都是根、左、右。
测试
我们需要构建一颗二叉树,首先就需要先申请出来一系列的节点,然后将这些节点链接起来。
//初始化申请节点方法
BTNode* BTBuyNode(BTDataType val)
{
	BTNode* node = malloc(sizeof(BTNode));//申请一块节点空间
	node->_left = node->_right = NULL;//左右指针都指向空,否则会随机分配地址。建议大家节点初始化的时候都给指针置空
	node->_val = val;//值是你给设置的
	return node;//将节点返回去
}
#define  _CRT_SECURE_NO_WARNINGS 1
#include"BinaryTree.h"

void test01()
{

	BTNode* A = BTBuyNode('A');
	BTNode* B = BTBuyNode('B');
	BTNode* C = BTBuyNode('C');
	BTNode* D = BTBuyNode('D');
	BTNode* E = BTBuyNode('E');
	A->_left = B;
	A->_right = C;
	B->_left = D;
	B->_right = E;

	//测试前序遍历
	printf("preOrder:");
	preOrder(A);
	printf("\n");
	//测试中序遍历
	printf("InOrder:");
	InOrder(A);
	printf("\n");
	//测试后序遍历
	printf("postOrder:");
	postOrder(A);
	printf("\n");
}

int main()
{
	test01();
	return 0;
}
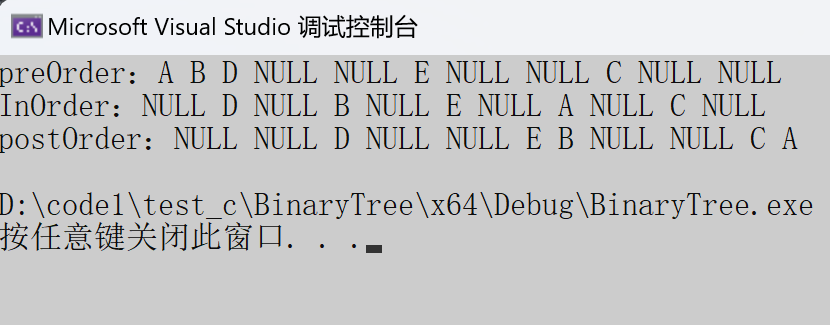
结果
2、两种常考题的简便解法
这里我在王道计算机考研书上看到一个方法特别好教给大家:因为我们前中后序遍历,一般是不写NULL的,很多老师讲的时候就直接讲不带NULL的,就有许多的同学不理解,以为根、左、右,左和右是左孩子、右孩子,其实是左子树、右子树。讲完了相信大家能够理解具体是如何遍历的了,那么我们讲讲如何快速应对考试的写出前中后序:
- 如何快速写出前中后序
-
先序:
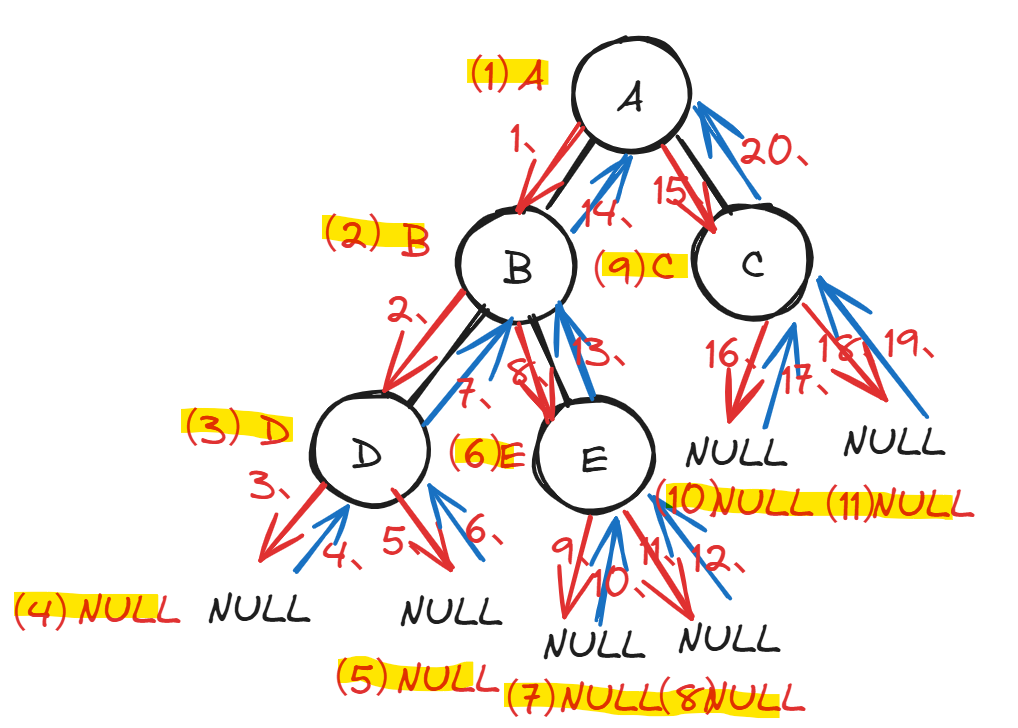
注:黄色的是打印顺序
箭头是递归顺序
红色箭头代表递推、蓝色箭头代表回归 -
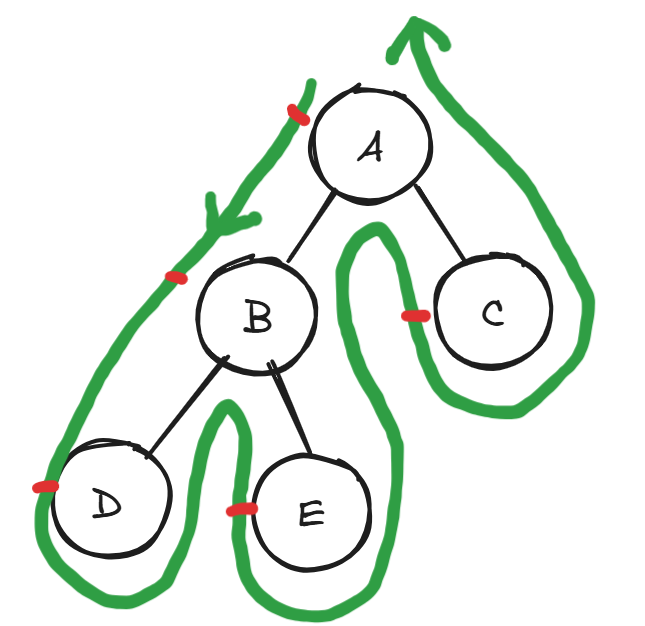
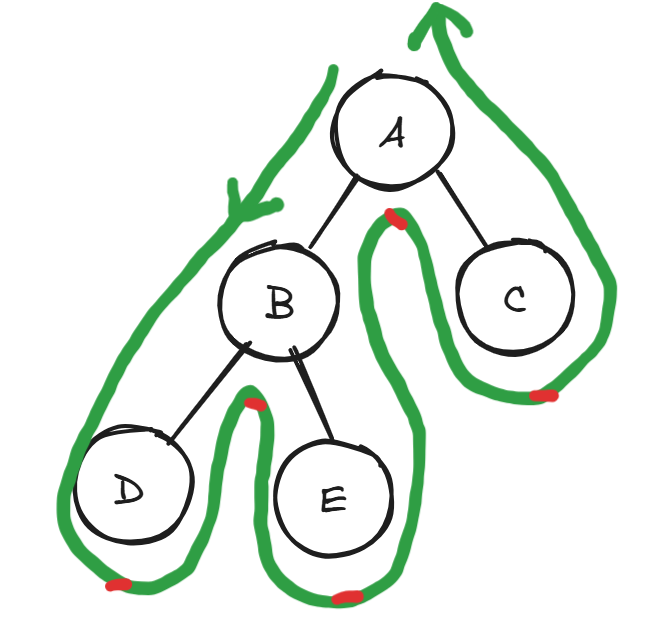
可以看出如果我们把NULL都去掉,那么走的顺序是这样的:如果我们把每一个节点的左边都打上圈圈,这条线穿过的顺序就是先序遍历
-
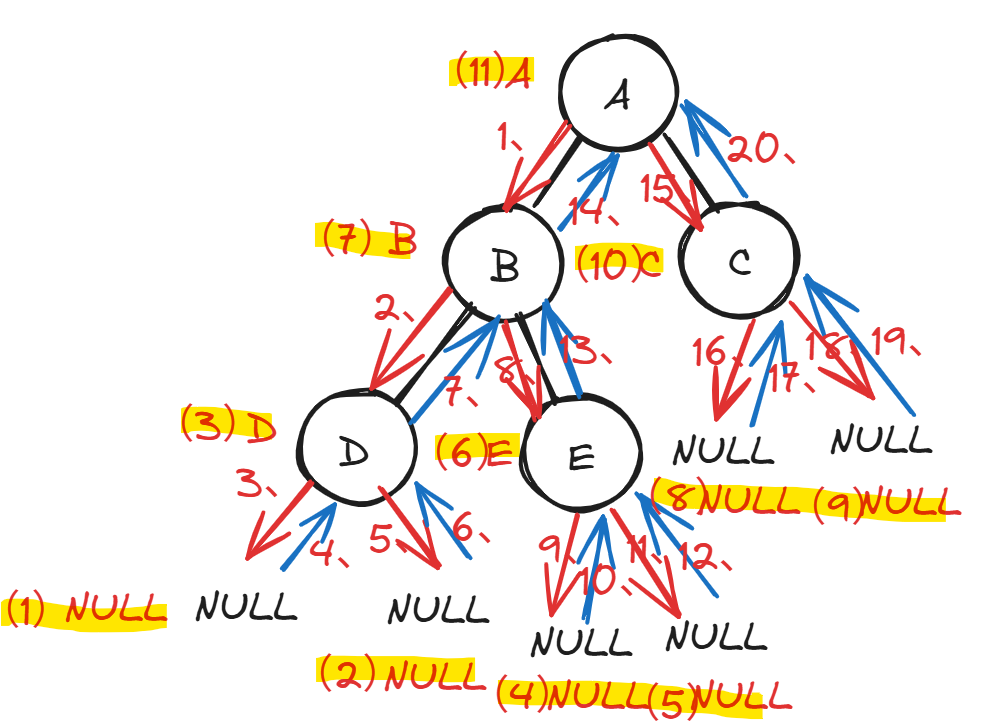
中序:左、根、右。发现其实他的遍历顺序没有改变,只是打印顺序变了而已。先打印左,再打印根,再打印右
其实是因为,不管前中后序,它的访问顺序都是先左子树,再右子树,根只影响了打印位置。他并不会影响访问的顺序。
- 如果在每个节点的下方画圈圈,神奇的发现它的,这条遍历的线穿过圈圈的顺序就是中序遍历
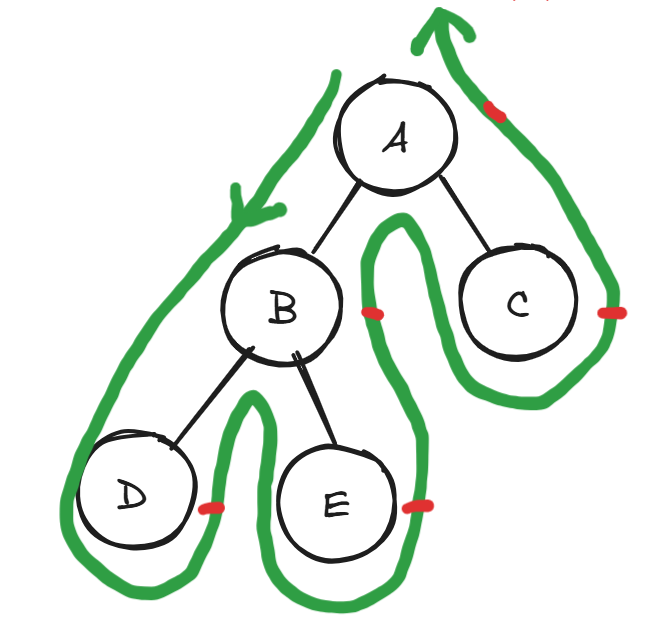
- 后序:
- 如果在每个节点的右方画圈圈,神奇的发现它的,这条遍历的线穿过圈圈的顺序就是中序遍历
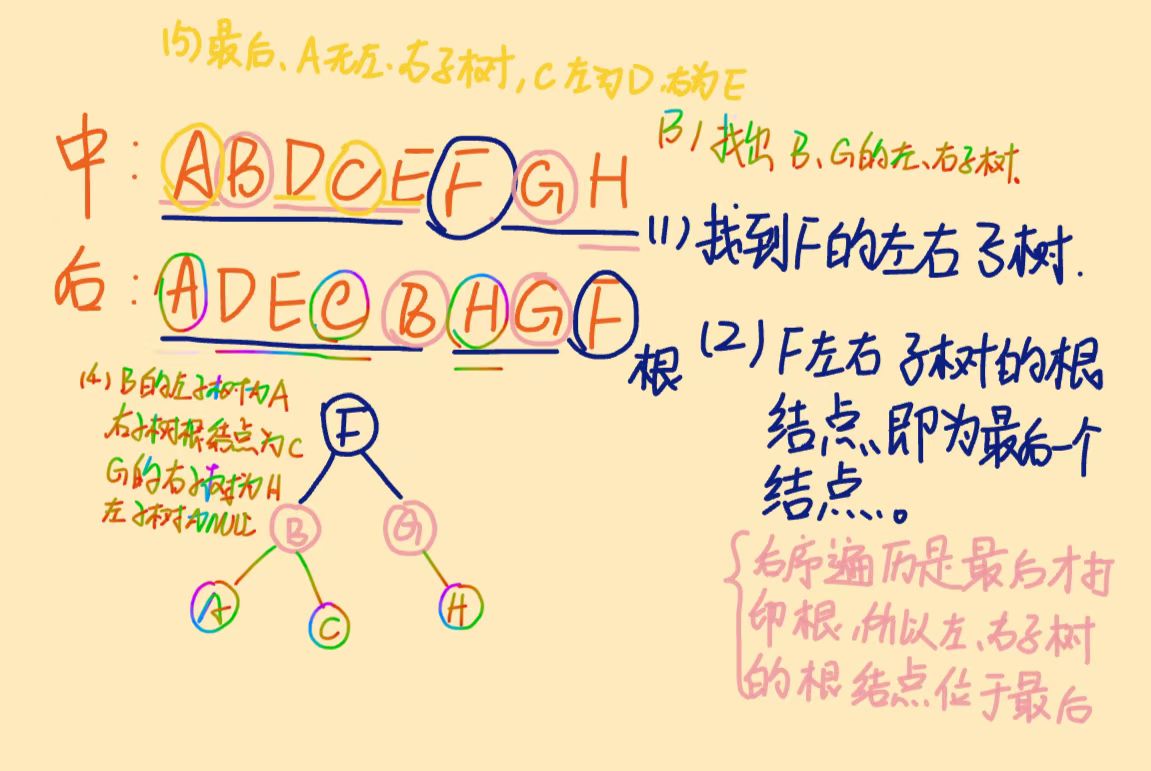
- 如果是给出其中一个排序和中序节点,让写出另一种序列/画出树,可以这样做:
- 先序
首先可以试着推出写出的前中后序节点和左右子树的关系
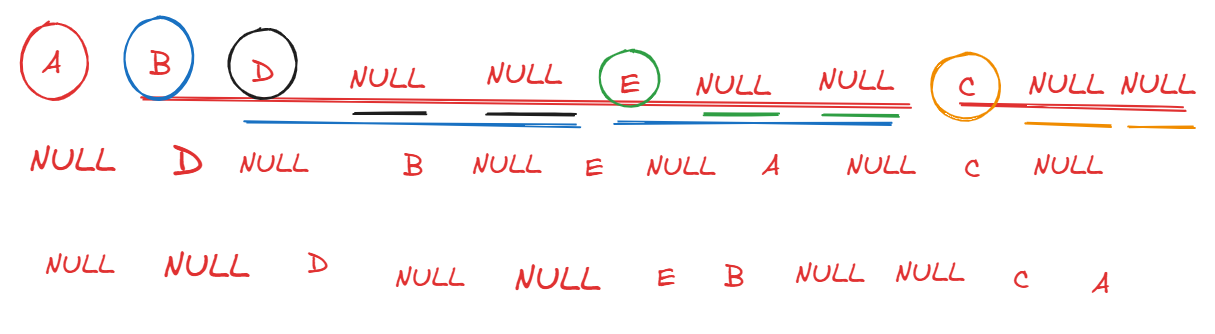
先序中:
- 在图中的圈代表根,两条线,靠近根的是左子树范围、远的是右子树范围。
- 可以发现所有的子树的遍历顺序都是根、左、右
- 中序:
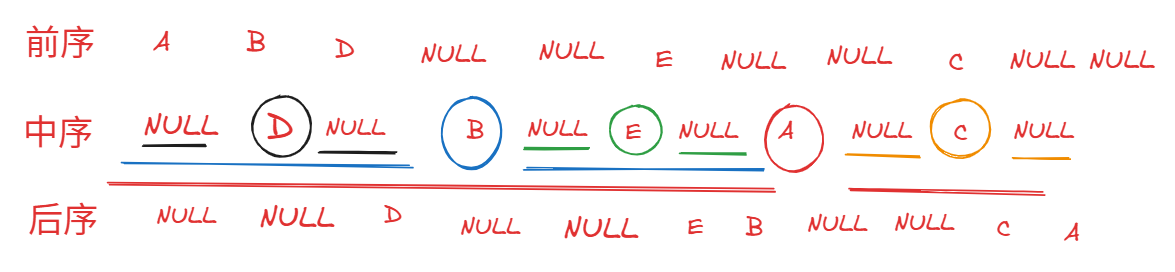
中序中:
- 在图中的圈代表根,两条线,根左边的是左子树范围、根右边是右子树范围。
- 可以发现所有的子树的遍历顺序都是左、根、右
- 后序
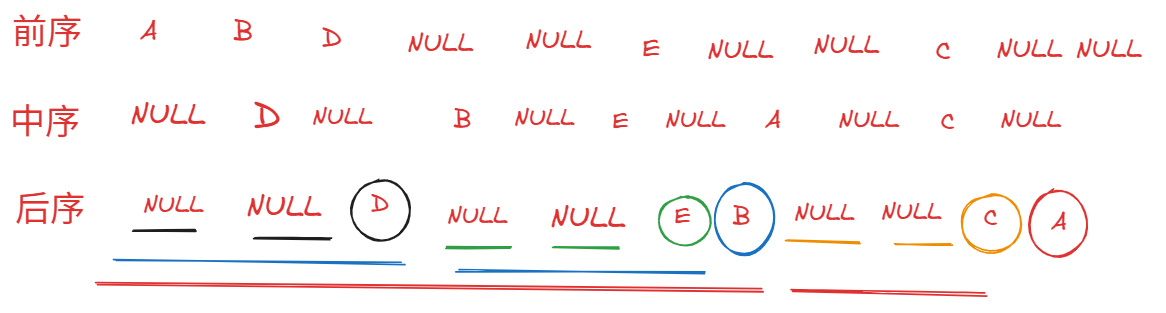
后序中:
- 在图中的圈代表根,两条线,根远的是左子树范围、根近的是右子树范围。
- 可以发现所有的子树的遍历顺序都是左、右、根。
方法:
- 给定的前或后序可以确定根的位置,我们发现最终的根都落在,前序是最左边,后序是最右边。
- 有了根的位置,结合中序遍历序列,这样做便可以得出答案(这里的(2)左划线的第一个节点是左子树的根节点,右划线第一个节点是右子树根节点,是针对先序来说的,因为先序顺序为:根、左、右。第一个节点就是某子树根,如果是后序就是线的末尾节点为某子树的根,因为是左、右、根)
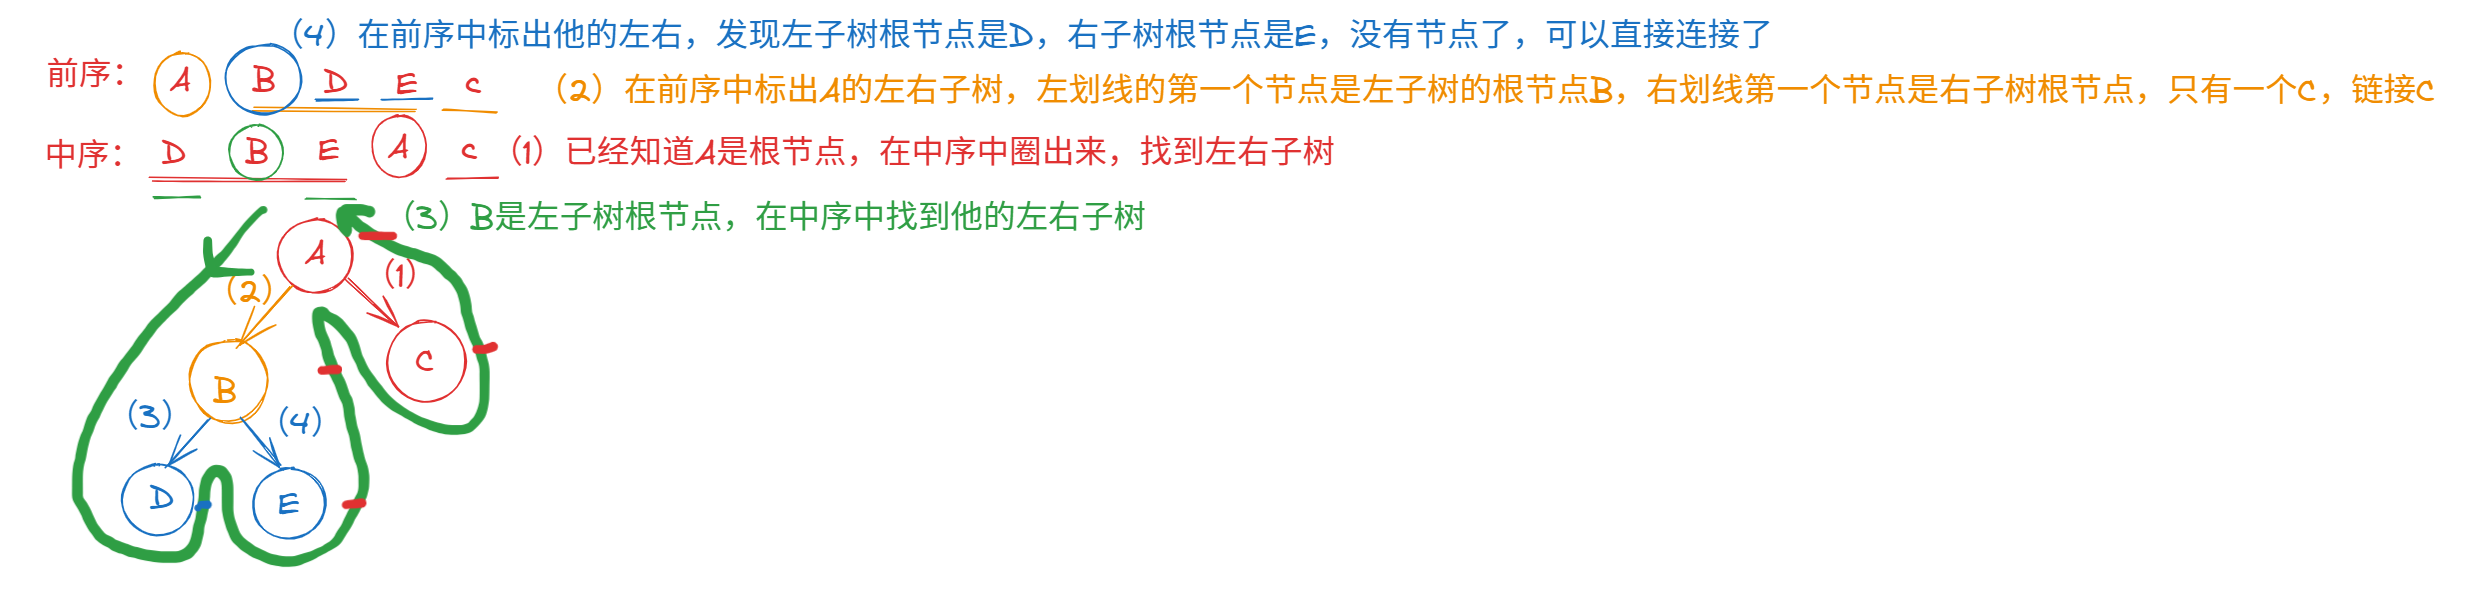
后序遍历的顺序即为线穿过红点的顺序:DEBCA
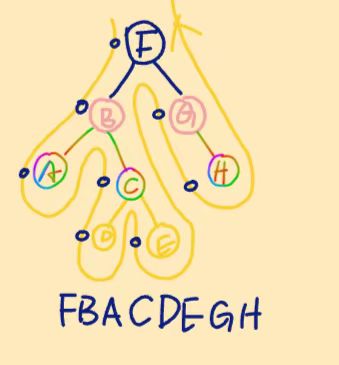
- 试一个难的:
它的先序遍历即为:
深度和广度
先大概了解一下深度和广度的意思,后续会将深度搜索和广度搜索。不会讲哈夫曼树了,他在工程里并不常用。
- 深度遍历:在上述我们讲解的过程中,发现前中后序的遍历过程都是一直往深处走,走到无路可走了便退回来,再往深处走,重复这个过程。
- 广度遍历:层序就是广度,以根为中心点一层一层的走。
其实单纯的二叉树、树,拿来存储数据和增删查改没有任何意义,如果纯粹的使用它做这些还不如用顺序表链表,后面讲的搜索二叉树、平衡搜索二叉树才有意义,实现高效搜索数据。二叉树需要结合一些性质去使用才更有意义奥,但是在这之前需要先将基本功学好,而且考试的角度会经常考经典的二叉树遍历,镜像,平衡二叉树等等普通的题,所以先做一点简单的二叉树OJ题
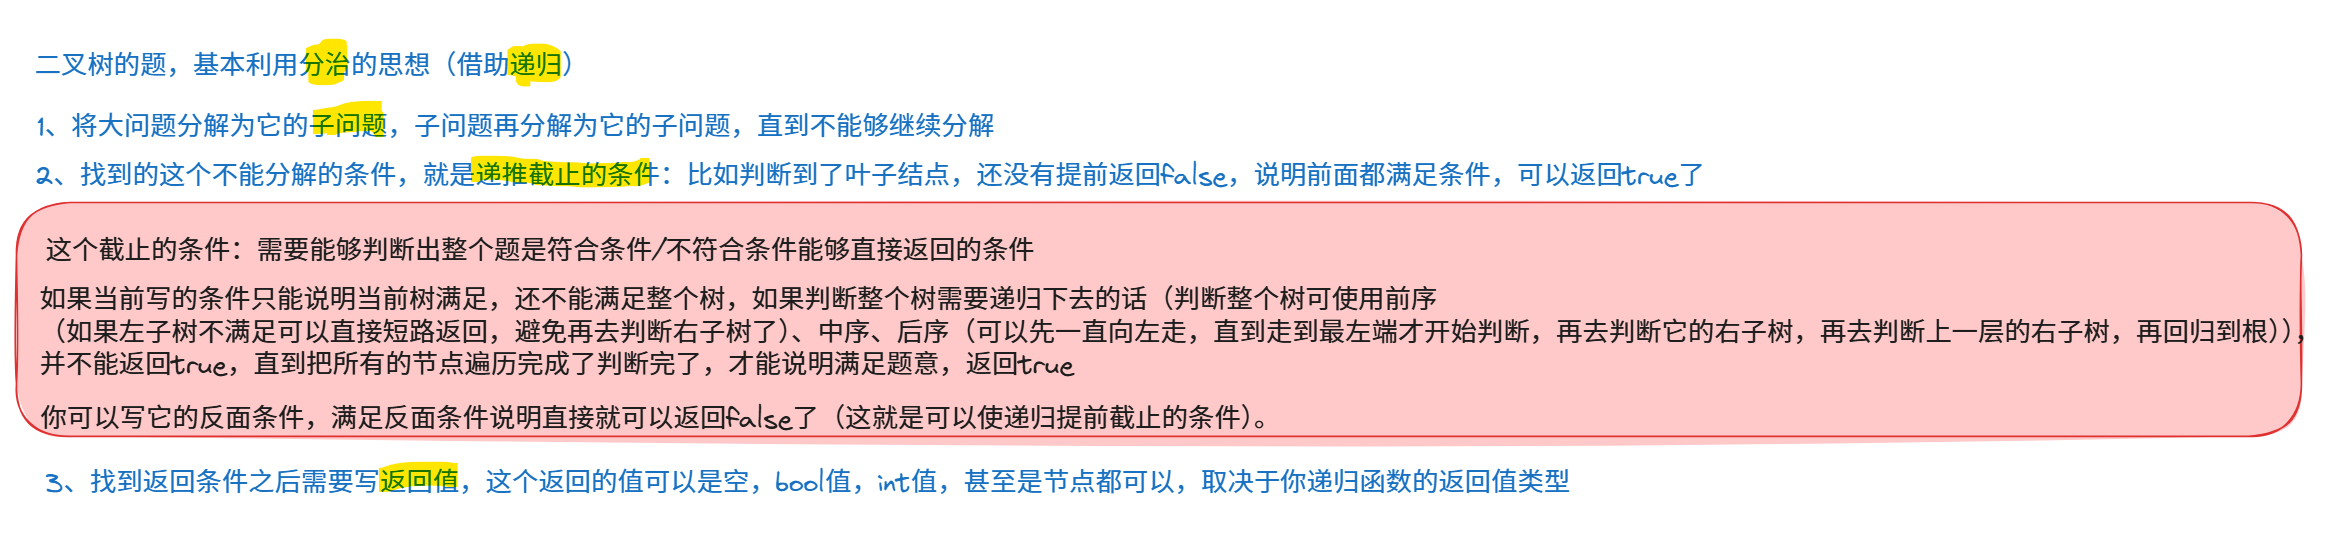
二叉树题常用思想:分治思想
可以先往后面看题,尝试做一些题后再来体会这个思想,这里相当于一个总结。
3、求完全二叉树的节点个数
- 遍历完全二叉树
首先第一个想到的办法必然是创建一个变量,然后遍历一次完全二叉树,将根节点数量累加到这个变量上
//方法一:遍历整棵树,遇到节点就加加到变量size上去
//二叉树节点的个数
int TreeSize(BTNode* root)
{
	if (root == NULL)//如果节点为空,就返回0
		return 0;
	//定义记录节点个数变量
	int size = 0;
	size++;
	TreeSize(root->_left);
	TreeSize(root->_right);
	//当前树的节点个数=它的左子树节点个数+它的右节点个数
	return size;
}
测试下方法:
//测试计算节点个数
printf("TreeSizeA = %d ",TreeSize(A));
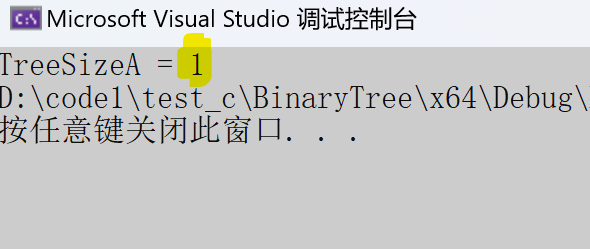
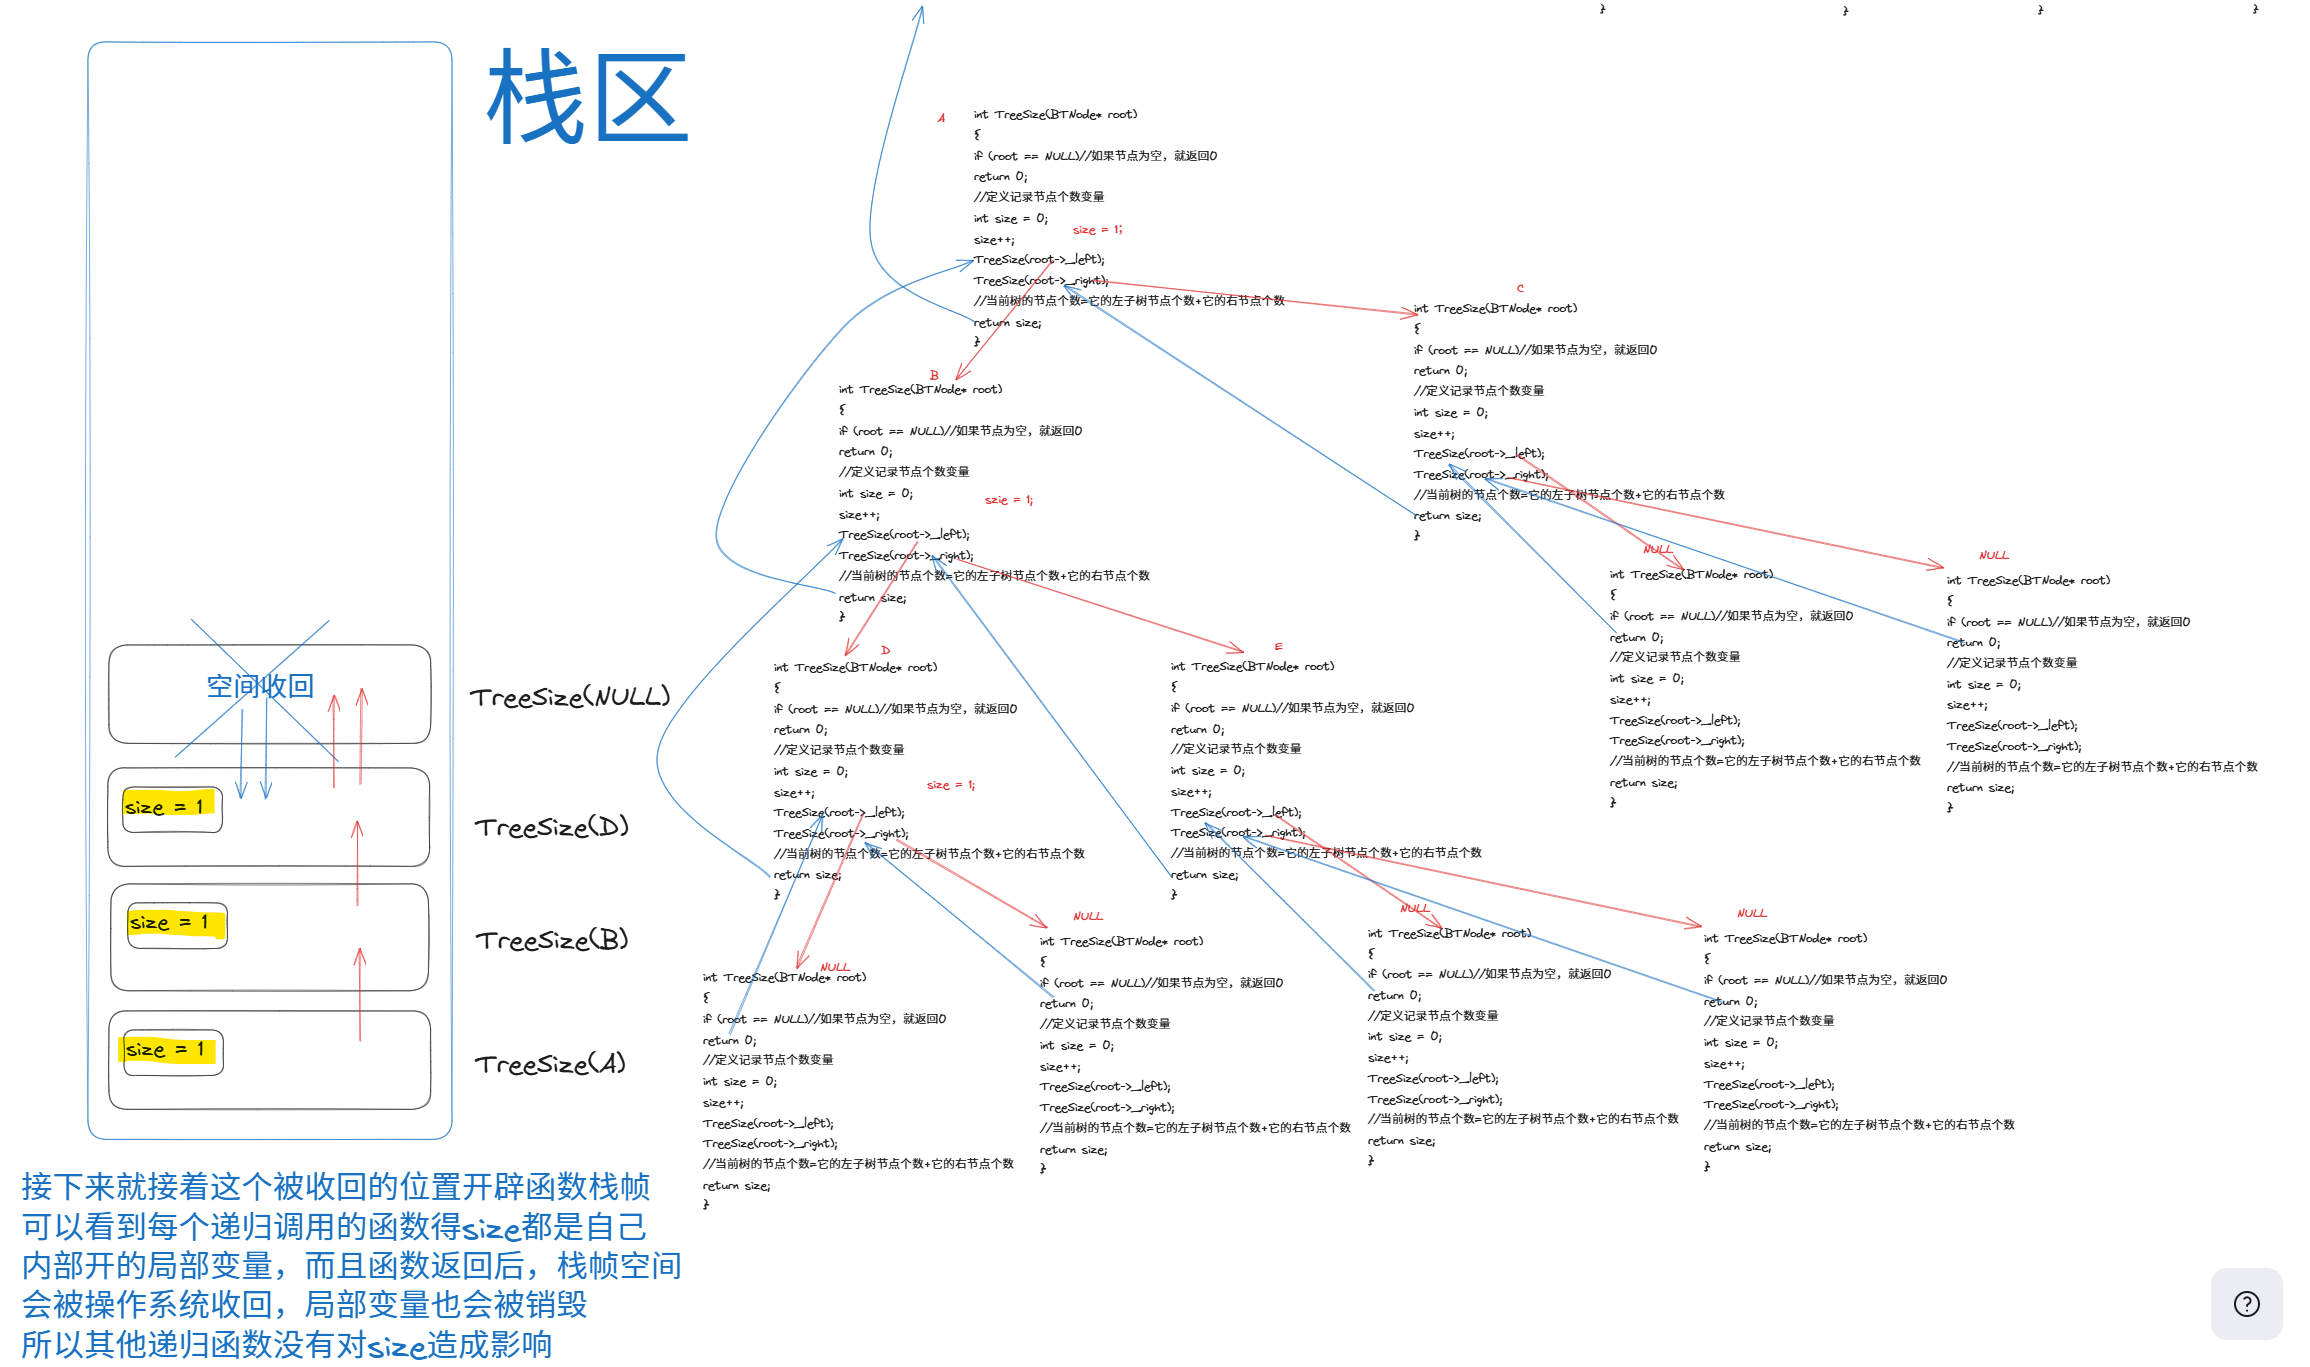
原因:size是一个局部变量,在每次递归时,size都会在当前函数栈帧中重新创建,这些size都不是同一个size,所以本质上并没有对size造成实际上的累加。
- 修改:
如果将size改成全局变量或静态变量,就可以将所有的size++都加到这个全局变量上了。
(1)int size = 0;
int treesize(btnode* root)
{
	if (root == null)//如果节点为空,就返回0
		return 0;
	//定义记录节点个数变量

	size++;
	treesize(root->_left);
	treesize(root->_right);
	//当前树的节点个数=它的左子树节点个数+它的右节点个数
	return size;
}

int treesize(btnode* root)
{
	if (root == null)//如果节点为空,就返回0
		return 0;
	//定义记录节点个数变量
	(2)static int size = 0;
	size++;
	treesize(root->_left);
	treesize(root->_right);
	//当前树的节点个数=它的左子树节点个数+它的右节点个数
	return size;
}
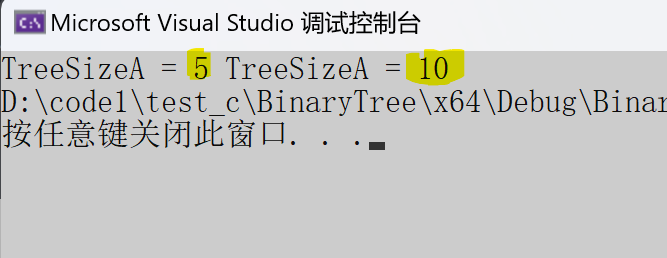
可是这样做也有弊端,如果这样去测试
这也算是全局变量的缺点,两次调用全部加在全局变量上,还有一种情况,比如多线程,你和我都在操作这个函数,那么size都会加在这个全局变量上。
//测试计算节点个数
printf("TreeSizeA = %d ",TreeSize(A));
printf("TreeSizeA = %d ", TreeSize(A));
- 如果是传递指针呢:
每次都将size的地址传进去,通过解引用找到size这块空间的位置,去修改size的值。这是可以做到的。
这种方法,是不是感觉有点别扭,一般不都是传进去结构,然后有一个返回值返回size,这还要先传进一个size,然后还没有返回值。
void TreeSize(BTNode* root,int* psize)
{
	if (root == NULL)//如果节点为空,就返回0
		return;
	//定义记录节点个数变量
	(*psize)++;
	TreeSize(root->_left,psize);
	TreeSize(root->_right,psize);
}
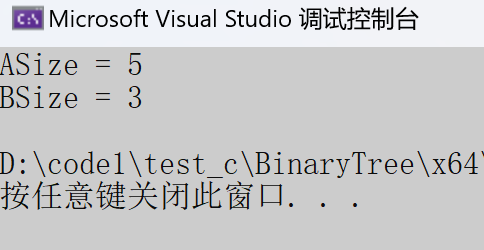
测试:
int size = 0;
int* psize = &size;
TreeSize(A, psize);
printf("ASize = %d\n", *psize);

*psize = 0;
TreeSize(B, psize);
printf("BSize = %d\n", *psize);
- (最正统)分治思想:将大问题划分成子问题解决,每个子问题的解决办法都和大问题的类似。
思路:如果是空树,那么节点数是0,返回0,完全二叉树的节点个数等于当前根节点+左子树节点个数+右子树节点个数。
int TreeSize(BTNode* root)
{
	if (root == NULL)
		return 0;
	return 1 + TreeSize(root->_left) + TreeSize(root->_right);
}
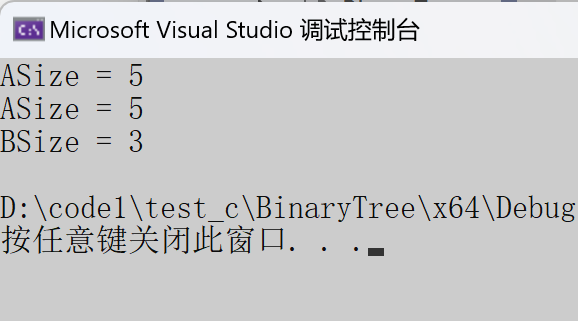
测试:
printf("ASize = %d \n", TreeSize(A));
printf("ASize = %d \n", TreeSize(A));
printf("BSize = %d \n", TreeSize(B));
运行:
代码实际运行:
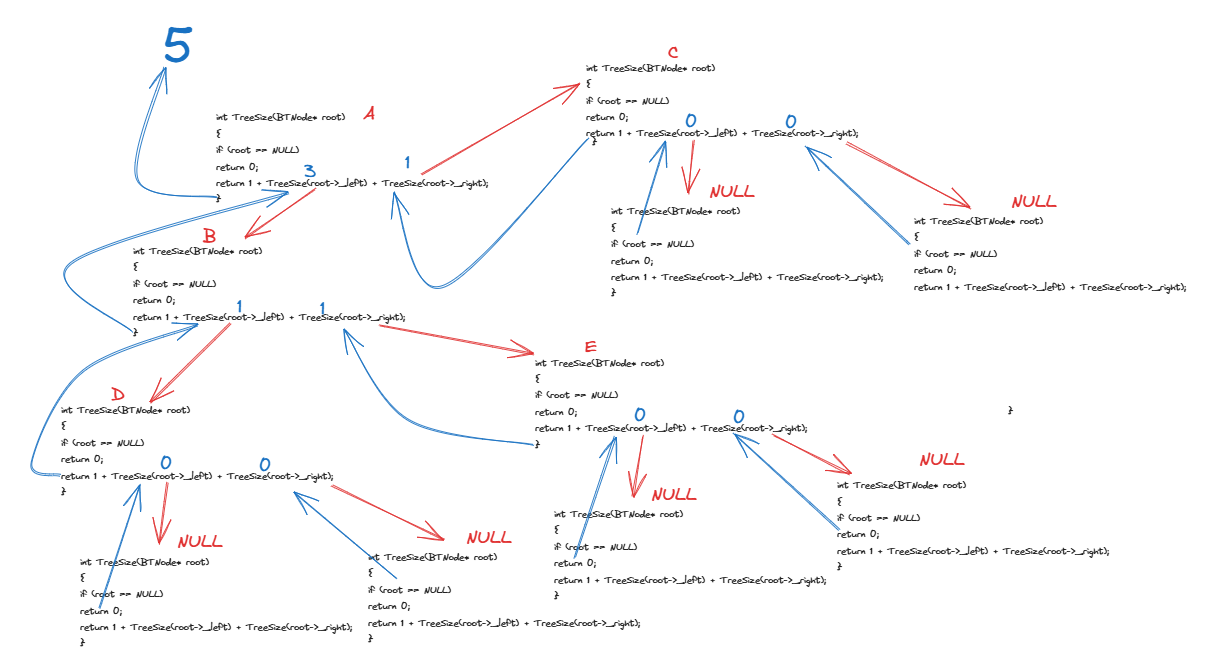
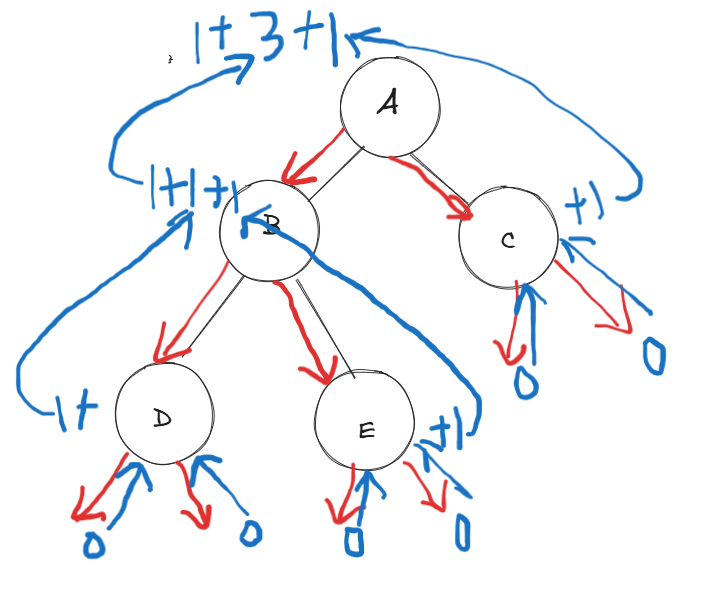
可以看到遍历的过程中如果就是当前节点加上左子树节点个数再加上右子树节点个数。
4、完全二叉树的叶子结点个数
只需要做一点小小的改动,叶子结点判定是:左子树为NULL,右子树为NULL。
思路:如果是空树,返回个数为0
如果是叶子节点,返回个数为1
如果是普通节点,继续递推,不做累加,反正推到叶子结点会返回的(递推的截止条件)。
//完全二叉树叶子节点个数
int TreeLeafSize(BTNode* root)
{
	if (root == NULL)
		return 0;
	if (root->_left == NULL && root->_right == NULL)
		return 1;
	return TreeLeafSize(root->_left) + TreeLeafSize(root->_right);
}
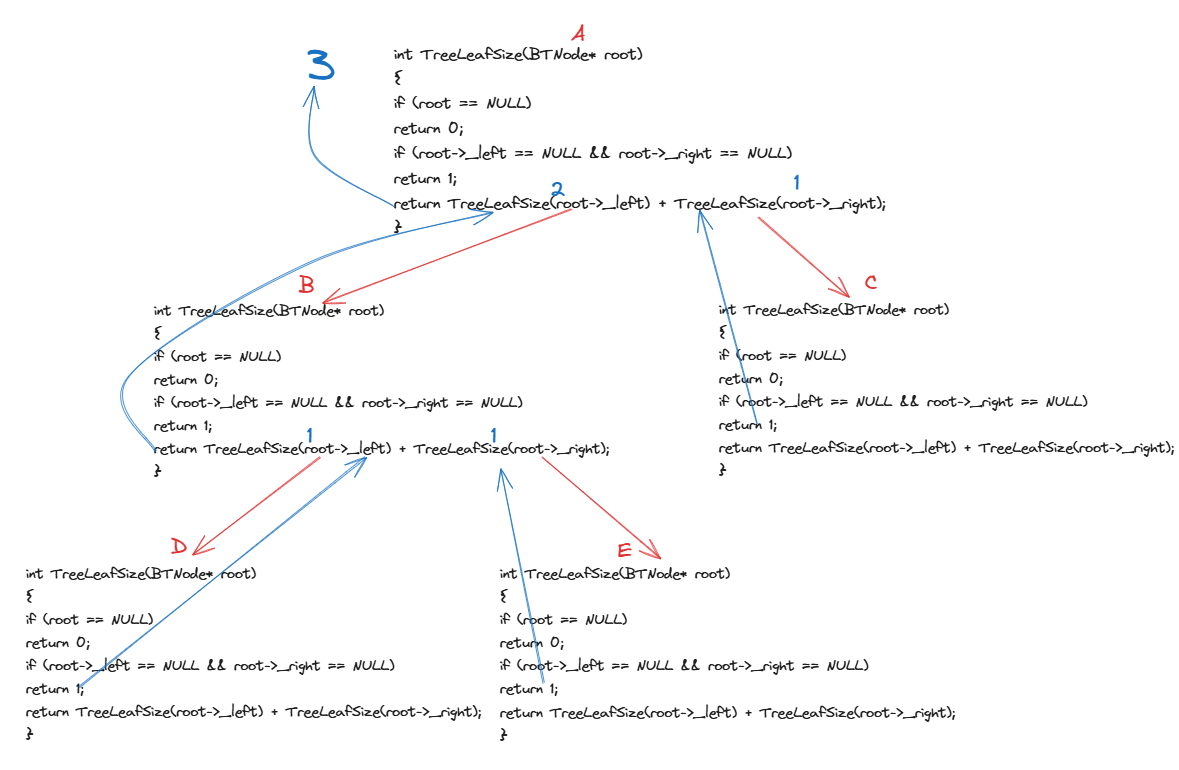
可以看到,这个过程中只是累加了该节点的左子树和右子树的叶子节点个数,如果是普通节点并没有计数,如果是空树会直接返回0。
5、二叉树的前序遍历
二叉树的前序遍历
首先,让我们看看这个题给的接口:
 * Note: The returned array must be malloced, assume caller calls free().
 */
int* preorderTraversal(struct TreeNode* root, int* returnSize) {

}
要求我们返回一个动态开辟的数组,并且还要修改输出型参数returnSize。
这个函数是不适合做递归的。所以需要自己先求出完全二叉树的节点个数(新开辟数组的大小),然后写个函数递归的将前序节点放入新开辟的数组空间中。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
/**
 * Note: The returned array must be malloced, assume caller calls free().
 */
int treeSize(struct TreeNode* root)//求完全二叉树节点个数
{
    /*如果是空树,节点个数为0,节点个数等于当前根节点+左子树节点个数+右子树节点个数*/
    if(root == NULL)
        return 0;
    return 1 + treeSize(root->left) + treeSize(root->right);
}

void inElements(int* nums,struct TreeNode* root,int* pi )
{
    /*存入数组nums,原数组root,下标pi,前序遍历:根、左子树、右子树,入数组顺序:根数据,左子树val入数组,右子树val入数组*/
    if(root == NULL)//空节点不入
        return;
    nums[(*pi)++] = root->val;//将非空节点的值放入数组中
    inElements(nums,pi,root->left);
    inElements(nums,pi,root->right);
}
int* preorderTraversal(struct TreeNode* root, int* returnSize) {
    //开辟数组空间,用于存储二叉树前序遍历节点
    int n = treeSize(root);//首先我们要算出开多少个空间,也就是完全二叉树的节点个数
    int* treenums = (int*)malloc(sizeof(int)* n);
    int i = 0;//定义存入数组下标记录,由于下标是需要更改的,所以传递地址进去
    inElements(treenums,root,&i);
    *returnSize = n;//最终二叉树节点个数为n
    return treenums;
}
inElements不理解的可以自己代码递归的图奥,和我们上面的先序遍历是一样的,只是把那句打印root->val,换成了将root->val放入新的数组。
其实就是先序遍历,先将根节点数据放入数组,然后左子树节点放入数组,再右子树节点放入数组。
递归题的小tip
这里有一个我自己做这种递归题的一个小技巧:既然写出了这个递归函数,就要相信它可以实现你想要的功能,至于它怎么实现的,先不要管,就相信它能做到,先把逻辑写出来。在分析代码化代码递归图检查逻辑是否有错误。
比如:
int treeSize(struct TreeNode* root)//求完全二叉树节点个数
{
    /*如果是空树,节点个数为0,节点个数等于当前根节点+左子树节点个数+右子树节点个数*/
    if(root == NULL)
        return 0;
    return 1 + treeSize(root->left) + treeSize(root->right);
}
求完全二叉树的节点个数:(二叉树的题尽量都把他们拆解成根、左子树、右子树的维度,如果走递归就想是前序、中序、后序等)
- 空树,节点个数为0,如果走到空节点,个数也记为0。
if(root == NULL)
return 0;
- 完全二叉树节点个数 == 当前根节点+左子树节点个数+右子树节点个数
1 + treeSize(root->left) + treeSize(root->right);
1、treeSize(root->left):treeSize这个函数我是相信它能做到求完全二叉树节点的个数的,所以我把当前节点的左子树根节点传进函数,来求左子树这颗完全二叉树的节点个数。
2、treeSize(root->right):treeSize这个函数我是相信它能做到求完全二叉树节点的个数的,所以我把当前节点的右子树根节点传进函数,来求右子树这颗完全二叉树的节点个数。
3、return:最终节点个数求出来要作为返回值返回。
小练习:如果我想顺序的从高位到低位输出一个整数的每一位,怎么使用递归?
首先我们需要将大问题拆解成子问题:
除以10== 去掉最后一位
取模10 == 取出最后一位
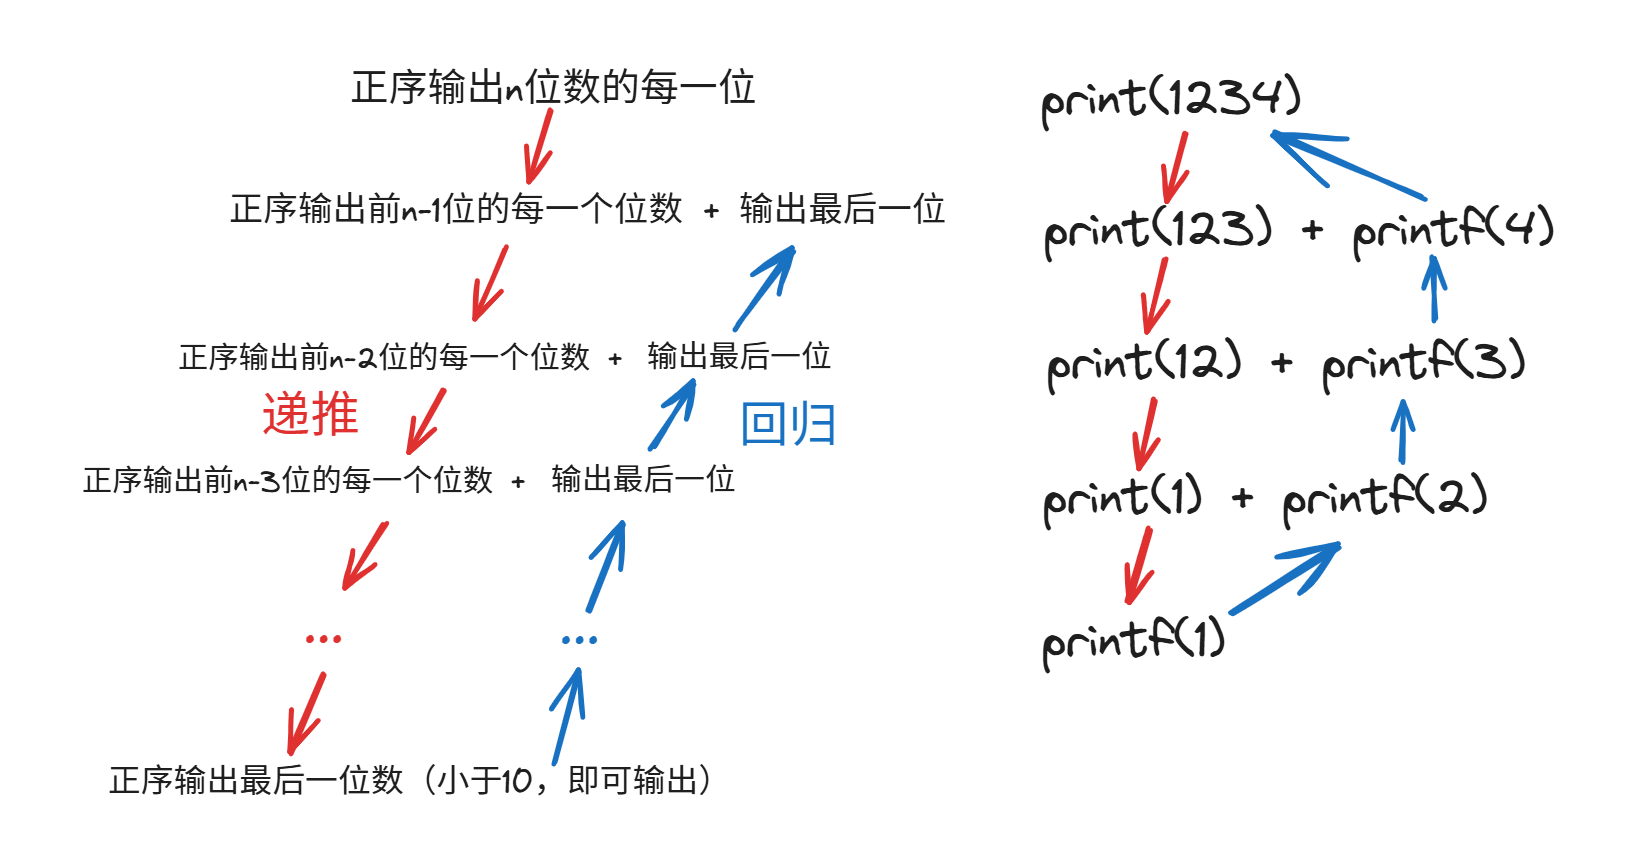
1、如果数大于一位数,就继续递归,传入去掉最后一位的num/10。
2、直到一位数,然后回归,每次都打印num%10的最后一位即可,由于小于10的数%10是本身,直接把逻辑合并了。
void print(int num)
{
	if (num >9)
		print(num / 10);
	printf("%d ", num % 10);
}
这里我就是相信print有拆解前n-1位数,和最后一位的能力,每一次传进去掉一位的值给print,然后在输出这个取模10得到的最后一位数。
另一种思路
- 可以看到递推截止条件是num<10。
- 否则就继续递归,每次都传入是num/10的数,然后再输出num%10的数。
void print(int num)
{
	if (num < 10)//如果小于10,直接输出
		printf("%d ", num);
	else//否则就递归
	{
		print(num / 10);//每次传入num/10
		printf("%d ", num % 10);//之后打印num%10的最后一位数
	}
}
6、中序
二叉树的中序遍历
思路和前序一样,大家可以自己默写加深印象奥,只是代码顺序变了一行而已。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
/**
 * Note: The returned array must be malloced, assume caller calls free().
 */
 int treeSize(struct TreeNode* root)
{
    if(root == NULL)
        return 0;
    return 1+treeSize(root->left)+treeSize(root->right);
}
void InElements(int* nums,struct TreeNode* root,int* pi)
{
    if(root == NULL)
        return;
    InElements(nums,root->left,pi);
    nums[(*pi)++] = root->val;
    InElements(nums,root->right,pi);
}
int* inorderTraversal(struct TreeNode* root, int* returnSize) {
    int n = treeSize(root);
    int* treenums = (int* )malloc(sizeof(int)*n);
    int i = 0;
    InElements(treenums,root,&i);
    * returnSize = n;
    return treenums;
}
7、后序
二叉树的后序遍历
思路和前序一样,大家可以自己默写加深印象奥,只是代码顺序变了一行而已。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
/**
 * Note: The returned array must be malloced, assume caller calls free().
 */
 int treeSize(struct TreeNode* root)
{
    if(root == NULL)
        return 0;
    return 1+treeSize(root->left)+treeSize(root->right);
}
void InElements(int* nums,struct TreeNode* root,int* pi)
{
    if(root == NULL)
        return;
    InElements(nums,root->left,pi);
    InElements(nums,root->right,pi);
    nums[(*pi)++] = root->val;

}
int* postorderTraversal(struct TreeNode* root, int* returnSize) {
    int n = treeSize(root);
    int* treenums = (int* )malloc(sizeof(int)*n);
    int i = 0;
    InElements(treenums,root,&i);
    * returnSize = n;
    return treenums;
}
8、二叉树的最大深度
- 如果是空树,深度为0
- 如果是叶子节点,深度为1
- 其余节点作为根节点当前子树的高度 = 左子树和右子树中高度大的那个+1
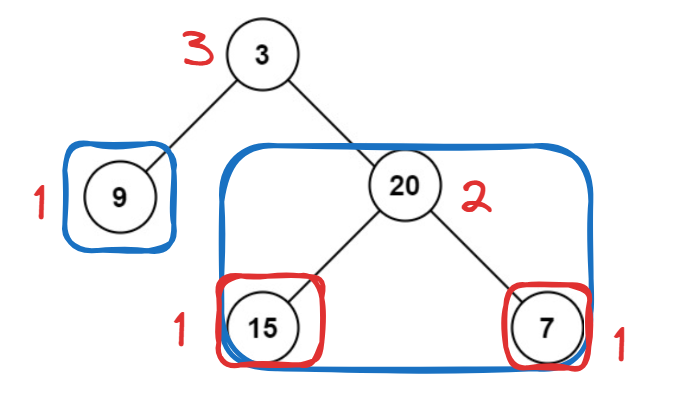
根据思路我们可以写出这样的代码:
int maxDepth(struct TreeNode* root) {
    if(root == NULL)
       return 0;
    if(root->left == NULL&& root->right == NULL)
        return 1;
    return maxDepth(root->left) > maxDepth(root->right)? maxDepth(root->left)+1:maxDepth(root->right)+1;
}
leetcode给了一个超大的测试用例,算法超时了
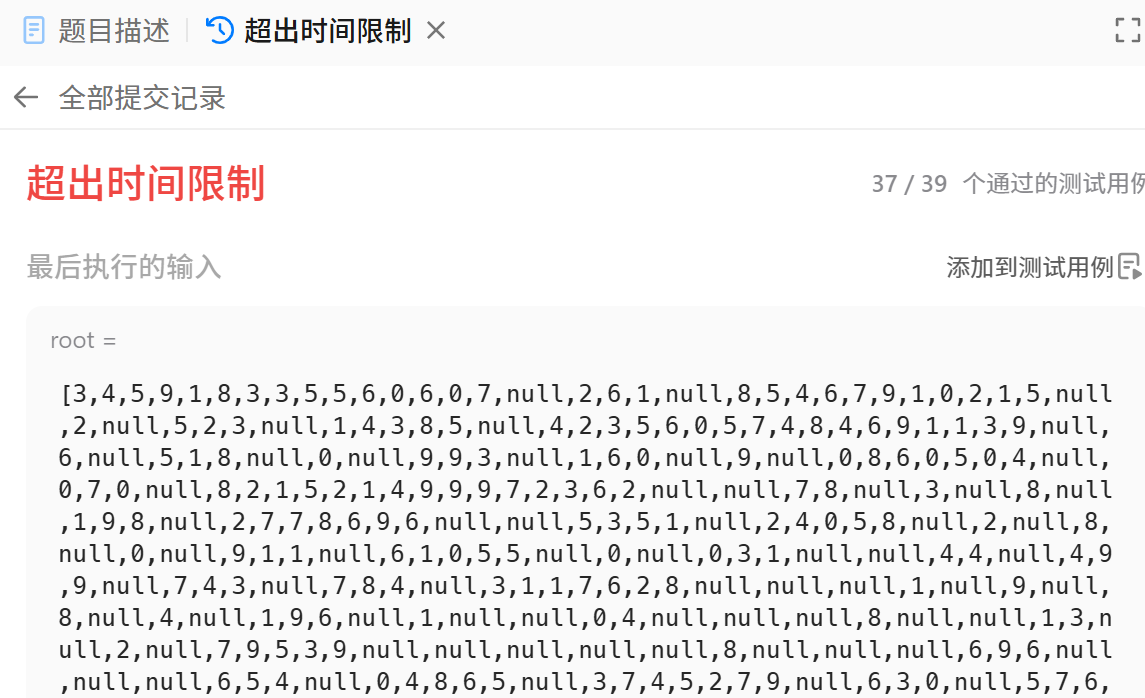
分析原因:
maxDepth(root->left) > maxDepth(root->right)? maxDepth(root->left)+1:maxDepth(root->right)+1; 由于三目操作符的原因,导致我们比较完maxDepth(root->left) > maxDepth(root->right)得出个结果,比如左大,但是并没有保存左的深度,因此走到maxDepth(root->left)+1表达式计算的时候,又会计算一遍左子树的深度再加1,作为结果返回值。**因此每一次递归调用都会计算两遍较大的那个子树的深度。**导致算法超出时间限制。
修改:保存左的深度和右的深度,再去比较,然后对深度大的加1作为结果值返回。
int maxDepth(struct TreeNode* root) {
    if(root == NULL)//如果是空树,深度为0
       return 0;
    if(root->left == NULL&& root->right == NULL)//如果是叶子节点,深度为1
        return 1;
    //其余节点作为根节点当前子树的高度 = 左子树和右子树中高度大的那个+1
    int left = maxDepth(root->left);
    int right = maxDepth(root->right);
    return left > right? left+1:right+1;
}
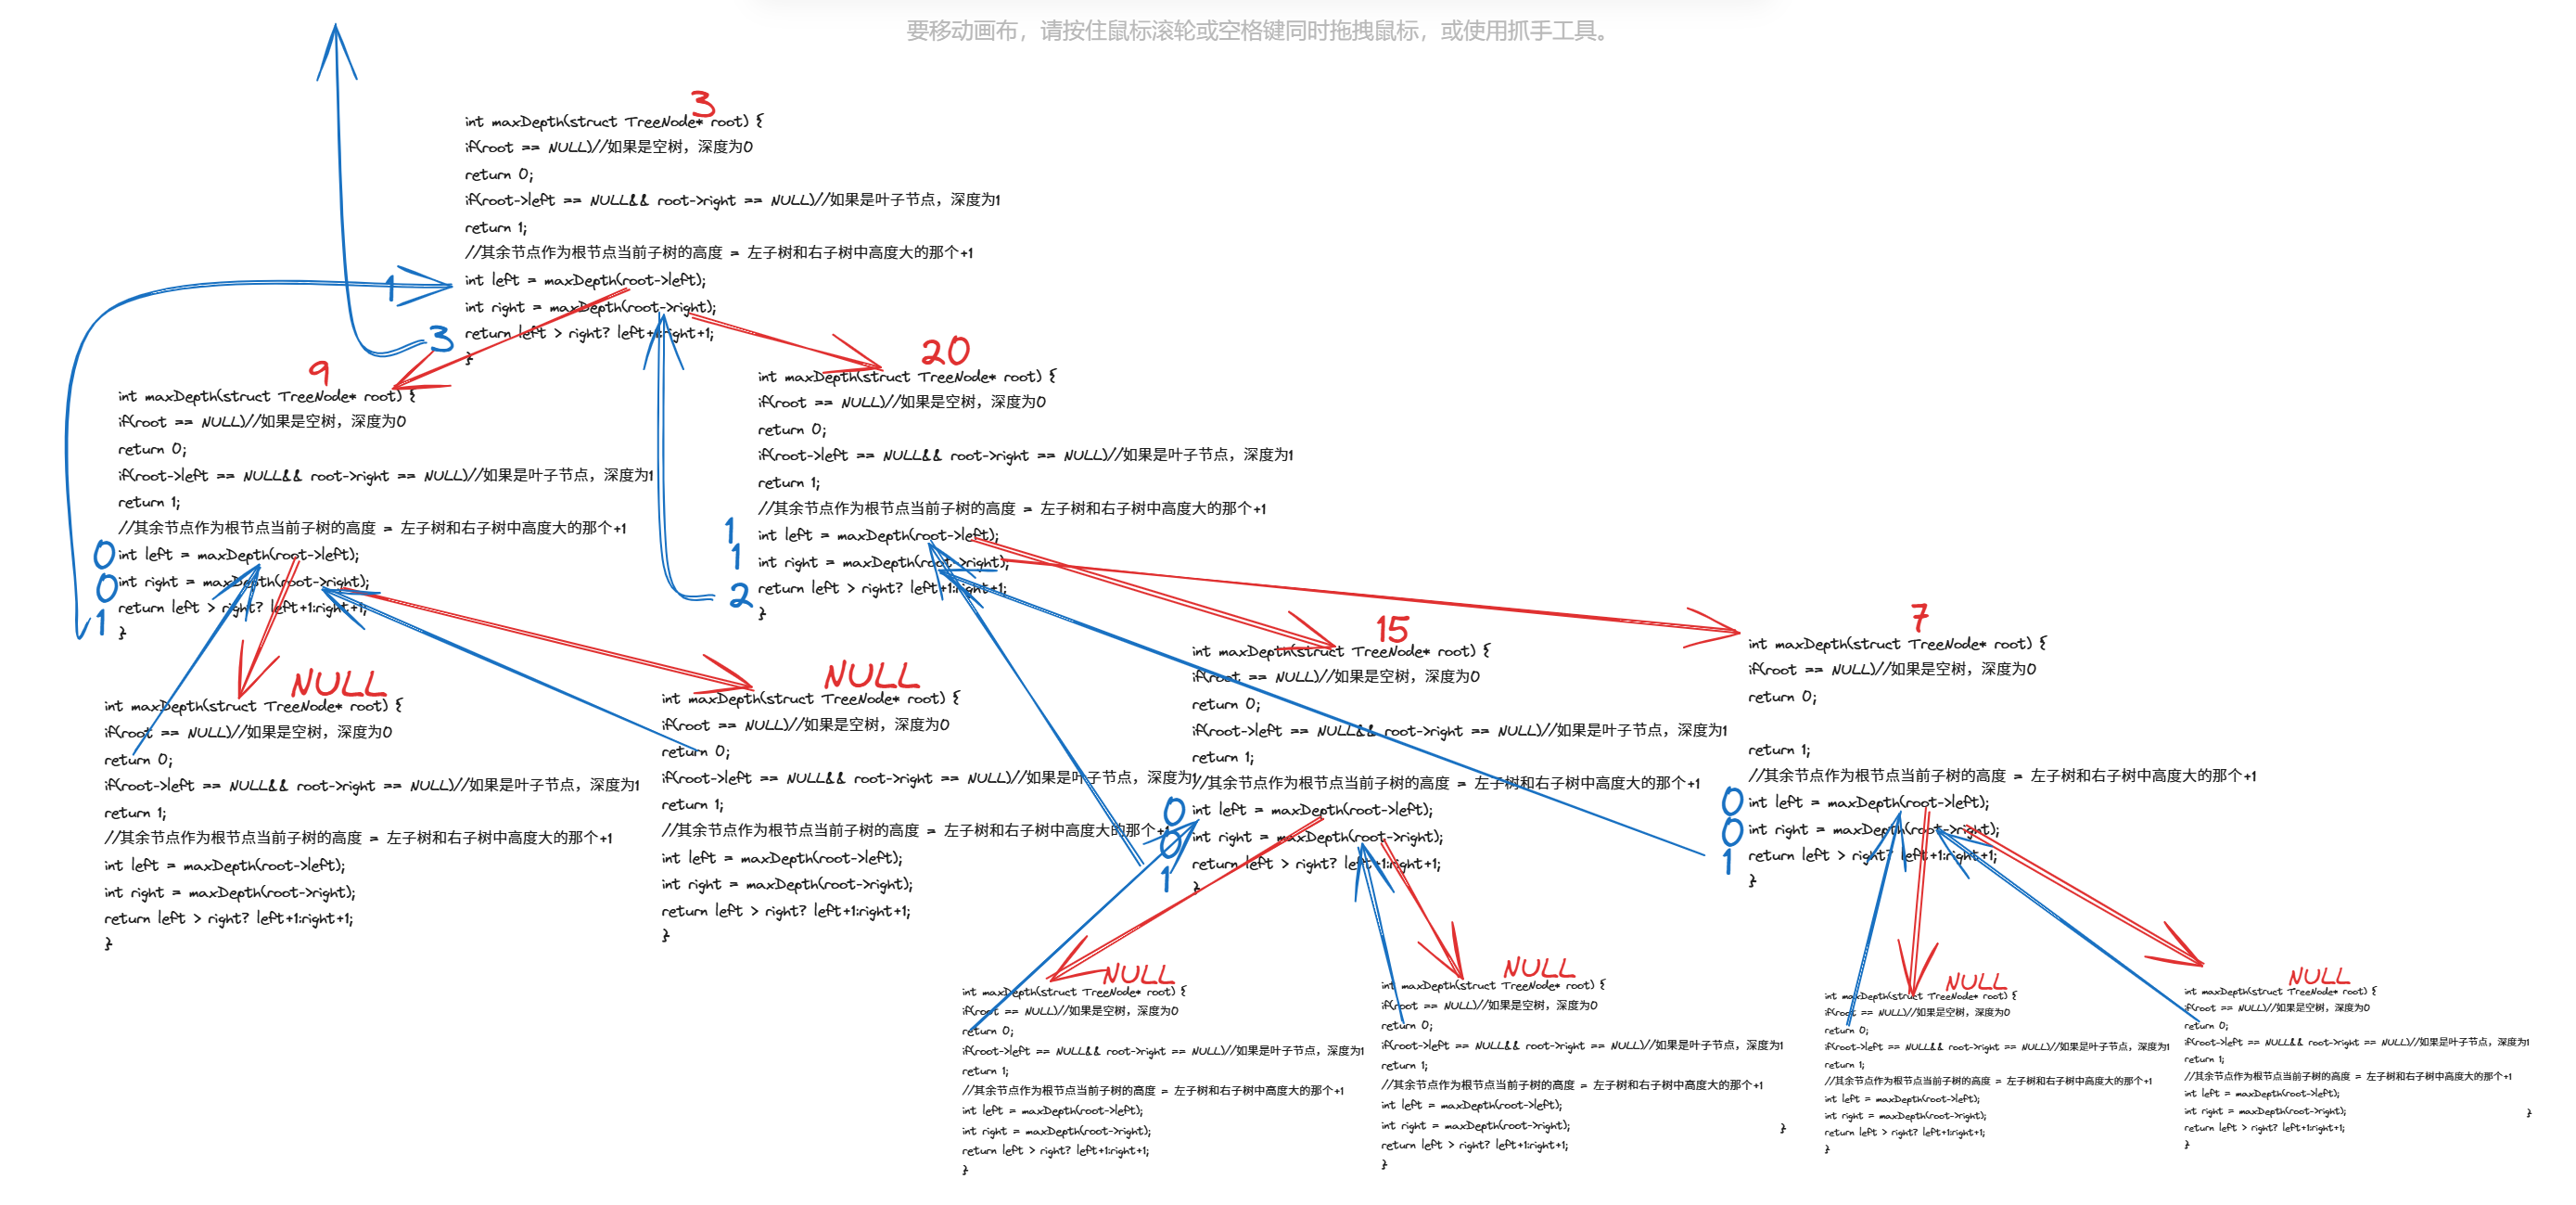
建议小伙伴们如果不能够理解代码,多多画递归的图,博主就是画了好多遍,之后就可以用眼睛看出递归的过程,初步判断算法的对错和写代码逻辑啦。
如果想使用软件可以使用博主画图的软件,免费但是注意画的图很容易丢失而且找不回,需要及时保存,菜鸟绘图。
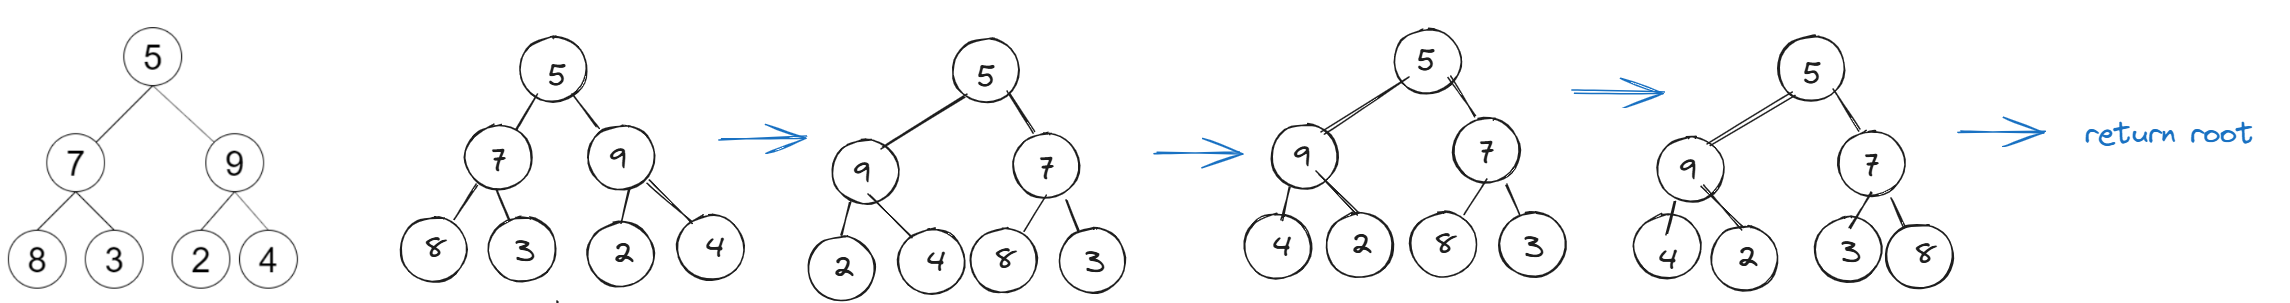
9、翻转二叉树
这题有的地方也会叫他镜像二叉树
思路一:这样做就没有借助它的返回值,直接采用先序遍历思想,先根,在处理左子树、右子树。
- 空树返回NULL。
- 将所有的左右子树互换位置
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
struct TreeNode* flipTree(struct TreeNode* root) {
    if(root == NULL)
        return NULL;
    //当前节点的左右节点互换
    struct TreeNode* tmp = root->left;
    root->left = root->right;
    root->right = tmp;
    //左子树的节点左右互换
    flipTree(root->left);
    //右子树的节点左右互换
    flipTree(root->right);
    return root;
}
思路二:
借助返回值的后序遍历:
4. 空树返回空
5. 将左子树连接到右子树上
6. 右子树链接接到左子树上
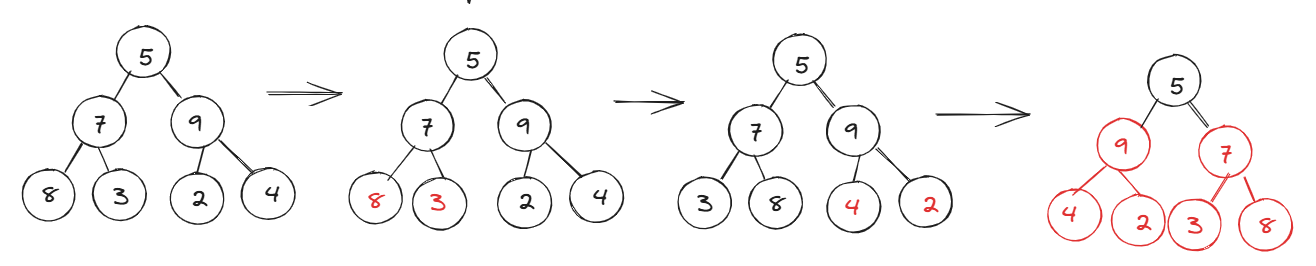
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
struct TreeNode* flipTree(struct TreeNode* root) {
    if(root == NULL)
        return NULL;
    //将左子树连接到右子树上
    struct TreeNode* right = root->right;//先存一下右子树的根节点
    root->right = flipTree(root->left);//将处理好的左子树连接到右子树的位置上
    root->left = flipTree(right);//将处理好的右子树连接到左子树的位置上
    return root;
}
10、相同的树
相同的树
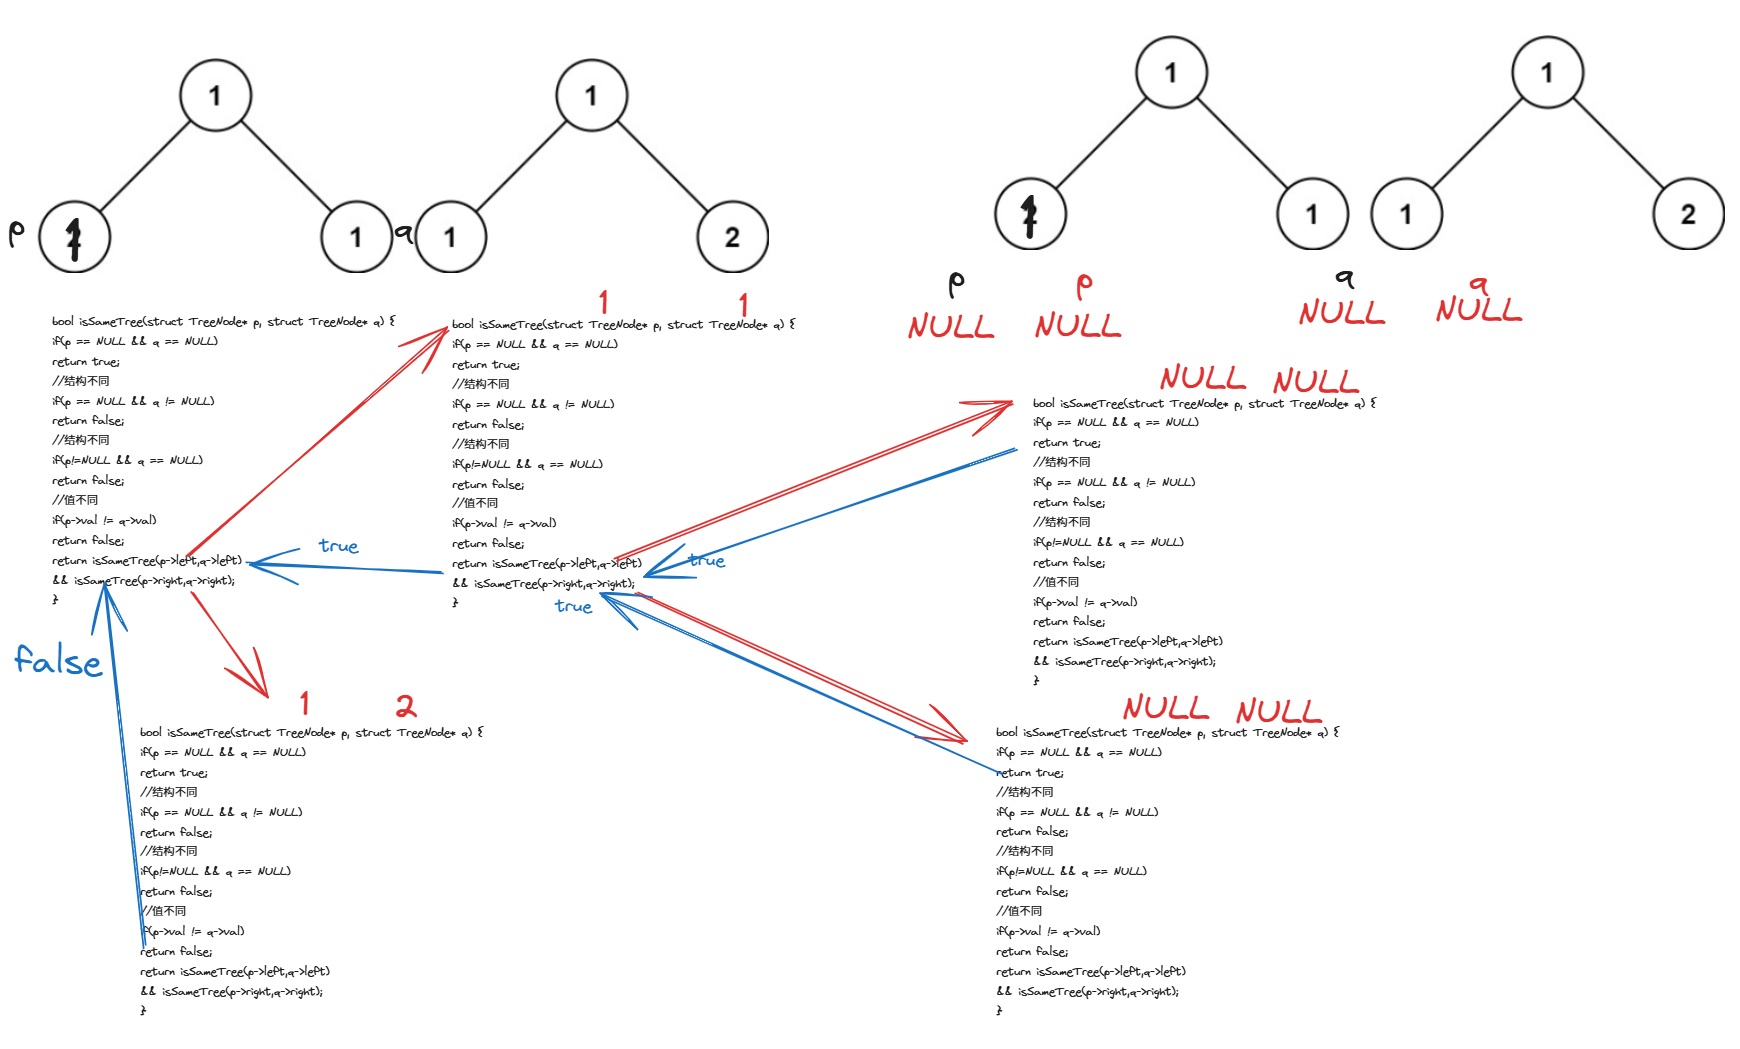
思路:
- 空树返回true,认为相等
也可以是递归到根节点前面都没有返回false,说明前面的节点都是相同的,返回true - 结构不同,返回false
- 值不同,返回false
- 递归左子树、右子树判断是否满足相同二叉树条件
这里原本我是想写结构相同并且值相同就返回true的逻辑,但是你想嘛,当前节点满足这个就直接是满足了嘛?你还要递归下去左子树和右子树也满足,所以换种思路,写反的逻辑更好,如果结构不同或是值不同,能够无所顾虑的直接返回false。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
bool isSameTree(struct TreeNode* p, struct TreeNode* q) {
    //空树返回true,认为相等
    //也可以是递归到根节点前面都没有返回false,说明前面的节点都是相同的,返回true
    if(p == NULL && q == NULL)
        return true;
    //结构不同
    if(p == NULL && q != NULL)
        return false;
    //结构不同
    if(p!=NULL && q == NULL)
        return false;
    //值不同
    if(p->val != q->val)
        return false;
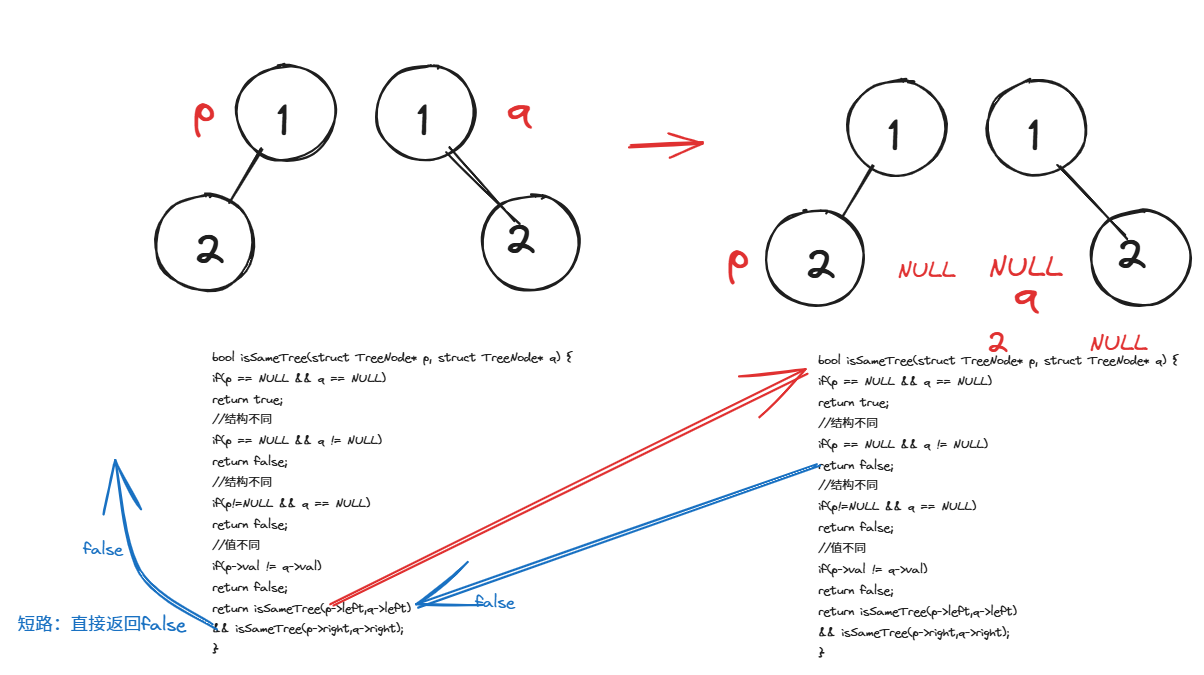
    //走到这里没成false说明当前节点相同,再递归下去检查左子树是否相同
    //如果左子树不相同返回了false,那就不需要再检查右子树了,&& 就短路了为false
    //相当于先序遍历,根、左子树、右子树
    return isSameTree(p->left,q->left)
    && isSameTree(p->right,q->right);
}
11、单值二叉树
单值二叉树
思路:
- 首先空树返回true
- 每个节点的左孩子或者右孩子如果不是空,他们的值都得和根节点一致,否则就返回false说明不是单值二叉树。
这里有个小tip:本来我是想写,左孩子或者右孩子如果不是空,他们的值得和根节点一致返回true的逻辑,但是你想,满足这一个节点的左孩子值、右孩子值一样就是单值二叉树了嘛,还要满足下面的节点,所以我们写与其相反的逻辑,如果有不同,就返回false。
- 检查完根节点,检查左子树、右子树。(先序遍历)
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
bool isUnivalTree(struct TreeNode* root) {
   //空树返回空
   //如果走到叶子结点根的左右孩子都相同,中途没有返回false,即返回true
   if(root == NULL)
        return true;
    //如果左节点不为空,就判断其和根节点值是否相同
    if(root->left != NULL && root->val != root->left->val  )
        return false;
    //如果右节点不为空,就判断其和根节点值是否相同
    if(root->right != NULL && root->val != root->right->val)
        return false;
    return isUnivalTree(root->left) && isUnivalTree(root->right);
}
12、对称二叉树
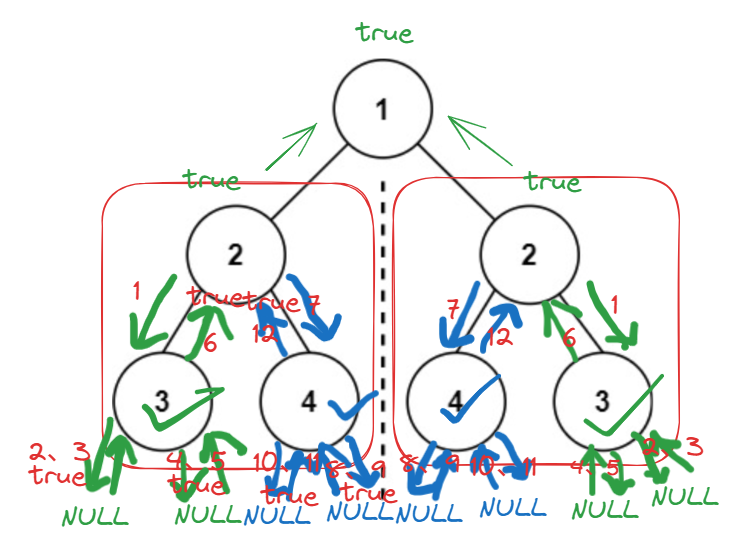
这道题emm是第一个杭哥没讲,我自己想出来的,记录一下~,建议大家多多练习,这样会形成系统性思维,比如这道题我就复用了上面讲的相同二叉树的代码和思想。如果大家有更好的办法,欢迎在评论区留言给我奥
思路:
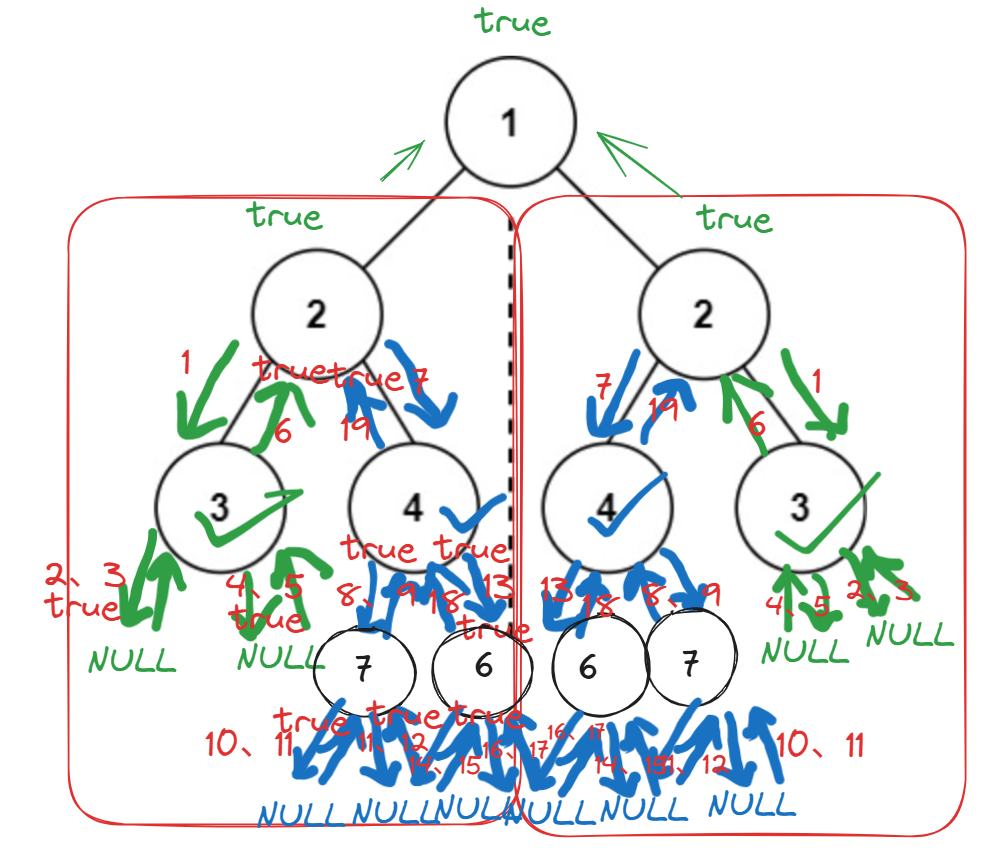
- 先将整颗二叉树看做根,左部分,右部分
- 可以看出,左部分的每个节点作为根的左孩子== 右部分每个节点作为根的右孩子。
还是先序逻辑,先比较当前根节点否相同,然后先递归左部分传的左孩子与右部分传的右孩子作比较。之后再比较左部分的右子树,右部分的左子树(它的内部其实每次还是先比较左部分的左孩子和右部分的右孩子)。
主逻辑就可以先这样写着:
bool isSymmetric(struct TreeNode* root) {
    if(root == NULL)//空树认为是对称的
        return true;
    //分为根,左右部分,拿左部分和右部分作对比
    return (leftEqualright(root->left,root->right));
}
- (递归)左部分先递归左子树,右部分先递归右子树,节点完全相同走到NULL,中途不返回false,即最终返回true。之后再递归左部分右子树,右部分的左子树(它的内部其实每次还是先比较左部分的左孩子和右部分的右孩子),如果也完全相同也会返回个true,最终两者归根,返回值为true就说明是对称二叉树。
由于题中给的接口
bool isSymmetric(struct TreeNode* root)
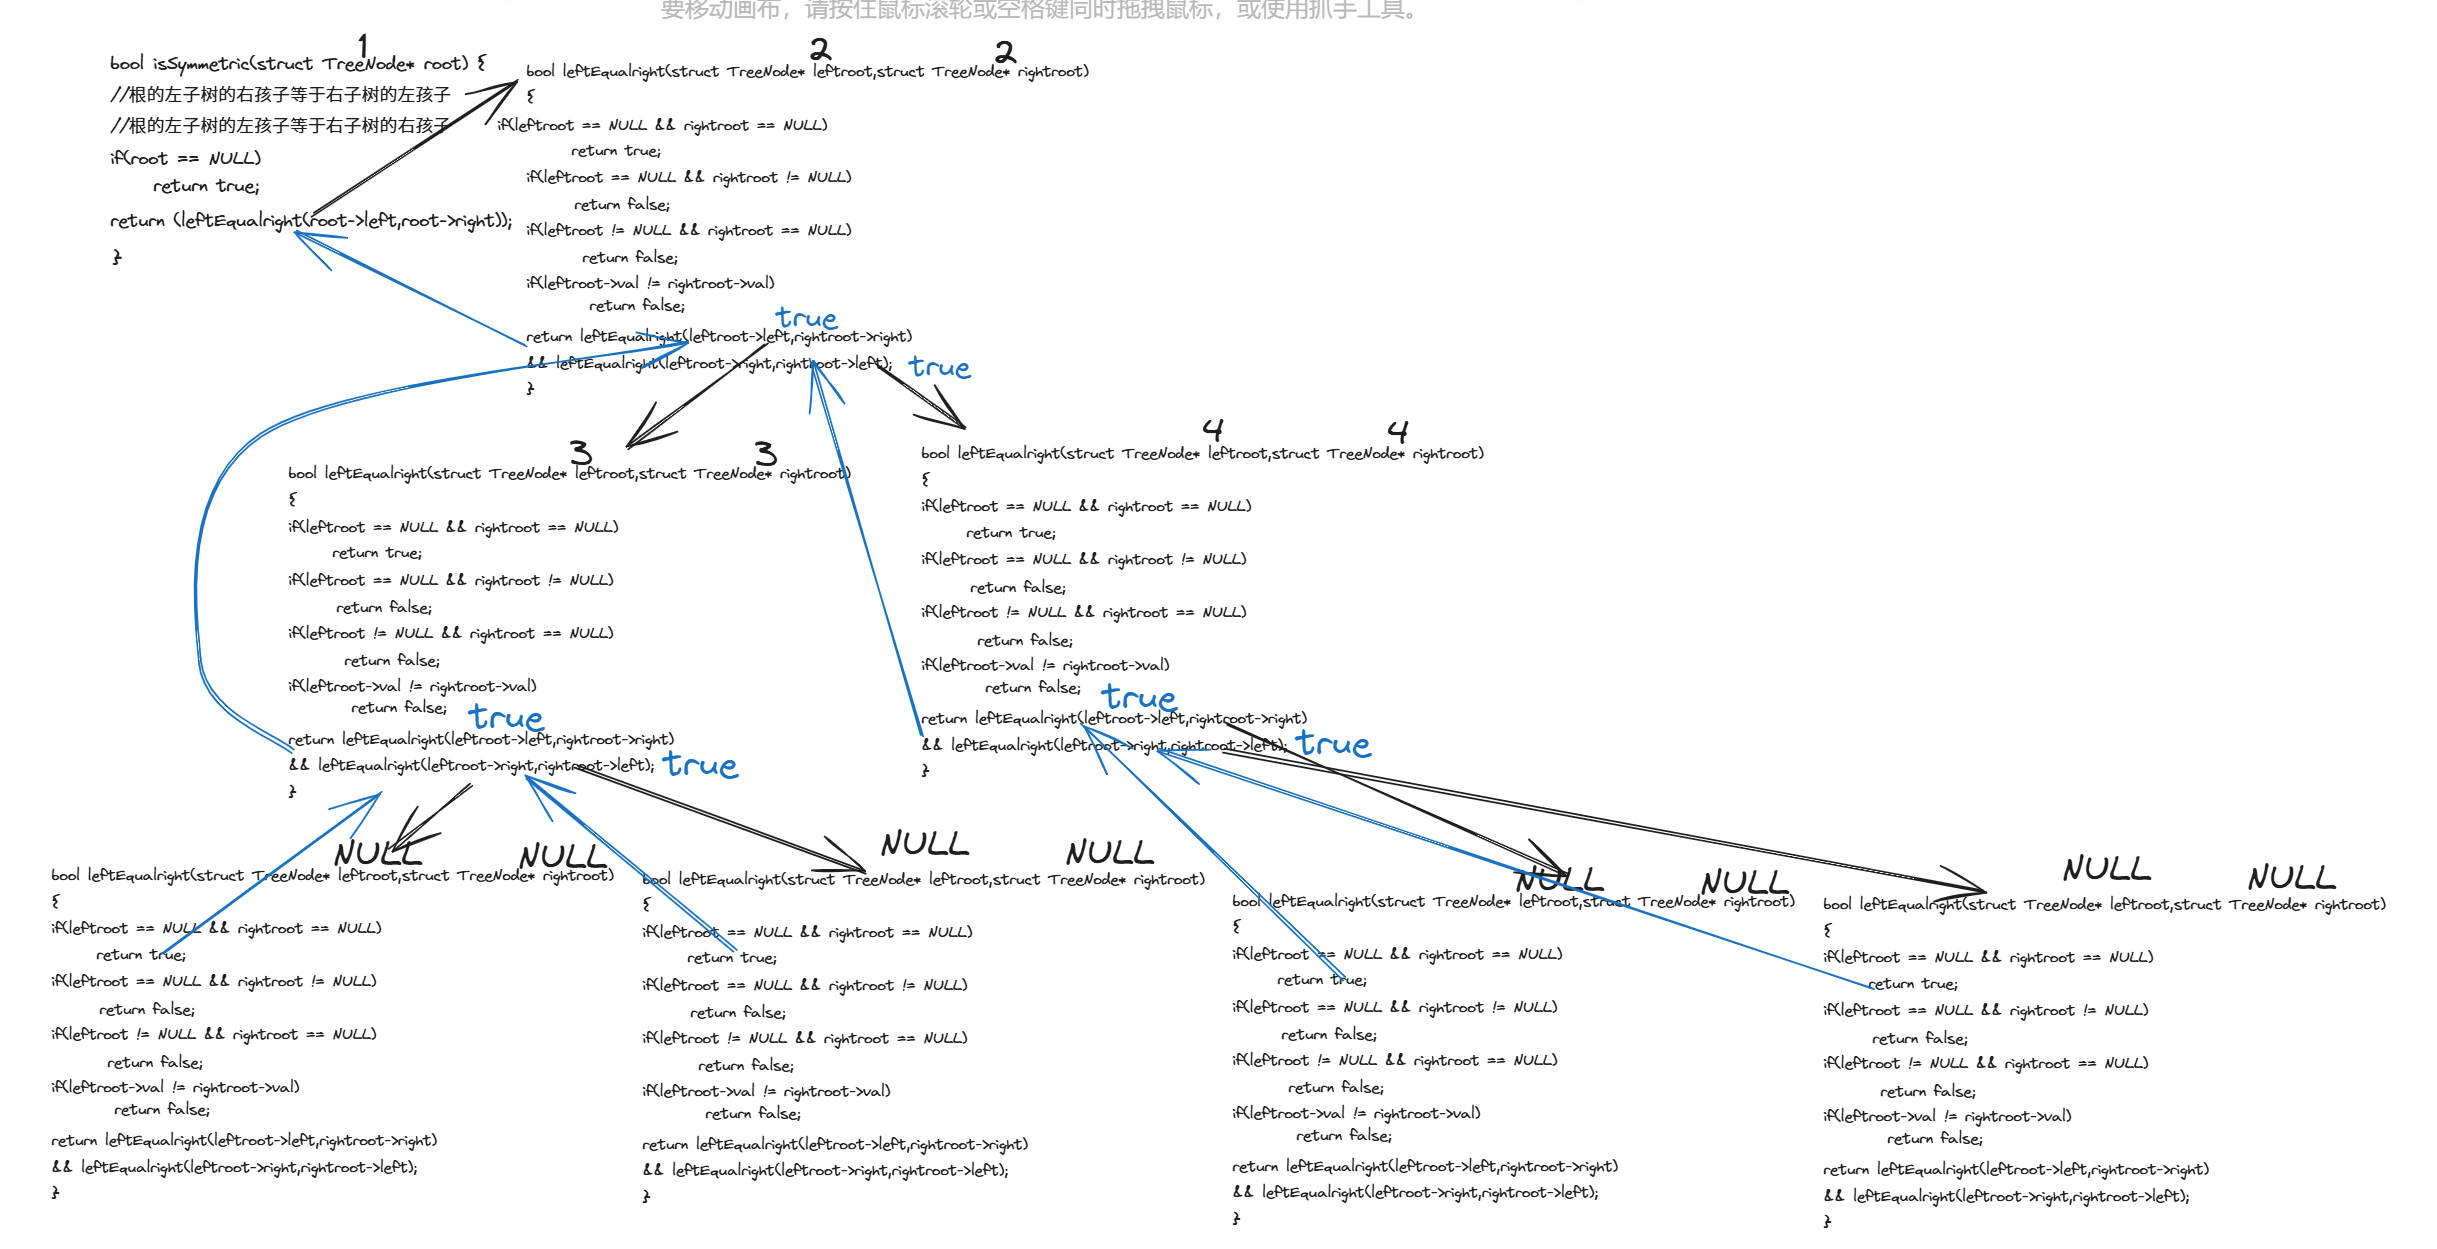
只给了一个根,这是不好做递归的,让左子树根节点向左走,右子树根节点向右走,需要传递左子树左孩子,右子树右孩子,所以自己写一个函数传进二叉树根的左右节点开始递归。然后比较节点是否相同(相同树的代码逻辑),相同为true,否则为false,调用完这个比较函数的返回值就是结果。
bool leftEqualright(struct TreeNode* leftroot,struct TreeNode* rightroot)
 {
    //判断节点是否相同
    //递归一直走到最后,中途没有返回false,走到节点为空了,说明值相同结构也相同开始返回个true。或者理解成左子树和右子树根节点为空,直接返回true,认为是对称二叉树
    if(leftroot == NULL && rightroot == NULL)
        return true;
    //结构不同
    if(leftroot == NULL && rightroot != NULL)
        return false;
    //结构不同
    if(leftroot != NULL && rightroot == NULL)
        return false;
    //值不同
    if(leftroot->val != rightroot->val)
        return false;
    //先左部分左走,右部分右走,如果这里有不相同直接短路最终返回false,都不用继续向下判断。在判断左部分右走,右部分左走节点是否都相同
    //(这里面还是先左部分左走,右部分右走,再左部分右走,右部分左走判断)递归就是这样,子问题和大的问题解决思路是一致的。
    //最终左部分和右部分完全相同才能说明是对称二叉树
    return leftEqualright(leftroot->left,rightroot->right)
    && leftEqualright(leftroot->right,rightroot->left);
 }
代码运行过程:
13、另一颗树的子树
另一颗树的子树
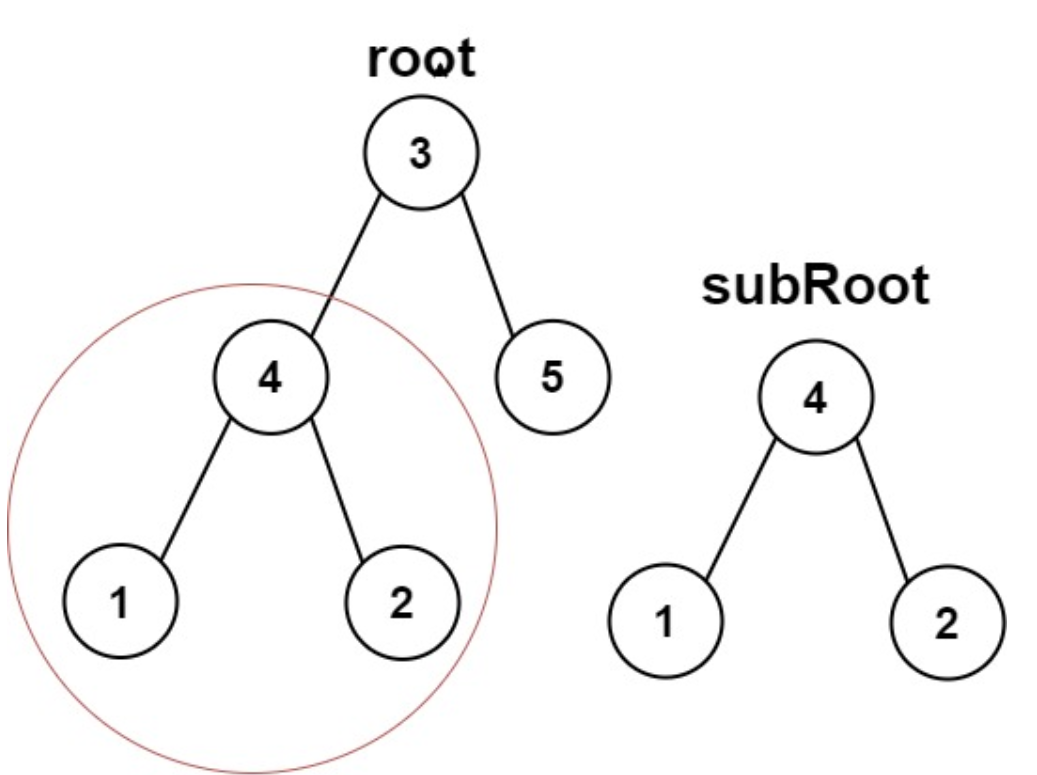
思路:
子树 == 当前树的某一个节点作为根,一直到叶节点的结构都相同
(可以复用相同树的代码和逻辑)
- 如果树是空的,就没有子树
- 比较从根下来的每一个树,是否和子树完全相等
- 递归左子树判断,递归右子树判断。(先序)
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
 //相同树代码
 bool isSametree(struct TreeNode* p,struct TreeNode* q)
 {
 //比到最后,或者根左右子树都为空
    if(p == NULL && q == NULL)
        return true;
    //结构不同
    if(p == NULL && q != NULL)
        return false;
    //结构不同
    if(p != NULL && q == NULL)
        return false;
    //值不同
    if(p->val != q->val)
        return false;
    return isSametree(p->left,q->left) && isSametree(p->right,q->right);
 }
bool isSubtree(struct TreeNode* root, struct TreeNode* subRoot) {
    if(root == NULL)//如果树是空的,就没有子树
        return false;
    if(isSametree(root,subRoot))//比较从根下来的每个树
        return true;
    return isSubtree(root->left,subRoot) || isSubtree(root->right,subRoot);
}
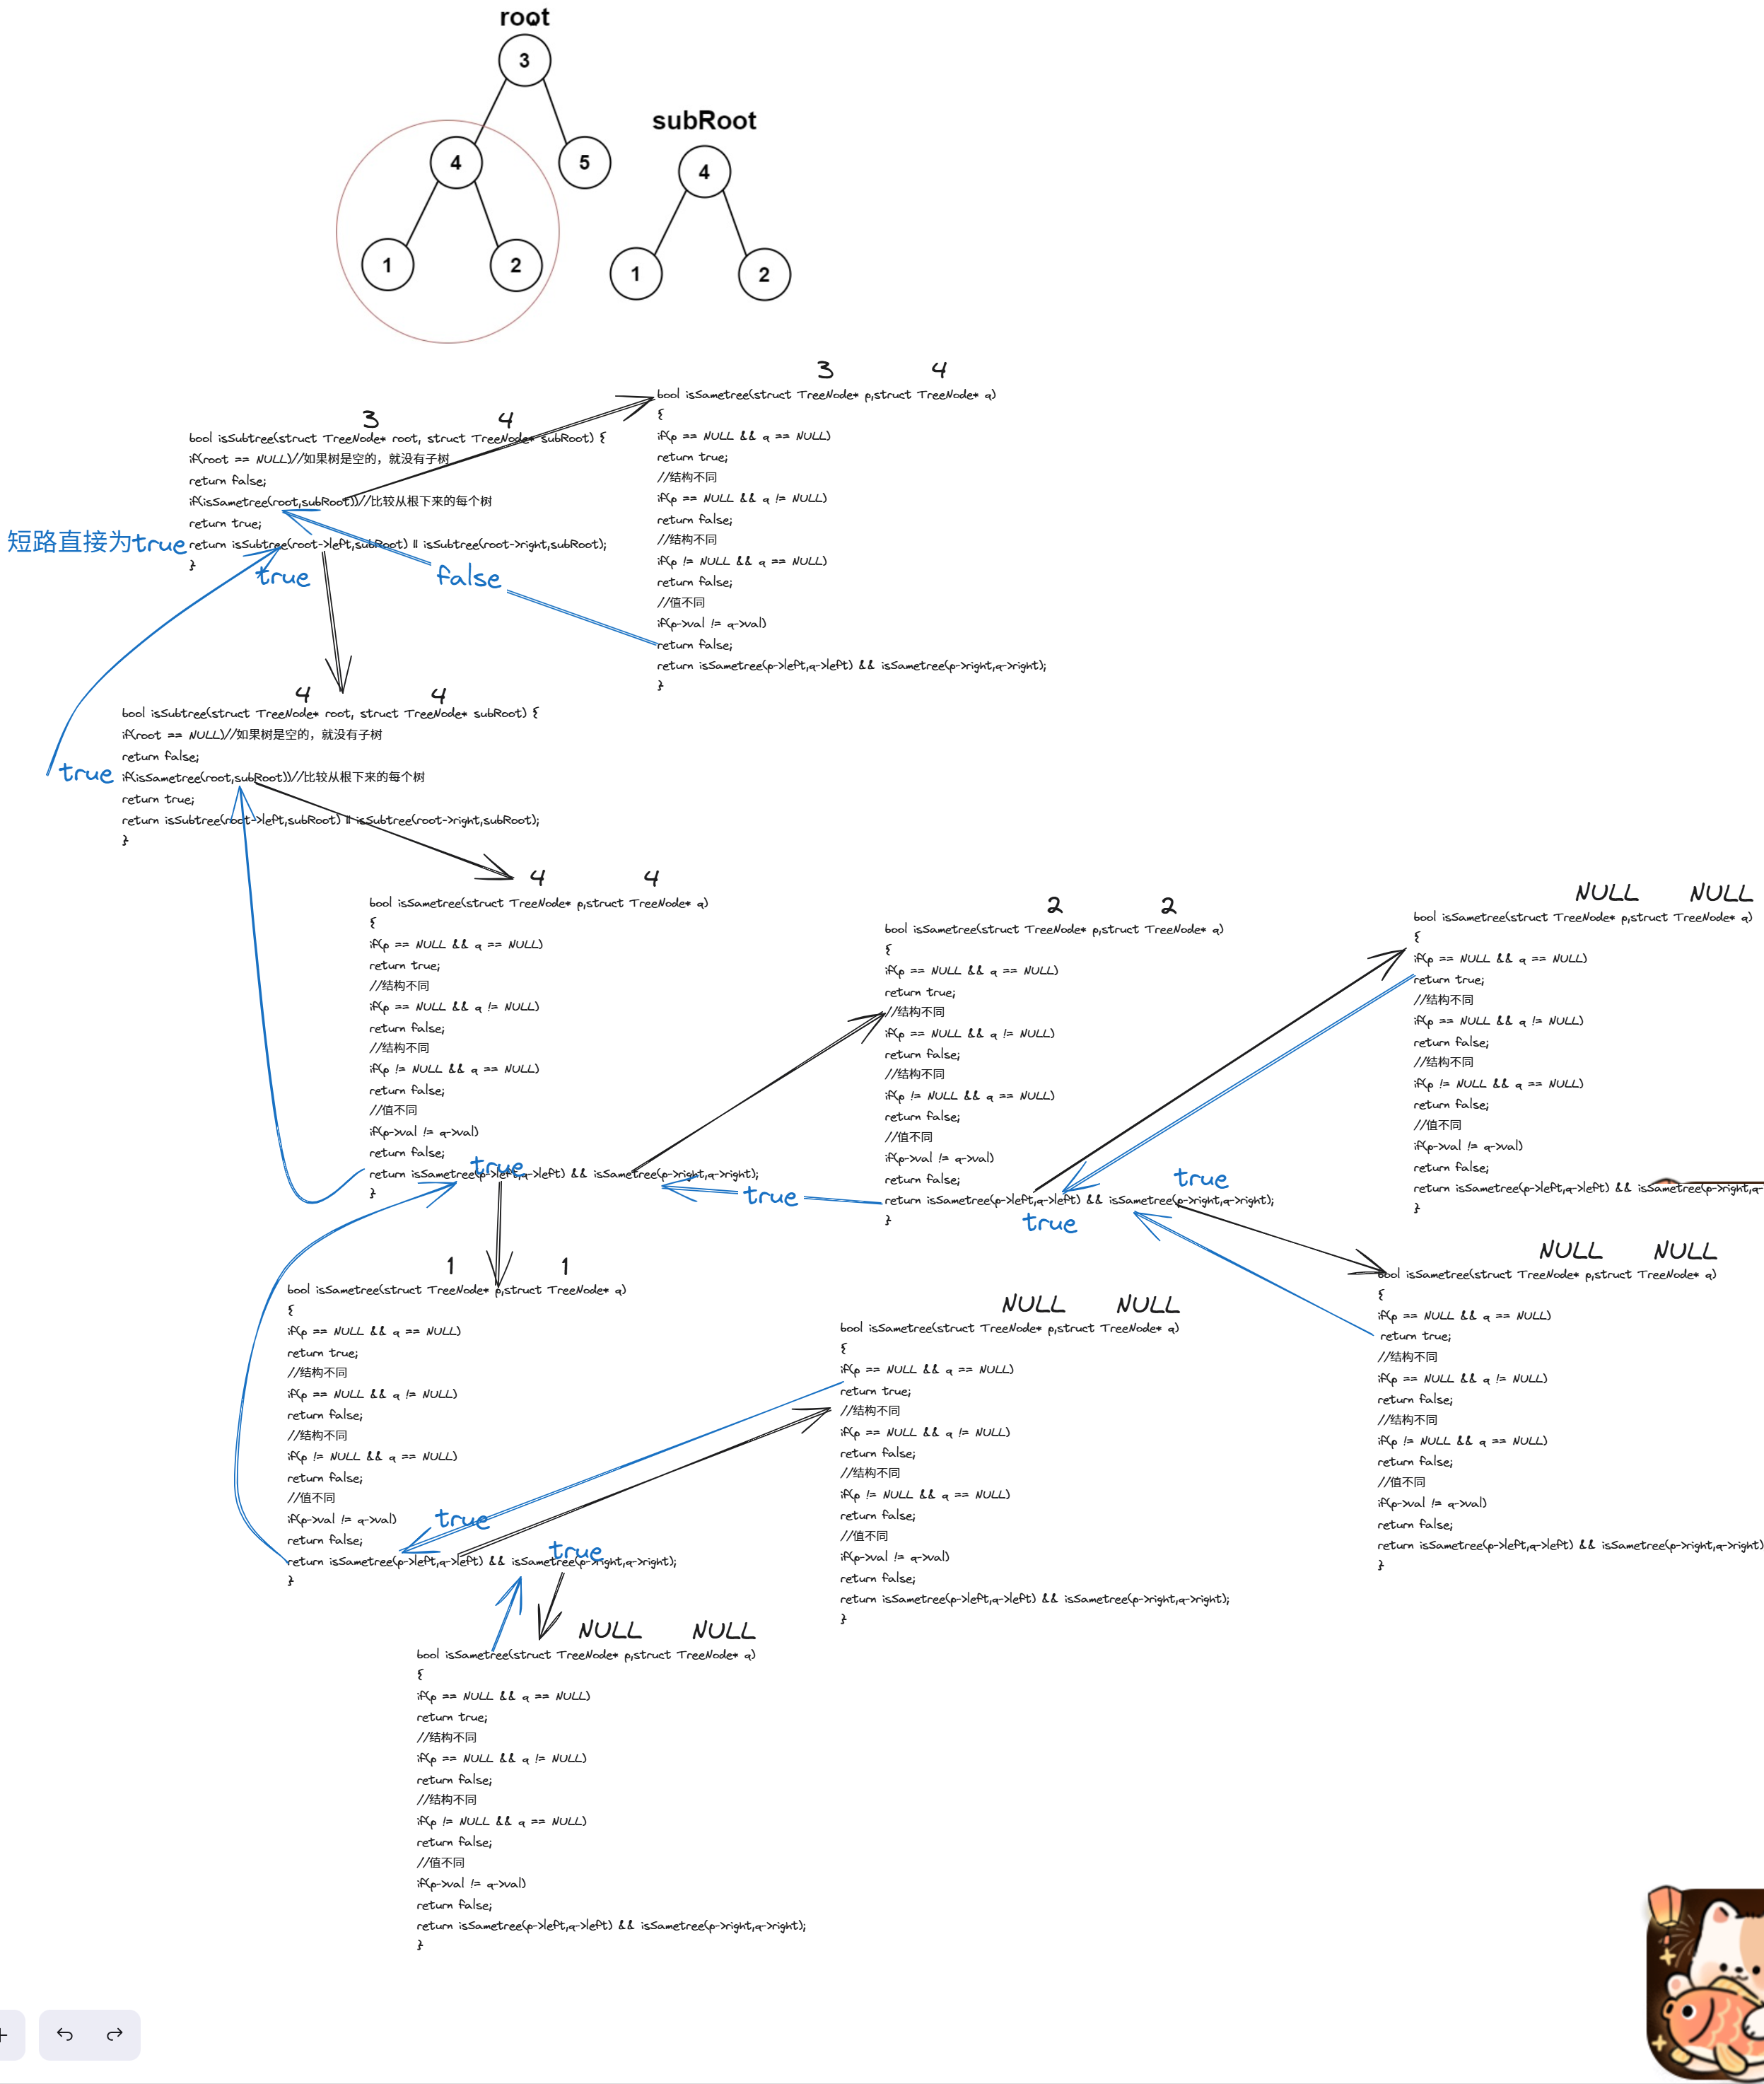
代码运行递归过程:
14、判断是否为平衡二叉树
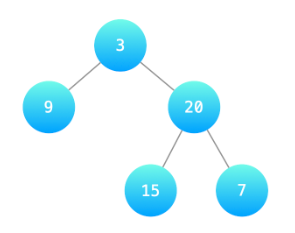
- 解法一:
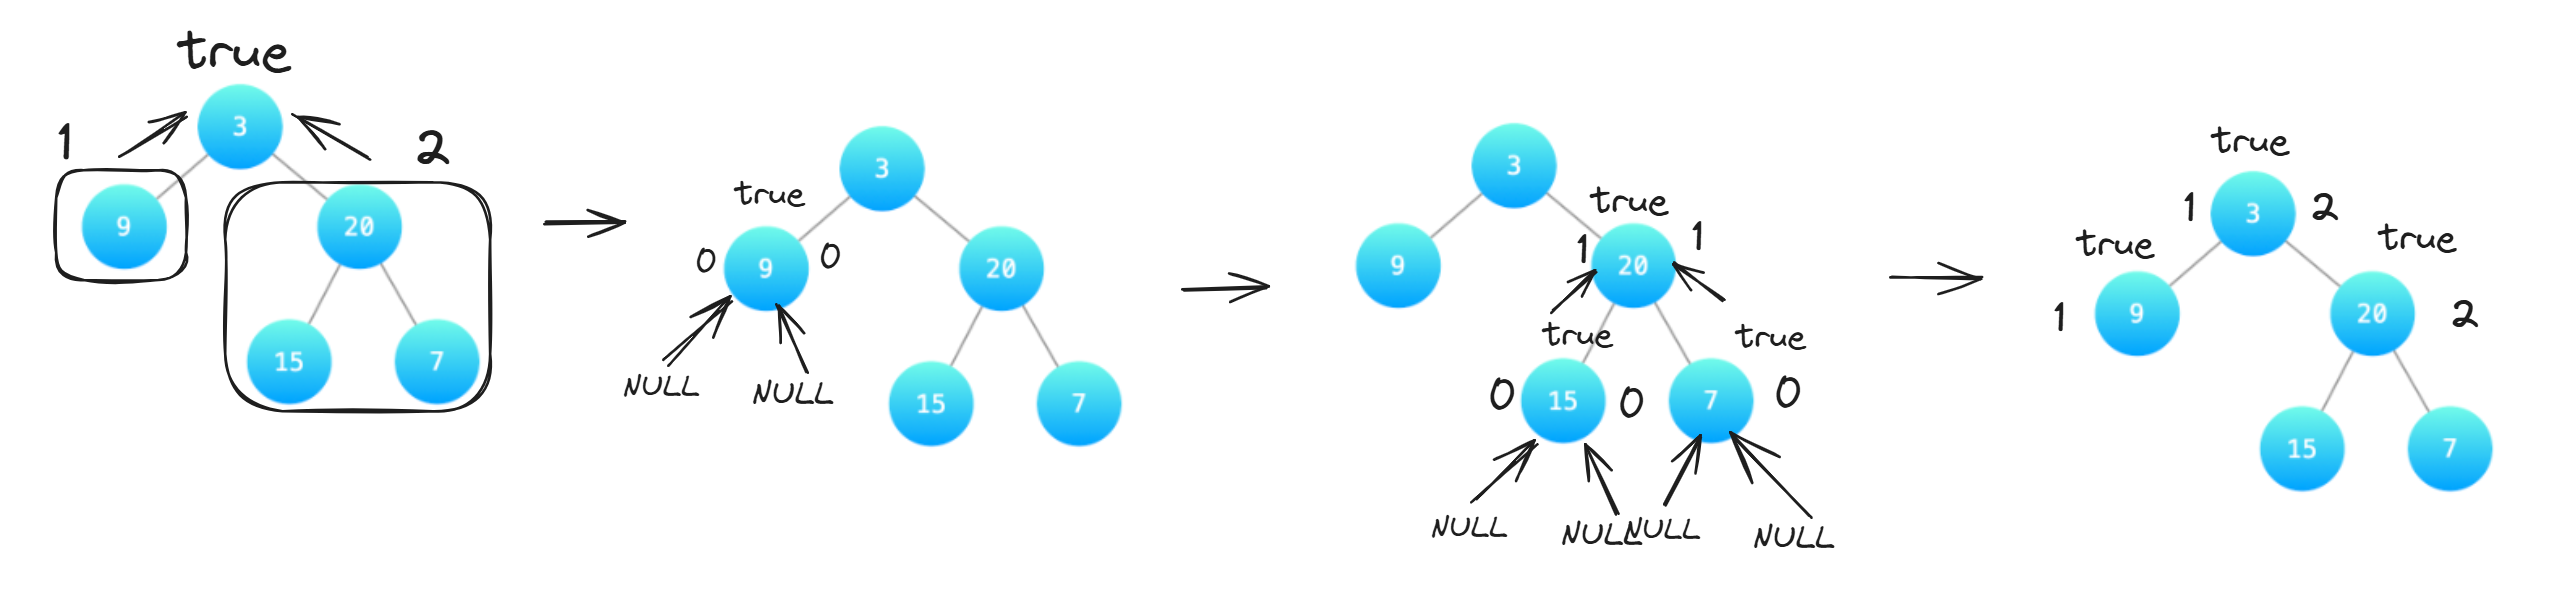
思路:
- 求当前节点的左右子树的深度。
- 判断左右子树的深度之差是否小于1(如果大于1就返回false,说明有一个节点作为根节点的左右子树深度不满足平衡二叉树的条件,整棵树就不是平衡二叉树)
- 当前节点满足还不够,还要递归判断他的左子树和右子树。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
int TreeDepth(struct TreeNode* root)
{
    if(root == NULL)//空树高度为0
        return 0;
    if(root->left == NULL&& root->right == NULL)//叶子结点高度为1
        return 1;
    //存起来根的左右子树高度值
    int left = TreeDepth(root->left);
    int right = TreeDepth(root->right);
    return left > right ? left+1 : right+1;//高的作为上一层根节点高度
}
bool isBalanced(struct TreeNode* root) {
    if(root == NULL)//空树或走到叶子结点符合平衡树条件
        return true;
    if(abs(TreeDepth(root->left)-TreeDepth(root->right))>1)//当前节点作为根节点的左子树和右子树高度之差大于1说明不符合
        return false;
    return isBalanced(root->left) && isBalanced(root->right);//前序遍历左子树、右子树是否满足
}
这样做的缺点(前序造成了O(N*N)的时间复杂度):
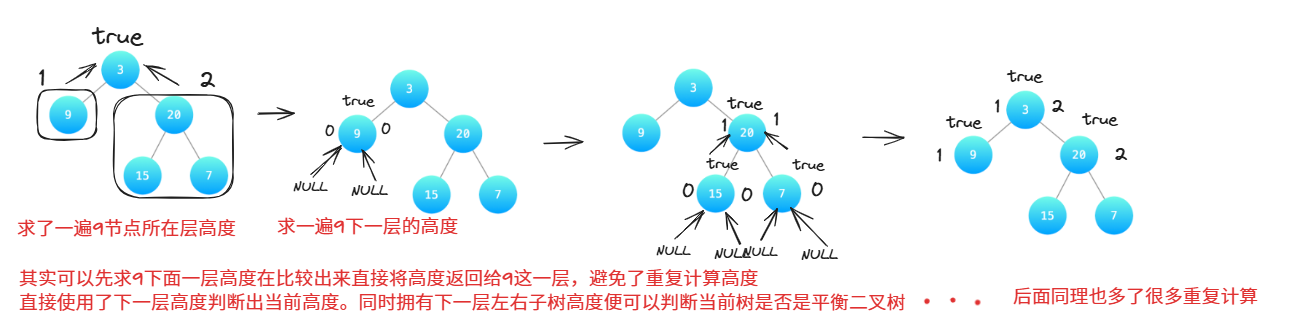
由于每一次求高度都需要遍历一下下面所有的节点,算是O(N)复杂度了,而求每一个节点的高度,也就是N个节点,复杂度最好是O(N),判断第一个根节点左右子树就返回false,最坏是O(N*N);
优化
时间复杂度:O(N)只遍历一遍树,即可判断,使用后序遍历,先去求最左子树的高度,再求右子树高度,判断是否是平衡树,如果是连同求出的上一层高度和true一起返回,如果不是,直接返回false,因为已经不是平衡二叉树,所以不需要高度了。
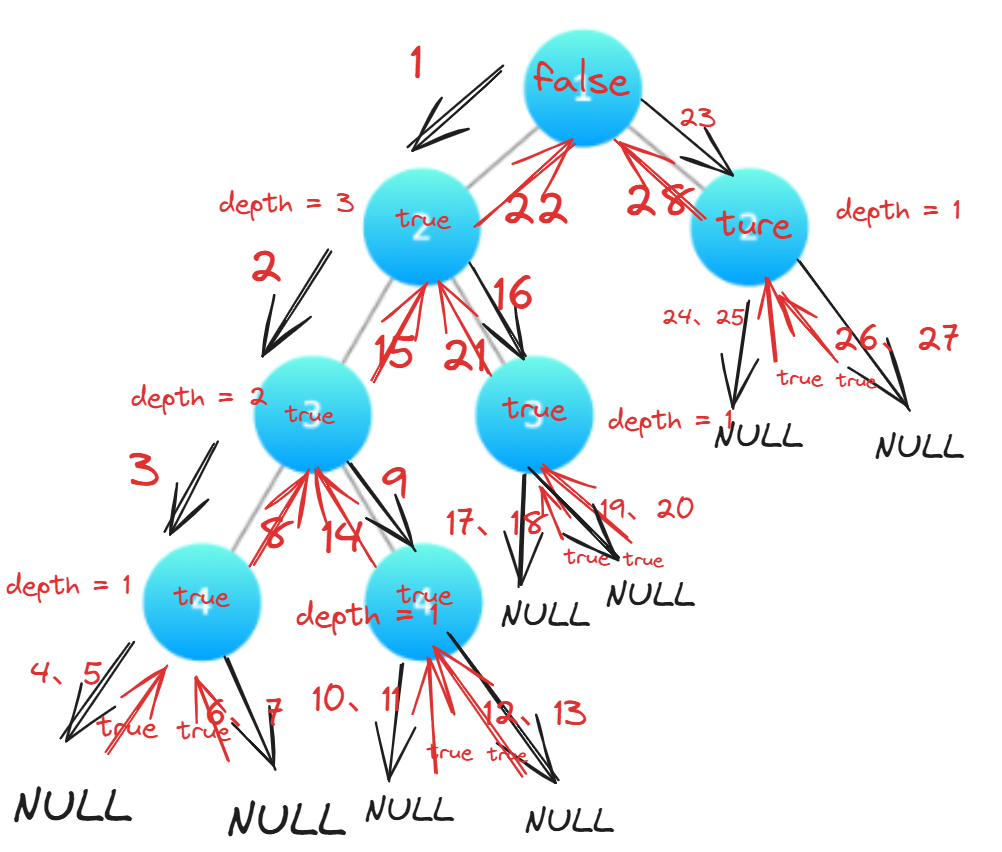
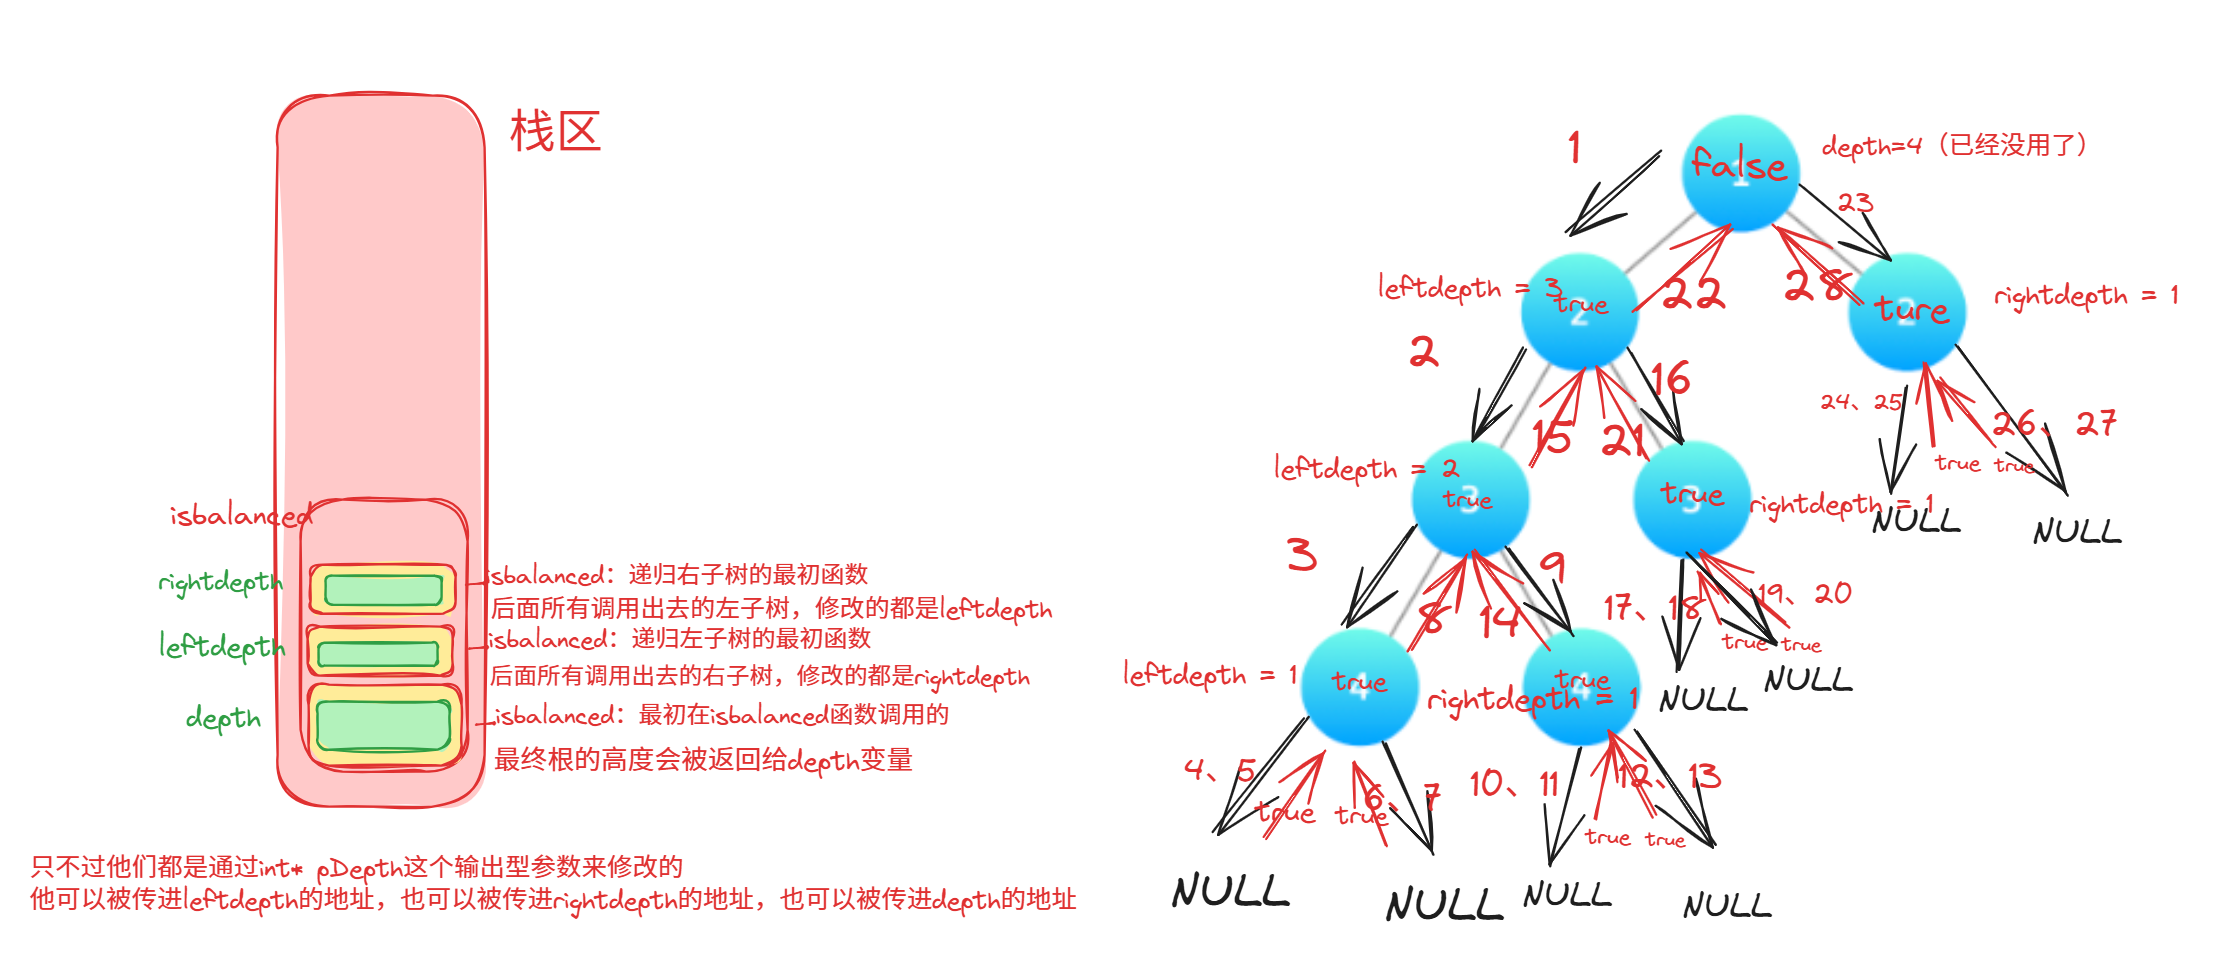
注:每次都是先走箭头(递推或者回归),之后再根据true or false来判断当前树是否满足,满足之后再修改深度depth。
子函数递归:
由于每次递归的时候除了需要判断是否是平衡二叉树返回的bool值,还需要算出的高度返回给上一层
bool _isBalanced(struct TreeNode* root,int* pDepth):isBalanced的子函数_isBalanced,需要一个子函数做递归,由于最后是要bool值判断,所以将bool作为这个函数的返回值,由于c语言是不支持多个返回值的,所以深度只能够通过输出型参数去返回,或者更准确的来说是传地址在每次递归函数内部修改它的值。
子函数内部逻辑:
bool _isBalanced(struct TreeNode* root,int* pDepth)
{
    //一进来就是空树,满足平衡二叉树
    //递归到最后一层为空,没有提前返回false,说明当前子树满足条件,可以返回true给上一层的叶子结点
    if (root == NULL)
        return true;
    //当前左子树满足是平衡树,并不能说明什么而且还得需要递归其他节点,所有的全部满足才能是true,这个条件没意义。但是如果当前左子树不是平衡树,直接就可以说明整棵树不是平衡树,相当于递归截止条件了,在些条件的时候也都应该写这种能够截止递归的条件。
    //不能判断当前树,需要先判断左树
    int leftDepth = 0;//这里专门是左子树的高度地址处的值,改的就是每一个左子树节点的高度
    if (!_isBalanced(root->left,&leftDepth))
        return false;
    //在判断右树
    int rightDepth = 0;//这里专门是右子树高度地址处的值,改的就是每一个右子树节点的高度
    if(!_isBalanced(root->right,&rightDepth))
        return false;
    //左树、右树都满足,判断当前树
    int gap = abs(leftDepth - rightDepth);
    if(gap > 1)//左右子树高度差大于一,直接就说明不是平衡二叉树
        return false;
    //走到这里说明当前子树满足平衡二叉树,将深度修改
    * pDepth = leftDepth > rightDepth ? leftDepth+1 : rightDepth+1;
    //_isBalanced(root->left,&leftDepth)输出型参数,传的是哪个子树高度的地址,就将他的左右子树高度深的加1,改到这个子树高度,这里改的就是每一个左子树节点处的高度
    //_isBalanced(root->right,&rightDepth)改的就是每一个右子树节点的高度
    //很巧的是地址都传给了pDepth统一修改,因为他们修改的方式一致。
    //最后一次传递深度会传递给整棵树的根节点,不是leftDepth,也不是rightDepth,是我们isBalanced里的Depth变量,但是没关系,因为这个参数现在用不上了,根节点不需要高度了。
    return true;
}
巧妙的输出型参数设计:
完整代码:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */
 //优化:时间复杂度:O(N)只遍历一遍树,即可判断,使用后序遍历,先去求最左子树的高度,再求右子树高度,判断是否是平衡树,如果是连同求出的上一层高度和true一起返回,如果不是,直接返回false,因为已经不是平衡二叉树,所以不需要高度了。

bool _isBalanced(struct TreeNode* root,int* pDepth)
{
    //一进来就是空树,满足平衡二叉树
    //递归到最后一层为空,没有提前返回false,说明当前子树满足条件,可以返回true给上一层的叶子结点
    if (root == NULL)
        return true;
    //当前左子树满足是平衡树,并不能说明什么而且还得需要递归其他节点,所有的全部满足才能是true,这个条件没意义。但是如果当前左子树不是平衡树,直接就可以说明整棵树不是平衡树,相当于递归截止条件了,在些条件的时候也都应该写这种能够截止递归的条件。
    //不能判断当前树,需要先判断左树
    int leftDepth = 0;//这里专门是左子树的高度地址处的值
    if (!_isBalanced(root->left,&leftDepth))
        return false;
    //在判断右树
    int rightDepth = 0;//这里专门是右子树高度地址处的值
    if(!_isBalanced(root->right,&rightDepth))
        return false;
    //左树、右树都满足,判断当前树
    int gap = abs(leftDepth - rightDepth);
    if(gap > 1)//左右子树高度差大于一,直接就说明不是平衡二叉树
        return false;
    //走到这里说明当前子树满足平衡二叉树,将深度修改
    * pDepth = leftDepth > rightDepth ? leftDepth+1 : rightDepth+1;//_isBalanced(root->left,&leftDepth)输出型参数,传的是哪个子树高度的地址,就将他的左右子树高度深的加1,改到这个子树高度,这里改的就是每一个左子树节点处的高度,_isBalanced(root->right,&rightDepth)改的就是每一个右子树节点的高度。很巧的是地址都传给了pDepth统一修改,因为他们修改的方式一致。最后一次传递深度会传递给整棵树的根节点,不是leftDepth,也不是rightDepth,是我们isBalanced里的Depth变量,但是没关系,因为这个参数现在用不上了,根节点不需要高度了。
    return true;
}

bool isBalanced(struct TreeNode* root) {
    //由于每次递归的时候除了需要判断是否是平衡二叉树返回的bool值,还需要算出的高度返回给上一层
    //isBalanced的子函数,需要一个子函数做递归,由于最后是要bool值判断,所以将bool作为这个函数的返回值,由于c语言是不支持多个返回值的,所以深度只能够通过输出型参数去返回,或者更准确的来说是传地址在每次递归函数内部修改它的值。
    int Depth = 0;//由于最后一层的高度没有用,传进来的Depth和leftDepth还有rightDepth虽然不是一个地址处的值,但每次左树都是&leftDepth内的值,右树都是&rightDepth内的值,最后根节点的高度是&Depth内的值。
    return _isBalanced(root,&Depth);
}
15、利用前序遍历的字符串构建完全二叉树
本题目来源于清华大学机试复试题
清华大学机试
构建这棵树:需要字符串,还有他的下标,并且还需要修改这个下标,所以要传递指针。
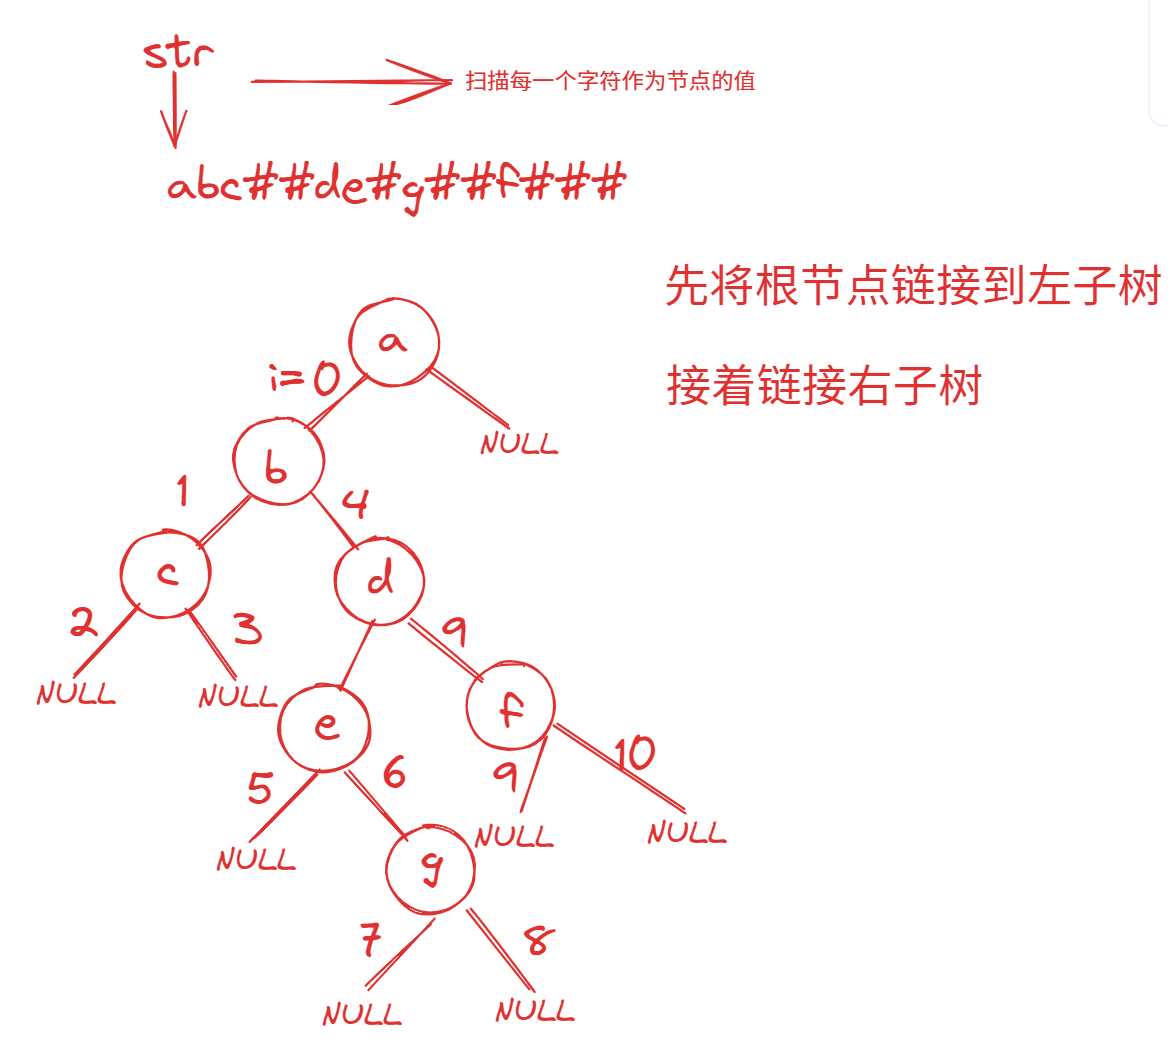
//构建二叉树
TreeNode* CreatTree(char* str,int* pi)
{
    //如果是#说明是NULL,直接返回NULL作为节点即可
    if(str[*pi] == '#')//空节点不连接,直接跳过,但是下标要增加
    {
        (*pi)++;
        return NULL;
    }
    //创建新的节点
    TreeNode * node = (TreeNode* )malloc(sizeof(TreeNode));
    node->val = str[*pi];
    (*pi)++;
    //先链接到左子树,再链接到右子树
    node->left = CreatTree(str,pi);//先链接左子树
    node->right = CreatTree(str,pi);//链接右子树
    return node;//返回根节点,最终会返回到最开始调用的函数,也就是第一个创建的节点,node即为根节点
}
其实上面是我们预期的每扫描一个节点连接一个节点的过程,实际的链接过程是先创建节点,然后从最小左子树开始链接,在链接右子树的。
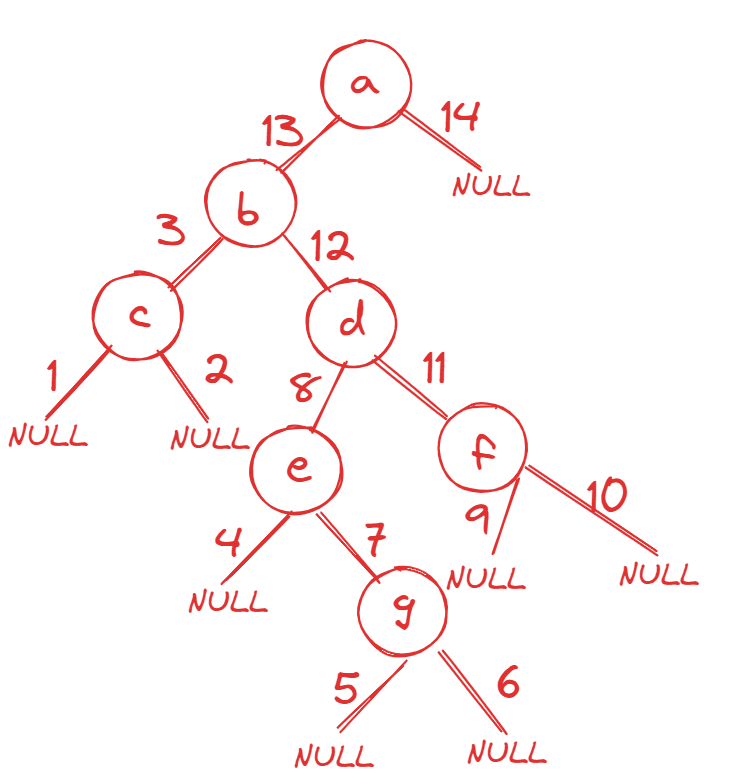
完整代码:
#include <stdio.h>
#include <stdlib.h>
typedef char BTDataType;
//二叉树结构
typedef struct TreeNode
{
    BTDataType val;
    struct TreeNode* left;
    struct TreeNode* right;
}TreeNode;

//构建二叉树
TreeNode* CreatTree(char* str,int* pi)
{
    //如果是#说明是NULL,直接返回NULL作为节点即可
    if(str[*pi] == '#')//空节点不创建节点但是也会被链接,返回空之前下标要增加。
    {
        (*pi)++;
        return NULL;
    }
    //创建新的节点
    TreeNode * node = (TreeNode* )malloc(sizeof(TreeNode));
    node->val = str[*pi];
    (*pi)++;
    //先链接到左子树,再链接到右子树
    node->left = CreatTree(str,pi);//先链接左子树
    node->right = CreatTree(str,pi);//链接右子树
    return node;//返回根节点,最终会返回到最开始调用的函数,也就是第一个创建的节点node即为根节点
}
//中序遍历
void InOrder(TreeNode* root)
{
    if(root == NULL)
        return;
    InOrder(root->left);
    printf("%c ",root->val);
    InOrder(root->right);
}
int main() {
    char str[100] = {};//输入字符串,注意c语言c99规则以前是不可以使用变长数组的。也就是数组的大小必须提前确定。最多是100个,就先开100个空间使用
    scanf("%s",str);

    //创建完全二叉树
    //将字符串传进去,作为构建二叉树节点的值,i作为访问下标,因为二叉树内的节点是一个一个malloc来的,不需要传递字符串的长度,需要一个申请一个节点即可
    int i = 0;
    TreeNode* root = CreatTree(str,&i);
    InOrder(root);
    return 0;
}
16、二叉树第k层节点个数
- 第k层的节点个数是左子树的第k-1层节点个数加上右子树第k-1层的节点个数,而每一层的第k层都是下一层的第k-1层。
- 直到k=1的时候即可返回1,说明当前需要求得第k层有一个节点,如果某一层走到NULL,直接返回0即可。
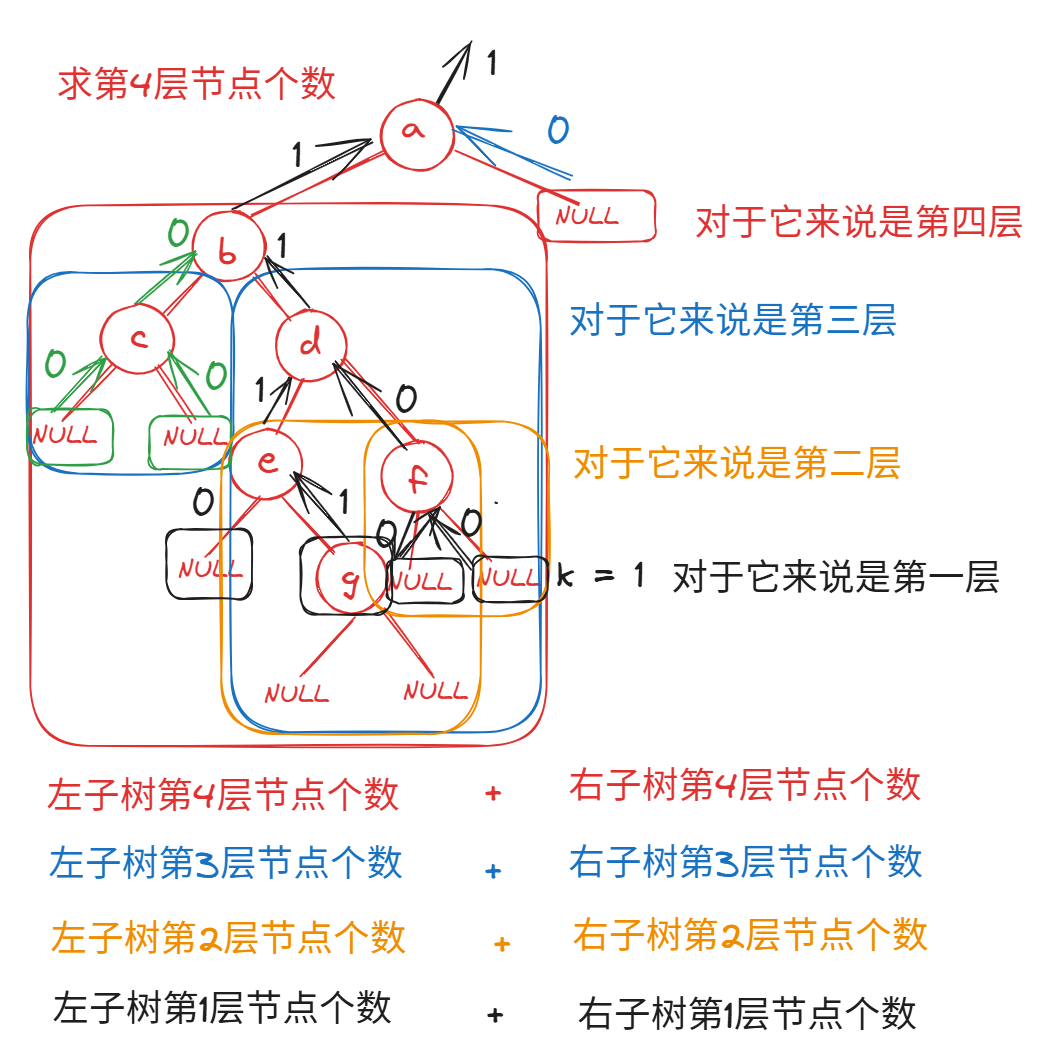
//求二叉树第k层节点个数
int BinaryTreeLevelkSize(BTNode* root, int k)
{
	//第k层的节点个数是左子树的第k-1层节点个数加上右子树第k-1层的节点个数,而每一层的第k层都是下一层的第k-1层。
	//直到k=1的时候即可返回1,说明当前需要求得第k层有一个节点,如果这一层走到NULL,直接返回0即可。
	if (root == NULL)
		return 0;
	if (k == 1)//这里的k这是方便看层数,判断k=1的时候需要加上这一层的这一个节点数的,所以没必要传地址改变这个k值
	//每一次函数调用的时候自动调用的就是当前层的k-1层,比如求第4层,-->代表调用,k=4-->k=3-->k=2-->k=1(返回),中间遇到NULL返回0。
		return 1;
	return BinaryTreeLevelkSize(root->_left,k-1) + BinaryTreeLevelkSize(root->_right,k-1);
}
17、二叉树的销毁
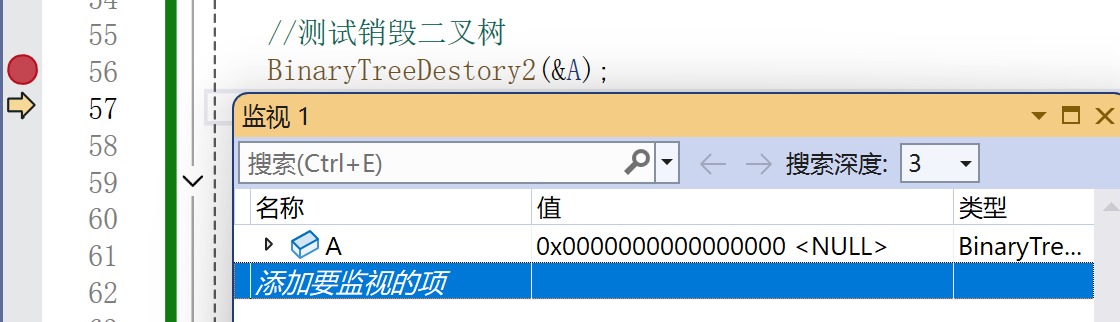
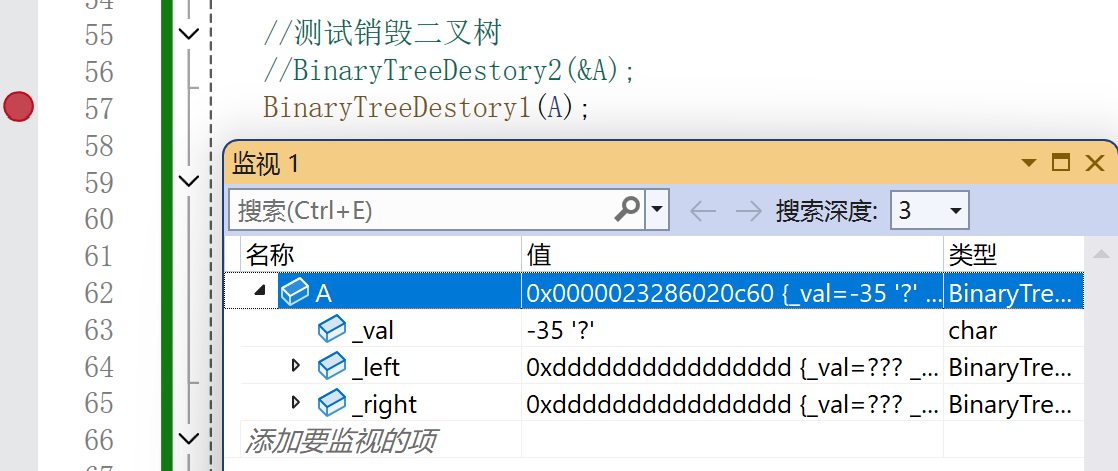
两种销毁方式:第一种保证了接口的一致性,第二种将指针置空了,避免了野指针的问题
//二叉树的销毁
bool BinaryTreeDestory1(BTNode* root)
{
	//销毁节点,采用后序销毁,如果采用前序先销毁了根,找不到左右了
	if (root == NULL)
		return true;
	BinaryTreeDestory1(root->_left);
	BinaryTreeDestory1(root->_right);
	free(root);
	return true;
}
//二叉树的销毁
bool BinaryTreeDestory2(BTNode** root)
{
	//销毁节点,采用后序销毁,如果采用前序先销毁了根,找不到左右了
	if (*root == NULL)
		return true;
	BinaryTreeDestory2(&(*root)->_left);
	BinaryTreeDestory2(&(*root)->_right);
	free(*root);
	*root = NULL;
	return true;
}
测试:
//测试销毁二叉树
BinaryTreeDestory2(&A);
BinaryTreeDestory1(A);
18、二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x)
{
	if (root == NULL)
		return NULL;
	if (root->_val == x)
		return root;
	//将节点存起来,便于找到的时候返回
	BTNode* node = BinaryTreeFind(root->_left, x);
	if (node)//node不为空就说明找到了,为空就说明左子树找不到
		return node;
	//没找到继续在右子树上找
	node = BinaryTreeFind(root->_right, x);
	if (node)//node在右子树中找到了,返回即可
		return node;
	//走到这里说明压根找不到了
	return NULL;
}
19、层序遍历
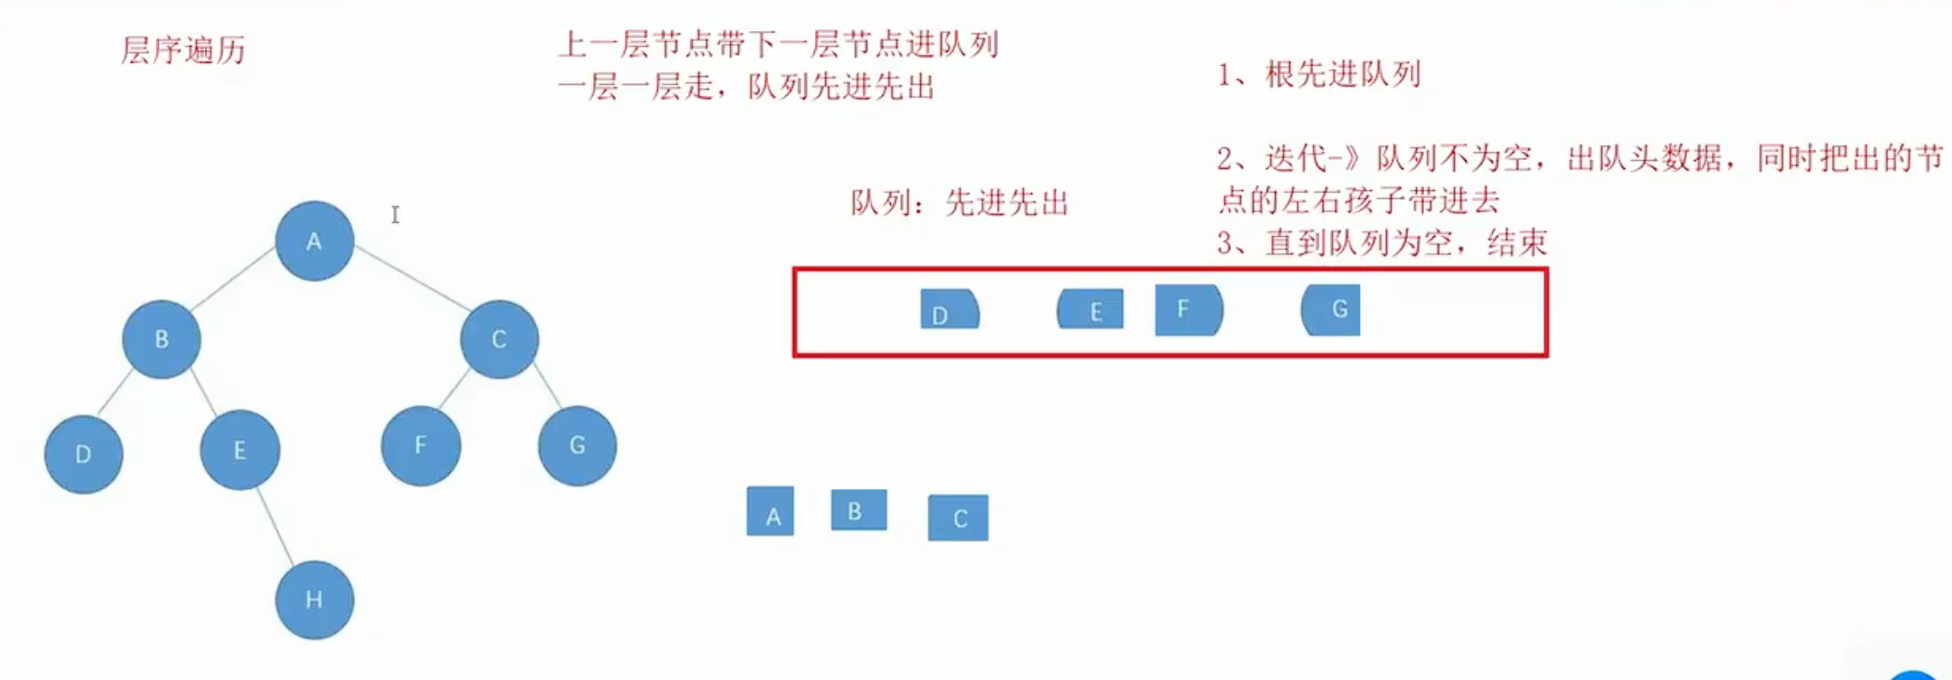
借助队列先进先出的性质:(一层节点带一层,将下一层带进来。)
思路:
- 根先进队列
- 迭代—>队列不为空,出对头数据,同时把出的节点的左右孩子带进队列。
- 直到队列为空,结束。
- 出队列的顺序就是层序的顺序
20、头文件互相包含问题解决办法
那这里需要使用队列,所以将队列的代码拷贝到工程中:
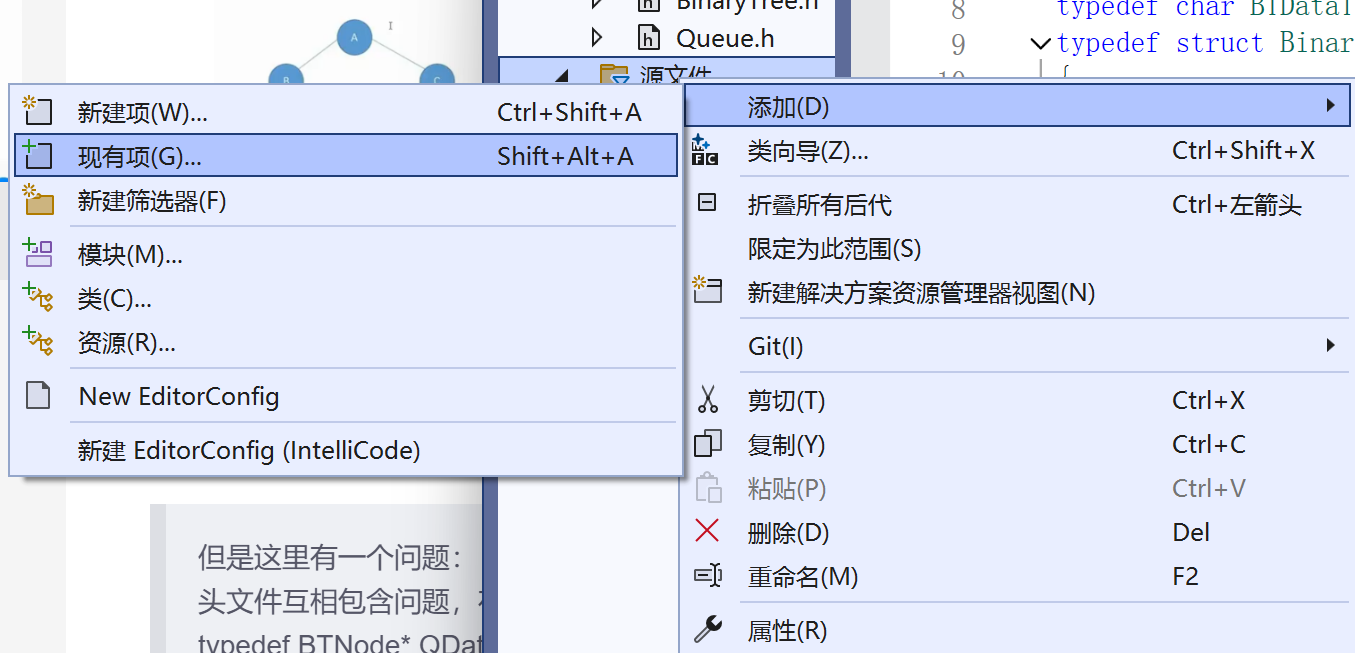
然后去工程中,将Queue.h和Queue.c拷贝到这个工程项目中:
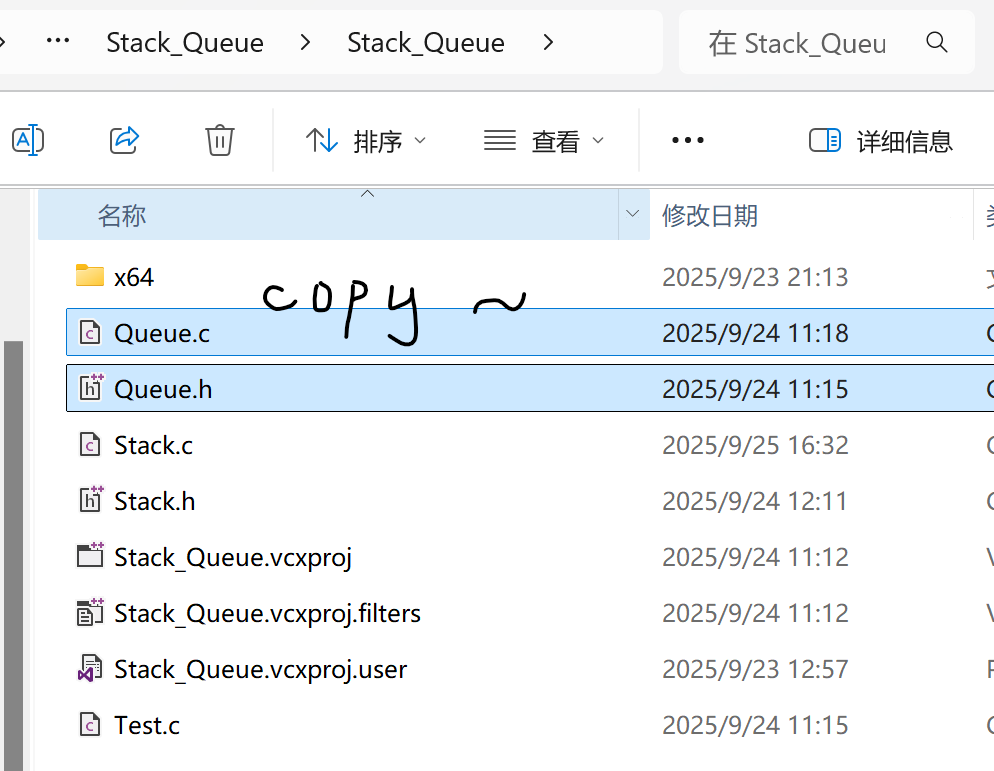
然后拷贝到当前工程,之后将Queue.h拉到.h头文件中即可:
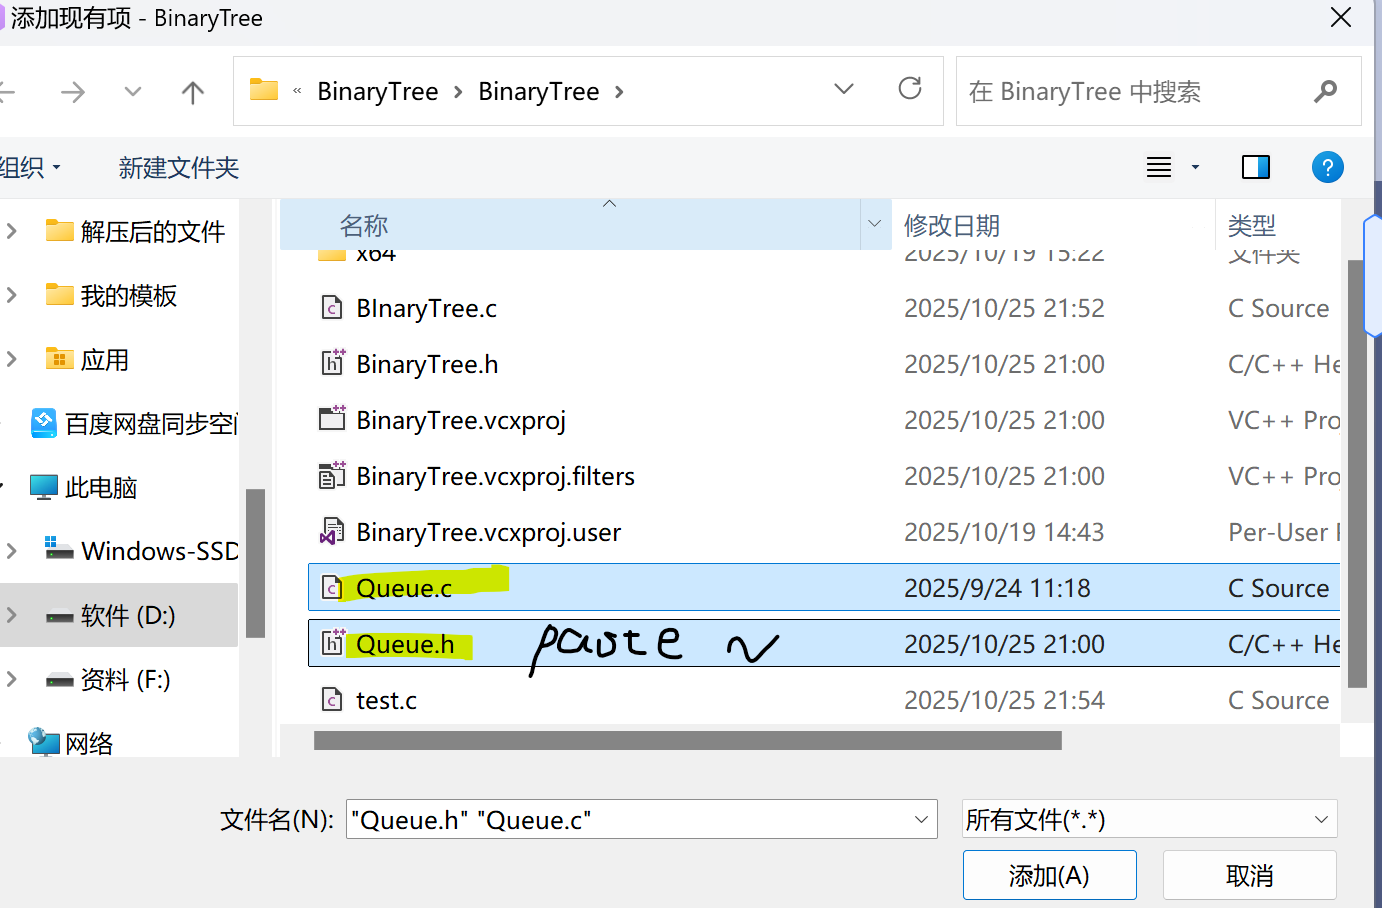
因为二叉树需要使用到队列的方法,将Queue.h包含在在BinaryTree.h中,然后BinaryTree.h,会在BinaryTree.c中展开,就可以在BinaryTree.c中使用队列了。
但是这里有一个问题:
头文件互相包含问题,由于队列中装的元素不再是整形,而是二叉树节点指针BTNode*(结构体节点太大,传指针节省空间,还可以找到它的左右孩子),在队列代码中需要将typedef int QDataType;改成typedef BTNode* QDataType,;但是有个问题这个,编译的过程是分布进行的,每个文件单独编译,所以Queue.h文件向上查找找不到BTNode的定义。
解决办法:
- 在Queue.h中包BinaryTree.h吗?不可以这样,两个头文件互相包,会导致编译阶段你展开我,我也要展开你,这种死循环似的展开下去。
- (最好的解决办法)因为只是需要BTNode结构体的定义嘛,所以我们可以在Queue.h,将BTNode结构体声明为外部变量,意味着我有这个变量,先声明在这,具体在哪里,需要去后面另外的文件中找。但是这里声明得这样写extern struct BinaryTreeNode;,所以重定义类型就这样写吧:typedef struct BinaryTreeNode* QDataType;
- 将所有的结构体等等变量、函数的声明,定义全部放在common.h中,再将所有的工程文件都包含这个公共的头文件。
接下来就可以写层序遍历的代码啦:
//层序遍历---借助队列
void BinaryTreeLevelorder(BTNode* root)
{
	//将根节点入队列,当队列不为空时,每次出一个节点,然后将他的左右孩子带进来,直到队列为空,层序遍历完成
	Queue q;
	QueueInit(&q);
	//将根节点入队
	QueuePush(&q,root);
	//当队列不为空的时候,出一个节点带进来他的左右孩子
	while (!QueueEmpty(&q))
	{
		QDataType node = QueueFront(&q);//取队头节点
		QueuePop(&q);//将对头节点移出队列
		if (node != NULL)//空没有左右子树,所以不需要入节点
		{
			printf("%c ", node->_val);
			QueuePush(&q, node->_left);//将左右节点入队
			QueuePush(&q, node->_right);
		}
	}
	QueueDestroy(&q);//销毁队列
}
测试:
//测试层序遍历
BinaryTreeLevelorder(A);
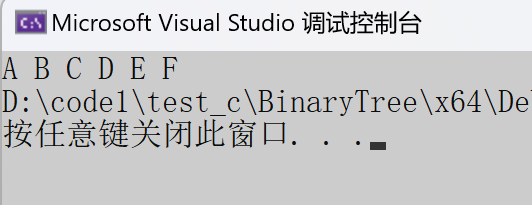
21、判断二叉树是否是完全二叉树
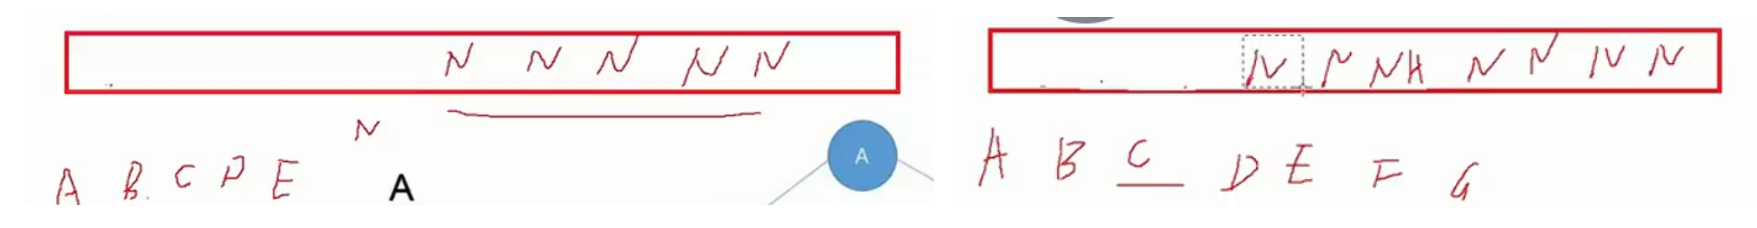
层序遍历,当出第一个NULL时候就break出循环,然后判断队列中是否还有出除了NULL以外的元素,有就直接返回false,没有就返回true。
//判断二叉树是否是完全二叉树
bool BinaryTreeComplete(BTNode* root)
{
	//将根节点入队列,当队列不为空时,每次出一个节点,然后将他的左右孩子带进来,直到队列为空,层序遍历完成
	Queue q;
	QueueInit(&q);
	//将根节点入队
	QueuePush(&q, root);
	//当队列不为空的时候,出一个节点带进来他的左右孩子
	while (!QueueEmpty(&q))
	{
		QDataType node = QueueFront(&q);//取队头节点
		QueuePop(&q);//将对头节点移出队列
		if (node == NULL)//第一次出了NULL就出循环,不在出元素
			break;
		QueuePush(&q, node->_left);//将左右节点入队
		QueuePush(&q, node->_right);
	}
	while (!QueueEmpty(&q))//检查队列中剩余值里除了NULL还有没有其他值
	{
		QDataType node = QueueFront(&q);//取队头节点
		if (node)
		{
			QueueDestroy(&q);//返回要先销毁空间
			return false;
		}
		QueuePop(&q);//将队头节点移出队列
	}
	QueueDestroy(&q);//返回前先销毁空间,因为他是malloc而来的
	return true;
}
测试:
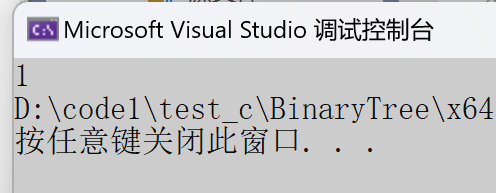
//测试是否是完全二叉树
printf("%d ",BinaryTreeComplete(A));
1代表true,0代表false
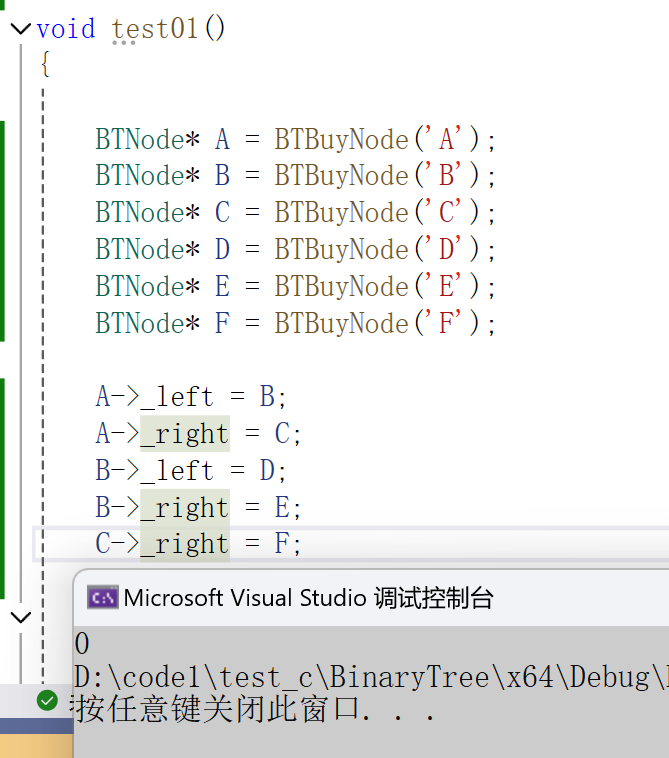
当我在C的右孩子加了F节点,C没有左节点
22、完整代码
BinaryTree.h:
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<stdbool.h>
#include"Queue.h"//二叉树要用到队列里的东西

typedef char BTDataType;
typedef struct BinaryTreeNode
{
	BTDataType _val;
	struct BinaryTreeNode* _left;
	struct BinaryTreeNode* _right;
}BTNode;

//二叉树接口

//初始化申请节点
BTNode* BTBuyNode(BTDataType val);


//先序遍历
void preOrder(BTNode* root);
//中序遍历
void InOrder(BTNode* root);
//后续遍历
void postOrder(BTNode* root);

//二叉树节点的个数
//int TreeSize(BTNode* root);
//void TreeSize(BTNode* root, int* psize);
int TreeSize(BTNode* root);


//完全二叉树叶子节点个数
int TreeLeafSize(BTNode* root);

//求二叉树第k层节点个数
int BinaryTreeLevelkSize(BTNode* root,int k);

//二叉树的销毁
bool BinaryTreeDestory1(BTNode* root);
bool BinaryTreeDestory2(BTNode** root);

//二叉树查找值为x的节点
BTNode* BinaryTreeFind(BTNode* root, BTDataType x);

//层序遍历
void BinaryTreeLevelorder(BTNode* root);

//判断二叉树是否是完全二叉树
bool BinaryTreeComplete(BTNode* root);
BInaryTree.c
//判断二叉树是否是完全二叉树
bool BinaryTreeComplete(BTNode* root)
{
	//将根节点入队列,当队列不为空时,每次出一个节点,然后将他的左右孩子带进来,直到队列为空,层序遍历完成
	Queue q;
	QueueInit(&q);
	//将根节点入队
	QueuePush(&q, root);
	//当队列不为空的时候,出一个节点带进来他的左右孩子
	while (!QueueEmpty(&q))
	{
		QDataType node = QueueFront(&q);//取队头节点
		QueuePop(&q);//将对头节点移出队列
		if (node == NULL)
			break;
		QueuePush(&q, node->_left);//将左右节点入队
		QueuePush(&q, node->_right);
	}
	while (!QueueEmpty(&q))//检查队列中剩余值里除了NULL还有没有其他值
	{
		QDataType node = QueueFront(&q);//取队头节点
		if (node)
		{
			QueueDestroy(&q);//返回要先销毁空间
			return false;
		}
		QueuePop(&q);//将队头节点移出队列
	}
	QueueDestroy(&q);//返回前先销毁空间,因为他是malloc而来的
	return true;
}
test.c
#define  _CRT_SECURE_NO_WARNINGS 1
#include"BinaryTree.h"

void test01()
{

	BTNode* A = BTBuyNode('A');
	BTNode* B = BTBuyNode('B');
	BTNode* C = BTBuyNode('C');
	BTNode* D = BTBuyNode('D');
	BTNode* E = BTBuyNode('E');
	BTNode* F = BTBuyNode('F');

	A->_left = B;
	A->_right = C;
	B->_left = D;
	B->_right = E;
	C->_right = F;

	////测试前序遍历
	//printf("preOrder:");
	//preOrder(A);
	//printf("\n");
	////测试中序遍历
	//printf("InOrder:");
	//InOrder(A);
	//printf("\n");
	////测试后序遍历
	//printf("postOrder:");
	//postOrder(A);
	//printf("\n");

	////测试计算节点个数
	//printf("TreeSizeA = %d ",TreeSize(A));
	//printf("TreeSizeA = %d ", TreeSize(A));
	/*int size = 0;
	int* psize = &size;
	TreeSize(A, psize);
	printf("ASize = %d\n", *psize);

	*psize = 0;
	TreeSize(B, psize);
	printf("BSize = %d\n", *psize);*/
	/*printf("ASize = %d \n", TreeSize(A));
	printf("ASize = %d \n", TreeSize(A));
	printf("BSize = %d \n", TreeSize(B));*/


	/*printf("TreeLeafSize = %d \n", TreeLeafSize(A));*/

	//测试第k层节点数
	//printf("第三层节点数:%d\n", BinaryTreeLevelkSize(A, 3));

	//测试销毁二叉树
	//BinaryTreeDestory2(&A);
	//BinaryTreeDestory1(A);

	////测试查找节点
	//BTNode* node = BinaryTreeFind(A, 'A');
	//if (node != NULL)
	//	printf("A节点存在:%c \n", node->_val);
	//else
	//	printf("不存在\n");

	//node = BinaryTreeFind(A, 'E');
	//if (node != NULL)
	//	printf("E节点存在:%c \n", node->_val);
	//else
	//	printf("不存在\n");

	//node = BinaryTreeFind(A, 'M');
	//if (node != NULL)
	//	printf("M节点存在:%c \n", node->_val);
	//else
	//	printf("不存在\n");

	////测试层序遍历
	//BinaryTreeLevelorder(A);

	//测试是否是完全二叉树
	printf("%d ",BinaryTreeComplete(A));

}
//void print(int num)
//{
//	if (num < 10)
//		printf("%d ", num);
//	else
//	{
//		print(num / 10);
//		printf("%d ", num % 10);
//	}
//}


//void print(int num)
//{
//	if (num >9)
//		print(num / 10);
//	printf("%d ", num % 10);
//}
int main()
{
	test01();
	/*int num = 1034;
	print(num);*/
	int size = 10;
	return 0;
}
Queue.c
#define  _CRT_SECURE_NO_WARNINGS 1
#include"Queue.h"

//队列接口
//初始化
void QueueInit(Queue* pq)
{
	assert(pq);
	//初始置空
	pq->_head = pq->_tail = NULL;
	pq->size = 0;
}

//队列销毁
void QueueDestroy(Queue* pq)
{
	assert(pq);
	//将节点一个一个销毁
	while (pq->_head)
	{
		QNode* next = pq->_head->_next;
		free(pq->_head);
		pq->_head = next;
	}
	//注意此时尾指针变成了野指针它指向的空间已经被销毁了,但是他还指向这个空间,所以应该将其置空
	pq->_tail = NULL;
}

//队尾入队
void QueuePush(Queue* pq, QDataType x)
{
	assert(pq);
	//申请节点,将值置为x
	QNode* next = (QNode* )malloc(sizeof(QNode));
	if (next == NULL)
	{
		perror("QueuePush::malloc");
		exit(1);
	}
	next->_data = x;
	next->_next = NULL;
	if (next == NULL)
	{
		perror("QueuePush::mallooc");
		exit(1);
	}
	//如果是队列为空,将next节点直接给给head,tail
	if (pq->_head == NULL)
	{
		pq->_head = pq->_tail = next;
	}
	//队列不为空,将next节点尾插
	else
	{
		pq->_tail->_next = next;
		pq->_tail = next;//更新尾结点
	}
	pq->size++;//元素个数加1
}

//队头出队
void QueuePop(Queue* pq)
{
	assert(pq);
	assert(pq->_head);//队列不为空
	//从队头出队
	QNode* next = pq->_head->_next;
	free(pq->_head);
	pq->_head = next;//更新队头节点
	pq->size--;//元素个数减1
}

//取队头元素值
QDataType QueueFront(Queue* pq)
{
	assert(pq);
	assert(pq->_head);//队列不为空

	return pq->_head->_data;
}

//取队尾元素
QDataType QueueBack(Queue* pq)
{
	assert(pq);
	assert(pq->_tail);//队列不为空
	//队列尾部元素直接返回
	return pq->_tail->_data;
}

//判断队列是否为空
bool QueueEmpty(Queue* pq)
{
	assert(pq);
	return pq->_head == NULL ? 1 : 0;
}

//队列中元素个数
int QueueSize(Queue* pq)
{
	assert(pq);
	return pq->size;
}
Queue.h
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<stdbool.h>
//队列也需要通道二叉树的节点类型--头文件互相包含问题
extern struct BinaryTreeNode;//声明外部变量结构体,解决头文件互相包含的问题
typedef struct BinaryTreeNode* QDataType;//存结构体指针因为结构体太大了,不能只存结构体的值,这样找不到他的左右孩子

//队列节点
typedef struct QueueNode
{
	QDataType _data;//数据域
	struct QueueNode* _next;//指针域
}QNode;

//队列
typedef struct Queue
{
	//需要头尾指针维护
	QNode* _head;
	QNode* _tail;
	int size;//大小
}Queue;

//队列接口
//初始化
void QueueInit(Queue* pq);

//队列销毁
void QueueDestroy(Queue* pq);

//队尾入队
void QueuePush(Queue* pq, QDataType x);

//队头出队
void QueuePop(Queue* pq);

//取队头元素值
QDataType QueueFront(Queue* pq);

//取队尾元素
QDataType QueueBack(Queue* pq);

//判断队列是否为空
bool QueueEmpty(Queue* pq);

//队列中元素个数
int QueueSize(Queue* pq);
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)