
jmeter之预制处理器JSR223
·
在使用jmeter的过程中,最近发现一个特别好用,但是有点坑的预制处理器JSR223,它可以融合很多种语言来编写脚本,然后实现预制参数的效果,比如其中融合的比较好的python2.7版本的脚本,就可以让用户直接在脚本里面运行python语句,来降低脚本的可理解性,众所周知,python脚本的工具特别强大,通过一行语句就可以实现其他语言几行语句的作用,所以可以直接在脚本里面写python语句,确实好用,比如以前需要通过复杂的两个变量引用实现的功能,
例如:${__V(cartId_${random_int})}这个变量里面:random_int定义为${__Random(1,${goodId_matchNr},)};而cartId是一串从json里提取出来的列表值,他的定义为$.data.data[*].id
我们想要得到最终的这个变量的实际值,需要通过一个${__V()}的函数来实现多次引用,整个写法比较复杂(少一个符号都直接引用失败),而通过python脚本,只需要一个语句就实现了引用,如下:
a='''<?xml version="1.0" encoding="UTF-8"?>
<Service>
    <Service_Header>
        <service_sn>${flowID}</service_sn>
        <global_trace_num>${__UUID}</global_trace_num>
        <requester_id>${request_id}</requester_id>
        <channel_id>${channel_id}</channel_id>
        <service_time>${__timeShift( yyyyMMddHHmmss,,,,)}</service_time>
        <version_id>01</version_id>
        <service_id>01860000100001</service_id>
        <branch_id>${branch_id}</branch_id>
    </Service_Header>
    <Service_Body>
        <request>
            <cId>500222********4627</cId>
            <cName>何某某</cName>
            <cType>0200</cType>
            <idImg>${param11}</idImg>
            <faceImg>${param12}</faceImg>
            <channel>${channel_id}</channel>
            <org>123</org>
            <businesscode>01860000100001</businesscode>
            <usercode>${usercode}</usercode>
            <inputtype>0</inputtype>
            <isNetworkCheck></isNetworkCheck>
            <netCheckImg>${param11}</netCheckImg>
            <netCheckImgType>2</netCheckImgType>
            <companyFirmType>1</companyFirmType>
        </request>
    </Service_Body>
</Service>'''

para_len = a.encode('utf-8')
filesize_bytes = len(a)
aa = str(filesize_bytes).zfill(7)
vars.put("num",aa)
log.info("========>"+aa)
变量a内部的变量直接就在计算长度前,就自动填充了,然后强制使用utf-8的格式进行字符数量计算,最总得到整个请求报文的字节数量,最后TCP取样器请求报文里还可以直接引用变量num,当做最终的报文的一部分发送给服务器
但是这段代码要完整执行,并正常请求到服务器,还有两个常见的坑要避开,目前我遇到的问题点主要如下:
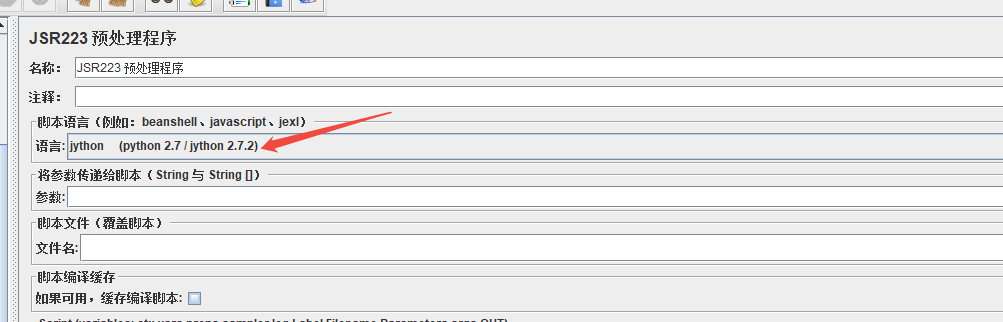
- 如果python脚本中需要用到中文,引用的python语言的版本最好是2.7版本,这个版本对中文的兼容性较好,否则容易出现乱码
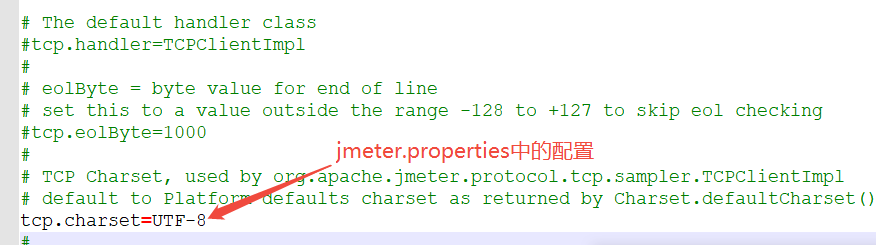
 2. jmeter后台的配置中关于tcp取样器请求必须默认使用utf-8的编码,否则发送到服务器的报文中,只要含有中文,就会有乱码
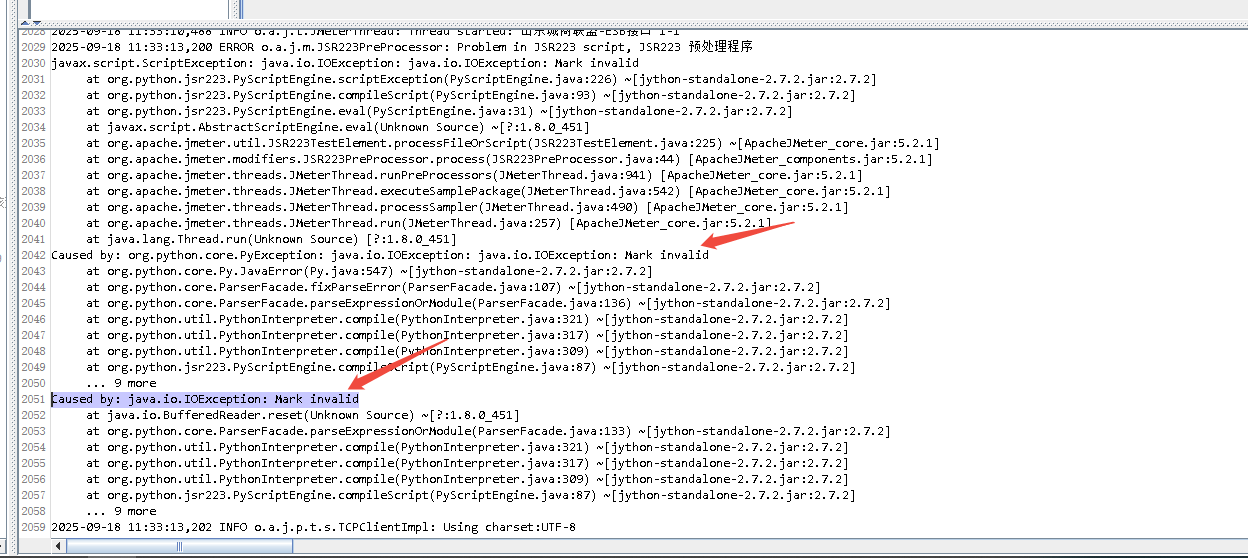
- a变量内部应用的变量体内容不能太长,对于大文件的读取jdk运行环境的缓存数量有限,jmeter工具配置的java堆栈空间一般是512M,所以建议内容不能超过50Kb,

python脚本中,变量a内部引用的变量【例如${param11}}等】超过50kb,jmetet就会出现如下的报错:
4、JSR223 PreProcessor预处理程序中引用的变量必须在执行前初始化完成,否则引用的变量值会检测不到数据,直接用${flowID}文本填充,计算出来的请求体的报文字节数就和实际发送的报文字节数不一致;在此,就引入一个jemter中预处理器的执行顺序,一个取样器内部的预处理器的执行顺序:物理添加顺序就是执行顺序,同一个取样器中包含一个前置处理器BeanShell PreProcessor和JSR223 PreProcessor,他们的顺序如下图可看到:
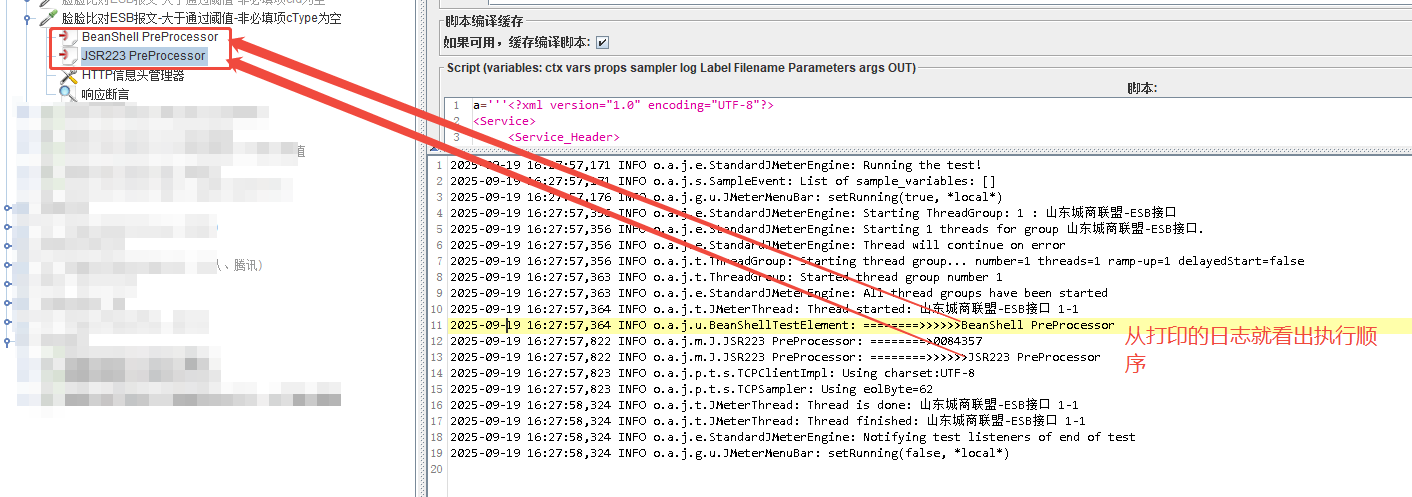

同一个请求两个处理器的顺序就计算出了,两个完全不一样的请求报文长度!!
更多推荐



 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)