
【分库分表】分库分表场景下分页查询的设计:痛点、根源与实战方案
一、背景:为什么分库分表后分页成了难题?
在业务初期,单库单表支撑所有数据,分页查询直接用 LIMIT offset, size 即可实现,例如查询第 11 页(每页 10 条):SELECT * FROM t_order ORDER BY create_time DESC LIMIT 100, 10。此时数据库能通过索引快速定位全局有序数据,性能稳定。
但当业务进入成长期,数据量突破千万级后,单库单表会面临三大瓶颈:
-
索引失效:单表数据量过大,B + 树索引层级增加(超过 3 层),查询从 “毫秒级” 沦为 “秒级”;
-
IO 瓶颈:单磁盘无法承载高频读写,磁盘 IO 利用率长期达 90% 以上;
-
运维风险:全表备份耗时超数小时,在线 DDL 可能导致业务中断。
为解决这些问题,分库分表成为必然选择 —— 通过水平分片(将单表数据拆分到多表 / 多库,如按用户 ID 哈希分 16 库 64 表)将数据分散存储。但分库分表后,传统分页逻辑彻底失效,性能和准确性问题凸显。
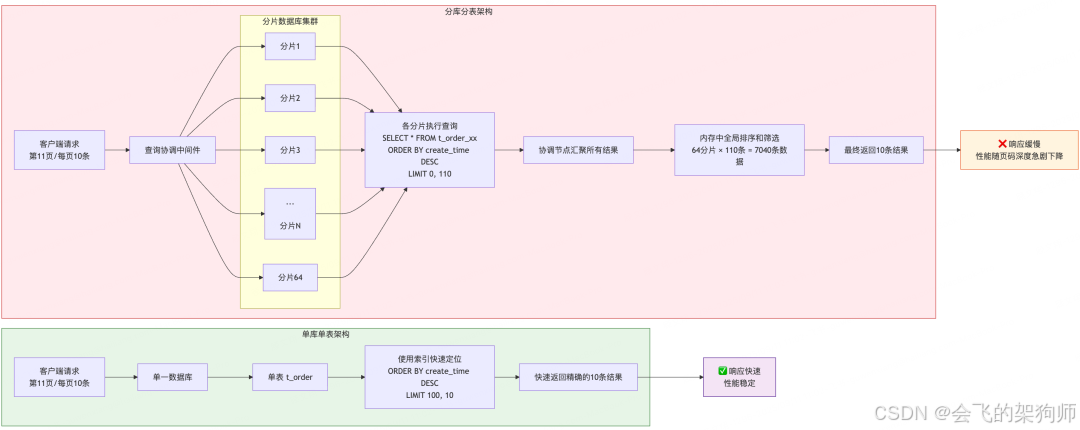
二、分库分表下分页查询的核心问题
1. 深度分页性能暴跌
现象:当 offset 增大时(如 LIMIT 10000, 10),查询耗时呈指数级增长。
实例:假设 t_order 按用户 ID 哈希分为 10 个分片(t_order_0 至 t_order_9),执行传统分页逻辑:
-
步骤 1:向 10 个分片各发送
SELECT * FROM t_order_x ORDER BY create_time DESC LIMIT 10010; -
步骤 2:收集 10 个分片返回的 100100 条数据,在应用层排序后取前 10 条。
问题:每个分片需扫描 10010 条数据,10 个分片累计扫描超 100 万条,大量冗余数据传输和内存排序直接拖垮系统。
2. 分页结果不准确
现象:分页数据重复、缺失,或排序混乱。
原因:
-
分片规则与排序字段不匹配:按用户 ID 分片却按创建时间排序,不同分片的时间范围重叠,聚合时可能漏掉跨分片的连续数据;
-
数据动态变更:查询过程中某分片插入新数据,导致前后页数据重复(如第 1 页末尾数据与第 2 页开头数据重叠)。
3. 多维度排序无法支持
现象:按非分片键排序(如 “按订单金额降序 + 支付时间升序”)时,性能极差甚至无法实现。
原因:非分片键字段没有全局索引,必须扫描所有分片的全量数据才能排序,相当于 “分布式全表扫描”,分片数越多,性能越差。
三、问题根源:分布式环境的 “全局有序性缺失”
分库分表后分页问题的本质,是数据分散存储导致的全局视图割裂:
-
单库单表中,数据库引擎维护全局有序索引(如
create_time上的 B + 树),LIMIT offset, size可直接在全局有序集合中截取片段,无需额外计算; -
分库分表后,每个分片是独立的数据库实例,仅维护本地数据的有序性,缺乏 “全局有序索引”;
-
offset是 “全局偏移量”,但分片只能理解 “本地偏移量”,导致必须拉取大量本地数据才能拼凑出全局结果 —— 这就是 “深度分页性能暴跌” 的核心根源。
四、实战解决方案:从 “偏移量” 到 “精准定位”
方案 1:基于全局唯一键的二次查询优化(浅分页首选)
核心思路:通过 “先查主键、再查详情” 减少冗余数据传输,适用于 offset < 1万 的浅分页场景(如后台管理系统)。
实现步骤
- 第一次查询(拉取主键):向各分片发送仅查询排序字段(需全局唯一有序,如雪花 ID、
create_time+order_id)的 SQL,减少数据传输量:
-- 分片t_order_0的查询
SELECT order_id, create_time FROM t_order_0 ORDER BY create_time DESC LIMIT 10010;
-
全局聚合排序:收集所有分片的(order_id, create_time)数据,在应用层按
create_time排序,截取第 10000-10010 条的order_id列表(如 [100001, 100002, …, 100010])。 -
第二次查询(拉取详情):根据
order_id路由到对应分片,查询完整数据:
-- 路由到order_id对应的分片
SELECT * FROM t_order_0 WHERE order_id IN (100001, 100002, ..., 100010) ORDER BY create_time DESC;
优势与局限
-
优势:相比直接拉取全量数据,传输量减少 80% 以上(主键仅 8-16 字节,完整行可能数百字节);
-
局限:
offset过大时(如 10 万),第一次查询仍需拉取大量主键,性能依然衰减。
代码示例(Java + MyBatis)
// 1. 第一次查询:拉取各分片的主键和排序字段
List<OrderKeyDTO> keyList = new ArrayList<>();
for (int shardIndex = 0; shardIndex < 10; shardIndex++) {
    // 切换分片(通过MyBatis插件或ShardingSphere实现)
    ShardContext.switchShard(shardIndex);
    List<OrderKeyDTO> shardKeys = orderMapper.selectKeysByPage(10010);
    keyList.addAll(shardKeys);
}

// 2. 全局排序并截取目标主键
List<OrderKeyDTO> sortedKeys = keyList.stream()
    .sorted(Comparator.comparing(OrderKeyDTO::getCreateTime).reversed())
    .skip(10000)
    .limit(10)
    .collect(Collectors.toList());

// 3. 第二次查询:拉取详情
List<Long> orderIds = sortedKeys.stream().map(OrderKeyDTO::getOrderId).collect(Collectors.toList());
List<OrderDTO> result = orderMapper.selectByIds(orderIds);
方案 2:游标分页(Keyset Pagination,深分页首选)
核心思路:用 “上一页最后一条数据的排序值” 替代 offset,实现 “无偏移量分页”,适用于 offset 无上限的深分页场景(如电商商品列表、订单流水)。
实现原理
排序字段必须满足全局唯一且有序(如雪花 ID、create_time+order_id),通过 “范围查询 + LIMIT” 定位下一页数据:
- 首页查询:直接查前 10 条,记录最后一条的排序值(
lastCreateTime、lastOrderId);
SELECT * FROM t_order ORDER BY create_time DESC, order_id DESC LIMIT 10;
- 下一页查询:以上一页的排序值为条件,查询后续数据;
SELECT * FROM t_order
WHERE create_time < ? OR (create_time = ? AND order_id < ?)
ORDER BY create_time DESC, order_id DESC LIMIT 10;
(注:create_time+order_id 组合确保唯一性,避免同一时间的订单排序混乱)
分库分表适配逻辑
-
向所有分片发送带游标条件的查询(如
create_time < '2025-09-11 00:00:00'); -
收集所有分片返回的数据,在应用层按排序字段重新排序;
-
取前 10 条作为当前页结果,同时记录这 10 条中最后一条的排序值作为下一页游标。
优势与局限
-
优势:性能稳定(每个分片仅扫描游标后的少量数据,与
offset无关)、结果无重复 / 缺失; -
局限:不支持跳页(如直接从第 1 页跳到第 10 页),仅支持 “上一页 / 下一页”。
代码示例(Java + ShardingSphere)
// 游标参数(上一页最后一条数据的排序值)
Long lastOrderId = 100000L;
LocalDateTime lastCreateTime = LocalDateTime.of(2025, 9, 10, 23, 59, 59);

// ShardingSphere自动路由到各分片执行查询
List<OrderDTO> currentPage = orderMapper.selectByCursor(
    lastCreateTime,
    lastOrderId,
    10
);

// 更新游标(取当前页最后一条数据的排序值)
if (!currentPage.isEmpty()) {
    OrderDTO last = currentPage.get(currentPage.size() - 1);
    lastCreateTime = last.getCreateTime();
    lastOrderId = last.getOrderId();
}
Mapper.xml SQL
<select id="selectByCursor" resultType="com.example.OrderDTO">
    SELECT * FROM t_order
    WHERE create_time < #{lastCreateTime}
       OR (create_time = #{lastCreateTime} AND order_id < #{lastOrderId})
    ORDER BY create_time DESC, order_id DESC
    LIMIT #{size}
</select>
方案 3:全局索引表(多维度排序场景)
核心思路:建立独立的全局索引表,存储所有分片的排序字段与主键,解决非分片键排序问题(如 “按订单金额降序分页”)。
实现步骤
- 创建全局索引表:在独立数据库中创建索引表,存储排序字段和主键:
CREATE TABLE t_order_index (
    order_id BIGINT PRIMARY KEY,
    amount DECIMAL(10,2) NOT NULL, -- 排序字段(非分片键)
    create_time DATETIME NOT NULL,
    shard_index INT NOT NULL -- 记录该订单所在的分片索引,用于路由
);
-- 建立排序索引
CREATE INDEX idx_amount_create_time ON t_order_index(amount DESC, create_time DESC);
-
同步索引数据:通过 Binlog 同步(如 Canal)或业务代码,在订单创建 / 更新时同步
t_order_index; -
分页查询流程:
- 步骤 1:查询全局索引表,获取目标页的
order_id和shard_index;
SELECT order_id, shard_index FROM t_order_index
ORDER BY amount DESC, create_time DESC
LIMIT 10000, 10;
- 步骤 2:根据
shard_index路由到对应分片,查询完整订单数据。
优势与局限
-
优势:支持任意维度排序,查询性能稳定;
-
局限:需维护额外索引表,存在数据同步延迟(毫秒级,大部分业务可接受)。
方案 4:中间件优化(ShardingSphere 配置)
主流分库分表中间件(如 ShardingSphere)提供内置分页优化,无需手动处理跨分片逻辑。
1. 自动 SQL 改写(解决浅分页冗余)
ShardingSphere 会自动将 LIMIT offset, size 改写为 LIMIT offset+size 发送到各分片,减少应用层代码量。例如:
-
原 SQL:
SELECT * FROM t_order ORDER BY create_time DESC LIMIT 10000, 10; -
改写后分片 SQL:
SELECT * FROM t_order_x ORDER BY create_time DESC LIMIT 10010; -
中间件自动聚合排序后返回目标 10 条数据。
2. 流式归并(降低内存占用)
默认情况下,ShardingSphere 会将所有分片数据加载到内存后排序(“内存归并”),当数据量过大时可开启 “流式归并”:
# ShardingSphere配置
spring:
  shardingsphere:
    rules:
      sharding:
        tables:
          t_order:
            # 分片配置...
        merge:
          t_order:
            type: STREAM # 流式归并:边接收数据边排序,内存占用低
五、方案选型决策表
| 方案类型 | 适用场景 | 支持跳页 | 性能瓶颈 | 开发成本 |
|---|---|---|---|---|
| 二次查询优化 | 后台管理(offset < 1 万) | 是 | 深度分页性能差 | 低 |
| 游标分页 | 前台列表(深分页) | 否 | 无(与页数无关) | 中 |
| 全局索引表 | 多维度排序(如排行榜) | 是 | 索引同步延迟 | 高 |
| ShardingSphere 默认 | 快速迭代项目 | 是 | 深度分页性能差 | 极低 |
六、实战避坑指南
-
排序字段必须唯一:避免使用单一时间字段排序(可能存在同一时间的多条数据),需搭配主键(如
create_time+order_id)确保全局唯一; -
限制深度分页:前端隐藏 “超深页码”(如 > 100 页),后端对
offset > 1万的请求返回 “数据量过大,请缩小查询范围”; -
分片键与排序键对齐:设计分片规则时,优先选择高频排序字段作为分片键(如按
create_time分表,天然支持时间排序分页),从源头减少跨分片聚合; -
监控分片数据倾斜:通过 Prometheus 监控各分片的查询耗时,若某分片数据量远超其他分片,需及时调整分片规则(如从 “哈希分片” 改为 “范围 + 哈希分片”)。
总结
分库分表下的分页设计,核心是 “放弃对 offset 的依赖,转向精准定位”。对于浅分页场景,用 “二次查询” 快速落地;对于深分页场景,游标分页是唯一可靠选择;对于多维度排序,全局索引表是必要妥协。结合 ShardingSphere 等中间件的自动化能力,可在 “性能” 与 “开发效率” 之间找到最佳平衡点。
更多推荐


 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)