
Redis原理(一):Redis中的数据结构
关于redis的原理,我们需要掌握的内容有四个部分,分别是:数据结构、网络模型、通信协议以及内存策略,在第一章我们首先需要了解redis底层的数据结构,以及我们常用的几种数据类型包括:String、Hash等是怎么由这些数据结构构成。
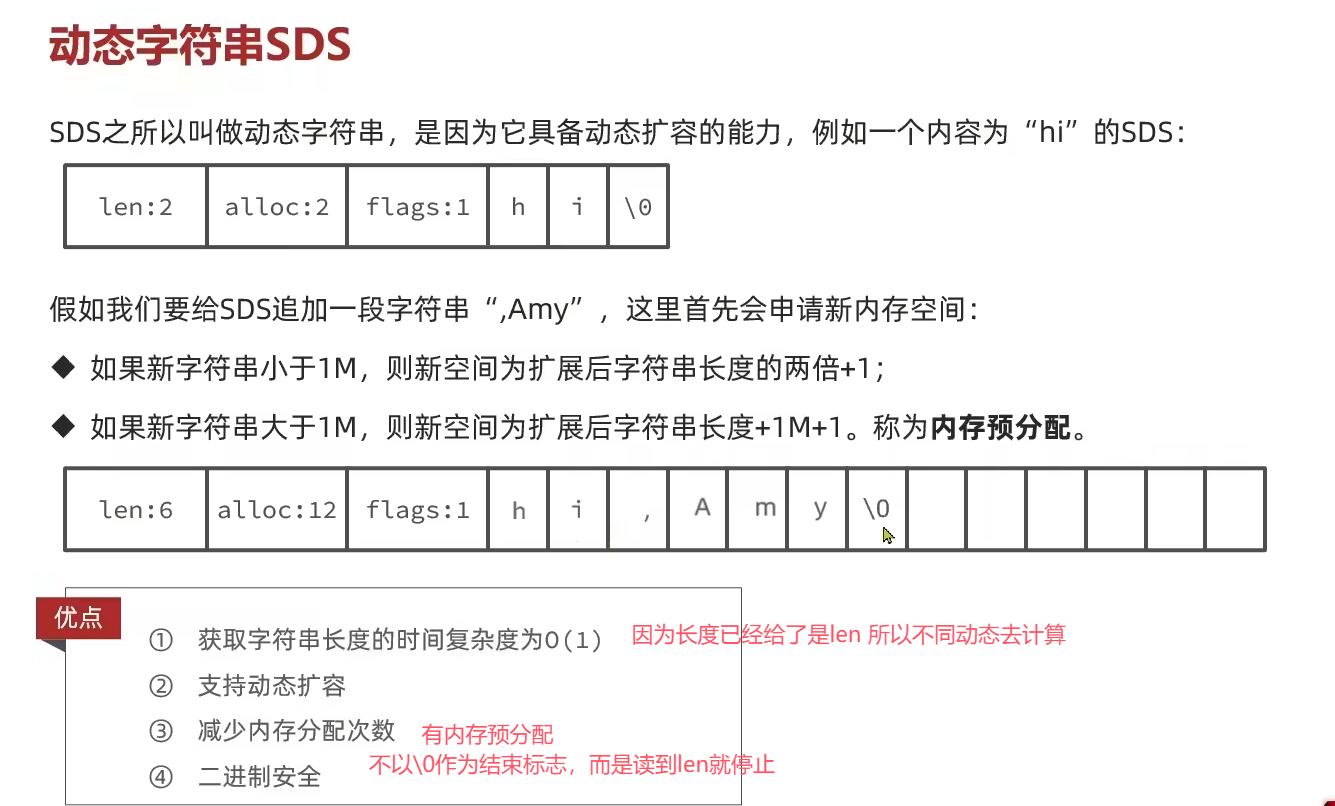
SDS(Simple Dynamic String)
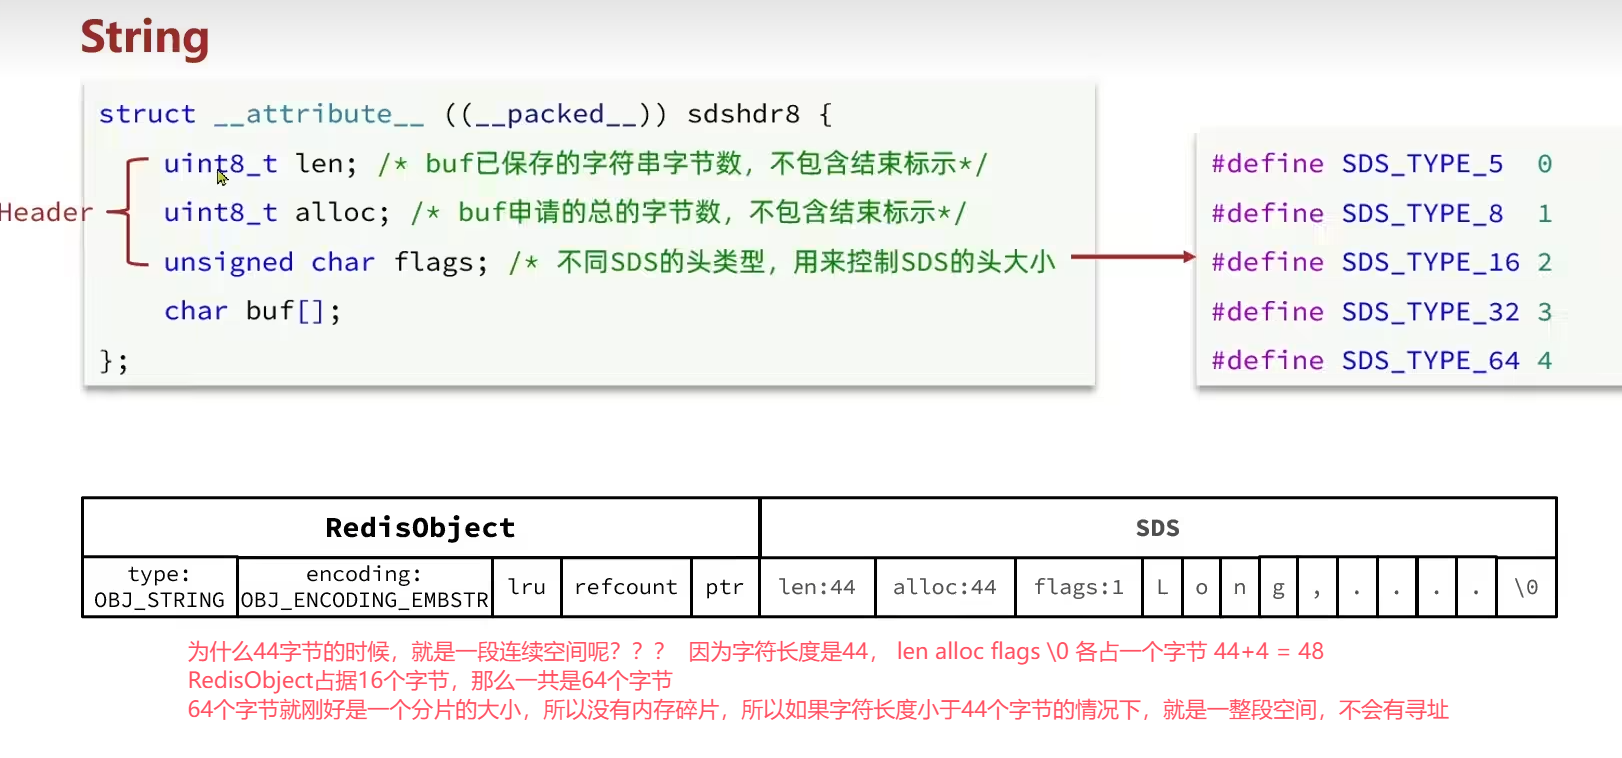
SDS是Redis自定义的字符串类型,用于替代C语言原生的字符数组。结构包含len(已用长度)、free(剩余空间)和buf(字符数组)。优势在于:
- O(1)时间复杂度获取长度:直接读取
len字段。 - 二进制安全:通过
len判断字符串结束,而非依赖\0。 - 自动扩容:当空间不足时,按需分配额外空间,减少内存重分配次数。
intSet(整数集合)
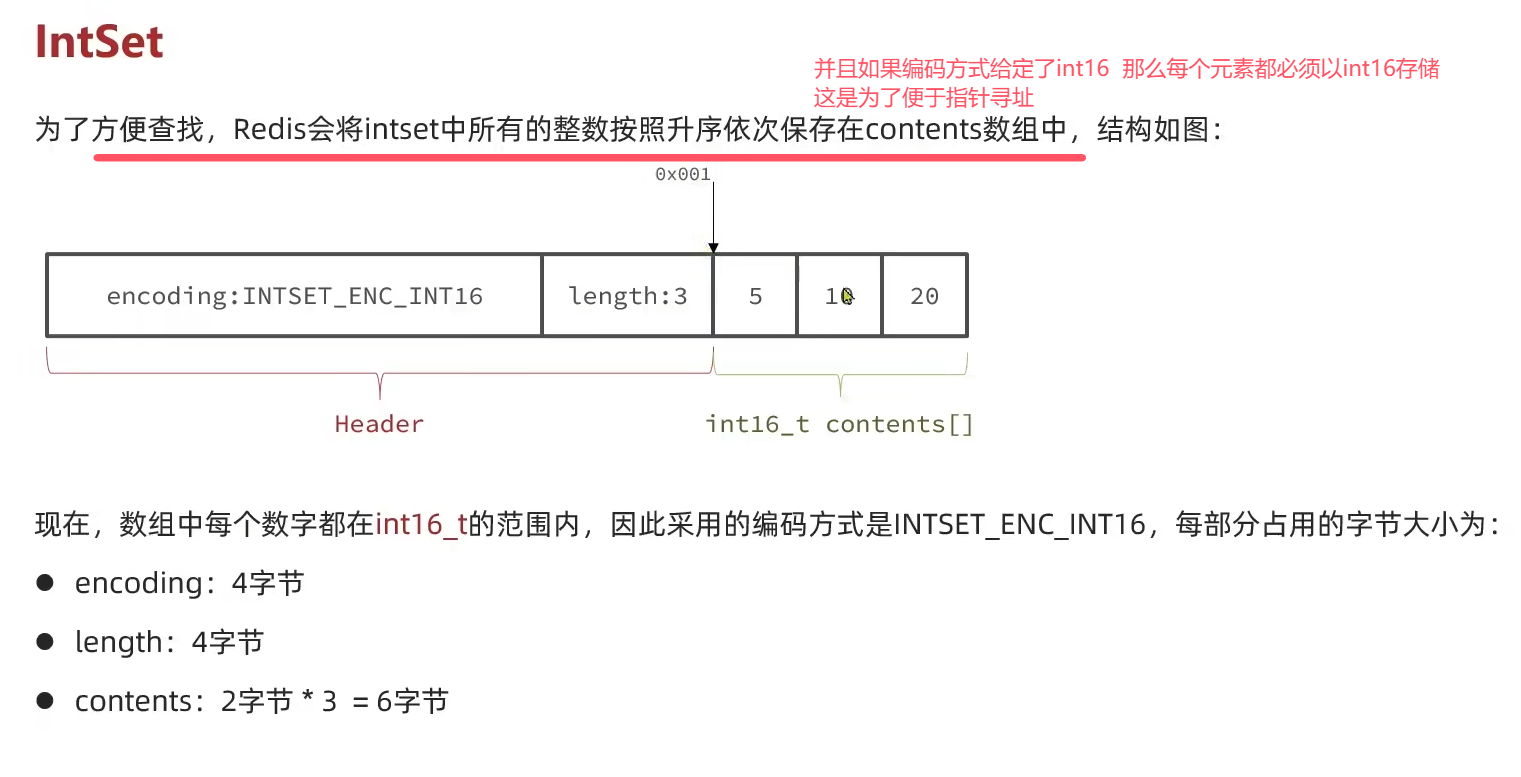
intSet用于存储有序、不重复的整数,根据元素大小自动选择int16_t、int32_t或int64_t编码。结构包含encoding(编码类型)、length(元素数量)和contents(整数数组)。特点包括:
- 内存紧凑:根据最大元素动态升级编码,节省空间。
- 二分查找:利用有序特性支持高效查询。
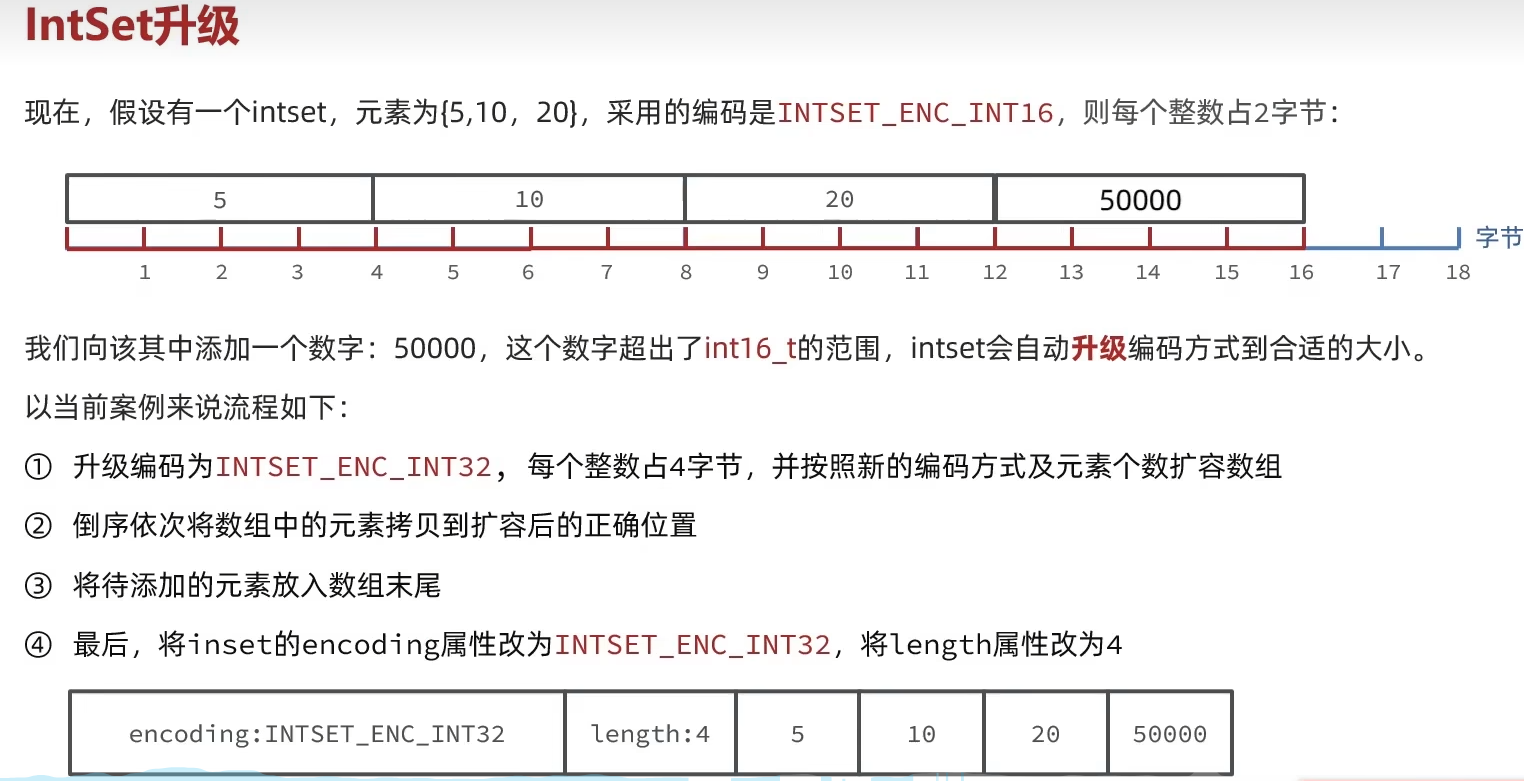
并且IntSet还存在一个特点,与SDS类似,它也会进行自动扩容:
Dict(字典)
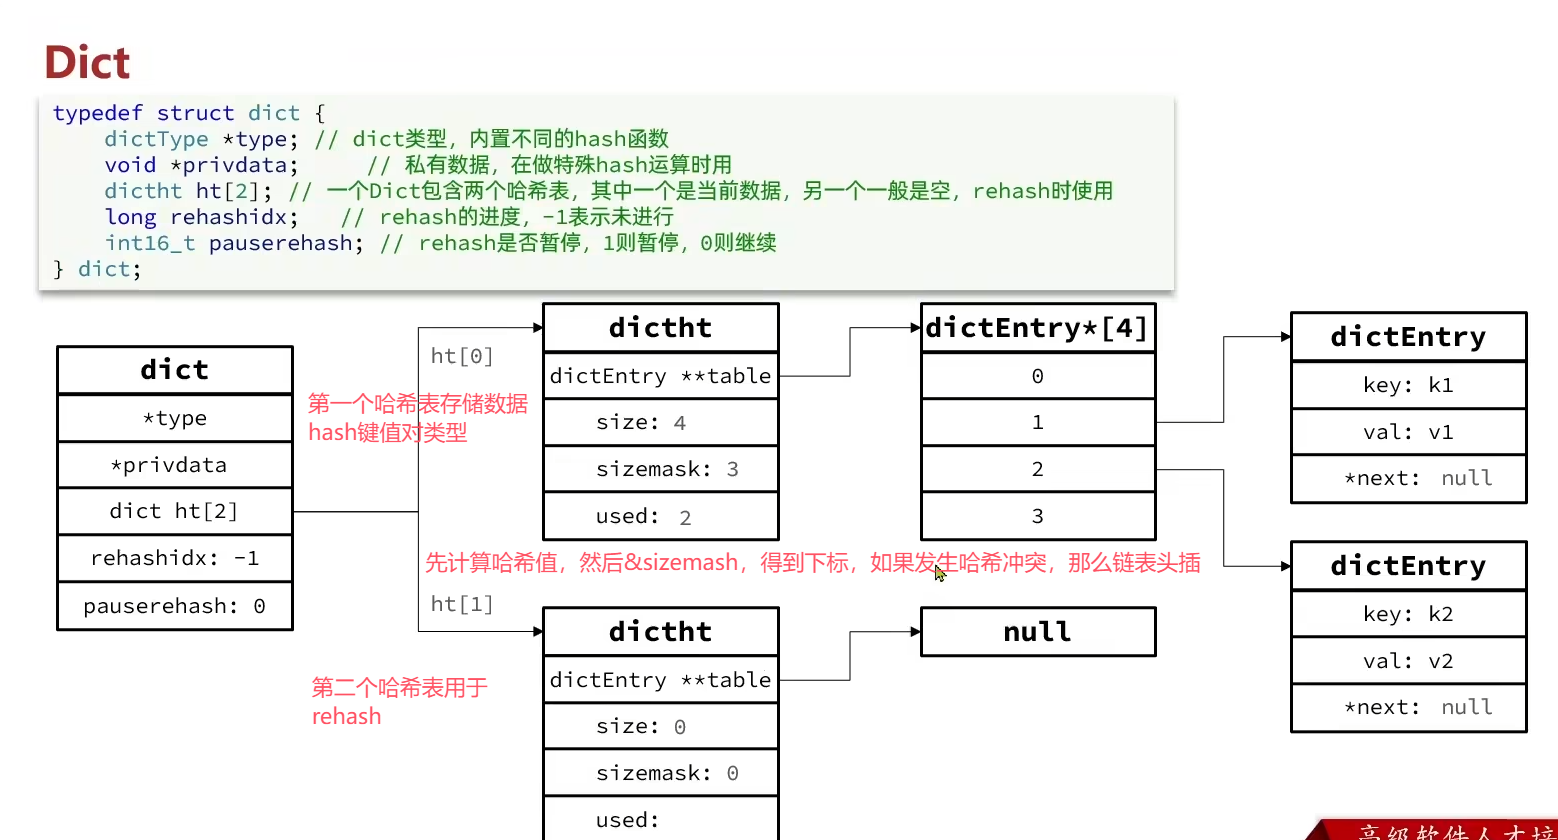
Redis使用Dict实现键值对存储,采用哈希表结构,包含两个哈希表(ht[0]和ht[1])用于渐进式Rehash。关键设计:
- 链式哈希解决冲突:通过链表处理哈希冲突。
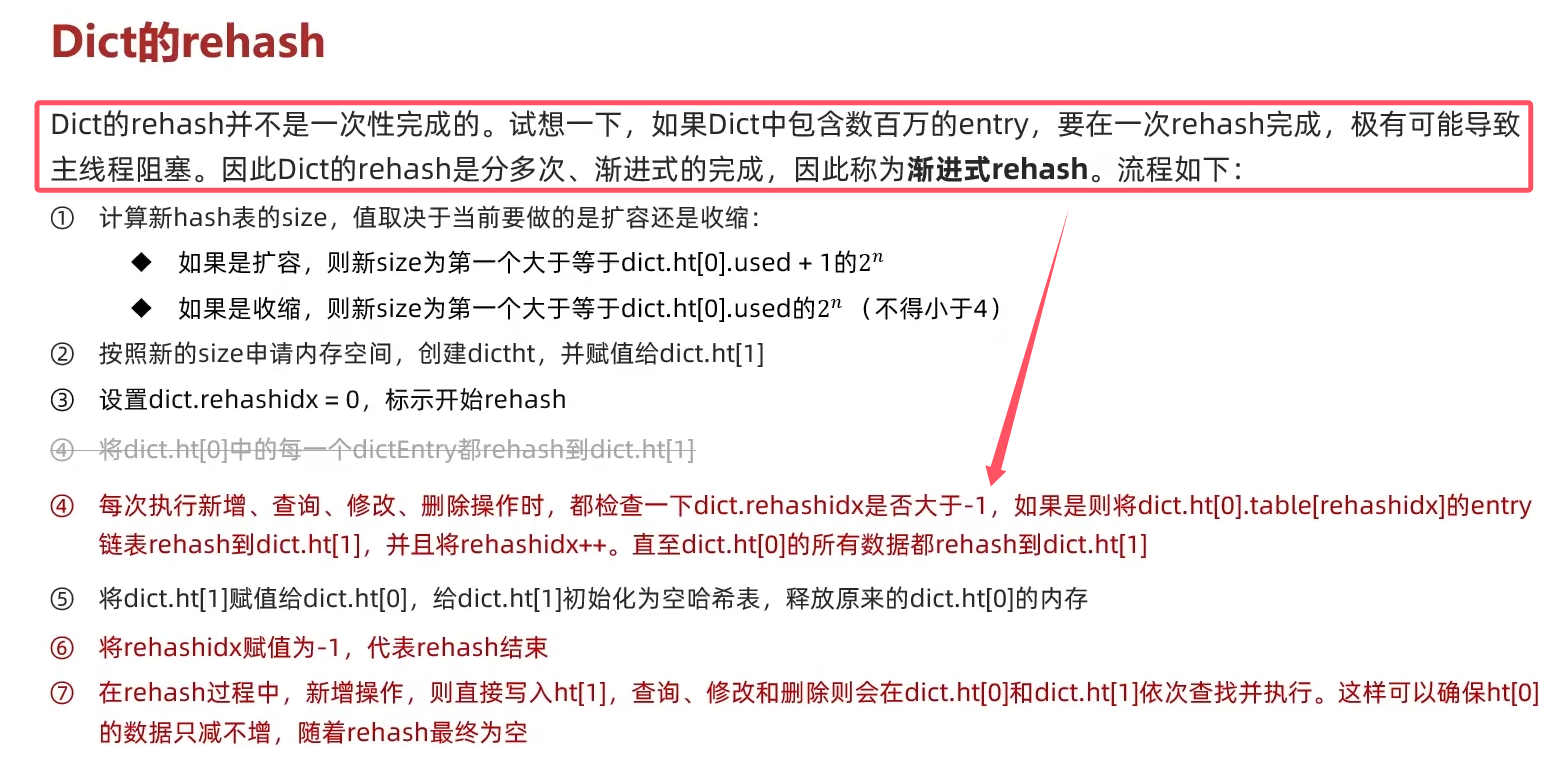
- 渐进式Rehash:在扩容时逐步迁移数据,避免阻塞服务。
在java中,当Hash表某个节点的数据量太大,就会形成单链表,导致查询效率大大降低,这个时候java的处理方法是,转为红黑树,但是redis底层并不是这样做的:
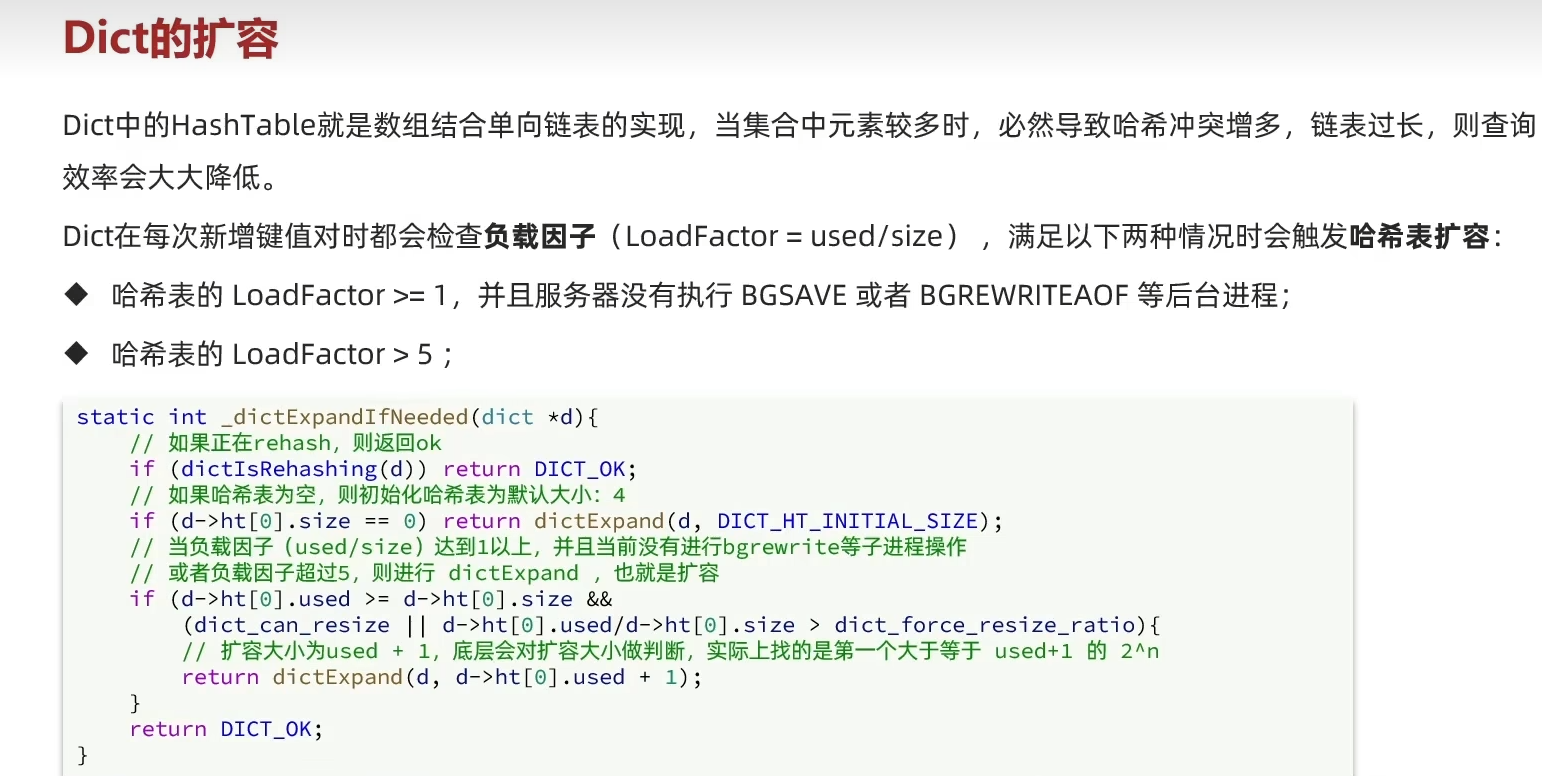
他会对哈希表进行扩容(并且当时并没有进行redis的数据持久化操作,如RDB、AOF文件重写等)
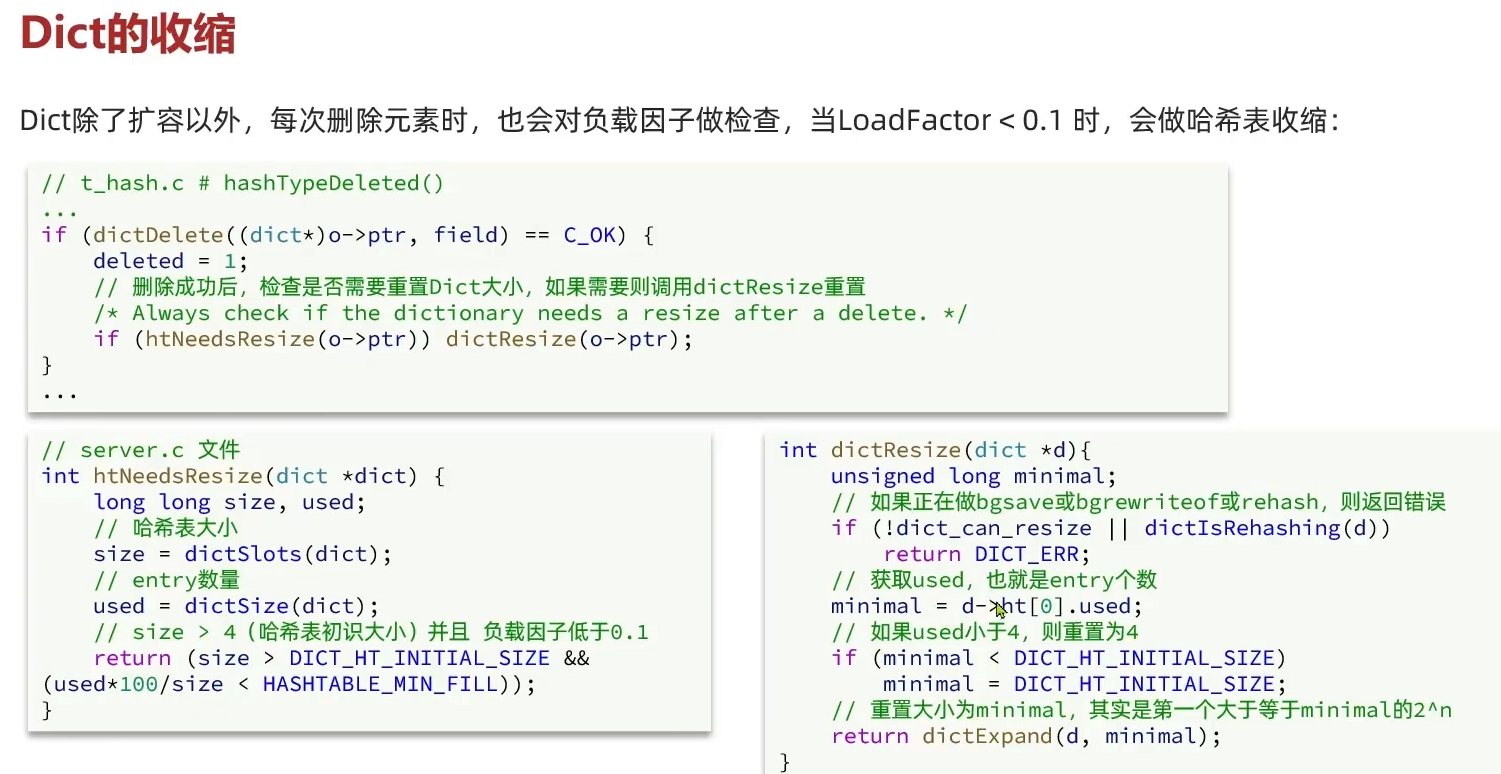
Dict除了扩容,还会在元素减少到一定程度之后自动收缩:
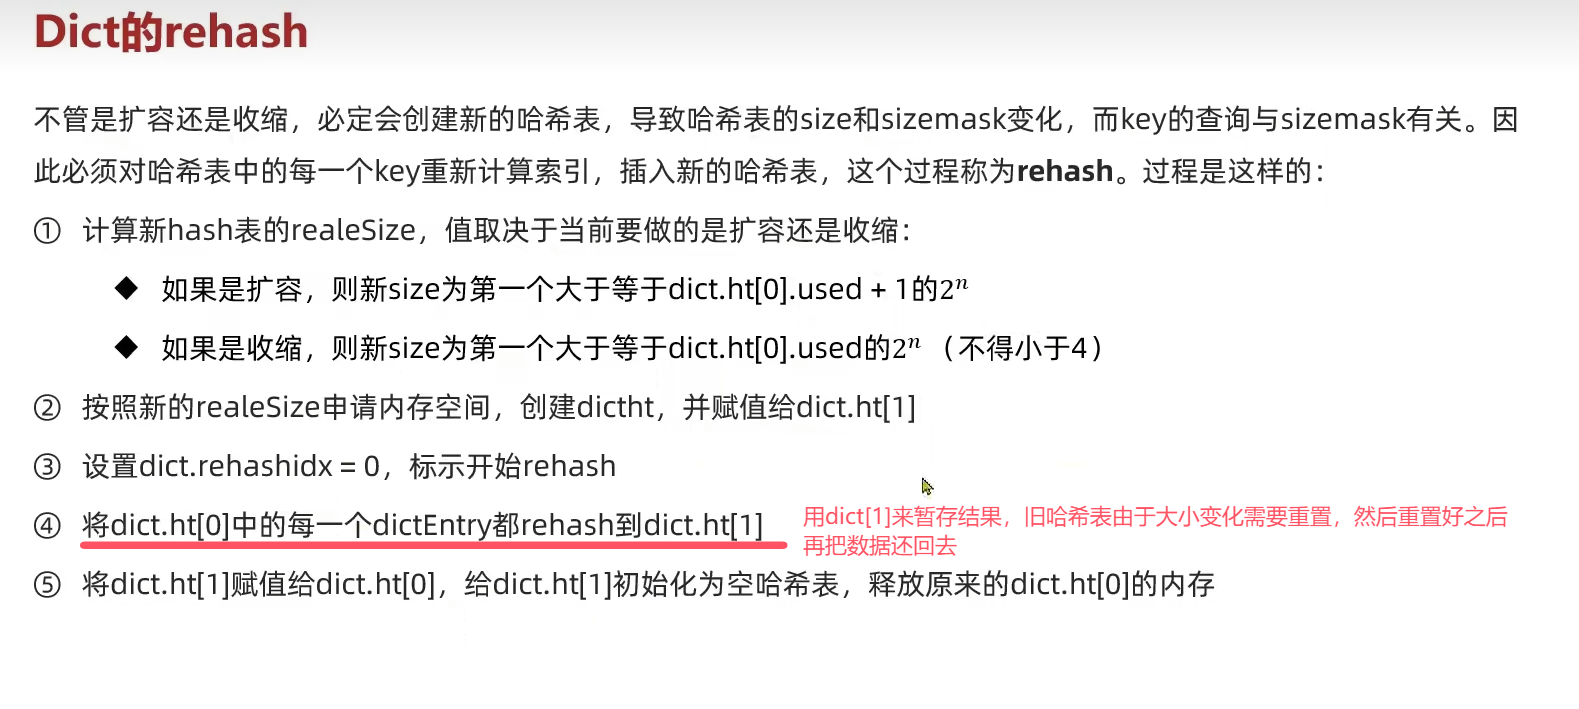
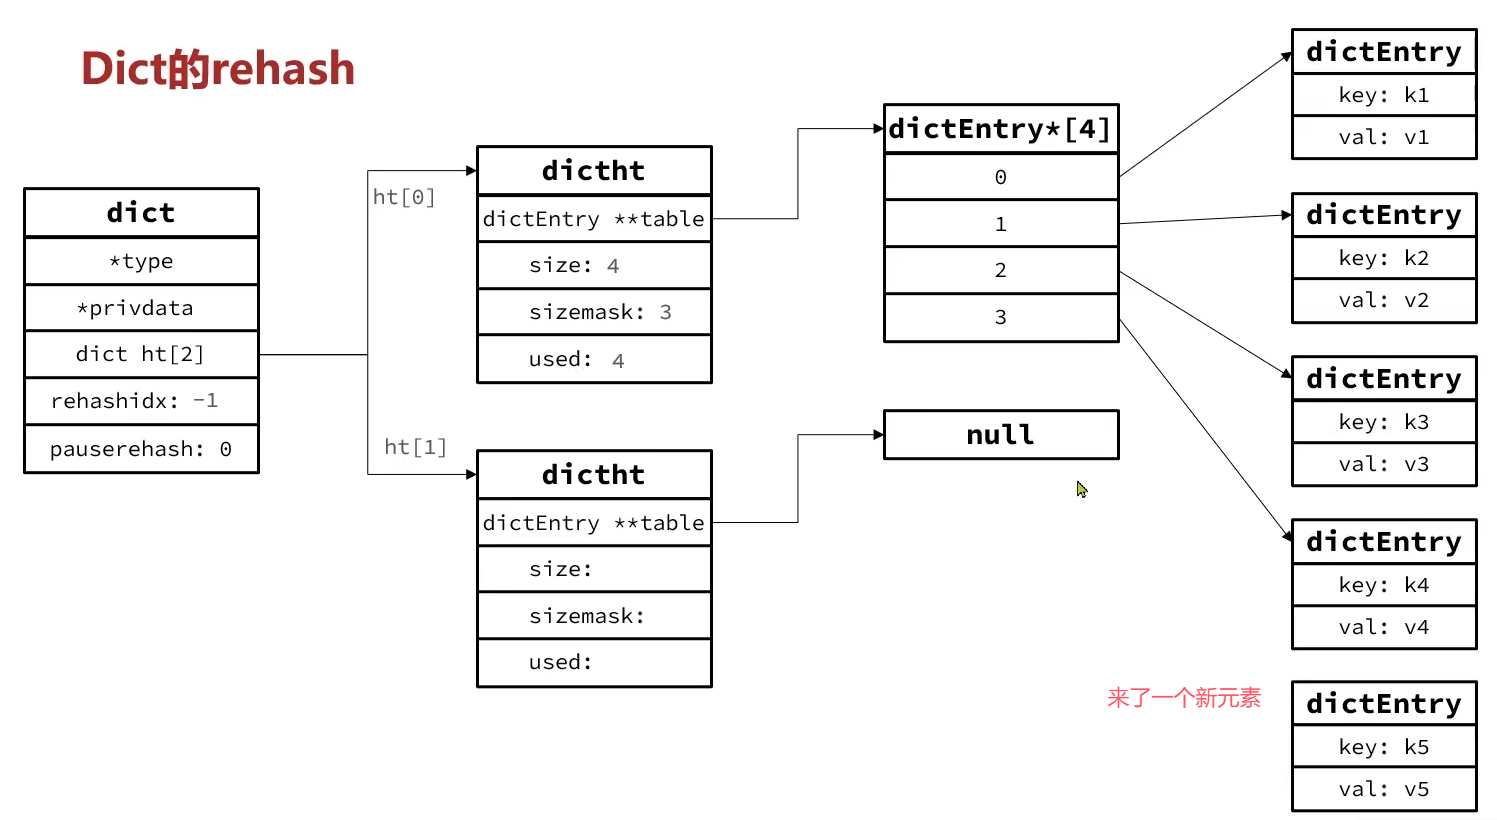
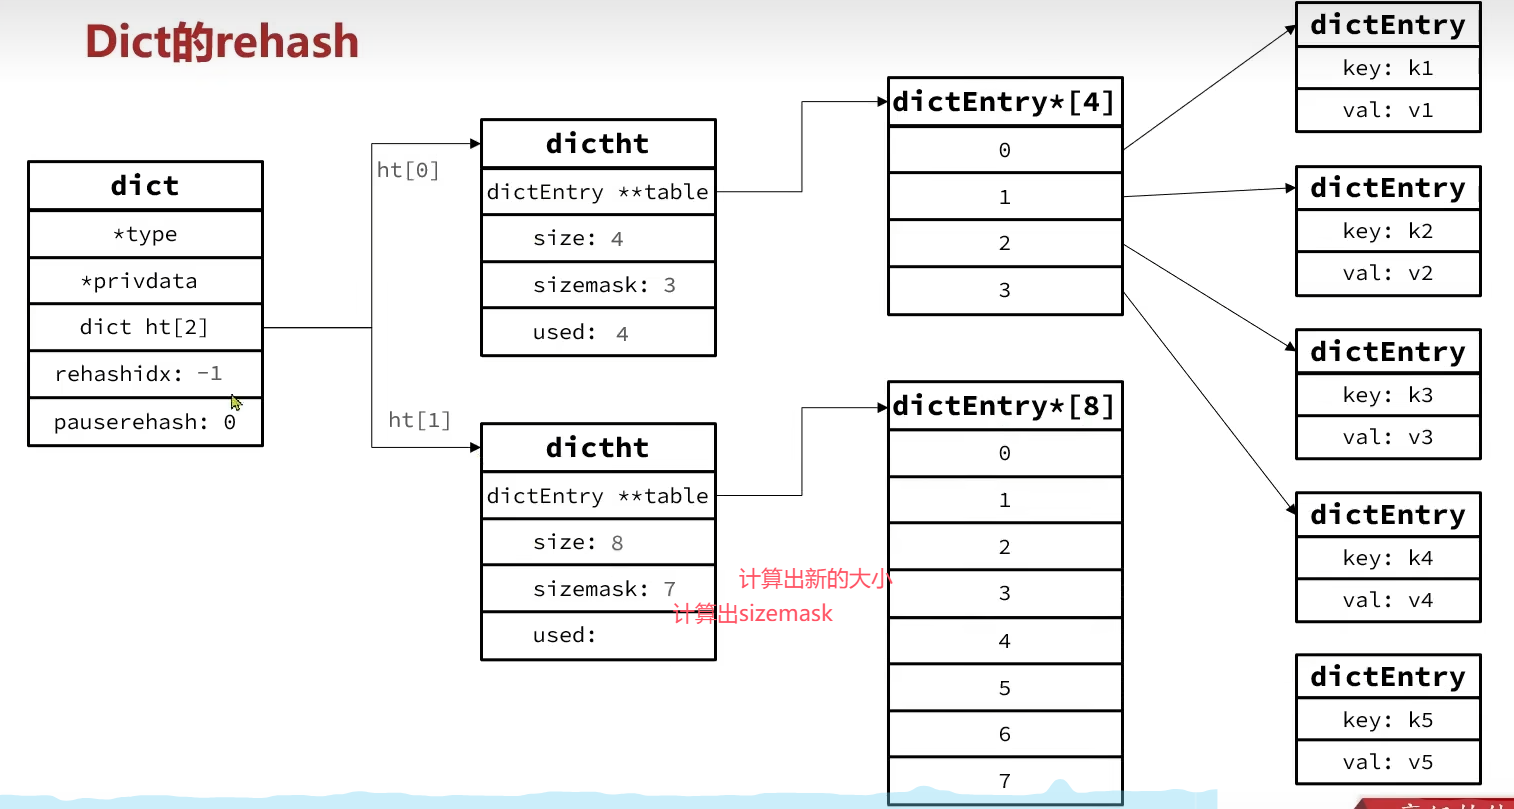
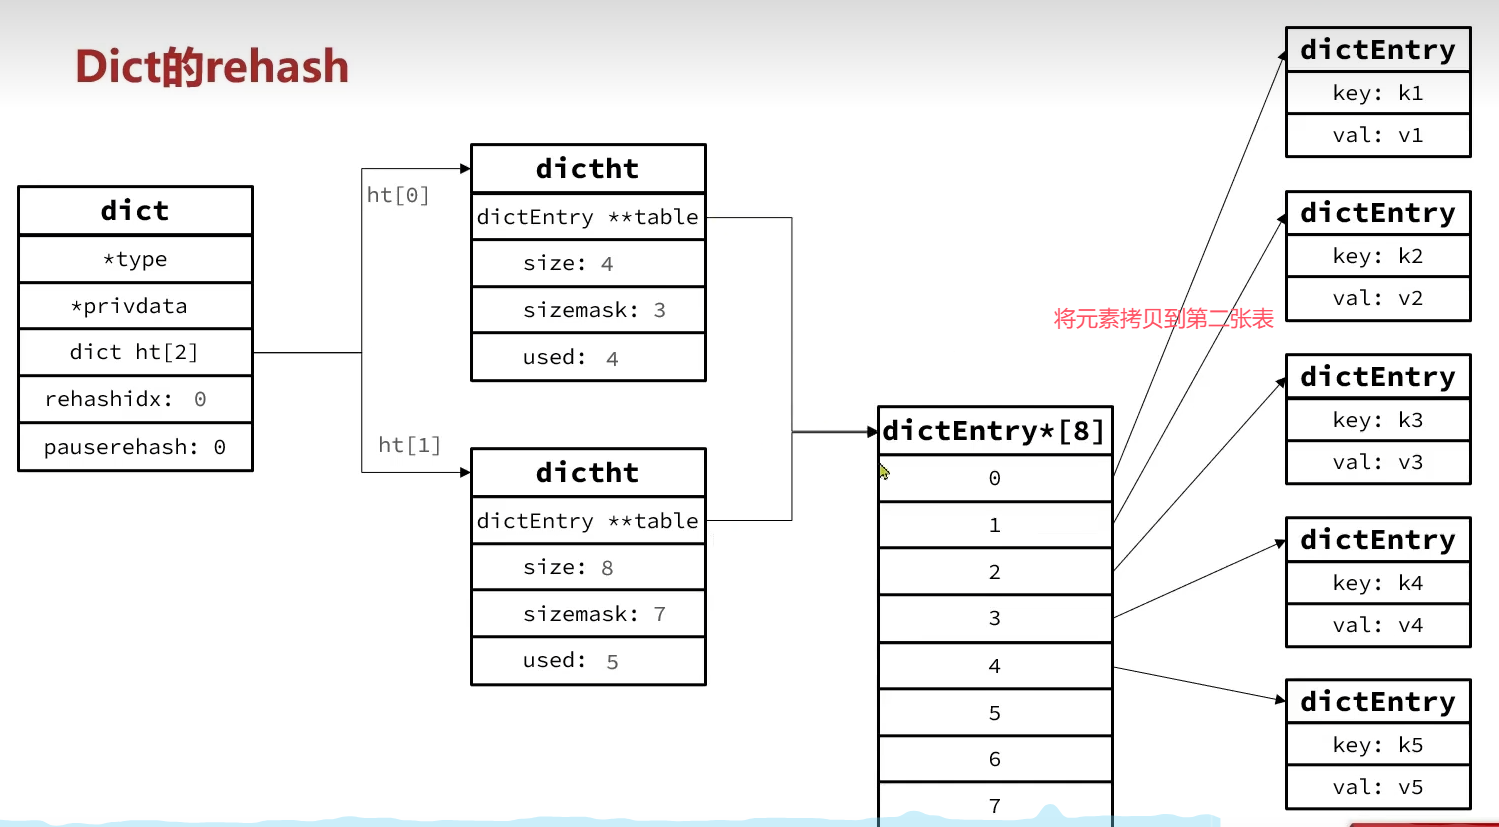
我们要知道hash表中的每个数据都是由hash算法计算出的位置,不管是扩容还是收缩,都会导致哈希表的size(容量大小)和sizemask(size-1,是计算位置的掩码)变化,所以需要重新计算每个key-value的位置,这个时候就需要用到ht[1]了,先将内容暂存在其中,然后对ht[0]重构,最后将数据从ht[1]迁移回来,这个过程称为rehash:
ZipList(压缩列表)
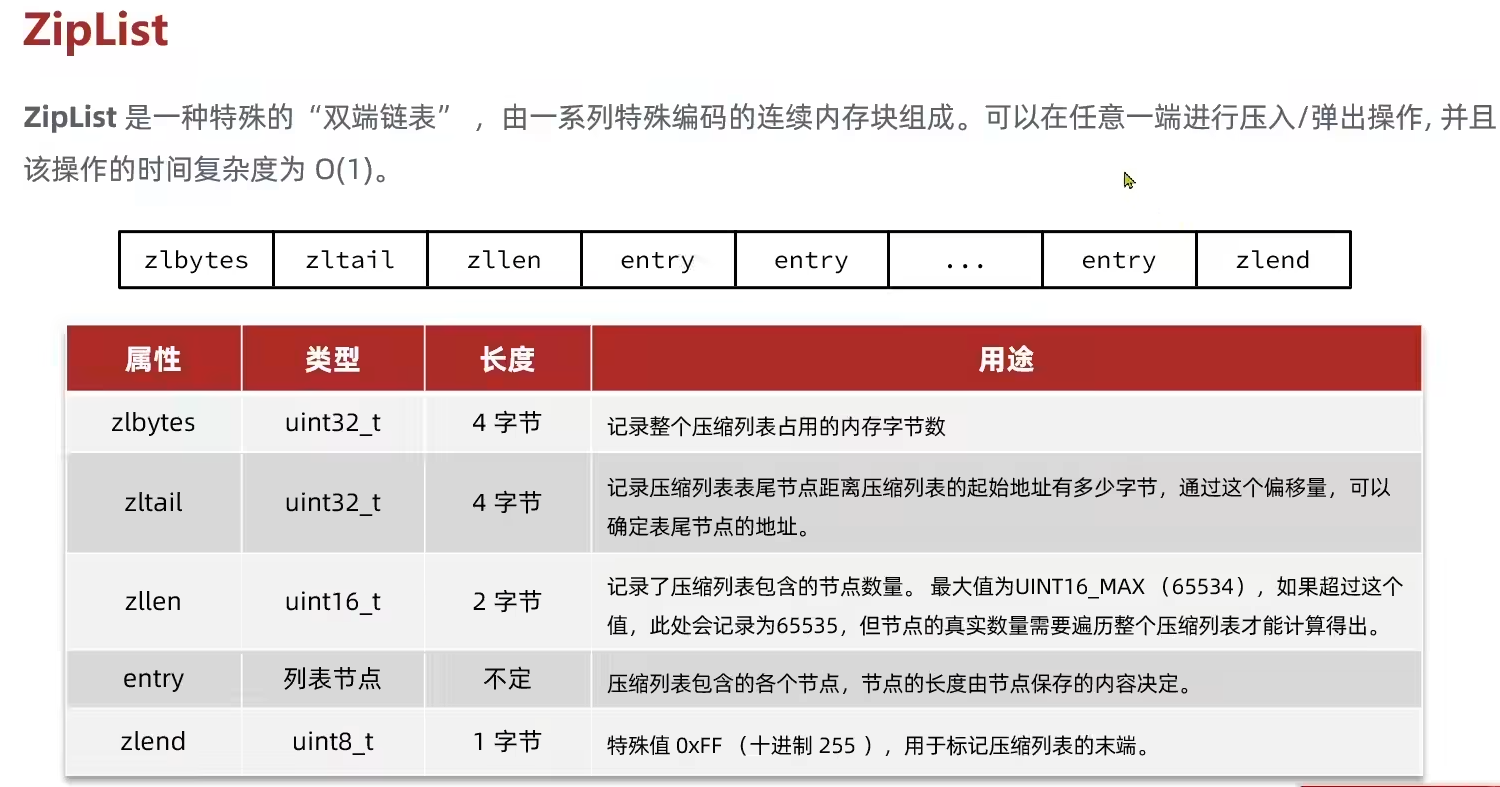
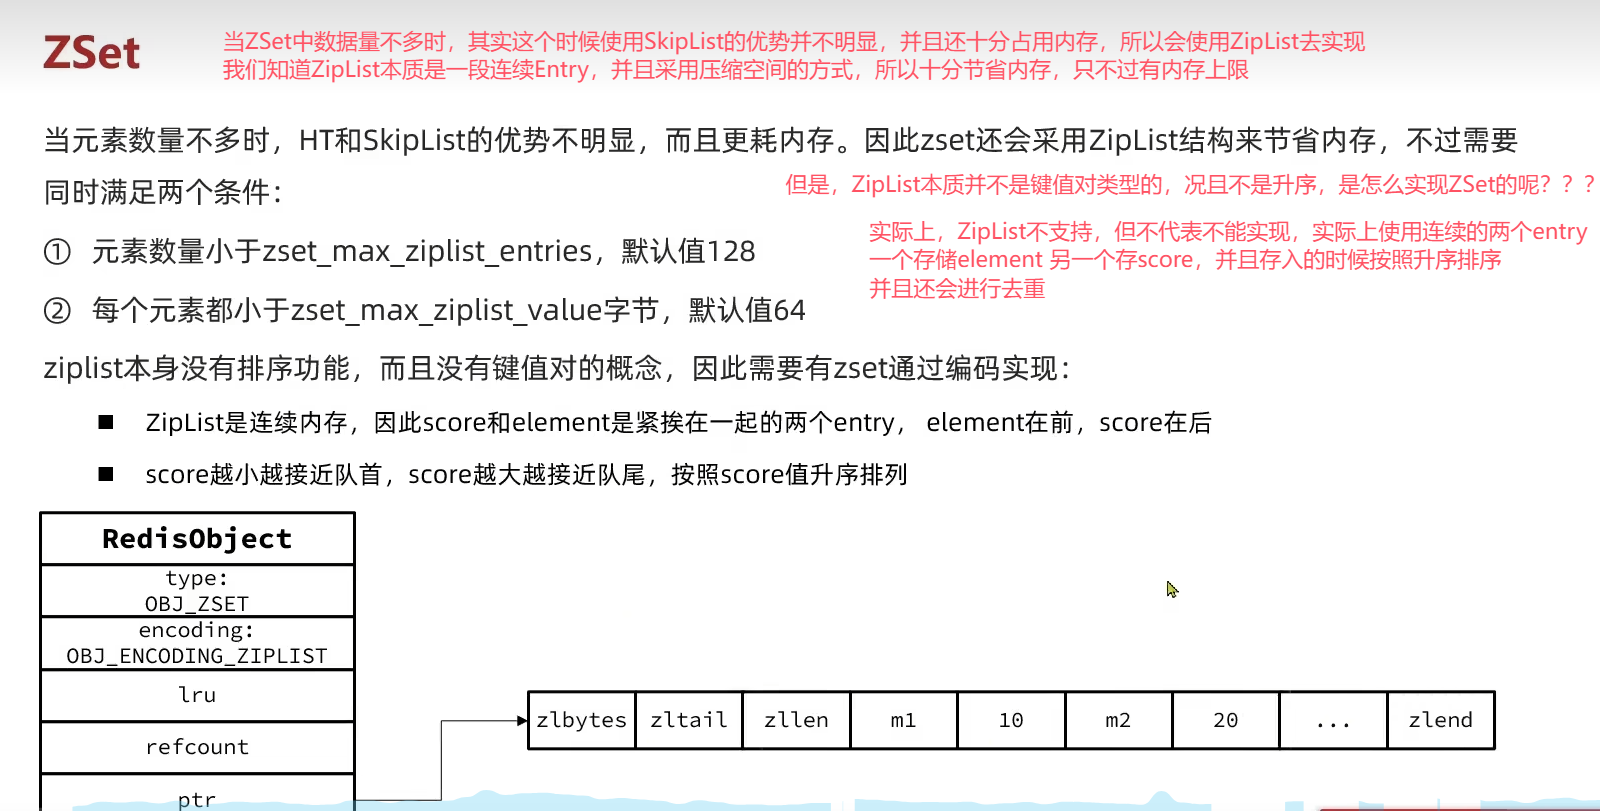
ZipList是一种紧凑的线性结构,适用于小型列表或哈希。内存布局为连续字节数组,包含zlbytes(总字节数)、zltail(尾部偏移量)、zllen(元素数量)和entry(元素列表)。特点有:
- 内存高效:省去指针开销,存储实际数据与元信息。
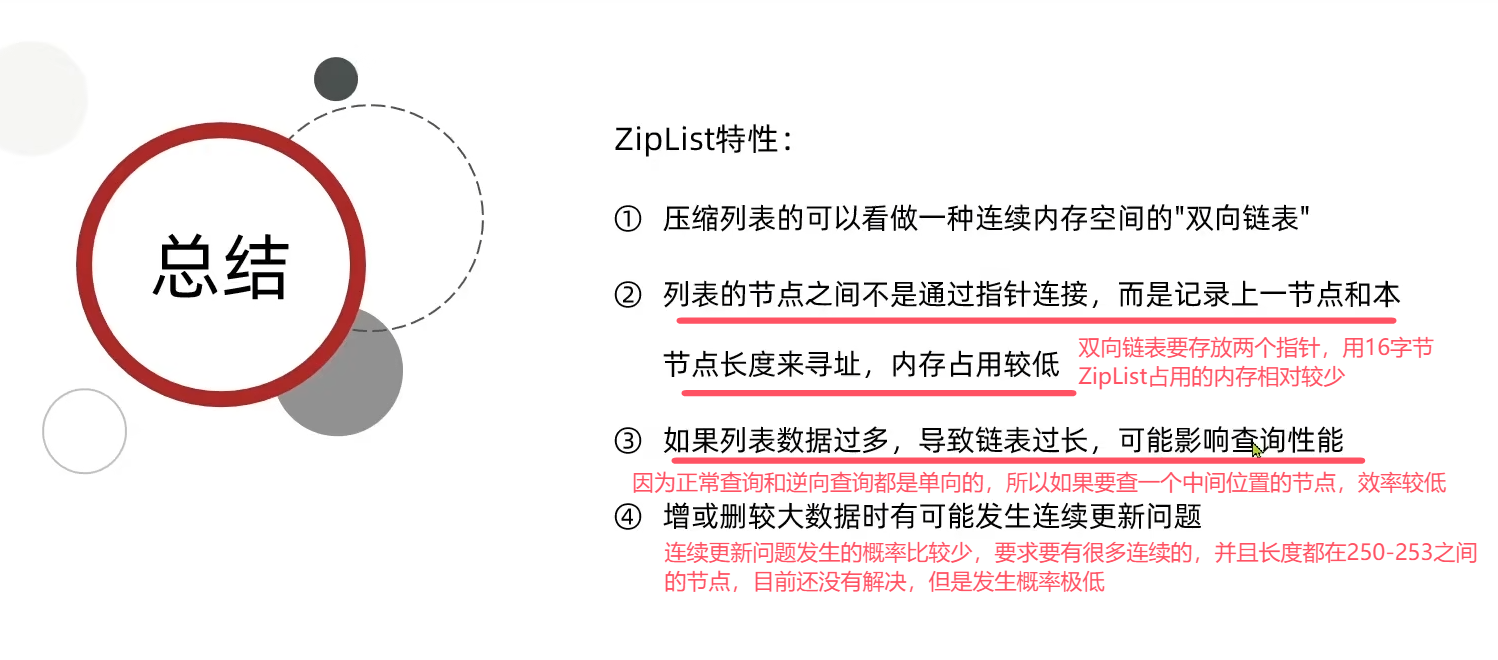
- 双向遍历:支持从头部或尾部访问,但插入/删除需内存移动。
我们对ZipList需要知道,他也能实现双向遍历,但是并不是像双向链表一样通过指针实现,而是记录当前块与上一块的大小,从而计算出下一块的索引位置,为什么这样做? 因为一个指针大小是8字节,但是如果通过这种方式记录,可以大大节省空间。
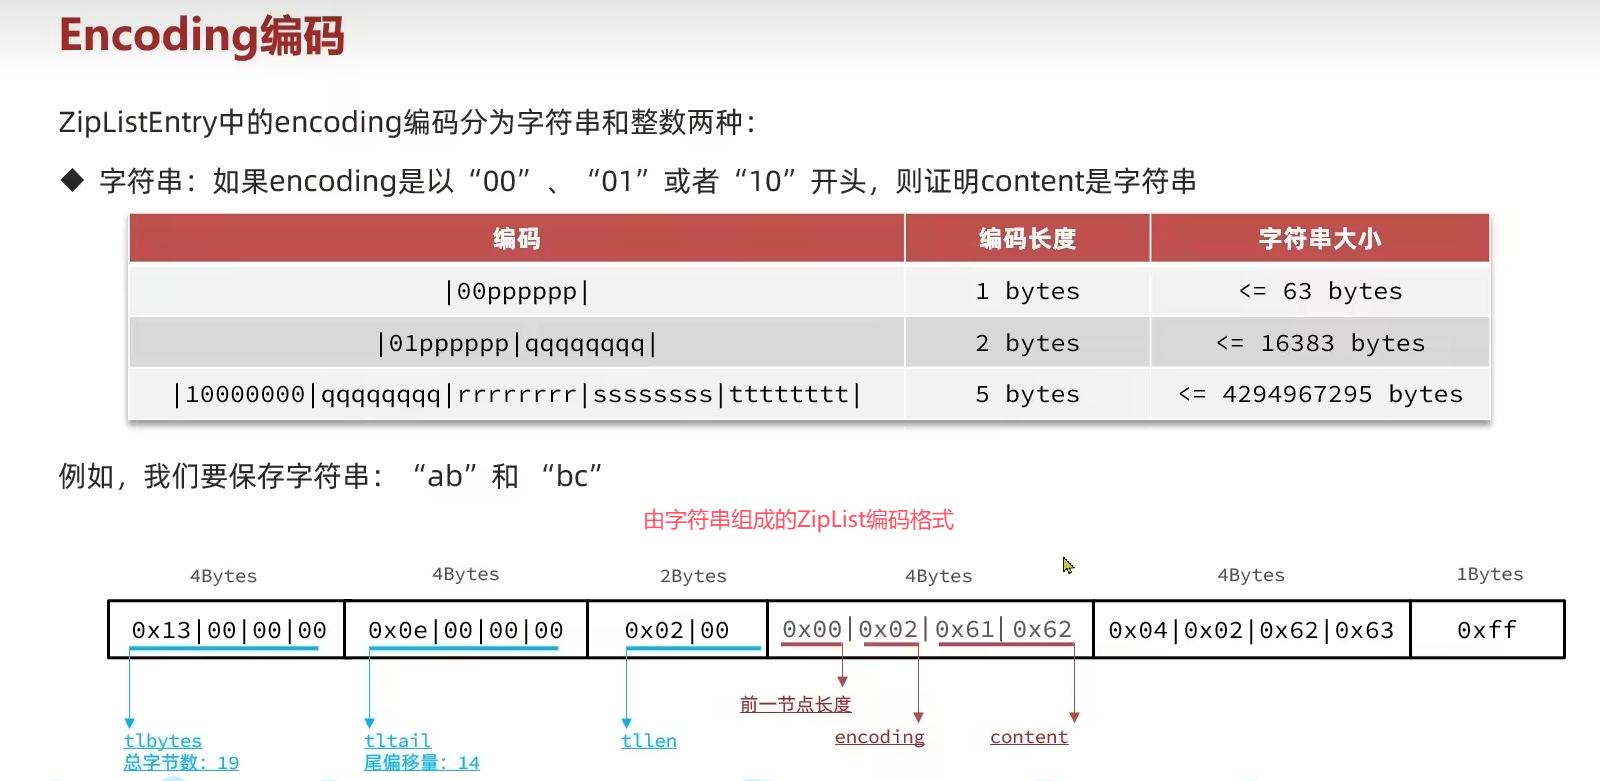
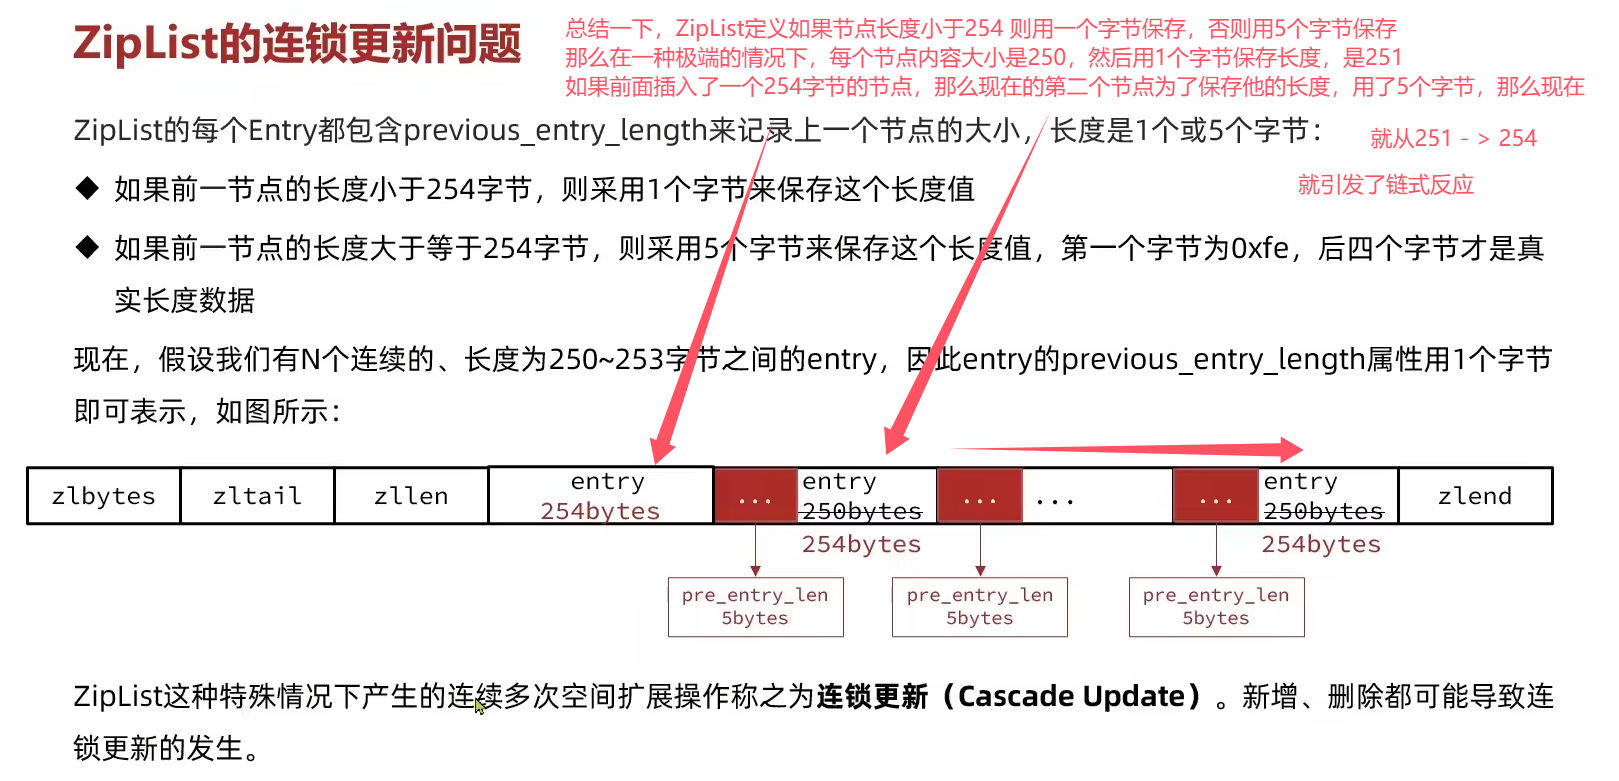
但是!!! ZipList存在一个重大问题:由于它使用254字节作为一个节点的边界阈值,如果大于这个值就会用个字节来创建这个entry,所以会出现下面的问题:
QuickList(快速列表)
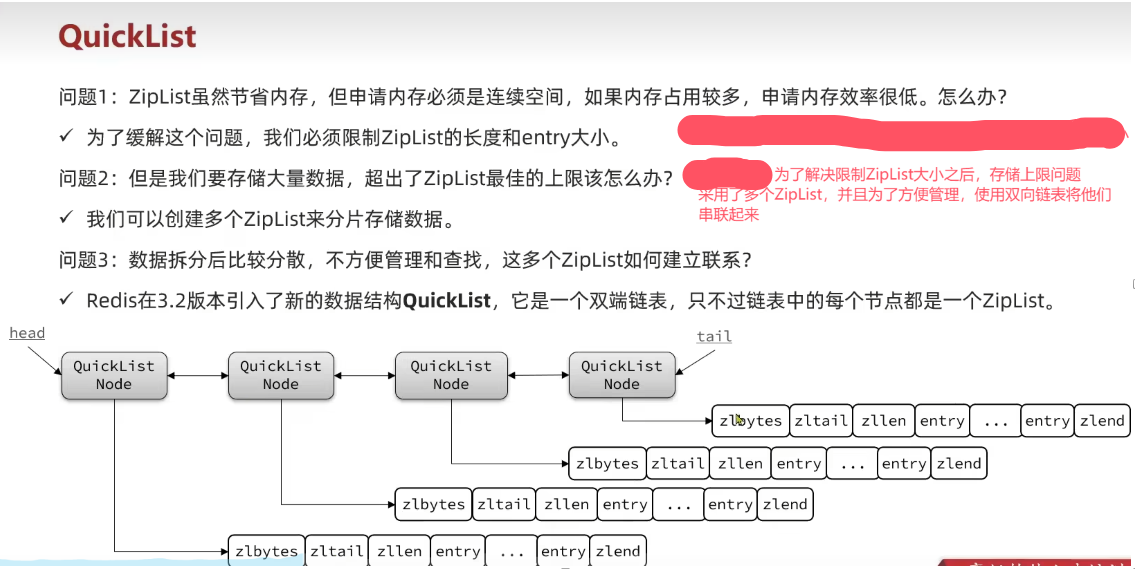
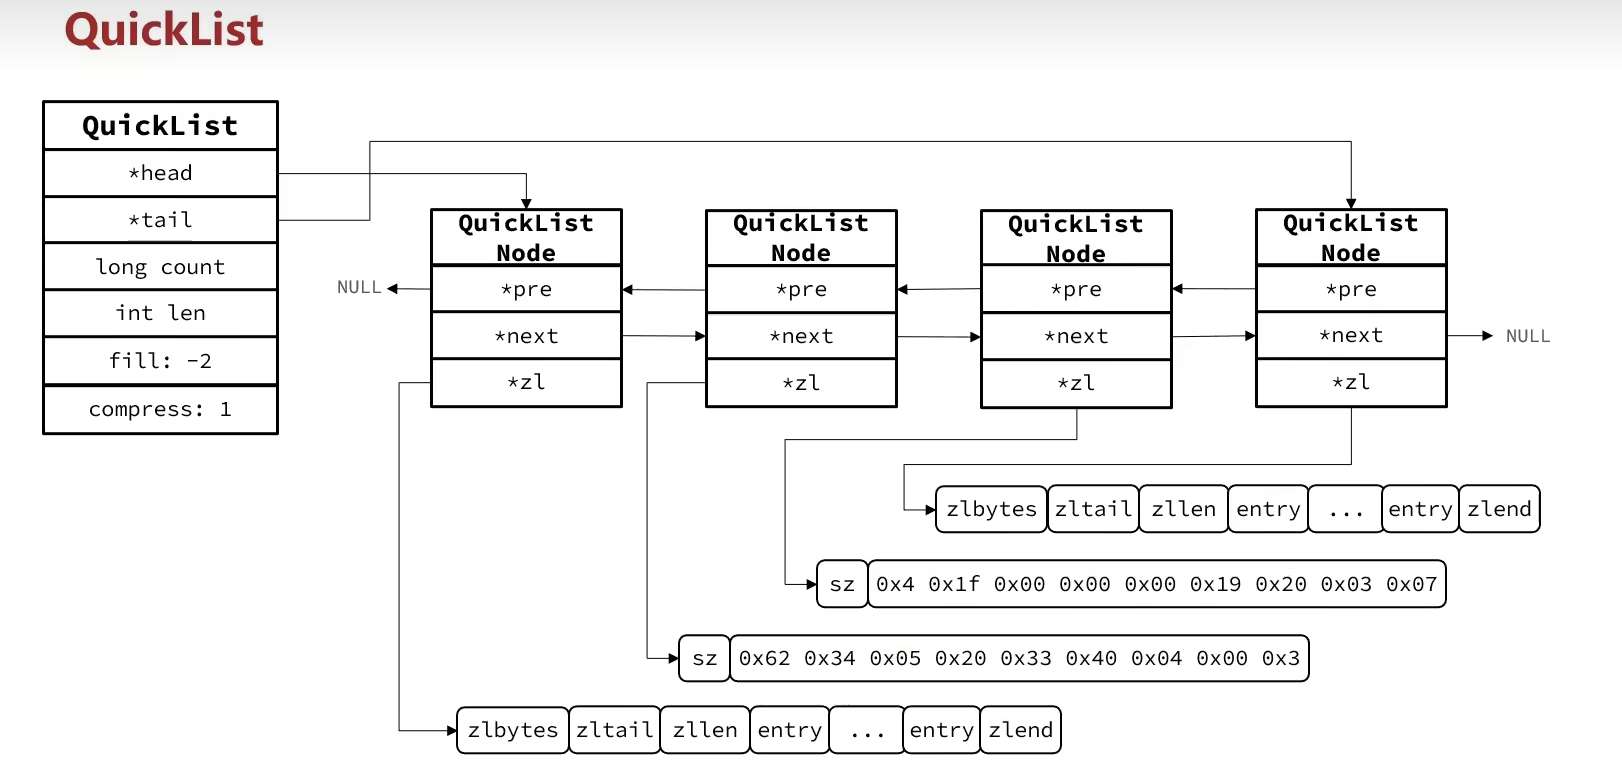
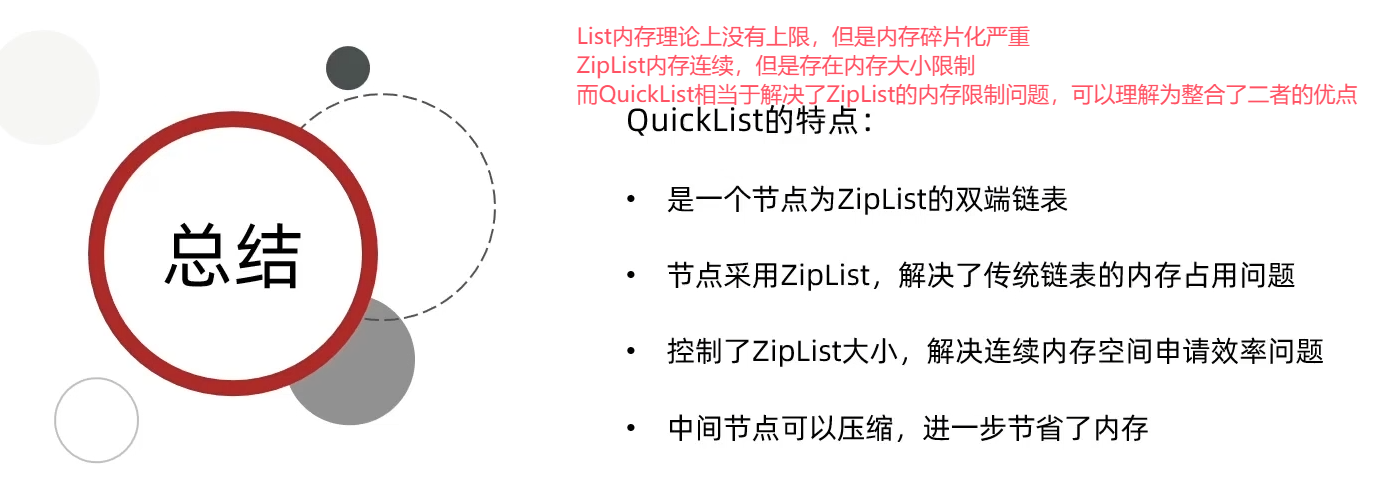
QuickList是Redis 3.2引入的列表底层实现,结合了ZipList和双向链表的优点。结构由多个ZipList节点通过双向链表连接而成。核心特性:
- 平衡内存与性能:通过
list-max-ziplist-size控制单个ZipList大小。 - LZF压缩:可选配置对节点进行压缩,进一步节省空间。
SkipList(跳跃表)
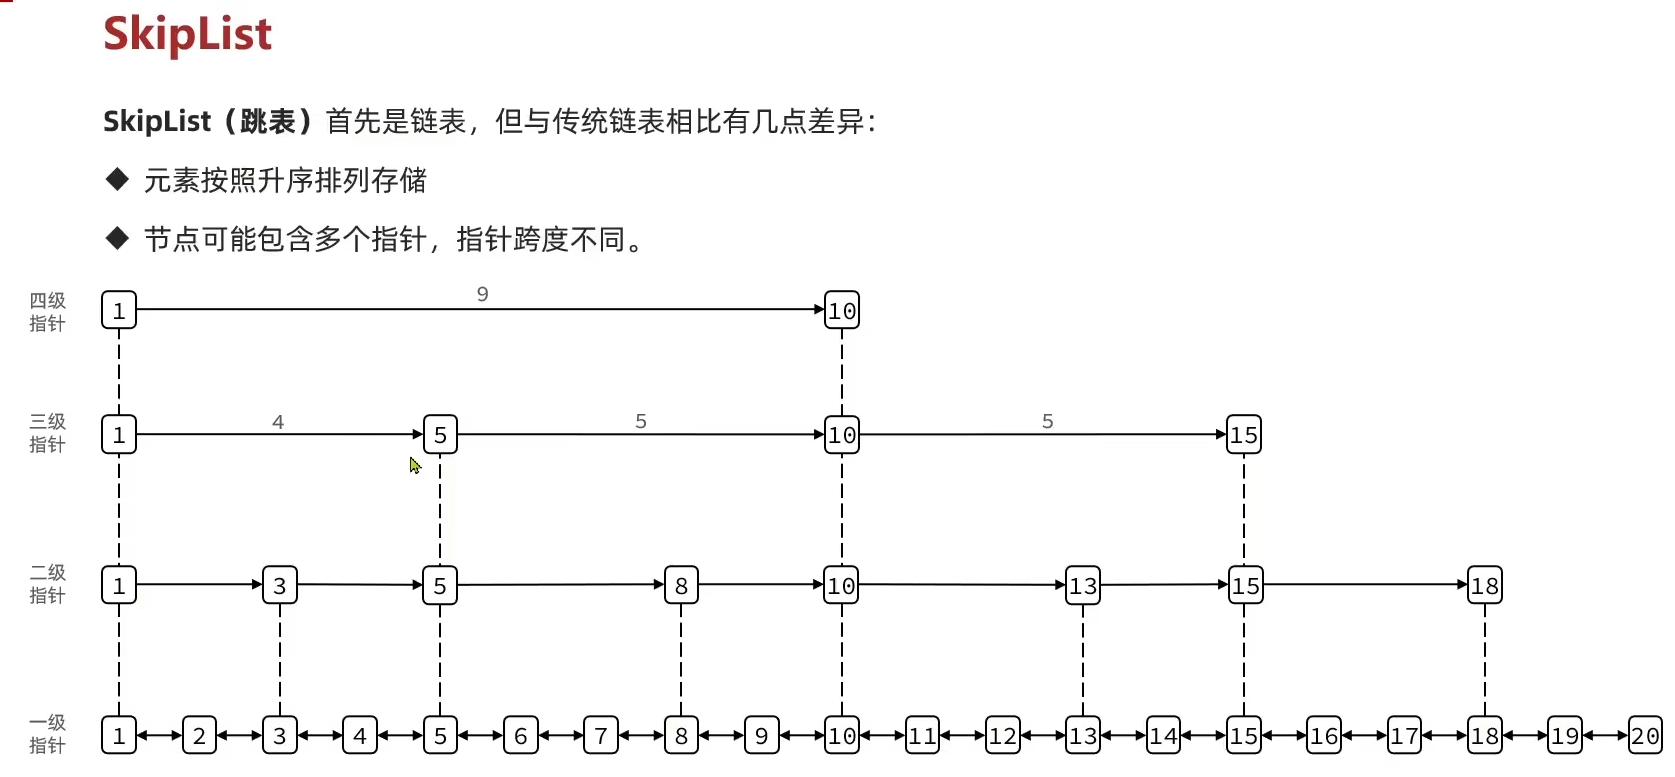
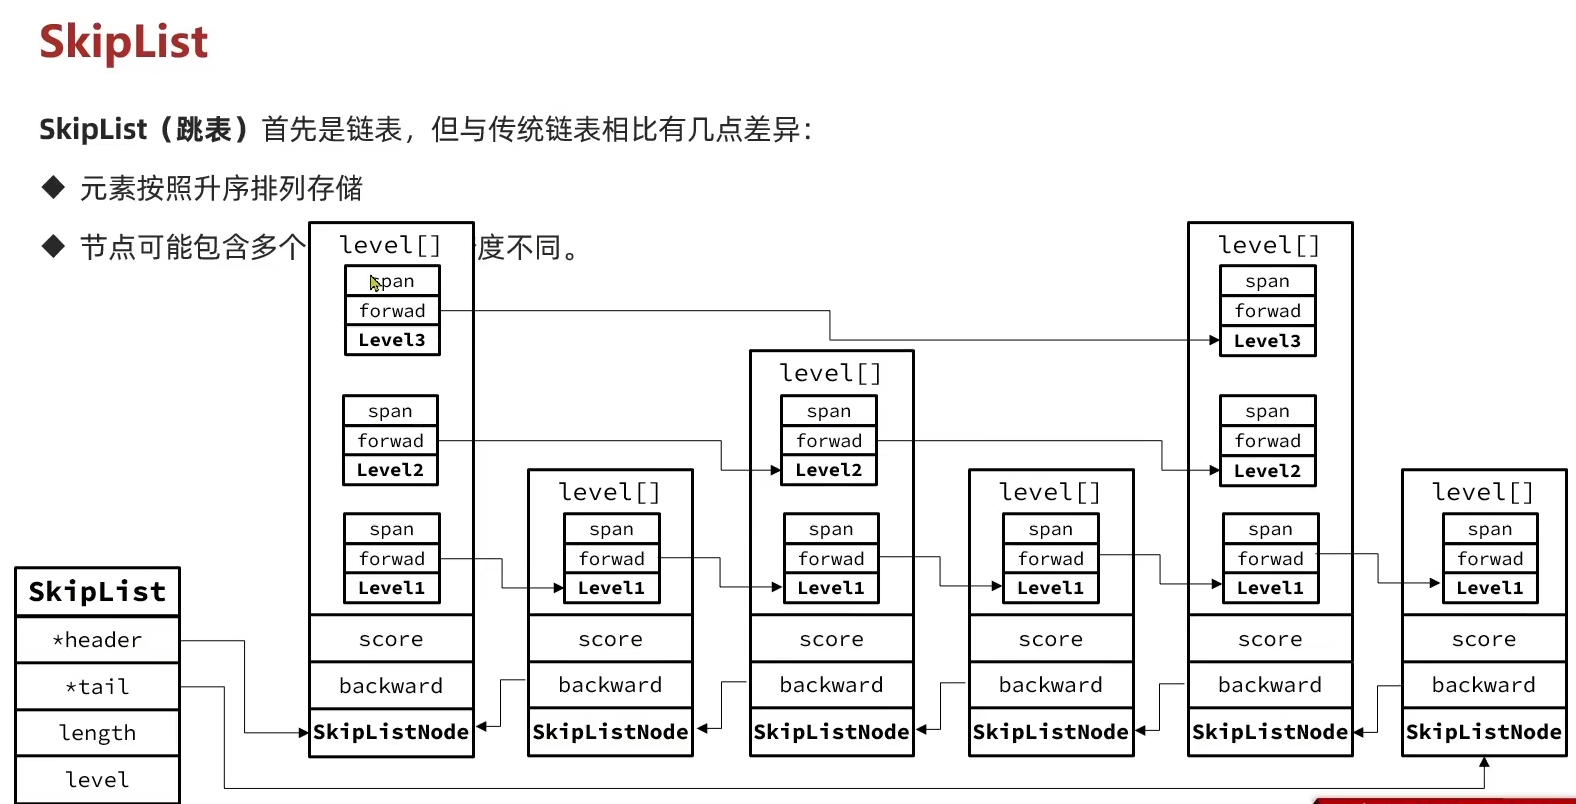
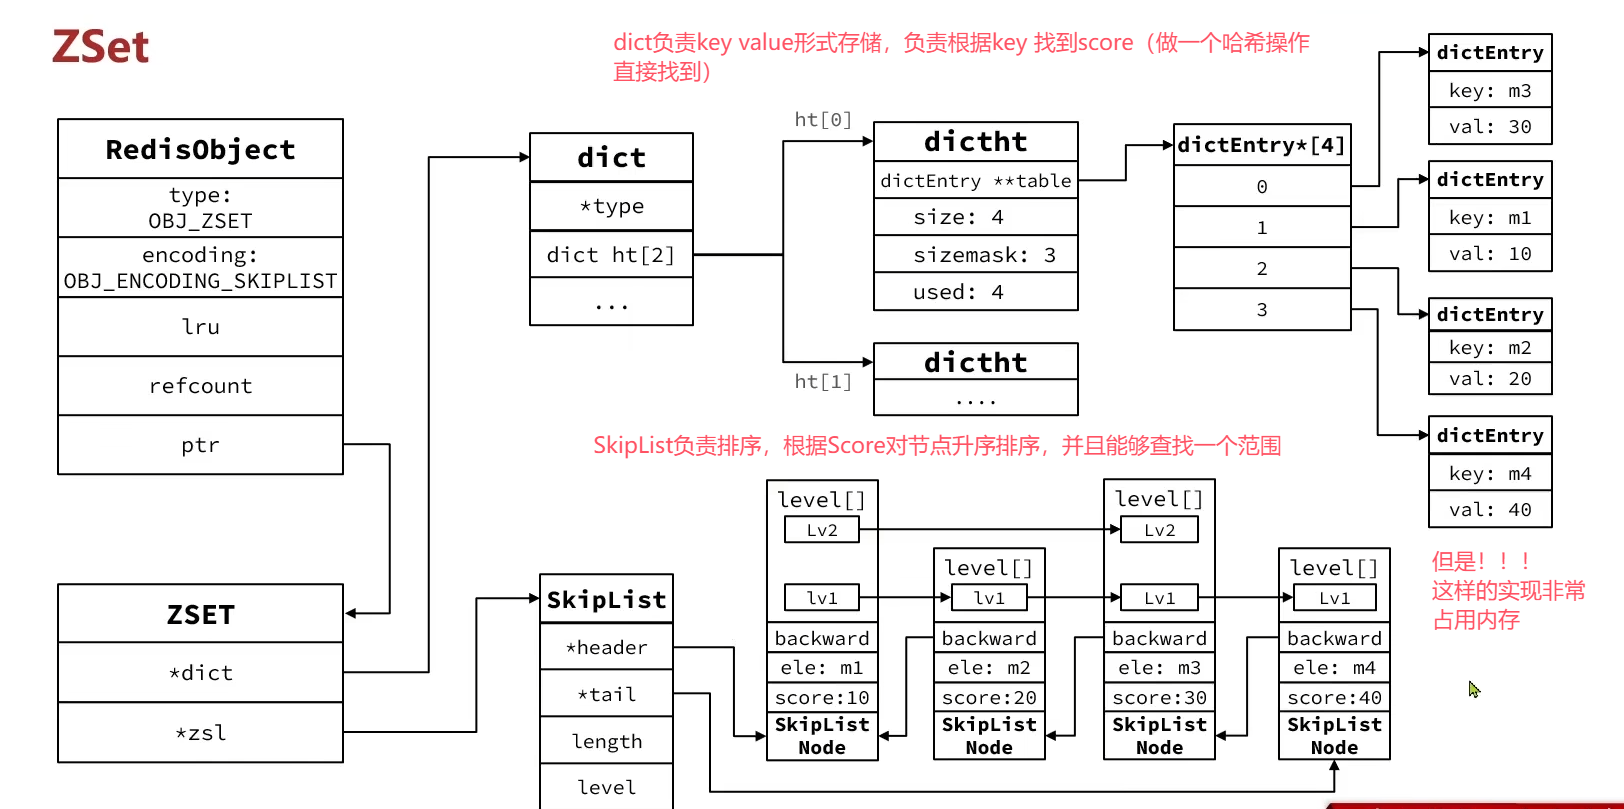
SkipList用于实现有序集合(ZSET),通过多层链表加速查询。结构包含头尾指针、长度和层高,节点按分值排序。设计亮点:
- 平均O(logN)查询:利用随机层高(1~32)建立索引路径。
- 范围操作高效:支持
ZRANGE等命令直接遍历底层链表。
跳表会利用Score值升序存储,并且支持跳跃查询,查询效率很高。
------------------------------------------------------分隔符----------------------------------------------------
既然理解了上面6种数据结构,能否分析出redis的五种基本数据类型是怎么根据这些数据结构生成的?
上面学过了Redis底层的数据结构,最后,实际上所有的数据最后都会被封装为RedisObject,那么我们redis常用的几种数据类型底层都是由上面的集中数据结构实现的
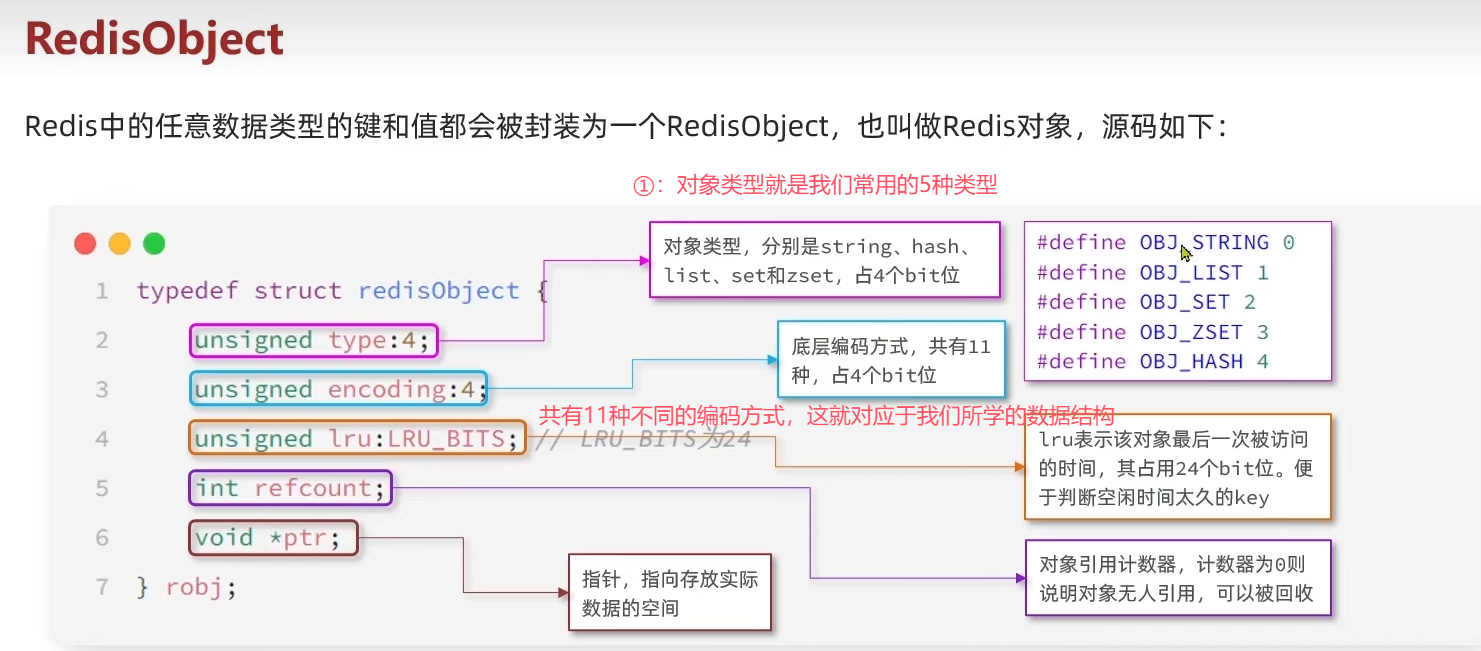
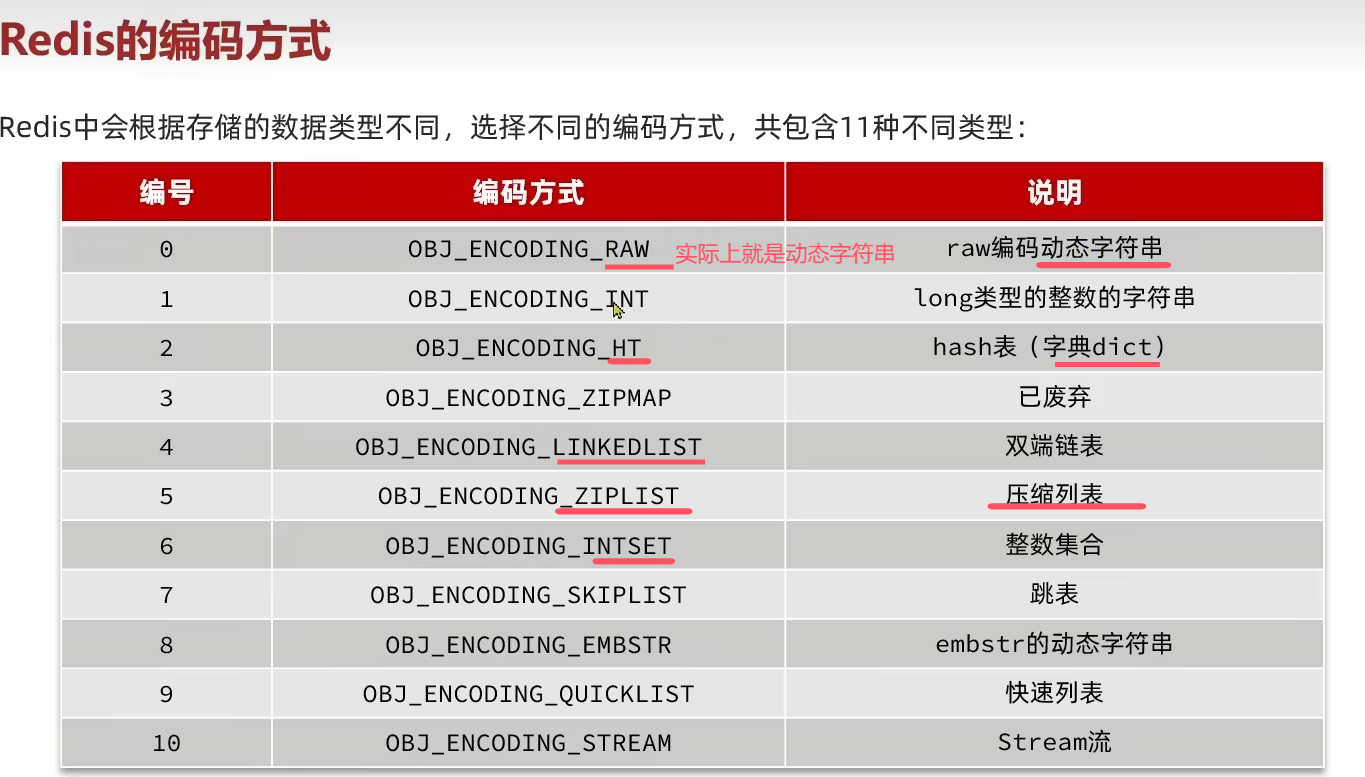
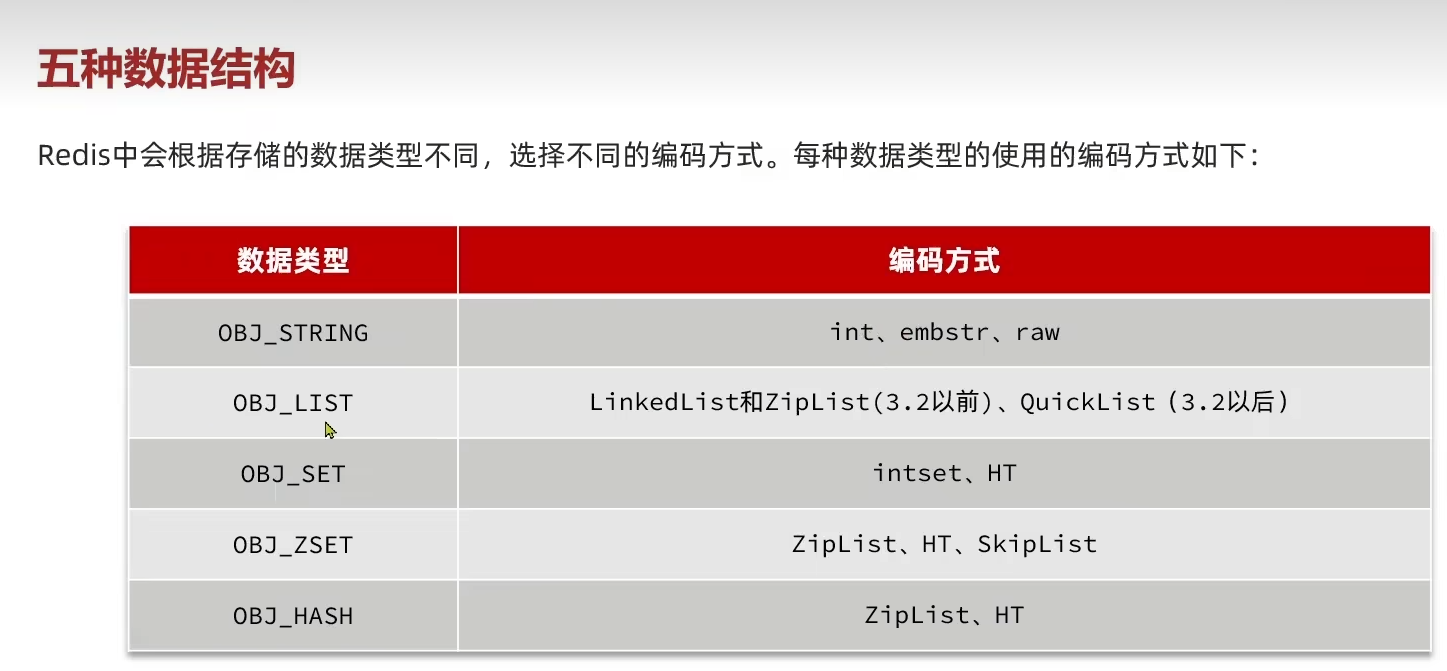
Redis数据类型与底层数据结构对应关系
Redis的5种常用数据类型(String、Hash、Set、List、ZSet)分别使用了不同的底层数据结构实现,具体如下:
String(字符串类型)
- 简单动态字符串(SDS, Simple Dynamic String):Redis默认的字符串表示方式,包含长度信息和预分配空间,支持高效修改和二进制安全。
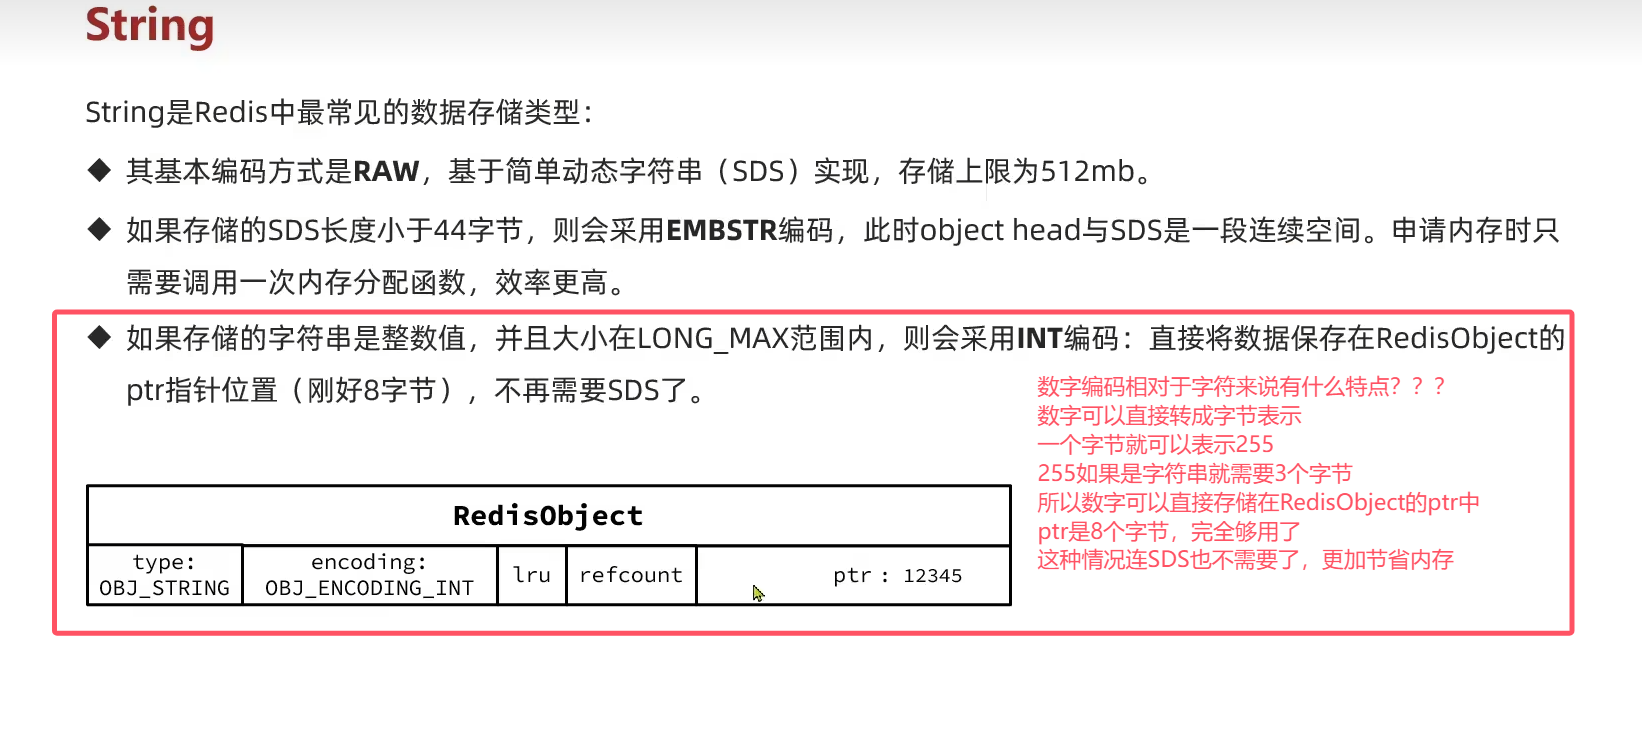
- 整数编码(int):当字符串内容可表示为长整型时,Redis会直接使用整数存储以节省空间。
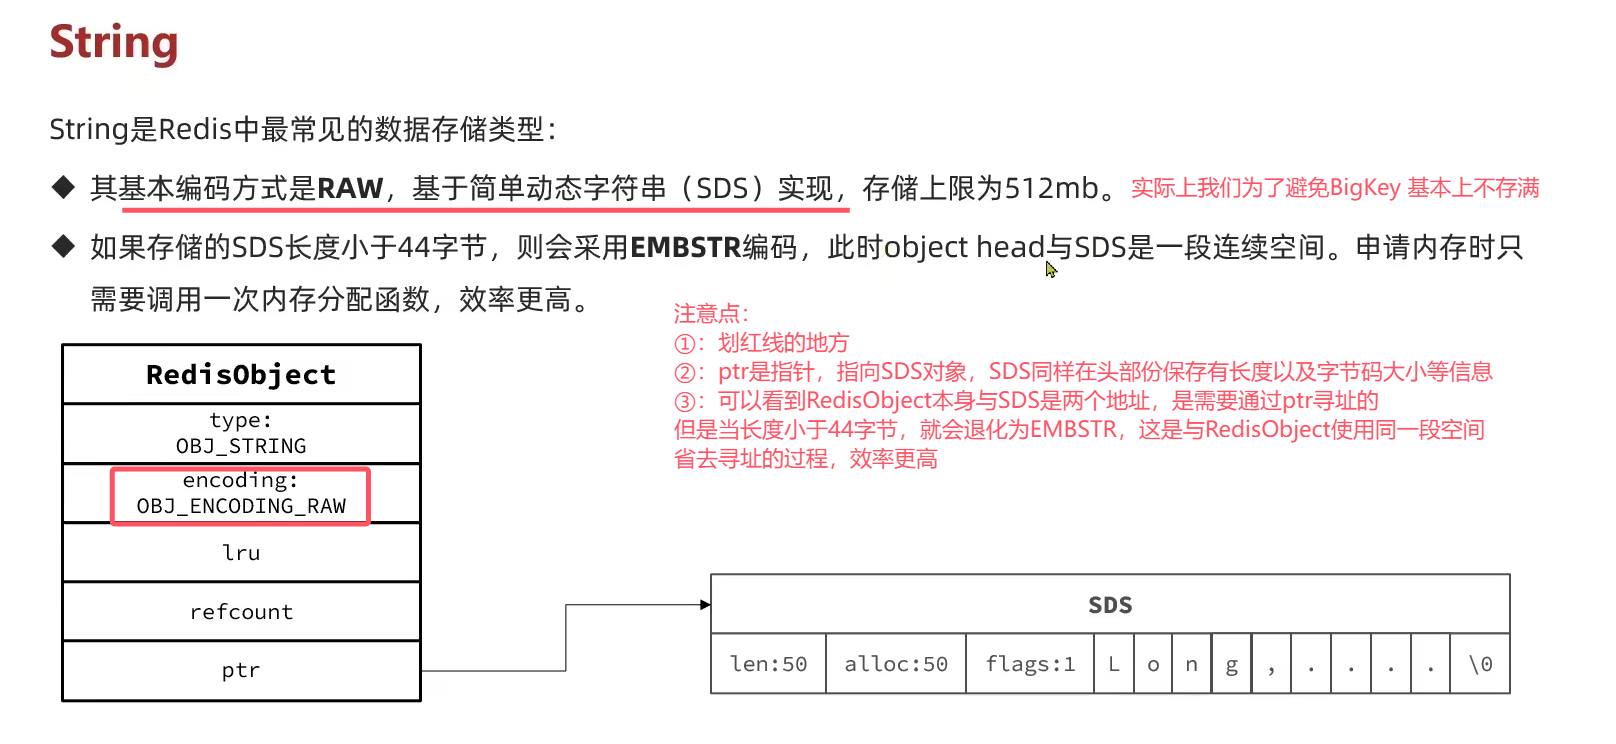
如果存储的是数字,直接把数字用二进制位的形式存储在ptr中
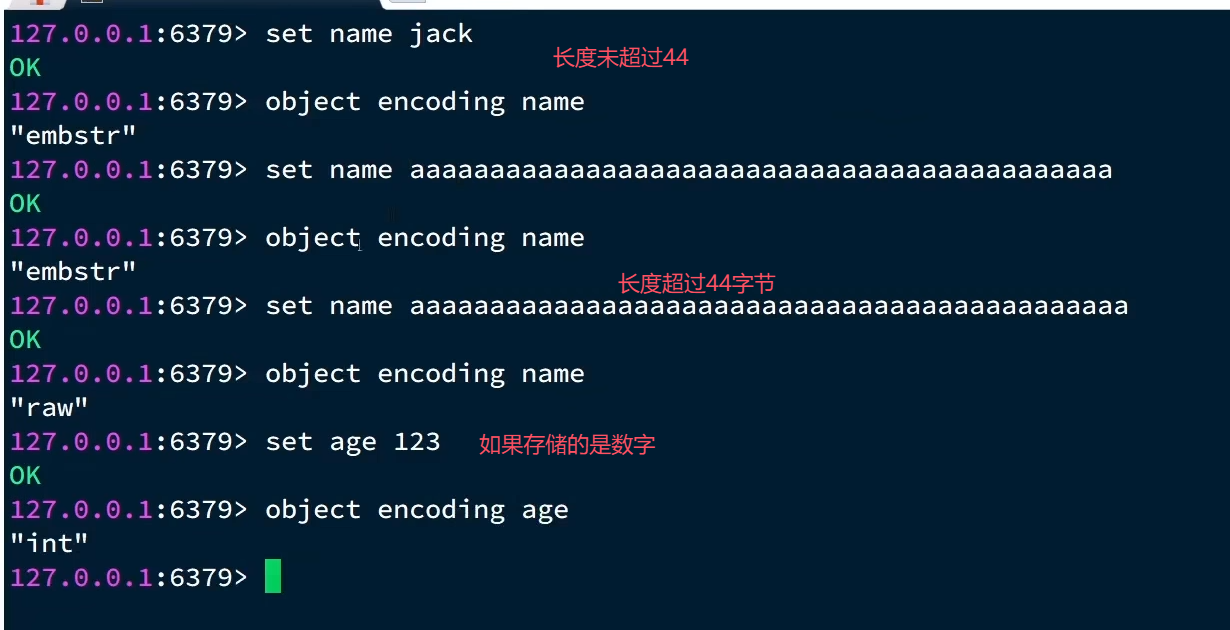
实践验证:(Redis(SDS)中存储字符串一般是一个字符一个字节,如果要存储aaaaa 一般是6个字节,因为要加一个\0)
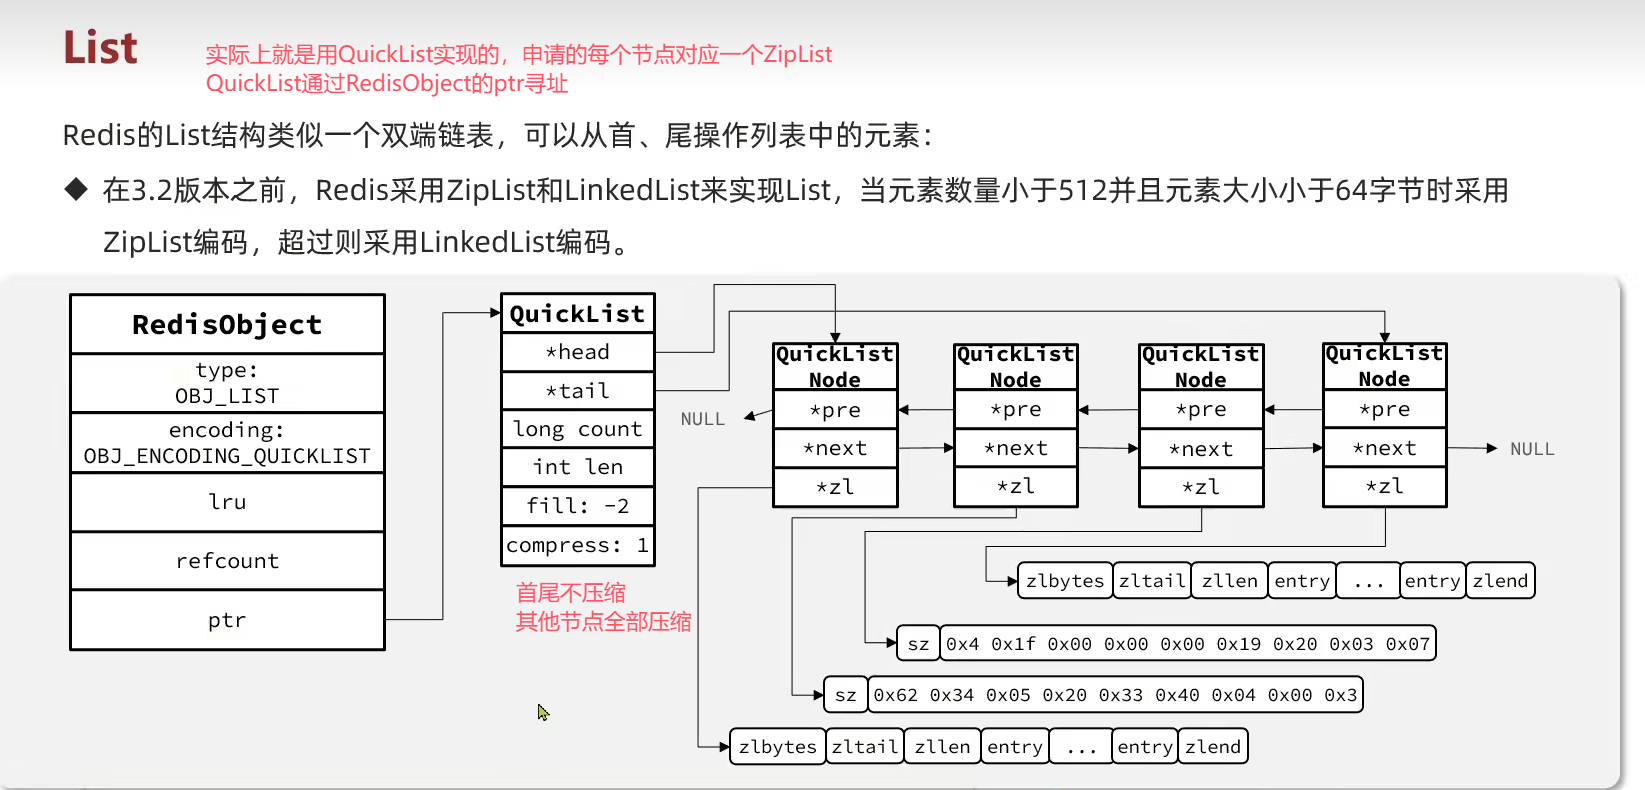
List(列表类型)
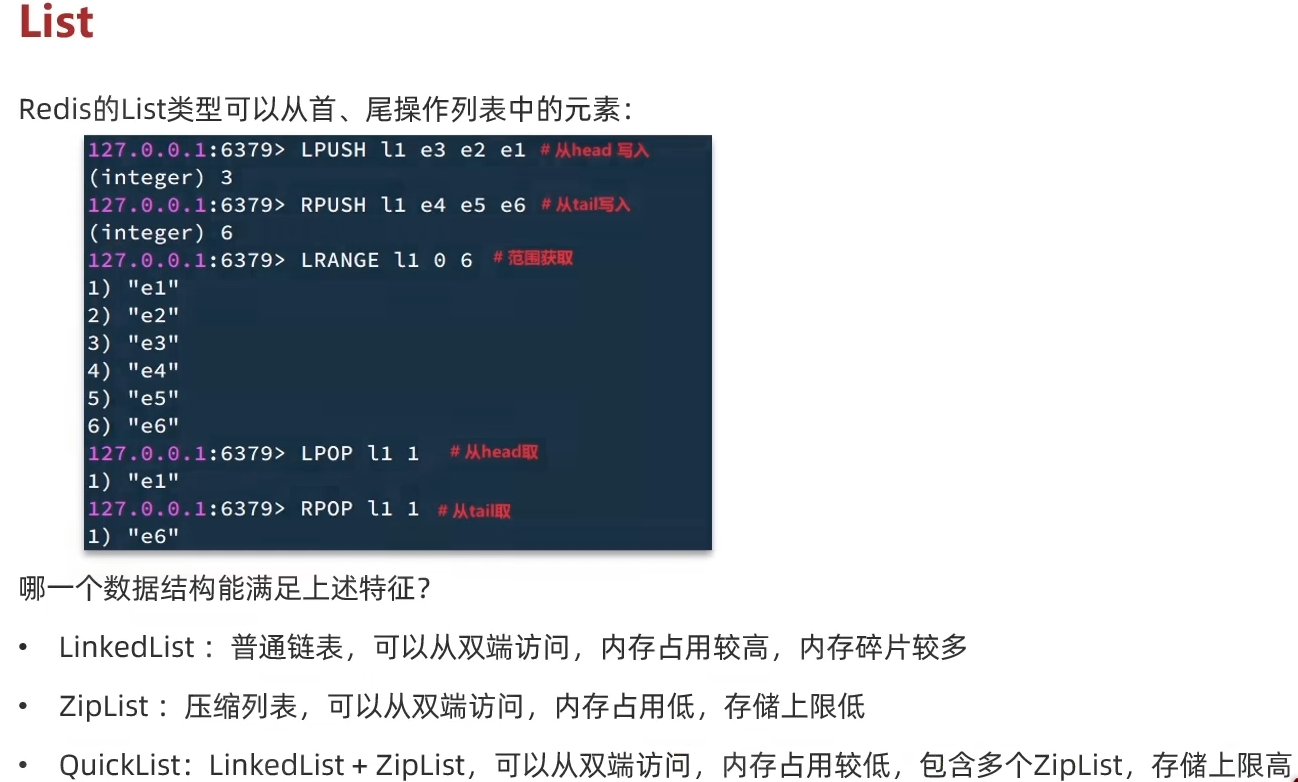
- 压缩列表(ziplist):适用于元素较少且较小的场景,通过连续内存块存储数据。
- 快速链表(quicklist):Redis 3.2后的默认实现,由多个ziplist组成的双向链表,平衡内存效率和操作性能。
Set(集合类型)
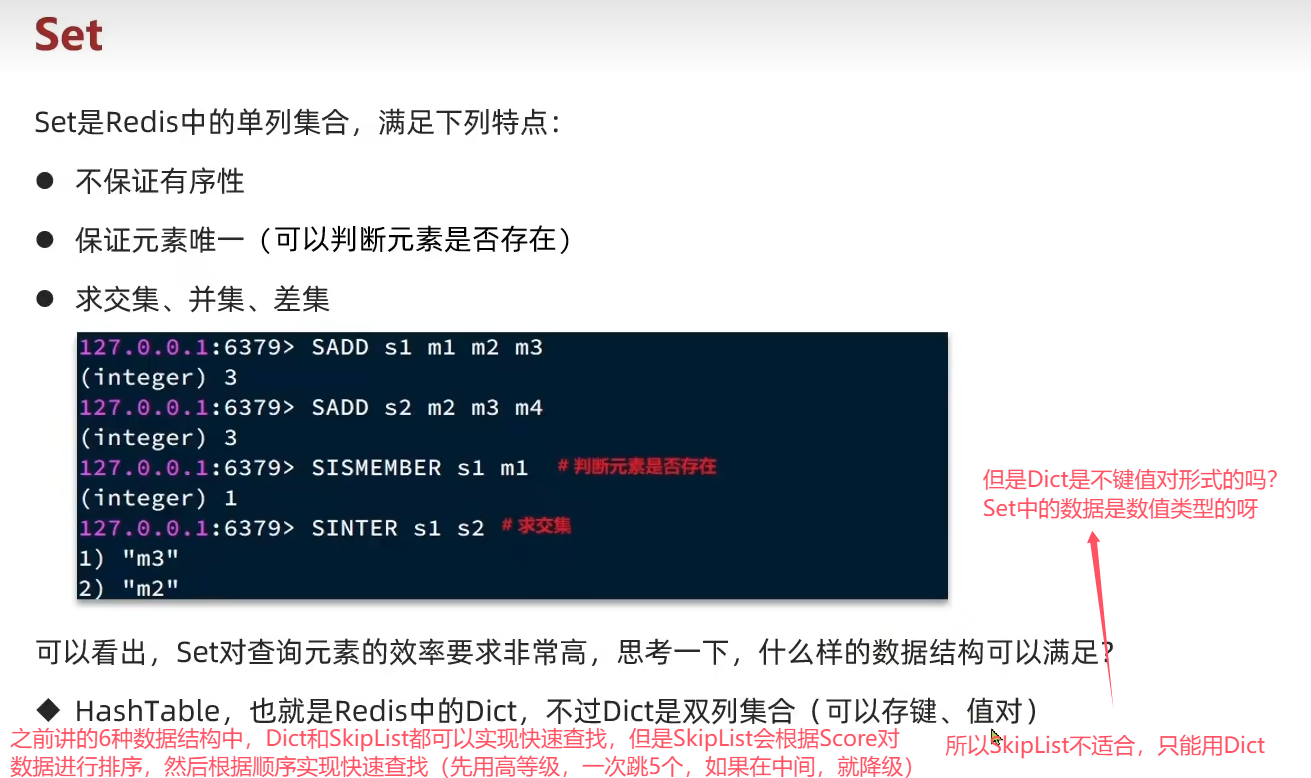
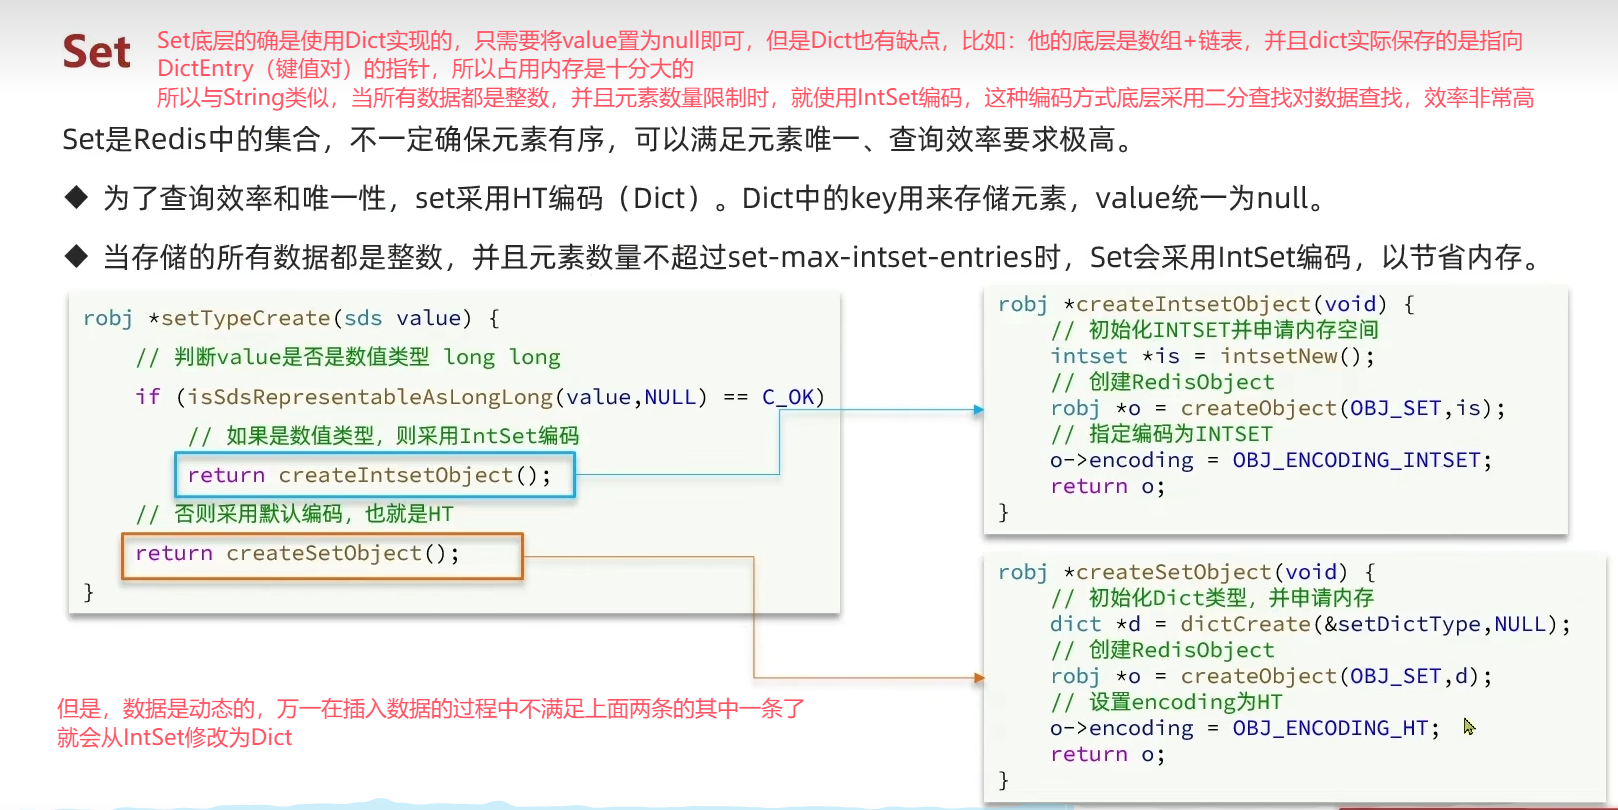
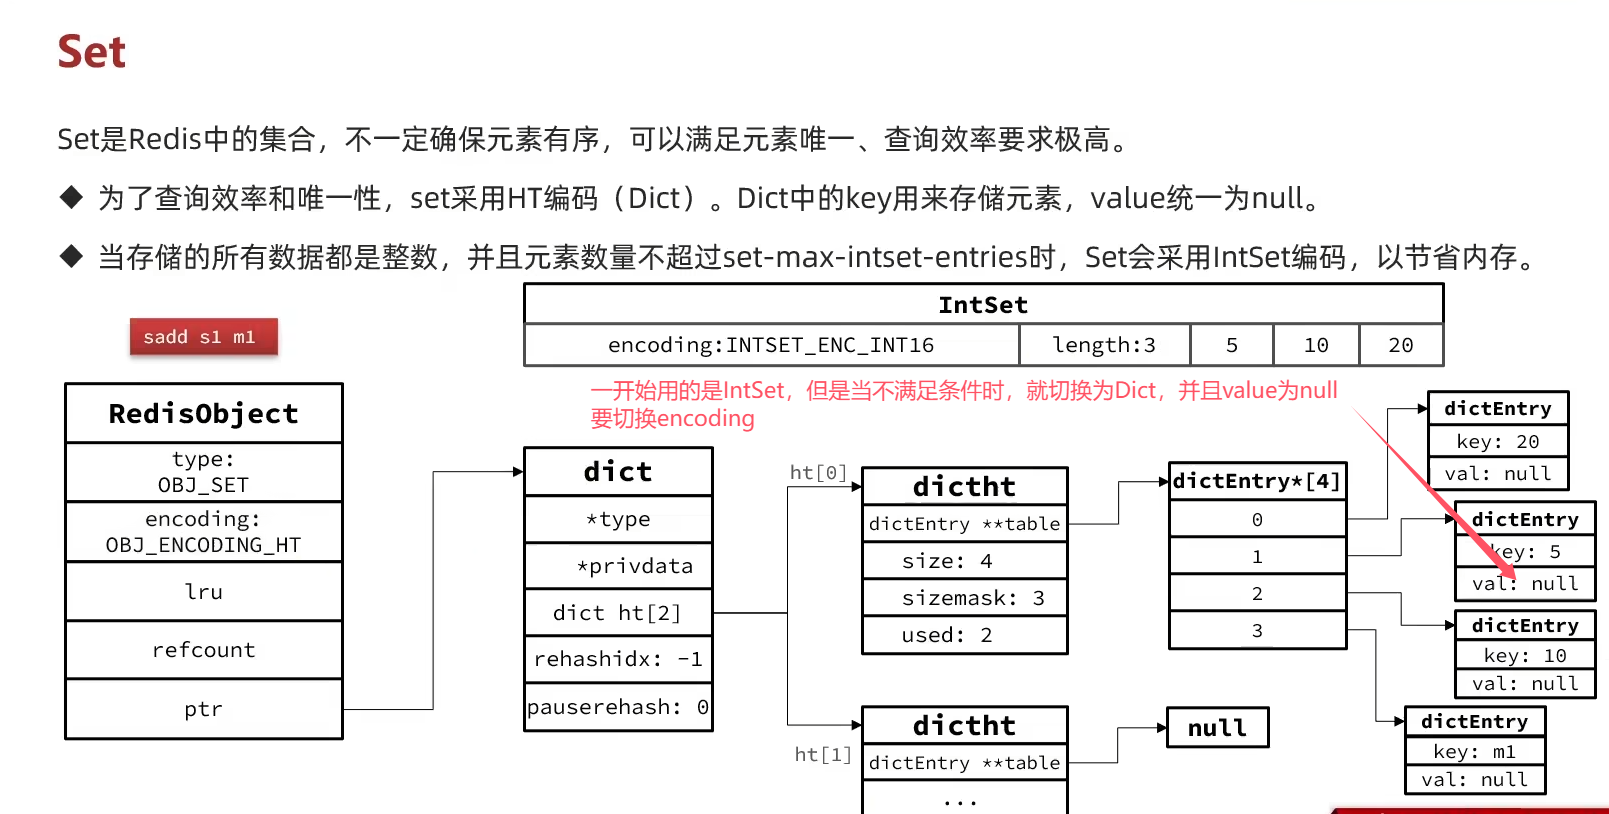
- 整数集合(intset):当集合内所有元素均为整数且数量较少时,采用紧凑的整数数组存储。
- 哈希表(hashtable):元素包含非整数或数量较大时,退化为标准哈希表实现,仅存储键(无值部分)。
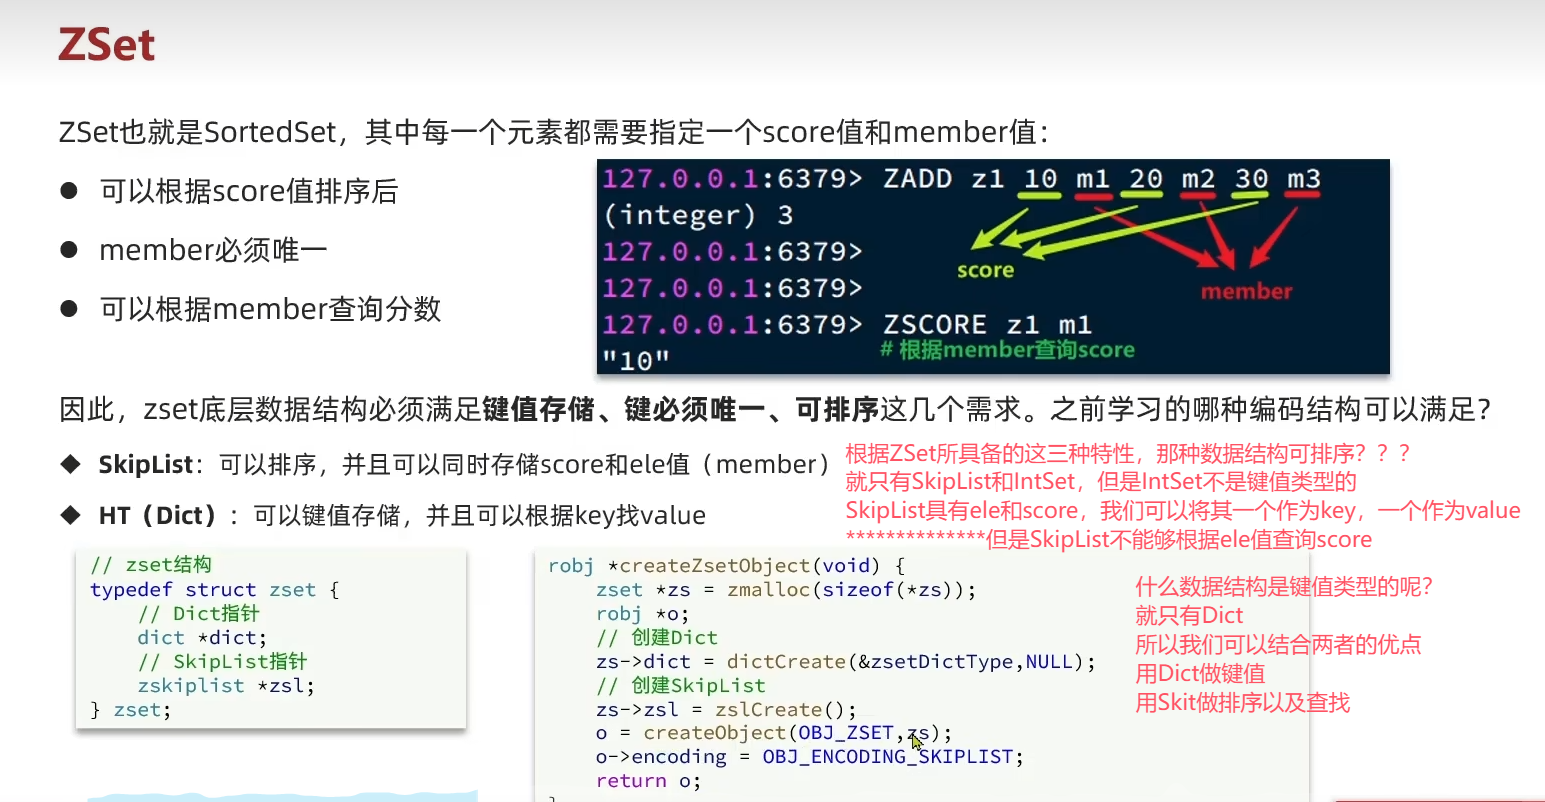
ZSet(有序集合类型)
- 压缩列表(ziplist):元素较少且较小时,按分值-成员顺序紧凑存储。
- 跳表+哈希表(skiplist + hashtable):标准实现中,跳表支持范围查询,哈希表保障单点查询效率,两者通过指针共享数据。
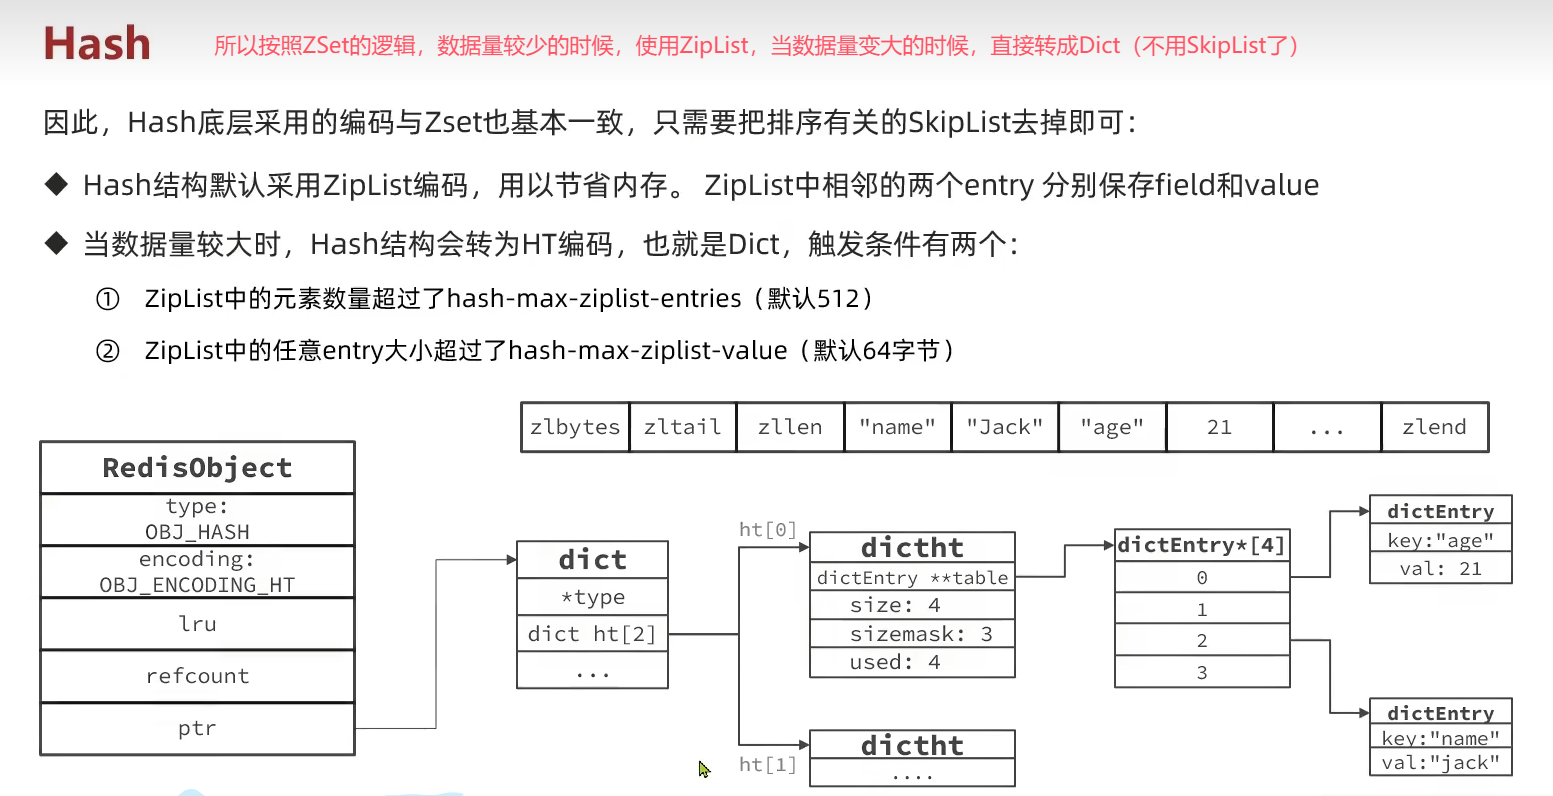
Hash(哈希类型)
- 压缩列表(ziplist):在元素较少且较小时使用,通过紧凑存储减少内存占用。
- 哈希表(hashtable):当元素数量或大小超过阈值时,转为标准的哈希表结构,支持高效键值对操作。
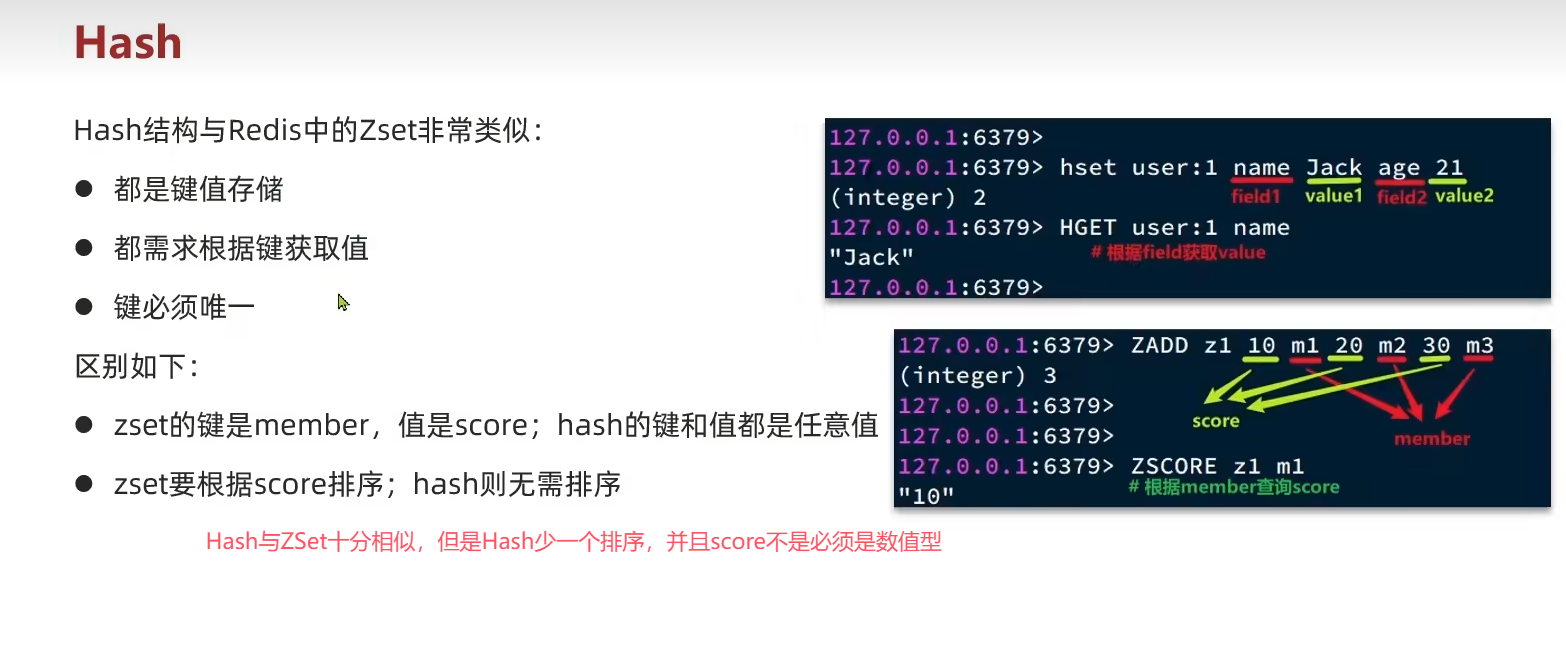
既然不用排序,那就可以不像ZSet一样用SkipList了,数据量较少的时候,使用ZipList,数据量较大的时候,转成Dict
更多推荐


 41
 0
- 0


 已为社区贡献1条内容

所有评论(0)