
数据结构笔记——图
数据结构笔记——图
图的理论知识点
表结构:1:1 树结构:1:n 图结构:n:m
图G是由两个集合V和E组成,记为G = (V,E),其中V是顶点的有限非空集合,E是V中顶点偶对(边)的有限集,这些顶点偶对称之为边(弧)。
注:有方向的叫做弧,无方向的叫做边 弧要注意弧尾和弧头
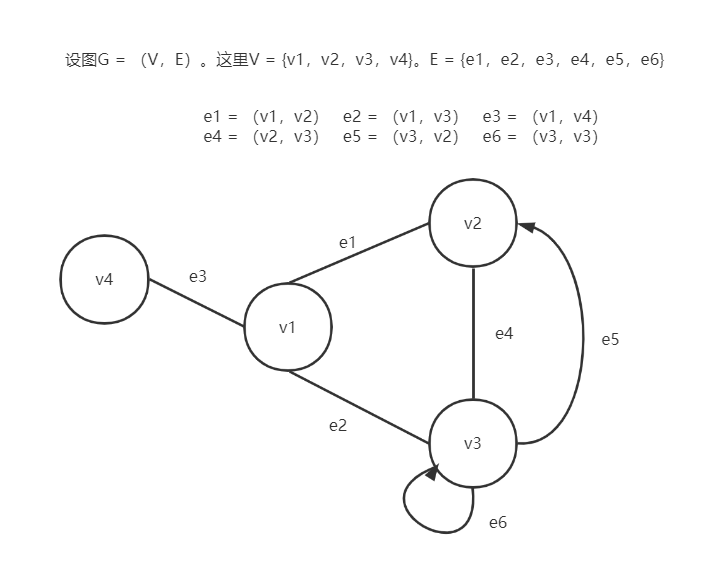
- 图:分为简单图(若不存在顶点到其⾃身的边,且同⼀条边步重复出现),有向图,无向图(存在方向的判断),
完全图:如果图中的每两个顶点之间,都存在⼀条边,我们就称这个图为完全图。
完全有向图:有n(n-1)条边 完全⽆向图:有n(n-1)/2条边
- 顶点的度、⼊度和出度
⽆向图中,顶点所具有的边的数⽬称为该顶点的度。
有向图中,顶点v的度就分为⼊度和出度(分别是指向该节点,指出该节点) 在⼀个 具有e条边的图中:度之和为2e
-
环路:
如果经过图中各边⼀次且恰好⼀次的环路,称为欧拉环路
经过图中的各顶点⼀次且恰好⼀次的环路,称作哈密尔顿环路 -
连通:直接或间接可以互相抵达的路径
在⽆向图G中,若从顶点i到顶点j有路径,则称这两个顶点时连通的。
如果图G中任意两个顶点都连通,则称G为连通图,否则称为非连通图。 -
连通分量:
⽆向图G中的极大连通子图称为G的连通分量。对于连通图只有⼀个极大连通⼦图,就是它本身(是唯⼀的)。
非连通图有多个极大连通子图(非连通图的极大连通子图叫做连通分量,每个分量都是⼀个连通图)强连通图和强连通分量
-
强连通图和强连通分量(单独针对无向图来说)
从顶点i到顶点j和从顶点j到顶点i都存在路径,则称图G是强连通图
图的存储结构
图在内存中存储⽅式有很多种,最经典的包括邻接矩阵、邻接表、逆邻接表和⼗字链表
邻接矩阵
图的邻接矩阵是⽤两个数组来表示,⼀个⼀位数组存储图中的顶点信息
⼀个⼆维数组(我们将这个数组称之为邻接矩阵)存储图中的边的信息。
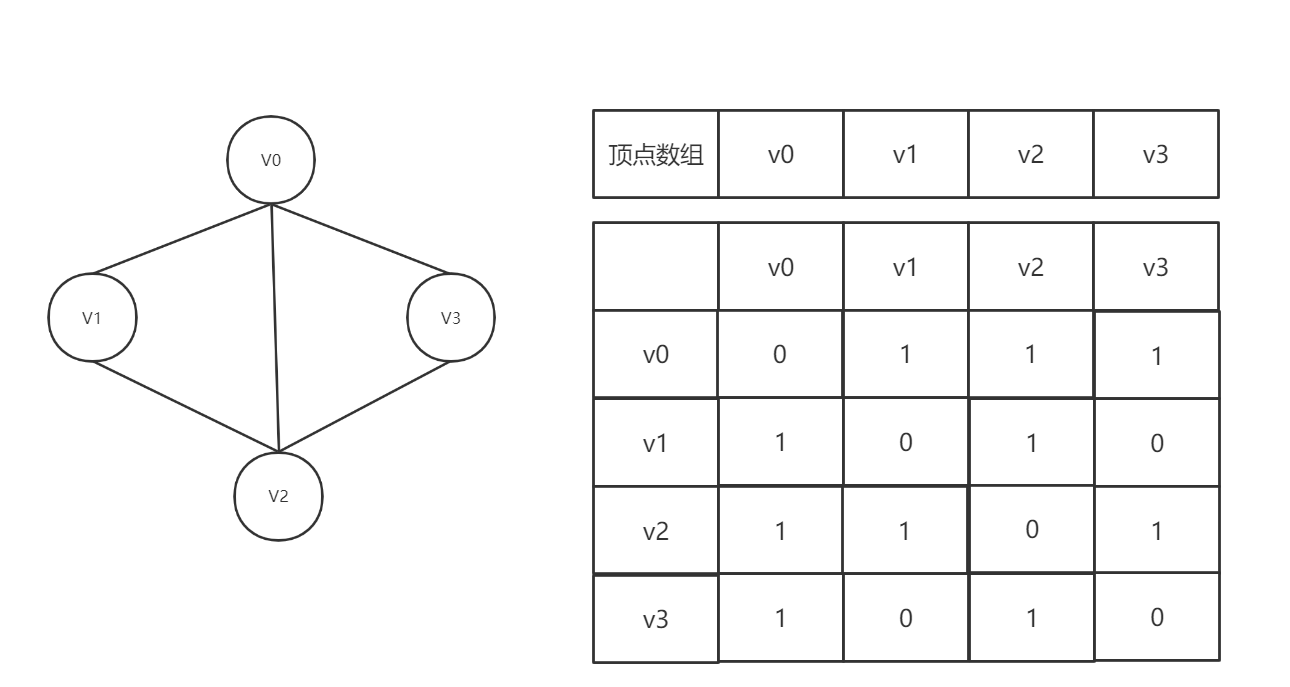
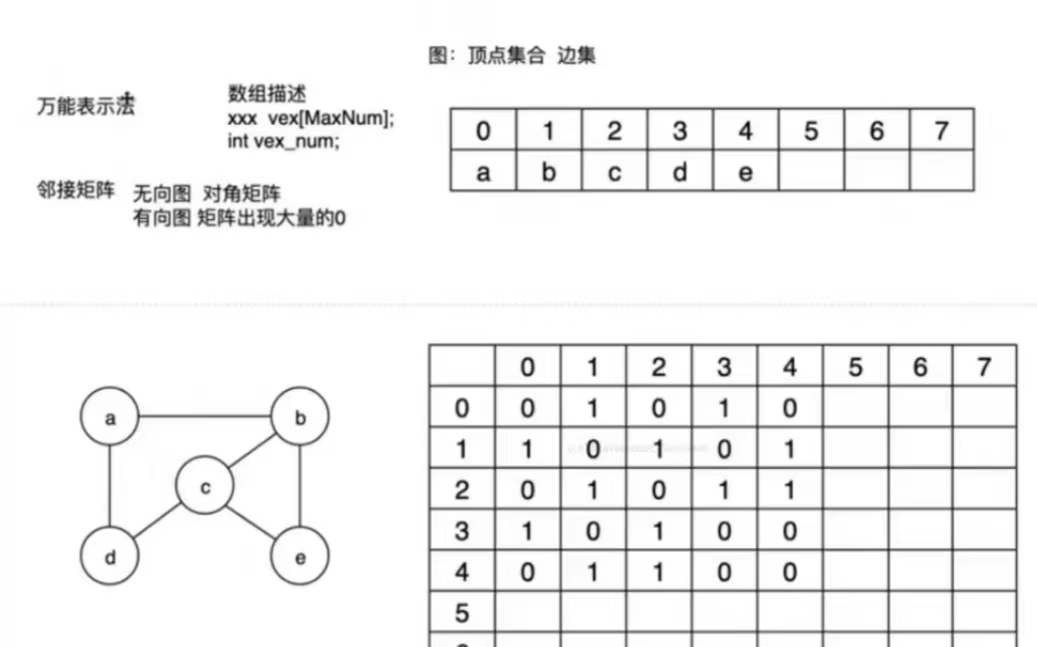
有了这个⼆维数组组成的对称矩阵,我们就可以很容易地知道图中的信息:
- 判定任意两顶点是否有边无边;
- 可以轻松知道某个顶点的度,其实就是这个顶点Vi在邻接矩阵中第i行(或第i列)的元素之和;
- 求顶点Vi的所有邻接点就是将矩阵中第i行元素扫描⼀遍,arc[i] [j]为1就是邻接点喽。
代码集合
#define MaxNodeNum	20         //限制节点的最大个数
#define INF			1E4        //定义一个无穷值

// 顶点结构
typedef struct {
	int no;					// 顶点的编号
	const char *show;		// 存储顶点表示的数据
} MatrixVertex;
// 定义边的结构
typedef int MatrixEdge;

// 邻接矩阵表示图结构
typedef struct {
	MatrixVertex	vex[MaxNodeNum];     //顶点集合
	MatrixEdge edges[MaxNodeNum][MaxNodeNum]; //边集数组
	int nodeNum;						// 约束访问顶点边界
	int edgeNum;						// 边的个数
	int directed;						// 是否有向图
} MGraph;

//初始化图
void initMGraph(MGraph *graph, const char *name[], int num, int directed, int edgeValue);
//添加图的边集合
void addMGraph(MGraph *graph, int x, int y, int w);
//DFS,BFS遍历对应集合
void DFSMGraphTravel(MGraph *g, int v);
void BFSMGraphTravel(MGraph *g, int v);
//重置visit数组
void initMGraphVisit(void);
初始化图
void initMGraph(MGraph *graph, const char *name[], int num, int directed, int edgeValue) {
	graph->directed = directed;
	graph->edgeNum = 0;
	graph->nodeNum = num;
	memset(graph->vex, 0, sizeof(graph->vex));   //初始化节点数组都为0
	memset(graph->edges, 0, sizeof(MatrixEdge) * MaxNodeNum * MaxNodeNum);
	//可以使用sizeof(graph->graph->edges)

	for (int i = 0; i < num; ++i) {
		graph->vex[i].no = i;
		graph->vex[i].show = name[i];
		for (int j = 0; j < num; ++j) {
			graph->edges[i][j] = edgeValue;
            //edgeValue是方便后期修改时统一重置初始值(INF/0....)
		}
	}
}
添加图的边集合(注意边是否超出范围)
void addMGraph(MGraph *graph, int x, int y, int w) {
	if (x < 0 || x >= graph->nodeNum) {//记得将=号加上
		return;
	}
	if (y <0 || y >= graph->nodeNum) {
		return;
	}
	if (!isEdge(graph->edges[x][y])) {
		graph->edges[x][y] = w;
		if (graph->directed == 0) { //判断是否是无向图
			graph->edges[y][x] = w;
		}
		graph->edgeNum++;
	}//共用一个边,不管无向图还是有向图,都只添加一次
}
//特判:边的权值是否正确
static int isEdge(int weight) {
	if (weight > 0 && weight < INF) {
		return 1;
	}
	return 0;
}
DFS,BFS遍历对应集合
void visitMGraphNode(MatrixVertex *node) {
	printf("\t%s", node->show);
}

/*1.首先标记v节点已被遍历
* 2.处理该节点
* 3.再遍历v节点与附近所连的节点的边结构
* 4.判断权值,是否遍历.....其他条件是否符合,递归到相邻节点
*/
// V: 第几个位置
static int MGraphVisited[MaxNodeNum];
void DFSMGraphTravel(MGraph *g, int v) {
	visitMGraphNode(&g->vex[v]);
	MGraphVisited[v] = 1;
	// 从v节点开始,找到一个边节点,再通过这个阶段进行DFS
	for (int i = 0; i < g->nodeNum; ++i) {
		if (isEdge(g->edges[v][i]) && MGraphVisited[i] == 0) {		// 第i个节点有边,并没有被访问
			DFSMGraphTravel(g, i);
		}
	}
}
void initMGraphVisit() {
	memset(MGraphVisited, 0, sizeof(MGraphVisited));
}
//一定要及时的把遍历过的节点标记已访问
/*
* 核心思想:利用队列来整合数据,首先front遍历第一个元素
* 再整体遍历边找到可达的节点,将节点rear入队,不断遍历,达到层级遍历
*/
void BFSMGraphTravel(MGraph *g, int v) {
	int que[MaxNodeNum];   //队列有2个条件,front和rear及时调整
	int rear = 0, front = 0;
	int cur;

	rear = (rear + 1) % MaxNodeNum;//rear负责及时的调整添加后面的元素
	que[rear] = v;
	MGraphVisited[v] = 1;
	while (front != rear) {
		front = (front + 1) % MaxNodeNum;//front及时遍历并处理对应的元素
		cur = que[front];

		visitMGraphNode(&g->vex[cur]);
		for (int i = 0; i < g->nodeNum; ++i) {
			if (isEdge(g->edges[cur][i]) && !MGraphVisited[i]) {
				rear = (rear + 1) % MaxNodeNum;
				que[rear] = i;
				MGraphVisited[i] = 1;
			}
		}
	}
}
测试案例
#include <stdio.h>
#include "matrixGraph.h"

void setupMatTrix(MGraph *g1) {
	const char *nodeNames[] = {"V1", "V2", "V3", "V4",
								"V5", "V6", "V7", "V8"};

	initMGraph(g1, nodeNames, sizeof(nodeNames) / sizeof(nodeNames[0]), 0, 0);

	addMGraph(g1, 0, 1, 1);
	addMGraph(g1, 0, 2, 1);
	addMGraph(g1, 1, 3, 1);
	addMGraph(g1, 1, 4, 1);

	addMGraph(g1, 2, 5, 1);
	addMGraph(g1, 2, 6, 1);
	addMGraph(g1, 3, 7, 1);
	addMGraph(g1, 4, 7, 1);
	addMGraph(g1, 5, 6, 1);
}

int main() {
	MGraph g1;
	setupMatTrix(&g1);
	DFSMGraphTravel(&g1, 0);
	printf("\n[edges]: %d\n", g1.edgeNum);

	initMGraphVisit();
	printf("wide: \n");
	BFSMGraphTravel(&g1, 0);
}
邻接表
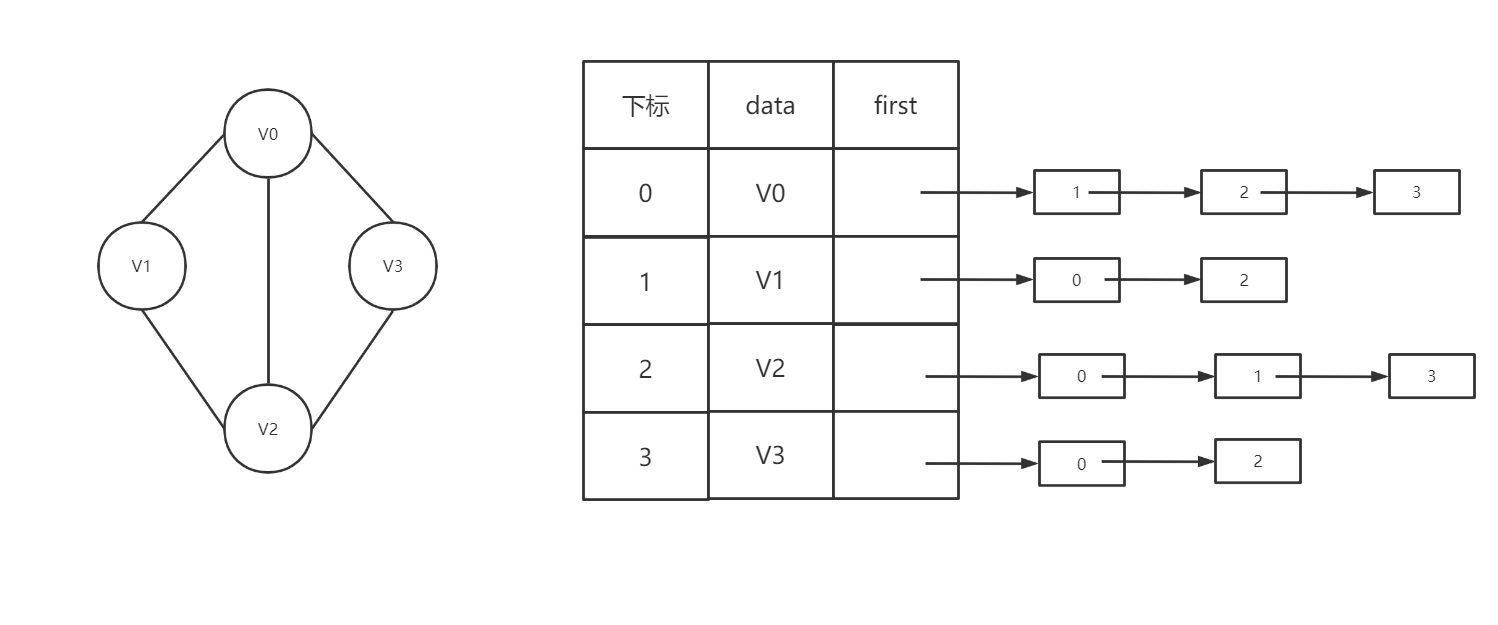
图中顶点⽤⼀个⼀维数组存储,当然,顶点也可以⽤单链表来存储
(不过数组可以较容易地读取顶点信息,更加⽅便。
图中每个顶点Vi的所有邻接点构成⼀个线性表,由于邻接点的个数不确定,所以我们选择⽤单链表来存储。
代码集合
// 边的结构
typedef struct arcEdge {
	int no;                //边的编号,便于定位边的位置
	int weight;		       //权重
	struct arcEdge *next;  //使用单链表的形式来处理
} ArcEdge;
// 顶点的结构
typedef struct {
	int no;
	const char *show;		// 顶点的显示
	ArcEdge *firstEdge;		// 出度
} ArcNode;
// 使用邻接表
typedef struct {
	ArcNode *nodes;         //顶点结构+出度->边的结构
	int *visited;			//记录是否比遍历过
	int nodeNum;			//顶点个数
	int edgeNum;			//边的个数
	int directed;			//是否有向图,无向图
} AGraph;

// 动态产生n个节点
AGraph *createAGraph(int n);
// 初始化邻接表的结构
void initAGraph(AGraph *graph, const char *name[], int num, int directed);
// 添加边的信息
void addAGraph(AGraph *graph, int x, int y, int w);

void DFSAGraphTravel(AGraph *graph, int v);

void BFSAGraphTravel(AGraph *graph, int v);
//重置visit数组
void resetAGraphVistied(AGraph *graph);
动态产生n个节点/初始化数据
初始化先初始常规变量,数组内容,指针(数组)->记得memset为0
AGraph *createAGraph(int n) {
	AGraph *graph = malloc(sizeof(AGraph));
	if (graph == NULL) {
		return NULL;
	}
	graph->edgeNum = 0;
	graph->nodeNum = n;
	graph->nodes = malloc(sizeof(ArcNode) * n);//一旦出现指针数组,一定要初始化memset
	graph->visited = malloc(sizeof(int) * n);

	//memset(graph->visited, 0, sizeof(graph->visited));
	memset(graph->nodes, 0, sizeof(ArcNode) * n);
	memset(graph->visited, 0, sizeof(int) * n);
	return graph;
}

void initAGraph(AGraph *graph, const char *name[], int num, int directed) {
	graph->directed = directed;
	for (int i = 0; i < num; ++i) {
		graph->nodes[i].no = i;
		graph->nodes[i].show = name[i];
		graph->nodes[i].firstEdge = NULL;
	}
}
注意事项
int *visited;   //出现此类情况,统一使用第二种memset
memset(graph->visited, 0, sizeof(graph->visited));//此类错误(除了是数组),会直接指int的大小
memset(graph->visited, 0, sizeof(int) * n);//正确,初始化正确
| 特性 | sizeof(int) * n | sizeof(graph->visited) |
|---|---|---|
| 计算对象 | int 类型大小 × 元素数量 n | 指针变量本身的大小 |
| 典型值 | 4 * n(假设 int 占 4 字节) | 8(64 位系统)或 4(32 位系统) |
| 正确性 | ✅ 正确(计算数组总字节数) | ❌ 错误(仅计算指针大小) |
| 内存覆盖范围 | 整个数组(n 个 int) | 仅数组前 4/8 字节(1-2 个元素) |
| 风险 | 需确保 n ≤ 实际分配大小 | 严重越界:只覆盖部分内存,数据未清零 |
添加边的信息
-
判断边界条件
-
记得使用头插法来处理该问题
-
判断是否为无向图,单独重复一次
static ArcEdge *createArcEdge(int no, int w) {
	ArcEdge *edge = malloc(sizeof(ArcEdge));
	if (edge == NULL) {
		return NULL;
	}
	edge->no = no;
	edge->weight = w;
	edge->next = NULL;
	return edge;
}

void addAGraph(AGraph *graph, int x, int y, int w) {
	if (x < 0 || x > graph->nodeNum || y < 0 || y >graph->nodeNum) {
		return;
	}
	if (x == y) {
		return;
	}
	// 使用头插法进行边信息的维护
	ArcEdge* edge = createArcEdge(y, w);
	edge->next = graph->nodes[x].firstEdge;
	graph->nodes[x].firstEdge = edge;
	graph->edgeNum++;
	if (graph->directed == 0) {		// 无向图
		edge = createArcEdge(x, w);
		edge->next = graph->nodes[y].firstEdge;
		graph->nodes[y].firstEdge = edge;
		graph->edgeNum++;
	}
}
DFS,BFS遍历对应集合
DFS核心思想:
- 不断从v节点的**firstEdge(出度)**遍历(判断是否为空,是否遍历过)直到为NULL,
- 接下来再遍历v->firstEdge**->next节点**(后半部分c++不支持,利用辅助指针来代替处理*p)
- 重复上述步骤,直到为null
void visitAGraphNode(ArcNode *node) {
	printf("\t%s", node->show);
}

void DFSAGraphTravel(AGraph *graph, int v) {
	ArcEdge *p;
	graph->visited[v] = 1;//处理
	visitAGraphNode(&graph->nodes[v])//标记

	p = graph->nodes[v].firstEdge;
	while (p) {
		if (graph->visited[p->no] == 0) {   //巧妙的点p->no,灵活使用指针
			DFSAGraphTravel(graph, p->no);
		}
		p = p->next;//当执行到这步时,(表示将v的一条道全部走完,需要换一条边)
	}
}
BFS核心思想:
邻接矩阵BFS需要遍历的是v节点与周围的各个节点的边
邻接表BFS需要遍历的是v节点的出度(所有)
- 使用队列思想来不断入队,出队
- 利用辅助指针*p去遍历v的出度,直到为空
- 及时的遍历,处理条件
void BFSAGraphTravel(AGraph *graph, int v) {
	int *que = malloc(sizeof(int) * graph->nodeNum);//没有对应的限制条件,可以用指针数组
	int front = 0, rear = 0;
	int cur;

	ArcEdge *p;

	rear = (rear + 1) % graph->nodeNum;
	que[rear] = v;
	graph->visited[v] = 1;

	while (front != rear) {
		front = (front + 1) % graph->nodeNum;
		cur = que[front];
		visitAGraphNode(&graph->nodes[cur]);

		p = graph->nodes[cur].firstEdge;
		while (p) {
			if (graph->visited[p->no] == 0) {
				rear = (rear + 1) % graph->nodeNum;
				que[rear] = p->no;
				graph->visited[p->no] = 1;
			}
			p = p->next;//把整个firstEdge不为null的全部遍历完
		}
	}
	free(que);
}

//重置visit数组
void resetAGraphVistied(AGraph *graph) {
	if (graph && graph->visited) {
		memset(graph->visited, 0, sizeof(int) * graph->nodeNum);
	}
}
测试样例
#include <stdio.h>
#include "adjacencyList.h"

void setupGraph(AGraph *graph) {
	const char *nodeNames[] = {"A", "B", "C", "D", "E"};
	initAGraph(graph, nodeNames, sizeof(nodeNames) / sizeof(nodeNames[0]), 1);
	addAGraph(graph, 0, 3, 1);
	addAGraph(graph, 0, 2, 1);
	addAGraph(graph, 0, 1, 1);
	addAGraph(graph, 2, 3, 1);
	addAGraph(graph, 3, 4, 1);
}

int main() {
	int n = 5;
	AGraph *graph = createAGraph(n);
	setupGraph(graph);

	DFSAGraphTravel(graph, 0);
	printf("\n");
	resetAGraphVistied(graph);
	BFSAGraphTravel(graph, 0);

	return 0;
}
十字链表
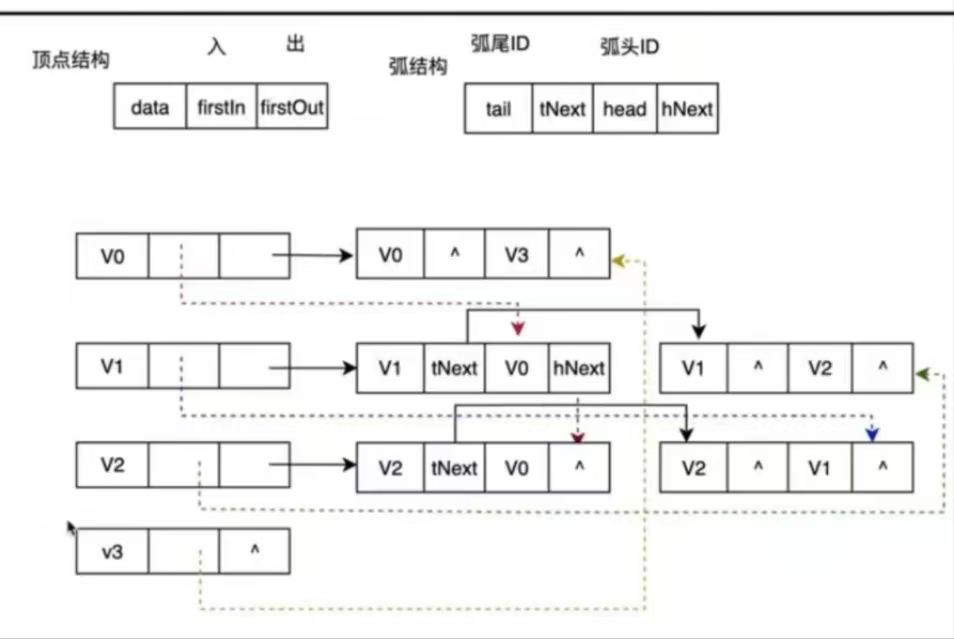
十字链表是一种高效存储有向图/网的数据结构,结合了邻接表与逆邻接表的优点。它通过顶点结点和弧结点的双层链接形式,实现了对顶点出度(出边)和入度(入边)的同步管理。
十字链表的操作优势
| 操作 | 时间复杂度 | 实现方式 |
|---|---|---|
| 查询出边 | O(出度) | 通过 firstOut 遍历 tailNext 链 |
| 查询入边 | O(入度) | 通过 firstIn 遍历 headNext 链 |
| 删除顶点 | O(出度+入度) | 同步清理该顶点的所有出边和入边链表 |
| 添加弧 | O(1) | 在起点出边链和终点入边链头部插入新结点 |
✅ 典型应用场景:有向图的拓扑排序、关键路径计算、网络流分析等需频繁访问入/出边的算法。

代码集合
// 弧结构
typedef struct arcBox {
	int tailVertex;				// 弧尾编号,出度的位置
	struct arcBox *tailNext;	// 下一个弧尾,即出度firstOut需要连接的位置
	int headVertex;				// 弧头编号
	struct arcBox *headNext;	//即firstIn需要连接的位置
	int weight;
} ArcBox;

// 十字链表的顶点结构
typedef struct {
	int no;
	const char *show;
	ArcBox *firstIn;			// 入度
	ArcBox *firstOut;			// 出度
} CrossVertex;

// 图头,顺序存储实现图的结构
typedef struct {
	CrossVertex *nodes;			//顶点集合
	int numVertex;				//顶点个数
	int numEdge;				//边的个数
} CrossGraph;

CrossGraph *createCrossGraph(int n);		// 产生n个节点的十字链表的图
void releaseCrossGraph(CrossGraph *grap);

// 初始化图,设置节点信息
void initCrossGraph(CrossGraph *grap, int num, char *names[]);
// 添加
void addCrossArc(CrossGraph *grap, int tail, int head, int w);
// 计算no编号节点入度
int inDegreeCrossGraph(CrossGraph *grap, int no);
// 计算no编号节点出度
int outDegreeCrossGraph(CrossGraph *grap, int no);
注:
typedef 的生效时机
typedef struct arcBox { ... } ArcBox;

typedef struct { ... } CrossVertex;
CrossVertex *firstIn;  // 正确用法
ArcBox类型别名在整个结构体定义完成后才生效
- 在结构体
{}内部定义时,typedef尚未完成,此时编译器不认识ArcBox类型
结构体标签(tag)的可见性
- 结构体标签
struct arcBox在结构体内部立即生效 - 在结构体内部,只能通过完整的
struct arcBox引用自身类型 - 这是C语言标准规定的行为(C99 §6.7.2.3)
外部使用的原理
- 当定义
CrossVertex时,ArcBox的typedef已完成定义 - 此时编译器已识别
ArcBox为完整类型,可直接使用
| 场景 | 内部引用 (struct arcBox 内部) | 外部引用 (CrossVertex 内部) |
|---|---|---|
| 可见类型 | struct arcBox (标签) | ArcBox (typedef别名) |
| 原因 | typedef尚未生效 | typedef已全局生效 |
| 语法要求 | 必须带 struct 关键字 | 可直接使用类型别名 |
创建表头(把所有带有指针指代的对象全部创建对象/开辟空间) + 初始化对象
CrossGraph *createCrossGraph(int n) {
	CrossGraph *grap = (CrossGraph *)malloc(sizeof(CrossGraph));
	if (grap == NULL) {
		return NULL;
	}
	grap->nodes = (CrossVertex *)malloc(sizeof(CrossVertex) * n);
	if (grap == NULL) {
		free(grap);
		return NULL;
	}
	return grap;
}

void initCrossGraph(CrossGraph *grap, int num, char *names[]) {
	for (int i = 0; i < num; ++i) {
		grap->nodes[i].no = i;
		grap->nodes[i].show = names[i];
		grap->nodes[i].firstIn = grap->nodes[i].firstOut = NULL;
	}
}
添加边集合
void addCrossArc(CrossGraph *grap, int tail, int head, int w) {
	ArcBox *box = (ArcBox *)malloc(sizeof(ArcBox));
	if (box == NULL) {
		return;
	}
	box->weight = w;
	// 采用头插法,出度关系
	box->tailNext = grap->nodes[tail].firstOut;     //尾对应firstOut
	grap->nodes[tail].firstOut = box;
	// 采用头插法, 入度关系
	box->headVertex = head;
	box->headNext = grap->nodes[head].firstIn;		//头对应firstIn
	grap->nodes[head].firstIn = box;
}
入度/出度计算(不断遍历出度/入度的所有边)
int inDegreeCrossGraph(CrossGraph *grap, int no) {
	int count = 0;
	ArcBox *box = grap->nodes[no].firstIn;
	while (box) {
		++count;
		box = box->headNext;
	}

	return count;
}

int outDegreeCrossGraph(CrossGraph *grap, int no) {
	int count = 0;
	ArcBox *box = grap->nodes[no].firstOut;

	while (box) {
		++count;
		box = box->tailNext;
	}

	return count;
}
邻接多重表
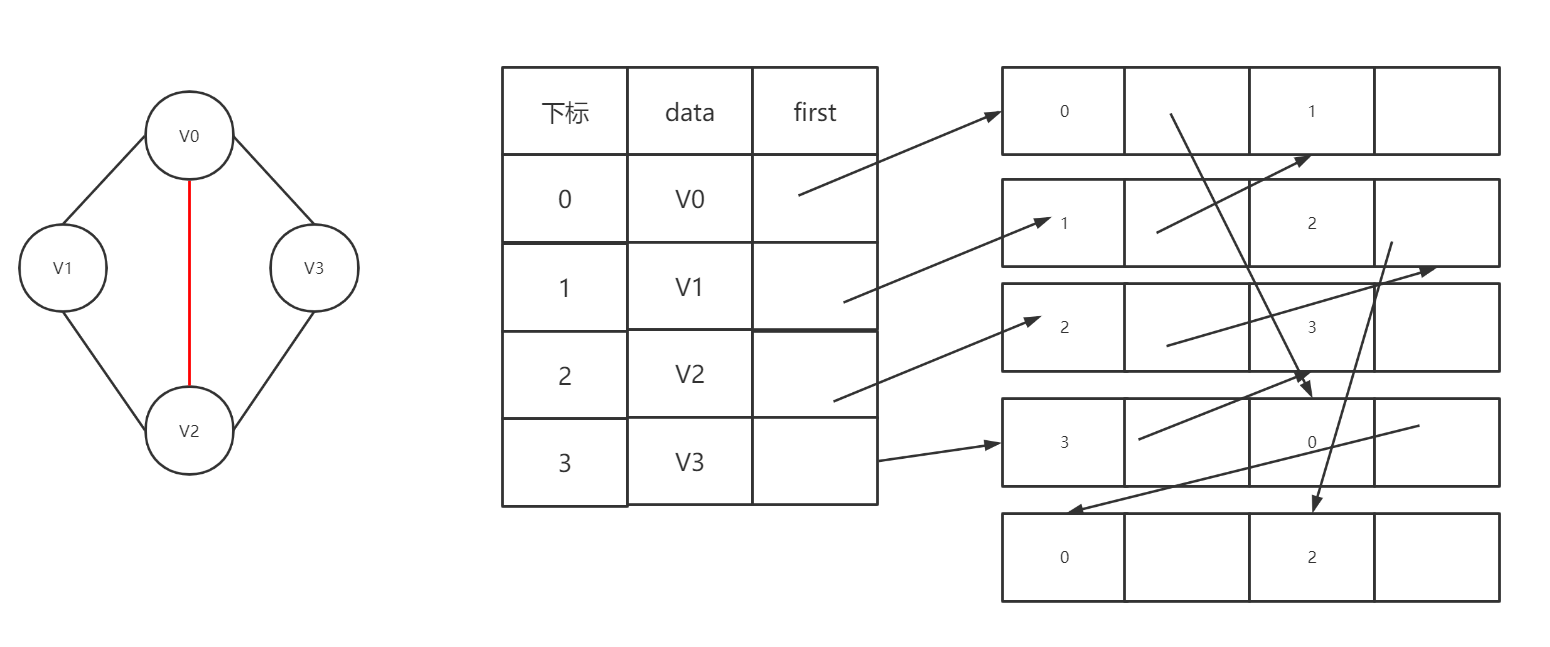
类似于十字链表,只不过十字链表是针对于有向图,邻接多重表针对无向图
由于过于麻烦,且使用价值不大(不再展示代码)
Kruskal算法
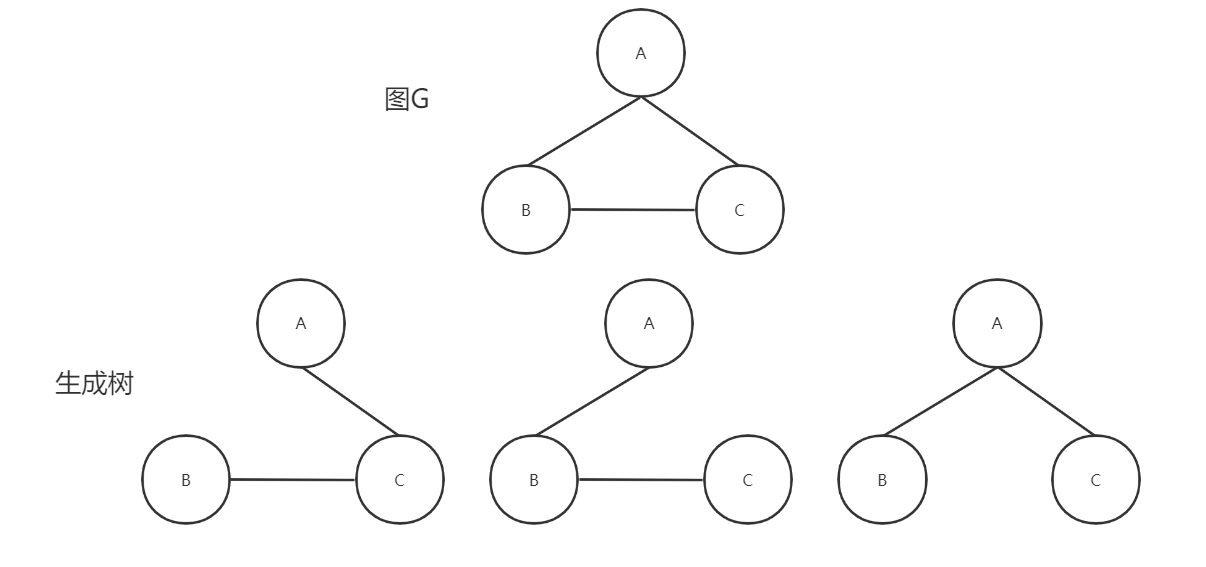
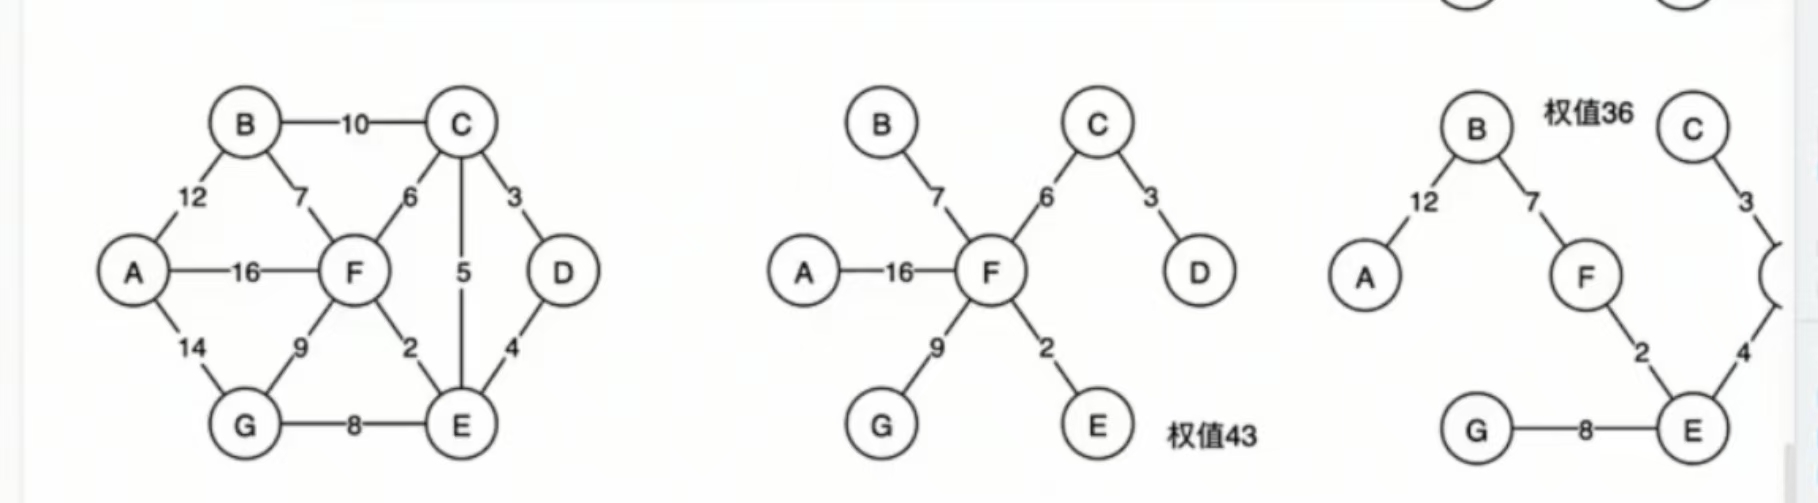
最小生成树:⼀个连通图的⽣成树是⼀个极小的连通⼦图,它包含图中全部的n个顶点,但只有构成⼀棵树的n-1条边。
对于包含n个顶点的⽆向完全图最多包含
Cnn−2
C_{n}^{n-2}
Cnn−2
颗⽣成树。
生成树的特性:
-
⼀个连通图可以有多个生成树;
-
⼀个连通图的所有⽣成树都包含相同的顶点个数和边数;
-
⽣成树当中不存在环;
-
移除⽣成树中的任意⼀条边都会导致图的不连通, ⽣成树的边最少特性;
-
在⽣成树中添加⼀条边会构成环。
-
对于包含n个顶点的连通图,⽣成树包含n个顶点和n-1条边;
对于包含n个顶点的⽆向完全图最多包含Cnn−2颗⽣成树。 对于包含n个顶点的⽆向完全图最多包含C_{n}^{n-2}颗⽣成树。 对于包含n个顶点的⽆向完全图最多包含Cnn−2颗⽣成树。
代码集合
/* 定义一个边集结构,边集数组 int a[5] */
typedef struct {
	int begin;		// 边的起点(顶点1)
	int end;		// 边的终点(顶点2)
	int weight;		// 边的权值
}EdgeSet;

#include "../01_MatrixGraph/matrixGraph.h"
// 顶点结构
typedef struct {
	int no;					// 顶点的编号
	const char *show;		// 存储顶点表示的数据
} MatrixVertex;
// 定义边的结构
typedef int MatrixEdge;

// 邻接矩阵表示图结构
typedef struct {
	MatrixVertex	vex[MaxNodeNum];
	MatrixEdge edges[MaxNodeNum][MaxNodeNum];
	int nodeNum;						// 约束访问顶点边界
	int edgeNum;						// 边的个数
	int directed;						// 是否有向图
} MGraph;

int initEdgeSet(const MGraph *graph, EdgeSet *edges);
// 排序边集数组
void sortEdgeSet(EdgeSet *edges, int num);
// Kruskal最小生成树,最外层的接口
int KruskalMGraph(const MGraph *graph, const EdgeSet *edges, int num, EdgeSet *result);
初始化边集数组
无向图(邻接矩阵)转换成边集数组
int initEdgeSet(const MGraph *graph, EdgeSet *edges) {
	int k = 0;    	//存一下graph->edges里面有多少个无向图的边,定为m
	for (int i = 0; i < graph->nodeNum; ++i) {		// 遍历每个节点
		for (int j = i + 1; j < graph->nodeNum; ++j) {
			if (graph->edges[i][j] > 0) {			// 有边
				edges[k].begin = i;
				edges[k].end = j;
				edges[k].weight = graph->edges[i][j];
				++k;
			}
		}
	}
	return k;		//返回对应的边集数组的总和来为后面做铺垫
}
排序边集数组
使用冒泡排序来处理数据
memcpy使用方法
对于拷贝一些结构体数据更加方便
#include <string.h>  // C 语言头文件
#include <cstring>   // C++ 头文件

void* memcpy(void* dest, const void* src, size_t n); //传输对应地址
| 参数 | 类型 | 作用 |
|---|---|---|
dest | void* | 目标内存地址(需可写) |
src | const void* | 源内存地址(只读) |
n | size_t | 复制的字节数 |
void sortEdgeSet(EdgeSet *edges, int num) {
	EdgeSet tmp;
	for (int i = 0; i < num; ++i) {
		for (int j = i + 1; j < num; ++j) {
			if (edges[j].weight < edges[i].weight) {
				memcpy(&tmp, &edges[i], sizeof(EdgeSet));
				memcpy(&edges[i], &edges[j], sizeof(EdgeSet));
				memcpy(&edges[j], &tmp, sizeof(EdgeSet));
			}
		}
	}
}
Kruskal最小生成树
时刻牢记:最小生成树节点为n,那么边的个数就是n-1
//利用参数值*edges来返回对应的对象值(就可以一个函数返回多个值,就可以以返回值为唯一值来操控整个函数)
int KruskalMGraph(const MGraph *graph, const EdgeSet *edges, int num, EdgeSet *result) {
	int *uSet;		  //并查集编号数组
	int sum = 0;	  //计算总权值
	int count = 0;    //用来单独判断是否达到n-1条边
	int a, b;
	// 1. 初始化并查集,每一个节点的编号都是自己
	uSet = malloc(sizeof(int) * graph->nodeNum);
	if (uSet == NULL) {
		return 0;
	}
	for (int i = 0; i < graph->nodeNum; ++i) {   //图里面的顶点个数
		uSet[i] = i;
	}
	// 2. 从已经排好序的边集中,找到最小的边,当这个边加入后,不构成闭环(边数达到n-1)
	for (int i = 0; i < num; ++i) {    //num是无向图里面所有边的总数
		a = getRoot(uSet, edges[i].begin);
		b = getRoot(uSet, edges[i].end);
		if (a != b) {
			uSet[a] = b;
            //result数组用于存储对应结果数组
			result[count].begin = edges[i].begin;
			result[count].end = edges[i].end;
			result[count].weight = edges[i].weight;
			sum += edges[i].weight;
			++count;
			if (count == graph->nodeNum - 1) {    //一旦边达到n-1一定要及时退出
				break;
			}
		}
	}
	free(uSet);

	return sum;
}
测试样例
void setupMGraph(MGraph *graph, int edgeValue) {
	const char *names[] = {"A", "B", "C", "D",
							"E", "F", "G"};
	initMGraph(graph, names, sizeof(names)/sizeof(names[0]), 0, edgeValue);
	addMGraph(graph, 0, 1, 12);
	addMGraph(graph, 0, 5, 16);
	addMGraph(graph, 0, 6, 14);
	addMGraph(graph, 1, 2, 10);
	addMGraph(graph, 1, 5, 7);
	addMGraph(graph, 2, 3, 3);
	addMGraph(graph, 2, 4, 5);
	addMGraph(graph, 2, 5, 6);
	addMGraph(graph, 3, 4, 4);
	addMGraph(graph, 4, 5, 2);
	addMGraph(graph, 4, 6, 8);
	addMGraph(graph, 5, 6, 9);
}

void test01() {
	MGraph graph;
	EdgeSet *edges;			// 边集数组
	int num;				// 边集数组的个数
	int sumWeight;			// 最小生成树的结果
	EdgeSet *result;

	setupMGraph(&graph, 0);
	edges = malloc(sizeof(EdgeSet) * graph.edgeNum);
	if (edges == NULL) {
		return;
	}
	num = initEdgeSet(&graph, edges);    //存一下graph->edges里面有多少个无向图的边,定为m
	sortEdgeSet(edges, num);

	result = malloc(sizeof(EdgeSet) * (graph.nodeNum - 1));     //结果数组
	if (result == NULL) {
		return;
	}
	sumWeight = KruskalMGraph(&graph, edges, num, result);
	printf("Kruskal sum of weight: %d\n", sumWeight);
	for (int i = 0; i < graph.nodeNum - 1; ++i) {
		printf("edge: %d: [%s] ---- <%d> ---- [%s]\n", i + 1,
					graph.vex[result[i].begin].show, result[i].weight, graph.vex[result[i].end].show);
	}

	free(edges);
	free(result);
}
普里姆(Prim)算法
最经典的两个最小生成树算法:Kruskal 算法与 Prim 算法。
两者分别从不同的角度构造最小生成树,Kruskal 算法从边的角度出发,使用贪心的方式选择出图中的最小生成树,而Prim 算法从顶点的角度出发,逐步找各个顶点上最小权值的边来构建最小生成树的。
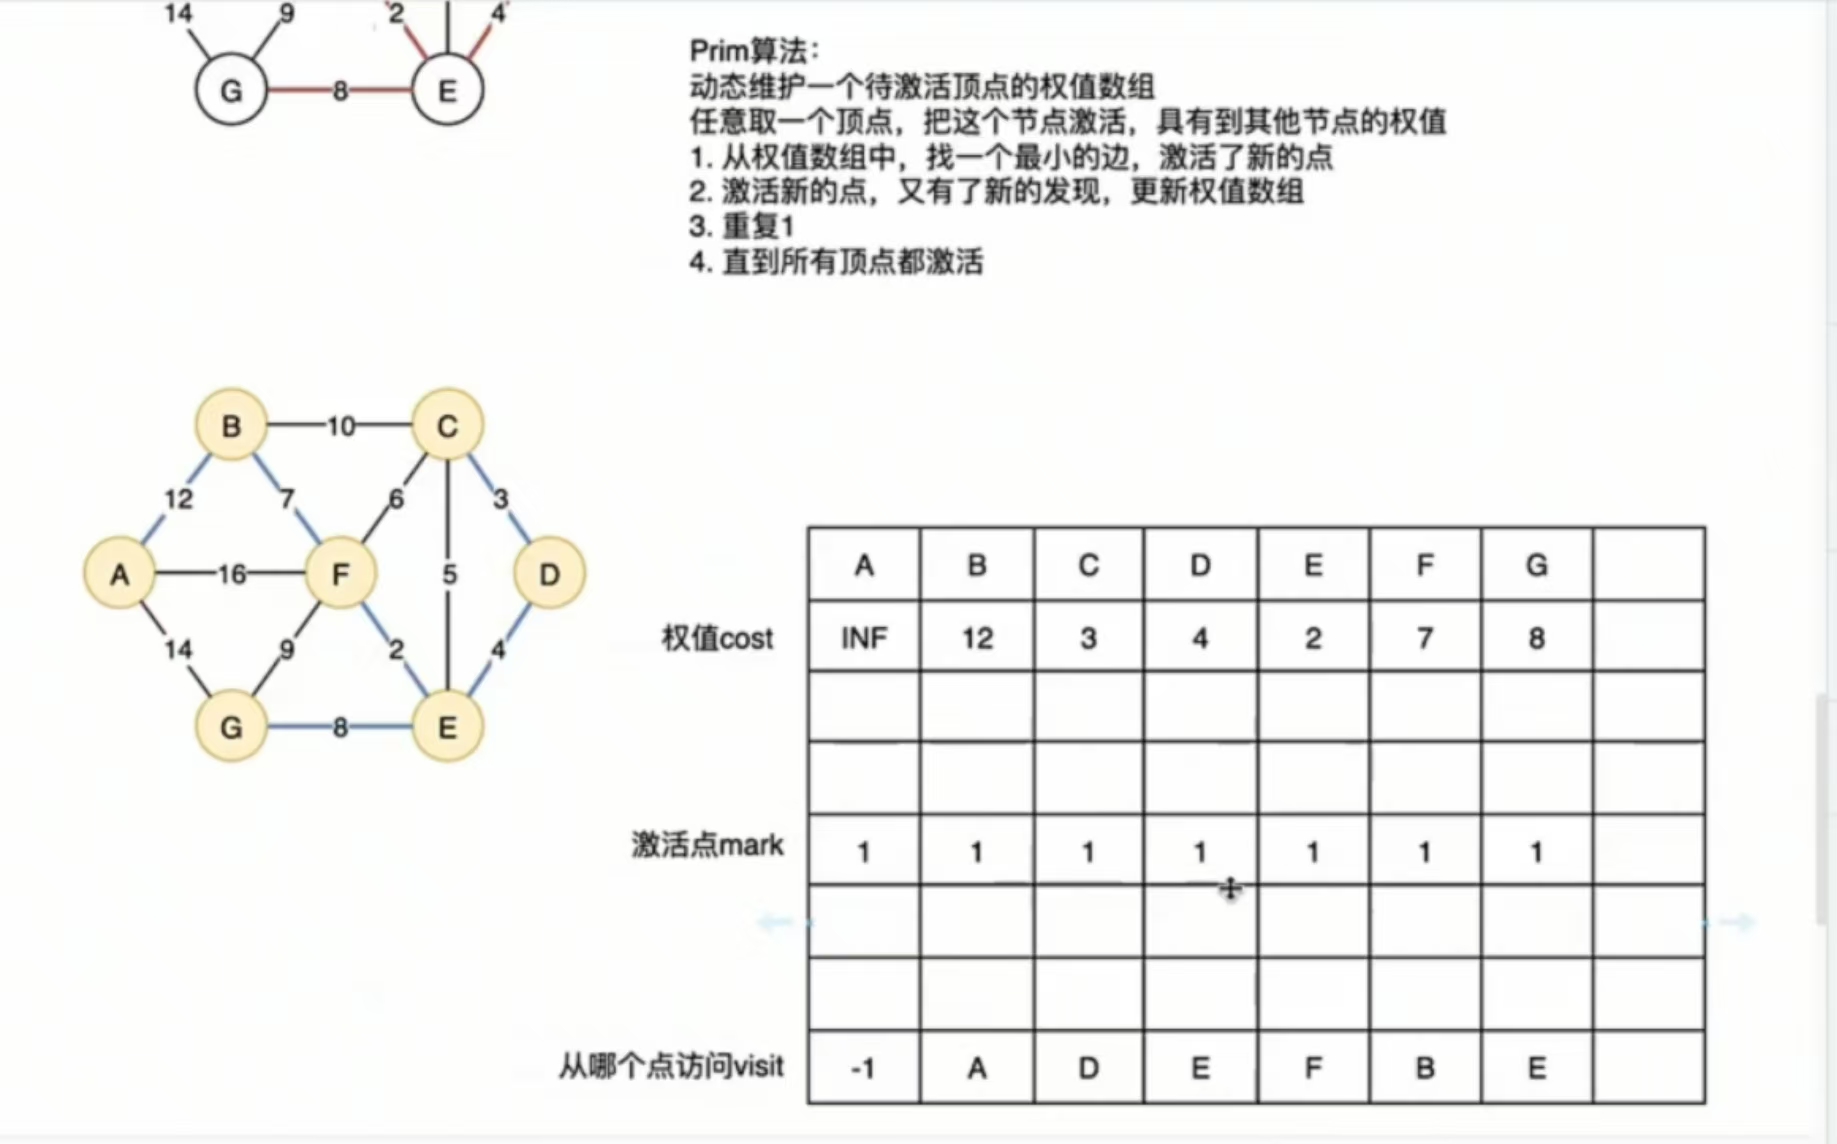
核心思路:
- 首先初始化cost数组
用于记录前一节点到该节点的权值,mark数组标记是否激活,visit数组记录激活的前一节点 - 其次激活给定节点(A节点),找A节点附近所有的边,并记录权值/更新cost找到最小边,激活该点(B节点)。
- 重复上述操作,直至所有顶点全部激活。
代码集合
typedef struct {
	int begin;
	int end;
	int weight;
}EdgeSet;

#define MaxNodeNum	20
#define INF			1E4

// 顶点结构
typedef struct {
	int no;					// 顶点的编号
	const char *show;		// 存储顶点表示的数据
} MatrixVertex;
// 定义边的结构
typedef int MatrixEdge;

// 邻接矩阵表示图结构
typedef struct {
	MatrixVertex	vex[MaxNodeNum];
	MatrixEdge edges[MaxNodeNum][MaxNodeNum];
	int nodeNum;						// 约束访问顶点边界
	int edgeNum;						// 边的个数
	int directed;						// 是否有向图
} MGraph;

//prim算法,startV为其实节点
int PrimMGraph(const MGraph *graph, int startV, EdgeSet *result);
Prim算法
逻辑:1->2.1->2.2(1)->2.1 == (2.2 -> 2.1)形式
int PrimMGraph(const MGraph *graph, int startV, EdgeSet *result) {
	int *cost = malloc(sizeof(int) * graph->nodeNum);	//记录权值
	int *mark = malloc(sizeof(int) * graph->nodeNum);	//激活数组(类似visit)
	int *visit = malloc(sizeof(int) * graph->nodeNum);	//记录激活前一节点
	if (cost == NULL || mark == NULL || visit == NULL) {
		return 0;
	}
	int sum = 0;
	// 1. 更新第一个节点激活的状态
	for (int i = 0; i < graph->nodeNum; ++i) {
		cost[i] = graph->edges[startV][i];
		mark[i] = 0;
		// 1.1 更新visit信息,说明从哪个节点开始访问i的
		if (cost[i] < INF) {
			visit[i] = startV;
		} else {
			visit[i] = -1;
		}
	}
	mark[startV] = 1;

	// 2. 动态激活节点,查找最小值,添加到result边集数组里
	for (int i = 0; i < graph->nodeNum - 1; ++i) {		// 查找n-1个最小生成树的边
		// 2.1从权值数组里找到未激活节点的最小值,并及时存储
		int min = INF;
		int k = 0;	//临时的k
		for (int j = 0; j < graph->nodeNum; ++j) {		// 从权值数组里找到未激活顶点的最小值
			if (mark[j] == 0 && cost[j] < min) {
				min = cost[j];
				k = j;
			}
		}
		mark[k] = 1;			// 激活了最小值的节点
		result[i].begin = visit[k];		// 确定从哪个节点来的
		result[i].end = k;
		result[i].weight = min;
		sum += min;
        // 2.2 类似1的做法,更新激活状态(cost,visit值)
		for (int j = 0; j < graph->nodeNum; ++j) {
			if (mark[j] == 0 && graph->edges[k][j] < cost[j]) {		// 激活的k号节点他的边比之前的cost小
				cost[j] = graph->edges[k][j];
				visit[j] = k;
			}
		}
	}
    //防止内存泄漏
	free(cost);
	free(mark);
	free(visit);
	return sum;
}
测试样例
void setupMGraph(MGraph *graph, int edgeValue) {
	const char *names[] = {"A", "B", "C", "D",
							"E", "F", "G"};
	initMGraph(graph, names, sizeof(names)/sizeof(names[0]), 0, edgeValue);
	addMGraph(graph, 0, 1, 12);
	addMGraph(graph, 0, 5, 16);
	addMGraph(graph, 0, 6, 14);
	addMGraph(graph, 1, 2, 10);
	addMGraph(graph, 1, 5, 7);
	addMGraph(graph, 2, 3, 3);
	addMGraph(graph, 2, 4, 5);
	addMGraph(graph, 2, 5, 6);
	addMGraph(graph, 3, 4, 4);
	addMGraph(graph, 4, 5, 2);
	addMGraph(graph, 4, 6, 8);
	addMGraph(graph, 5, 6, 9);
}

void test02() {
	MGraph graph;			//图对象
	EdgeSet *result;		//边集数组
	int sumWeight;
	setupMGraph(&graph, INF);

	result = malloc(sizeof(EdgeSet) * (graph.nodeNum - 1));
	if (result == NULL) {
		return;
	}
	sumWeight = PrimMGraph(&graph, 0, result);	//计算总权值
	printf("Prim weight = %d\n", sumWeight);
	for (int i = 0; i < graph.nodeNum - 1; ++i) {
		printf("edge %d: [%s] --- [%d] ---- [%s]\n", i + 1, graph.vex[result[i].begin].show,
					result[i].weight, graph.vex[result[i].end].show);
	}
}

int main() {
	test02();

	return 0;
}
迪杰斯特拉算法(dijkstra)
源点
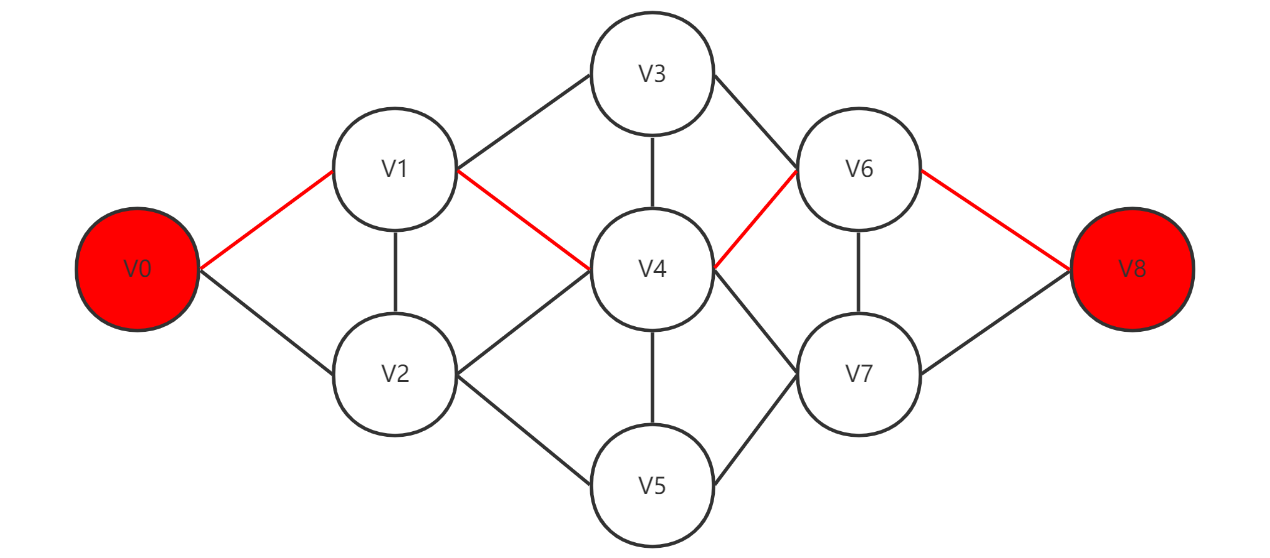
路径起始的第⼀个顶点称为源点(Source),最后⼀个顶点称为终点(Destination)。图下图中,我们⽤红色标注出的就可以认为是⼀个路径(V0 ->V1 ->V4 ->V6 ->V8)的源点和终点
最短路径
对于无向图而言,从源点V0到终点V8的最短路径就是从源点V0到终点V8所包含的边最少的路径。我们只需要从源点V0出发对图做广度优先搜索,⼀旦遇到终点V8就终⽌
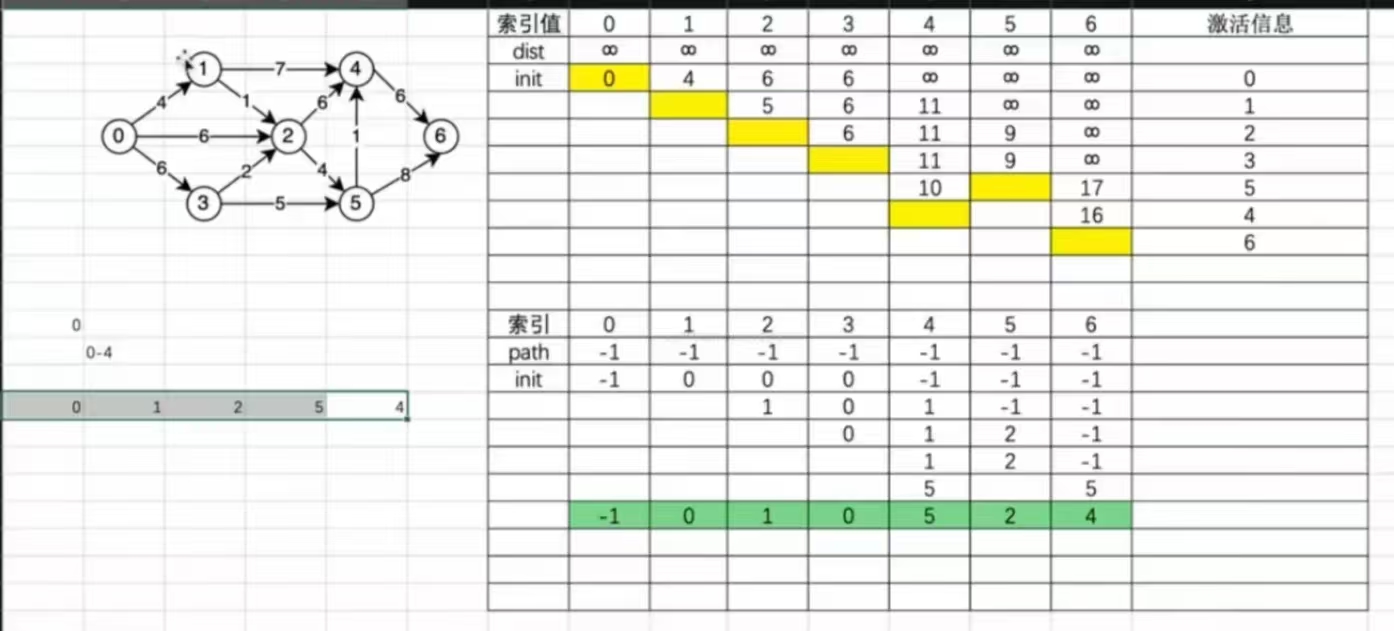
核心思路:
- 初始化有向图,dist数组(存储源点到节点的距离)初始化为INF
- 将激活start编号到其他各个节点的路径进行更新
(mark[start]=1, dist[start]=0,path[start]=-1结束标志),再更新PATH - 循环,所有节点都激活
3.1 每激活一个节点, 从源点开始到这个激活点,是目前认为的最优解,再最优解的情况下,增加相关的边会影响其他未激活点的距离情况,找到最小的值
3.2 更新dist数组最小值/PATH(类似于2的操作)
核心逻辑:1 -> 2 -> 3.1 -> 3.2 == 1 ->(3.1 -> 3.2)
#define MaxNodeNum	20
#define INF			1E4

// 顶点结构
typedef struct {
	int no;					// 顶点的编号
	const char *show;		// 存储顶点表示的数据
} MatrixVertex;
// 定义边的结构
typedef int MatrixEdge;

// 邻接矩阵表示图结构
typedef struct {
	MatrixVertex	vex[MaxNodeNum];
	MatrixEdge edges[MaxNodeNum][MaxNodeNum];
	int nodeNum;						// 约束访问顶点边界
	int edgeNum;						// 边的个数
	int directed;						// 是否有向图
} MGraph;

//dij最短距离
void DijkstraMGraph(const MGraph *graph, int start, int dist[], int path[]);
//栈的思想(展示数据)
void showShortPath(const int path[], int num, int pos);
dij最短距离
核心3数组:dist (当前节点到源点的距离)
path(记录上一个激活自己的节点)
mark (是否为激活节点)
void DijkstraMGraph(const MGraph *graph, int start, int dist[], int path[]) {
	int *mark;			// 节点访问记录
	mark = malloc(sizeof(int) * graph->nodeNum);
	if (mark == NULL) {
		return;
	}
	// 1. 激活start后,更新dist表,path中start编号设置为-1,作为路径打印时结束标志
	for (int i = 0; i < graph->nodeNum; ++i) {
		dist[i] = graph->edges[start][i];
		mark[i] = 0;
		if (dist[i] < INF) {
			path[i] = start;
		} else {
			path[i] = -1;
		}
	}
	mark[start] = 1;
	path[start] = -1;	//作为路径打印时结束标志
	dist[start] = 0;	//源点到自己为0
	// 2. 从dist里查找最小值
	int min;
	int tmpIndex;
	for (int i = 0; i < graph->nodeNum - 1; ++i) {		// 还要激活的点
		min = INF;
		// 从未激活节点中,找到一个源点到其的最短距离
		for (int j = 0; j < graph->nodeNum; ++j) {
			if (mark[j] == 0 && dist[j] < min) {
				min = dist[j];
				tmpIndex = j;
			}
		}
		mark[tmpIndex] = 1;
		// 以刚刚激活的节点,更新源点到其他未激活顶点的距离
		for (int j = 0; j < graph->nodeNum; ++j) {	//牢记每个对象的含义
			if (mark[j] == 0 && dist[tmpIndex] + graph->edges[tmpIndex][j] < dist[j]) {
				dist[j] = dist[tmpIndex] + graph->edges[tmpIndex][j];
				path[j] = tmpIndex;
			}
		}
	}
	free(mark);
}
弹栈展示数据
void showShortPath(const int path[], int num, int pos) {
	int *stack;			// 栈结构
	int top = -1;		// 指向有效位置

	stack = malloc(sizeof(int)*num);
	if (stack == NULL) {
		return;
	}
	// 1. 将上一个状态压入栈
	while (path[pos] != -1) {
		stack[++top] = pos;
		pos = path[pos];
	}
	stack[++top] = pos;		//将-1数据存储出来
	// 2. 弹栈打印,直到top等于-1
	while (top != -1) {
		printf("\t%d", stack[top--]);
	}
	printf("\n");
	free(stack);
}
测试样例
#include <stdio.h>
#include <stdlib.h>
#include "DijkstraShortPath.h"

void setupMGrap(MGraph *graph) {
	const char *names[] = {"0", "1", "2", "3",
					 "4", "5", "6"};
	initMGraph(graph, names, sizeof(names) / sizeof(names[0]), 1, INF);

	addMGraph(graph, 0, 1, 4);
	addMGraph(graph, 0, 2, 6);
	addMGraph(graph, 0, 3, 6);
	addMGraph(graph, 1, 4, 7);
	addMGraph(graph, 1, 2, 1);
	addMGraph(graph, 2, 4, 6);
	addMGraph(graph, 2, 5, 4);
	addMGraph(graph, 3, 2, 2);
	addMGraph(graph, 3, 5, 5);
	addMGraph(graph, 4, 6, 6);
	addMGraph(graph, 5, 4, 1);
	addMGraph(graph, 5, 6, 8);
}

int main() {
	MGraph graph;
	int *dist;			// 存储 源点x到其他节点的最短路径
	int *path;			// 存储源点到每个顶点最短路径的前一个节点信息

	setupMGrap(&graph);

	dist = malloc(sizeof(int) * graph.nodeNum);
	path = malloc(sizeof(int) * graph.nodeNum);

	DijkstraMGraph(&graph, 0, dist, path);
	printf("0 node to 5 node\n");
	showShortPath(path, 10, 5);
	printf("0 node to 6 node\n");
	showShortPath(path, 10, 6);
}
拓扑排序
基础概念
有向无环图
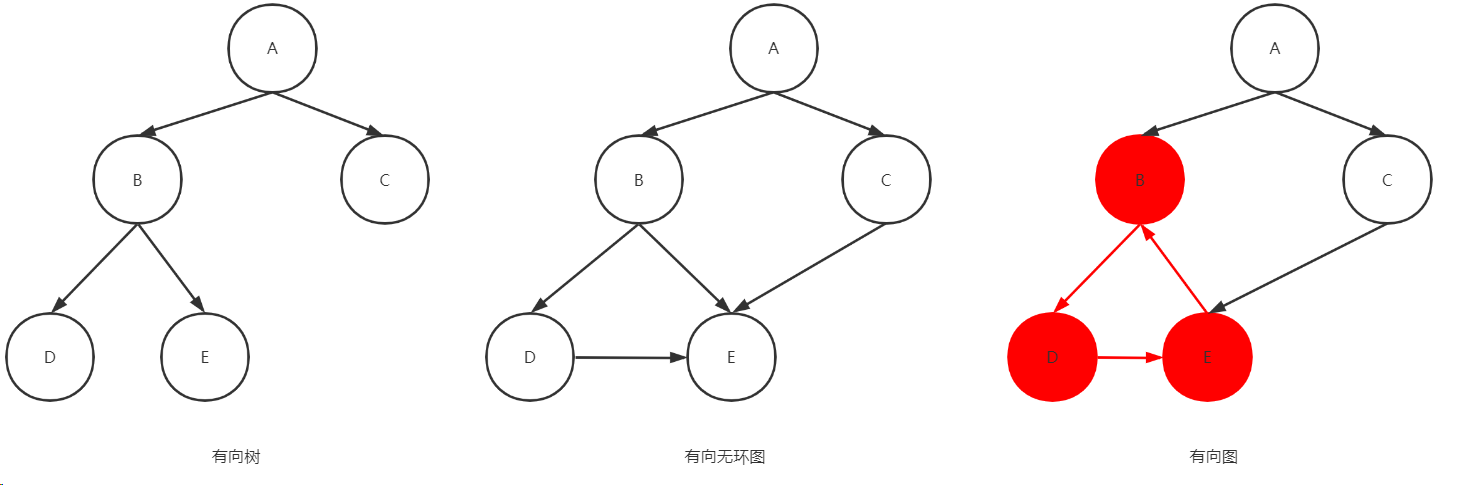
⼀个无环的有向图称为有向无环图(Directed Acycline Graph),简称 DAG 图。
活动 (强调动作的先后顺序)
所有的⼯程或者某种流程都可以分为若干个小的工程或者阶段,我们称这些小的⼯程或阶段为“活动”。
打个比方,如何把⼀只⼤象装到冰箱⾥,很简单,分三步。第⼀,打开冰箱门;第⼆,将⼤象装进去;第三,关上冰箱门。这三步中的每⼀步便是⼀个 “活动” 。
AOV网
在⼀个表示工程的有向图中,⽤顶点表示活动,⽤弧表示活动之间的优先关系的有向图 称为顶点 表示活动的⽹(Activity On Vertex Network),简称AOV网。(重点在顶点Vertex)
拓扑排序
所谓的拓扑排序,其实就是对⼀个有向⽆环图构造拓扑序列的过程。
可以认为是有向无环图中强调活动顺序先后的一个过程
拓扑序列:设G=(V,E)是⼀个具有n个顶点的有向图,V中的顶点序列 V1,V2,V3…Vn满⾜若从顶点Vi到Vj有⼀条路径,则在顶点序列中顶点Vi必在顶点Vj之前。则我们称这样的顶点序列为⼀个拓扑序列。
核心思想
-
在有向图中选⼀个没有前驱的顶点且输出之。 (即入度=0的顶点)
-
从图中删除该顶点和所有以它为尾的弧。(即以该顶点所有出度的边全部删除)
重复上述两步,直⾄全部顶点均已输出,或者当前图不存在无前驱的顶点为⽌,后⼀种情况说明有向图中存在环。
(即count==graph->nodeNum时候即无环图)
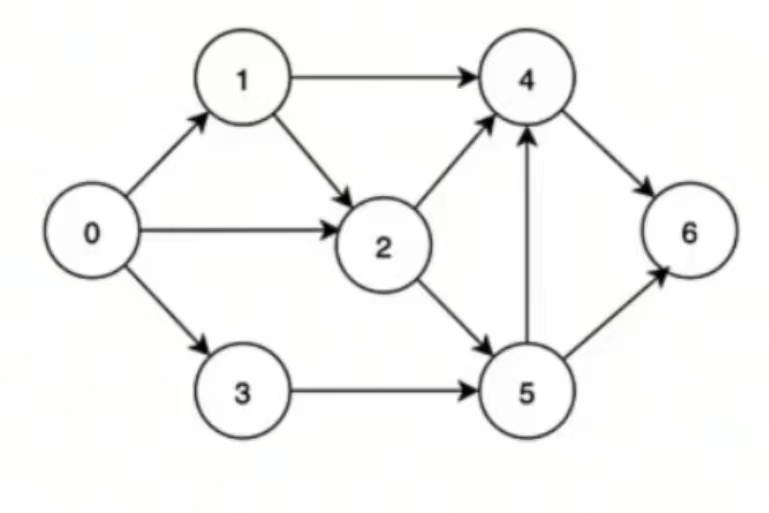
拓扑排序(TopologicalSort)
核心需要:inDegree数组(所有节点的入度情况)
stack入栈数组(统计inDegree数组中所有入度为0的节点)
//利用的是邻接表,注意各个对象的含义
// 边的结构
typedef struct arcEdge {
	int no;
	int weight;
	struct arcEdge *next;
} ArcEdge;

// 顶点的结构
typedef struct {
	int no;
	const char *show;		// 顶点的显示
	ArcEdge *firstEdge;		// 出度
} ArcNode;

// 使用邻接表
typedef struct {
	ArcNode *nodes;
	int *visited;
	int nodeNum;
	int edgeNum;
	int directed;
} AGraph;

void visitAGraphNode(ArcNode *node);

int TopologicalSortAGrap(AGraph * grap) {
	int *inDegree;			// 入度记录表
	// 1. 将有向图的所有入度边更新到入度记录表
	inDegree = malloc(sizeof(int) * grap->nodeNum);
	if (inDegree == NULL) {
		return -1;
	}
	memset(inDegree, 0, sizeof(int) * grap->nodeNum);

	for (int i= 0; i < grap->nodeNum; ++i) {
		if (grap->nodes[i].firstEdge) {
			ArcEdge *edge = grap->nodes[i].firstEdge;
			while (edge) {
				++inDegree[edge->no];
				edge = edge->next;
			}
		}
	}
	// 2. 发现度为0,入栈
	// 查找入度记录表,度为0的顶点,入栈
	int *stack;
	int top = -1;
	stack = malloc(sizeof(int) * grap->nodeNum);
	if (stack == NULL) {
		free(inDegree);
		return -1;
	}
	for (int i = 0; i < grap->nodeNum; ++i) {
		if (inDegree[i] == 0) {
			stack[++top] = i;
		}
	}
	// 3. 根据任务栈里数据,弹出当前第一个任务
	int index;
	int count = 0;
	while (top != -1) {
		index = stack[top--];
		count++;
		visitAGraphNode(&grap->nodes[index]);
		// 更新入度信息表,如果发现有0,直接入缓存区
		ArcEdge *edge = grap->nodes[index].firstEdge;
		while (edge) {
			--inDegree[edge->no];
			if (inDegree[edge->no] == 0) {
				stack[++top] = edge->no;
			}
			edge = edge->next;
		}
	}

	if (count == grap->nodeNum) {
		return 0;
	} else {
		return 1;
	}
}
关键路径(拓扑排序的应用)
拓扑排序是关键路径的基础
基础概念
AOV网
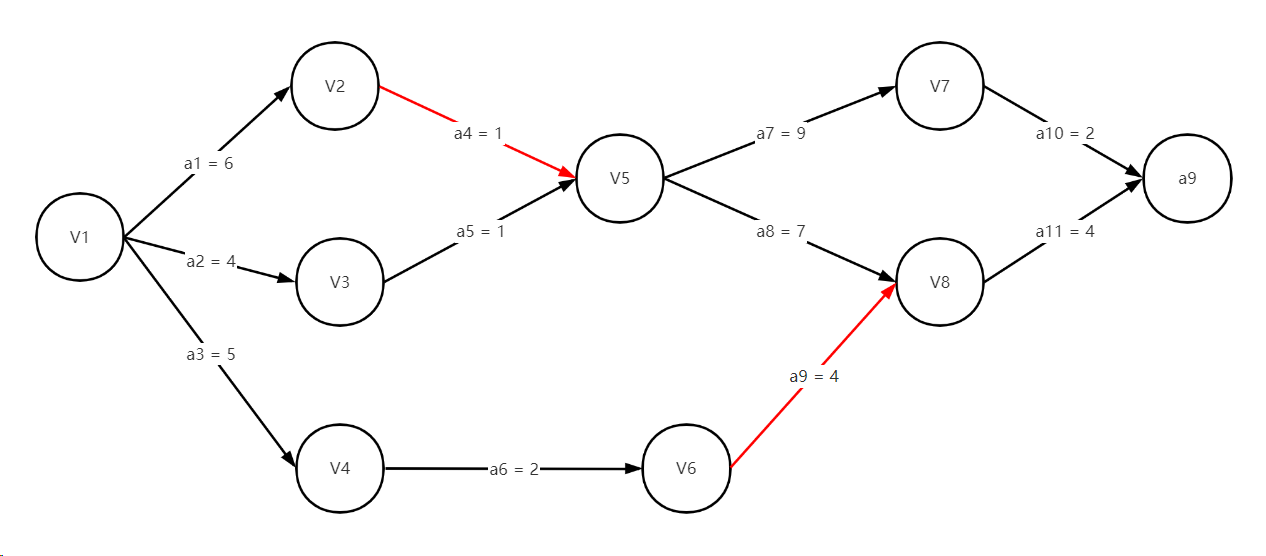
AOE网(Activity On Edge)即边表示活动的网,是与AOV网(顶点表示活动)相对应的⼀个概念。而拓扑排序恰恰就是在AOV网上进行的,这是拓扑排序与关键路径最直观的联系。AOE网是⼀个带权的有向无环图,其中顶点表示事件(Event),弧表示活动,权表示活动持续的时间。
AOE网的源点和汇点
由于⼀个工程中只有⼀个开始点和⼀个完成点,故将AOE网中入度为零的点称为源点,将出度为零的点称为汇点。
关键路径
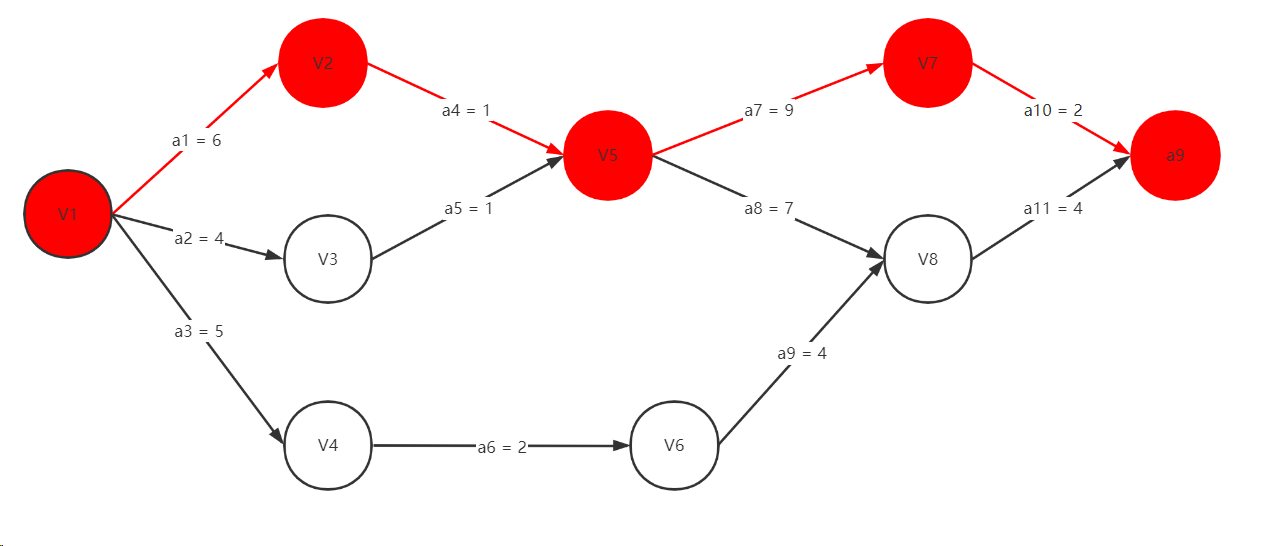
由于AOE网中的有些活动是可以并行进行的(如活动a1、a2和a3就是可以并行进行的),所以完成工程的最短时间是从源点到汇点的最长路径的长度。路径长度最长的路径就叫做关键路径(Critical Path)。如下图中红⾊顶点和有向边构成的就是⼀条关键路径,关键路径的长度就是完成活动 a1、a4 和a9、a10所需要的时间总和,即为 6+1+9+2 = 18。
ETV
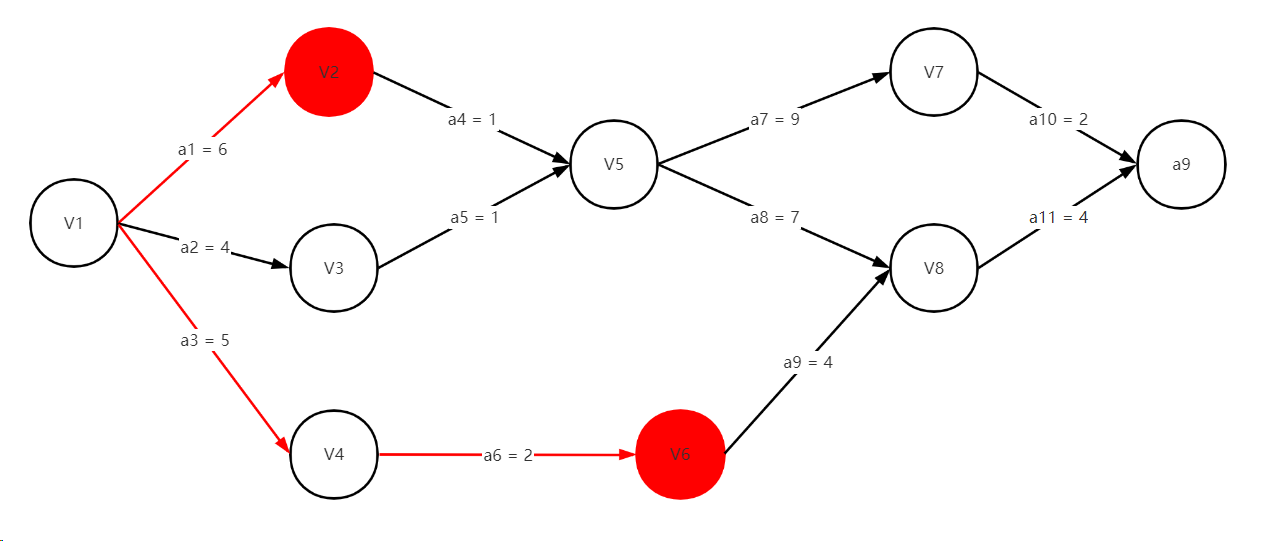
ETV(Earliest Time Of Vertex):事件最早发生时间,就是顶点的最早发生时间
(即从前一个节点正着推导) 需要说明,事件的最早发生时间一定是从源点到该顶点进行计算的。
LTV
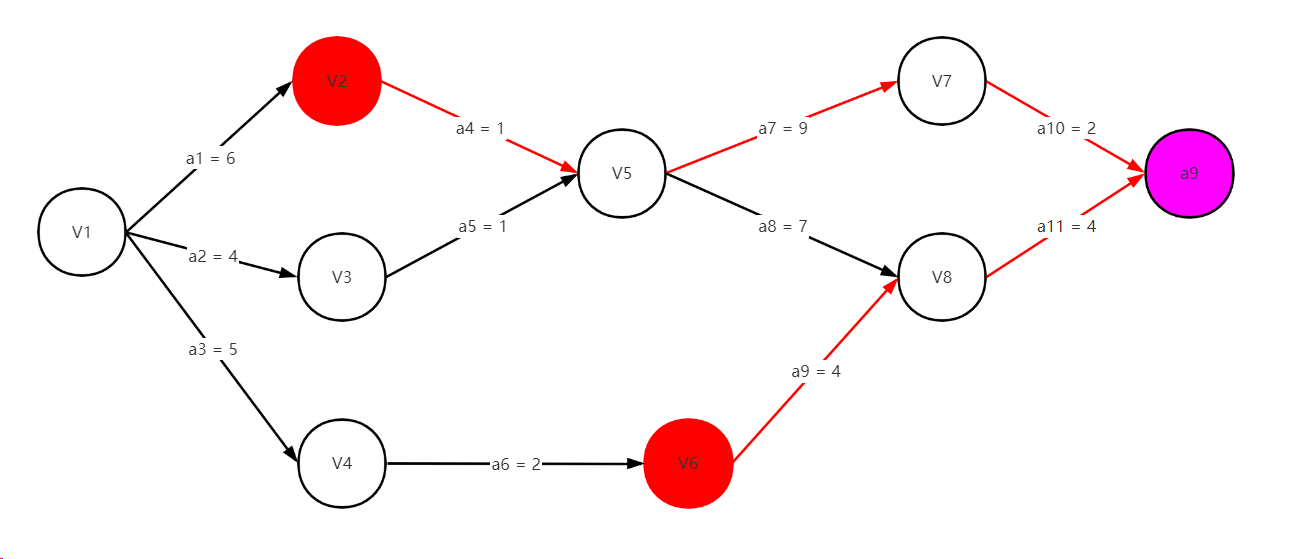
LTV(Latest Time Of Vertex):事件最晚发生时间,就是每个顶点对应的事件最晚需要开始的时间,如果超出此时间将会延误整个工期。
(即从后一个节点倒着推导) 因为要计算某⼀个事件的最晚发⽣时间,我们需要从汇点V9进⾏倒推。
ETE
ETE(Earliest Time Of Edge):活动的最早开工时间,就是弧的最早发生时间。
活动a4要最早开工时间为事件V2的最早发生时间 6;同理,活动a9的最早开工时间为事件v6的最早发生时间 7。显然活动的最早开工时间就是活动发生前的事件的最早开始时间。
LTE
LTE(Lastest Time of Edge):活动的最晚开工时间,就是不推迟工期的最晚开工时间。
活动的最晚开工时间则是基于事件的最晚发生时间。比如活动a4的最晚开工时间为事件V5的最晚发⽣时间减去完成活动a4所需时间,即 7 - 1 = 6;活动 a9的最晚开工时间为事件V8的最晚发生时间减去完成活动a9所需时间,即 14 - 4 = 10;
从上面也就可以看出 只要知道了每⼀个事件(顶点)的ETV 和 LTV,就可以推断出对应的 ETE 和 LTE . 此外还需要注意,关键路径是活动的集合,而不是事件的集合,所以当我们求得 ETV 和 LTV 之后,还需要计算 ETE 和 LTE 。
核心思想
必备要素:ETV,LTV(两个数组)
临时要素:inDegree(入度数组),stack+top(入度为0的数组),topOut+index(记录拓扑排序的索引)
tmp(暂存从栈上弹出的顶点编号),
-
使用拓扑排序归纳到ETV,LTV两个数组中
- 初始化记录所有节点的入度情况inDegree(),并查询出入度为0的节点->入栈stack(即源点)
-
- 暂存节点tmp
- 记录排序过程topOut+index
- 找附近边edge开始更改inDegree里面的值(–inDegree[edge->no])并及时入栈stack入度为0的点
- 计算最晚时间ETV值
- 循环while(top==-1)
- 用上一个记录的tmp节点ETV值初始化LTV数组
- 不断倒着index–,更新LTV里面的权值
-
不断遍历寻找
下一个顶点LTV及当前节点的权值之差是否等于当前节点的ETV,相等则为关键路径,否则不是。
代码集合
/* 关键路径:AOE网,边表示的活动,顶点表示事件
 * 整个项目,至少需要多少时间完成,AOE网中找一条从源点到汇点长度最长的路径
 * ETV: 事件最早发生时间		LTV: 事件最晚发生时间
 * 对于边:
 * ETE: 活动最早发生时间		LTE: 活动最晚发生时间
 * 统计边种最早发生时间和最晚开始时间,这个边成为关键活动,整个关键活动构成的就是关键路径
 */
#include "../02_AdjacencyList/adjacencyList.h"

//关键路径
void keyPath(AGraph *grap);
static void topologicalOrder(AGraph *grap, int *ETV, int *LTV) {
	int *inDegree = malloc(sizeof(int) * grap->nodeNum);
	if (inDegree == NULL) {
		return;
	}
	memset(inDegree, 0, sizeof(int) * grap->nodeNum);
	// 1. 初始化图中顶点的入度记录
	for (int i = 0; i < grap->nodeNum; ++i) {
		if (grap->nodes[i].firstEdge) {
			ArcEdge *edge = grap->nodes[i].firstEdge;
			while (edge) {
				++inDegree[edge->no];
				edge = edge->next;
			}
		}
	}
	// 2. 将所有入度为0的节点入栈,出栈找到各个顶点的最早时间发生时间
	int top = -1;
	int *stack = malloc(sizeof(int) * grap->nodeNum);
	int *topOut = malloc(sizeof(int) * grap->nodeNum);
	if (stack == NULL || topOut == NULL) {
		free(inDegree);
		return;
	}
	// 2.1 将初始化的入度为0的顶点编号,入栈,第一次一定是源点
	for (int i = 0; i < grap->nodeNum; ++i) {
		if (inDegree[i] == 0) {
			stack[++top] = i;
			break;
		}
	}
	// 2.2 不断出栈
	int tmp = 0;				// 暂存从栈上弹出的顶点编号
	int index = 0;				// 拓扑排序结果的索引
	while (top != -1) {
		tmp = stack[top--];
		topOut[index++] = tmp;		//记录排序的过程
		ArcEdge *edge = grap->nodes[tmp].firstEdge;
		while (edge) {
			--inDegree[edge->no];
			if (inDegree[edge->no] == 0) {
				stack[++top] = edge->no;
			}
			//  删除这个edge边后,这个边的入度顶点最早发生时间
			if (ETV[tmp] + edge->weight > ETV[edge->no]) {
				ETV[edge->no] = ETV[tmp] + edge->weight;
			}
			edge = edge->next;
		}
	}
	// 拓扑排序结束
	free(inDegree);
	free(stack);
	if (index < grap->nodeNum) {
		free(topOut);
		printf("Have a loop!\n");
		return;
	}
	// 3. 更新LTV
	for (int i = 0; i < grap->nodeNum; ++i) {
		LTV[i] = ETV[tmp];
	}
	while (index) {
		int getTopNo = topOut[--index];
		ArcEdge *edge = grap->nodes[getTopNo].firstEdge;
		while (edge) {
			if (LTV[edge->no] - edge->weight < LTV[getTopNo]) {
				LTV[getTopNo] = LTV[edge->no] - edge->weight;
			}
			edge = edge->next;
		}
	}
	free(topOut);
}

static void showTable(int *table, int n, const char *name) {
	printf("%s ", name);
	for (int i = 0; i < n; ++i) {
		printf("\t%d", table[i]);
	}
	printf("\n");
}

void keyPath(AGraph *grap) {
	// 1. 计算顶点的ETV和LTV
	int *ETV = malloc(sizeof(int) * grap->nodeNum);
	int *LTV = malloc(sizeof(int) * grap->nodeNum);
	if (ETV == NULL || LTV == NULL) {
		return;
	}
	memset(ETV, 0, sizeof(int) * grap->nodeNum);
	memset(LTV, 0, sizeof(int) * grap->nodeNum);
	topologicalOrder(grap, ETV, LTV);
	showTable(ETV, grap->nodeNum, "ETV");
	showTable(LTV, grap->nodeNum, "LTV");

	// 2. 计算边的ETE和LTE
	for (int i = 0; i < grap->nodeNum; ++i) {
		ArcEdge *edge = grap->nodes[i].firstEdge;
		while (edge) {
			// 每个边的最早发生时间是边的弧尾ETV
			// 每个边最晚发生的时间变弧头的LTV减去当前权值
			if (ETV[i] == LTV[edge->no] - edge->weight) {
				printf("<%s> --- <%d> --- <%s>\n",
					grap->nodes[i].show, edge->weight, grap->nodes[edge->no].show);
			}
			edge = edge->next;
		}
	}
	free(ETV);
	free(LTV);
}
注意点:
-
拓扑排序(TopologicalSort)的过程也可以用来代替迪杰斯特拉(dij)的求点与点之间的最短距离,但拓扑排序只能用于有向无环图,而迪杰斯特拉任何图都可以考虑(除了权值为负的情况)
-
普利姆(Prim)和迪杰斯特拉(dij)的算法代码类似,都是从边的角度去找寻最短距离
(kruskal从顶点的角度去寻找最短距离),但是最为核心的一点是普利姆是贪心算法内核,
而迪杰斯特拉是全局考虑(考虑的点更为全面)。判断条件不同—>考虑范围不同迪杰斯特拉的判断条件 if (mark[j] == 0 && dist[tmpIndex] + graph->edges[tmpIndex][j] < dist[j]) { dist[j] = dist[tmpIndex] + graph->edges[tmpIndex][j]; } 普利姆的判断条件 if (mark[j] == 0 && graph->edges[k][j] < cost[j]) { // 激活的k号节点他的边比之前的cost小 cost[j] = graph->edges[k][j]; } -
一定要明确各个对象的含义,尤其是邻接表里面的边和顶点结构
邻接矩阵和邻接表使用最为频繁(*ArcEdge edge = graph->nodes[cur].firstEdge)// 边的结构 typedef struct arcEdge { int no; //下一节点的编号 int weight; //当前节点到下一节点的权值 struct arcEdge *next; } ArcEdge; // 顶点的结构 typedef struct { int no; //当前节点的编号 const char *show; // 顶点的显示 ArcEdge *firstEdge; // 出度 } ArcNode; -
整个图结构的遍历充斥着BFS的思想,比如普利姆算法(附近边中找到最短距离),迪杰斯特拉算法(寻找最优解),拓扑排序(删除节点入度值),利用好栈/队列的性质,时刻变更。
更多推荐


 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)