
数据湖hudi原理
本文主要参考hudi0.15官网、hudi0.15源代码以及hudi更高的1.X版本编写,另外小部分参考了网上的材料,比如基础架构图等。
一、hudi架构
1.1 什么是Hudi
Apache Hudi 是一个开放数据湖(仓)平台,基于高性能开放表格式构建,旨在为您的数据湖提供数据库功能。Hudi 通过强大的新型增量处理框架重构了传统的低效批数据处理模式,实现分钟级低延迟分析能力。
-
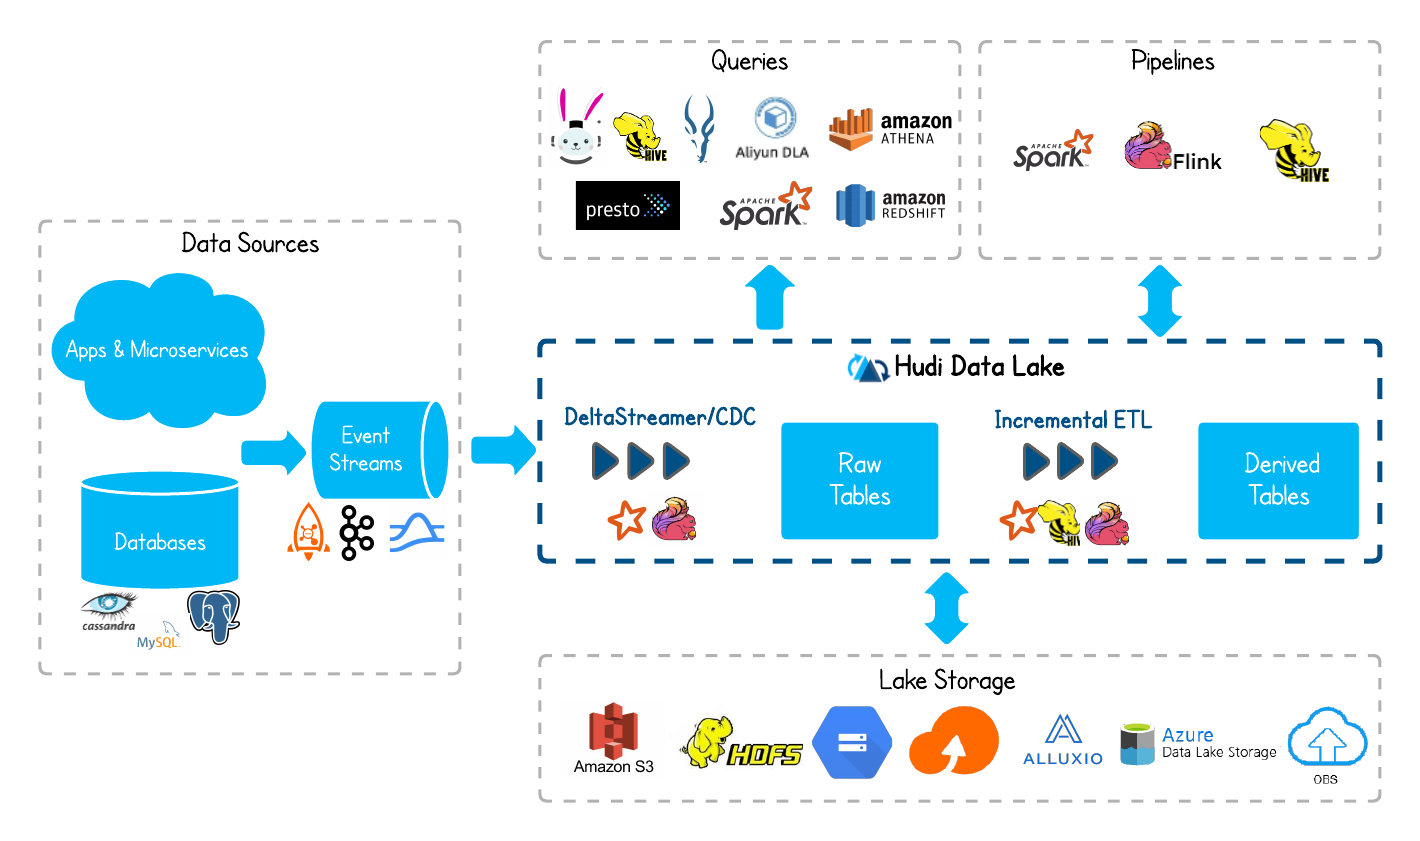
hudi 底层的数据可以存储到hdfs、s3、azure、alluxio、OBS等存储
-
hudi 可以使用spark/flink 计算引擎来消费 kafka、pulsar 等消息队列的数据,而这些数据可能来源于 app 或者微服务的业务数据、日志数据,也可以是 mysql 等数据库的 binlog 日志数据
-
spark/flink 首先将这些数据处理为hudi 格式的 row tables (原始表),然后这张原始表可以被 Incremental ETL (增量处理)生成一张 hudi 格式的 derived tables 派生表
-
hudi 支持的查询引擎有:trino、hive、impala、spark、presto等
-
支持 spark、flink、map-reduce 等计算引擎继续对hudi的数据进行再次加工处理
| 维度 | 传统架构(HDFS+批处理) | Apache Hudi |
|---|---|---|
| 数据处理粒度 | 文件级(File-level) | 记录级(Record-level) |
| 更新效率 | 全量重写(小时级) | 增量更新(分钟级) |
| 元数据管理 | • 静态分区元数据 • 无全局索引 | • 全局元数据索引(HoodieIndex) • 支持Schema演进 |
| 小文件处理 | • 依赖手动合并(Compact) • 合并时停写 | • 自动合并(Async Compaction) • 写入时同步合并(Clustering) |
| 数据恢复 | • 基于快照回滚(需全量备份) • 恢复耗时(小时级) | • 时间旅行(Time Travel)任意版本恢复 • 秒级回滚(基于Timeline) |
| ACID支持 | 不支持 | 支持事务提交(Timeline服务保障) |
| 查询模式 | 批式全表扫描 | 增量视图(Incremental Query) |
1.2 基础架构
-
通过DeltaStreammer、Flink、Spark等工具,将数据摄取到数据湖存储,可使用HDFS作为数据湖的数据存储;
-
基于HDFS可以构建Hudi的数据湖;
-
Hudi提供统一的访问Spark数据源和Flink数据源;
-
外部通过不同引擎,如:Spark、Flink、Presto、Hive、Impala、Aliyun DLA、AWS Redshit访问接口;
二、Timeline
Hudi把随着时间流逝,对表的一系列CRUD操作叫做Timeline,Timeline中某一次的操作,叫做Instant。Hudi 的核心是维护一个日志,timeline有助于提供表的即时视图,同时还能高效地支持按到达顺序检索数据。Hudi 的即时状态Instant由以下三部分组成:
-
Instant action:在表上执行的操作类型(COMMITS、CLEANS、DELTA_COMMIT、COMPACTION、ROLLBACK、SAVEPOINT)-
COMMITS- 提交表示将一批记录原子写入表中。 -
CLEANS- 后台活动会删除表中不再需要的旧版本文件。 -
DELTA_COMMIT- 增量提交是指将一批记录原子写入 MergeOnRead 类型表,其中部分/全部数据可以写入增量日志。 -
COMPACTION- 后台活动用于协调 Hudi 内部的差异数据结构,例如:将更新从基于行的日志文件迁移到列式格式。在内部,压缩操作在时间线上表现为一个特殊的提交 -
ROLLBACK- 表示提交/增量提交不成功并回滚,删除此类写入期间生成的任何部分文件 -
SAVEPOINT- 将某些文件组标记为“已保存”,以便清理程序不会删除它们。这有助于在发生灾难/数据恢复的情况下将表还原到时间线上的某个时间点。
-
-
Instant time:即时时间通常是一个时间戳(例如:20190117010349),按照动作开始时间的顺序单调增加。 -
state:当前时刻的状态-
REQUESTED- 表示某项行动已安排,但尚未启动 -
INFLIGHT- 表示当前正在执行该操作 -
COMPLETED- 表示时间轴上某项操作的完成
-
注意:两个数据处理的时间,用于解决因为延迟造成的数据时序问题。
1、arrival time(到达时间):数据到达Hudi的时间,commit time。
2、
event time(记录时间):record中记录的时间,如下图通过记录时间小时分区(从 07:00 开始按小时分区)
如下示例展示了在10:00至10:20期间,Hudi表上大约每5分钟发生一次的更新操作,这些操作会在Hudi时间轴上留下提交的元数据,同时伴随着其他后台清理/压缩作业。
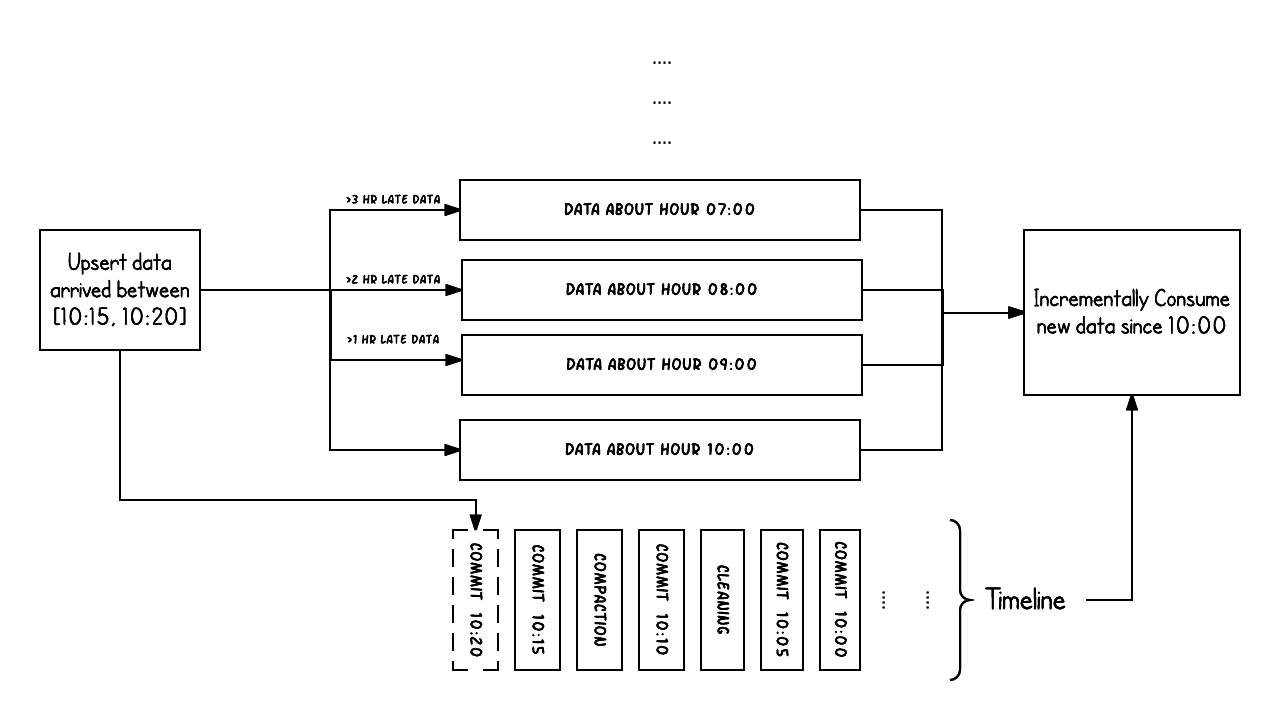
当出现延迟到达的数据时(例如本应属于9:00的数据延迟超过1小时,在10:20才到达),更新操作会将新数据写入较早的时间分区/文件夹中。借助Hudi的时间轴(timeline)机制,增量查询可以非常高效地仅消费自10:00以来成功提交的新数据变更文件,而无需扫描所有早于07:00的时间分区。
三、表格式
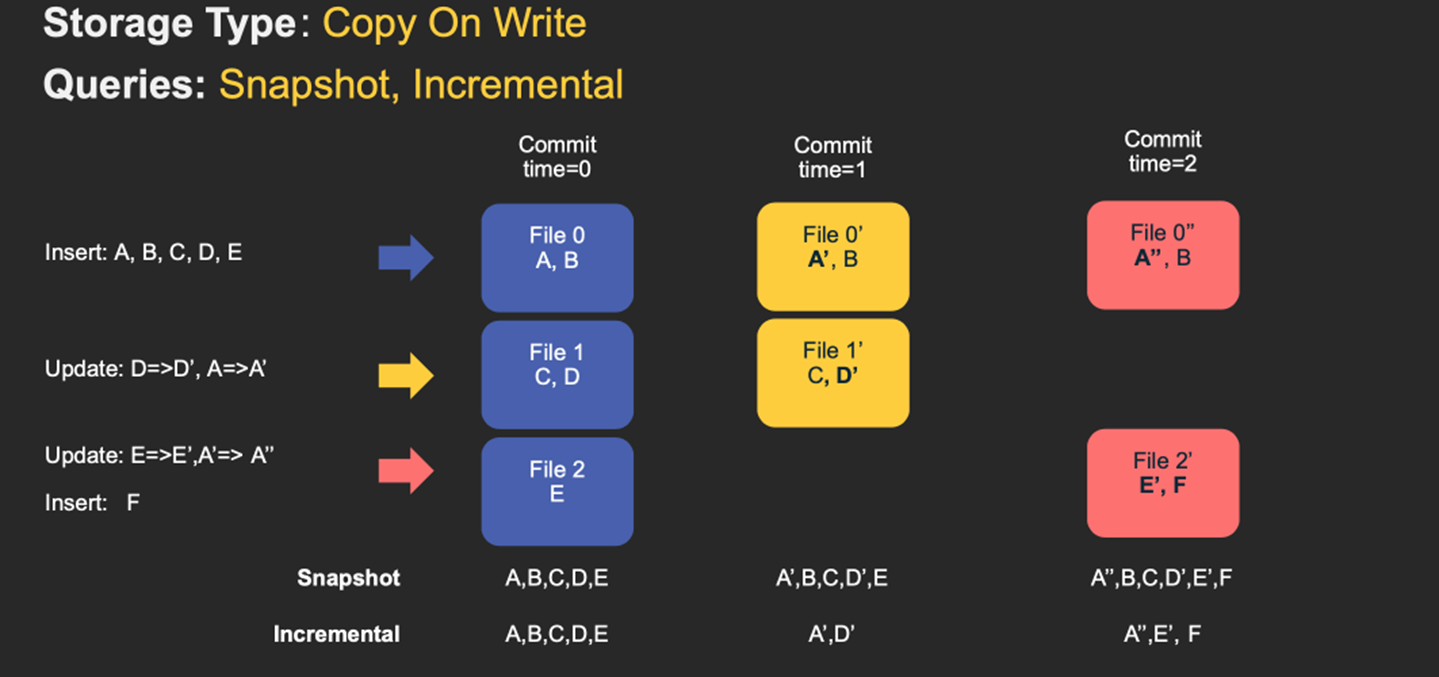
Hudi 提供了两种表类型,分别为Copy-on-Write(COW)和Merge-on-Read(MOR),其对应的查询类型如下:
| Copy-on-Write (COW) | Merge-on-Read(MOR) | |
|---|---|---|
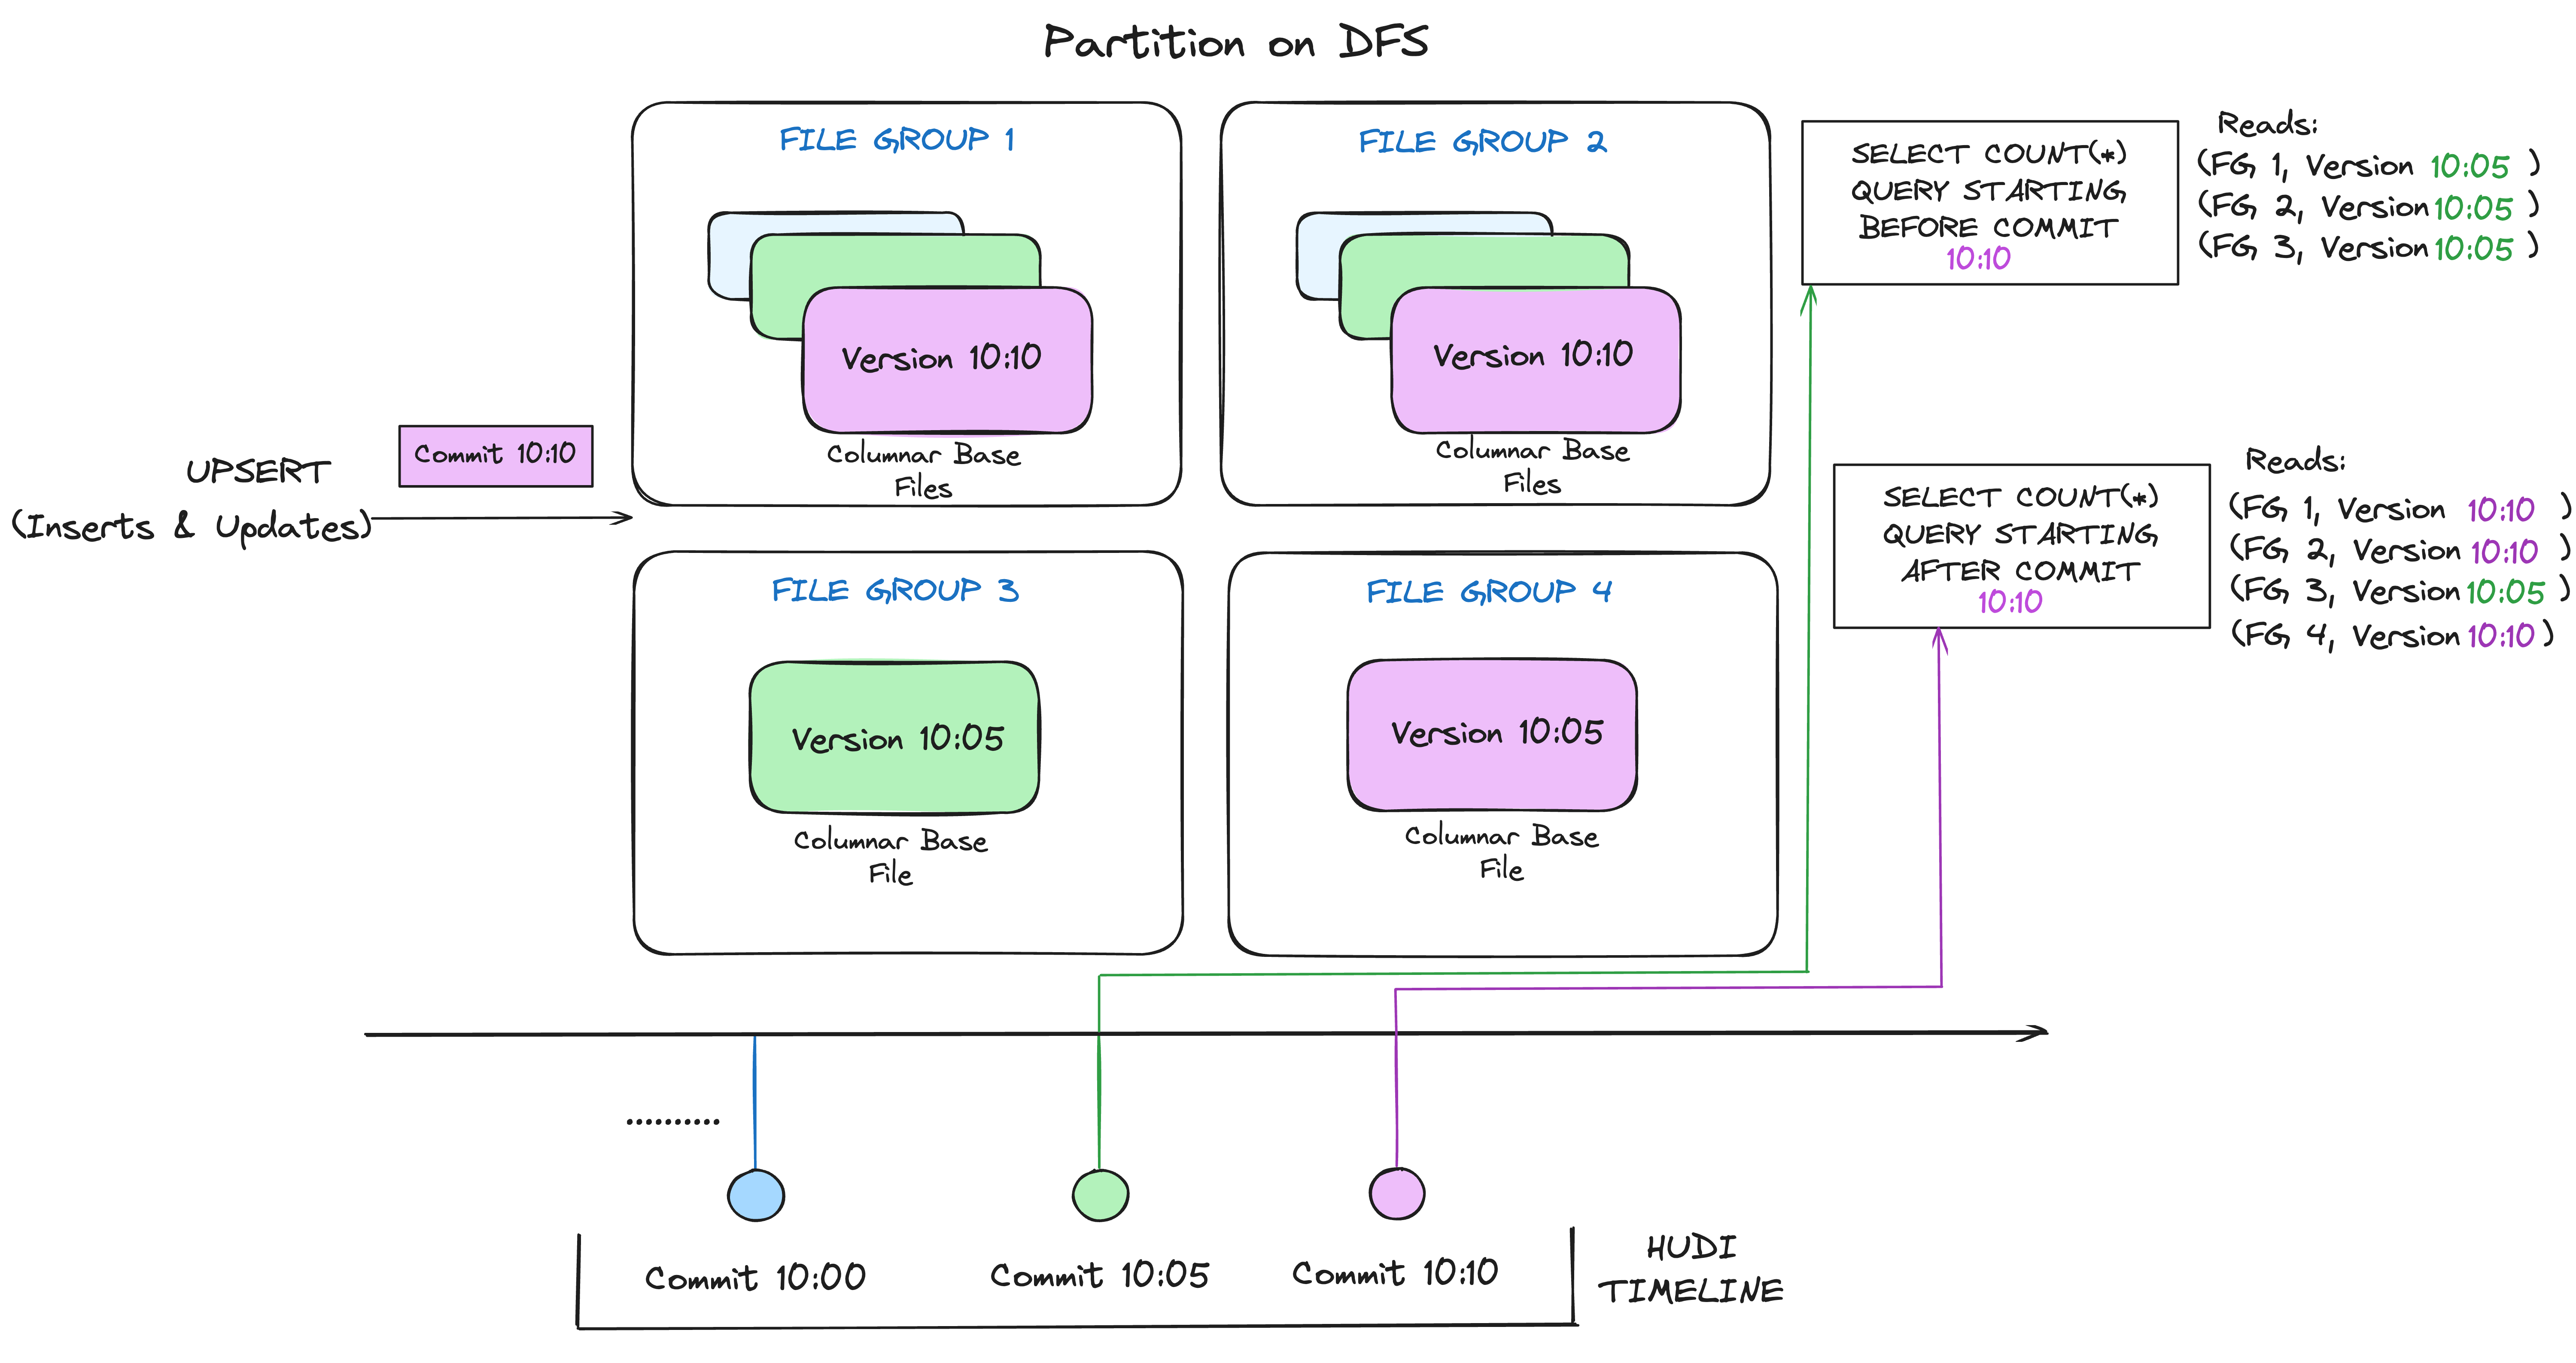
| 读写方式 | COW,在数据写入的时候,先找到包含更新数据的基础/列式文件切片,更新生成一个带有提交时刻标记的新切片,类似RDBMS中的B-Tree更新。 正在读数据的请求,读取的是最近的完整副本,类似Mysql 的MVCC的思想。 | MOR,新插入的数据存储在delta log中,定期再将delta log合并进行parquet数据文件。 读取数据时,会将delta log跟基/列式文件做merge,得到完整的数据返回。 |
 |
| |
| 查询支持 |
|
|
|
| |
| 优缺点 |
| 优点:由于写入数据先写delta log,且delta log较小,所以写入成本较低; 缺点:需要定期合并整理compact,否则碎片文件较多。读取性能较差,因为需要将delta log和老数据文件合并 |

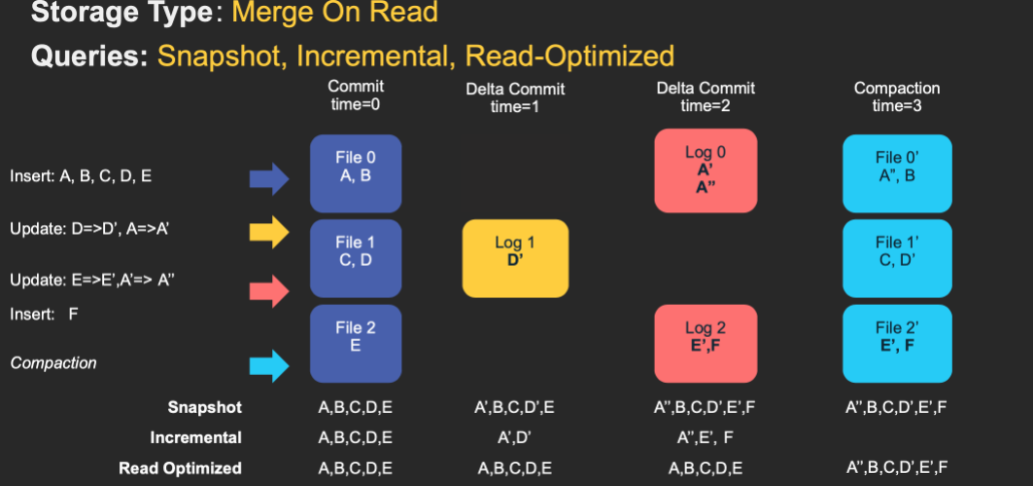
COW和MOR比对
| Trade-off | CopyOnWrite | MergeOnRead |
| Data Latency | Higher | Lower |
| Query Latency | Lower | Higher |
| Update cost (I/O) | Higher (rewrite entire parquet) | Lower (append to delta log) |
| Parquet File Size | Smaller (high update(I/0) cost) | Larger (low update cost) |
| Write Amplification | Higher | Lower (depending on compaction strategy) |
| 使用场景 | 写少读多 | 写多读少 |
四、数据组织
4.1 文件布局
-
Hudi 将数据表组织到分布式文件系统上基本路径下的目录结构中
-
表被分成多个分区
-
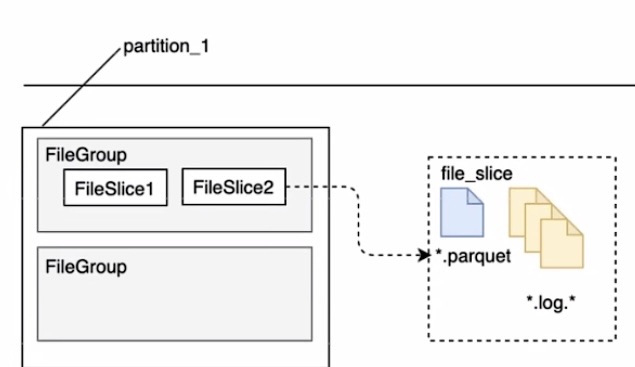
在每个分区中,文件被组织成文件组,由文件 ID 唯一标识
-
每个文件组包含多个文件切片
-
每个切片包含在某个提交/压缩瞬间生成的基本文件(.parquet/ .orc)(由配置 - hoodie.table.base.file.format定义),以及自生成基本文件以来包含对基本文件的插入/更新的一组日志文件( .log. )。
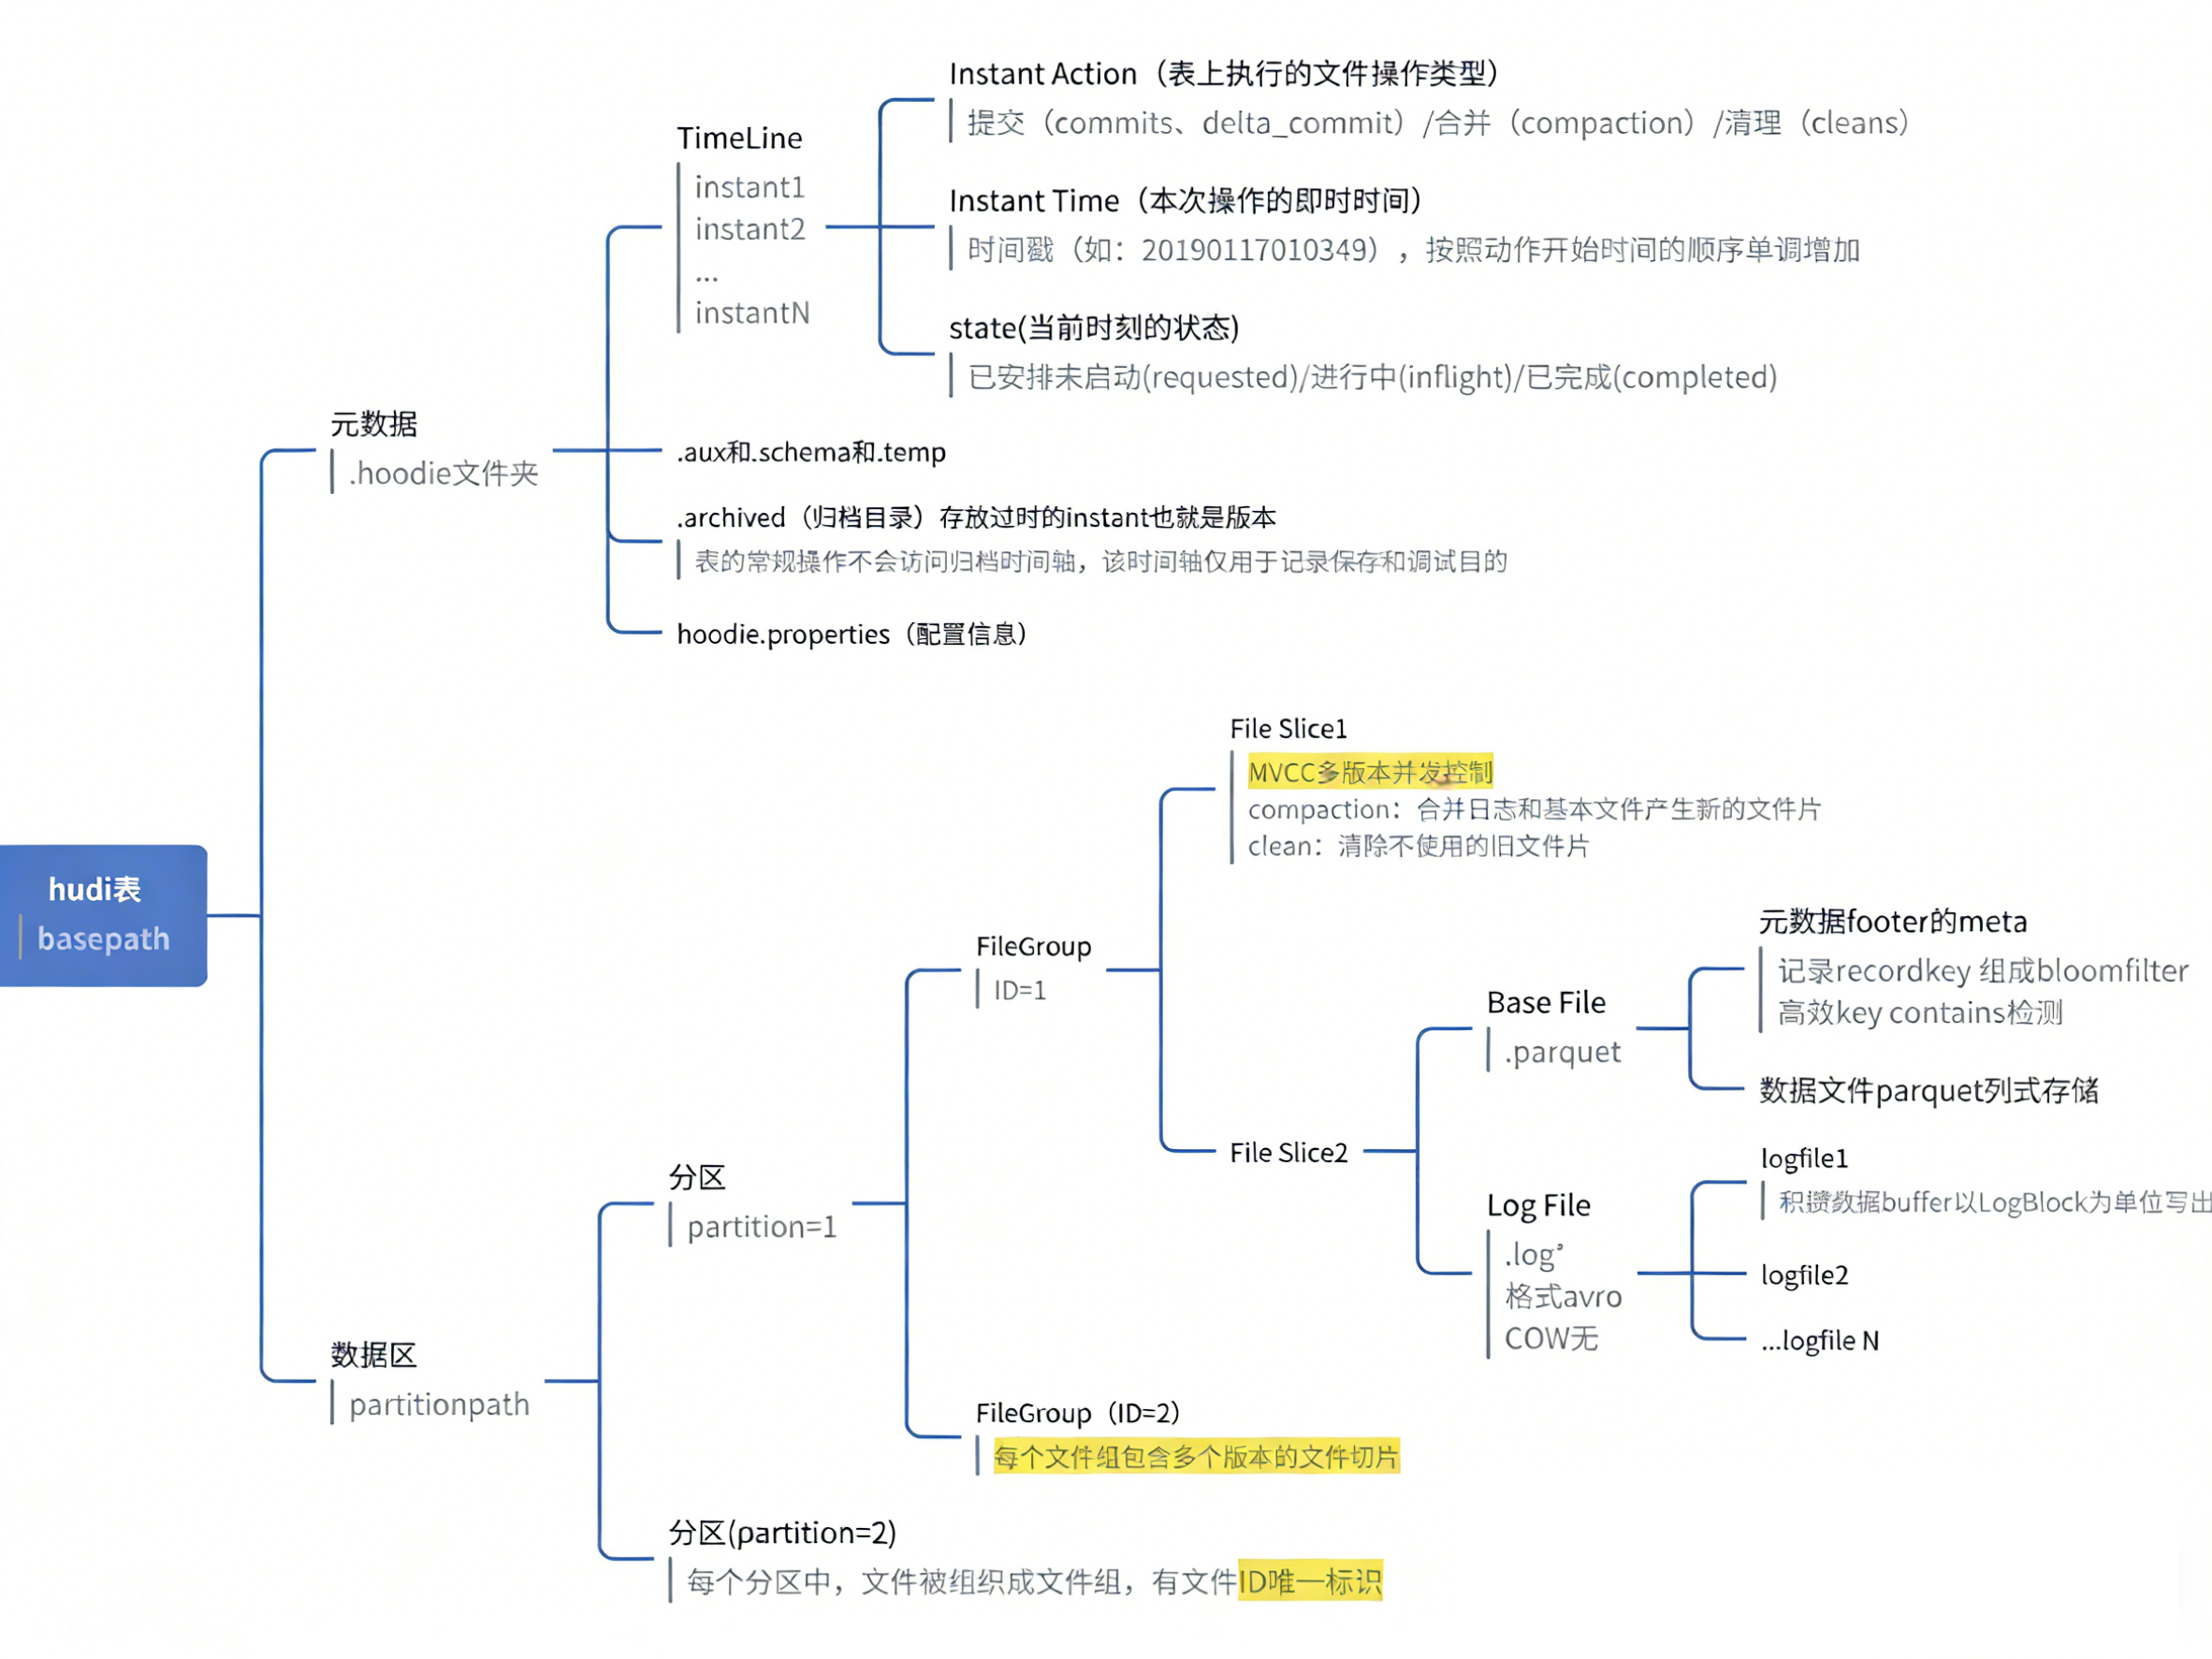
| hudi表 basepath | 元数据 .hoodie文件夹 | TimeLine
|
| |
| .archived (归档目录) | 存放过时的instant也就是版本 表的常规操作不会访问归档时间轴,该时间轴仅用于记录保存和调试目的 | |||
| .aux和.schema和.temp | ||||
| hoodie.properties(配置信息) | ||||
| 数据区 partitionpath | 分区 partition=1 | FileGroup ID=1 |
| |
| ||||
| FileGroup(ID=2) | 每个文件组包含多个版本的文件切片 | |||
| 分区 partition=2 | 每个分区中,文件被组织成文件组,有文件ID唯一标识 | |||
/.hoodie 文件夹下
所有处于请求/进行中状态的操作都以名为<begin_instant_time>.<action_type>.<requested|inflight> 的文件形式存储在活动时间轴中。
已完成的操作连同表示操作完成时间的时间一起存储在名为 <begin_instant_time><completion_instant_time>.<action_type> 的文件中。
每个分区中
数据在物理上以基础文件和日志文件的形式存储,并在逻辑上组织成文件组和文件切片。文件组包含多个版本的文件切片,并被拆分成多个文件切片。文件切片由基础文件和日志文件组成。文件组中的每个文件切片都由创建它的提交时间戳唯一标识。
Hudi中的文件格式结构如下图:
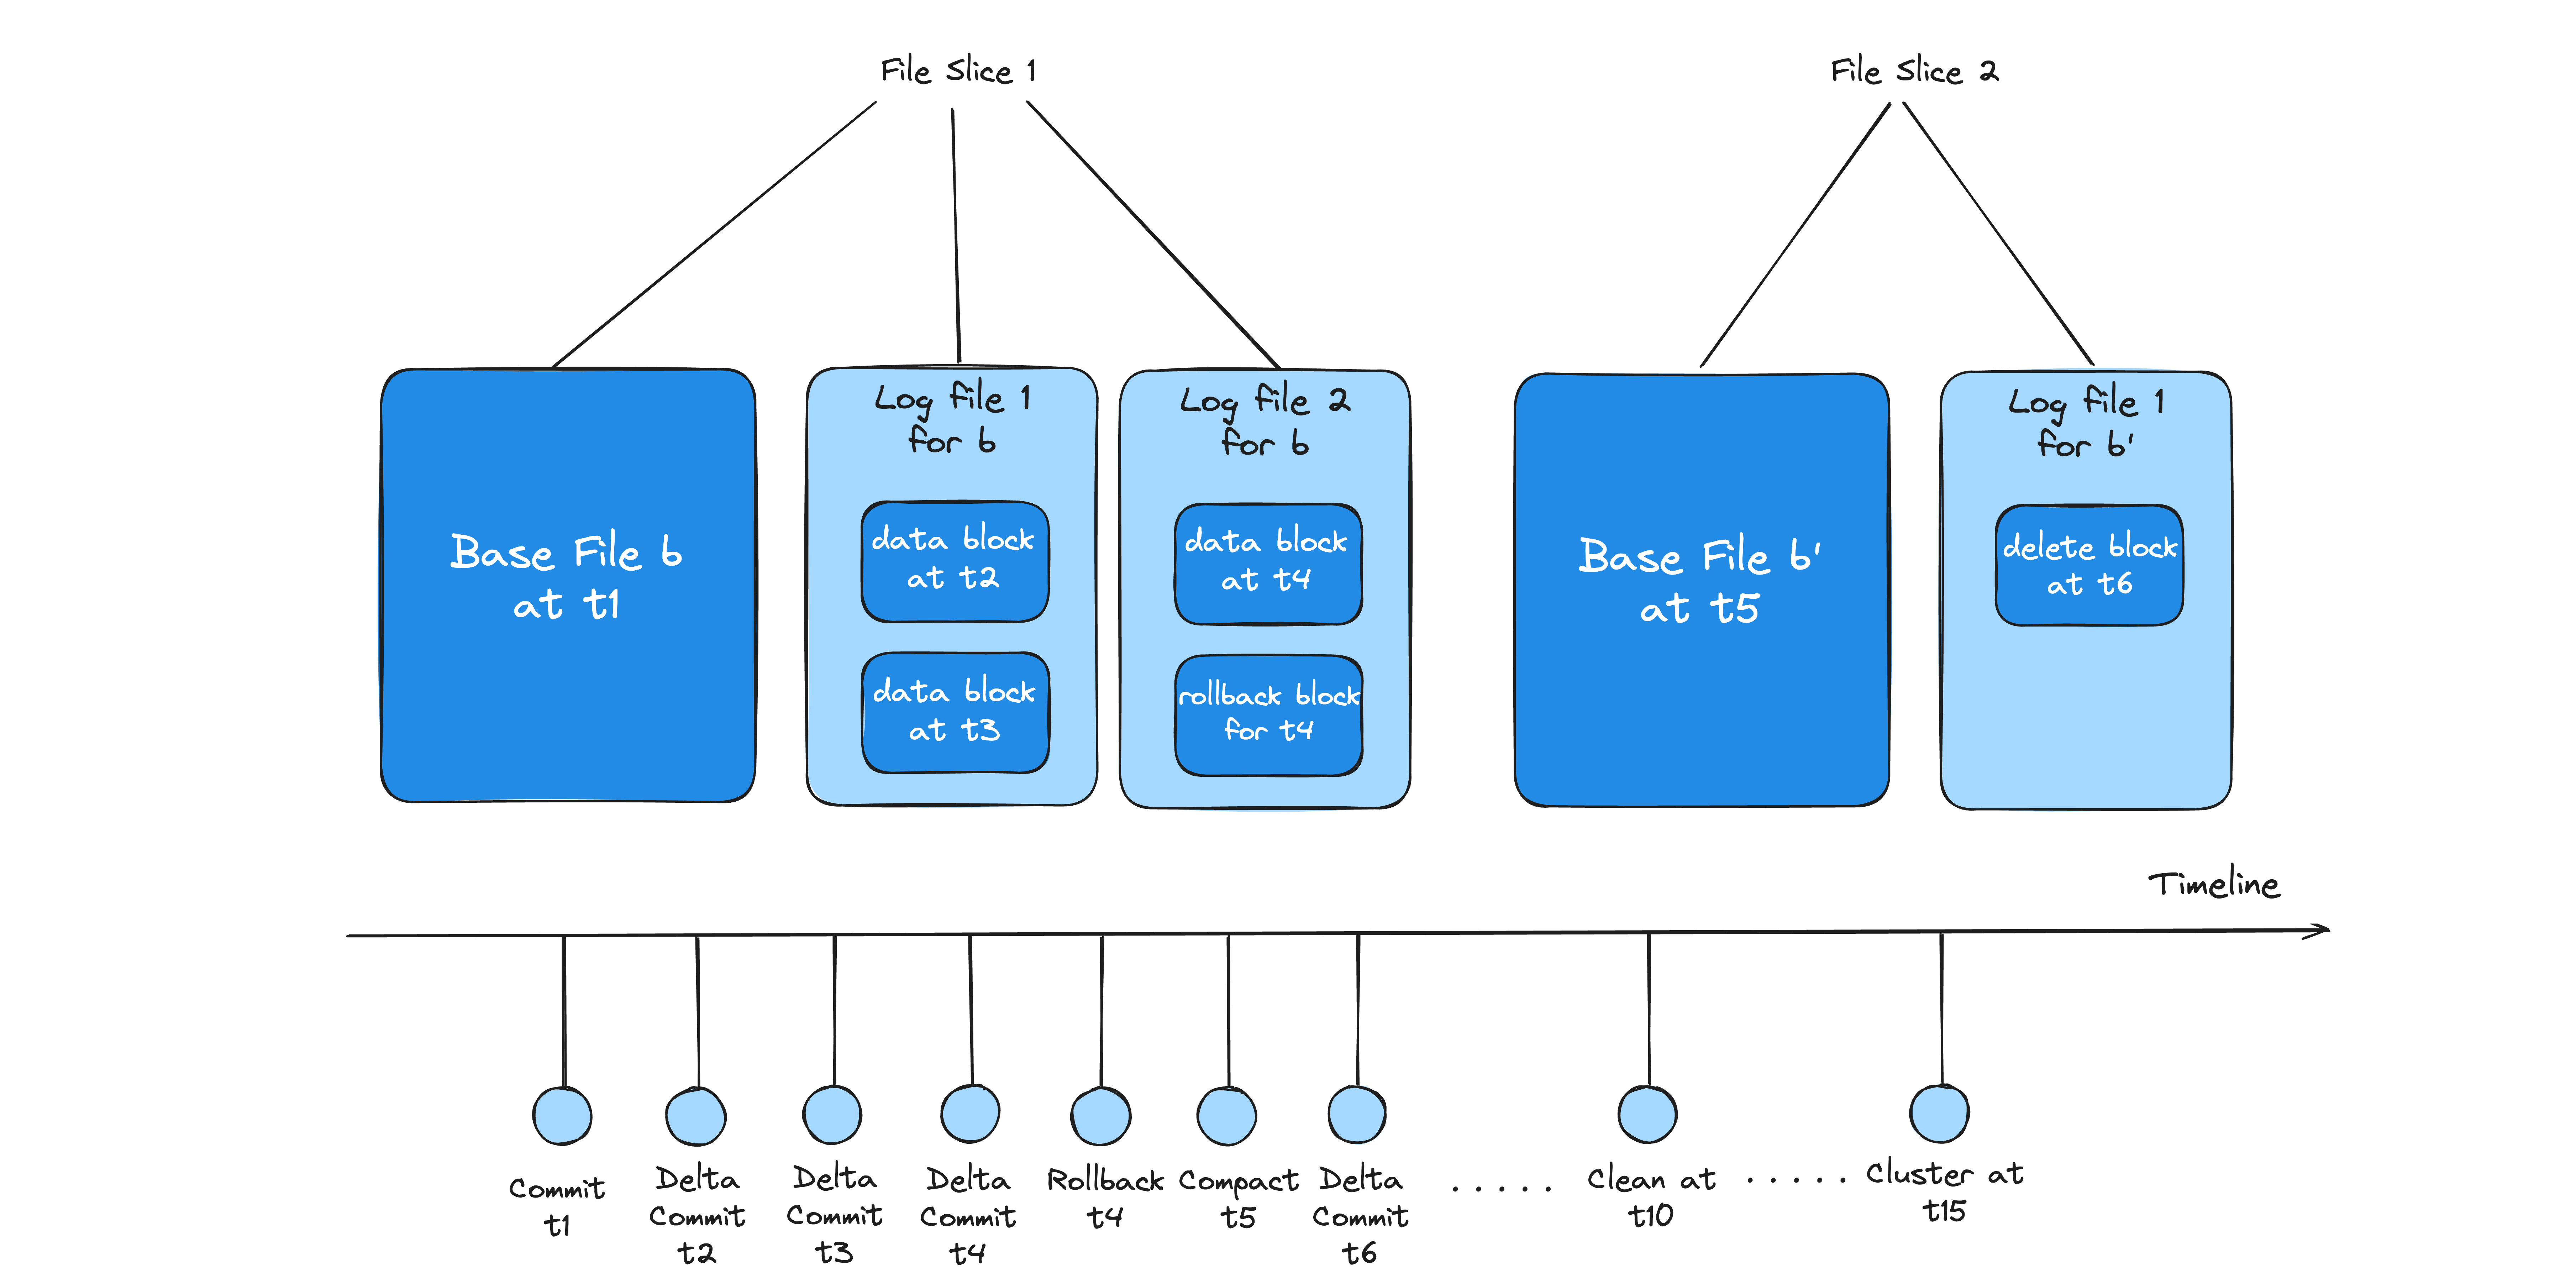
文件命名--4部分组成(parquet/orc/avro)
5eaef46b-f581-41a2-8012-c66f608b3070-0_8-514-118306_20250714133607800.parquet
4.2 索引
Hudi 中的索引增强了查询规划,最大限度地减少了 I/O,加快了响应时间,并以较低的合并成本实现了更快的写入速度。
元数据索引:元数据表中的各种索引,例如文件列表、列统计信息、布隆过滤器、记录级索引和功能索引,以快速生成优化的查询计划并提高读取性能。
其他索引:简单索引、布隆过滤器、HBase 索引和桶索引,能高效地定位包含特定记录键的文件组。
HoodieKey的构成
HoodiKey
① record key 唯一标识一条记录的字段,支持多字段组合
②partition path 分区表,记录所属分区的路径;非分区表,所有文件仍然会存储到一个目录下,通常是“”空字符串/default。
Bucket Index
索引实现之一是Bucket Index,如下图所示。它使用哈希函数将记录分配到存储桶中,每个存储桶对应一个文件组(即一对一映射)。这种简单而有效的设计将键查找的时间复杂度降低到常数时间(即哈希函数计算),从而带来良好的写入性能。
HFile 是一种索引文件格式,支持类似 Map 的键值查找,速度更快。
Hudi维护着一个索引,以支持在记录key存在情况下,将新记录的key快速映射到对应的file id。
COW通过索引机制,无需与整个数据集进行连接操作即可确定需要重写的文件,从而实现快速的upsert/delete操作。MOR给定的基础文件仅需与属于该基础文件的记录的更新进行合并。
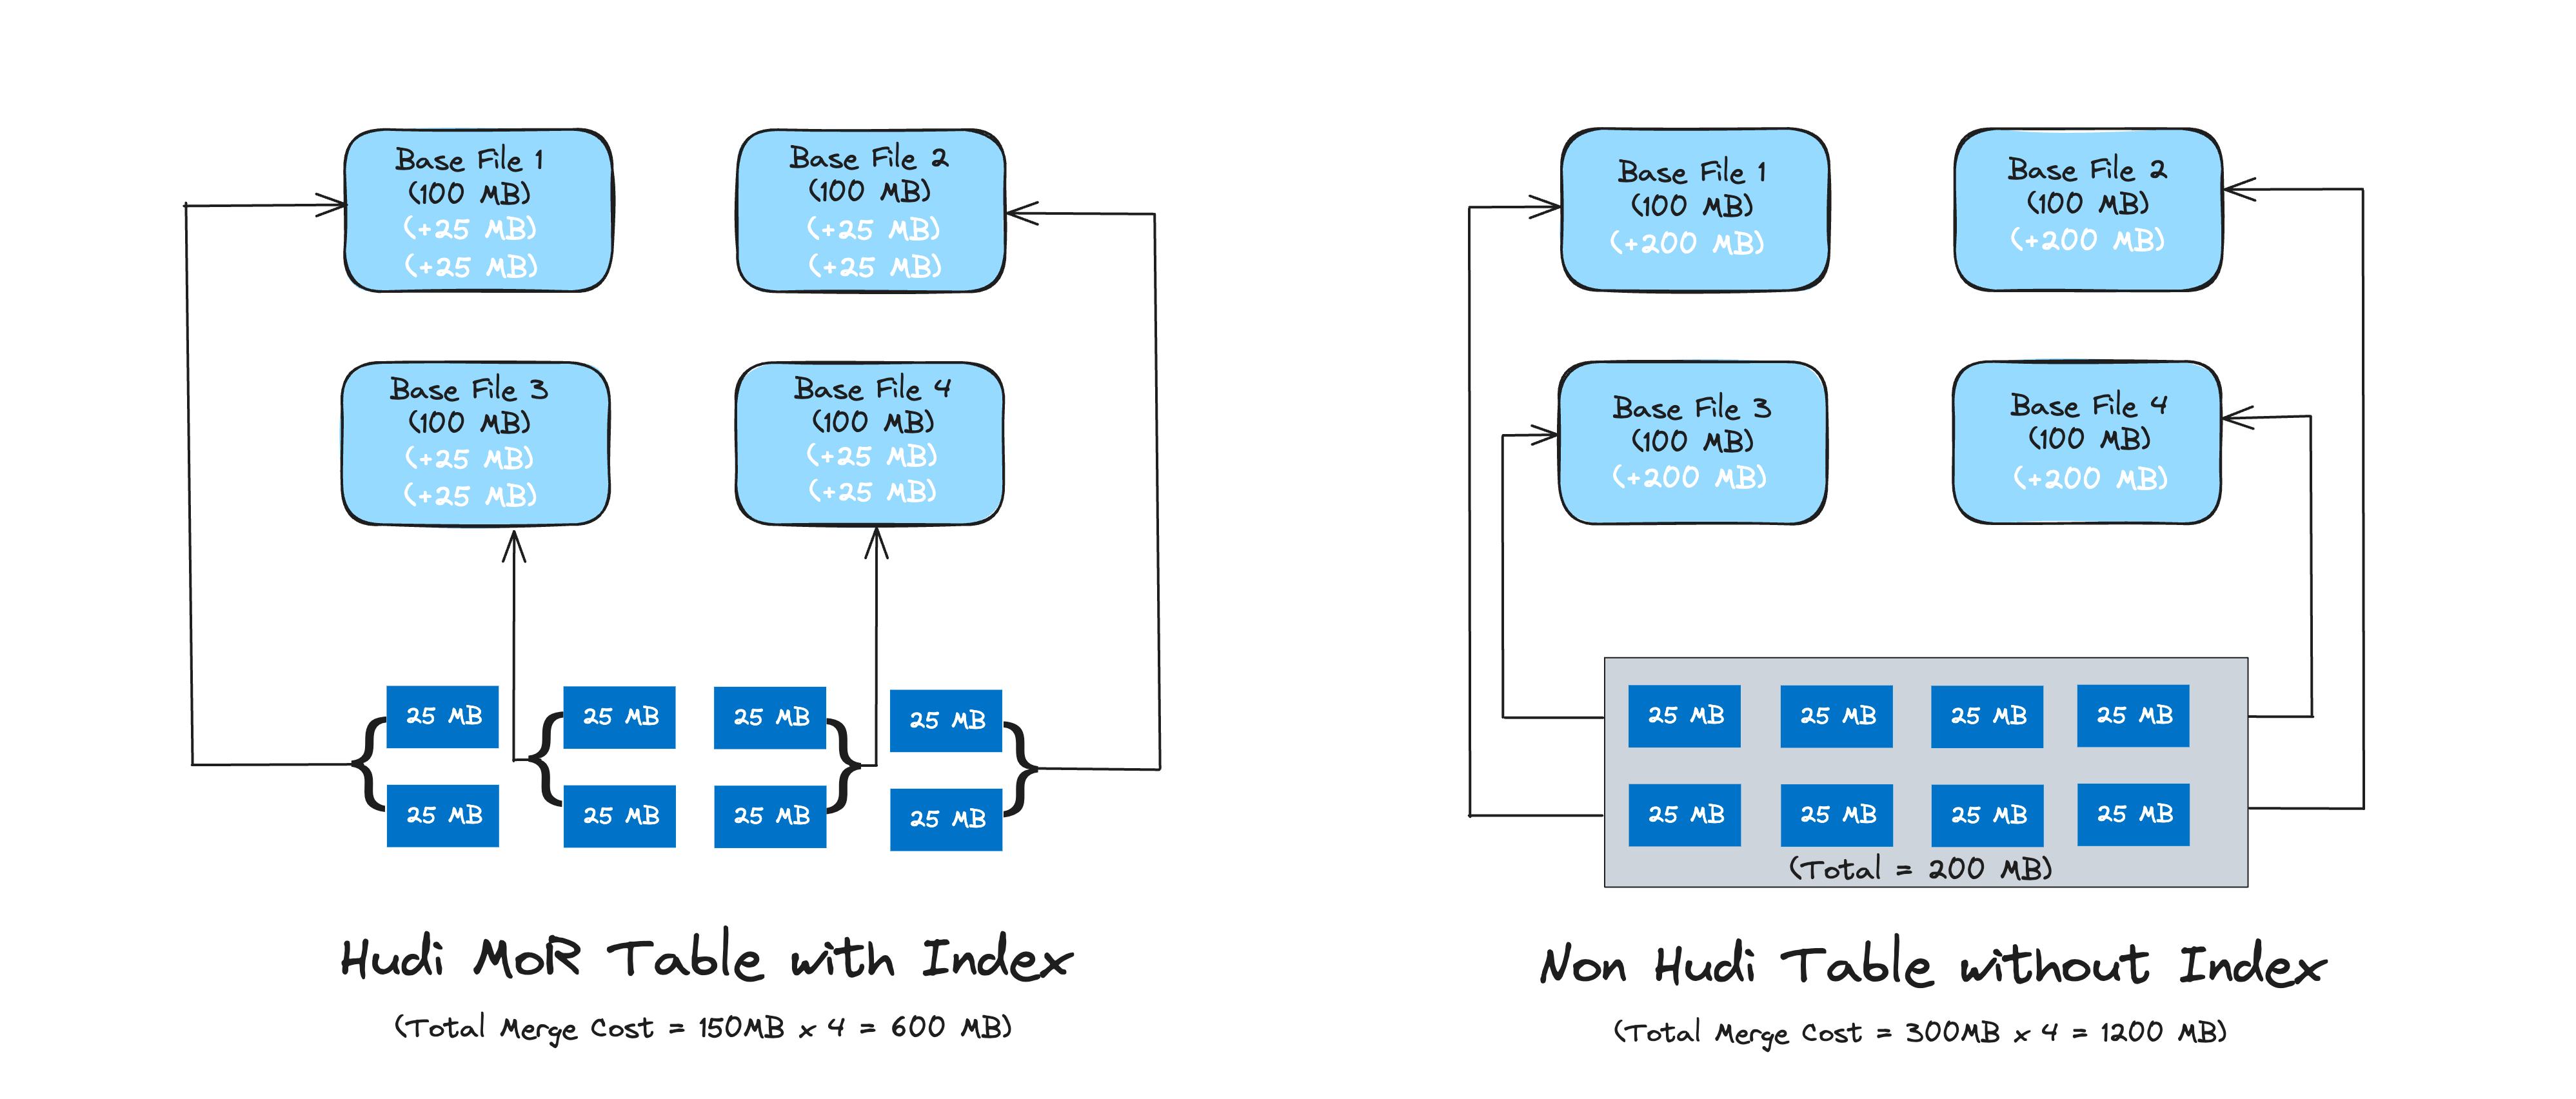
其他索引
-
Bloom filter:存储于数据文件footer。默认选项,不依赖外部系统实现。数据和索引始终保持一致。
-
Apache HBase :可高效查找一小批key。在索引标记期间,此选项可能快几秒钟。
4.3 文件管理(合并)Compaction
Hudi通过TableFileSystemView来抽象管理table对应的数据文件。比如找到所有最新版本的File Slice中的Base file(COW)或base + log file(MOR),通过Timeline和TableFileSystemView的抽象实现了高效便捷的文件查找。
文件合并的过程
1)没有base file:走copy on write insert流程,直接Merge所有的log file并写base file;
2)有base file:走copy on write upsert流程,先读log file建index,在读base file,最后读log file写新的base file。
flink和Spark streaming的writer都可以apply异步的compation策略,按照间隔commits数或者时间来触发compaction任务,在独立的pipeline中执行。
压缩执行流程梳理:ScheduleCompactionActionExecutor.java
-
保证了压缩时间轴范围上的连贯性Option<HoodieCompactionPlan> execute():目标instantTime必须大于所有activecommit时间且小于最小的inflight状态的非compaction的instantTime。确保压缩时还有没有正常写入、清除的动作正在进行。
-
使用HoodieCompactionPlan plan = scheduleCompaction();去获取压缩计划
-
返回一个存放“所有现有的压缩计划的operation 对应的HoodieFileGroupId”的set,Set<HoodieFileGroupId> ,叫做fgIdsInPendingCompactionAndClustering(BaseHoodieCompactionPlanGenerator.java),大概过程就是把上方筛选后的partitionPaths,经过flatmap里的方法处理每一个分区目录。
-
【117行】逻辑是:每个分区目录先转换为其分区区下所有
fileSlice,该分区所有flieSlice在过滤掉其中对应的HoodieFileGroupId已经出现在现存压缩计划operation中的(不在上方fgInPendingCompactionAndClustering里的),可以理解为“先前压缩计划就已经包含了的数据,本次生成压缩计划就不再包含这些”。 -
【120行】在经过map继续处理每一个fileSlice,把每个fileSlice的logfile和baseFile也就是所有log和parquet文件获取到,再构造成一个个新的CompactionOperation。所有新Operation需要再过滤掉其deltaFileNames为空的
-
【117行】List<HoodieCompactionOperation> operations已经获取到【149行】选择合适的压缩计划返回compactionPlan。
-
-
回到【113行】
HoodieCompactionPlan plan = scheduleCompaction();构建一个新的元数据文件 :InstantTime.compaction.request(在.hoodie下),再用
【121行】table.getActiveTimeline().saveToCompactionRequested(compactionInstant, TimelineMetadataUtils.serializeCompactionPlan(plan));把压缩继续写入到该文件里,到此压缩计划就已生成。
五、写/更新流程
5.1 操作分类
| 写操作分类 | 特点 | 适用场景 | 优势 |
|---|---|---|---|
| INSERT(插入) | 跳过index,纯插入模式 | 批量数据初次加载或确定无重复数据 | 高吞吐 |
| UPSERT(更新) | 默认写入模式,通过index快速定位记录是否存在,智能合并更新和插入 | 记录级更新,避免全表扫描 | |
| BULK INSERT(写排序) | 批量插入,适合初始化加载 | 大规模数据初始导入 | 比insert高效 |
5.2 upsert写流程
总结:对updata和delete的支持都非常高效,一条记录的整个生命周期操作都发生在同一个bucket,不仅减少小文件数量,也提升数据读取效率(不必要的join和Merge)。COW 写会一直将一个bucket (FileGroup) 的 base 文件写到设定的阈值大小才会划分新的 bucket; MOR写在同一个 bucket 中,log file 也是一直 append 直到大小超过设定的阈值 roll over。
通过案例认识写流程parquet文件(要修改)读取 -- > 在内存中合并(基本文件+本次新记录)-- > 生成新的文件版本-- >切换元数据指向新文件
-
COW 的 UPSERT 会读取整个
base_file进行合并,但 Hudi 会优化 I/O(利用索引、列存等),更新:覆盖匹配记录(基于主键)。
-
布隆过滤器 (Bloom Filter):
-
如果
base_file有布隆过滤器,Hudi 可快速判断某记录是否存在于文件中,减少 I/O。
-
-
Parquet 列存 + 谓词下推:
-
如果更新只涉及部分字段,Hudi 可能只读取相关列。
-
-
主键索引:
-
如果 Hudi 维护了索引(如
HoodieBloomIndex),可定位记录所在数据页,减少扫描范围。
-
举例:
假设有一个包含100条记录的基文件file1.parquet,现在要更新其中的10条记录:
-
读取
file1.parquet中的100条记录 -
在内存中合并:
-
保留未修改的90条记录
-
用新版本替换10条更新记录
-
-
生成新的
file2.parquet(包含100条记录) -
元数据切换,使查询指向
file2.parquet
Copy On Write类型表,UPSERT 写入流程:
第一步、先对 records 按照 record key 去重;
第二步、首先对这批数据创建索引 (HoodieKey => HoodieRecordLocation);通过索引区分哪些 records 是 update,哪些 records 是 insert(key 第一次写入);
第三步、对于 updata消息,会直接找到对应 key 所在的最新 FileSlice 的 base 文件,并做 merge 后写新的 base file (新的 FileSlice);
第四步、对于 insert 消息,会扫描当前 partition 的所有 SmallFile(小于一定大小的 base file),然后 merge 写新的 FileSlice;如果没有 SmallFile,直接写新的 FileGroup + FileSlice;
Merge On Read类型表,UPSERT 写入流程:
第一步、先对 records 按照 record key 去重(可选)
第二步、首先对这批数据创建索引 (HoodieKey => HoodieRecordLocation);通过索引区分哪些 records 是 update,哪些 records 是 insert(key 第一次写入)
第三步、如果是 insert 消息,如果 log file 不可建索引(默认),会尝试 merge 分区内最小的 base file (不包含 log file 的 FileSlice),生成新的 FileSlice;如果没有 base file 就新写一个 FileGroup + FileSlice + base file;如果 log file 可建索引,尝试 append 小的 log file,如果没有就新写一个 FileGroup + FileSlice + base file
第四步、如果是 update 消息,写对应的 file group + file slice,直接 append 最新的 log file(如果碰巧是当前最小的小文件,会 merge base file,生成新的 file slice)log file 大小达到阈值会 roll over 一个新的
5.3 insert写流程
Copy On Write类型表,INSERT 写入流程:
第一步、先对 records 按照 record key 去重(可选);
第二步、不会创建 Index;
第三步、如果有小的 base file 文件,merge base file,生成新的 FileSlice + base file,否则直接写新的 FileSlice + base file;
Merge On Read类型表,INSERT 写入流程:
第一步、先对 records 按照 record key 去重(可选);
第二步、不会创建 Index;
第三步、如果 log file 可索引,并且有小的 FileSlice,尝试追加或写最新的 log file;如果 log file 不可索引,写一个新的 FileSlice + base file;
5.4 更新原理详解
针对使用Parquet的COW表的更高效HoodieMergeHandler[HUDI-4790] 1.X新特性
说明:Parquet 是一种列式存储格式,所有数据在水平方向上被划分成行组(Row Group),一个行组包含该行组对应区间内所有列的列块(Column Chunk),一个列块由页(Page)组成,页是压缩和编码的单位。
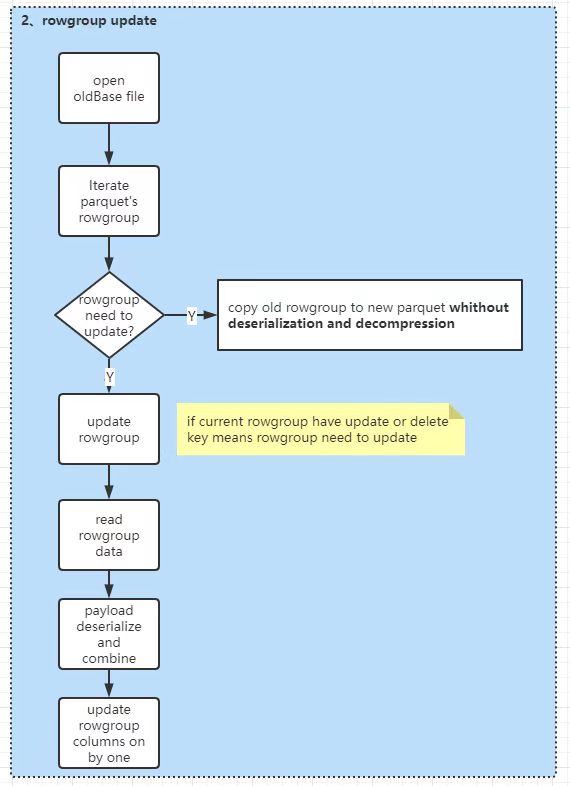
a 'surgery' is introduced, which rebuilds a new parquet from an old one, just copying unchanged rowGroups and overwriting changed rowGroups when updating parquet files.(从旧 parquet 表重建新的 parquet 表,在更新 parquet 文件时,只需复制未更改的 rowGroup 并覆盖已更改的 rowGroup)
知道哪些行组需要更新,甚至知道这些行组中需要更新的列,就可以跳过大量数据的反序列化和解压缩。
5.4.1 部分更新工作原理
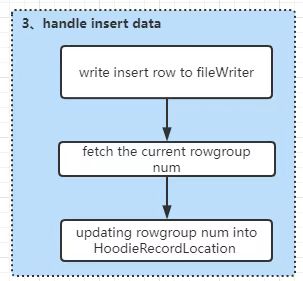
a. 在 HoodieRecordLocation 类中再添加一个成员变量(Integer rowGroupId)。
public class HoodieRecordLocation implements Serializable {
 protected String instantTime;
 protected String fileId;
 /**
 * the index of key in parquet rowGroup num.
 */
 protected Integer rowGroupNum;
 }
b. Parquet 的行组数量从 0 开始不断增加,直到 BlockSize 达到hoodie.parquet.block.size。由于 Parquet 中的每条记录都属于一个行组,我们可以简单地使用 Parquet API 来定位需要写入相应 Parquet 文件的新记录的行组编号,然后将行组编号记录到每个 hoodieRecord 的 hoodieRecordLocation 中。HoodieRecordLocations 将被收集到 WriteStatus 中,并按批次更新到索引中。
c. 在打标签索引阶段,会查询出rowgroup num,以便用来加速文件更新。
upserting具体流程如下:
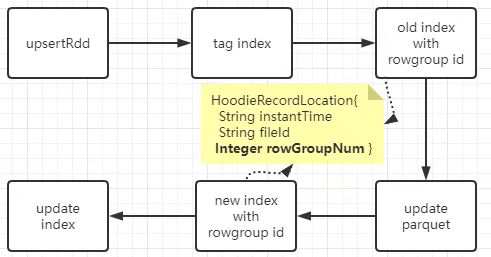
5.4.2 在 Cow 上更新 Parquet 文件的步骤
| 步骤&图解 | 详情 |
|---|---|
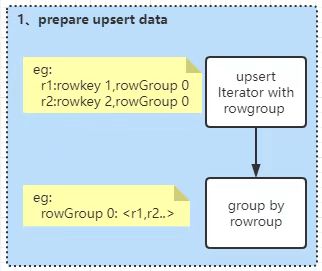
| 第一:数据准备 (更新插入)
| 在标签索引阶段,查找 |
| 第二:行组更新
| 更新rowgroup的过程分为5个步骤。
|
| 第三:插入处理
|
更多推荐



 23
 0
- 0


 已为社区贡献1条内容

所有评论(0)