
wal: max entry size limit exceeded 和 mvcc: database space exceeded
目录标题
这两类常见但容易混淆的 etcd 报错系统地讲清楚:发生机制(原理)、触发条件、定位步骤、修复与预防;最后给一些真实案例参考链接。
1) wal: max entry size limit exceeded
原理(发生在 WAL 层)
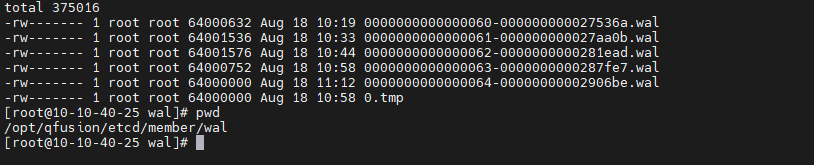
- etcd 把最新的 Raft 事务先顺序写入 WAL 段文件,每个段的目标大小≈ 64MB,到阈值就切段(rotate)。(pkg.go.dev, etcd)
- 当当前 WAL 段剩余空间不足以容纳下一个“记录”(包含数据与校验、对齐填充)时,就会触发 “max entry size limit exceeded”。一些日志里还能看到等式:
entryLimit = fileSize - offset - padBytes,recBytes > entryLimit即报错。(Support Portal) - etcd 还有 “请求大小上限”(
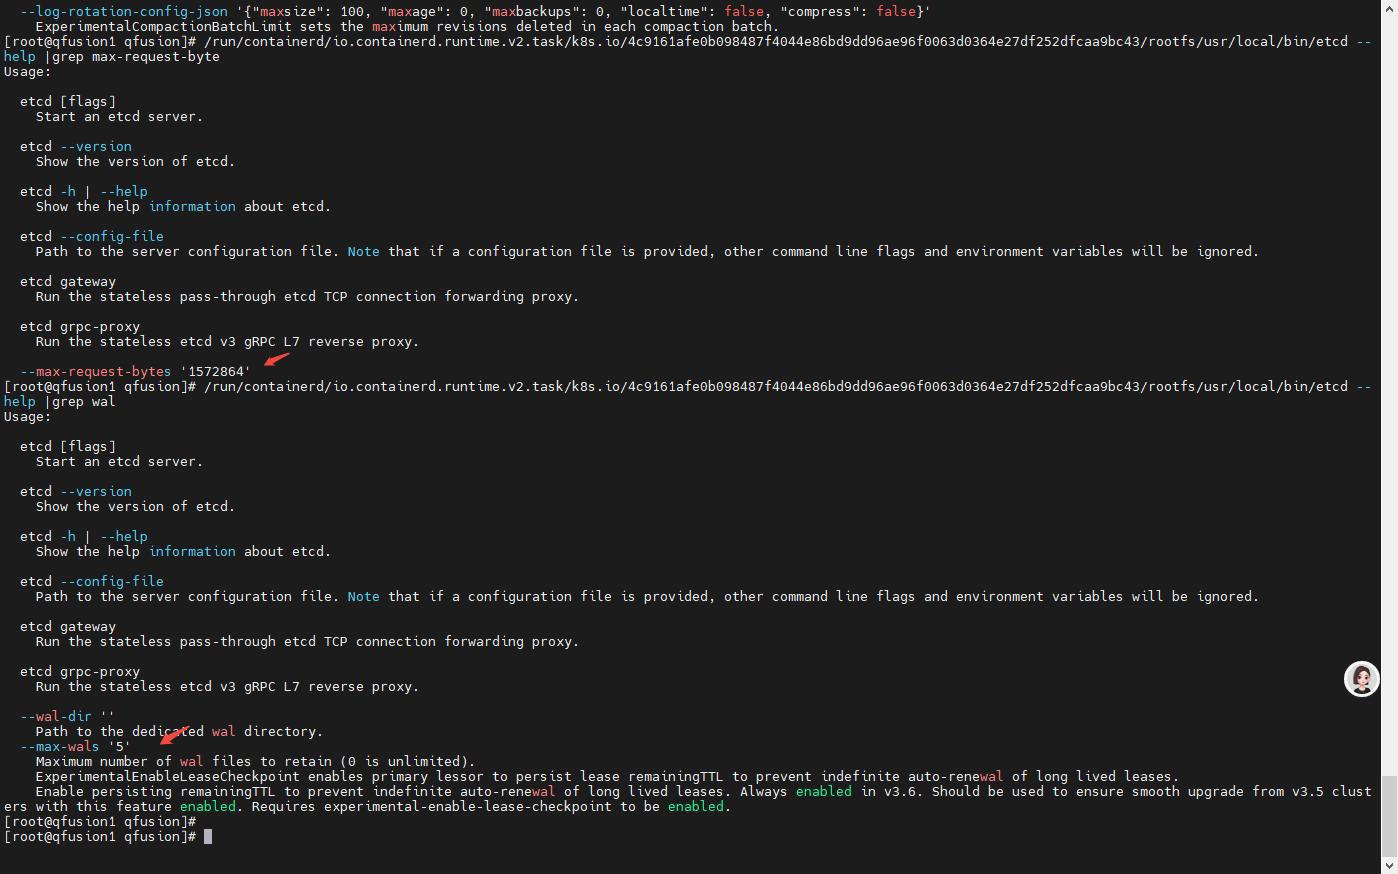
--max-request-bytes,默认 1.5 MiB),它与 WAL 段空间是两个不同维度的限制;请求可以通过,但重启时若曾经写入过超大记录,WAL 解码/重放可能失败并报这个错(社区曾讨论过 WAL 记录硬限制与请求上限不一致导致重启失败的问题)。(etcd, GitHub)
和 2GB 后端数据库配额(见第 2 节)不是一回事。WAL 错来自日志段剩余空间/记录大小,而
mvcc: database space exceeded是后端 DB 配额问题。
常见触发场景
- 单条写入或事务太大(例如大 value、批量事务、过大的 watch 事件批),逼近/超过剩余 WAL 段可用空间。(etcd)
- 调大了
--max-request-bytes(甚至>10MB),运行时能写入;但重启回放 WAL 时因“WAL 单条记录安全上限”而失败。(GitHub) - WAL 轻微损坏或异常关闭,剩余空间/对齐计算与记录大小不匹配。见若干 CrashLoop 案例。(GitHub)
快速排查
- 先确认报错堆栈是否出现在 启动阶段(多见)还是运行时。
- 查看数据目录
member/wal/下最后一个.wal文件大小与 offset;与日志里的entryLimit、recBytes对应。(Support Portal) - 回顾近期是否调大了
--max-request-bytes或出现过超大事务/快照。(etcd)
处理与预防
- 缩小单次请求:限制写入 value/事务大小,必要时把批次拆小;保守使用
--max-request-bytes。(etcd) - 清理/重建有问题的 WAL(高风险操作,仅在无路可走且具备一致性恢复能力时考虑):根据官方文件结构说明,理解 WAL 与快照关系后再做恢复流程;优先从健康副本重新加入替换异常节点。(etcd)
- 避免把 max-request-bytes 调得过大(>10MB 的历史坑点在重启阶段暴露)。(GitHub)
相关案例
- vSphere/Workload 管理集群启动失败,日志直接给出
recBytes、entryLimit的计算细节(最直观)。(Support Portal) - GitHub:etcd 节点 CrashLoop,启动时报
wal: max entry size limit exceeded。(GitHub) - Red Hat OpenShift:成员 CrashLoop,Operator 降级并提示同样报错(需登录查看详情)。(Red Hat Customer Portal)
2) mvcc: database space exceeded
原理(发生在后端 MVCC/boltdb 配额层)
- etcd 后端存储(bbolt)有空间配额:默认 2 GiB,可通过
--quota-backend-bytes调整,官方建议不超过 8 GiB(不是硬上限,但超过会被警告)。(etcd, GitHub) - 当任一成员的后端 DB 超过配额,etcd 触发集群级 NOSPACE 警报,进入“维护模式”:仅允许 读与删,拒绝新的写入,于是客户端看到
etcdserver: mvcc: database space exceeded。(etcd)
为什么会“看起来有盘但 still exceeded”
- 这是逻辑配额而不是磁盘满:哪怕磁盘还有空间,只要 DB 文件超过配额就会触发该错误。(docs.veertu.com)
- 频繁写删会产生大量历史修订版本;即便删了 key,未压实的历史版本仍占空间,导致 DB 文件持续增大。需要压缩(compaction)+ 碎片整理(defrag)。(etcd)
快速定位
-
查看端点状态与告警:
ETCDCTL_API=3 etcdctl --endpoints=<...> endpoint status --write-out=table
ETCDCTL_API=3 etcdctl --endpoints=<...> alarm list
关注
DB Size/DB Size In Use与etcd_server_quota_backend_bytes。(etcd, runbooks.prometheus-operator.dev) -
结合监控:
etcd_mvcc_db_total_size_in_bytes、etcd_mvcc_db_total_size_in_use_in_bytes。(runbooks.prometheus-operator.dev)
立即修复(按风险/影响排序)
-
压缩历史版本(释放逻辑历史):
# 压缩到最新修订或一个安全修订 ETCDCTL_API=3 etcdctl compact <rev>注意:压缩是逻辑操作,不会立刻缩小文件。(etcd)
-
碎片整理(真正回收文件空洞):
ETCDCTL_API=3 etcdctl defrag --cluster建议逐个成员执行,避免同时阻塞。(etcd)
-
临时删除大 key 或缩减写入,让 DB 尽快低于配额(常与上两步配合)。(etcd)
-
提高配额(治标不治本):
仅当确认数据规模确实需要更大容量时再调大--quota-backend-bytes;超过 8 GiB 官方不推荐(虽非硬限制)。(etcd, GitHub)
长期预防
- 开启/校准自动压缩:
--auto-compaction-mode=revision|period,--auto-compaction-retention=<N>。许多“越用越大”案例都是没有压缩造成的。(etcd, GitHub) - 定期 defrag(业务低峰、滚动执行)。(etcd)
- 控制变更噪音:避免把 大量临时/频繁更新数据放进 etcd;对 operator/控制器的热 key 做降噪或 TTL。
- 监控接近配额的告警(如 90%/95% 阈值)。(runbooks.prometheus-operator.dev)
相关案例
- 平台厂商 KB:DB 到 2.1 GB(超过默认 2 GiB)后集群拒绝写,如何恢复。(Platform9)
- 第三方运维笔记(Patroni 场景):通过 compact+defrag 解除
database space exceeded。(dbi services) - Kublr 文档:解释“数据库文件大小 vs 数据卷占用(含 WAL/快照)”。(Kublr Documentation)
- 官方维护指南与“如何排查 DB 变大”的官方博客(强烈建议阅读)。(etcd)
3) 一张表看懂两类错误的差异
| 维度 | wal: max entry size limit exceeded | mvcc: database space exceeded |
|---|---|---|
| 层次 | WAL 段文件(约 64MB/段) | 后端 DB(bbolt) 配额 |
| 典型时机 | 多见于启动回放或写入阶段 | 正常运行中写入被拒 |
| 触发条件 | 当前段剩余空间 < 要写入记录大小(含 pad);或曾写入过超大记录导致回放失败 | DB Size 超过 --quota-backend-bytes(默认 2 GiB;建议≤8 GiB) |
| 集群状态 | 该成员可能 CrashLoop/启动失败 | 进入 NOSPACE 维护模式,仅允许读/删 |
| 快速解法 | 限制单请求大小;避免把 --max-request-bytes 调太大;必要时从健康副本重建 | compact + defrag;必要时删大 key 或谨慎调大配额 |
| 是否和“2 GiB 默认限制”有关 | 无直接关系 | 直接相关 |
(参考:WAL 64MB、请求上限 1.5MiB、配额默认 2 GiB/建议≤8 GiB)(pkg.go.dev, etcd)
参考与案例链接
- 官方:系统限制(请求大小/配额)、维护指南(compact/defrag/NOSPACE)。(etcd)
- 官方:持久化文件结构(WAL≈64MB/段,切段机制)。(etcd)
- 官方博客:如何排查 DB 变大问题(指标、
DB Size In Use、碎片等)。(etcd) - Prometheus Runbook:接近配额 告警与指标说明。(runbooks.prometheus-operator.dev)
- vSphere/Workload 管理:WAL entryLimit/recBytes 报错示例。(Support Portal)
- GitHub Issue:WAL 报错 CrashLoop、请求上限 vs WAL 记录上限 讨论。(GitHub)
- OpenShift 知识库:WAL 报错导致成员 CrashLoop(需登录)。(Red Hat Customer Portal)
- 其它
database space exceeded现场与处理记录(Platform9、Kublr、Veertu)。(Platform9, Kublr Documentation, docs.veertu.com)
如果你愿意提供一段现场日志(尤其是 entryLimit/recBytes 那行)和 endpoint status 输出,我可以把你的环境做成一张“最短修复路径”(按影响/恢复速度排序)的操作单,直接照着执行即可。
字段说明
这几个字段 entryLimit、fileSize、offset、padBytes、recBytes,其实就是 etcd 在写 WAL 日志时的空间检查逻辑,出自 wal 包的实现。
逐个拆开说明它们的含义和关系:
1. fileSize
- 含义:当前 WAL 段文件的目标大小(通常 64 MB)。
- 来源:etcd 默认每个 WAL segment 64 MiB,写满后会 rotate 到新文件。
- 例如:
fileSize=67108864。
2. offset
- 含义:当前写指针在该 WAL 文件中的位置,即写入偏移量。
- 随着记录不断写入,这个值逐渐增加。
- 例如:
offset=67108320表示文件已经写到 64 MB 的末尾附近。
3. padBytes
- 含义:为了保证 页对齐(WAL 日志内部按 8 字节对齐,crc 也需要对齐),可能需要填充的字节数。
- 如果当前偏移不是对齐位置,就会预留一些 padding 空间。
- 例如:
padBytes=16。
4. entryLimit
-
公式:
entryLimit = fileSize - offset - padBytes -
含义:当前 WAL 段剩余可写空间(减去对齐补齐后)。
-
用来判断“下一条记录还能不能写进这个段”。
-
如果一条记录比
entryLimit大,就写不进去,触发报错。 -
例如:
fileSize=64MB,offset=63.99MB,padBytes=16→entryLimit≈528字节。
5. recBytes
- 含义:本次要写入的 WAL 记录大小(含数据、crc 校验、header、padding)。
- etcd 在把一个 Raft entry 封装成 WAL record 时,会计算出
recBytes。 - 例如:
recBytes=16351字节。
6. 报错触发逻辑
if recBytes > entryLimit {
    return error("wal: max entry size limit exceeded")
}
-
例子:
entryLimit=528recBytes=16351
→ 明显超过剩余空间 → 报错wal: max entry size limit exceeded。
直观理解
可以把 WAL 段想象成一本 64MB 的本子:
fileSize= 本子总页数offset= 已经写到第几页padBytes= 为了保证每条记录写在“整页的开头”,需要跳过的空页数entryLimit= 还能写多少页recBytes= 下一条要写的内容页数- 如果要写的内容比剩下的空间大 → 写不进去 → 报错
更多推荐



 30
 0
- 0


 已为社区贡献14条内容

所有评论(0)