
矩阵分解推荐系统
过去几年,推荐系统彻底改变了我们与数字平台互动的方式。从 Netflix 的电影推荐到亚马逊的商品推荐,再到亚马逊的个性化播放列表,这些系统在提升用户参与度和改善整体体验方面发挥着至关重要的作用。
创建推荐系统的方法多种多样,但最常见的两种是基于内容的过滤和协同过滤。基于内容的过滤根据对象本身的特征来推荐元素:例如,经常观看科幻电影的用户会收到相同类型的电影推荐。而协同过滤则基于用户与对象之间的交互,利用了“如果两个人过去有相似的偏好,那么他们将来很可能也会有相似的偏好”这一原则。
协同过滤主要分为两类:
- 基于用户的协同过滤:比较用户,找到具有相似品味的用户。
- 基于项目的协同过滤:比较对象,找到与已经欣赏的对象最相似的对象。
然而,协同过滤的主要问题之一是所谓的稀疏矩阵:在实际数据集中,大多数用户只评估了一小部分可用元素,从而导致交互矩阵中存在许多缺失值。这时,矩阵分解就应运而生了。这种技术可以将用户-商品矩阵分解为两个较小的矩阵,从而降低维度,并更准确地预测缺失值。
在今天的文章中,我们将了解:
- 协同过滤和矩阵分解的具体工作原理。
- 因式分解背后的数学。
- 如何在 Python 中实现这两者。
协同过滤:基础和动机
协同过滤是推荐系统中最常用的技术之一,因为它利用用户与对象之间的交互来预测未来的偏好。其基本思想很简单:如果两个用户过去表达过相似的偏好,那么他们未来很有可能继续保持这种偏好。这种方法在 Netflix、Amazon 和 Spotify 等应用中被广泛使用,在这些应用中,个性化推荐在用户参与度方面发挥着至关重要的作用。
实现协同过滤有两种主要策略:
- 基于用户的协同过滤。这种方法基于用户之间的相似性。如果用户 A 与用户 B 的品味相似,那么系统会向 A 推荐 B 曾经欣赏过但 A 尚未看过的作品。例如,如果两个用户对同一部科幻电影给出了高评分,系统可能会向其中一个用户推荐另一用户也给予高评分但 A 尚未看过的电影。用户之间的相似度度量通常使用欧几里得距离、皮尔逊相关系数或余弦相似度等指标来计算。
2.基于对象的协同过滤。这种方法不是比较用户,而是比较对象。如果两部电影经常被同一用户以相同的方式评分,则认为它们相似,系统可能会将其中一部推荐给看过另一部电影的用户。这种方法在用户数量众多的情况下尤其有用,因为它相对于基于用户的方法降低了计算复杂度。
尽管这些方法很有效,但协同过滤仍面临一些问题:
- 冷启动问题:当新用户或新项目输入系统时,没有足够的数据来生成可靠的推荐。
- 数据稀疏性:在实际数据集中,用户-项目矩阵通常比较稀疏,即包含许多缺失的评估。
- 可扩展性:大规模地比较用户和项目通常在计算上是繁重的。
为了解决这些问题,我们使用了矩阵分解技术,通过分解用户-项目矩阵,即使面对稀疏数据,也能实现更准确、更有效的预测。
矩阵分解简介
传统的协同过滤,无论是基于用户还是基于对象,由于稀疏矩阵和可扩展性问题,在高维数据集上效率低下。一种解决方案是矩阵分解 (MF),这项技术可以降低问题的维数并提高预测的准确性。这种方法因Netflix 奖竞赛而广受欢迎,每个获奖团队都成功地运用矩阵分解来提高其推荐系统的精度。
矩阵分解的基本思想是将用户-项目矩阵分解为两个较小的矩阵,分别表示未明确定义特征的潜在空间中的用户和项目。假设我们有一个矩阵R,其中每一行代表一个用户,每一列代表一个项目(电影、产品、歌曲等),矩阵的元素包含用户对各个项目的评分。矩阵分解将R分解为两个矩阵:
- U(用户矩阵):该矩阵的每一行代表一个用户,每一列都是一个潜在因素,即描述用户偏好的隐藏特征。
- V(项目矩阵):矩阵中每一行代表一个项目,每一列都是一个潜在因素,代表该项目的特征。
这两个矩阵的乘积近似于原始矩阵:

在哪里:
- U的维度为m × k(m 个用户,k 个潜在因素)。
- V 的维度为n × k(n 个项目,k 个潜在因素)。
- R的维度为m × n。
U和V的值是通过优化 过程学习而来的,该过程旨在最小化观测值与预测值之间的误差。通常使用奇异值分解 (SVD)和交替最小二乘 (ALS)等技术来实现此目的。
矩阵分解特别有效,因为与传统的协同过滤不同,它允许我们甚至为交互很少的用户和项目(冷启动问题)生成建议,从而提高系统的预测能力。
如上所述,基于协同过滤的推荐系统的主要问题之一是稀疏数据的存在。在大多数情况下,用户仅与一小部分可用对象进行交互,从而在用户-项目矩阵中留下许多空单元格。矩阵分解是一种有助于解决此问题的技术,它使模型能够学习用户和项目之间的潜在关系,并进行更准确的预测。
稀疏矩阵问题
在实际数据集中,用户-项目矩阵极其不完整:例如,在电影推荐系统中,用户可能只对 10 万部影片中的 20 部进行了评分。这使得基于相似度的传统协同过滤方法难以应用。矩阵分解通过将矩阵分解为两个降维子矩阵来应对这一挑战,这两个子矩阵分别代表潜在特征空间中的用户和项目。
目标函数和正则化
为了学习U和V矩阵,我们使用数值优化方法,通常最小化预测值和观察值之间的损失函数。
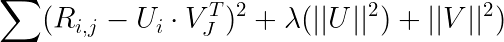
期限
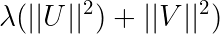
是一个正则化因子,有助于避免过度拟合的问题,即模型对训练数据适应得太好了,但很大程度上无法推广到新用户或新项目的风险。
该技术是许多先进推荐系统的基础,代表了对传统方法的一次关键革命。
MovieLens 100K是推荐系统评估中最常用的数据集之一。它由GroupLens Research 发布,包含 943 位用户对 1,682 部电影的 100,000 条评分,评分范围从 1 星到 5 星。该数据集非常适合测试协同过滤和矩阵分解算法,因为它具有真实数据集的典型特征,例如稀疏矩阵和评分的非均匀分布。
该数据集已集成到 Surprise 库中,从而简化了其使用。我们可以非常轻松地加载它并将其划分为训练集和测试集:
from surprise导入数据集
from surprise.model_selection导入train_test_split

# 加载 MovieLens 100k 数据集
data = Dataset.load_builtin( 'ml-100k' )

# 划分为训练集和测试集
trainset, testset = train_test_split(data, test_size= 0.2 )
如果我们想将数据集作为 Pandas 的 DataFrame 进行分析,我们可以手动加载它:
import pandas as pd

# 将数据转换为 DataFrame
 df = pd.read_csv( 'http://files.grouplens.org/datasets/movielens/ml-100k/u.data' ,
                 sep= '\t' , names=[ 'UserID' , 'MovieID' , 'Rating' , 'Timestamp' ])

# 可视化数据集的右侧
print (df.head())

>>>

   UserID MovieID Rating Timestamp
0      196       242        3   881250949
1      186       302        3   891717742
2       22       377        1   878887116
3      244        51        2   880606923
4 166 346 1 886397596在探索了MovieLens 100k数据集之后,我们可以开始实现基于矩阵分解的推荐系统。我们将使用Surprise库中的奇异值分解 (SVD)算法,该算法将用户-商品矩阵分解为两个潜在因子矩阵,从而预测缺失的评分。
在我们开始之前,让我们导入必要的库:
<span style="background-color:#f9f9f9"><span style="color:#242424"><span style="color:#aa0d91">从</span>surprise<span style="color:#aa0d91">导入</span>SVD,数据集,准确率</span></span>训练 SVD 模型
现在我们可以使用 SVD 模型应用矩阵分解:
# 创建 SVD 模型,并包含 50 个延迟和调整
model = SVD(n_factors= 50 , reg_all= 0.02 )

# 添加模型
model.fit(trainset)超参数n_factors=50表示潜在因子的数量,而reg_all=0.02是防止过度拟合的正则化系数。
模型评估
为了评估预测的准确性,我们计算测试集的均方根误差:
# Generazione delle predizioni sul 测试集
Predictions = model.test(testset)

# Calcolo dell'errore RMSE
 rmse = precision.rmse(predictions)
print ( f'RMSE del modello: {rmse} ' )

>>>

RMSE: 0.9271
 RMSE del modello: 0.9271033421188378
RMSE 值越低,表示预测用户评分的准确率越高。
生成个性化推荐
我们现在可以预测特定用户对特定电影的评分:
# 根据 l'utente 196 和 il film 242 进行评估
pred = model.predict(uid= 196 , iid= 242 )
print ( f"Valutazione prevista: {pred.est} " )

>>>

Valutazione prevista: 3.5273875
这使我们能够根据用户的喜好向他推荐电影。
模型优化
在基于矩阵分解和奇异值分解(SVD) 模型实现推荐系统之后,下一步就是对其进行优化,以提高其准确性。优化可以通过调节超参数、选择替代方法以及整合策略来实现,以减少过拟合和可扩展性等常见问题。
超参数的调节
SVD 模型有各种影响性能的参数,其中包括:
n_factors:潜在因子的数量(潜在空间的维度)。reg_all:避免过度拟合的正则化系数。lr_all:梯度下降的学习率。n_epochs:算法的迭代次数。
我们可以使用网格搜索来找到最佳组合:
from surprise.model_selection import GridSearchCV #参数网格定义param_grid = { 'n_factors' : [ 20 , 50 , 100 ], 'reg_all' : [ 0.01 , 0.02 , 0.05 ], 'lr_all' : [ 0.002 , 0.005 , 0.01 ] } # 搜索最佳参数gs = GridSearchCV(SVD, param_grid, measures=[ 'rmse' ], cv= 3 ) gs.fit(Dataset.load_builtin( 'ml-100k' )) # 选择最佳参数print (gs.best_params[ 'rmse' ]) >>> { 'n_factors' : 50 , ‘reg_all’:0.05,‘lr_all’:0.01 }
该策略使我们能够自动选择最小化 RMSE 损失的参数。
替代方案:交替最小二乘法(ALS)
矩阵分解的另一种有效方法是交替最小二乘法 (ALS)。它对于高维数据集特别有用。与 SVD 不同,ALS 将问题分解为更小的子问题,从而允许我们分别更新用户矩阵和商品矩阵。
在 Python 中,ALS 可在隐含于大型数据集的库中使用:
从scipy.sparse导入csr_matrix
导入numpy作为np

user_ids = []
item_ids = []
ratings = []

for uid, iid, ratings in trainset.all_ratings():
    user_ids.append(uid)
    item_ids.append(iid)
    ratings.append(rating)

# 创建 CSR 矩阵
num_users = trainset.n_users
num_items = trainset.n_items
train_matrix = csr_matrix((ratings, (user_ids, item_ids)), shape=(num_users, num_items))

# 或者可以传递隐式 ALS 模型
model.fit(train_matrix)

>>>

100 %|██████████| 15 / 15 [ 00 : 00 < 00 : 00 , 113.87它/秒]
ALS 对于可扩展的推荐系统很有用,例如拥有数百万用户的大公司。
改进模型的策略
除了调节超参数和使用替代算法之外,还有其他优化推荐系统的策略。
- 过滤掉不活跃的用户:删除只有少量配给的用户可以提高推荐的质量。
- 协作方法与基于内容的方法相结合:将协作过滤与电影内容文本/元数据相结合可以改善预测。
- 模型的动态更新:定期重新训练模型以使其适应新数据。
在使用矩阵分解实现和优化推荐系统之后,可以探索高级扩展和实际应用到现实生活中。
在下一节中,我们将了解矩阵分解的其他技术、将模型集成到现实生活中的策略以及仍将面临的挑战。
矩阵分解的其他算法
除了奇异值分解之外,矩阵分解还有其他技术,具有特定优势:
- 交替最小二乘法(ALS)
- 由于其计算效率,适用于高维数据集
- Spotify 和 LinkedIn 等平台使用它来推荐内容
- 在Apache Spark MLib中实现可扩展系统
2.概率矩阵分解(PMF):
- 使用贝叶斯概率方法扩展 SVD ,改进对非常稀疏数据集的预测
- 用于数据不确定性非常高的应用
3.神经矩阵分解(NeuMF):
- 将深度学习与协同过滤相结合,以创建更准确的推荐系统
- 用于电子商务和社交媒体等高级应用。
概括
在本文中,我们探讨了基于矩阵分解的推荐系统的功能,分析了协同过滤的基本技术,并用SVD(奇异值分解)实现了一个实用模型。
我们首先介绍了推荐系统的概念、它 在数字服务中的应用,以及基于用户和对象相似性的主要方法。随后,我们深入探讨了矩阵分解,它能够降低用户-物品矩阵的维数并预测缺失信息。
从实践角度来看,我们使用了MovieLens 100K 数据集,它是测试推荐算法的理想基准。我们加载并分析了数据,使用Surprise库实现了 SVD 模型,并使用 RMSE 指标评估了性能。最后,我们探索了优化模型的策略,例如使用GridSearch搜索超参数,以及使用ALS和概率矩阵分解等替代方法。
更多推荐



 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)