
数据结构——链表:一文彻底吃透链表底层原理!
目录
1.链表的引出
在学习线性表 ArrayList 后,有这么两个疑问:
- ArrayList 底层是连续的空间,任意插入或删除一个元素时都需要将整个数组进行大量移动,有没有一种方法在不需要移动的情况下就可以完成这个操作?
- 数组满时需要扩容,但是当数组比较大时,如果以 2 被扩容或者 1.5 倍扩容,而这时候只需一个或几个位置插入元素,剩下的空间是没有元素的,会造成空间在一定程度上的消耗,这个问题怎么解决呢?
这也说明了 ArrayList 不适合做任意位置的插入和删除比较多的场景 。
为了解决这个问题,就需要用到 LinkedList ,也就是链表结构。
2. 链表的概念及结构
2.1 链表的概念
链表是线性表的一种链式存储实现方式,它们在逻辑结构上都属于线性表,只是物理存储方式不同。链表的存储结构在物理上是非连续的,数据元素的逻辑顺序是通过链表中的引用链接次序来实现。
比如,大家熟知的老鹰捉小鸡的游戏中母鸡和小鸡就可以看成一条链,还有火车的相互连接车厢等。
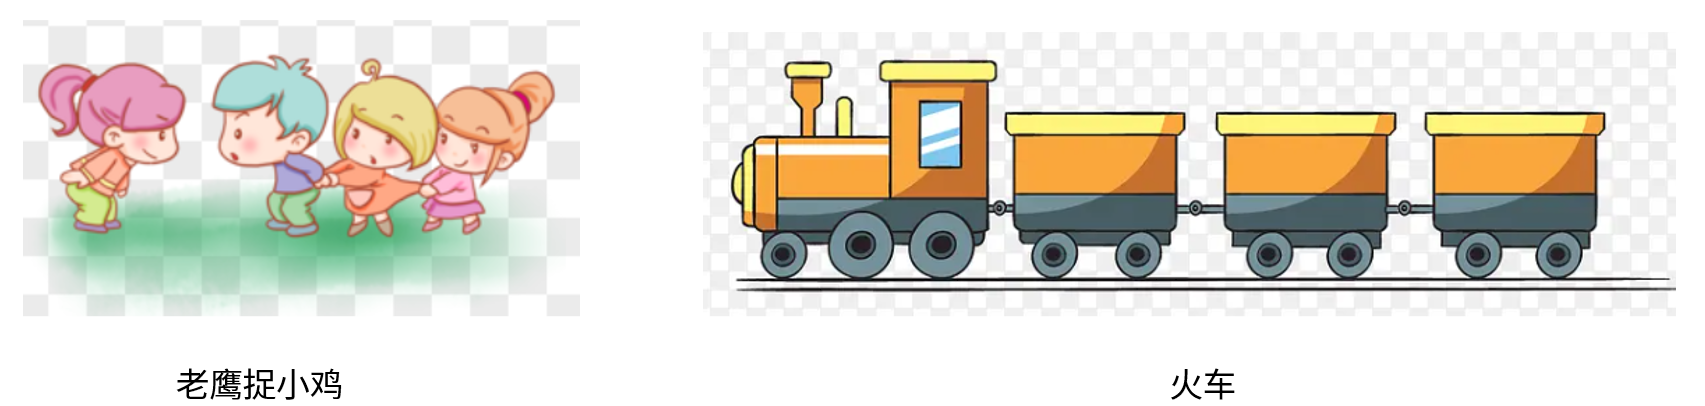
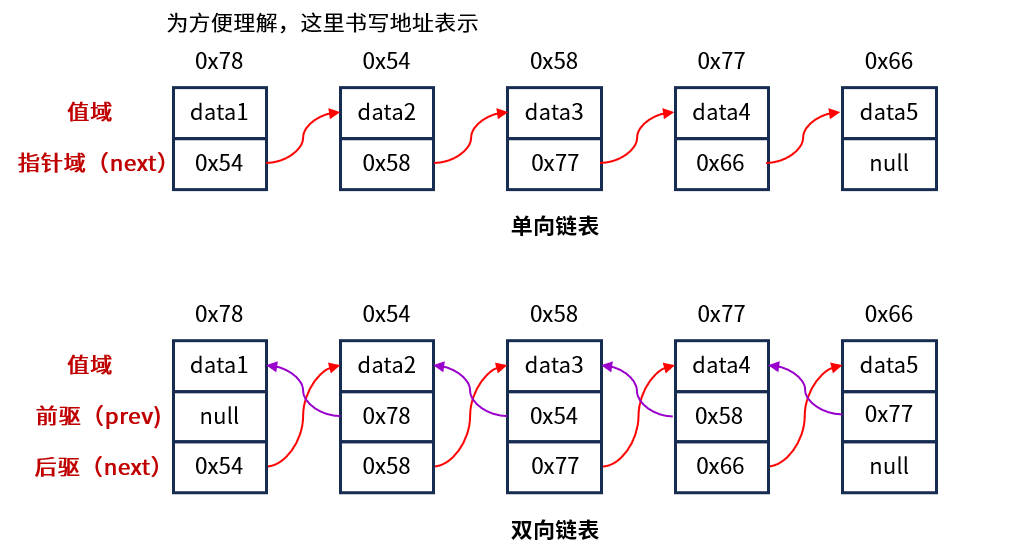
链表的节点可以形象理解为每一个火车的车厢,链表可以分为单向链表和双线链表,链表每个节点都有拥有一个值域,值域用来存放该节点的值,但是单向链表只有一个指针域(只有后驱 next 没有前驱),指针域用来指向下一节点的位置,而双向链表有两个指针域(前驱节点
prev.和后继节点next),前驱节点用来指向上一节点的位置,后驱节点用来指向下一节点的位置。
2.2 链表的分类
上面提到,链表可以分为单向链表和双向链表,在此基础可以分为带头和不带头的链表以及循环和非循环的链表,这些组合起来一共有 8 种链表结构。
1. 带头链表
普通链表(不带头):头指针
head直接指向第一个数据节点。
如果链表为空,
head = null。插入/删除头节点时,需要特殊处理
head指针。带头链表:头指针
head指向一个 不存储实际数据的哑节点(Dummy Node),真正的数据从head.next开始。
即使链表为空,
head也指向哑节点(head.next = null)。插入/删除操作无需单独处理
head指针。
2. 循环链表是一种特殊的链表,其最后一个节点的指针(
next)不再指向null,而是指向链表的头节点(或某一个节点),形成一个闭环。
虽然链表结构种类很多,但只需要掌握最基础的单向链表和双向链表就可以理解其他的链表结构。下面是分别是单向链表和双向链表主要常用方法的实现(便于理解,这里未实现泛型形式),主要从增删查改四个方面来理解,实现这些主要方法的目的不是去背诵它们的具体实现,而是通过方法的实现来理解链表的底层逻辑。
3. 单向链表的实现
3.1 定义内部类
首先定义一个内部类,用来说明节点的值和指针域,并提供构造方法。
public class MySingleLinkedList{
    //定义一个内部类
    public class ListNode{
        public int value;//值
        public ListNode next;// 指向下一个节点的指针
        //提供值域的构造方法,默认next为null
        public ListNode(int value) {
            this.value = value;
        }
    }
    public ListNode head;//定义头节点
    //遍历单链表
    public void display() {
        ListNode cur = head;
        while (cur != null) {
            System.out.print(cur.value + " ");
            cur = cur.next;
        }
        System.out.println();
    }
}
3.2 增
单向链表节点的插入可以分为头插、尾插和指定位置插入。链表的插入和顺便表的插入不同,顺序表的插入需要遍历整个数组然后大量地移动元素才可以插入,但是链表并不需要,只需要改变链表中节点的指向就可以插入元素。
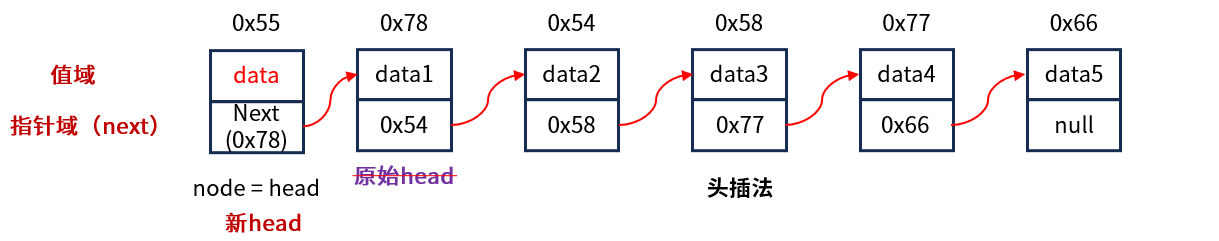
1. 头插法 addFirst(int data) :针对头插法,并不需要判断头节点是否为空,因为要插入的节点会称为新链表的头节点,所以只需改变头节点的指针域指向需要插入的元素(假设未node节点)即可,然后更新头节点的指向,即 node.next = head,head = node。
    //头插法
    public void addFirst(int data) {
        ListNode node = new ListNode(data);
        node.next = head;
        head = node;
    }
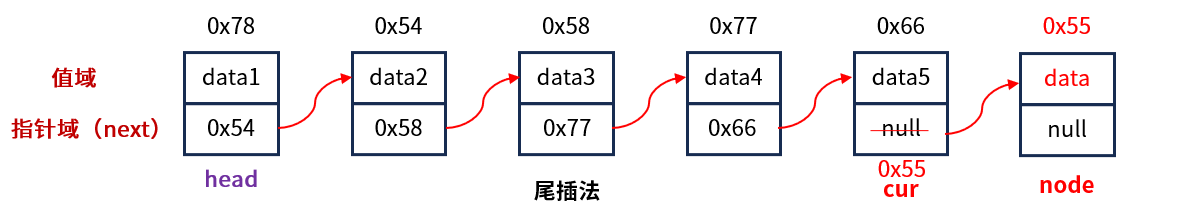
2. 尾插法 addLast(int data) :针对尾插法,需要先判断头节点是否为空,如果头节点为空,则与头插法相似,只需改变头节点的指针域指向需要插入的元素(假设未 node 节点)即可,然后更新头节点的指向,即 node.next = head,head = node。如果头节点不为空,就需要借助一个变量节点(假设为 cur)从头节点遍历整个链表(不能用头节点 head 来遍历 ,否则插入后无法获得该链表的头节点)直到找到某一节点的指针域是空为止,此时所处的位置就是最后一个节点,遍历的条件就是 cur.next != null ,当不满足这个条件后,说明此时的节点就是最后一个节点,当找到这个节点后,只需让这个节点的指针域指向新插入的节点(node)即可完成操作,即 cur.next = node。
    //尾插法
    public void addLast(int data) {
        ListNode node = new ListNode(data);
        if (head == null) {
            head = node;
            return;
        }
        ListNode cur = head;
        while (cur.next != null) {
            cur = cur.next;
        }
        cur.next = node;
    }
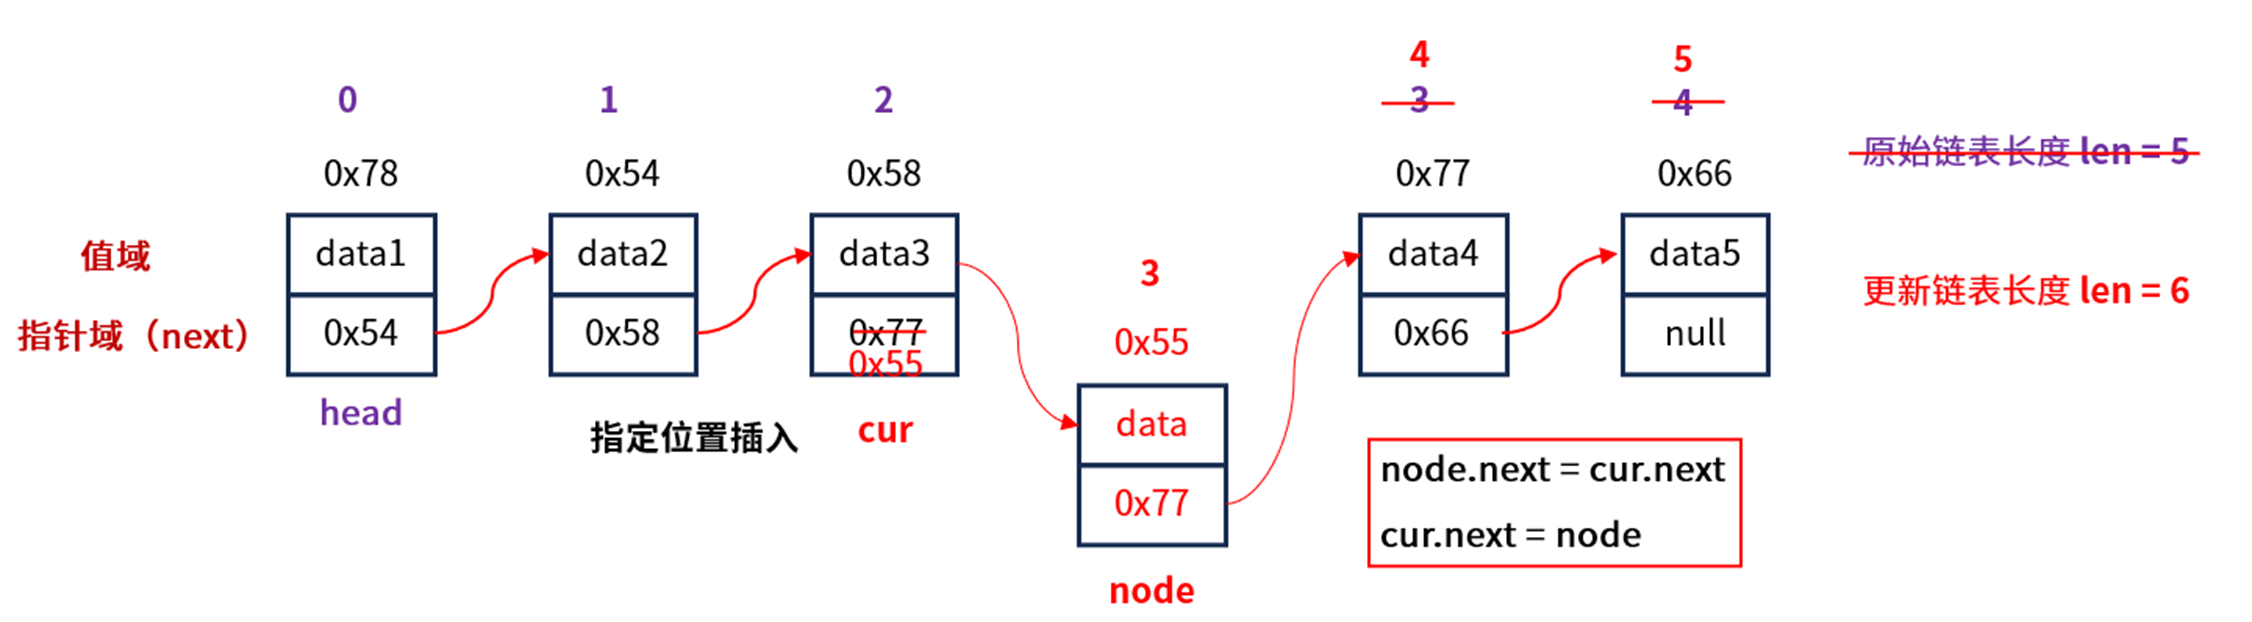
3. 指定位置插入 addIndex(int index , int data) :针对指定位置插入,第一步要先判断指定的位置(index)是否合法,次数就需要求得链表的长度,用到的方法是 size(),假设这个长度是 len,当位置(index)小于0或者大于链表的长度 len 时,是不可能成功插入的 (对于边界,也可以自定义一个异常类的 java 文件),当 index == 0(链表下标和数组一样,都是从0开始),就属于头插法,同理,index == len 时,就属于尾插法。链表的插入不像顺序表一样需要大量移动元素,但是链表也并不像顺序一样支持随机访问,所以接下来的第二步便是找到 index 的前一个位置,假设index = 3,则需要找到 len = 2 的位置节点 cur,然后然这个 cur 节点的指针域指向新增的节点 node ,再让 node 指向原本属于 len 的下一节点,就可以完成这个插入的操作。需要注意的时,所有节点的插入,都需要先绑定后边再绑定前边,也就是说要先进行 node 和下一节点的绑定,再进行 cur 和 node 的绑定,即 node.next = cur.next,cur.next = node。
//自定义异常类
public class BoundaryException extends RuntimeException{
    public BoundaryException(String message) {
        super(message);
    }
}
//指定位置插入
public void addIndex(int index , int data) {
try {
checkBoundaryException(index);
int len = size();
if (index == 0) {
addFirst(data);
return;
}
if (index == len) {
addLast(data);
return;
}
ListNode cur = head;
while (index - 1 != 0) {
cur = cur.next;
index--;
}
ListNode node = new ListNode(data);
node.next = cur.next;
cur.next = node;
} catch (BoundaryException e) {
e.printStackTrace();
}
}
//检查index的位置是否超出边界
private void checkBoundaryException(int index) throws BoundaryException {
if (index < 0 || index > size()) {
throw new BoundaryException("插入位置超出边界!!!");
}
}
//求链表的长度
public int size() {
ListNode cur = head;
int len = 0;
while (cur != null) {
len++;
cur = cur.next;
}
return len;
}3.3 查
查找 contains(int key) 链表中是否存在关键字key :针对这个方法,只需要遍历一次链表,就可以得出结果。
    //判断是否存在关键字key
    public boolean contains(int key) {
        ListNode cur = head;
        while (cur != null) {
            if (cur.value == key) {
                return true;
            }
            cur = cur.next;
        }
        return false;
    }
3.4 删
单向链表节点的删除主要有两种,一是只删除第一次出现关键字 key 的节点的操作(remove(int key) )和删除链表中所有含有关键字 key 的节点的操作(removeAllKey(int key))。
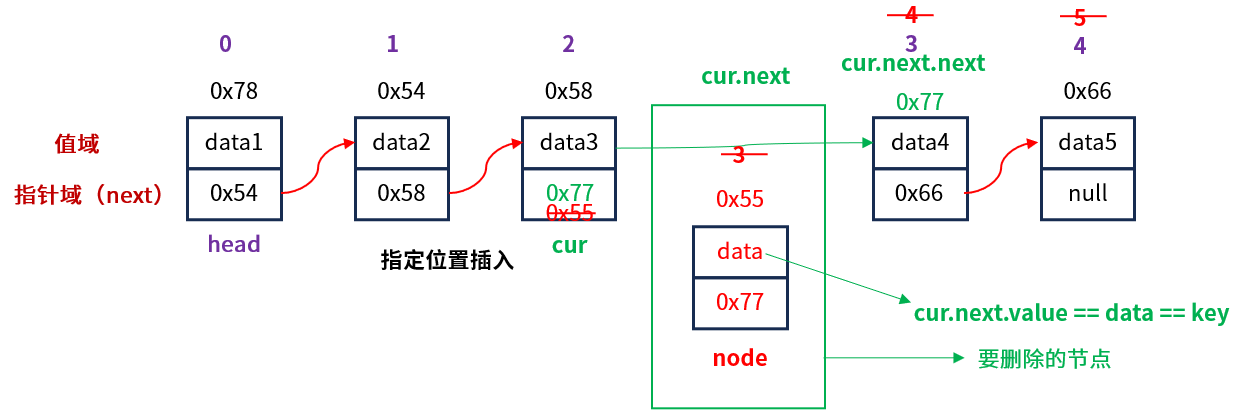
1. remove(int key) :针对这个删除操作,一是先判断头节点的值是否就等于关键字 key (即 head.value == key),如果满足只需要把头节点换成下一节点即可完成,如果不是这种情况,第二步就要对这个链表进行遍历,找到含有第一次含有该关键字的节点,这里可以用一个新的查找方法 findIndexOfKey(int key)来查找该关键字节点的上一个节点 cur,便于代码分块,此时如果返回的是 null 即链表中没有含关键字 key 的节点,那么直接返回即可,如果返回一个位置,那么只需让该节点位置的 next 指向直接跳过含有关键字 key 的节点就可以完成操作,即 cur.next = cur.next.next。
    //删除第一次出现关键字key的节点
    public void remove(int key) {
        if (head == null) {
            return;
        }
        if (head.value == key) {
            head = head.next;
        }
        ListNode cur = findIndexOfKey(key);
        if (cur == null) {
            return;
        }
        cur.next = cur.next.next;
    }
    //找关键字key节点的前一个节点位置
    private ListNode findIndexOfKey(int key) {
        ListNode cur = head;
        while (cur != null && cur.next != null) {
            if (cur.next.value == key) {
                return cur;
            }
            cur = cur.next;
        }
        return null;
    }
2. removeAllKey(int key) :针对删除链表中所有含有关键字 key 的节点,可以理解为类似双指针的思想,假设是 fast 和 slow ,先让fast 走一步,即 fast = head.next,slow = head,然后这两个节点依次往后走,如果 fast 走到的节点元素恰好等于关键字 key ,即 fast.value == key,此时 slow 跳过 fast 指向这个节点,fast 继续往后遍历,即 slow.next = fast,fast = fast.next,否则这两个节点只需保持正常往后遍历即可,最后还要对头节点进行判断,如果头节点元素恰好等于关键字 key ,则需要改变头节点改变为下一个节点。这里需要特别注意,不能先判断头节点,否则无法正确定义 slow 和 fast 的位置。
    //删除所有含有关键字key的节点
    public void removeAllKey(int key) {
        if (head == null) {
            return;
        }
        ListNode slow = head;
        ListNode fast = head.next;
        while (fast != null) {
            if (slow.value == key) {
                slow.next = fast.next;
                fast = fast.next;
            } else {
                slow = fast;
                fast = fast.next;
            }
        }
        if (head.value == key) {
            head = head.next;
        }
    }
4.双向链表的实现
对于双向链表的实现,有一些方法的实现其实和单链表相同,比如遍历 display() 、链表长度 size() 、是否存在关键字 key 的节点contains(int key) ,这些方法可以直接沿用单链表中的具体实现:
public class MyLinkedList{
    static class ListNode {
        public int value;//值
        public ListNode next;//前驱
        public ListNode prev;//后驱
        public ListNode(int value) {
            this.value = value;
        }
    }
    public ListNode head;//头节点
    public ListNode last;//尾节点
    //链表长度
    public int size() {
        ListNode cur = head;
        int count = 0;
        while (cur != null) {
            count++;
            cur = cur.next;
        }
        return count;
    }
    //遍历
    public void display() {
        ListNode cur = head;
        while (cur != null) {
            System.out.print(cur.value + " ");
            cur = cur.next;
        }
        System.out.println();
    }
    //是否包含关键字key
    public boolean contains(int key) {
        ListNode cur = head;
        while (cur != null) {
            if (cur.value == key) {
                return true;
            }
            cur = cur.next;
        }
        return false;
    }
}
4.1 增
双向链表节点的插入也可以分为头插、尾插和指定位置插入。双向链表的插入,需要考虑其后驱( next ) 和前驱 ( prev )。
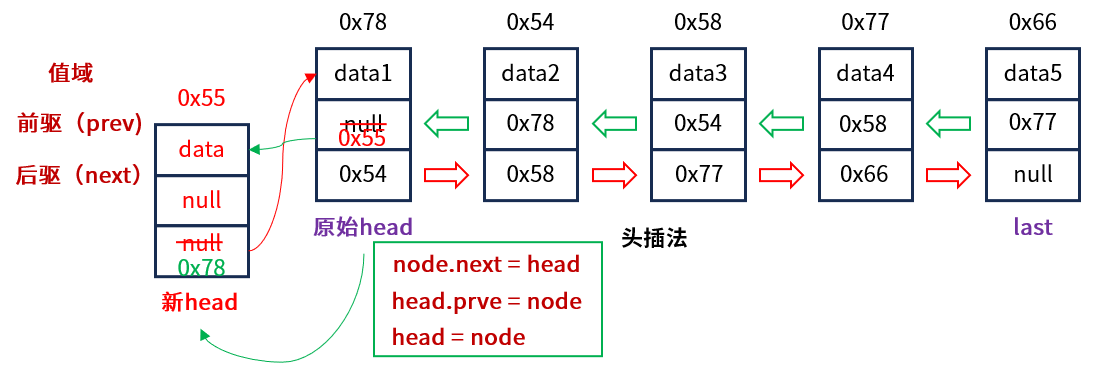
1. 头插法 addFirst(int data):针对双向链表的头插,需要判断头节点 head 是否为空,如果为空,则需要插入的节点既是头节点也是尾节点,就有 head = last = node,如果不为空,由于头节点的前驱为空,所有在更新头节点前,还要改变原来头节点的前驱指向插入头节点,即 node.next = head, head.prev = node , head = node。(所有的插入,都是先绑定后边再绑定前边!!!)
    //头插法
    public void addFirst(int data) {
        ListNode node = new ListNode(data);
        if (head == null) {
            head = last = node;
        } else {
            node.next = head;//node后驱指向head
            head.prev = node;//head前驱指向node
            head = node;//新链表的头变为node
        }
    }
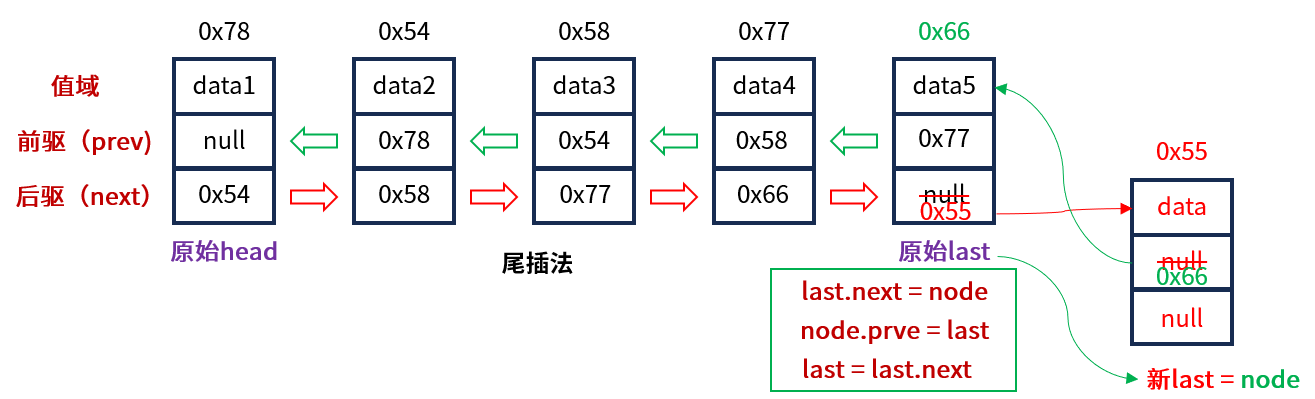
2. 尾插法 addLast(int data) :针对双向链表的尾插法和单向链表不同,因为双向链表是可以知道尾节点的,这时候只需要让尾节点的后驱指向插入的节点,然后插入的节点前驱指向原来的尾节点,最后更新尾节点的位置即可完成操作,即 last.next = node, noder.prev = last, last = last.next。
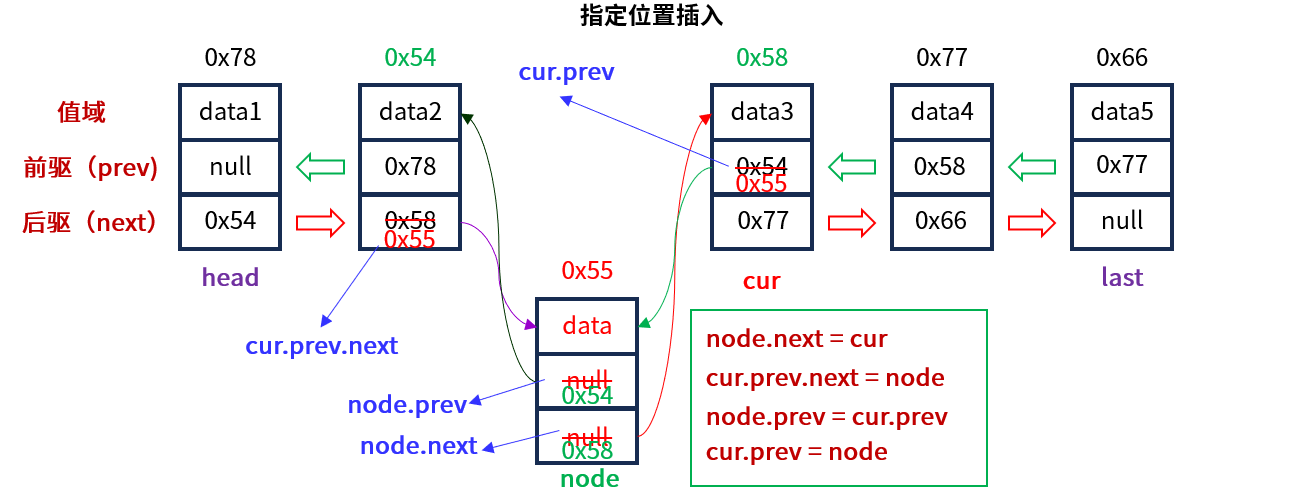
3. 指定位置插入 addIndex(int index , int data) :针对指定位置的插入,同样地第一步要先判断指定的位置(index)是否合法,次数就需要求得链表的长度,用到的方法是 size(),假设这个长度是 len,当位置(index)小于0或者大于链表的长度 len 时,是不可能成功插入的 (对于边界,也可以自定义一个异常类的 java 文件),当 index == 0(链表下标和数组一样,都是从0开始),就属于头插法,同理,index == len 时,就属于尾插法。第二步要找到需要插入节点的位置 cur,找到该位置后,从后往前,依次绑定新插入节点的后驱指向cur,cur 位置前驱的后驱指向新插入的节点,新插入节点的前驱指向 cur 的前驱,最后 cur 的前驱指向新插入的节点就能完成操作,即 node.next = cur,cur.prev.next = node,node.prev = cur.prev,cur.prev = node。
//自定义异常类
public class FindIndexBoundaryException extends RuntimeException{
    public FindIndexBoundaryException(String message) {
        super(message);
    }
}
public void addIndex(int index , int data) {
if (index == 0) {
addFirst(data);
return;
}
if (index == size()) {
addLast(data);
return;
}
try {
ListNode cur = findIndex(index);
ListNode node = new ListNode(data);
node.next = cur;
cur.prev.next = node;
node.prev = cur.prev;
cur.prev = node;
} catch (FindIndexBoundaryException e) {
e.printStackTrace();
}
}
//判断是否存在index这个位置,如果有则返回这个节点
private ListNode findIndex(int index){
if (index < 0 || index > size()) {
throw new FindIndexBoundaryException("插入位置超出边界!!!");
}
ListNode cur = head;
while (index != 0) {
cur = cur.next;
index--;
}
return cur;
}
4.2 删
单向链表节点的删除也有两种,一是只删除第一次出现关键字 key 的节点的操作(remove(int key) )和删除链表中所有含有关键字 key 的节点的操作(removeAllKey(int key))。
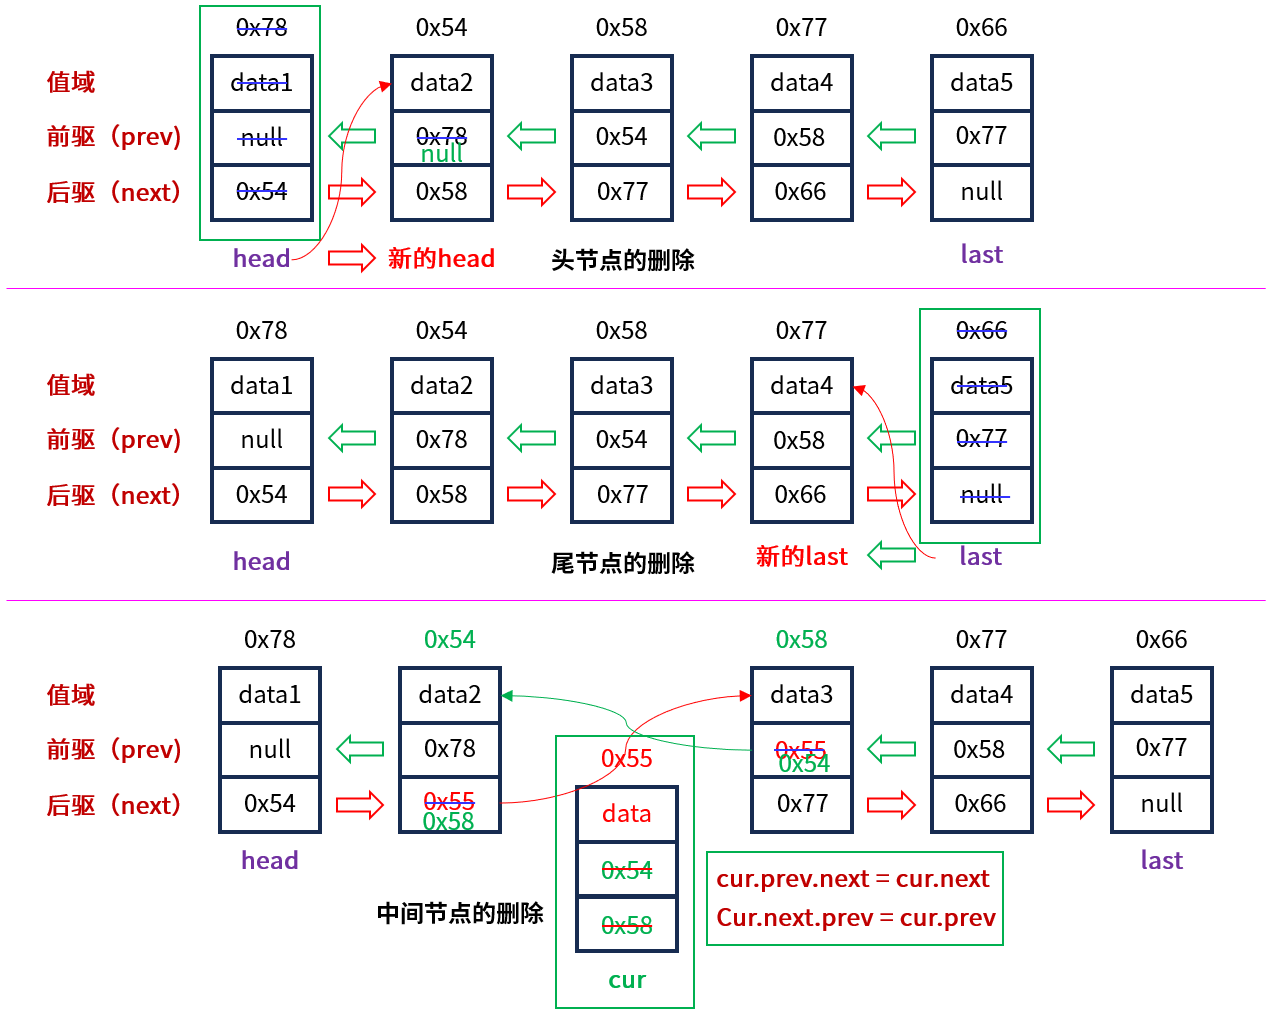
1. remove(int key) :针对双向链表的删除,只需要定义一个节点 cur 从头节点(从尾节点也可以,这里只说从头节点开始)开始遍历这个双向链表当第一次找到某一节点元素与关键字 key 相等时,执行删除操作。如果头节点就是需要删除的节点,那么更新头节点为下一节点即可完成操作,即 head = head.next,如果该链表只有一个节点即头节点时,删除之后,那么这个链表就已经是空链表,就需要把新头节点的前驱置为空,即 head.prev = null。如果删除的节点是中间节点,也就是此时 cur 指向的节点,那么把 cur 的前一个节点的后驱指向 cur 的后一个节点,再更新 cur 的后一个节点的前驱指向 cur 的前驱,即 cur.prev.next = cur.next,cur.next.prev = cur.prev。但是需要注意,如果删除是节点恰好是尾节点(即 cur == last)时,则会到 cur的后驱可能是空,也就是 cur 已经没有下一个节点,如果是这种情况,就不需要执行第二步操作 cur.next.prev = cur.prev,只需要把尾节点更新为前一个节点(即 last = last.prev)即可完成整个删除的操作。
    //删除第一含关键字key的节点
    public void remove(int key) {
        ListNode cur = head;
        while (cur != null) {
            if (cur.value == key) {
                //开始删除
                if (cur == head) {
                    head = head.next;
                    if (head != null) {
                        head.prev = null;
                    }
                } else {
                    cur.prev.next = cur.next;
                    if (cur.next == null) {
                        last = last.prev;
                    } else {
                        cur.next.prev = cur.prev;
                    }
                }
                return;
            }
            cur = cur.next;
        }
    }
2. removeAllKey(int key) :针对删除链表中所有含有关键字 key 的节点,双向链表并不像单向链表那么赋值,只需在上面的方法 remove(int key) 中,当找到第一个关键字时,不进行返回即可。
    //删除所有含关键字key的节点
    public void remove(int key) {
        ListNode cur = head;
        while (cur != null) {
            if (cur.value == key) {
                //开始删除
                if (cur == head) {
                    head = head.next;
                    if (head != null) {
                        head.prev = null;
                    }
                } else {
                    cur.prev.next = cur.next;
                    if (cur.next == null) {
                        last = last.prev;
                    } else {
                        cur.next.prev = cur.prev;
                    }
                }
               // return;不要这条语句即可完成操作
            }
            cur = cur.next;
        }
    }
5. 循环链表
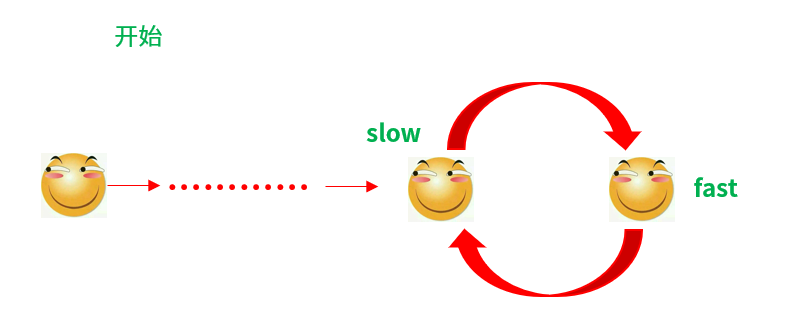
针对循环链表,主要是利用单链表来判断一个链表是否有环,可以使用双指针的方法来判断,首先定义一个快指针 fast ,一个慢指针 slow ,其中快指针 fast 一次走两步(即 fast = fast.next.next),慢指针一次走一步(即slow = slow.next),两个指针都从头节点 head 开始走,由于快指针 fast 先走,所以如果不存在环,那么这个指针会先到达尾节点 ,如果存在环,那么快慢指针一定会在环中相遇。这就类似于在足球操场上跑步,有的人跑得慢,有的人跑得快,如果一直跑下去,只要速度不变,那么这两人迟早会再次相遇。
    public boolean hasCycle(ListNode head) {
        ListNode slow = head;
        ListNode fast = head;
        while(fast !=null && fast.next != null){
            slow = slow.next;
            fast = fast.next.next;
            if(slow == fast ){
                return true;
            }
        }
        return false;
    }
为什么要让快指针一次走两步,慢指针走一步呢?
假设链表带环,两个指针最后都会进入环中,而且是快指针先进环,慢指针后进环,当慢指针进环时,最后的情况就是这两个指针在环的第一个节点就相遇,最差的情况就是两个指针的举例刚好等于环的长度,此时继续移动,快指针每走一步都会和慢指针的距离缩小一步,以此类推,快慢指针迟早会相遇,并且不会出现快指针跳过慢指针的情况。如果是快指针走三步或者三步以上,则有可能出现快指针跳过慢指针的情况,这种情况,快慢指针一直走下去虽然也有肯会相遇,但是如果是特殊情况是永远相遇不了的。比如:
当一个链表是循环链表且循环的节点直邮两个时,快指针一次走三步,慢指针一次走一步,当满指针刚好进入循环的第一个,而快指针又刚好在循环的第二个,这种情况下,不论快慢指针重复多少次,都不可能相遇。
6. LinkedList 与 ArrayList 的区别
LinkedList 的底层实现是双向链表,它实现了 List 接口,其任意位置的插入和删除效率都比较高,时间复杂度是O(1) ,但它不支持随机访问,这是链表的缺点。LinkedList 提供了很多方法,本篇文章实现的方法都是 LinkedList 的常用方法,当时它还有很多的方法,数据结构的每一种集合框架都提供了很多种方法,只有了解其底层逻辑并加以运用,才能更好地去理解这些方法。
LinkedList 与 ArrayList 的区别 :
LinkedList ArrayList 底层结构 双向链表 动态数组 插入/删除效率 O(1)(不需要移动元素,只需调整节点指向即可) O(n)(需要移动数组元素) 随机访问效率 O(n)(需要对链表遍历) O(1)(直接索引下标访问) 存储空间 逻辑上连续,物理上不一定连续 物理上一定连续 适用场景 频繁插入/删除(如栈、队列) 频繁随机访问(如查找)
(感谢阅读,文章较长,如有错误,还望指正!撒花❀❀❀)
更多推荐

 27
 0
- 0


 已为社区贡献2条内容

所有评论(0)