
C++中最小堆数据结构的实现与应用

简介:最小堆是一种树形数据结构,其特性是每个节点的值都小于或等于其子节点的值。它在算法和计算机科学中广泛应用,尤其在优先队列和排序算法中占有重要地位。C++中通常使用STL库实现最小堆,但也可以通过数组来构建。本文将详细介绍最小堆的基本操作,包括插入元素、删除最小元素、下滤和堆的调整,以及如何在C++中进行实现,并探讨其在优先队列、排序算法、计算数据流中位数和最短路径算法等场景中的应用。
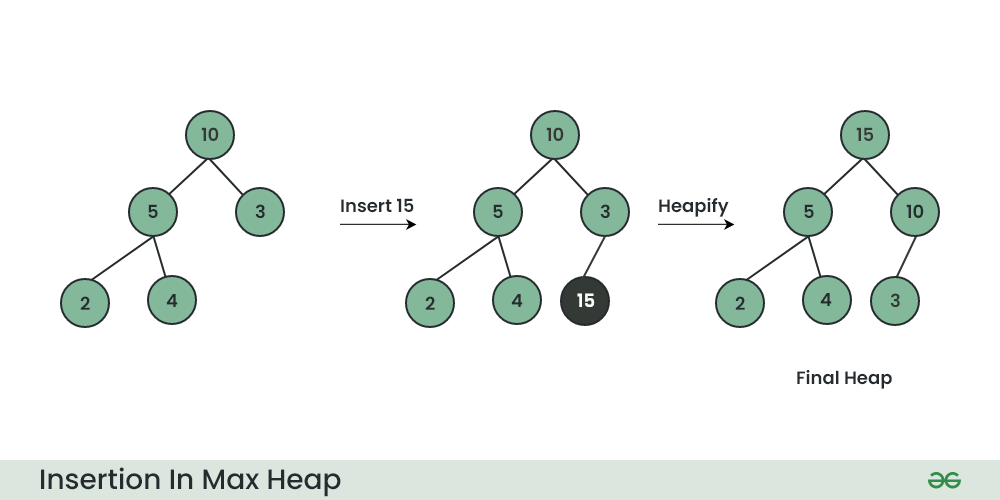
1. 最小堆定义和性质
1.1 最小堆的定义
最小堆是计算机科学中一种特殊的完全二叉树,它具有以下性质:任何一个非叶子节点的值都不大于其子节点的值。在最小堆中,最小的元素总是在根节点,这使得最小堆成为优先队列的一个理想实现,用于快速访问集合中的最小元素。
1.2 最小堆的性质
最小堆的基本性质保证了数据的有序性,同时使得插入和删除最小元素的操作复杂度最小。具体来说,最小堆具有的关键性质包括:
- 完全二叉树结构:在树的最后一层,节点都尽可能靠左填充。
- 堆序性质:每个节点的值都不大于其子节点的值,确保根节点存储最小值。
- 任意节点的子树也都是一个最小堆:这保证了堆的结构在整个数据结构操作过程中得以维持。
通过这些性质,最小堆不仅能够高效地实现优先队列,还可以支持其他多种高效的算法和数据处理技术。在后续章节中,我们将详细探讨最小堆的数组表示法、基本操作以及在不同场景中的应用。
2. 最小堆的数组表示法与操作原理
2.1 数组表示法的基础概念
2.1.1 数组存储与堆结构的映射关系
在讨论最小堆的数组表示法时,我们必须了解它是如何在内存中存储堆的结构。最小堆通常用一个数组来实现,而这个数组中的元素恰好以一种特定的方式映射到堆结构的父子节点上。具体来说,一个数组中的第 i 个元素的左子节点和右子节点分别位于位置 2*i + 1 和 2*i + 2 。此外,任何一个节点的父节点都位于位置 (i-1)/2 。这种表示方式使我们可以非常高效地通过数组索引来访问节点的子节点和父节点,而无需额外的指针或链接,从而大大减少了内存使用。
graph TD;
    A[0] -->|2*i + 1| B[1];
    A[0] -->|2*i + 2| C[2];
    B[1] -->|2*j + 1| D[3];
    B[1] -->|2*j + 2| E[4];
在上述的 Mermaid 流程图中,可以看出数组索引与堆结构的映射关系。例如,索引为 0 的节点(表示堆的根节点)有左子节点索引为 1 和右子节点索引为 2,而索引为 1 的节点又会继续向下映射其子节点。
2.1.2 访问父节点和子节点的方法
有了前面的数组表示法基础,现在我们来具体说明如何在数组中访问任意节点的父节点和子节点。假设我们要访问位于数组索引 i 的节点的父节点,那么父节点的索引就是 (i-1)/2 (对于 i 的值为 0,它的父节点定义为它自己)。对于子节点,左子节点的索引是 2*i + 1 ,而右子节点的索引是 2*i + 2 。
下面是对应的代码实现:
// 获取父节点的索引
int getParentIndex(int i) {
    return (i - 1) / 2;
}

// 获取左子节点的索引
int getLeftChildIndex(int i) {
    return 2 * i + 1;
}

// 获取右子节点的索引
int getRightChildIndex(int i) {
    return 2 * i + 2;
}
这个实现非常直接,但是要注意,对于 i 是偶数的情况, 2*i + 1 保证了返回正确的左子节点索引,即使 i 等于 0。数组表示法允许我们通过简单的算术运算来遍历堆结构,这使得后续的操作,如插入和删除等,更加高效。
2.2 最小堆的核心性质
2.2.1 堆属性和堆序性质
堆是一种特殊的完全二叉树,其中每个父节点的值都小于或等于其子节点的值。这样的性质被称为堆序性质(Heap Property)。对于最小堆,这个性质确保了堆的根节点(数组的第一个元素)是所有节点中最小的。
为了维护堆序性质,我们必须确保在对堆进行插入或删除操作之后重新调整堆。这通常通过 heapify 过程来完成,该过程会从调整的节点开始向上或向下遍历,确保整个堆满足堆序性质。
堆属性的关键代码片段如下:
void heapify(int arr[], int n, int i) {
    int smallest = i; // 初始化最小元素为根
    int l = 2 * i + 1; // 左子节点
    int r = 2 * i + 2; // 右子节点

    // 检查左子节点是否小于根节点的值
    if (l < n && arr[l] < arr[smallest]) {
        smallest = l;
    }

    // 检查右子节点是否小于当前最小节点的值
    if (r < n && arr[r] < arr[smallest]) {
        smallest = r;
    }

    // 如果最小的不是根节点,交换它们,并继续调整交换后的节点
    if (smallest != i) {
        swap(arr[i], arr[smallest]);
        heapify(arr, n, smallest);
    }
}
上述代码展示了维护堆序性质的核心逻辑,如果当前节点不是最小值,我们就会与它的最小子节点进行交换,并递归地调用 heapify 函数来调整树结构。
2.2.2 最小堆与最大堆的对比分析
最小堆和最大堆是两种常见的堆数据结构,它们都满足堆序性质,但有根本的不同。在最小堆中,任何一个父节点的值都小于等于其子节点的值,而在最大堆中,任何一个父节点的值都大于等于其子节点的值。这种差异导致了它们在不同的应用场合中各自的优势。
最小堆通常用于实现优先队列,如在任务调度中,我们总是希望最先处理最小的元素。另一方面,最大堆经常用于实现某些特定的优先队列,比如模拟优先级高的任务先被处理的场景。
在算法复杂度方面,两者基本相同,对于插入和删除操作的时间复杂度都是 O(log n),其中 n 是堆中元素的数量。然而,实际的应用场景和数据特点将决定我们选择使用最小堆还是最大堆。例如,如果需要频繁地获取最小元素,则最小堆是较好的选择;相反,如果我们需要获取最大元素,最大堆则是更合适的选择。
通过上述对比,我们可以看到,最小堆和最大堆在数据结构的实现上有着共通之处,但在逻辑上和应用场景上又有明显的区别,这要求我们根据实际需要选择合适的数据结构,以便在性能和效率上达到最优。
3. 最小堆的构建和基本操作
在探讨数据结构和算法时,最小堆是一种重要的数据结构,它支持快速查找和删除最小元素。在本章中,我们将详细介绍如何构建最小堆以及执行一些基本操作。最小堆通常用于实现优先队列等数据结构,它的操作是许多复杂算法的基石。
3.1 插入元素(Heapify Up)
3.1.1 插入操作的逻辑和步骤
当我们在堆中插入一个新元素时,首先将这个元素添加到堆的最末端(通常是数组的末尾),然后通过上滤(Heapify Up)操作将其移动到正确的位置。这个过程保证了堆的堆序性质。具体步骤如下:
- 将新元素插入到堆的最末端。
- 比较新元素与其父节点的值。
- 如果新元素小于其父节点,交换它们的位置。
- 重复步骤2和3,直到新元素的父节点不再大于新元素,或者新元素已经成为根节点。
3.1.2 插入操作的时间复杂度分析
插入操作的时间复杂度取决于树的高度。由于堆通常用数组实现,且完全二叉树的性质,堆的高度与树中元素数量的对数成正比。因此,插入操作的最坏情况时间复杂度为 O(log n) ,其中 n 是堆中元素的数量。
代码块示例
void insert(int value) {
    heapSize++;
    int i = heapSize - 1;
    // 将新值放到堆的末端
    heap[i] = value;
    // 上滤调整
    while (i > 0 && heap[parent(i)] > heap[i]) {
        swap(heap[i], heap[parent(i)]);
        i = parent(i);
    }
}
逻辑分析:
- heapSize 是当前堆的大小。
- i 是新元素的当前位置。
- parent(i) 计算父节点的位置。
- 循环直到新元素不再需要上滤或者到达根节点。
参数说明:
- value :要插入堆中的新元素值。
- heap :存储堆元素的数组。
- heapSize :堆当前的大小。
3.2 删除最小元素(Extract Min)
3.2.1 删除操作的逻辑和步骤
从最小堆中删除最小元素是优先队列中最常见的操作之一。具体步骤如下:
- 将堆顶元素(最小元素)与最后一个元素交换。
- 将新的堆顶元素移除,并调整剩余堆以保持最小堆性质。
- 执行下滤(Heapify Down)操作,直到新的堆顶元素处于正确位置。
3.2.2 删除操作的时间复杂度分析
删除最小元素的操作开始于一次上滤,终止于一次下滤。每次操作都是在堆的路径上进行,时间复杂度为 O(log n) 。
代码块示例
int extractMin() {
    if (heapSize == 0) return INT_MIN;
    int root = heap[0];
    heap[0] = heap[heapSize - 1];
    heapSize--;
    heapifyDown(0);
    return root;
}

void heapifyDown(int i) {
    int smallest = i;
    int left = left(i);
    int right = right(i);

    if (left < heapSize && heap[left] < heap[smallest])
        smallest = left;

    if (right < heapSize && heap[right] < heap[smallest])
        smallest = right;

    if (smallest != i) {
        swap(heap[i], heap[smallest]);
        heapifyDown(smallest);
    }
}
逻辑分析:
- 交换堆顶元素与最后一个元素。
- 移除最后一个元素,堆的大小减一。
- 从根节点开始下滤,直至满足最小堆的性质。
参数说明:
- heap :存储堆元素的数组。
- heapSize :堆当前的大小。
- left(i) 和 right(i) :计算节点 i 的左右子节点索引。
3.3 下滤(Heapify Down)
3.3.1 下滤操作的逻辑和步骤
下滤操作是调整堆中元素以维持堆性质的另一种重要操作。当根节点的子节点违反了最小堆性质时,需要通过下滤操作将它们调整到合适的位置。具体步骤如下:
- 将要下滤的元素与其子节点中的较小者交换。
- 重复这个过程,直到不再违反最小堆性质或到达堆的底部。
3.3.2 下滤操作的时间复杂度分析
下滤操作的时间复杂度同样是 O(log n) ,因为节点的移动最多发生在从根节点到叶节点的路径上。
代码块示例
void heapifyDown(int i) {
    int smallest = i;
    int left = left(i);
    int right = right(i);

    if (left < heapSize && heap[left] < heap[smallest])
        smallest = left;

    if (right < heapSize && heap[right] < heap[smallest])
        smallest = right;

    if (smallest != i) {
        swap(heap[i], heap[smallest]);
        heapifyDown(smallest);
    }
}
逻辑分析:
- 找到需要下滤的节点及其左右子节点。
- 比较子节点的值,找到最小者,并考虑与当前节点进行交换。
- 如果需要交换,则递归地对新位置进行下滤。
参数说明:
- i :开始下滤的节点索引。
- left(i) 和 right(i) :计算节点 i 的左右子节点索引。
在整个第三章中,我们详尽地探讨了最小堆的构建与基本操作。在第四章中,我们将深入探讨最小堆的高级操作以及在C++中的实现细节。
4. 最小堆的高级操作与调整
最小堆不仅仅能够执行基本的插入和删除操作,在某些复杂的情况下,我们可能需要执行更高级的操作来调整堆的状态。这些操作能够使得最小堆在不同的应用场景中保持良好的性能,优化数据结构的使用效率。
4.1 调整堆(Heapify)
4.1.1 调整堆的概念及其必要性
调整堆是一个操作,旨在重新组织堆中的元素,以便从任意节点开始,都满足最小堆的性质。这一过程通常在初始构建堆或者在对堆进行大量修改后进行,以确保最小堆的属性得到恢复。调整堆在堆的构建过程中尤其重要,因为它可以决定整个堆结构的效率。我们可以将调整堆的概念分为两种:从上往下(Build-Heap)和从下往上(Heapify)。
4.1.2 调整堆的算法实现
调整堆的算法实现通常采用递归或循环的方法。在这里,我们以从下往上的堆化过程为例进行说明:
void heapify(int arr[], int n, int i) {
    int smallest = i; // Initialize smallest as root
    int left = 2 * i + 1; // left = 2*i + 1
    int right = 2 * i + 2; // right = 2*i + 2

    // See if left child of root exists and is
    // smaller than root
    if (left < n && arr[left] < arr[smallest])
        smallest = left;

    // See if right child of root exists and is
    // smaller than smallest so far
    if (right < n && arr[right] < arr[smallest])
        smallest = right;

    // Change root, if needed
    if (smallest != i) {
        swap(arr[i], arr[smallest]);
        // Heapify the root.
        heapify(arr, n, smallest);
    }
}
逻辑分析:
- 我们首先假设根节点(当前节点)是最小的。
- 检查左子节点是否存在于数组内,并且是否比当前的“最小”节点还要小。
- 同样,检查右子节点是否存在,并且是否比当前的“最小”节点还要小。
- 如果发现一个更小的节点,就更新我们的“最小”节点的索引。
- 如果“最小”节点不是根节点,那么交换它们,并对新的根节点(原来更小的子节点)递归地执行堆化过程。
参数说明:
-
arr[]:存储堆元素的数组。 -
n:堆中元素的数量。 -
i:需要堆化的节点索引。
在堆的构建过程中,我们可以从最后一个非叶子节点开始,对每一个节点执行堆化操作,最后得到一个完全满足最小堆性质的堆结构。
4.2 最小堆的C++实现细节
4.2.1 C++类的设计与封装
C++中的最小堆可以通过类来进行设计和封装,以便提供更好的抽象和复用性。一个典型的最小堆类可能会包含数据成员、构造函数、析构函数、成员函数等。
下面是一个简单的最小堆类的框架示例:
#include <vector>

class MinHeap {
private:
    std::vector<int> data;

    void heapify(int n, int i) {
        // ...堆化逻辑...
    }

public:
    MinHeap() : data() {}
    MinHeap(std::vector<int>& arr) : data(arr) {
        // 构建最小堆
        for (int i = parent(data.size() - 1); i >= 0; i--) {
            heapify(data.size(), i);
        }
    }

    void insert(int element) {
        // 插入元素并堆化
        data.push_back(element);
        int i = data.size() - 1;
        while (i != 0 && data[parent(i)] > data[i]) {
            swap(data[parent(i)], data[i]);
            i = parent(i);
        }
    }

    int extractMin() {
        // 提取最小元素并堆化
        if (data.size() <= 0) return INT_MAX;
        if (data.size() == 1) {
            int root = data[0];
            data.clear();
            return root;
        }

        int root = data[0];
        data[0] = data[data.size() - 1];
        data.pop_back();

        heapify(data.size(), 0);
        return root;
    }

    // ...其他成员函数...
};
4.2.2 功能函数的实现与优化
在最小堆类中,除了插入和提取最小元素的基本功能外,还可能包括其他辅助性的成员函数,如:
-
void buildHeap(const std::vector<int>& arr):从给定数组构建最小堆。 -
void printHeap():打印当前堆结构。 -
int getParent(int i)、int getLeftChild(int i)、int getRightChild(int i):获取父节点或子节点的索引。
在实现这些功能时,我们需要注意操作的效率和代码的可读性。例如, insert 函数在插入新元素后,会向上调整堆结构;而 extractMin 函数在提取最小元素后,则需要向下调整堆结构。
此外,最小堆类还可以根据实际需要实现更多高级功能,例如,调整堆大小的 resizeHeap 函数,或者改变指定位置元素的值的 changeValue 函数。
通过这些功能函数,我们能够使最小堆不仅仅在理论上是完备的,而且在实际应用中也是灵活和实用的。
5. 最小堆的应用场景分析
5.1 最小堆在优先队列中的应用
5.1.1 优先队列的基本概念
优先队列是一种逻辑上的数据结构,它允许插入操作,但是每次取出元素时都是取出优先级最高的元素。在计算机科学中,这通常意味着在队列中保持元素按照一定的顺序,比如数值大小或时间戳等。最小堆作为一种能够高效维持顺序的数据结构,是实现优先队列的常用方式。
5.1.2 最小堆与优先队列的关系
最小堆维护的是一种最小元素优先出队的逻辑,这与优先队列中优先级高的元素优先出队的要求不谋而合。通过最小堆实现的优先队列,每次 Extract Min 操作都能获得队列中的最小元素,非常适合于需要频繁检索最小元素的场景。
5.2 最小堆的其他实际应用
5.2.1 事件驱动模拟
在事件驱动的模拟中,需要根据事件的发生时间来调度事件。最小堆可以帮助维护一个事件队列,事件按照发生时间排序。每次事件队列弹出最小堆顶元素,即获取下一个将要发生的事件。这种方法的优点是,当有新事件加入时,可以通过下滤操作迅速找到其合适的位置。
5.2.2 数据压缩算法中的应用
在某些数据压缩算法中,如霍夫曼编码,需要构建一棵霍夫曼树。构建这棵树的过程中,使用最小堆可以使得每次合并两个节点时都能快速找到最小频率的两个节点进行合并操作。
5.2.3 中位数和数据统计问题中的应用
最小堆可以用于动态维持一组数据的中位数。将所有数据分成两个堆,一个最大堆存储较小一半的数据,一个最小堆存储较大一半的数据。这样,最小堆的堆顶元素即为较大一半数据中的最小值,最大堆的堆顶元素为较小一半数据中的最大值。这两个值的平均值即为当前数据集的中位数。在插入新元素时,通过比较和调整两个堆来更新中位数,保持时间复杂度为对数级别。
在实际应用中,最小堆的这些使用案例展示了它在维护数据顺序上的强大功能和高效性能。从优先队列到事件驱动模拟,再到数据压缩和中位数查询,最小堆的灵活性和效率使之成为IT领域中不可或缺的工具。
简介:最小堆是一种树形数据结构,其特性是每个节点的值都小于或等于其子节点的值。它在算法和计算机科学中广泛应用,尤其在优先队列和排序算法中占有重要地位。C++中通常使用STL库实现最小堆,但也可以通过数组来构建。本文将详细介绍最小堆的基本操作,包括插入元素、删除最小元素、下滤和堆的调整,以及如何在C++中进行实现,并探讨其在优先队列、排序算法、计算数据流中位数和最短路径算法等场景中的应用。
更多推荐
 13
 0
- 0


 已为社区贡献10条内容

所有评论(0)