
AI出题人给出的Java后端面经(二)(日更)
链接双端链表:
目录
题目:列举至少 5 种常见的 MySQL 索引失效场景(例如:对索引列使用函数),并针对每种场景简要说明失效原因及优化方案。
题目:什么是 Redis 缓存雪崩?与缓存击穿有何本质区别?请给出 三种预防雪崩 的有效方案(如数据预热、随机过期时间等),并说明每种方案的实现原理。
题目:ThreadPoolExecutor 的 核心构造参数 有哪些(至少说出5个)?请描述当新任务提交时,线程池的 完整工作流程(从任务提交到进入阻塞队列,再到创建新线程的触发条件)。
题目:描述 Spring Bean 的 完整生命周期(从实例化到销毁),需包含以下关键阶段:
🔵 一、Java 基础
题目:
Java 中 String 类的不可变性(Immutable)是如何实现的?这种设计带来了哪些优点?同时,解释为什么在大量字符串拼接场景下推荐使用 StringBuilder 而不是 + 操作符?
答案:
不可变性实现:
String类内部用final char[] value存储数据。类本身为
final禁止继承。修改操作(如
concat())均返回新对象而非修改原对象。优点:
线程安全(无需同步)。
缓存Hash值(提升
HashMap等性能)。安全性(防止篡改,如网络连接、文件路径)。
拼接场景优化:
+操作符编译后实质是StringBuilder.append(),但循环拼接时会在每次循环创建新StringBuilder对象(性能差)。直接使用
StringBuilder全程复用同一个缓冲区,减少对象创建。
🗃️ 二、持久化层 (MySQL)
题目:
列举至少 5 种常见的 MySQL 索引失效场景(例如:对索引列使用函数),并针对每种场景简要说明失效原因及优化方案。
答案:
索引失效场景 失效原因 优化方案 1. 对索引列使用函数 WHERE YEAR(create_time)=2023改用范围查询: BETWEEN '2023-01-01' AND '2023-12-31'2. 隐式类型转换 列 varchar,查询WHERE id=100(int转string)统一类型: WHERE id='100'3. LIKE 以通配符开头 WHERE name LIKE '%abc'改用覆盖索引 / 全文索引 4. OR 条件未全覆盖 WHERE a=1 OR b=2,仅a有索引为b加索引 / 拆分为UNION查询 5. 违反最左前缀原则 联合索引 (a,b,c),查询WHERE b=1 AND c=2调整查询顺序或补充缺失列 ⚠️ 其他场景:索引列数学运算、
!=/NOT IN查询、JOIN字段字符集不一致。
⚙️ 三、中间件
a) 消息队列 (RabbitMQ)
题目:
RabbitMQ 的 Exchange 类型(Direct/Fanout/Topic/Headers)分别有什么特点?请描述生产者发送消息到消费者接收的完整流程(需包含 Exchange、RoutingKey、Queue 的绑定关系)。
答案:
Exchange类型 特点 路由规则 Direct 精确匹配 RoutingKey 完全相等 才转发 Fanout 广播模式 忽略 RoutingKey,所有绑定队列都接收 Topic 通配符匹配 RoutingKey 支持 *(单词)#(多词)Headers 基于消息头匹配(少用) 指定 key-value匹配规则消息流转流程:
生产者发送消息到 Exchange,指定
RoutingKey。Exchange 根据 类型 + Binding规则 将消息路由到 Queue。
消费者监听 Queue 获取消息。
b) Redis
题目:
什么是 Redis 缓存雪崩?与缓存击穿有何本质区别?请给出 三种预防雪崩 的有效方案(如数据预热、随机过期时间等),并说明每种方案的实现原理。
答案:
缓存雪崩:大量Key同时过期,导致请求全部穿透到数据库(压垮DB)。
vs 缓存击穿:雪崩是多个Key同时失效,击穿是单个热点Key失效。
预防方案:
随机过期时间:
TTL = base_time + random(0, 300s),分散过期时间。数据预热:系统启动时加载高频数据,并设置合理过期时间。
熔断降级:使用 Hystrix 等组件在DB压力大时返回默认值。
集群部署:Redis 主从+哨兵,避免单点故障。
🧠 四、JVM
题目:
对比说明 JVM 中三种垃圾回收算法的核心思想:标记-清除(Mark-Sweep)、标记-复制(Mark-Copy)、标记-整理(Mark-Compact)
并分析每种算法的 空间效率缺陷 和 适用场景(如年轻代/老年代)。
答案:
垃圾回收算法 核心思想 空间缺陷 适用场景 标记-清除 标记存活对象 → 清除未标记对象 内存碎片严重 CMS老年代回收 标记-复制 内存分两块,存活对象复制到另一半 浪费50%空间 新生代(Survivor区) 标记-整理 标记存活对象 → 向一端移动 → 清理边界 整理耗时高 老年代(Serial Old / G1) 新生代选择复制算法:因对象“朝生夕死”,存活对象少,复制成本低。
⚡ 五、Java 并发
题目:
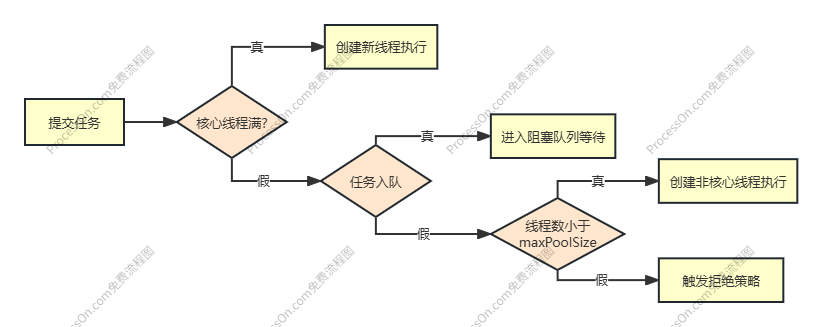
ThreadPoolExecutor 的 核心构造参数 有哪些(至少说出5个)?请描述当新任务提交时,线程池的 完整工作流程(从任务提交到进入阻塞队列,再到创建新线程的触发条件)。
答案:
核心构造参数:
corePoolSize(核心线程数)maximumPoolSize(最大线程数)keepAliveTime(空闲线程存活时间)unit(时间单位)workQueue(阻塞队列,如LinkedBlockingQueue)threadFactory(线程工厂)handler(拒绝策略,如AbortPolicy)任务提交流程图:
🌱 六、Spring 框架
题目:
描述 Spring Bean 的 完整生命周期(从实例化到销毁),需包含以下关键阶段:
-
实例化
-
属性填充(依赖注入)
-
BeanPostProcessor 前置处理
-
初始化方法(
@PostConstruct和InitializingBean) -
BeanPostProcessor 后置处理
-
销毁(
@PreDestroy和DisposableBean)
并说明@PostConstruct和@PreDestroy注解的执行时机。
答案:
Bean 生命周期流程:
实例化:通过构造器或工厂方法创建对象。
属性填充:注入
@Autowired依赖。BeanPostProcessor 前置处理:
postProcessBeforeInitialization()。初始化:
调用
@PostConstruct注解方法。实现
InitializingBean的afterPropertiesSet()。自定义
init-method。BeanPostProcessor 后置处理:
postProcessAfterInitialization()(可返回代理对象)。销毁:
调用
@PreDestroy注解方法。实现
DisposableBean的destroy()。自定义
destroy-method。执行时机:
@PostConstruct:在依赖注入完成后,其他初始化方法前执行。
@PreDestroy:在容器关闭时,Bean销毁前执行。
📌 今日总结:
6 大领域共 7 道题,重点关注:
-
String底层设计 -
MySQL 索引优化
-
RabbitMQ 路由模型
-
JVM 垃圾回收算法对比
-
线程池任务调度流程
-
Spring Bean 生命周期钩子
更多推荐



 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)