
Java数据结构:哈希表
一、哈希表概述
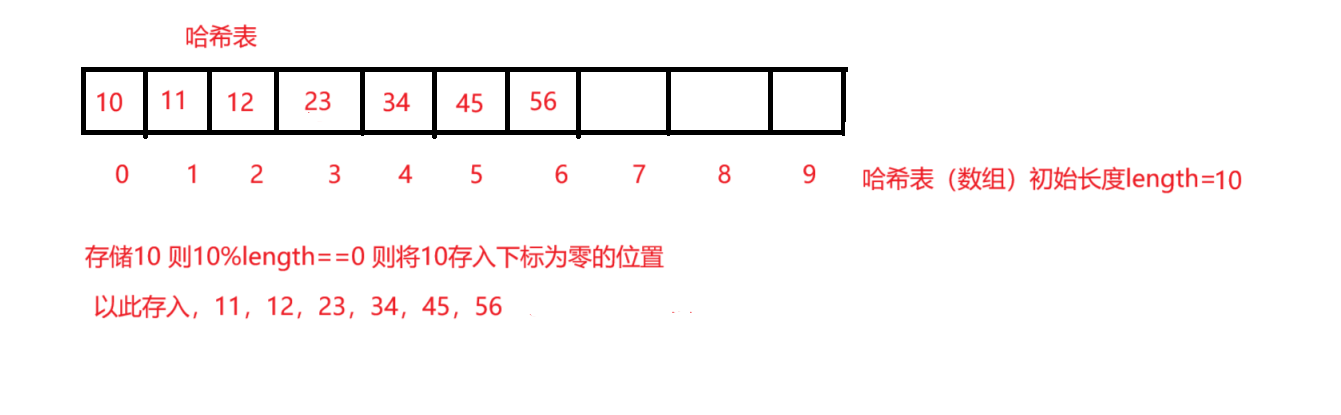
哈希表是一种通过哈希函数将键(key)映射到表中特定位置来访问记录的数据结构,这种映射关系可以加快查找速度。
### 基本概念
- **键(Key)**:用于查找的唯一标识
- **值(Value)**:与键关联的数据
- **哈希函数(Hash Function)**:将键转换为数组索引的函数
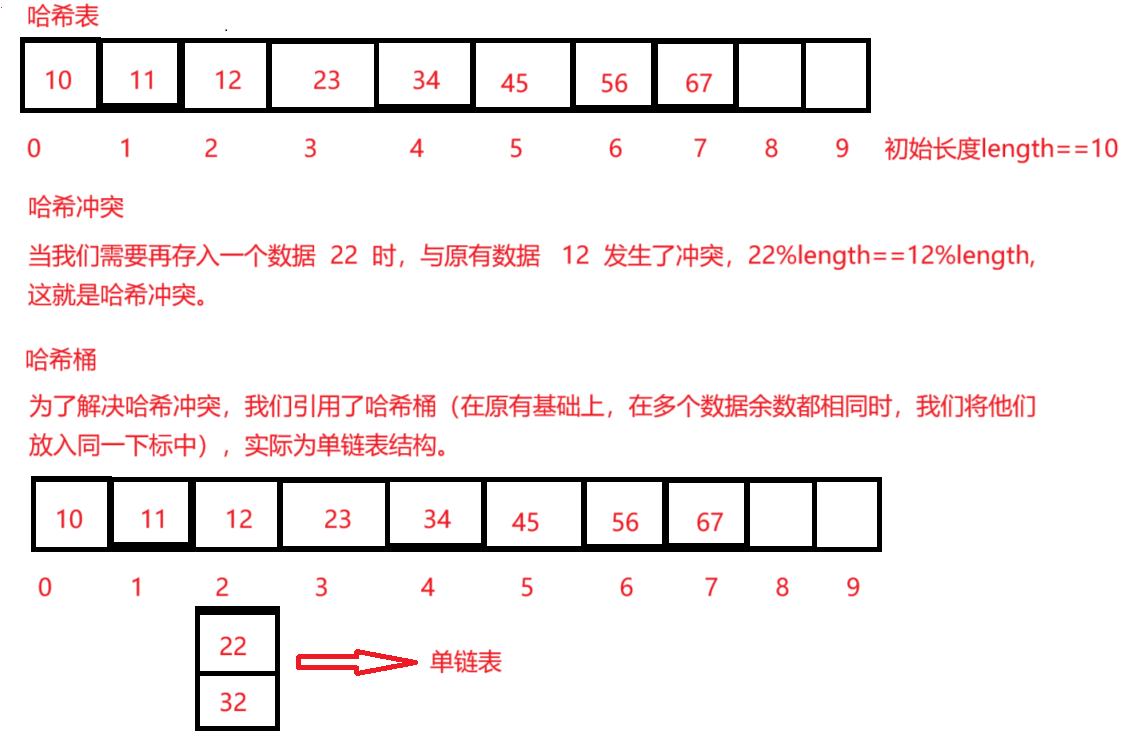
- **哈希冲突(Hash Collision)**:不同键映射到相同索引的情况
二、Java中的哈希表实现
Java提供了多种哈希表实现,主要位于`java.util`包中:
### 1. HashMap
最常用的哈希表实现,允许null键和null值,非线程安全。
java
// HashMap基本用法示例
Map<String, Integer> studentScores = new HashMap<>();
studentScores.put("Alice", 95);
studentScores.put("Bob", 88);
studentScores.put("Charlie", 91);
int score = studentScores.get("Bob"); // 返回88
```
### 2. Hashtable
早期实现,线程安全但性能较差,不推荐在新代码中使用。
### 3. LinkedHashMap
保持插入顺序或访问顺序的HashMap。
### 4. ConcurrentHashMap
线程安全的高性能哈希表实现。
三、哈希表工作原理
### 1. 存储过程
1. 计算键的哈希码(`hashCode()`方法)
2. 通过哈希函数将哈希码转换为数组索引
3. 如果该位置为空,直接存储键值对
4. 如果发生冲突,使用链表或红黑树处理
2. 哈希冲突解决
Java HashMap采用**链地址法**解决冲突:
- JDK 1.7及之前:纯链表
- JDK 1.8及之后:链表长度超过8时转为红黑树
java
// HashMap中的节点定义(简化版)
static class Node<K,V> implements Map.Entry<K,V> {
final int hash;
final K key;
V value;
Node<K,V> next; // 链表结构
}
```
### 3. 扩容机制
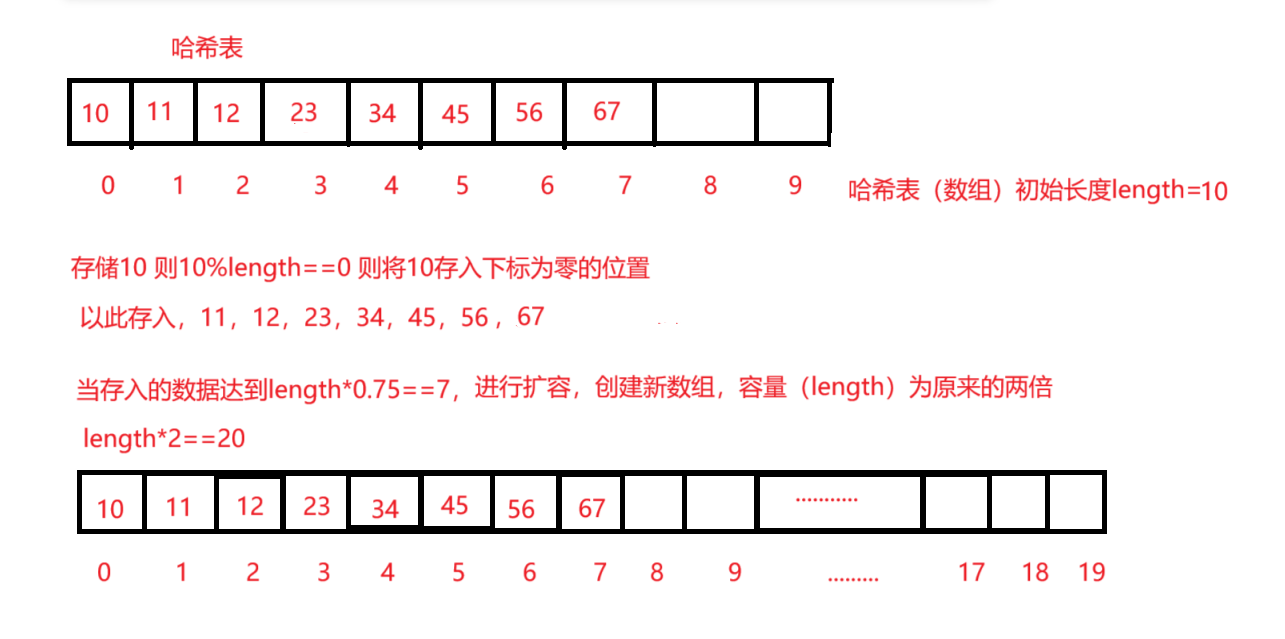
当元素数量超过容量×负载因子(默认0.75)时,HashMap会进行扩容:
1. 创建新的数组(大小为原数组2倍)
2. 重新计算所有元素的哈希位置
3. 将元素迁移到新数组
四、关键方法实现
### 1. hash()方法
java
static final int hash(Object key) {
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
```
这种方法称为"扰动函数",目的是减少哈希冲突。
### 2. put()方法流程
五、性能分析
| 操作 | 平均时间复杂度 | 最坏情况 |
|------|--------------|----------|
| 插入 | O(1) | O(log n) |
| 查找 | O(1) | O(log n) |
| 删除 | O(1) | O(log n) |
**注意**:良好的哈希函数对性能至关重要!
六、最佳实践
1. **正确实现hashCode()和equals()**
java
class Student {
String id;
String name;
@Override
public int hashCode() {
return Objects.hash(id, name);
}
@Override
public boolean equals(Object o) {
if (this == o) return true;
if (o == null || getClass() != o.getClass()) return false;
Student student = (Student) o;
return Objects.equals(id, student.id) &&
Objects.equals(name, student.name);
}
}
```
2. **初始化时设置合理容量**
java
// 预计存储1000个元素,避免频繁扩容
Map<String, String> map = new HashMap<>(1334); // 1334 ≈ 1000/0.75
```
3. **选择合适的键类型**
- 不可变对象(如String、Integer)是理想的键
- 如果使用自定义对象作为键,确保它是不可变的
七、应用场景
1. **缓存实现**
```java
// 简单缓存示例
public class SimpleCache<K, V> {
private final Map<K, V> cache = new HashMap<>();
public synchronized void put(K key, V value) {
cache.put(key, value);
}
public synchronized V get(K key) {
return cache.get(key);
}
}
```
2. **频率统计**
```java
// 统计单词出现频率
String text = "hello world hello java world";
Map<String, Integer> freqMap = new HashMap<>();
for (String word : text.split(" ")) {
freqMap.put(word, freqMap.getOrDefault(word, 0) + 1);
}
```
3. **索引构建**
八、常见问题解答
**Q1: HashMap和Hashtable有什么区别?**
- HashMap允许null键值,非线程安全,性能更好
- Hashtable不允许null键值,线程安全但性能较差
**Q2: 为什么HashMap的容量总是2的幂次方?**
为了更高效地计算索引:`index = (n - 1) & hash`,其中n是数组长度
**Q3: 如何设计好的hashCode()方法?**
- 对关键字段使用Objects.hash()
- 保证相等的对象有相同的hashCode
- 尽量使不同对象的hashCode分布均匀
九、总结
哈希表是Java中最高效的数据结构之一,理解其工作原理对于编写高性能Java代码至关重要。通过合理使用HashMap等实现,可以显著提高程序的执行效率。记住要正确实现hashCode()和equals()方法,并根据实际需求设置初始容量和负载因子。
更多推荐



 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)