
nf_distillation:归一化流的知识蒸馏实战指南

简介:在机器学习领域,“知识蒸馏”是一种将大型模型知识转移到小型模型的技术,”nf_distillation”项目特别关注归一化流模型。该技术通过一系列有序的变换,将简单分布映射到复杂非高斯分布,常用于生成模型和密度估计。本文将介绍归一化流的基础概念、知识蒸馏方法、Python编程实践、深度学习框架应用、模型优化技巧、数据预处理步骤、模型评估以及代码结构,以帮助开发者在Python环境中优化归一化流模型。
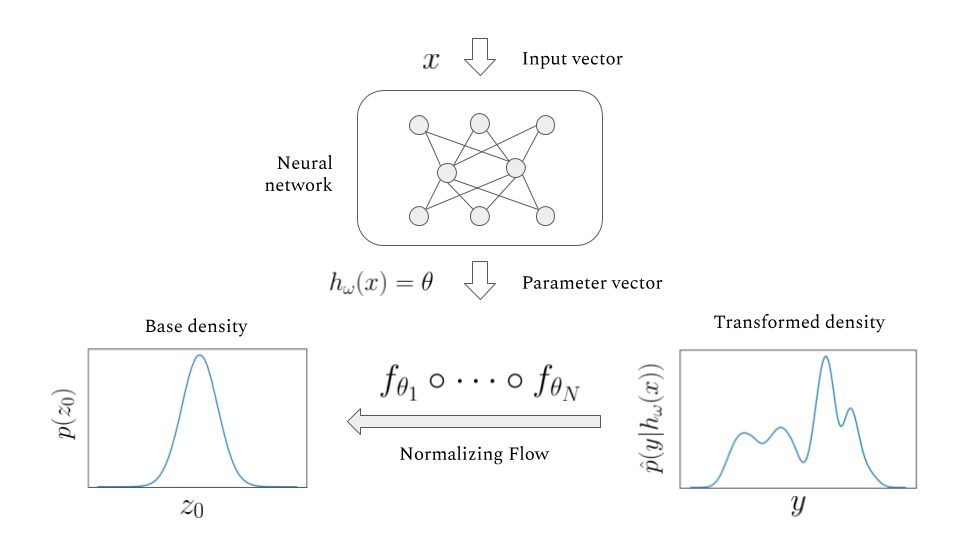
1. 归一化流模型基础
1.1 归一化流概念
归一化流模型是深度生成模型的一种,它通过可逆变换和概率密度函数连续变换来学习数据的分布。这种模型在生成高质量数据样本和密度估计方面表现出色。
1.2 归一化流的工作原理
归一化流使用一系列参数化可逆变换来将简单分布(如高斯分布)转换为复杂分布。通过这种转换,模型能够学习到复杂数据的底层结构,并生成与真实数据相类似的样本。
1.3 归一化流的应用场景
归一化流模型广泛应用于图像生成、语音合成以及异常检测等领域。由于其可逆变换的特性,归一化流尤其适合于精确地建模复杂数据的高维结构。
在这一章节中,我们将探讨归一化流模型的基本概念和工作原理,同时展示一些在实际应用中的案例,以便读者能够理解其在现代深度学习中的重要性。接下来,我们将深入探讨归一化流模型的数学基础和实现细节。
2. 知识蒸馏原理与应用
在深度学习领域,模型的大小和性能往往是设计者面临的两难选择。庞大的模型虽然能够提供更高的准确度,但也带来了计算量大和运行效率低下的问题。知识蒸馏(Knowledge Distillation)技术的出现,为解决这一矛盾提供了一种有效的方法。它通过一种独特的“教师-学生”模型架构,将复杂的大型模型(教师模型)的知识转移到一个更为简洁、高效的模型(学生模型)中,从而实现模型的优化和压缩。接下来,让我们详细探讨知识蒸馏的概念、技术路线以及实际应用场景。
2.1 知识蒸馏的概念和背景
2.1.1 知识蒸馏的定义
知识蒸馏是一种模型压缩技术,它允许我们从一个复杂、大型的神经网络(教师模型)中提取知识,并转移到一个更小、更轻量级的神经网络(学生模型)中。这个过程本质上是将教师模型的软标签(soft labels)或输出概率分布传递给学生模型,使其学会模仿教师模型的决策过程。这种方法不仅可以减小模型体积,还可以提升模型在特定任务上的性能,尤其是在资源受限的环境下。
2.1.2 知识蒸馏的发展历程
知识蒸馏的概念最早由Hinton等人在2015年的论文中提出,他们发现教师模型的输出概率分布比简单的硬标签(hard labels)包含了更多有用的信息。该技术提出后,很快在模型压缩和加速领域得到了广泛的应用。随着时间的推移,知识蒸馏技术也在不断完善和演进,出现了多样化的蒸馏方法和策略,包括但不限于温度缩放(temperature scaling)、特征蒸馏、关系蒸馏等。
2.2 知识蒸馏的技术路线
2.2.1 蒸馏方法的分类
知识蒸馏的方法可以分为几类,其中最常见的是基于概率分布的方法。该方法侧重于使学生模型的输出概率分布与教师模型的输出概率分布尽可能接近。另外,还有基于特征的方法,侧重于让两个模型在各个中间层的输出特征尽可能相似。除此之外,基于损失函数的方法和基于注意力的方法也是知识蒸馏的常见策略之一。
2.2.2 各种方法的原理和实现方式
不同蒸馏方法的原理和实现方式各有不同。基于概率分布的方法通常使用交叉熵损失函数,但在此基础上引入了温度参数,使得概率分布更加平滑,便于学生模型学习。基于特征的方法则关注特征映射的相似度,例如使用均方误差(MSE)或余弦相似度来衡量特征之间的差异。基于损失函数的方法则是在损失函数中加入额外的项,使得学生模型不仅优化原始的任务损失,还需要优化蒸馏损失。基于注意力的方法则通过关注输入数据的重要部分,使得学生模型在这些部分学习得更为深入。
2.3 知识蒸馏的实际应用场景
2.3.1 教师-学生模型架构
在知识蒸馏中,教师-学生模型架构是一种常见的应用场景。在这种架构下,一个预训练好的复杂模型(教师模型)被用来指导一个小模型(学生模型)的学习。这种做法不仅能够将教师模型的知识传递给学生模型,还可以在不牺牲太多准确度的情况下,减小模型的大小和提升推断速度。
2.3.2 降低模型复杂度的策略
除了利用教师-学生模型架构外,知识蒸馏也被广泛应用于降低模型复杂度的场景中。例如,在模型部署到边缘设备时,为了满足内存和速度的限制,通过知识蒸馏得到的轻量级模型能够更好地适应边缘计算环境。此外,对于实时应用(如视频流分析、自然语言处理等),轻量级模型可以显著减少延迟,提升用户体验。
知识蒸馏不仅提高了模型的效率,而且在许多情况下还能提升模型的泛化能力。在后续章节中,我们将详细探讨如何使用Python编程来实现知识蒸馏,并分析如何在实际应用中优化和部署这样的模型。
3. Python编程在知识蒸馏中的作用
在深度学习领域,Python语言以其简洁直观的语法、丰富的库支持以及良好的社区支持成为开发者的首选。尤其是在知识蒸馏(Knowledge Distillation)这一领域,Python不仅与深度学习框架(如TensorFlow、PyTorch等)紧密集成,更通过其强大的编程能力,为知识蒸馏的实现提供了便利。接下来,我们将探讨Python编程在知识蒸馏中的作用。
3.1 Python与深度学习框架的集成
3.1.1 Python在深度学习中的地位
Python语言的崛起与深度学习的复兴几乎同步,其简洁的语法、强大的库生态系统以及丰富的社区资源,为研究人员和工程师提供了一个易于学习和使用的环境。Python的这种地位得益于其背后成熟的生态系统,尤其是深度学习框架的普及。从最初的Theano到现在的TensorFlow、PyTorch,以及MXNet、Keras等,这些框架几乎都是用Python编写的,或者提供了Python接口。
Python使得研究人员可以专注于算法设计和模型架构,而不用过多关注底层实现细节。同时,Python的快速原型开发能力加速了深度学习算法的迭代与应用。这为知识蒸馏提供了一个友好的实现平台。
3.1.2 Python深度学习库的介绍
Python深度学习库丰富多样,大致可以分为两大类:一类是直接提供了深度学习模型构建能力的框架,另一类是提供了深度学习算法实现的库。前者如TensorFlow和PyTorch,后者如scikit-learn。
TensorFlow是由Google开发的一个开源机器学习框架,其以静态计算图著称,适合于大规模分布式训练和部署。PyTorch则是由Facebook推出的一个动态计算图框架,以其易用性和灵活性受到研究人员的青睐。scikit-learn提供了各种传统的机器学习算法,虽然它本身并不直接支持深度学习,但其提供的数据预处理和模型评估工具在深度学习项目中也具有重要的辅助作用。
3.2 Python编程实现知识蒸馏
3.2.1 实际代码实现过程
在知识蒸馏中,Python编程实现的关键在于如何设计教师模型(Teacher Model)和学生模型(Student Model),以及蒸馏过程的优化。一个典型的实现过程如下:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# 定义教师模型
class TeacherModel(nn.Module):
    def __init__(self):
        super(TeacherModel, self).__init__()
        # 定义教师模型的网络结构
        self.features = ...
        self.classifier = ...

    def forward(self, x):
        x = self.features(x)
        x = self.classifier(x)
        return x

# 定义学生模型
class StudentModel(nn.Module):
    def __init__(self):
        super(StudentModel, self).__init__()
        # 定义学生模型的网络结构
        self.features = ...
        self.classifier = ...

    def forward(self, x):
        x = self.features(x)
        x = self.classifier(x)
        return x

# 实例化模型
teacher_model = TeacherModel()
student_model = StudentModel()

# 加载数据集
train_loader = DataLoader(datasets.CIFAR10(root='./data', train=True, download=True, transform=transforms.Compose([
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])), batch_size=64, shuffle=True)

# 定义优化器
optimizer = torch.optim.SGD(student_model.parameters(), lr=0.01, momentum=0.9)

# 训练过程
for epoch in range(num_epochs):
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        # 假设teacher_model的知识已经预训练完成
        teacher_output = teacher_model(data)
        student_output = student_model(data)
        # 计算损失函数,这里使用了蒸馏损失
        loss = F.cross_entropy(student_output, target) + distillation_loss(teacher_output, student_output)
        loss.backward()
        optimizer.step()
上述代码展示了在PyTorch中实现知识蒸馏的基本框架。首先,我们定义了教师模型和学生模型的网络结构。接着,实例化了这两个模型,并加载了数据集。最后,通过一个训练循环来优化学生模型的参数,其中使用了交叉熵损失函数和蒸馏损失函数的组合来指导学生模型的学习过程。
3.2.2 Python代码在蒸馏中的优化技巧
在知识蒸馏的过程中,有几个优化技巧可以提高模型训练的效率和效果:
-
温度调节 :在计算软标签(soft labels)时,通常使用一个温度参数来调整输出概率分布的”软度”。较高的温度可以使得软标签更平滑,从而提供更多的信息给学生模型。
-
蒸馏损失函数的组合 :除了交叉熵损失,还可以结合使用其他损失函数,如均方误差(MSE)损失,来进一步引导学生模型学习教师模型的输出。
-
梯度裁剪 :在训练学生模型时,梯度裁剪可以防止梯度爆炸,有助于稳定训练过程。
-
正则化技术 :使用正则化技术(如权重衰减)可以帮助减轻过拟合问题,尤其是在蒸馏过程中,教师模型的复杂性可能过高。
3.3 Python在模型部署中的角色
3.3.1 部署工具和平台选择
模型部署是将训练好的模型应用到实际场景中的重要步骤。Python在这一环节中同样扮演了关键角色。在选择部署工具和平台时,可以根据具体需求和使用场景来决定:
- 本地服务器部署 :可以选择如Flask、Django这类Python Web框架来部署模型服务。
- 云服务部署 :可以使用AWS SageMaker、Google AI Platform等云服务,这些平台通常提供了一套完整的部署流程。
- 移动和边缘设备部署 :可以考虑使用TensorFlow Lite、ONNX等工具,它们支持将训练好的模型转换为移动端或边缘设备上运行的格式。
3.3.2 代码部署流程详解
部署代码的流程一般包括以下步骤:
-
模型转换 :将训练好的模型转换为适合部署的格式。例如,使用
torch.save保存PyTorch模型,并使用torch.jit将模型转换为ScriptModule。```python
保存PyTorch模型
torch.save(student_model.state_dict(), ‘student_model.pth’)
将模型转换为ScriptModule
scripted_model = torch.jit.script(student_model)
scripted_model.save(‘student_model_scripted.pth’)
``` -
环境准备 :确保目标环境中安装了所有必要的库和依赖项,通常使用
requirements.txt文件来管理依赖。```bash
requirements.txt 示例
torch==1.5.0
torchvision==0.6.0
flask==1.1.2
``` -
服务器配置 :配置Web服务器(如Nginx)和应用服务器(如Gunicorn)来处理外部请求。
-
模型接口编写 :编写API接口,使得外部程序可以调用模型进行预测。
python from flask import Flask, request, jsonify import torch from PIL import Image import torchvision.transforms as transforms app = Flask(__name__) def transform_image(image_bytes): my_transforms = transforms.Compose([ transforms.Resize(256), transforms.CenterCrop(224), transforms.ToTensor(), transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]), ]) image = Image.open(io.BytesIO(image_bytes)) return my_transforms(image).unsqueeze(0) @app.route('/predict', methods=['POST']) def predict(): if request.method == 'POST': image = request.files['file'] image_bytes = image.read() tensor = transform_image(image_bytes) scripted_model = torch.jit.load('student_model_scripted.pth') scripted_model.eval() with torch.no_grad(): outputs = scripted_model(tensor) _, predicted = torch.max(outputs.data, 1) return jsonify({'label': predicted.item()}) if __name__ == '__main__': app.run(host='0.0.0.0', port=8080) -
性能优化 :对部署后的模型进行性能监控和调优,包括但不限于模型压缩、量化、并行处理等技术。
通过以上的步骤,Python不仅支持了知识蒸馏的实现,也为模型的部署和应用提供了便利。这种从研发到部署的一致性编程体验,是Python在深度学习领域中无可替代的优势。
4. 深度学习框架的使用
在现代AI项目中,深度学习框架扮演着核心角色,它们不仅简化了神经网络的设计和实现过程,还提供了优化、部署的一系列工具。本章节将深入探讨两个流行框架——TensorFlow和PyTorch——的基础使用、进阶应用、框架对比与选择。我们将分析每个框架的特点,探讨它们在构建深度学习模型时的优缺点,并提供选择框架时的考量因素。
4.1 TensorFlow基础及进阶应用
TensorFlow是由Google开发的一个开源深度学习库,自2015年发布以来,就迅速成为业界领先的技术选择之一。这一小节将首先介绍TensorFlow的核心组件,随后讨论其高级特性。
4.1.1 TensorFlow的核心组件
TensorFlow的核心是计算图(Compute Graph),它定义了数据如何在一系列操作中流动。一个计算图由节点(操作,如加法或乘法)和边(张量,即多维数组)组成。这种设计允许开发者轻松地在不同设备上进行分布式计算。
TensorFlow 2.x版本引入了Eager Execution模式,该模式下操作立即执行,无需构建计算图,极大地简化了学习曲线,提高了代码的可读性和实验效率。
以下是一个TensorFlow计算图的基本示例:
import tensorflow as tf

# 定义计算图的节点
a = tf.constant(2)
b = tf.constant(3)
c = a * b

# 启动会话执行图
with tf.compat.v1.Session() as sess:
    print(sess.run(c))  # 输出: 6
4.1.2 高级TensorFlow特性
TensorFlow提供了许多高级API,比如 tf.keras ,它提供了一个模块化的网络层API,使得构建模型更为直观。此外,TensorFlow还集成了TensorBoard,一个强大的可视化工具,可以帮助开发者追踪和优化模型性能。
TensorFlow还支持动态计算图,称为tf.data API,它可以高效地处理大量数据,非常适合进行大规模深度学习。
示例代码:
# 使用tf.keras构建一个简单的序列模型
model = tf.keras.Sequential([
    tf.keras.layers.Dense(256, activation='relu', input_shape=(784,)),
    tf.keras.layers.Dropout(0.2),
    tf.keras.layers.Dense(10, activation='softmax')
])

# 编译模型
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

# 模型摘要信息
model.summary()
4.2 PyTorch与模型设计
作为另一种流行的深度学习框架,PyTorch自2016年问世以来,以其动态计算图和灵活性,成为研究人员的首选框架。本小节将探讨PyTorch的主要特点,并展示如何使用PyTorch设计深度学习模型。
4.2.1 PyTorch的主要特点
PyTorch使用动态计算图,这意味着图是在运行时构建的,代码的执行顺序与Python代码一致,极大地提升了开发效率。此外,PyTorch为研究者提供了便利,例如支持即时的梯度计算,使得实现新算法更为简单。
以下是使用PyTorch实现前向和反向传播的基本示例:
import torch

# 定义参数张量
a = torch.tensor(2.0, requires_grad=True)
b = torch.tensor(3.0, requires_grad=True)

# 定义前向传播操作
c = a * b

# 反向传播
c.backward()

# 梯度信息
print(a.grad, b.grad)  # 输出: tensor(3.), tensor(2.)
4.2.2 使用PyTorch设计深度学习模型
PyTorch通过 torch.nn.Module 提供了丰富的网络层和损失函数。设计模型时,开发者只需要继承这个基类并定义前向传播方法即可。
import torch.nn as nn

class SimpleModel(nn.Module):
    def __init__(self):
        super(SimpleModel, self).__init__()
        self.fc1 = nn.Linear(in_features=784, out_features=256)
        self.fc2 = nn.Linear(in_features=256, out_features=10)
    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = self.fc2(x)
        return x

# 实例化模型
model = SimpleModel()
4.3 框架对比与选择
选择合适的深度学习框架对于项目的成功至关重要。下面将对TensorFlow和PyTorch的优缺点进行对比,并探讨选择框架时应考虑的因素。
4.3.1 TensorFlow与PyTorch的优缺点对比
TensorFlow优点包括广泛的社区支持、丰富的预训练模型和工具,以及适用于生产环境的模型部署能力。缺点可能在于入门门槛相对较高,且对于研究者来说不如PyTorch灵活。
PyTorch优点在于其灵活性和易用性,非常适合进行研究和原型开发。缺点可能在于其部署工具和生态系统相对于TensorFlow来说还不够成熟。
4.3.2 框架选择的考量因素
在选择深度学习框架时,应考虑以下几个因素:
- 团队技能和经验 :团队中是否有成员已经熟悉某个框架,减少学习成本。
- 项目需求 :是否需要立即执行代码、灵活性还是需要强大的生产部署工具。
- 社区和生态 :框架是否有强大的社区支持和丰富的第三方库。
- 工具和资源 :是否存在对框架优化的工具,以及是否有足够的教程和文档。
最终,框架选择应基于具体项目需求和团队偏好,没有绝对的好坏之分。
在本章节中,我们探讨了TensorFlow和PyTorch的使用,包括基础概念、进阶特性以及在实际应用中如何设计深度学习模型。通过对比两个框架的优缺点和考量因素,我们为选择合适的框架提供了指导。深度学习框架的使用是AI项目成功的重要一环,熟练掌握这些工具将有助于开发者更好地构建和部署高效的深度学习模型。
5. 模型优化与评估
5.1 超参数调整的艺术
深度学习模型的性能在很大程度上依赖于正确的超参数设置。超参数是模型训练前就确定的参数,如学习率、批量大小、网络层数、隐藏单元数等。由于它们不通过学习过程来确定,因此找到合适的超参数组合是一个实验性的试错过程。
5.1.1 超参数调整的策略和方法
- 随机搜索 :在给定的超参数空间中随机选择参数组合进行实验。它简单且易于实现,适合于参数空间较大时使用。
- 网格搜索 :在一系列预定义值上进行系统的搜索。虽然系统全面,但计算开销巨大,不适用于高维参数空间。
- 贝叶斯优化 :利用贝叶斯理论对超参数空间进行智能采样,通常能找到较好的参数组合。
- 遗传算法 :通过模拟自然选择过程对超参数进行优化,适用于复杂和非线性的优化问题。
- 基于模型的优化 :使用如梯度下降的优化算法,根据先前的实验结果来指导后续的超参数选择。
5.1.2 实际案例分析
假设有一个图像分类任务,目标是在CIFAR-10数据集上使用卷积神经网络(CNN)提高准确率。初始时,我们可能会选择以下超参数:
- 学习率:0.01
- 批量大小:64
- 卷积层:3
- 全连接层:2
- 神经元数量:[64, 128, 256]
使用随机搜索方法,我们可能会试验不同的学习率(例如:0.001, 0.01, 0.1),不同的批量大小(例如:32, 64, 128),和不同层数的网络结构。每次实验后,根据验证集上的性能评估结果选择下一轮的超参数组合。经过多次迭代,我们可能会发现0.001的学习率和批量大小为64的组合能够提升模型表现。
5.2 过拟合的防御策略
过拟合是指模型在训练数据上表现良好,但在未见过的数据上表现不佳的现象。这通常是模型过于复杂,学习到了训练数据中的噪声和细节,而这些并不具有普适性。
5.2.1 过拟合的原因和表征
过拟合可能由以下几个原因引起:
- 模型复杂度过高
- 训练数据量不足
- 数据不平衡或噪声过多
- 训练时间过长
过拟合的表征包括:
- 训练集上的准确率远高于验证集
- 验证集上的损失值在迭代过程中不再下降甚至上升
5.2.2 防止过拟合的技术
为了防止过拟合,可以采取以下技术:
- 正则化 :通过L1或L2正则化项惩罚模型的复杂度。
- 数据增强 :通过旋转、翻转、裁剪等方法增加训练数据的多样性。
- 早停法 (Early Stopping):在验证集性能不再提升时停止训练。
- dropout :随机关闭网络中的一部分神经元,防止网络对特定特征过度依赖。
- 集成学习 :结合多个模型的预测结果,降低单个模型过拟合的风险。
5.3 数据预处理与模型评估
数据预处理是提高模型性能的关键步骤之一。它包括数据清洗、归一化、编码等步骤,可以显著改善模型训练的效率和效果。
5.3.1 数据预处理的重要性
数据预处理的目的是:
- 消除数据中的噪声和异常值
- 提高特征值的可解释性和一致性
- 加速模型训练过程
常见的数据预处理技术包括:
- 标准化(Standardization):将特征值按比例缩放,使其具有单位方差。
- 归一化(Normalization):将特征值缩放到[0, 1]区间。
- 对数转换:减少数据分布的偏斜度。
5.3.2 模型评估的常用指标
模型评估指标帮助我们理解模型在特定任务上的表现。根据任务的不同,选择的评估指标也不同。
对于分类任务,常用指标有:
- 准确率(Accuracy):正确预测的比例。
- 精确率(Precision):预测为正的样本中,实际为正的比例。
- 召回率(Recall):实际为正的样本中,被正确预测为正的比例。
- F1分数:精确率和召回率的调和平均。
对于回归任务,常用指标有:
- 均方误差(MSE):预测值与实际值差的平方的平均值。
- 平均绝对误差(MAE):预测值与实际值差的绝对值的平均值。
5.4 “nf_distillation-main”代码解析
“nf_distillation-main”是一个开源的模型蒸馏库,它的代码库可以帮助我们更好地理解知识蒸馏的实现细节。
5.4.1 代码结构概述
“nf_distillation-main”通常包含以下几个主要模块:
- 数据加载和预处理模块
- 模型定义模块
- 训练和蒸馏模块
- 评估和测试模块
5.4.2 关键代码段的分析与解释
# 一个简单的训练循环伪代码

for epoch in range(num_epochs):
    for batch in dataloader:
        inputs, labels = batch
        # 前向传播
        outputs = model(inputs)
        loss = criterion(outputs, labels)
        # 反向传播和优化器步骤
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    # 蒸馏步骤
    for batch in distiller_dataloader:
        inputs, labels = batch
        teacher_outputs, student_outputs = distill(model, inputs)
        distill_loss = distillation_loss(teacher_outputs, student_outputs)
        distill_loss.backward()
        optimizer.step()
代码中, criterion 通常是指损失函数, distillation_loss 是蒸馏过程中使用的损失函数,用于衡量教师模型和学生模型输出的差异。 distill 函数负责实现蒸馏的具体步骤,可能会包括温度缩放等技术。
在实际应用中,知识蒸馏库如”nf_distillation-main”还可能包括教师模型的选择、蒸馏参数的调整等高级功能。这需要用户根据具体任务的需求进行相应的配置和优化。
简介:在机器学习领域,“知识蒸馏”是一种将大型模型知识转移到小型模型的技术,”nf_distillation”项目特别关注归一化流模型。该技术通过一系列有序的变换,将简单分布映射到复杂非高斯分布,常用于生成模型和密度估计。本文将介绍归一化流的基础概念、知识蒸馏方法、Python编程实践、深度学习框架应用、模型优化技巧、数据预处理步骤、模型评估以及代码结构,以帮助开发者在Python环境中优化归一化流模型。
更多推荐

 4
 0
- 0


 已为社区贡献12条内容

所有评论(0)