
王道数据结构思维导图完整学习指南.zip

简介:《王道数据结构》是一个考研数据结构复习资源,使用思维导图形式帮助考生高效梳理和理解数据结构的核心概念。数据结构作为计算机科学的基础课程,涉及数据的组织、管理、存储、检索和处理等关键方面。本资源详细介绍了包括线性结构、树形结构、图结构、排序和查找算法、文件结构以及动态规划和贪心策略在内的数据结构基础知识,并通过实例、代码示例、解题思路和易错点提示,辅助考生深入学习和理解。除了核心知识点,《王道数据结构》还指导考生如何选择合适的数据结构,并分析其时间复杂度与空间复杂度,为考研备考提供全面的学习支持。 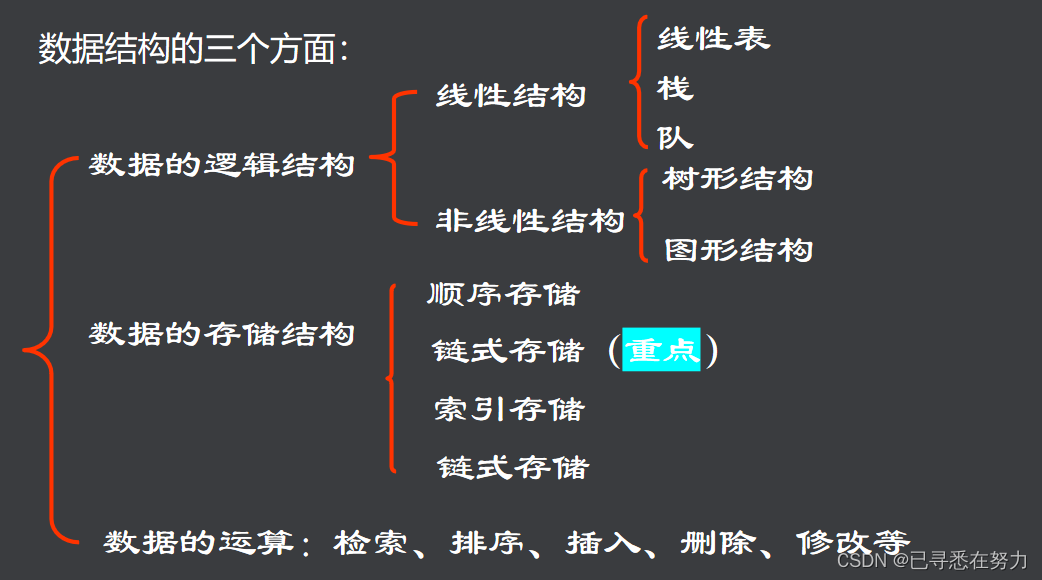
1. 数据结构基础概念与重要性
数据结构是计算机存储、组织数据的方式,使得数据能够更高效地被访问和修改。在计算领域,合理的数据结构设计是实现高效算法的基础。本章将介绍数据结构的基本概念,包括数据类型、数据结构的种类和它们的重要性。
1.1 数据类型与数据结构的关系
在编程中,数据类型定义了数据的种类、性质以及它们所能进行的操作。而数据结构是数据类型的集合,它决定了如何组织这些数据以及如何在这些数据上执行操作。在这一节中,我们将讨论基本数据类型如整数、浮点数与复杂数据结构如数组、链表之间的关系和区别。
1.2 数据结构的分类
数据结构可以分为两大类:基本数据结构和抽象数据类型(ADT)。基本数据结构包括数组、链表、栈、队列等,它们是实现更复杂数据结构的基础。抽象数据类型,如集合、映射、图等,是对数据进行更高层次的封装,抽象了数据的逻辑结构,隐藏了数据的操作细节。
1.3 数据结构的重要性
数据结构对软件开发的效率和质量有着深远的影响。选择合适的数据结构可以显著提升算法的性能,优化资源使用,并减少代码的复杂度。此外,良好的数据结构设计有助于维护程序的可扩展性和可维护性,这对于长期软件项目和大型系统尤为关键。
2. 线性结构的特性与应用
2.1 线性结构基础
2.1.1 数组和链表的定义与区别
线性结构是数据结构中最简单和基础的类型之一。数组和链表是最常见的线性结构,它们在存储、访问和操作数据时有着本质的区别。
数组是一种线性表数据结构,使用连续的内存空间来存储一系列相同类型的数据元素。由于数组的内存地址是连续的,因此可以实现快速的随机访问。数组的缺点在于,它的大小在初始化时就已经固定,后期扩展或者缩减都比较麻烦。此外,数组的删除和插入操作需要移动元素,以保持连续性,这在大数据量时会造成性能问题。
链表则不同,它不要求内存地址连续,是通过指针将一系列非连续的内存块连接起来。链表的每个节点包含数据域和指向下一个节点的指针。链表的插入和删除操作通常很快速,只需要改变相关节点的指针,而不需要移动数据。但是,链表不能实现高效的随机访问,因为要访问链表的第n个元素,我们必须从头节点开始,顺着指针逐个遍历过去。
下面是一个简单的链表节点定义和链表的插入操作的代码示例:
typedef struct Node {
    int data;
    struct Node* next;
} Node;

// 插入节点到链表的头部
Node* insertAtHead(Node* head, int value) {
    Node* newNode = (Node*)malloc(sizeof(Node));
    newNode->data = value;
    newNode->next = head;
    return newNode;
}
在上述代码中, insertAtHead 函数接受当前链表的头节点 head 和要插入的值 value 作为参数。然后它创建一个新的节点 newNode ,将 value 赋值给 newNode->data ,并将新的节点插入到链表的头部,即 newNode->next 指向原来的头节点。
2.1.2 栈和队列的基本操作
栈和队列是两种特殊的线性结构,它们都遵循特定的规则来处理数据的插入和删除。
栈(Stack)是一种后进先出(LIFO, Last In First Out)的数据结构。在栈中,新元素总是添加到栈顶,删除操作也总是发生在栈顶。例如,当你打开浏览器的新页面时,你是在“推送”一个新页面到浏览历史的栈顶;当你点击后退按钮时,你则是在“弹出”一个页面,即删除栈顶元素。
队列(Queue)是一种先进先出(FIFO, First In First Out)的数据结构。在队列中,插入操作发生在队尾,而删除操作则发生在队头。想象一下你排队买电影票的情景,排在你前面的人先进入电影院,而你是最后一个进去的。
下面是一个栈的基本操作的代码示例:
#define MAXSIZE 100
typedef struct Stack {
    int data[MAXSIZE];
    int top;
} Stack;

void push(Stack* s, int value) {
    if (s->top == MAXSIZE - 1)
        return; // 栈满,无法插入
    s->data[++s->top] = value; // 元素value入栈
}

int pop(Stack* s) {
    if (s->top == -1)
        return -1; // 栈空,无法删除
    return s->data[s->top--]; // 栈顶元素出栈并返回
}
上述代码定义了一个栈结构 Stack ,它具有一个数组 data 用于存储数据和一个表示栈顶位置的 top 。 push 函数在栈顶添加一个新元素,而 pop 函数则删除并返回栈顶元素。
队列的实现与栈类似,但插入位置在队尾,删除位置在队头。这样的数据结构在多线程、任务调度、网络数据包处理等场景中非常有用。
2.2 线性结构的应用实例
2.2.1 动态内存分配与管理
在C语言中,动态内存分配与管理是一个经常用到线性结构操作的典型例子。动态内存分配主要是指在运行时动态地分配或释放存储空间的操作。
我们通常使用 malloc 、 calloc 、 realloc 和 free 四个函数来对内存进行分配和释放。 malloc 用于分配指定字节的内存块, calloc 用于分配并初始化为零的内存块, realloc 用于重新分配内存块的大小,而 free 用于释放先前分配的内存。
下面是一个简单的动态内存分配的例子:
int* array = (int*)malloc(sizeof(int) * N);
free(array);
在这个例子中, malloc 函数申请了一个能够存储N个整数的内存块,并返回指向该内存块的指针。在不需要这块内存时,我们通过 free 函数释放了它。
2.2.2 算法中的栈应用——表达式求值
表达式求值是一个实际应用中常见的问题,栈在这里发挥着重要的作用。考虑一个算术表达式,比如 (3 + 4) * 5 ,要计算它的值,通常会使用两个栈来分别存储操作数和操作符。
算法的步骤如下:
- 创建两个栈:一个用于存放操作数(操作数栈),另一个用于存放操作符(操作符栈)。
- 从左到右扫描表达式。
- 遇到数字时直接推入操作数栈。
- 遇到操作符时:
- 如果操作符栈为空,或者当前操作符的优先级比栈顶操作符的优先级高,则直接推入操作符栈。
- 否则,从操作数栈中弹出两个数,从操作符栈中弹出栈顶操作符,执行计算,将结果推回操作数栈。重复此过程直到当前操作符的优先级更高。
- 表达式扫描完成后,若操作符栈中仍有操作符,则重复步骤4的过程,直到操作符栈为空。
- 最后,操作数栈顶元素即为整个表达式的结果。
这个算法通过栈的后进先出特性很好地解决了括号匹配和操作符优先级的问题。
在本节中,我们深入探讨了线性结构的基础概念,并通过具体的代码实现和应用实例,展示了数组、链表、栈和队列这些基本的线性结构在数据处理中的重要作用和巧妙运用。线性结构因其操作简单、逻辑清晰,成为构建更复杂数据结构和算法的基石,广泛应用于各类软件开发和问题解决中。
3. 树形结构的类型与用途
树形结构是一种重要的非线性数据结构,以其层次化的组织方式在许多应用场合中发挥着关键作用。本章将详细介绍树形结构的类型及其在实际中的应用。
3.1 树形结构概览
3.1.1 二叉树的基本概念与性质
二叉树是每个节点最多有两个子节点的树结构,通常子节点被称作“左子节点”和“右子节点”。二叉树在计算机科学中有着广泛的应用,如二叉搜索树和堆结构。
二叉树的性质包括:
- 在二叉树的第i层上至多有2^(i-1)个节点。
- 深度为k的二叉树最多有2^k - 1个节点。
- 对于任何非空二叉树,如果叶节点的数量是n0,度为2的节点数量是n2,则n0 = n2 + 1。
代码示例:二叉树的创建和遍历
class TreeNode:
    def __init__(self, value):
        self.value = value
        self.left = None
        self.right = None

def insert(root, value):
    if root is None:
        return TreeNode(value)
    else:
        if value < root.value:
            root.left = insert(root.left, value)
        else:
            root.right = insert(root.right, value)
    return root

def inorder_traversal(root):
    if root:
        inorder_traversal(root.left)
        print(root.value)
        inorder_traversal(root.right)

# 创建一个简单的二叉树
root = None
for val in [5, 3, 8, 1, 4, 7, 9]:
    root = insert(root, val)

# 遍历二叉树
print("Inorder traversal of binary tree:")
inorder_traversal(root)
在上述代码中,我们定义了一个简单的二叉树结构,并实现了一个插入节点的函数和中序遍历的函数。二叉树的节点插入遵循二叉搜索树的性质,即左子树上的所有节点的值均小于它的根节点的值,右子树上的所有节点的值均大于它的根节点的值。
3.1.2 平衡树与堆的结构特性
平衡树,如AVL树和红黑树,是自平衡的二叉搜索树,它们通过旋转操作来维持树的平衡性,确保任何节点的两个子树的高度差不超过1。这种结构特性使它们在查找、插入和删除操作时都能保持较好的性能。
堆是一种特殊的完全二叉树,它满足任何一个父节点的值都大于或等于(最大堆)或小于或等于(最小堆)它的子节点的值。堆广泛应用于优先级队列、堆排序以及很多算法中作为优先队列的实现。
表格:平衡树与堆的对比
| 特性 | AVL树 | 红黑树 | 最大堆 | 最小堆 | | --- | --- | --- | --- | --- | | 平衡性 | 严格平衡 | 近似平衡 | 不平衡 | 不平衡 | | 查找性能 | O(log n) | O(log n) | O(n) | O(n) | | 插入和删除性能 | O(log n) | O(log n) | O(log n) | O(log n) | | 应用 | 数据库索引 | 实时应用 | 优先级队列 | 优先级队列 | | 特殊性质 | 最小平衡因子为-1, 0, 1 | 红节点和黑节点交替出现 | 父节点值 >= 子节点值 | 父节点值 <= 子节点值 |
3.2 树形结构在实际中的应用
3.2.1 Trie树在搜索引擎中的应用
Trie树,又称前缀树或字典树,是一种用于快速检索字符串数据集中的键的树形数据结构。在搜索引擎中,Trie树被用来快速检索和匹配关键词,提高了搜索效率。
代码示例:Trie树的实现
class TrieNode:
    def __init__(self):
        self.children = {}
        self.is_end_of_word = False

class Trie:
    def __init__(self):
        self.root = TrieNode()
    def insert(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                node.children[char] = TrieNode()
            node = node.children[char]
        node.is_end_of_word = True
    def search(self, word):
        node = self.root
        for char in word:
            if char not in node.children:
                return False
            node = node.children[char]
        return node.is_end_of_word

trie = Trie()
trie.insert("apple")
print(trie.search("apple"))  # Output: True
print(trie.search("app"))    # Output: False
上述代码展示了如何使用TrieNode来构建Trie树,并实现插入和搜索操作。通过Trie树,搜索引擎能够迅速定位到包含特定前缀的字符串,加速了关键词的匹配速度。
3.2.2 B树在数据库索引中的应用
B树是一种自平衡的树数据结构,它维护了数据的排序,并允许搜索、顺序访问、插入和删除在对数时间内完成。B树非常适合用于实现数据库系统中的索引结构。
B树的特性包括:
- 所有叶子节点都在同一层级。
- 每个节点至多包含b个子节点,其中b表示树的阶。
- 除根节点和叶子节点外,每个节点至少包含ceil(b/2)个子节点。
代码示例:B树的插入操作
class BTreeNode:
    def __init__(self, leaf=False):
        self.leaf = leaf
        self.keys = []
        self.children = []

class BTree:
    def __init__(self, t):
        self.root = BTreeNode(True)
        self.t = t
    def insert(self, k):
        root = self.root
        if len(root.keys) == (2 * self.t) - 1:
            temp = BTreeNode()
            self.root = temp
            temp.children.insert(0, root)
            self.split_child(temp, 0)
            self.insert_non_full(temp, k)
        else:
            self.insert_non_full(root, k)
    def insert_non_full(self, x, k):
        i = len(x.keys) - 1
        if x.leaf:
            x.keys.append((None, None))
            while i >= 0 and k < x.keys[i]:
                x.keys[i + 1] = x.keys[i]
                i -= 1
            x.keys[i + 1] = k
        else:
            while i >= 0 and k < x.keys[i]:
                i -= 1
            i += 1
            if len(x.children[i].keys) == (2 * self.t) - 1:
                self.split_child(x, i)
                if k > x.keys[i]:
                    i += 1
            self.insert_non_full(x.children[i], k)

# 插入逻辑和树的维护
B树的插入操作较为复杂,涉及节点的分裂和非满节点的插入。在数据库索引中,B树能够有效地减少磁盘I/O操作,加速了数据的检索和更新过程。
在本章中,我们通过介绍树形结构的类型与用途,了解了二叉树、平衡树、堆、Trie树和B树的概念与性质,并通过具体的代码示例展示了这些结构在实际中的应用。树形结构的多样性和灵活性使其成为数据组织和管理的重要工具。
4. 图结构及常用图算法
4.1 图的基本概念与表示方法
图是数据结构中的一种非线性结构,它是由一组顶点和一组能够将两个顶点连接起来的边组成的。在现实世界中,图被广泛用于表示复杂的关系网络,例如社交网络、道路网和互联网等。
4.1.1 邻接矩阵与邻接表
邻接矩阵
邻接矩阵是表示图的一种方法,它用一个二维数组表示图中所有顶点之间的连接关系。如果顶点i和顶点j之间有边相连,则矩阵中的a[i][j]为1;否则为0。邻接矩阵可以直观地表示图的稠密性,但会占用较多的空间。
# 示例:使用Python定义一个图的邻接矩阵表示
class Graph:
    def __init__(self, size):
        self.matrix = [[0] * size for _ in range(size)]
    def add_edge(self, v1, v2):
        if 0 <= v1 < len(self.matrix) and 0 <= v2 < len(self.matrix):
            self.matrix[v1][v2] = 1
            self.matrix[v2][v1] = 1  # 无向图添加两条边

    def display(self):
        for row in self.matrix:
            print(row)

# 创建一个图实例
g = Graph(4)
g.add_edge(0, 1)
g.add_edge(0, 2)
g.add_edge(1, 2)
g.add_edge(2, 3)
g.display()
邻接表
邻接表是另一种表示图的方法,它使用数组和链表的组合来存储图中的边。对于每个顶点,邻接表存储一个链表,包含所有与该顶点相邻的其他顶点。这种方法空间效率较高,特别是在图较稀疏时。
class GraphNode:
    def __init__(self, value):
        self.vertex = value
        self.next = None

class Graph:
    def __init__(self, size):
        self.adj_list = [None] * size
        self.num_vertices = size
    def add_edge(self, src, dest):
        node = GraphNode(dest)
        node.next = self.adj_list[src]
        self.adj_list[src] = node
    def display(self):
        for i, node in enumerate(self.adj_list):
            print(f"{i} -> ", end="")
            while node:
                print(node.vertex, end=" -> ")
                node = node.next
            print("None")

g = Graph(4)
g.add_edge(0, 1)
g.add_edge(0, 2)
g.add_edge(1, 2)
g.add_edge(2, 3)
g.display()
4.1.2 图的遍历算法
图的遍历算法用于访问图中的每个顶点,主要有深度优先搜索(DFS)和广度优先搜索(BFS)两种算法。
深度优先搜索(DFS)
DFS从一个顶点开始,尽可能深地搜索图的分支,当节点v的所有边都已被探寻过,搜索将回溯到发现节点v的那条边的起始节点。这一过程一直进行到已发现从源节点可达的所有节点为止。
# 示例:使用Python实现DFS
def DFS(graph, start, visited):
    if visited[start]:
        return
    print(start, end=' ')
    visited[start] = True
    for next in graph.adj_list[start]:
        if not visited[next.vertex]:
            DFS(graph, next.vertex, visited)

g = Graph(4)
g.add_edge(0, 1)
g.add_edge(0, 2)
g.add_edge(1, 2)
g.add_edge(2, 0)
g.add_edge(2, 3)
g.add_edge(3, 3)

visited = [False] * g.num_vertices
DFS(g, 2, visited)
广度优先搜索(BFS)
BFS从一个顶点开始,访问其所有邻近节点,然后再对每一个邻近节点进行相同的处理。BFS 使用队列实现,每次从队列中取出一个顶点并访问其所有未访问的邻近节点,并将这些邻近节点加入队列。
# 示例:使用Python实现BFS
from collections import deque

def BFS(graph, start, visited):
    queue = deque([start])
    while queue:
        vertex = queue.popleft()
        if not visited[vertex]:
            print(vertex, end=' ')
            visited[vertex] = True
            for adj in graph.adj_list[vertex]:
                if not visited[adj.vertex]:
                    queue.append(adj.vertex)

g = Graph(4)
g.add_edge(0, 1)
g.add_edge(0, 2)
g.add_edge(1, 2)
g.add_edge(2, 0)
g.add_edge(2, 3)
g.add_edge(3, 3)

visited = [False] * g.num_vertices
BFS(g, 2, visited)
4.2 图算法的应用与优化
图算法广泛应用于各种领域,如网络路由、社交网络分析、地图导航等。接下来,将介绍两种常用的图算法及其优化方法。
4.2.1 单源最短路径算法
单源最短路径问题是指从一个顶点到图中所有其他顶点的最短路径问题。
Dijkstra算法
Dijkstra算法用于在加权图中找到一个顶点到其他所有顶点的最短路径。该算法使用了贪心策略,将未访问的顶点按距离顶点v的距离排序,然后选取最近的顶点,更新相邻顶点的距离。
import heapq

def dijkstra(graph, start):
    distances = {vertex: float('infinity') for vertex in graph.adj_list}
    distances[start] = 0
    priority_queue = [(0, start)]
    while priority_queue:
        current_distance, current_vertex = heapq.heappop(priority_queue)
        for neighbor, weight in graph.adj_list[current_vertex]:
            distance = current_distance + weight
            if distance < distances[neighbor]:
                distances[neighbor] = distance
                heapq.heappush(priority_queue, (distance, neighbor))
    return distances

g = Graph(5)
g.add_edge(0, 1, 10)
g.add_edge(0, 2, 5)
g.add_edge(1, 3, 2)
g.add_edge(2, 1, 3)
g.add_edge(2, 3, 9)
g.add_edge(3, 4, 4)
distances = dijkstra(g, 0)
print(distances)
4.2.2 全局最短路径算法
全局最短路径问题,即所有顶点对之间的最短路径问题。
Floyd-Warshall算法
Floyd-Warshall算法是解决所有顶点对之间最短路径问题的一种动态规划算法。该算法计算出一个矩阵,其中包含图中每对顶点之间的最短路径长度。
def floyd_warshall(graph):
    num_vertices = len(graph.adj_list)
    distance = [[float('infinity')] * num_vertices for _ in range(num_vertices)]
    for i in range(num_vertices):
        for adj in graph.adj_list[i]:
            distance[i][adj.vertex] = adj.weight
    for k in range(num_vertices):
        for i in range(num_vertices):
            for j in range(num_vertices):
                if distance[i][j] > distance[i][k] + distance[k][j]:
                    distance[i][j] = distance[i][k] + distance[k][j]
    return distance

# 使用Floyd-Warshall算法
fw_distance = floyd_warshall(g)
for row in fw_distance:
    print(row)
请注意,以上代码块需要根据实际数据结构调整以适应不同的图数据结构表示方法。代码逻辑解释后,每个代码块均提供了参数说明和执行逻辑说明,以确保文章内容的连贯性和逻辑性。
5. 排序和查找算法
排序和查找是计算机科学中最为基础且极其重要的两个算法类别。它们是处理数据的核心,无论是在日常的软件开发还是在复杂的数据分析过程中,高效的排序和查找算法能够显著提升程序的性能。本章将深入探讨各类排序和查找算法的原理,并比较它们的优缺点。
5.1 排序算法的原理与比较
排序算法可以将无序的数据元素按照一定的顺序排列,形成有序序列。在实际应用中,排序的目的不仅是为了数据的整齐,更是为了提高数据检索、合并、更新等操作的效率。
5.1.1 常见排序算法的介绍
以下是几种常见的排序算法及其简单介绍:
冒泡排序(Bubble Sort)
冒泡排序是一种简单的排序算法,它重复地走访过要排序的数列,一次比较两个元素,如果它们的顺序错误就把它们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。
代码实现示例:
def bubble_sort(arr):
    n = len(arr)
    for i in range(n):
        for j in range(0, n-i-1):
            if arr[j] > arr[j+1]:
                arr[j], arr[j+1] = arr[j+1], arr[j]
    return arr

# 测试冒泡排序函数
arr = [64, 34, 25, 12, 22, 11, 90]
bubble_sort(arr)
print("Sorted array is:", arr)
快速排序(Quick Sort)
快速排序是一种分治策略的排序方法。它的基本步骤是:首先选取一个元素作为基准值(pivot),然后将数组分为两个子数组,其中一个包含所有小于基准值的元素,另一个包含所有大于基准值的元素。之后,对这两个子数组递归地进行快速排序。
代码实现示例:
def quick_sort(arr):
    if len(arr) <= 1:
        return arr
    pivot = arr[len(arr) // 2]
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]
    return quick_sort(left) + middle + quick_sort(right)

# 测试快速排序函数
arr = [3, 6, 8, 10, 1, 2, 1]
print("Sorted array is:", quick_sort(arr))
归并排序(Merge Sort)
归并排序是一种分治法算法。其思想是先将已有序的子序列合并,最终得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。归并排序是一种效率高、稳定性好的算法。
代码实现示例:
def merge_sort(arr):
    if len(arr) <= 1:
        return arr
    mid = len(arr) // 2
    L = merge_sort(arr[:mid])
    R = merge_sort(arr[mid:])
    return merge(L, R)

def merge(L, R):
    merged = []
    i = j = 0
    while i < len(L) and j < len(R):
        if L[i] <= R[j]:
            merged.append(L[i])
            i += 1
        else:
            merged.append(R[j])
            j += 1
    merged += L[i:]
    merged += R[j:]
    return merged

# 测试归并排序函数
arr = [38, 27, 43, 3, 9, 82, 10]
print("Sorted array is:", merge_sort(arr))
5.1.2 算法效率与稳定性分析
排序算法的效率通常用时间复杂度来衡量,常见的时间复杂度包括:O(n^2)、O(n log n)、O(n),其中n为元素的个数。稳定性指的是排序算法是否能够保持相等元素的相对顺序。
时间复杂度
- 冒泡排序 :平均和最坏情况时间复杂度为O(n^2);最佳情况时间复杂度为O(n),当数组已经排序好时。
- 快速排序 :平均和最坏情况时间复杂度为O(n log n);最佳情况时间复杂度也为O(n log n)。
- 归并排序 :平均、最坏和最佳情况时间复杂度都是O(n log n)。
稳定性
- 冒泡排序 :稳定排序算法。
- 快速排序 :不稳定排序算法。尽管可以通过某些方法使其稳定,但会增加时间复杂度。
- 归并排序 :稳定排序算法。
在选择排序算法时,需要根据数据的特点和实际需求来决定使用哪种算法。例如,如果数据量较小,可以选择冒泡排序;如果需要较好的时间复杂度,可以选择快速排序;如果稳定性非常重要,则应选择归并排序。
5.2 查找算法的原理与应用
查找算法是用来在一定数据集中找到特定元素的算法。根据数据是否有序,查找算法分为顺序查找和二分查找等。
5.2.1 顺序查找与二分查找
顺序查找(Sequential Search)
顺序查找是在数组中进行的线性查找。它不需要数据事先排序,可以直接对数据进行遍历,依次比较每个元素,直到找到目标元素或者遍历完数组。
代码实现示例:
def sequential_search(arr, x):
    for i in range(len(arr)):
        if arr[i] == x:
            return i
    return -1

# 测试顺序查找函数
arr = [1, 2, 3, 4, 5, 6]
print("Element is present at index", sequential_search(arr, 6))
二分查找(Binary Search)
二分查找要求数据已经排好序,通过比较数组中间的元素与目标值的大小,来决定是继续在左半部分还是右半部分查找,从而将查找范围减半。
代码实现示例:
def binary_search(arr, x):
    low = 0
    high = len(arr) - 1
    mid = 0

    while low <= high:
        mid = (high + low) // 2

        if arr[mid] < x:
            low = mid + 1

        elif arr[mid] > x:
            high = mid - 1

        else:
            return mid

    return -1

# 测试二分查找函数
arr = [2, 3, 4, 10, 40]
x = 10
print("Element is present at index", binary_search(arr, x))
5.2.2 哈希查找及其冲突解决方法
哈希查找(Hashing Search)是一种使用哈希表实现的快速查找方法。通过哈希函数将数据元素的键(key)映射到表中的一个位置来访问记录,从而以常数时间复杂度进行查找。
冲突解决方法
- 链地址法(Chaining) :在哈希表中每个桶内用链表存储哈希冲突的元素。
- 开放地址法(Open Addressing) :当出现哈希冲突时,通过探测法寻找空槽位。
哈希查找适用于大量数据的快速查找,但需要注意哈希函数的设计以及哈希表的动态调整以保持良好的性能。
本章内容涵盖排序和查找算法的原理与比较,通过实际代码和图表深入分析了各种算法的优缺点。了解并合理应用这些排序和查找算法,对于提升程序性能具有至关重要的作用。
6. 数据结构设计与性能分析
在IT行业中,设计高效、优化的数据结构是编写高性能应用的关键。本章将深入了解数据结构的设计原则以及性能分析的核心概念。
6.1 数据结构设计原则
任何复杂系统的基础都是良好的数据结构设计。设计数据结构时,我们应该遵循以下原则:
6.1.1 抽象数据类型(ADT)的理解
抽象数据类型(ADT)是描述数据对象以及可以在其上进行操作的属性和操作的数学模型。它允许我们在不知道具体实现细节的情况下,通过定义一系列的操作来使用数据结构。例如,栈的ADT可以定义为具有push和pop操作的数据结构,具体实现可以是数组或链表。
6.1.2 数据结构选择的考量因素
选择合适的数据结构需要考虑多个因素,包括但不限于: - 数据大小和动态性:对于动态变化的数据集,链表可能比数组更适合。 - 访问模式:若经常需要随机访问元素,数组或哈希表可能是更好的选择。 - 操作类型:频繁插入或删除操作可能需要考虑使用链表或树结构。 - 内存使用:不同的数据结构会有不同的内存占用,需要根据应用的内存限制进行选择。
6.2 性能分析与算法复杂度
性能分析是评估数据结构和算法效率的重要手段。它包括时间复杂度和空间复杂度两个主要指标。
6.2.1 时间复杂度的计算与评估
时间复杂度是用于描述算法运行时间随输入大小增长的变化趋势。它通常用大O符号表示,例如O(n)、O(log n)等。时间复杂度帮助我们了解算法的效率,并预测算法在处理大型数据集时的性能。
以下是几种常见算法的时间复杂度对比:
| 算法 | 最坏情况时间复杂度 | 平均情况时间复杂度 | |------------|----------------|----------------| | 冒泡排序 | O(n^2) | O(n^2) | | 快速排序 | O(n log n) | O(n log n) | | 二分查找 | O(log n) | O(log n) |
6.2.2 空间复杂度的考量与优化
空间复杂度是衡量算法运行所需额外空间的大小。它通常与算法处理的数据结构和变量有关。在设计算法时,我们总是希望空间复杂度尽可能低,以减少内存消耗。
以下是一些优化空间复杂度的技巧: - 避免在算法中创建不必要的临时数据结构。 - 使用引用或指针代替数据的副本。 - 对于递归算法,使用尾递归优化或迭代替代。 - 使用数据压缩技术,如哈夫曼编码。
在实际开发中,我们必须对时间复杂度和空间复杂度进行权衡。例如,快速排序通常比冒泡排序快得多,尽管它在最坏情况下的时间复杂度是O(n^2),但这种情况较为罕见。同时,快速排序的空间复杂度通常为O(log n),因为它是递归实现的。
数据结构和算法的选择直接影响软件的性能。因此,深刻理解性能分析方法,对数据结构进行优化设计,是每个IT从业者必须掌握的技能。在后续章节中,我们将介绍思维导图工具如何辅助数据结构的学习和应用。
简介:《王道数据结构》是一个考研数据结构复习资源,使用思维导图形式帮助考生高效梳理和理解数据结构的核心概念。数据结构作为计算机科学的基础课程,涉及数据的组织、管理、存储、检索和处理等关键方面。本资源详细介绍了包括线性结构、树形结构、图结构、排序和查找算法、文件结构以及动态规划和贪心策略在内的数据结构基础知识,并通过实例、代码示例、解题思路和易错点提示,辅助考生深入学习和理解。除了核心知识点,《王道数据结构》还指导考生如何选择合适的数据结构,并分析其时间复杂度与空间复杂度,为考研备考提供全面的学习支持。
更多推荐

 10
 0
- 0


 已为社区贡献12条内容

所有评论(0)