
hive优化相关问题
hive优化
矢量化查询:
配置:
set hive.vectorized.execution.enabled=true; 默认值: true
说明:
一旦开启了矢量化查询的工作, hive执行引擎在读取数据时候, 就会批量读取工作, 一次性读取【1024行】数据进行统一处理, 从而【减少读取的次数】(减少磁盘IO), 提升效率
注意事项:
要求表必须是【ORC类型存储】
读取零拷贝
说明: 在读取数据的时候, 能少读一点, 尽量少读一点(没用的数据尽量不读)
配置 :
set hive.exec.orc.zerocopy=true; 默认值为false
例如: 假设有一个A 表 表中 c1 c2 c3 三个字段
select c1,c2 from A where c1=xxx;
注意事项:
要求表必须是【ORC存储格式】
hive的并行优化
1) 并行编译:
hive.driver.parallel.compilation : 是否开启并行编译的操作
hive.driver.parallel.compilation.global.limit: 设置最大同时编译几个会话的SQL
如果设置为 0 表示无限制
如何设置: 建议直接在CM上设置
hive.driver.parallel.compilation : 默认值为 false 生产推荐设置为true
hive.driver.parallel.compilation.global.limit : 默认为 3 【生产推荐为 15】
设置的值越大, 从某种意义可能占用hiveserver2的内存越大
说明:
默认情况下, 如果hive有多个会话窗口, 而且多个窗口都在提交SQL. 此时hive默认情况只能对其中一个会话的SQL进行编译, 其他的会话上SQL, 需要等待 (hive默认同时只能对一个SQL进行编译)
2) 并行执行:
一条SQL语句在提交到hive之后, SQL可能会被翻译为多个阶段, 在这个过程中, 有可能会出现多个阶段互不干扰的情况, 这个时候, 可以按照多个阶段并行执行操作, 以提升效率
如何设置?
set hive.exec.parallel=true; 默认为false 是否开启并行执行
set hive.exec.parallel.thread.number=16; 最大并行可以运行多少个阶段 默认为8
注意:
开启此配置后, 并不代表所有SQL一定会并行执行的, 因为是否并行执行还取决于SQL中多个阶段之间是否有依赖关系, 只有在没有依赖的时候, 才可能并行执行
例子:
select * from A order by 字段1
union all
select * from B where xxx;
如果不开启并行执行:
第一步; 先执行第一个阶段: select * from A order by 字段1 得出一个临时结果
第二步: 接着执行第二个阶段: select * from B where xxx; 得出一个临时结果
第三步: 合并两个阶段的结果 得出最终结果
关联优化器
一个SQL最终会翻译为MR来运行 一个SQL非常有可能需要翻译为多个MR来运行, 每一个MR的中间都可能会执行shuffle的操作, 而shuffle其实比较耗费资源的操作 (内部存在多个IO操作)
关联优化器: 如果多个MR之间的操作的数据都是一样, 同样shuffle操作也是一样的, 让多个MR共享使用一个shuffle结果
比如说:
select max(age) from user group by address join select min(age) from user group by address join select avg(age) from user group by address; 此SQL 操作的表都是同一个表, 分组的字段都是同一个, 此时中间shuffle操作都是一致的, 只不过在reduce的时候, 聚合阶段的规则不一样而已, 此时让三个SQL对应MR使用一个shuffle结果
配置项:
set hive.optimize.correlation=true;
hive的数据倾斜问题处理
问题1: 什么是数据倾斜?
在reduce端, 某些reduce处理数据量远远大于其他reduce处理的数据量, 此时认为出现数据倾斜的问题
问题2: 数据倾斜会导致什么问题呢?
整个执行时间变得更长, 效率比较差
对出现倾斜的reduce压力较大, 可能会导致对应服务器出现宕机的问题
问题3: 数据倾斜一般在执行什么SQL的时候可能会发生呢?
【join】 和 【group by】
思考: 如何解决数据倾斜呢?
join 数据倾斜的解决
解决方案:
    方案一: 采用map join : 普通map join ,  bucket map join , SMB map join

    方案二: 【思路】 将产生数据倾斜的key的值从整个MR移出去. 单独找一个MR来处理这个key即可, 最后将两个MR的结果进行合并操作

        【编译期解决】:  主要适用于【提前知道哪个key会产生数据倾斜】
            处理思路: 在创建表的时候, 提前指定那个key的值会出现倾斜, 这样后期在执行操作的时候, hive会在编译期将key单独移出去, 单独找一个MR运行
            配置方式:
                set hive.optimize.skewjoin.compiletime=true; -- 是否开启编译期数据倾斜解决 默认false

                在建表的时候, 提前指定那个key产生倾斜
                CREATE TABLE list_bucket_single (
                    key STRING,
                    value STRING
                ) SKEWED BY (key) ON (1,5,6) -- 倾斜的字段和需要拆分的key值
                --  为倾斜值创建子目录单独存放
                [STORED AS DIRECTORIES];

        【运行期解决】:  主要适用于【并不清楚表中哪个key的值会有数据倾斜】的问题, 但是一定有倾斜
            处理思路: 在运行的过程中, 对每一个key的数量条数进行计数, 当发现key对应value的条数比较大的时候, 认为这个key出现了数据的倾斜, 将整个键值对从当前MR移出去, 单独找一个MR来处理
            配置方式:
                set hive.optimize.skewjoin=true; -- 开启运行期数据倾斜的处理 默认为false
                set hive.skewjoin.key=100000; -- 当key数据量达到多少的时候, 认为出现数据倾斜

    在生产中, 使用那种方案呢?
    建议两个组合都用,
    【提前知道的】, 提前定义好, 采用编译期解决(效率高),
    【不知道的】, 采用运行期解决, 这样两个组合, 既可以达到效率较高, 并且可以解决所有的join倾斜问题
join中union all优化
不管采用运行期 还是编译期, 最后都要将两个MR的结果进行合并操作, 而合并也是需要执行一个MR来处理, 此时可以对合并的操作进行优化, 优化目的不让其执行这个MR即可
配置:
set hive.optimize.union.remove=true;
建议和join倾斜的配置同时开启
原来流程:
两个MR执行完成后, 会得到两个临时结果, 临时结果会存储在临时目录下, 在合并时候, 将两个临时结果读取出来, 合并成最终结果,放置最终目录下
开启优化后, 两个MR执行完成后, 直接将数据写入到最终目录下, 直接作为最终结果
group by的数据倾斜
group by 出现数据倾斜的过程: 当某一个的数据量远远大于其他组的数据量, 那么这个时候, 就容易产生数据倾斜
假设目前有如下的数据内容:
1 张三 北京
2 李四 深圳
3 王五 北京
4 赵六 上海
5 田七 北京
6 周八 北京
7 老王 广州
8 李九 北京
select address,count(1) from user group by address;
map节点:
map1:
k2 v2
北京 {1,张三,北京}
深圳 {2,李四,深圳}
北京 {3,王五,北京}
上海 {4,赵六,上海}
map2:
k2 v2
北京 {5,田七,北京}
北京 {6,周八,北京}
广州 {7,老王,广州}
北京 {8,李九,北京}
reduce: 2个reduce
reduce1 : 北京 和深圳
拿到数据:
北京 {1,张三,北京}
深圳 {2,李四,深圳}
北京 {3,王五,北京}
北京 {5,田七,北京}
北京 {6,周八,北京}
北京 {8,李九,北京}
reduce2: 广州 和上海
拿到数据:
上海 {4,赵六,上海}
广州 {7,老王,广州}
此时: reduce1 比reduce2拿到数据量多得多, 此时认为 出现了数据倾斜了
如何解决?
方案一:基于 MR中combiner实现解决
map节点:
map1:
k2 v2
北京 {1,张三,北京}
深圳 {2,李四,深圳}
北京 {3,王五,北京}
上海 {4,赵六,上海}
conbiner:
北京 2
深圳 1
上海 1
map2:
k2 v2
北京 {5,田七,北京}
北京 {6,周八,北京}
广州 {7,老王,广州}
北京 {8,李九,北京}
conbiner:
北京 3
广州 1
reduce: 2个reduce
reduce1 : 北京 和深圳
拿到数据:
北京 2
深圳 1
北京 3
reduce2: 广州 和上海
拿到数据:
上海 1
广州 1
这是否减轻了group by 数据倾斜的压力呢? 必然是减轻了
方案二:负载均衡方案 (大的combiner)
思想: 利用两个MR来解决, 第一个MR负载将数据打散 保证每一个reduce都能接收到大致相等数据量, 得出一个局部结果, 接下来在利用第二个MR对第一个MR进行结果进一步处理, 得出最终结果
第一个MR:
map1:
k2 v2
北京 {1,张三,北京}
深圳 {2,李四,深圳}
北京 {3,王五,北京}
上海 {4,赵六,上海}
map2:
k2 v2
北京 {5,田七,北京}
北京 {6,周八,北京}
广州 {7,老王,广州}
北京 {8,李九,北京}
中间, 加入分区操作, 保证让数据均匀落在不同reduce (自定义分区)
reduce端:
reduce1: 接收4条
接收到数据:
北京 {1,张三,北京}
深圳 {2,李四,深圳}
广州 {7,老王,广州}
北京 {8,李九,北京}
计算操作: 输出 3条结果
北京 2
深圳 1
广州 1
reduce2: 接收4条
接收数据:
北京 {3,王五,北京}
上海 {4,赵六,上海}
北京 {5,田七,北京}
北京 {6,周八,北京}
计算操作: 输出2条
北京 3
上海 1
第二个MR执行:
map1:
北京 2
深圳 1
广州 1
北京 3
上海 1
发送给reduce : 相同key发往同一个reduce
reduce1: 北京 和深圳
接收数据: 接收3条数据
北京 2
深圳 1
北京 3
输出结果:
北京 5
深圳 1
reduce2: 上海 和广州
接收数据: 接收到2条数据
广州 1
上海 1
输出:
广州 1
上海 1
如何配置呢?
方案一: 小的combiner操作
set hive.map.aggr=true; 开启map端的combiner的操作
方案二: 负载均衡策略 (大的combiner)
set hive.groupby.skewindata=true;
【注意:在多个列上进行的去重操作与 hive配置: hive.groupby.skewindata存在冲突。】
(1) SELECT count(DISTINCT uid) FROM log
(2) SELECT ip, count(DISTINCT uid) FROM log GROUP BY ip
(3) SELECT ip, count(DISTINCT uid, uname) FROMlog GROUP BY ip
(4) SELECT ip, count(DISTINCT uid), count(DISTINCT uname) FROMlog GROUP BY ip
1、2、3能够正常执行,但是4会报错。
错误如下:
Error in semantic analysis: DISTINCT on different columns notsupported with skew in data.
如何判断执行的SQL, 存在数据倾斜的问题呢?
解决方案: 可以通过查看【MR的日志】, 观察每一个MR的中【reduce的执行时间】, 如果发现某些reduce的执行时间, 比其他的reduce长的多, 认为可能发生了数据倾斜
hive的小文件合并操作
当HDFS中小文件过多后, 会导致HDFS的存储容量下降, 因为每一个小文件都会有一个元数据, 而元数据是存储在namenode的内存中, 当内存一旦满了, 即使datanode还有空间, 那么也无法存储。
MR角度:当小文件过多后, 会导致读取数据时候, 产生大量的文件的切片, 从而导致有多个mapTask的执行, 而每个MapTask处理数据量比较少, 导致资源浪费, 导致执行时间变的更长, 一旦服务器没有资源, 所有map都需要串行化执行。
hive解决方案:在执行完成后, 输出结果的文件尽量的少一些, 避免出现小文件过多的问题, 可以通过设置让执行的SQL输出的文件尽可能少一些。
hive.merge.mapfiles:是否开启map端的小文件合并操作 指的 MR只有map没有reduce的时候 hive.merge.mapredfiles:是否开启reduce端小文件合并操作 指的普通MR hive.merge.size.per.task :设置文件的大小 (合并后的最大文件的大小) 默认为256M hive.merge.smallfiles.avgsize :当输出文件的平均大小小于此设置值的时候, 启动一个独立的map-reduce任务进行文件合并操作. 默认值为16M 以上配置都是可以直接在CM上进行配置的。
总结优化配置
-- 常开 -- 开启并行执行操作 set hive.exec.parallel=true; set hive.exec.parallel.thread.number=16; -- 开启矢量化查询 set hive.vectorized.execution.enabled=true; -- 开启读取零拷贝 set hive.exec.orc.zerocopy=true; -- 倾斜优化, 一般在指定对应操作 才需要加(有倾斜才开,没有不开) -- 解决 join倾斜 set hive.optimize.skewjoin=true; set hive.skewjoin.key=100000; set hive.optimize.skewjoin.compiletime=true; set hive.optimize.union.remove=true; -- 合并优化 -- 解决group by倾斜 set hive.map.aggr=true; set hive.groupby.skewindata=true; -- 开启关联优化器 set hive.optimize.correlation=true;
矢量化查询   :批量读取,减少读取的次数
读取零拷贝   :读取数据时,能少读一点,尽量少读一点
并行优化     :并行编译  并行执行
关联优化器   :让多个MR共享使用一个shuffle结果
小文件合并   :sql输出文件尽可能少一些
数据倾斜     :发生情况 join,group by
            join:两个mr,第一个打散,第二个进一步处理    group by :  Combiner
1) : hive底层转为mr, 底层是怎么转的
hive是基于Hadoop的一个数据仓库工具, 可以将结构化的数据文件映射为一张表, 并提供类SQL查询功能,也就是hive就是MapReduce客户端将用户编写的hql语法转化成mr程序运行
2) hive的倾斜与解决的方法?
SQL语句时的倾斜, 选用join key 分布最均匀地作为驱动表; 大小表联查时小表放在前面;大表和大表联查时可以把空值的key变成一个字符串加上一个随机值。
抽样和范围分区, 可以把抽样得到的结果集来预设分区边界值 combine: 使用combine可以大量的减少数据大小倾斜和数据频率倾斜 group by 的数据倾斜 用两个MR, 第一个负责把数据打散,保证每个reduce都能都能收到大致一样的数据量, 第二个就对第一个的结果的进一步处理
3) sqoop导入数据遇到什么问题? 1 分隔符的问题,默认的列分隔符是'\001',而行分割符是'\n'
解绝: 把导入数据中的包含的hive的默认分割符去掉
2 MySQL里的is null到hive 都变成了null字符串,变成了string类型了
因为hive 当中默认对null的处理是按照\n方式处理,所以只需要在后面加入'\n '即可
4) 在mr的核心步骤里 优化的方法
提前规约,降低reduce的读写次数
提高环形缓存区,减少小文件的数量
5)sqoop的导入问题
增量导入: 1 append 导入
CREATE TABLE `appendTest` (
  `id` int(11) ,
  `name` varchar(255)
)
insert into appendTest(id,name) values(1,'name1');
全量导入: sqoop import \
sqoop增量导入(根据column)
如何在Hive中使用Json格式数据
将json以字符串的方式整个入Hive表,然后使用LATERAL VIEW json_tuple的方法,获取所需要的列名。
问题2 : 如何设置动态分区
set hive.exec.dynamic.pratition.mode = nonstrict;
set hive.exec.max.dynamic.pratitions = 10000;(如果自动分区大于这个参数,就会报错)
set hive.exec.max.dynamic.pratitions .pernode = 100000;
建立分区表
drop table 表名 先删表,判断是否存在,在建表
create table 表名 (数据) partitioned by (字段)
row fromat delimit fields terminated by ','stored as TXTfile
删除分区
alter table 表名 drop partition (分区字段)
order by
order by 会对数据进行全局排序,和oracle和mysql等数据库中的order by 效果一样,它只在一个reduce中进行所以数据量特别大的时候效率非常低。
而且当设置 :set hive.mapred.mode=strict的时候不指定limit,执行select会报错,如下:
LIMIT must also be specified。
sort by
sort by 是单独在各自的reduce中进行排序,所以并不能保证全局有序,一般和distribute by 一起执行,而且distribute by 要写在sort by前面。
如果mapred.reduce.tasks=1和order by效果一样,如果大于1会分成几个文件输出每个文件会按照指定的字段排序,而不保证全局有序。
sort by 不受 hive.mapred.mode 是否为strict ,nostrict 的影响。
distribute by
DISTRIBUTE BY 控制map 中的输出在 reducer 中是如何进行划分的。使用DISTRIBUTE BY 可以保证相同KEY的记录被划分到一个Reduce 中。
cluster by
distribute by 和 sort by 合用就相当于cluster by,但是cluster by 不能指定排序为asc或 desc 的规则,只能是升序排列。
hive的最大优势其实是处理大数据,也就是大量的数据才显得更加有优势,对于小数据不太友好,因为hive的执行延迟比较高;hive合适用于数据分析以及平时对实时性要求不高的场景使用;还有就是hive数据仓优点在它能够给入门者低门槛、简单易学,操作接口采用类sql语法的,提高快速开发效率,开发者可以根据自己需要来实现自己的函数。
hive数据仓有什么缺点
hive的数据仓缺点非常明显,就是效率比较低,比如一些场景自动生成MapReduce时候,通常情况下是不够智能化的;其次hive的调优比较困难、粒度较粗、在数据挖掘时不擅长以及迭代式算法的表达都是不太好的。
hive的架构原理
hive其实它的本质就是将HOL转化为MapReduce程序的,底层实现就是MapReduce的,它处理的数据存储在HDFS中,执行程序在Yran上。
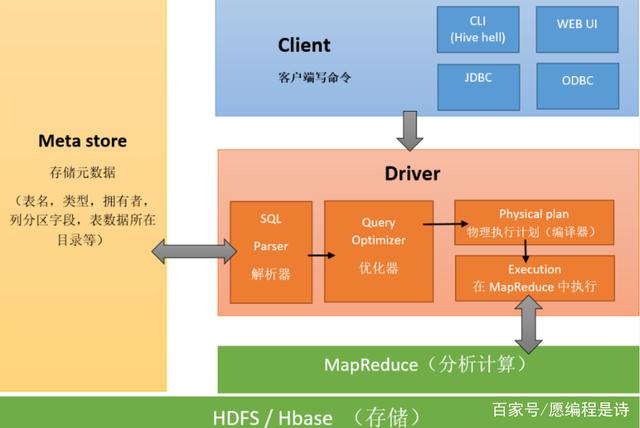
原理:从上图可以看到hive的原理,hive是通过给用户提供的一系列交互接口,然后通过接收到用户的指令如sql,再使用自己的Driver结合元数据Meta store,将这些的指令翻译成MapReduce的,也是我们上文提到的hive底层其实是实现MapReduce程序,最终提交到Hadoop集群中执行,再返回结果给用户交互接口。
hive执行详细步骤
第一步:首先用户操作接口(Client),各中操作如hive shell、通过浏览器访问hive以及Java访问hive等等。
第二步:就是用户操作接口后到元数据(Meta staore)比如表名、表的所属数据库、字段、表类型等这些成为元数据。
第三步:这一步就是执行计算了,数据存储到HDFS,使用的是MapReduce进行计算。
第四步:驱动器Driver,这一步首先。解析器将sql字符串转换成抽象语法树AST,然后到编译器将AST编译生成逻辑执行计划,再到优化器对逻辑执行计划进行一个优化,最终由执行器把这些逻辑执行计划转换成我们可以运行在物理机计划的这样一个过程。
hive的优化操作及原理
分桶表实现:
create table 表名(字段类型,字段类型)
clustered by (字段) sorted(字段 ACS) into 6 buckets --分桶操作
row fromat delimited fields terminated by '\t'
set hive.enforce.bucketing = true -->开启分桶表
向分桶表添加数据
-
想在hive中构建一张临时表,与分桶表里面的字段相同
-
将数据通过 load data 的方式加载到临时表中
-
最后通过 insert into 方式 查询临时表,将数据灌入到分桶表里
-- 限制对桶表进行load操作
set hive.strict.checks.bucketing = true;
说明: 开启此配置后, 无法对桶表执行load 方式, 一旦执行就会报错
分桶表作用:
-
数据量较大,对其进行统计分析时,从整个表数据中抽样取出一部分,然后进行SQL测试,此时效率比较高
-
在统计分析的时候, 不需要进行精确的计算结果,只需计算相应比例,只需抽样出一部分进行计算统计即可
-
提升查询数据效率
SQL优化
避免select *,列裁剪
谓词下推
多使用分区字段过滤
groupby高基数字段放前面 (高基数是指重复率比较低的数据)
orderby尽量使用limit
join时大表放在前面,后面表会放在内存中
当where和order by 的涉及的列里添加索引
尽量避免在where子句中对字段进行null值判断
慎用in和not in
SQL的知识点
编写一个 SQL 查询,查找所有至少连续出现三次的数字。
解决连续的问题
select distinct 字段
from(
select 字段,字段,
lead(字段,1) over(order by 字段) as a,
lead(字段,2) over(order by字段) as b,
...
lead(列1,n-1) over(order by 列) as n,
from 表名
) as t
where t.a=t.b and t.字段=t.a;
//lead 向上偏移    lag向下偏移
ifnull(a,b)函数解释:
如果value1不是空,结果返回a
如果value1是空,结果返回b
只有一张表
编写一个 SQL 查询,获取 Employee 表中第 n 高的薪水(Salary)
  select distinct salary
      from (
          select  salary ,
          dense_rank () over (order by salary desc ) rn
          from employee
      )t
      where rn =n


 多张表(最后join一下关联表就行)
 编写一个 SQL 查询,找出每个部门工资最高的员工
 select d.Name as Department,a.Name as Employee,a.Salary
from (
SELECT Name,Salary,DepartmentId,
dense_rank() over(partition by DepartmentId order by Salary desc) as rnk
FROM Employee ) a
join Department d on a.DepartmentId=d.Id
where a.rnk=1     (最高就=1,第二就是=2,前三就是<=3)
编写一个 SQL 查询,查找所有至少连续出现三次的数字。

返回的结果表中的数据可以按 **任意顺序** 排列。
select distinct Num as ConsecutiveNums
from (
    select Num ,Id ,
    lag( Num ,1) over (order by Id) as l1,
    lag( Num ,2) over (order by Id) as l2
    from Logs
) as lo
where lo.Num  =lo.l1 and lo.Num = lo.l2;

/*lag()/lead()
  lead(field, num, defaultvalue)
    field: 需要查找的字段
    num: 往后查找的num行的数据
    defaultvalue: 没有符合条件的默认值

over()
  表示lag()与lead()操作的数据都在over()的范围内,里面可以使用以下子句
    partition by 语句(用于分组)
    order by 语句()用于排序)
  如:over(partition by a order by b) 表示以a字段进行分组,再以b字段进行排序,对数据进行查询
只有一个表时,再查找时,把他想象两张一样的表进行两表,联查查找
编写一个 SQL 查询,查找 `Person` 表中所有重复的电子邮箱。
select email
from person
group by email
having count(email)>1 --->主要是count()统计也可以是重复
写一个 SQL 查询,来删除 `Person` 表中所有重复的电子邮箱,重复的邮箱里只保留 **Id** *最小* 的那个。
delete from Person where Id in       #where id in 是判断
    select Id
    from(
        select *, row_number() over (partition by Email order by Id) rk
        from Person
    ) t1
    where rk>1)
另一个需要着重去考虑的,就是如何找到 “昨天”(前一天),这里为大家介绍两个时间计算的函数:
datediff(日期1, 日期2):
得到的结果是日期1与日期2相差的天数。
SELECT DATEDIFF(day,'2008-12-29','2008-12-30') AS DiffDate ---->日期为正数
如果日期1比日期2大,结果为正;如果日期1比日期2小,结果为负。

select a.ID, a.date
from weather as a cross join weather as b
     on datediff(a.date, b.date) = 1
where a.temp > b.temp;
MySQL Str to Date (字符串转换为日期)函数:str_to_date(str, format)
MySQL Date/Time to Str(日期/时间转换为字符串)函数:date_format(date,format), time_format(time,format)
| date_format('2008-08-08 22:23:01', '%Y%m%d%H%i%s') |
+----------------------------------------------------+
| 20080808222301 |
select FROM_UNIXTIME(1156219870);
输出:2006-08-22 12:11:10
Select UNIX_TIMESTAMP('2006-11-04 12:23:00');
输出:1162614180
SQL里删除表时的用法
delete from 表名 where 删除字段(要求) in + 查询语句
mod函数(a,b) : 再 SQL 中的意思是a/b 的余数
用法: mod(id, 2)=1 指的id是奇数
mod(id,2 )=0 是指id为偶数
id % 2 =0 指id是偶数
id % 2 =1 指id是奇数
concat函数的用法 (拼接)
语法:concat(str1, str2,…)
select concat(',','11','22',NULL);
NULL
返回结果为连接参数产生的字符串,如果有任何一个参数为null,则返回值为null。
对于mysql 的 like 而言,一般都要用 like concat() 组合,可以防止sql注入。 在mybatis 中就可以这么写:
select * from region A where A.region_name like concat( ‘%’ , ‘#{region_name}’ , ‘%’ )
concat-ws 函数的用法
语法:concat(str1, str2,…)
concat_ws(',','11','22','33,'null')
11,22,33
presto的简介
Presto是Facebook旗下的一款基于Hadoop的一个开源的分布式SQL查询引擎,适用于交互式查询,数据量支持GB到PB字节。
比hive的查询速度快,presto是基于内存的,而hive是基于磁盘的
为什么要设置分层呢?
1 对数据进行规划管理 2 利于后期的维护工作 3 保证数据更加清晰化
为啥建模
访问性能:能够快速查询所需的数据,减少数据I/O
数据成本:减少不必要的数据冗余,实现计算结果数据复用,降低大数 据系统中的存储成本和计算成本
使用效率:改善用户应用体验,提高使用数据的效率
数据质量:改善数据统计口径的不一致性,减少数据计算错误 的可能性,提供高质量的、一致的数据访问平台
hive的面试问题
数据倾斜表现
(1) hadoop中的数据倾斜表现
有一个多几个Reduce卡住,卡在99.99%,一直不能结束。
各种container报错OOM
异常的Reducer读写的数据量极大,至少远远超过其它正常的Reducer
伴随着数据倾斜,会出现任务被kill等各种诡异的表现。

(2) hive中数据倾斜表现
一般发生在SQL中group by 和join on上,而且和数据逻辑绑定比较深。

(3) Spark中的数据倾斜
Spark中的数据倾斜,包括Spark Streaming和Spark Sql,表现主要有下面几种:
Executor lost,OOM,Shuffle过程出错;
Driver OOM;
单个Executor执行时间特别久,整体任务卡在某个阶段不能结束;
正常运行的任务突然失败;
hive的倾斜
hive倾斜的原因:
key值的分布不均, 业务数据激增, 建表时考虑不周, SQL语句本身就有数据倾斜
通过参数调优:
set hive.map.aggr=true;		//提高HiveQL聚合的执行性能
set hive.groupby.skewindata = ture;		//设置数据负载均衡

解决:  参数调节
SQL语句调节: 当大小表jion时, 小表放在前面, 当两大表jion时, 把空值key变成一个字符串加上随机数, 把倾斜的数据放到不同的reduce上

group by 的数据倾斜:用两个MR, 第一个负责把数据打散,保证每个reduce都能收到大致一样的数据量, 第二个就对第一个的结果做聚合计算。

第一个MR Job中,Map的输出结果会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的Group By Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MR Job再根据预处理的数据结果按照Group By Key分布到Reduce中(这个过程可以保证相同的Group By Key被分布到同一个Reduce中),最后完成最终的聚合操作。
hive的优化
通过参数调优:
set hive.map.aggr=true;
set hive.groupby.skewindata = ture;

大小表的join:将条目少的表/子查询放在Join操作符的左边。join的过程中通过小表在前可以适当的减少数据量,提高效率。

with as:【可以避免Hive对不同部分的相同子查询进行重复计算。】
with as是将语句中用到的子查询事先提取出来(类似临时表),使整个查询当中的所有模块都可以调用该查询结果。

Count(distinct):数据量小的时候无所谓,数据量大的情况下,由于COUNT DISTINCT操作需要用一个Reduce Task来完成,这一个Reduce需要处理的数据量太大,就会导致整个Job很难完成,一般COUNT DISTINCT使用先GROUP BY再COUNT的方式替换:
SQL优化
1、避免select *
2、多使用分区字段过滤
3、group by 高基数 字段放前面  (高基数是指重复率比较低的数据)
4、order by尽量使用limit
5、join时大表放在前面,后面表会放在内存中
6 当where和order by 的涉及的列里添加索引
7 尽量避免在where子句中对字段进行null值判断
8 慎用in和not in

null值替换为数值类型  +
hive底层转为mr是如何运行的
hive是基于Hadoop的一个数据仓库工具, 可以将结构化的数据文件映射为一张表, 并提供类SQL查询工能,也就是hive就是MapReduce客户端将用户编写的hql语法转化成mr程序运行
sqoop导入数据遇到什么问题?
1 分隔符的问题,默认的列分隔符是'\001',而行分割符是'\n'
解决: 把导入数据中的包含的hive的默认分割符去掉

2 MySQL里的is null到hive 都变成了null字符串,变成了string类型了
因为hive 当中默认对null的处理是按照\n方式处理,所以只需要在后面加入'\\n '即可
设置动态分区
set hive.exec.dynamic.pratition.mode = nonstrict;
set hive.exec.max.dynamic.pratitions = 10000;(如果自动分区大于这个参数,就会报错)
set hive.exec.max.dynamic.pratitions .pernode = 100000;

建立分区表
drop table 表名 先删表,判断是否存在,在建表
create table 表名 (数据) partitioned by (字段)
row fromat delimit fields terminated by ','stored as TXTfile

删除分区
alter table 表名 drop partition (分区字段)
where和on的区别
数据库在通过连接两张或多张表来返回记录时,都会生成一张中间的临时表,然后再将这张临时表返回给用户。
在使用left jion时,on和where条件的区别如下:
1、on条件是在生成临时表时使用的条件,它不管on中的条件是否为真,都会返回左边表中的记录。
2、where条件是在临时表生成好后,再对临时表进行过滤的条件。这时已经没有left join的含义(必须返回左边表的记录)了,条件不为真的就全部过滤掉。
SQL 中索引的作用:
提高效率,减少了 MapReduce 中数据的读取数据块的数量
order by、sort by、distribute by、cluster by 的区别
【order by】 会对数据进行全局排序,和oracle和mysql等数据库中的order by 效果一样,它只在一个reduce中进行,所以数据量特别大的时候效率非常低。

而且当设置 :set hive.mapred.mode=strict的时候不指定limit,执行select会报错,如下:
LIMIT must also be specified。
【sort by】 是单独在各自的reduce中进行排序,所以并不能保证全局有序,一般和distribute by 一起执行,而且distribute by 要写在sort by前面。

如果mapred.reduce.tasks=1和order by效果一样,如果大于1,会分成几个文件输出每个文件会按照指定的字段排序,而不保证全局有         序。

sort by 不受 hive.mapred.mode 是否为strict ,nonstrict 的影响。
【distribute by】 控制map 中的输出在 reducer 中是如何进行划分的。使用DISTRIBUTE BY 可以保证相同KEY的记录被划分到一个Reduce 中。
【cluster by】 distribute by 和 sort by 合用就相当于cluster by,但是cluster by 不能指定排序为asc或 desc 的规则,只能是升序排列。
hive数据仓有什么缺点
hive的数据仓缺点非常明显,就是效率比较低,比如一些场景自动生成MapReduce时候,通常情况下是不够智能化的;其次hive的调优比较困难、粒度较粗、在数据挖掘时不擅长以及迭代式算法的表达都是不太好的。
hive的架构原理
hive其实它的本质就是将HQL转化为MapReduce程序的,底层实现就是MapReduce的,它处理的数据存储在HDFS中,执行程序在Yran上。

原理:hive是通过给用户提供的一系列交互接口,然后通过接收到用户的指令如sql,再使用自己的Driver结合元数据Meta store,将这些的指令翻译成MapReduce的,也是我们上文提到的hive底层其实是实现MapReduce程序,最终提交到Hadoop集群中执行,再返回结果给用户交互接口。
hive执行详细步骤
第一步:首先用户操作接口(Client),各种操作如hive shell、通过浏览器访问hive以及Java访问hive等等。

第二步:就是用户操作接口后到元数据(Meta staore)比如表名、表的所属数据库、字段、表类型等这些成为元数据。

第三步:这一步就是执行计算了,数据存储到HDFS,使用的是MapReduce进行计算。

第四步:驱动器Driver,这一步首先。解析器将sql字符串转换成抽象语法树AST,然后到编译器将AST编译生成逻辑执行计划,再到优化器对逻辑执行计划进行一个优化,最终由执行器把这些逻辑执行计划转换成我们可以运行在物理机计划的这样一个过程。
分桶表实现:
create table  表名(字段类型,字段类型)

clustered by (字段) sorted(字段 ACS) into 6 buckets --分桶操作

row fromat delimited fields terminated by '\t'

set hive.enforce.bucketing = true -->开启分桶表

向分桶表添加数据

1. 先在hive中构建一张临时表,与分桶表里面的字段相同
2. 将数据通过 load data 的方式加载到临时表中
3. 最后通过 insert into 方式 查询临时表,将数据灌入到分桶表里

 -- 限制对桶表进行load操作

set hive.strict.checks.bucketing = true;
说明: 开启此配置后, 无法对桶表执行load 方式, 一旦执行就会报错
分桶表作用:
1. 数据量较大,对其进行统计分析时,从整个表数据中抽样取出一部分,然后进行SQL测试,此时效率比较高
2. 在统计分析的时候, 不需要进行精确的计算结果,只需计算相应比例,只需抽样出一部分进行计算统计即可
3. 提升查询数据效率
分区表和分桶表的区别
分桶表有什么作用: 将一个文件的数据随机拆分多个文件, 主要是用于数据抽样

分区表:
创建一个分区,把1张或多张表放入到这个分区中,这样可以在查询时避免进行全表查询,从而提高查询效率,分区表在HDFS上的表现形式是目录.

分桶表:
分桶表是一种更细粒度的数据分配方式,可以对一张表的某一列进行分桶,让该列数据按照哈希取模的方式随机、均匀地分发到各个桶文件中。这样一方面可以提高查询效率,另一方面用于数据的抽样,方便进行数据测试。在处理大规模数据集时,在开发和修改查询的阶段,如果能在数据集的一小部分数据上试运行查询,会带来很多方便。分桶表在HDFS上的表现形式是文件.
SQL的知识点
编写一个 SQL 查询,查找所有至少连续出现三次的数字。
解决连续的问题
select distinct 字段
from(
select 字段,字段,
lead(字段,1) over(order by 字段) as a,
lead(字段,2) over(order by字段) as b,
...
lead(列1,n-1) over(order by 列) as n,
from 表名
) as t
where t.a=t.b and t.字段=t.a;
//lead 向上偏移    lag向下偏移
只有一张表
编写一个 SQL 查询,获取 Employee 表中第 n 高的薪水(Salary)
  select distinct salary
      from (
          select  salary ,
          dense_rank () over (order by salary desc ) rn
          from employee
      )t
      where rn =n


 多张表(最后join一下关联表就行)
 编写一个 SQL 查询,找出每个部门工资最高的员工
 select d.Name as Department,a.Name as Employee,a.Salary
from (
SELECT Name,Salary,DepartmentId,
dense_rank() over(partition by DepartmentId order by Salary desc) as rnk
FROM Employee ) a
join Department d on a.DepartmentId=d.Id
where a.rnk=1     (最高就=1,第二就是=2,前三就是<=3)
编写一个 SQL 查询,查找所有至少连续出现三次的数字。

返回的结果表中的数据可以按 **任意顺序** 排列。
select distinct Num as ConsecutiveNums
from (
    select Num ,Id ,
    lag( Num ,1) over (order by Id) as l1,
    lag( Num ,2) over (order by Id) as l2
    from Logs
) as lo
where lo.Num  =lo.l1 and lo.Num = lo.l2;

/*lag()/lead()
  lead(field, num, defaultvalue)
    field: 需要查找的字段
    num: 往后查找的num行的数据
    defaultvalue: 没有符合条件的默认值

over()
  表示lag()与lead()操作的数据都在over()的范围内,里面可以使用以下子句
    partition by 语句(用于分组)
    order by 语句()用于排序)
  如:over(partition by a order by b) 表示以a字段进行分组,再以b字段进行排序,对数据进行查询
只有一个表时,再查找时,把他想象两张一样的表进行两表,联查查找
编写一个 SQL 查询,查找 `Person` 表中所有重复的电子邮箱。
select email
from person
group by email
having count(email)>1 --->主要是count()统计也可以是重复
写一个 SQL 查询,来删除 `Person` 表中所有重复的电子邮箱,重复的邮箱里只保留 **Id** *最小* 的那个。
delete from Person where Id in       #where id in 是判断
    select Id
    from(
        select *, row_number() over (partition by Email order by Id) rk
        from Person
    ) t1
    where rk>1)
另一个需要着重去考虑的,就是如何找到 “昨天”(前一天),这里为大家介绍两个时间计算的函数:
datediff(日期1, 日期2):
得到的结果是日期1与日期2相差的天数。
SELECT DATEDIFF(day,'2008-12-29','2008-12-30') AS DiffDate ---->日期为正数
如果日期1比日期2大,结果为正;如果日期1比日期2小,结果为负。

select a.ID, a.date
from weather as a cross join weather as b
     on datediff(a.date, b.date) = 1
where a.temp > b.temp;
MySQL Str to Date (字符串转换为日期)函数:str_to_date(str, format)
MySQL Date/Time to Str(日期/时间转换为字符串)函数:date_format(date,format), time_format(time,format)
| date_format('2008-08-08 22:23:01', '%Y%m%d%H%i%s') |
+----------------------------------------------------+
| 20080808222301 |
select FROM_UNIXTIME(1156219870);
输出:2006-08-22 12:11:10
Select UNIX_TIMESTAMP('2006-11-04 12:23:00');
输出:1162614180
SQL里删除表时的用法
delete from 表名 where 删除字段(要求) in + 查询语句
mod函数(a,b) : 再 SQL 中的意思是a/b 的余数
用法: mod(id, 2)=1 指的id是奇数
mod(id,2 )=0 是指id为偶数
id % 2 =0 指id是偶数
id % 2 =1 指id是奇数
concat函数的用法 (拼接)
语法:concat(str1, str2,…)
select concat(',','11','22',NULL);
NULL
返回结果为连接参数产生的字符串,如果有任何一个参数为null,则返回值为null。
对于mysql 的 like 而言,一般都要用 like concat() 组合,可以防止sql注入。 在mybatis 中就可以这么写:
select * from region A where A.region_name like concat( ‘%’ , ‘#{region_name}’ , ‘%’ )
concat-ws 函数的用法
语法:concat(str1, str2,…)
concat_ws(',','11','22','33,'null')
11,22,33
presto的简介
Presto是Facebook旗下的一款基于Hadoop的一个开源的分布式SQL查询引擎,适用于交互式查询,数据量支持GB到PB字节。
比hive的查询速度快,presto是基于内存的,而hive是基于磁盘的
SQL里为什么要设置分层呢?
1 对数据进行规划管理
2 利于后期的维护工作
3 保证数据更加清晰化
为啥建模
访问性能:能够快速查询所需的数据,减少数据I/O
数据成本:减少不必要的数据冗余,实现计算结果数据复用,降低大数据系统中的存储成本和计算成本
使用效率:改善用户应用体验,提高使用数据的效率
数据质量:改善数据统计口径的不一致性,减少数据计算错误 的可能性,提供高质量的、一致的数据访问平台
更多推荐

 22
 0
- 0


 已为社区贡献1条内容

所有评论(0)