
数据结构——查找3_哈希表
什么是哈希表
哈希(散列)函数
哈希函数f(key)是关键字key与记录(关键字所对应的内容)在表中的存储位置之间的一个函数关系。以函数f(key) 作为关键字 key 的记录在表中的位置
- 哈希函数是一个映象,即: 将关键字的集合映射到某个地址集合上。 哈希函数的设定很灵活,只要是的任何关键字对应的哈希函数值都落在表长允许范围内即可。
- 冲突:对不同的关键字可能得到同一哈希地址,即: key1
key2,而 f(key1) = f(key2)。
- 具有相同函数值的关键字对于该哈希函数来说称作同义词
- 在一般情况下,哈希函数是一个压缩映象,不可避免产生冲突。因此,在建造哈希表时,不仅要设定一个好的哈希函数,而且要设定一种处理冲突的方法。
哈希表
哈希表定义
根据设定的哈希函数H(key)和处理冲突的方法将一组关键字映像到一个有限的连续的地址集(区间)上,并以关键字在地址集中的“像”作为记录在表中的存储位置,这种表便称为哈希表。[可理解为哈希表是由哈希函数和记录的存储位置组成]
这一映像过程称为哈希造表或散列,所得存储位置称哈希地址或散列地址。

哈希表/散列的设计
- 有限连续地址空间——装填因子
- 散列函数的设计合理
- 发生冲突能够处理
装填因子: 填满程度,记为α,α=关键字的个数/表长(或者说:真实数量/空间大小)
常取值于[0.65,0.9](取值0.9:多开辟空间以适应冲突发生)
构造哈希函数
基本原则
- 值域内:哈希函数值在分配的散列表长度空间内。
- 简单性:哈希函数的计算都很简单。
- 均匀性:哈希函数的输出结果尽量均匀的分布在整个地址取值空间上(换句话说,任意关键字经哈希函数映像到地址集合中任何一个地址的概率时相等的),此类函数为均匀哈希函数
实际工作中需视不同的情况采用不同的哈希函数。通常,考虑的因素有:
(1)计算哈希函数所需时间(包括硬件指令的因素);
(2)关键字的长度;
(3)哈希表的大小;
(4)关键字的分布情况;
(5)记录的查找频率。
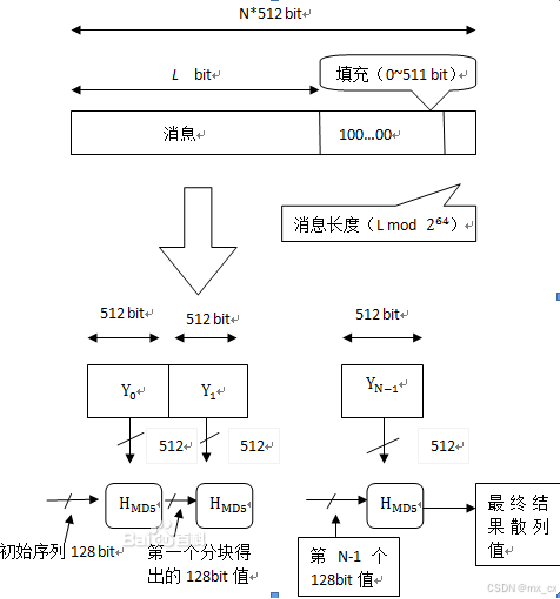
实际中使用的散列技术往往是复杂的综合体,极尽可能的使用找不到反函数的数学工具,例如著名的加密算法MD5(填充→分段→迭加式散列):
直接定址法(常用)
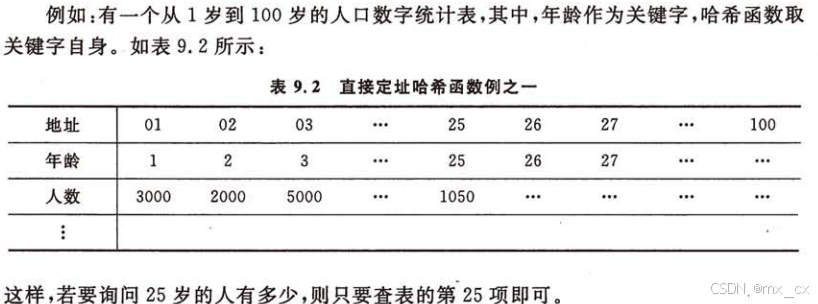
取关键字或关键字的某个线性函数值为哈希地址。即:
H(key) = key或H(key) = a*key + b(a,b为常数)
这种哈希函数叫做自身函数。
例1:
例2:
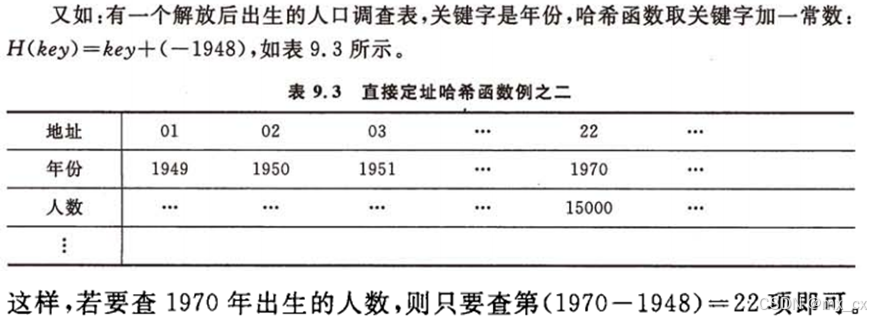
由于直接定址所得地址集合和关键字集合的大小相同。因此,对于不同的关键字不会发生冲突。但实际中能使用这种哈希函数的情况很少。
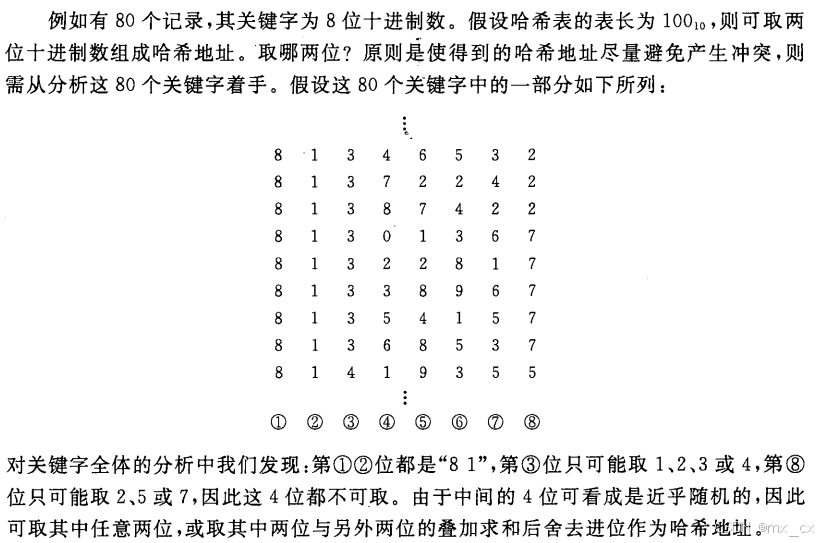
数字选择法
假设关键字是以r为基的数(如:以10为基的十进制数),并且哈希表中可能出现的关键字都是事先知道的,则可取关键字的若干数位组成哈希地址。
平方取中法
取关键字平方后的中间几位为哈希地址。
这是一种较常用的构造哈希函数的方法。通常在选定哈希函数时不一定能知道关键字的全部情况,取其中哪几位也不一定合适。而一个数平方后的中间几位数和数的每一位都相关,由此使随机分布的关键字得到的哈希地址也是随机的。取的位数由表长决定。、
例如:
(0100,0110,1010,1001,0111)关键字的平方结果是: (0010000,0012100,1020100,1002001,0012321)
若表长为1000,则可取中间三位作为散列地址集:(100, 121, 201, 020, 123)
折叠法
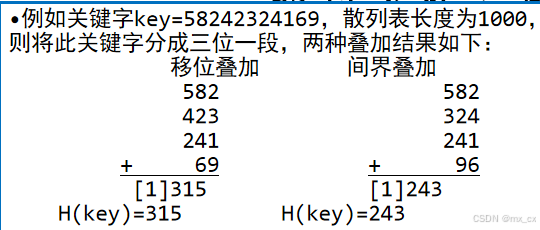
将关键字分割成位数相同的几部分(最后一部分的位数可以不同),然后取这几部分的叠加和(舍去进位)作为哈希地址,这方法称为折叠法(folding)。
- 关键字位数很多,而且关键字中每一位上数字分布大致均匀时,可以采用折叠法得到哈希地址。
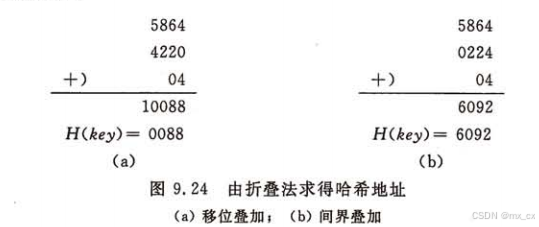
- 在折叠法中数位叠加可以有移位叠加和间界叠加两种方法。移位叠加是将分割后的每一部分的最低位对齐,然后相加;间界叠加是从一端向另一端沿分割界来回折叠,然后对齐相加。
例1:每一种西文图书都有一个国际标准图书编号(ISBN),它是一个10位的十进制数字,若要以它作关键字建立一个哈希表,当馆藏书种类不到10000时,可采用折叠法构造一个四位数的哈希函数。如国际标准图书编号0-442-20586-4的哈希地址分别如9.24(a)和(b)所示。
例2:
除留余数法(常用)
取关键字被某个不大于哈希表表长m的数p除后所得余数为哈希地址。即
H(key) = key MOD p,pm
- 这是一种最简单,也最常用的构造哈希函数的方法。它不仅可以对关键字直接取模(MOD),也可在折叠、平方取中等运算之后取模。
- 值得注意的是,在使用除留余数法时,对p的选择很重要。若p选的不好,容易产生同义词。
- 一般地选p为小于或等于散列表长度m的某个最大素数比较好
例1:
假设取标识符在计算机中的二进制表示为它的关键字(标识符中每个字母均用两位八进制数表示),然后对p=26取模。这个运算在计算机中只要移位便可实现,将关键字左移直至只留下最低的6位二进制数。这等于将关键字的所有高位值都忽略不计。因而使得所有最后一个字符相同的标识符,如al,il,templ,cp1等均成为同义词。
例2:
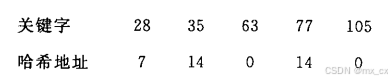
若p含有质因子pf,则所有含有pf因子的关键字的哈希地址均为pf的倍数。例如,当p=21(=3×7)时,下列含因子7的关键字对21取模的哈希地址均为7的倍数。
随机数法
选择一个随机函数,取关键字的随机函数值为它的哈希地址,即H(key)=random(key),其中random为随机函数。
通常,当关键字长度不等时采用此法构造哈希函数较恰当。
基数转换法
(b1b2…bt)p=(a1a2a3a4a5…an)q ,其中p与q互素
例如: 给定一个十进制数的关键字为(210485)10,我们把它看成以13为基数的十三进制(210485)13,
再把它转换为十进制: (210485)13=2*13^5+1*13^4+0*13^3+4*13^2+8*13+5=(771932)10
假设散列表长度10000,则可取低四位1932作为散列地址。
处理冲突的方法
开放定址法(常见)
基本思想:在发生冲突时,利用不同和哈希函数再求得一个哈希地址,直到不出现冲突为止。
Hi = ( H(key) + di ) MOD m i=1, 2, …, k(km-1)
其中:H(key)为哈希函数;m为哈希表表长;di为增量序列,可有下列3种取法:
(1)d1=1,2,3,…,m-1,称线性探测再散列;(从后往前依次探测,默认情况下直接往后填,顺序填)
(2)d1=1^2,-1^2,2^2,-2^2,3^2,…,±k^2,(≤m/2)称二次探测再散列;
(3)di=伪随机数序列或者di=i×H2(key) (又称双散列函数探测),称伪随机探测再散列。
例1:
关键字集合 { 19, 01, 23, 14, 55, 68, 11, 82, 36 }
设定哈希函数 H(key) = key MOD 11 ( 表长=11 )
若采用线性探测再散列处理冲突(下标为需探测的次数 )
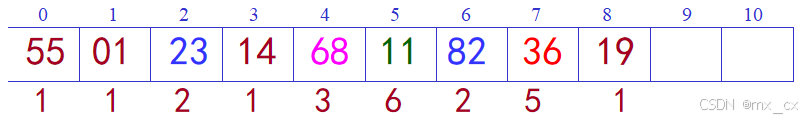
查找长度(ASL):ASL(success)=(1+1+2+1+3+6+2+5+1)/9
[探测次数之和/要探测(查找)的个数]
ASL(fail)=(10+1+1+2+1+3+6+2+5+1)/11(0-10,哈希函数的返回值有11个)
[(探测次数之和+查找到最后一个空要探测的次数)/哈希函数返回值的个数(与表长无关)]
若采用二次探测再散列处理冲突
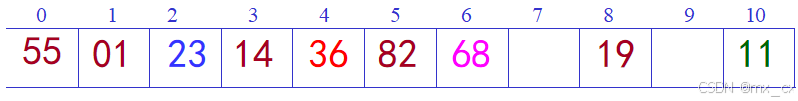
例2:
H2(key) 是另设定的一个哈希函数,它的函数值应和 m 互为素数。
若 m 为素数,则 H2(key) 可以是 1 至 m-1 之间的任意数;
若 m 为 2 的幂次,则 H2(key) 应是 1 至 m-1 之间的任意奇数。
关键字集合:{ 19, 01, 23, 14, 55, 68, 11, 82, 36 }
当 m=11时,可设 H2(key)=(3 key) MOD 10+1
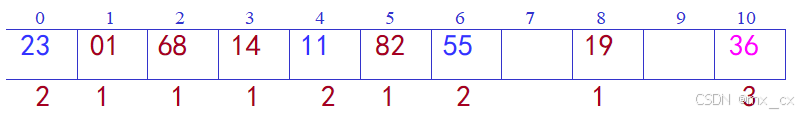
例3:
已知一组关键字集(26,36,41,38,44,15,68,12,06,51,25) 试构造这组关键字的散列表。
α=0.75 ,m= =15,m为表长,所以散列表为HT[15]。
散列函数为:H(key)=key%13
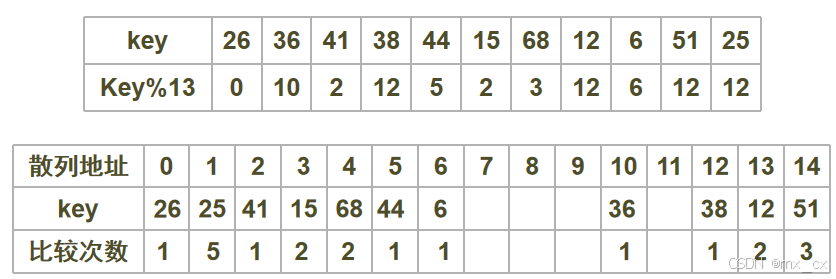
开放寻址法的C语言实现
typedef struct// 散列表{
 ElemType *elem;
 int count;
 int sizeindex
} HashTable;

/*===============================================
函数功能:线性探查法数据查找
函数输入:散列表顺序表指针,要查找的关键字的值
函数输出:找到的关键字所处的位置,或者未找到关键字返回-1
===============================================*/

int H(KeyType k);   //此为散列函数值计算函数
int SearchHash(HashTable H, KeyType k,int &p,int &c)
{
 p=Hash(k);            // d为散列地址
 while (&&(H.elem.[p].key!=k)&&(H.elem.[p].key !=Null))
  collision(p,++c);    //{   i++;d=(d+1) % M}
 if(H.elem.[p].key ==k) return success;
 return usuccess;
}
/*===============================================
函数功能:线性探查法数据插入
函数输入:散列表顺序表指针,要插入的结点
函数输出:无
===============================================*/
void InSertHash (hashtable &H, Elemtype e)
{
   c=0;
   if(SearchHash(H,e.key,p,c)) return DUPLICATE
   else  if (c<hasesize[H.sizeindex]/2)
   {  H.elem[p]=e;++H.count;return  OK; }
   else
   {RecreateHashtable(H); return UNSUCCESS;}
}
开放定址法下的删除
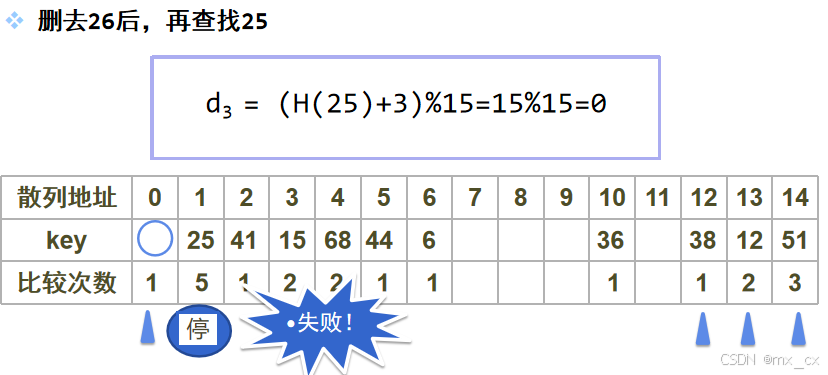
解决方法:删除的数据所在位置需做标记
再哈希法-哈希树
H1 = RH(key) i =1,2, ... ,k
RH(i)均是不同的哈希函数,即在同义词产生地址冲突时计算另一个哈希函数地址,直到冲突不再发生。这种方法不易产生“聚集”,但增加了计算的时间。
例:
已知一组关键字集(26,36,41,38,44,15,68,12,06,51,25) 试构造这组关键字的散列表。
由于该11个数取值范围在6~68,则可取两个散列函数分别为 H(key)=key%7 ,H(key)=key%11
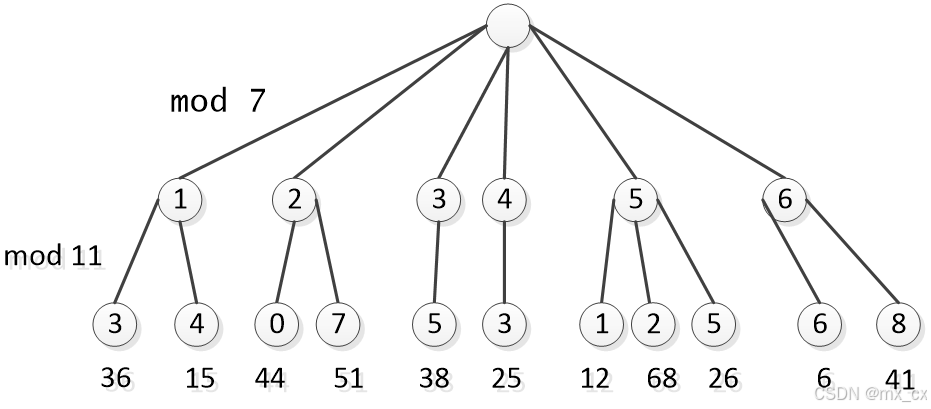
链表地址法(常见)
将所有关键字为同义词的记录存储在同一线性链表中。假设某哈希函数产生的哈希地址在区间[0,m-1]上,则设立一个指针型向量Chain ChainHash[m];
其每个分量的初始状态都是空指针。凡哈希地址为i的记录都插入到头指针为ChainHash[i]的链表中。在链表中的插入位置可以在表头或表尾;也可以在中间,以保持同义词在同一线性链表中按关键字有序。
例1:已知一组关键字集(26,36,41,38,44,15,68,12,06,51,25) 试构造这组关键字的散列表。 仍取散列函数为:H(key)=key%13,散列表为HT[13]
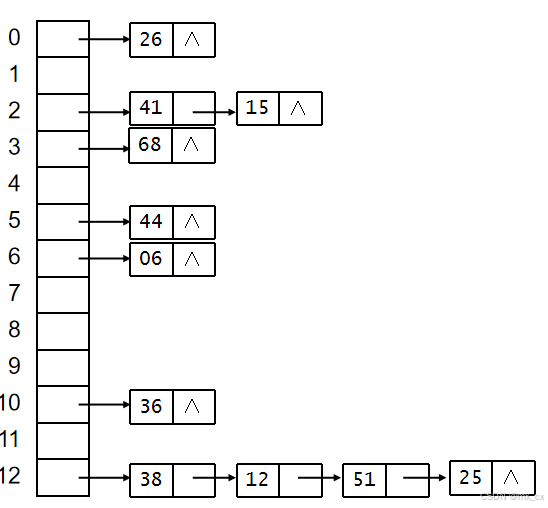
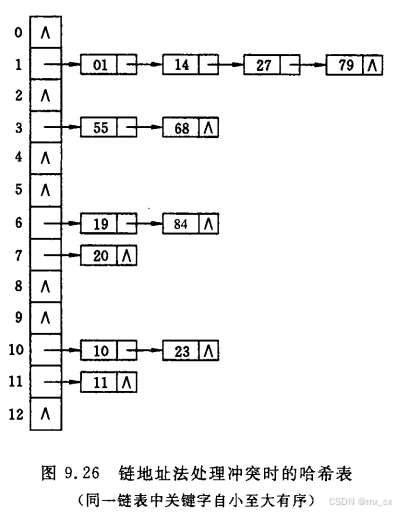
例2:已知一组关键字为(19,14,23,01,68,20,84,27,55,11,10,79)则按哈希函数H(key)=key MOD 13 和链地址法处理冲突构造所得的哈希表如图所示。
链地址法(拉链法)的实现
typedef struct NodeType
{
  KeyType key;
  DataType other;
  struct NodeType *next;
} ChainHash;
ChainHash *HTC[m];

/*===============================================
函数功能:拉链法下的数据查找
函数输入:散列表顺序表首地址,要查找的关键字的值
函数输出:找到的关键字所处的位置,或者未找到关键字返回空指针
===============================================*/
int H(KeyType k);        //此为散列函数值计算函数
ChainHash *ChnSrch(ChainHash *HTC[ ], keytype k)
{
ChainHash *p;
   p=HTC[H(k)];         // 取k所在链表的头指针
   while (p && (p->key ! =k))  p=p->next;      // 顺序查找
   return p;            // 查找成功,返回结点指针,否则返回空指针
}


/*===============================================
函数功能:拉链法数据插入
函数输入:散列表顺序表首地址,要插入的结点
函数输出:无
===============================================*/
void ChnIns(ChainHash *HTC[ ],*s)
{
int d ;
ChainHash *p;
p= ChnSrch (HTC,s->key);      // 查看表中有无待插结点
if (p)  printf(“ERROR”);      // 表中已有该结点
else { d=H(s->key);  s->next=HTC[d].next;  HTC[d].next=s; } // 插入s
}
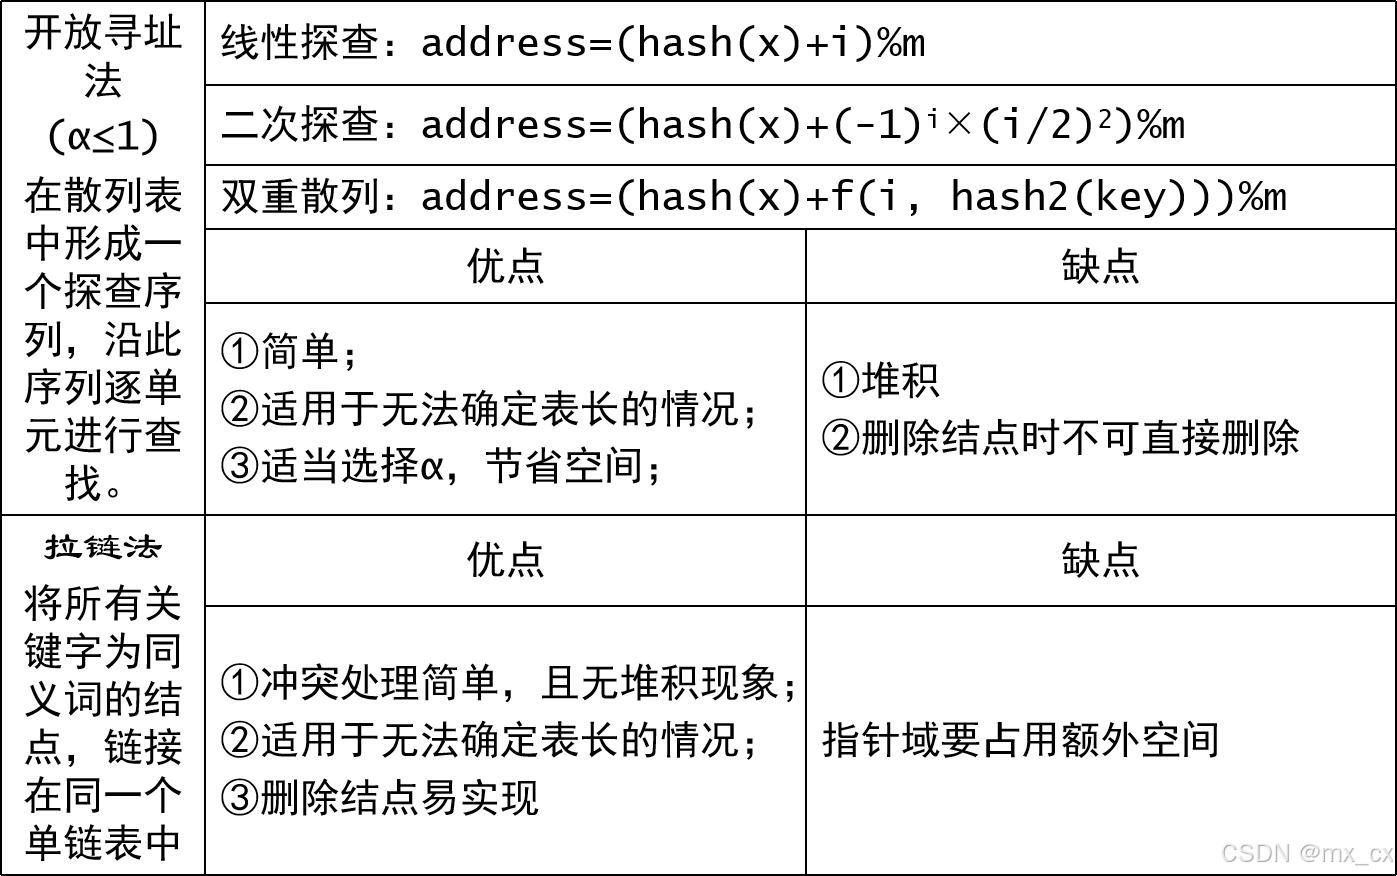
开放寻址法vs.链表地址法
哈希表查找的分析
从查找过程得知,哈希表查找的平均查找长度实际上并不等于零。
决定哈希表查找的ASL的因素:
1) 选用的哈希函数;
2) 选用的处理冲突的方法;
3) 哈希表饱和的程度,装载因子 α=n/m 值的大小(n—记录数,m—表的长度)
一般情况下,可以认为选用的哈希函数是“均匀”的,则在讨论ASL时,可以不考虑它的因素。因此,哈希表的ASL是处理冲突方法和装载因子的函数。
可以证明:查找成功时有下列结果(不用记公式,会算即可):
线性探测再散列:
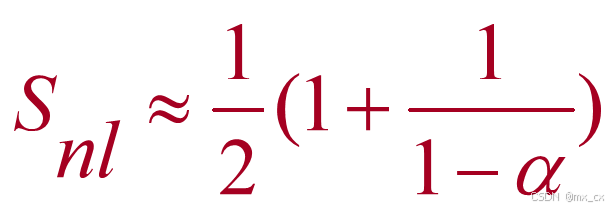
链地址法:
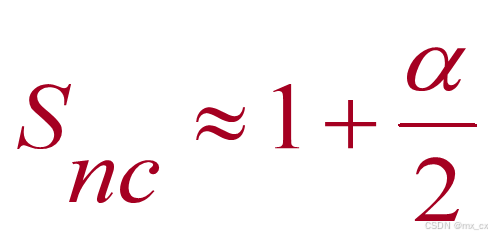
从以上结果可见:
哈希表的平均查找长度是的函数,而不是 n 的函数(注意,
也是n的函数)。
这说明,用哈希表构造查找表时,可以选择一个适当的装填因子 ,使得平均查找长度限定在某个范围内。— 这是哈希表所特有的特点。
更多推荐


 55
 0
- 0


 已为社区贡献1条内容

所有评论(0)