
案例:shell脚本安装elk
介绍
ELK是Elasticsearch(ES) , Logstash, Kibana的结合,是一个开源日志收集软件。
Elasticsearch 开源分布式搜索引擎,提供存储、分析、搜索功能。特点:分布式、基于reasful风格、支持海量高并发的准实时搜索场景、稳定、可靠、快速、使用方便等。 接收搜集的海量结构化日志数据,并提供给Kibana查询分析。
Logstash 开源日志搜集、分析、过滤框架,支持多种数据输入输出方式。 用于收集日志,对日志进行过滤形成结构化数据,并转发到Elasticsearch中。
Kibana 开源日志报表系统,对Elasticsearch以及Logstash有良好的web页面支持。 对Elasticsearch提供的数据进行分析展示。
新增的Filebeat是一个轻量级的日志收集处理工具(Agent),占用资源少,,可以在各服务器上搜集信息,传输给Logastash。
1、问题:
1.)logs 目录可能因为权限问题无法创建,或者指定的日志路径包含错误,导致脚本无法生成日志文件
2.)如果不是以 root 用户身份运行该脚本,会输出 "请用root用户执行此脚本!" 并退出。
3.) fdisk -l 需要 root 权限查看磁盘信息,如果未以 root 身份运行该命令,会报错 permission denied
4.)启动服务时,脚本页面很杂乱
2、分析:
1. ) 确保脚本在可写的目录下运行,或者修改脚本中的日志路径,使其指向一个有写权限的目录。
2. ) 要用 root 用户或使用 sudo 提升权限来执行该脚本:
bash
sudo ./script_name.sh
3.)可以将服务进行后台(nohup)运行
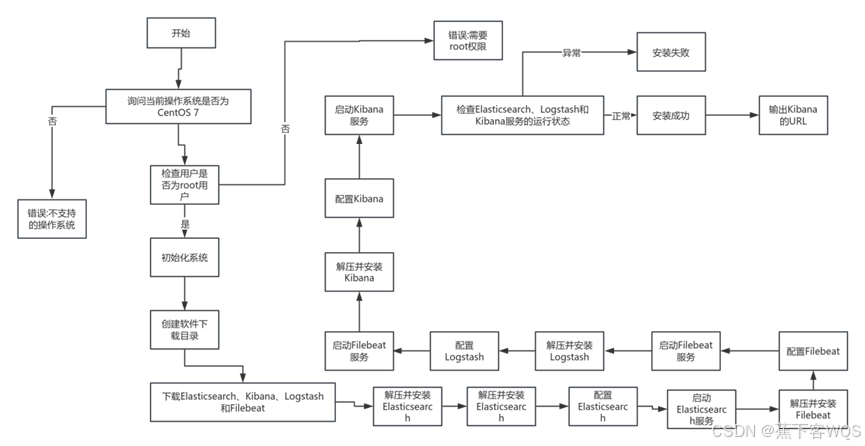
3、流程图:
4、实现
#!/bin/bash
# 清屏操作,用于在脚本开始时清理终端屏幕,使输出更加清晰
clear
#输出脚本的相关提示信息,告知用户脚本的功能以及如何取消或继续操作
echo "##########################################"
echo "#       Auto Install ELK.               ##"
echo "#       Press Ctrl + C to cancel        ##"
echo "#       Any key to continue             ##"
echo "##########################################"
# 定义环境及目录变量
# 定义软件下载存放的目录路径
software_dir="/usr/local/software"
# Elasticsearch软件的下载链接
elasticsearch_url="https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-5.4.1.tar.gz"
# Kibana软件的下载链接
kibana_url="https://artifacts.elastic.co/downloads/kibana/kibana-5.4.1-linux-x86_64.tar.gz"
# Logstash软件的下载链接
logstash_url="https://artifacts.elastic.co/downloads/logstash/logstash-5.4.1.tar.gz"
# Filebeat软件的下载链接
filebeat_url="https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-5.4.1-linux-x86_64.tar.gz"
# 获取系统版本信息,通过读取 /etc/redhat-release 文件,提取版本号的主版本部分
sys_version=`cat /etc/redhat-release |awk '{print $4}'|cut -d. -f1`
# 获取本机IP地址,通过解析网络接口信息,过滤掉本地回环地址(127.0.0.1)后提取IP地址
IP=`ip addr|grep "inet "|grep -v 127.0.0.1|awk '{print $2}'|cut -d/ -f1`
# Elasticsearch的JVM配置文件路径
jvm_conf="/usr/local/elasticsearch/config/jvm.options"
# 获取系统内存大小,以GB为单位(通过获取总内存大小,转换为GB并取整)
sys_mem=`free -m|grep Mem:|awk '{print $2}'|awk '{sum+=$1} END {print sum/1024}'|cut -d. -f1`

#下载软件函数,
wget_fun() {
  # 判断软件下载目录是否不存在,如果不存在则创建该目录并进入该目录,否则直接进入该目录
if [ ! -d ${software_dir} ];then
        mkdir -p ${software_dir} && cd ${software_dir}
else
        cd ${software_dir}
fi
 # 循环遍历定义的各个软件下载链接,使用wget命令进行下载,-c参数表示支持断点续传
for software in $elasticsearch_url $kibana_url $logstash_url $filebeat_url
do
        wget -c $software
done
 # 下载完成后清屏
clear
}
# 初始化系统,安装java环境,设置主机名称,禁用防火墙
init_sys() {
# 如果 /etc/init.d/functions 文件存在,则加载其中的函数定义
[ -f /etc/init.d/functions ] && . /etc/init.d/functions
 # 检查系统版本是否不是Centos7,如果不是则输出错误信息并退出脚本
[ "${sys_version}" != "7" ] && echo "Error:This Scripts Support Centos7.xx" && exit 1
# 检查当前用户是否为root用户,如果不是则输出错误信息并退出脚本
[ $(id -u) != "0" ] && echo "Error: You must be root to run this script" && exit 1
# 将SELinux配置为禁用状态,先修改配置文件,再通过setenforce命令立即生效
sed -i "s/SELINUX=enforcing/SELINUX=disabled/"  /etc/selinux/config
setenforce 0
 # 使用yum安装Java 1.8.0 OpenJDK、wget工具和net-tools工具包
yum install -y java-1.8.0-openjdk wget net-tools
# 设置主机名称为elk-server
hostnamectl set-hostname elk-server
# 停止防火墙服务
systemctl stop firewalld
# 修改文件/进程打开数,将相关配置添加到 /etc/security/limits.conf 文件末尾
cat >>/etc/security/limits.conf<<EOF
* soft nofile 65536
* hard nofile 65536
* soft nproc 65536
* hard nproc 65536
EOF
}

# 安装elasticsearch
install_elasticsearch() {
# 进入软件下载目录
cd $software_dir
# 解压Elasticsearch软件包
tar zxf elasticsearch-5.4.1.tar.gz
 # 将解压后的Elasticsearch目录移动到指定的安装目录 /usr/local/elasticsearch
mv elasticsearch-5.4.1 /usr/local/elasticsearch
# 创建Elasticsearch的数据目录和日志目录
mkdir -p /usr/local/elasticsearch/data /usr/local/elasticsearch/logs
# 增加用户
useradd elasticsearch
#修改Elasticsearch安装目录及其子目录的属主和属组为elasticsearch用户
chown -R elasticsearch:elasticsearch /usr/local/elasticsearch
# 设置系统参数vm.max_map_count,将其值添加到 /etc/sysctl.conf 文件中并使其立即生效
echo "vm.max_map_count = 655360" >>/etc/sysctl.conf && sysctl -p
# 修改配置文件
if [ ${sys_mem} -eq 0 ];then
 # 如果系统内存为0(可能获取失败等情况),则将JVM的最大和最小堆内存设置为512m
        sed -i "s#`grep "^-Xmx" ${jvm_conf}`#"-Xmx512m"#g" ${jvm_conf}
        sed -i "s#`grep "^-Xms" ${jvm_conf}`#"-Xms512m"#g" ${jvm_conf}
else
# 如果系统内存获取正常,则根据系统内存大小设置JVM的最大和最小堆内存
        sed -i "s#`grep "^-Xmx" ${jvm_conf}`#"-Xmx${sys_mem}g"#g" ${jvm_conf}
        sed -i "s#`grep "^-Xms" ${jvm_conf}`#"-Xms${sys_mem}g"#g" ${jvm_conf}
fi
# 向Elasticsearch的配置文件 elasticsearch.yml 中添加配置信息
cat >>/usr/local/elasticsearch/config/elasticsearch.yml<<EOF
cluster.name: my-application
node.name: elk-server
path.data: /usr/local/elasticsearch/data
path.logs: /usr/local/elasticsearch/logs
network.host: 127.0.0.1
http.port: 9200
discovery.zen.ping.unicast.hosts: ["elk-server"]
EOF
# 切换到elasticsearch用户,在后台启动Elasticsearch服务
su - elasticsearch -c "nohup /usr/local/elasticsearch/bin/elasticsearch &"
}

#安装 logstash
install_logstash() {
# 进入软件下载目录
cd $software_dir
 # 解压Logstash软件包
tar -zxf logstash-5.4.1.tar.gz
 # 将解压后的Logstash目录移动到指定的安装目录 /usr/local/logstash
mv logstash-5.4.1 /usr/local/logstash
#  创建Logstash的配置文件 01-syslog.conf,并添加输入输出相关的配置信息
cat>/usr/local/logstash/config/01-syslog.conf<<EOF
input {
        beats {
                port => "5044"
                }
        }
output {
        elasticsearch {
                hosts => "127.0.0.1:9200"
        }
        stdout { codec => rubydebug }
}
EOF
 # 在后台启动Logstash服务,并将输出重定向到空设备(即不显示输出信息)
nohup /usr/local/logstash/bin/logstash -f /usr/local/logstash/config/01-syslog.conf & >/dev/null
}
#安装 filebeat
install_filebeat() {
# 进入软件下载目录
cd $software_dir
# 解压Filebeat软件包
tar -zxf filebeat-5.4.1-linux-x86_64.tar.gz
# 将解压后的Filebeat目录移动到指定的安装目录 /usr/local/filebeat
mv filebeat-5.4.1-linux-x86_64 /usr/local/filebeat
 # 创建Filebeat的配置文件 filebeat.yml,并添加相关配置信息,如日志输入路径和输出到Logstash的主机地址等
cat >/usr/local/filebeat/filebeat.yml<<EOF
filebeat.prospectors:
- input_type: log
  paths:
    - /var/log/*.log
output.logstash:
  hosts: ["127.0.0.1:5044"]
EOF
#进入Filebeat安装目录,在后台启动Filebeat服务,并将输出重定向到空设备
cd /usr/local/filebeat/
nohup /usr/local/filebeat/filebeat & >/dev/null
}

#安装 kibana
install_kibana() {
# 进入软件下载目录
cd $software_dir
# 解压Kibana软件包
tar -zxf kibana-5.4.1-linux-x86_64.tar.gz
# 将解压后的Kibana目录移动到指定的安装目录 /usr/local/kibana
mv kibana-5.4.1-linux-x86_64 /usr/local/kibana
#  向Kibana的配置文件 kibana.yml 中添加配置信息,如端口、主机地址和连接Elasticsearch的URL等
cat >> /usr/local/kibana/config/kibana.yml <<EOF
server.port: 5601
server.host: "0.0.0.0"
elasticsearch.url: http://127.0.0.1:9200
EOF
# 在后台启动Kibana服务,并将输出重定向到空设备
nohup /usr/local/kibana/bin/kibana & >/dev/null
}

# 检测服务函数,用于检查指定端口和程序是否正在运行
check() {
port=$1
program=$2
# 通过netstat命令检查指定端口是否在监听状态,统计匹配结果的行数
check_port=`netstat -lntup|grep ${port}|wc -l`
# 通过ps命令检查指定程序是否正在运行,统计匹配结果的行数(过滤掉grep命令自身的进程)
check_program=`ps -ef|grep ${program}|grep -v grep|wc -l`
 # 如果端口正在监听且程序正在运行,则输出程序运行正常的提示信息,否则输出运行错误的提示信息
if [ $check_port -gt 0 ] && [ $check_program -gt 0 ];then
        action "${program} run is ok!" /bin/true
else
        action "${program} run is error!" /bin/false
fi
}
# 主函数,用于统一调用其他函数完成ELK的安装和检测等一系列操作
main() {
init_sys
wget_fun
install_elasticsearch
install_filebeat
install_logstash
install_kibana
 # 输出检查Elasticsearch的提示信息
echo -e "\033[32m Checking Elasticsearch...\033[0m"
sleep 20
# 检查Elasticsearch服务是否正常运行
check :9200 "elasticsearch"
# 输出检查Logstash的提示信息
echo -e "\033[32m Checking Logstash...\033[0m"
sleep 2
# 检查Logstash服务是否正常运行
check ":9600" "logstash"
# 输出检查Kibana的提示信息
echo -e "\033[32m Checking Kibana...\033[0m"
sleep 2
 # 检查Kibana服务是否正常运行
check ":5601" "kibana"
# 输出ELK安装成功的提示信息
action "ELK install is success!" /bin/true
# 输出Kibana的访问URL
echo "url:http://$IP:5601"
}
# 执行主函数
main
5、实现解析
该脚本的主要目的是在 Centos 7 系统上实现自动化安装和配置 ELK(Elasticsearch、Logstash、Kibana)以及 Filebeat 工具集。它完成了从系统环境初始化、软件下载、各组件安装与配置到服务启动及运行状态检测的一系列操作,最终输出 ELK 安装成功的提示信息以及 Kibana 的访问 URL。
wget_fun函数 - 软件下载
init_sys函数 - 系统初始化
install_elasticsearch函数 - Elasticsearch 安装
install_logstash函数 - Logstash 安装
install_filebeat函数 - Filebeat 安装
install_kibana函数 - Kibana 安装
check函数 - 服务检测
6、结果验证
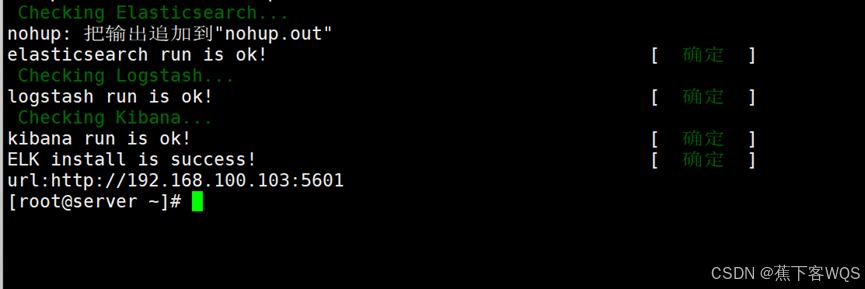
启动脚本如果这些都是确定就可以在浏览器上打开网址
浏览器上输入:http://192.168.100.103(本机服务器地址)
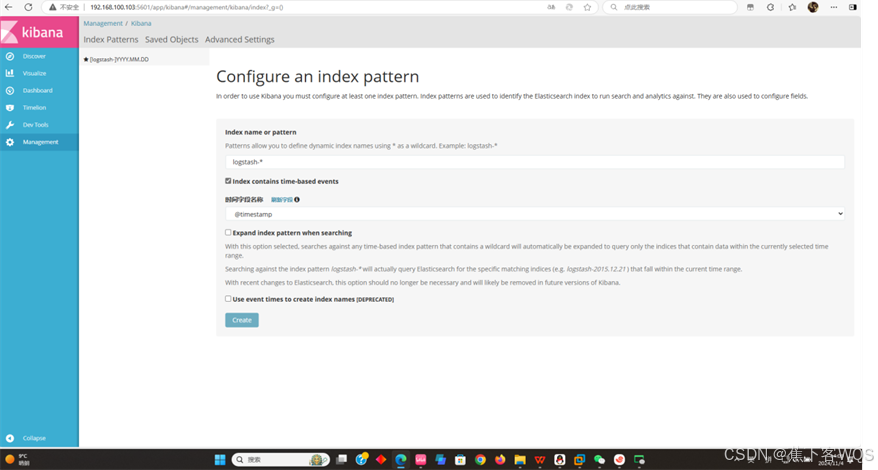
下方的蓝色按钮可以点击即试验成功
更多推荐



 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)