
flume+kafka+doris+fineBi 实时数仓设计文档
·
接下来我模拟一个实时行为数据场景,通过shell产生实时日志,然后flume读取日志并通过kafka削峰并把数据传输到Doris,最后FineBi读取Doris进行可视化大屏展示。架构如下:

1、服务器介绍
|
ip |
操作系统 |
内存 |
硬盘 |
部署的服务 | |
|
172.28.1.114 |
centos |
8G |
200G |
kafka | |
|
172.28.1.115 |
centos |
8G |
200G |
doris | |
|
172.28.1.116 |
centos |
8G |
200G |
fineBI | |
|
172.28.1.117 |
centos |
8G |
200G |
flume |
2、日志模拟器
shell脚本生成日志
#!/bin/bash

# 计算开始时间
START_TIME=$(date +%s%3N)
MIN=1
MAX=100

# 循环插入数据
while true; do
    # 获取当前时间(毫秒级)
    CURRENT_TIME=$(date +%s%3N)

    # 生成一个介于 MIN 和 MAX 之间的随机整数
    random_int1=$((RANDOM % (MAX - MIN + 1) + MIN))
    random_int2=$((RANDOM % (MAX - MIN + 1) + MIN))
    random_decimal=$(awk -v min=30 -v max=150 'BEGIN{srand(); print min + (max-min) * rand()}')
    random_decimal2=$(awk -v min=0 -v max=100 'BEGIN{srand(); print min + (max-min) * rand()}')
    random_decimal3=$(awk -v min=80 -v max=90 'BEGIN{srand(); print min + (max-min) * rand()}')
    random_decimal4=$(awk -v min=40 -v max=50 'BEGIN{srand(); print min + (max-min) * rand()}')

    # 将时间戳转换为可读日期时间格式
    random_ts=$(date -d @"$((CURRENT_TIME / 1000))" +"%Y-%m-%d %H:%M:%S")

    # 生成 JSON
    json=$(cat <<EOF
{
    "ts": "$random_ts",
    "equipment_type": "$random_int1",
    "equipment_id": "$random_int2",
    "speed": "$random_decimal",
    "mileage": "$random_decimal2",
    "longitude": "$random_decimal3",
    "latitude": "$random_decimal4"
}
EOF
    )

    # 写入日志文件
    echo "$json" >> click_log.log

    sleep 1
done
运行脚本
nohup ./generate_json.sh >output.log 2>&1 &
3、flume日志采集
在conf目录创建exec_source_kafka_sink.conf文件
touch exec_source_kafka_sink.conf
文件配置 (实时采集click.log 日志)
# Name the components on this agent
a1.sources = r1
a1.sinks = k1
a1.channels = c1

# Describe/configure the source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /export/click_log/click.log
a1.sources.r1.channels = c1

# Describe the sink
a1.sinks.k1.type = org.apache.flume.sink.kafka.KafkaSink
a1.sinks.k1.kafka.topic = itcast_shop_click_log
a1.sinks.k1.kafka.bootstrap.servers = 172.28.1.114:9092
a1.sinks.k1.kafka.flumeBatchSize = 20
a1.sinks.k1.kafka.producer.acks = 1
a1.sinks.k1.kafka.producer.linger.ms = 1
# a1.sinks.k1.kafka.producer.compression.type = snappy


# Use a channel which buffers events in memory
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100

# Bind the source and sink to the channel
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
Flume 启动
/export/servers/flume-1.8.0/bin/flume-ng agent -c conf -f /export/servers/flume-1.8.0/conf/exec_source_kafka_sink.conf -n a1 -Dflume.root.logger=INFO,console
4、kafka日志传输
创建kafka Topic
bin/kafka-topics.sh --create \
--zookeeper 172.28.1.114:2181 \
--replication-factor 1 \
--partitions 1 \
--topic itcast_shop_click_log
启动kafka,查看是否收集到日志:
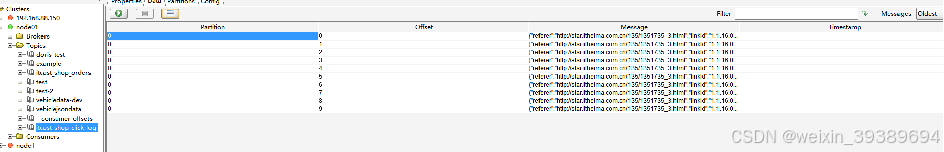
数据流转到kafka成功 !
5、doris 消费kafka中的数据
创建表结构
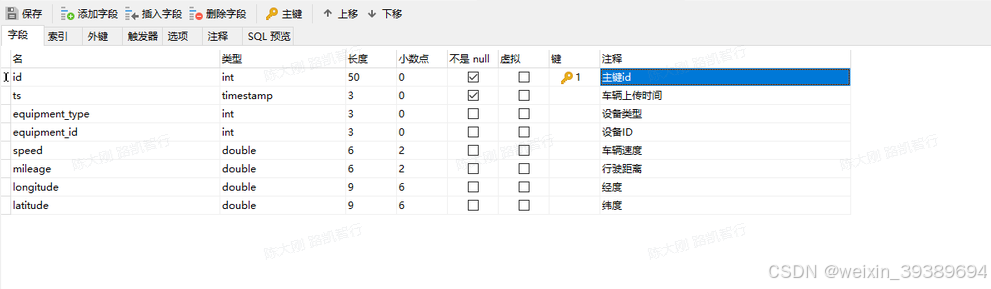
创建将kafka数据导入到doris表的作业:
CREATE ROUTINE LOAD itcast_shop.click_log_kafka_job ON click_log_kafka
COLUMNS(id,referer,linkId,ip,trackTime,guid,sessionId,attachedInfo,url)
PROPERTIES
(
    "desired_concurrent_number"="3",
    "max_batch_interval" = "5",
    "max_batch_rows" = "200000",
    "max_batch_size" = "104857600",
    "format" = "json",
        "jsonpaths" = "[\"$.id\",\"$.ts\",\"$.equipment_type\",\"$.equipment_id\",\"$.speed\",\"$.mileage\",\"$.longitude\",\"$.latitude\"]"
)
FROM KAFKA
(
    "kafka_broker_list"= "172.28.1.114:9092",
    "kafka_topic" = "itcast_shop_click_log",
    "property.group.id" = "test_group_1",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING",
    "property.enable.auto.commit" = "false"
);
作业的启动:
查看导入作业:
SHOW ROUTINE LOAD FOR click_log_kafka_job;
暂停导入作业:
PAUSE ROUTINE LOAD FOR click_log_kafka_job;
恢复导入作业:
RESUME ROUTINE LOAD FOR click_log_kafka_job;
停止导入作业:
STOP ROUTINE LOAD FOR click_log_kafka_job;
6、fineBi 进行数据展示
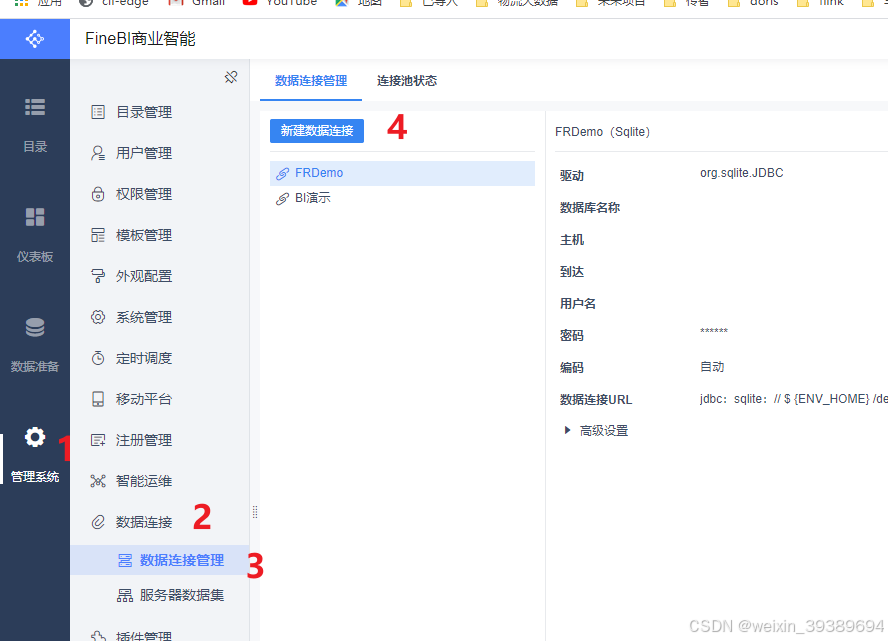
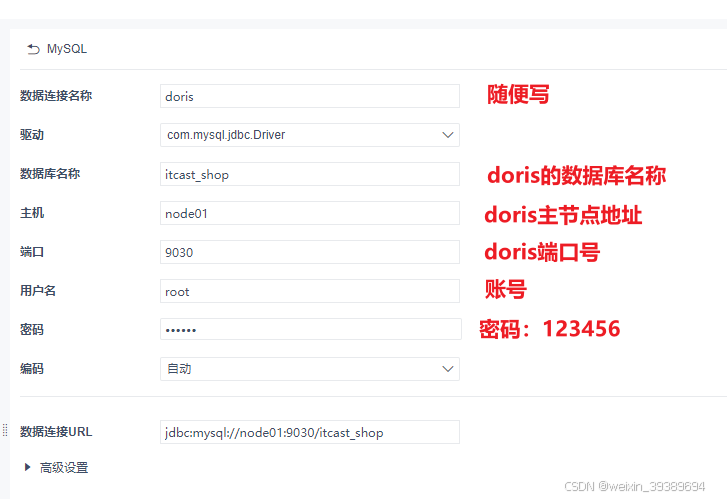
172.28.1.116服务器启动finebi,进行doris连接配置:
选择 mysql (doris 兼容mysql ):
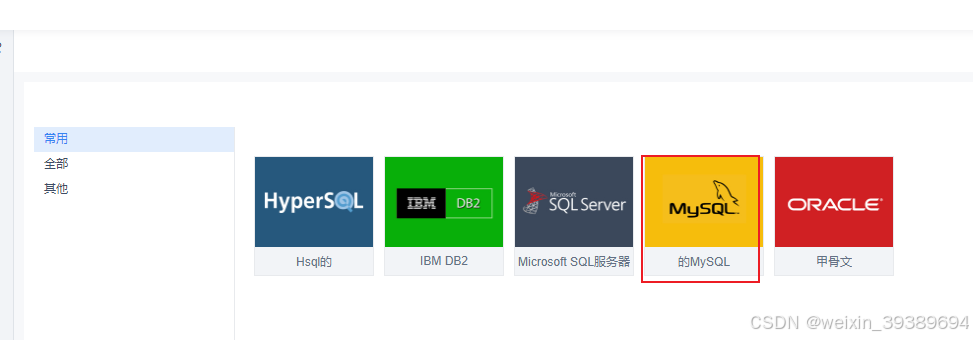
配置doris链接
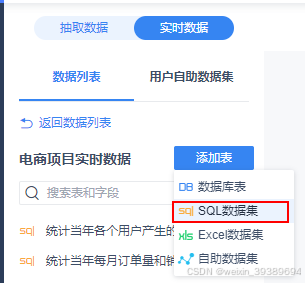
进入业务包, 添加SQL数据集,通过SQL的方式查询Doris。接下来就可以查询doris了 !
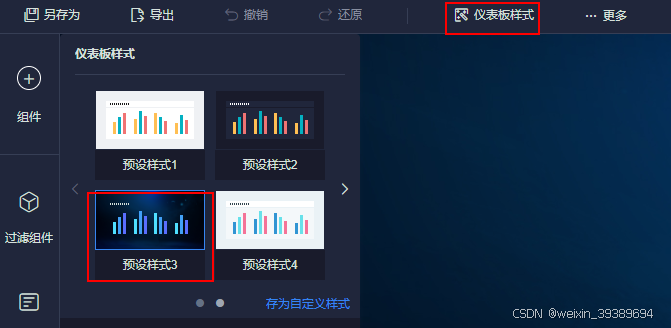
然后就可以在fineBI上通过托拉拽的形式把数据展示在大屏上了 !
更多推荐


 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)