
正则表达式
基本概念:一个正则表达式,就是用某种模式去匹配字符串的一个公式。很多人因为它们看上去比较古怪而且复杂所以不敢去使用,不过,经过练习后,就觉得这些复杂的表达式写起来还是相当简单的,而且,一旦你弄懂它们,你就能把数小时辛苦而且易错的文本处理工作缩短在几分钟(甚至几秒钟)内完成。
一、底层分析
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegTheory {
    public static void main(String[] args) {
        String content = "1998 年 12 月 8 日,第二代 Java 平台的企业版 J2EE 发布。1999 年 6 月,Sun 公司发布了" +
                "第二代 Java 平台(简称为 Java2)的 3 个版本:J2ME(Java2 Micro Edition,Java2 平台的微型" +
                "版),应用于移动、无线及有限资源的环境;J2SE(Java 2 Standard Edition,Java 2 平台的" +
                "标准版),应用于桌面环境;J2EE(Java 2Enterprise Edition,Java 2 平台的企业版),应" +
                "用 3443 于基于 Java 的应用服务器。Java 2 平台的发布,是 Java 发展过程中最重要的一个" +
                "里程碑,标志着 Java 的应用开始普及 9889 ";
//目标:匹配所有四个数字
//说明
//1. \\d 表示一个任意的数字
        String regStr = "(\\d\\d)(\\d\\d)";
//2. 创建模式对象[即正则表达式对象]
        Pattern pattern = Pattern.compile(regStr);
//3. 创建匹配器
//说明:创建匹配器 matcher, 按照 正则表达式的规则 去匹配 content 字符串
        Matcher matcher = pattern.matcher(content);
//4.开始匹配

        while (matcher.find()) {

            System.out.println("第 1 组()匹配到的值=" + matcher.group(1));
            System.out.println("第 2 组()匹配到的值=" + matcher.group(2));
        }
    }
}
matcher.find() 完成的任务 (考虑分组)
1.什么是分组,比如 (\d\d)(\d\d) ,正则表达式中有() 表示分组,第 1 个()表示第 1 组,第 2 个()表示第 2 组...2.根据指定的规则 ,定位满足规则的子字符串(比如(19)(98))
2. 找到后,将 子字符串的开始的索引记录到 matcher 对象的属性 int[] groups;
2.1 groups[0] = 0 , 把该子字符串的结束的索引+1 的值记录到 groups[1] = 4
2.2 记录 1 组()匹配到的字符串 groups[2] = 0 groups[3] = 22.3 记录 2 组()匹配到的字符串 groups[4] = 2 groups[5] = 4
2.4.如果有更多的分组..... *3. 同时记录 oldLast 的值为 子字符串的结束的 索引+1 的值即 4, 即下次执行 find 时,就从 4 开始匹配。
match.group(0)源码分析
matcher.group(0) 分析
*
* 源码:
* public String group(int group) {
* if (first < 0)
* throw new IllegalStateException("No match found");
* if (group < 0 || group > groupCount())
* throw new IndexOutOfBoundsException("No group " + group);
* if ((groups[group*2] == -1) || (groups[group*2+1] == -1))
* return null;
* return getSubSequence(groups[group * 2], groups[group * 2 + 1]).toString();
* }
* 1. 根据 groups[0]=0 和 groups[1]=4 的记录的位置,从 content 开始截取子字符串返回
* 就是 [0,4) 包含 0 但是不包含索引为 4 的位置
*
* 如果再次指向 find 方法.仍然安上面分析来执行
小结
1. 如果正则表达式有() 即分组
2. 取出匹配的字符串规则如下
3. group(0) 表示匹配到的子字符串
4. group(1) 表示匹配到的子字符串的第一组字串
5. group(2) 表示匹配到的子字符串的第 2 组字串
6.但是分组的数不能越界. System.out.println("找到: " + matcher.group(0));
二、元字符
1.字符匹配符
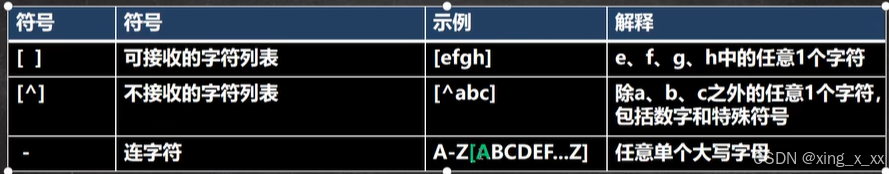
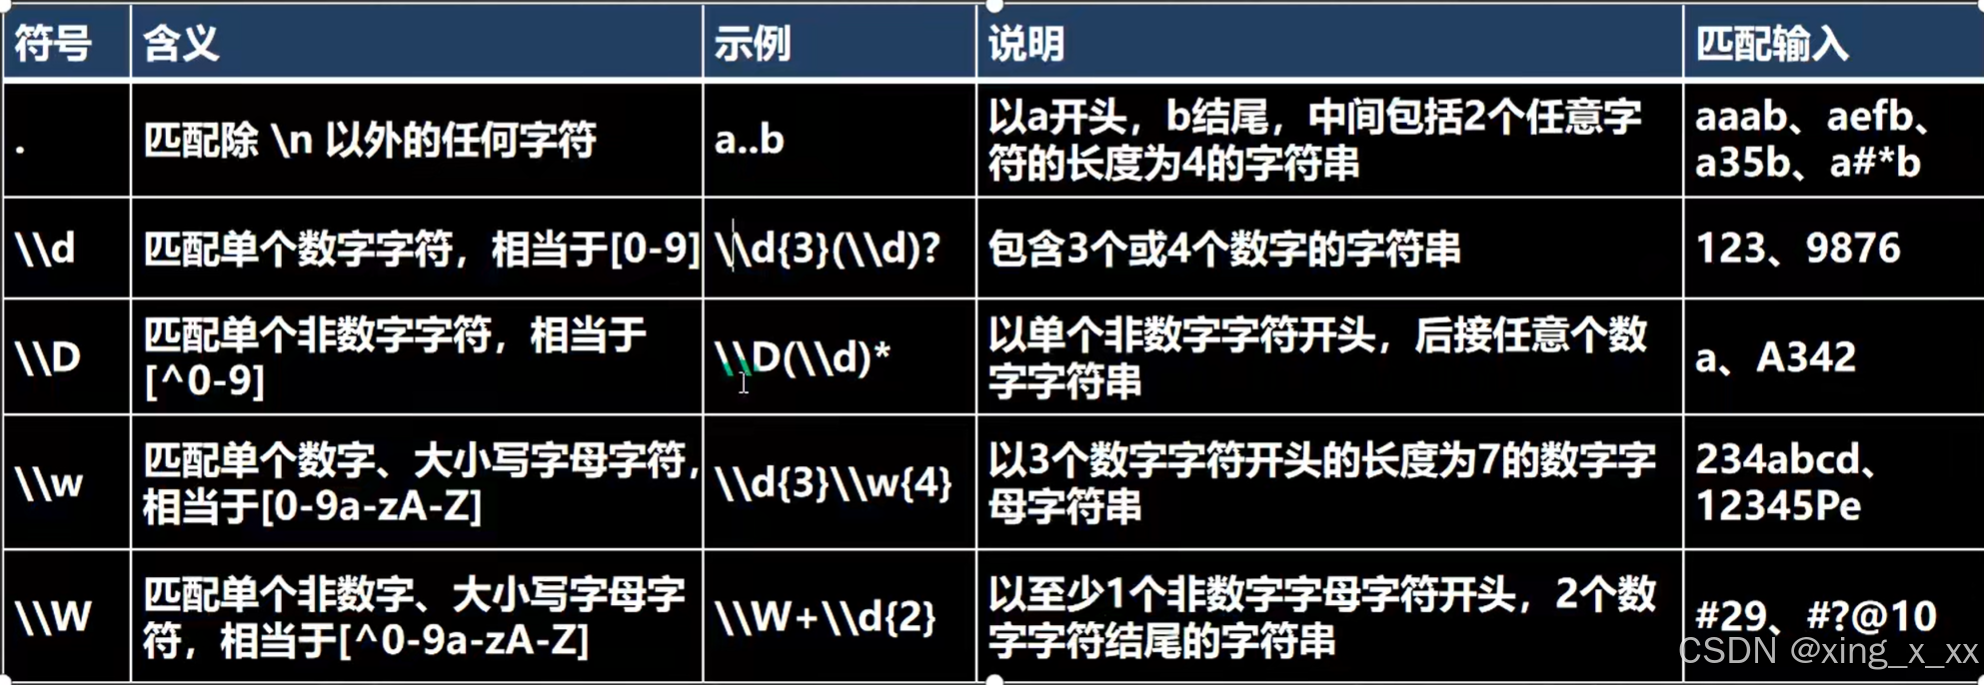
1.java正则表达式默认是区分字母大小写的,
(?i)abc表示abc都不区分大小写;a(?i)bc表示bc不区分大小写;a((?i)b)c表示只有b不区分大小写
2.当创建Pattern对象时,指定Pattern.CASE_INSENSITIVE,表示匹配是不区分字母大小写 Pattern pattern = Pattern.compile(regStr, Pattern.CASE_INSENSITIVE);
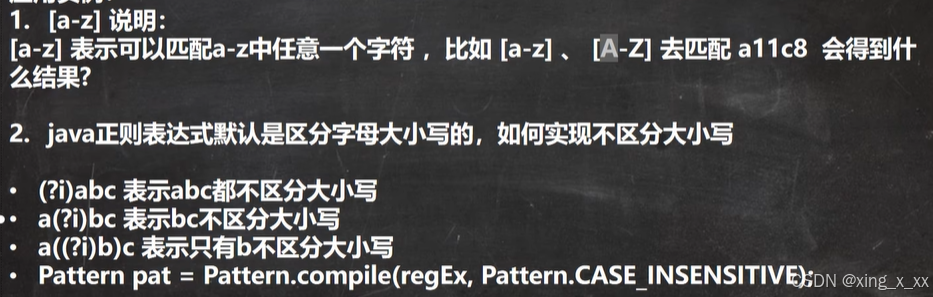
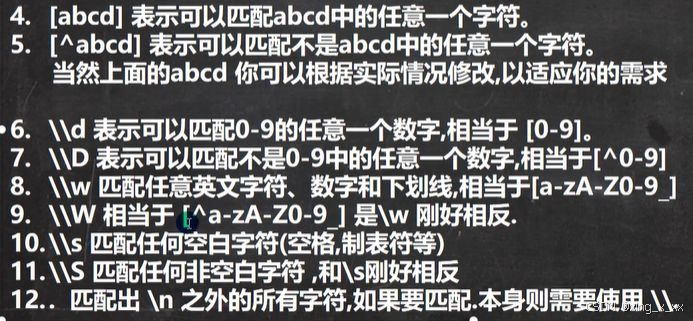
转义号:\\,在java的正则表达式中,两个\\代表其他语言中的一个\。
需要用到转义字符的字符有以下:. * + ( ) $ / \ ? [ ] ^ { }
2.选择匹配符
在匹配某个字符串的时候是选择性的,即:既可以匹配这个,又可以匹配那个,这时需要用到选择匹配符号|

3.限定符
用于指定其前面的字符和组合项连续出现多少次
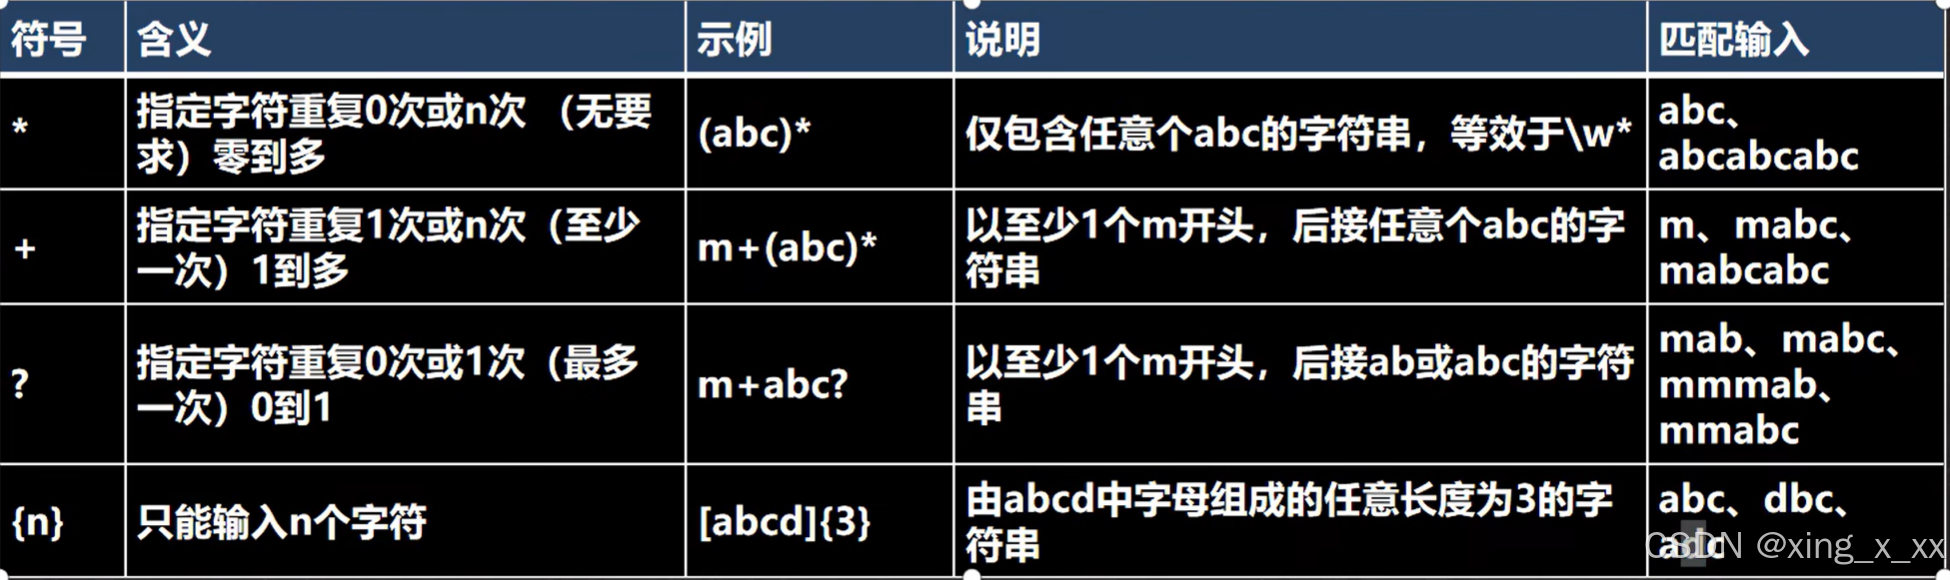
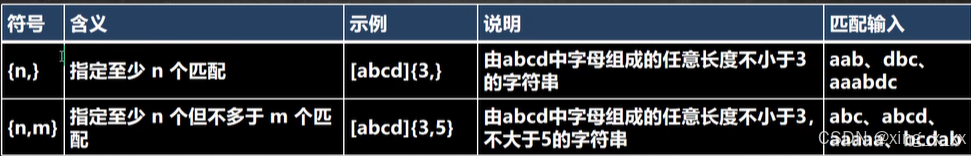
java匹配默认贪婪匹配,尽可能匹配多的。例如:String regStr="\\d{3,4}";当有四个数字时,显示四个数字,而不是只显示其中的三个。
4.定位符
定位符,规定要匹配的字符串出现的位置,比如在字符串的开始还是在结束的位置。
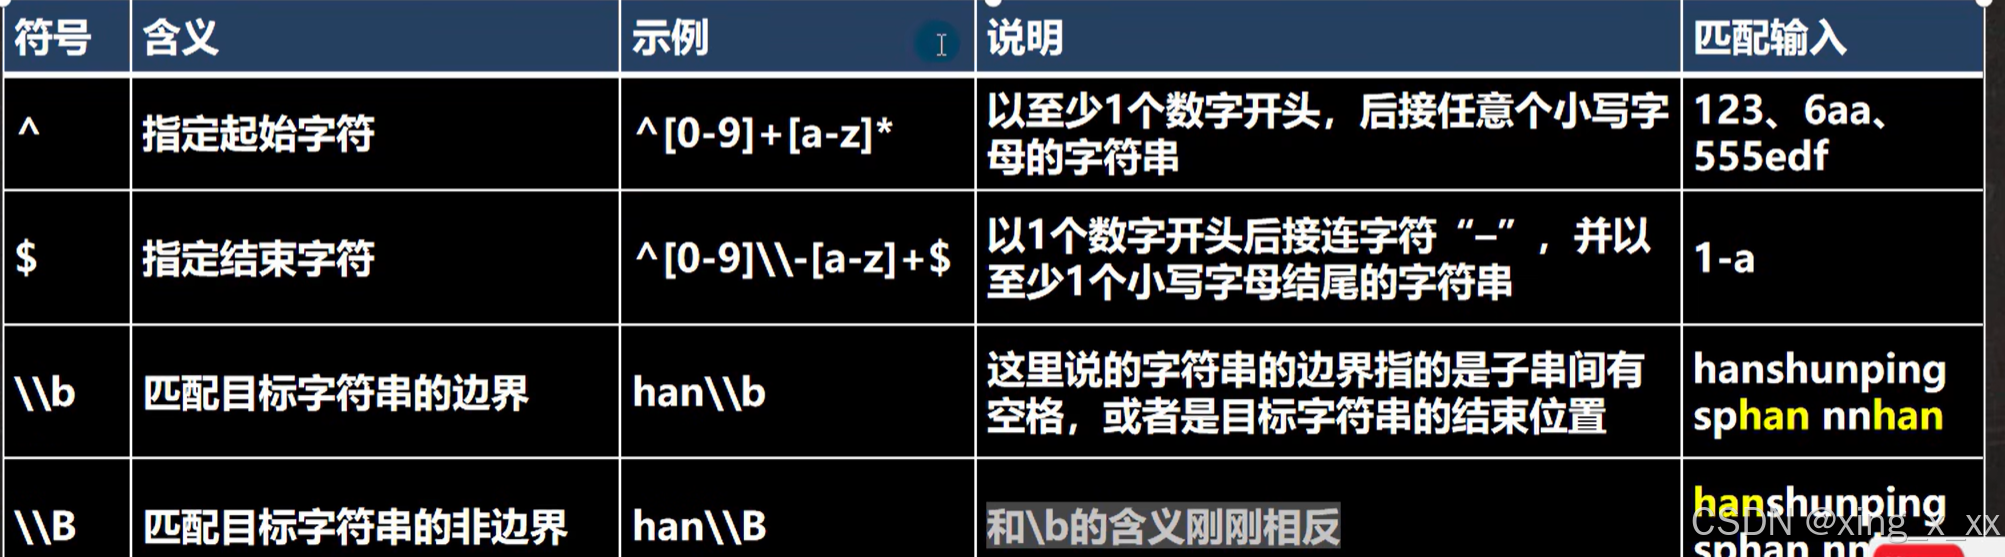
5,分组组合和反向引用符
(1)常见分组形式
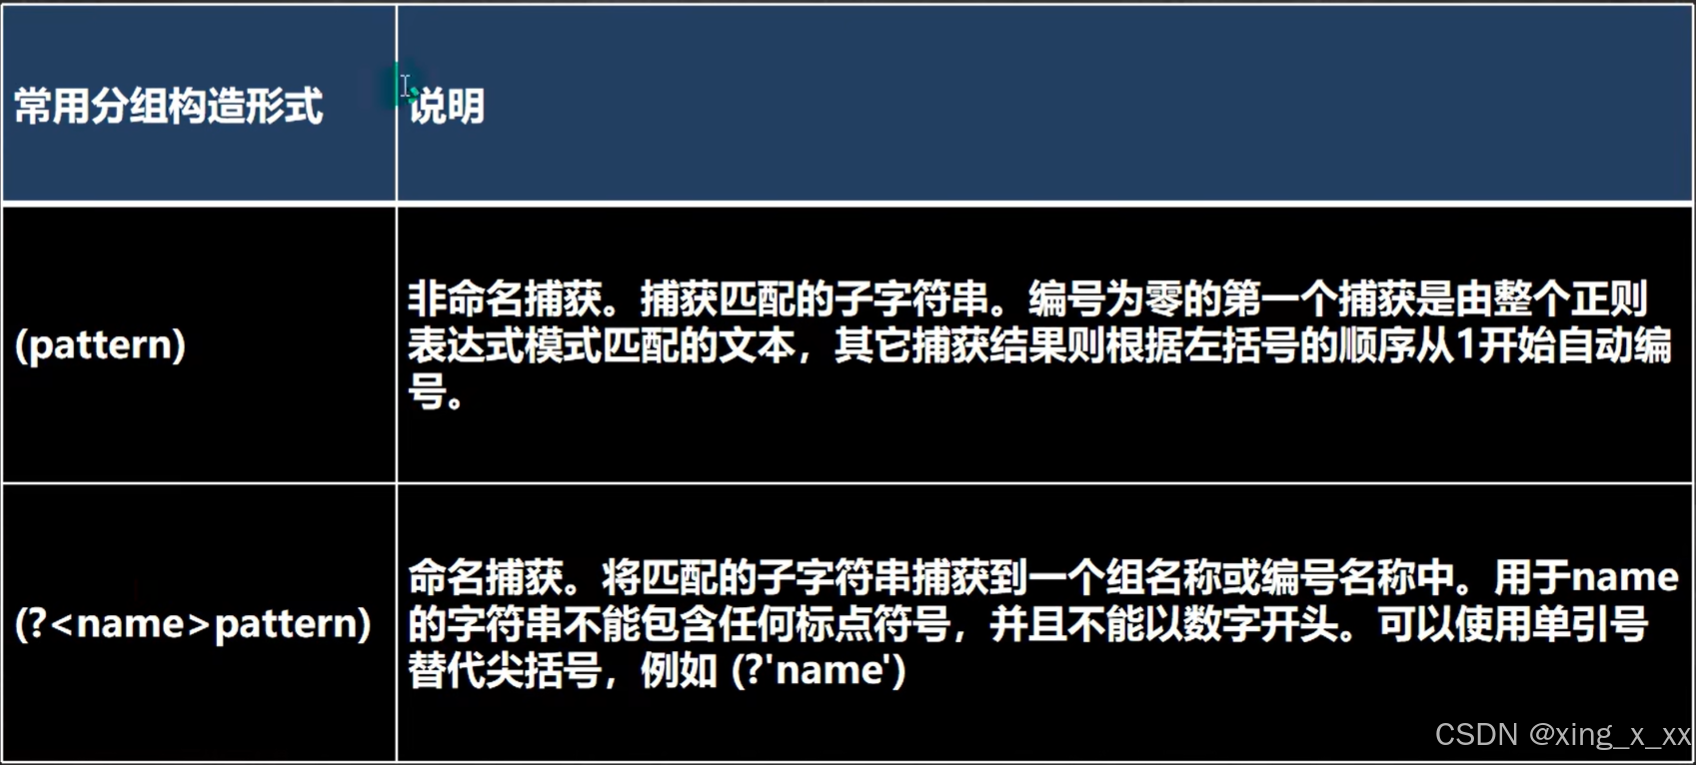
非命名捕获:matcher.group(0)得到匹配的字符串
matcher.group(1)得到匹配到的字符串的第1个分组内容
matcher.group(2)得到匹配到的字符串的第2个分组内容
命名捕获:既可以通过组名也可以通过编号来获取。matcher.group("组名");
(2)特别分组:
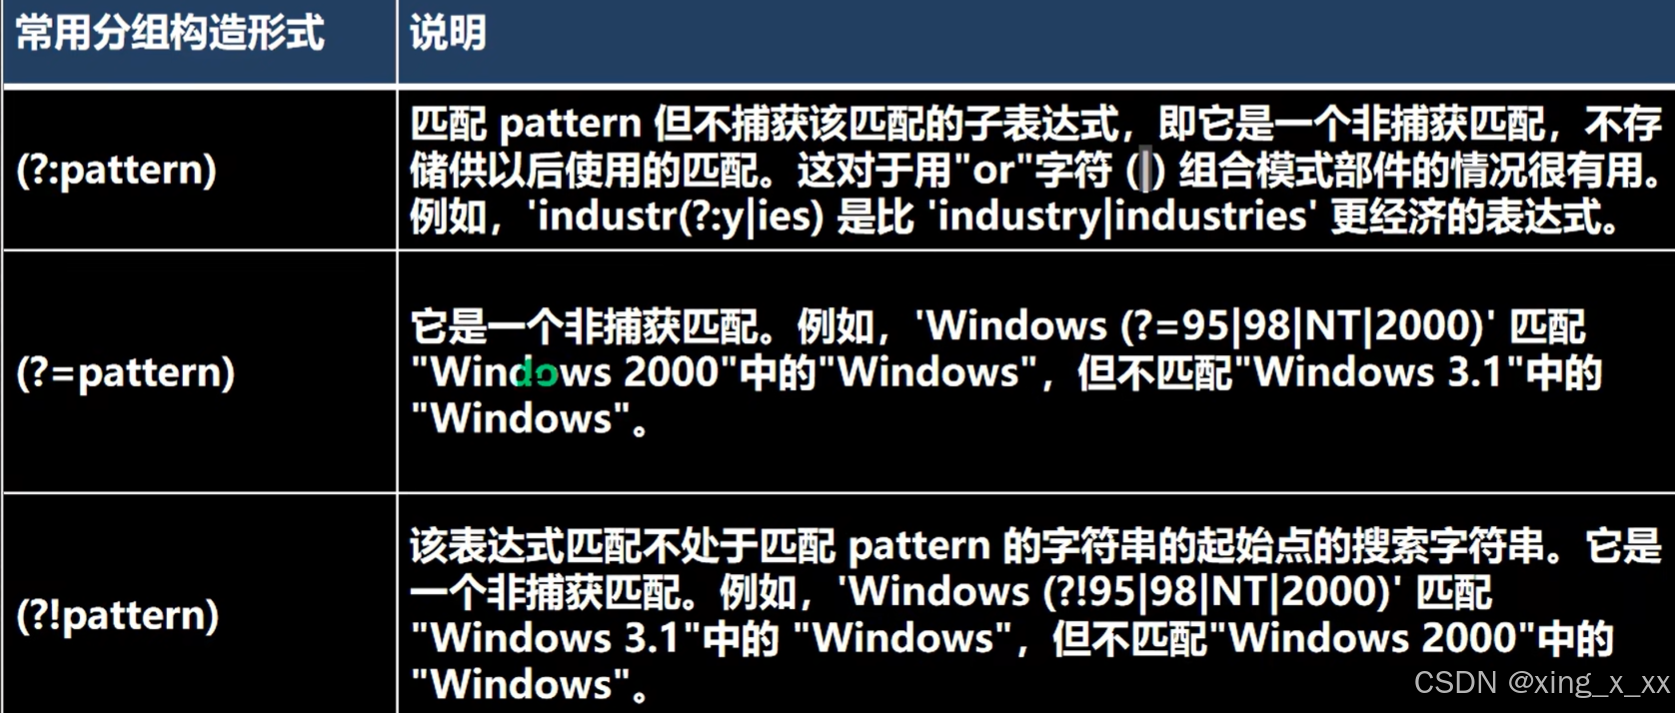
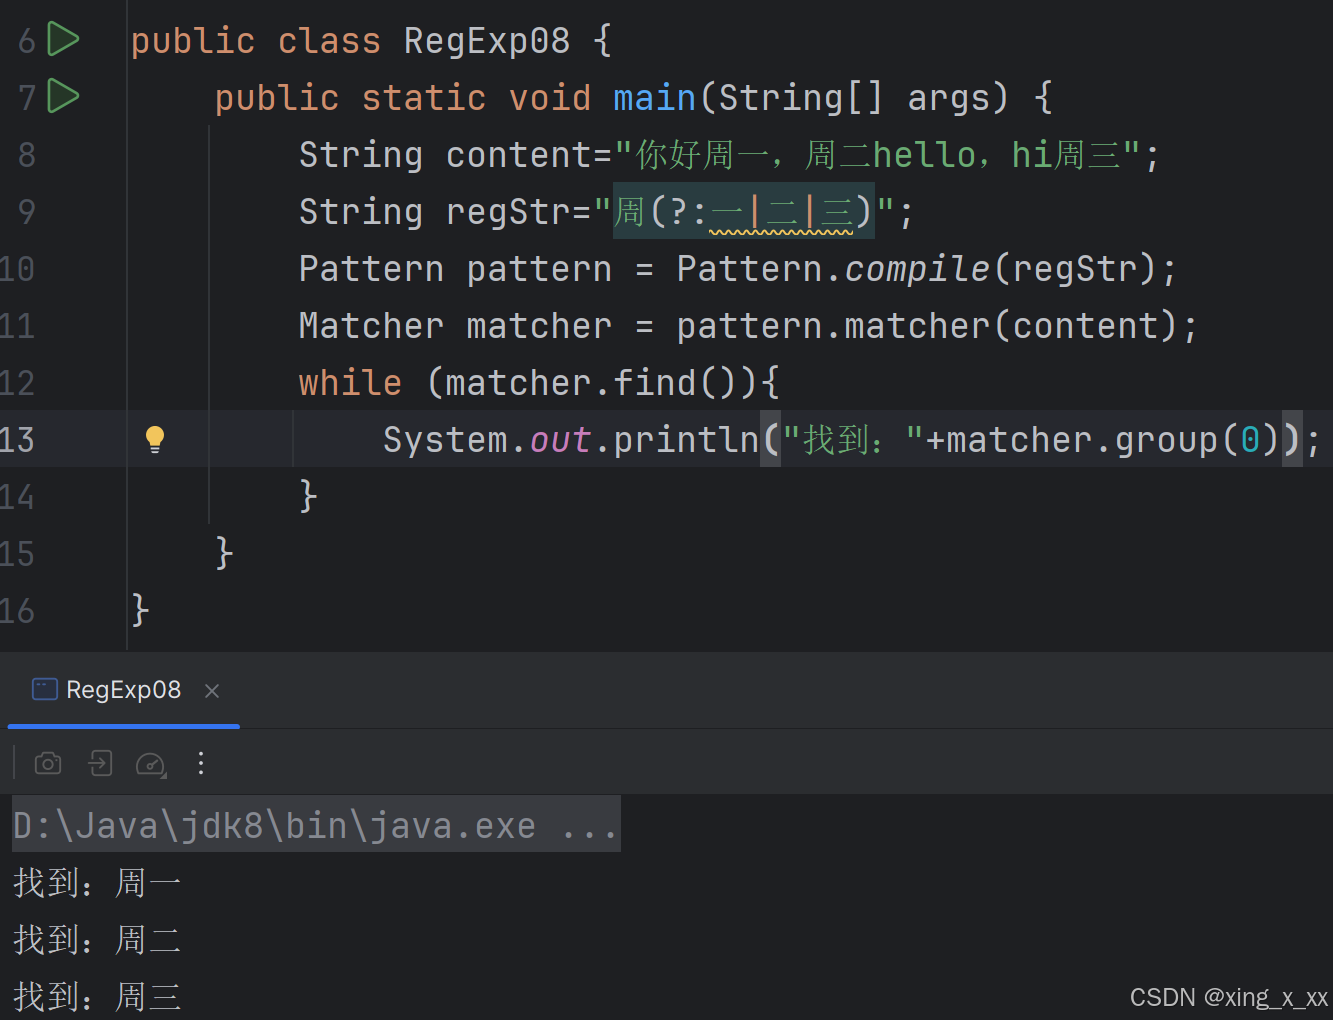
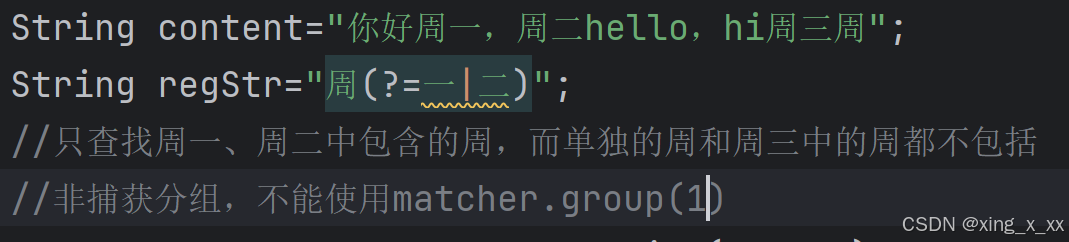
(?=pattern)和(?!pattern)刚好是相反的效果
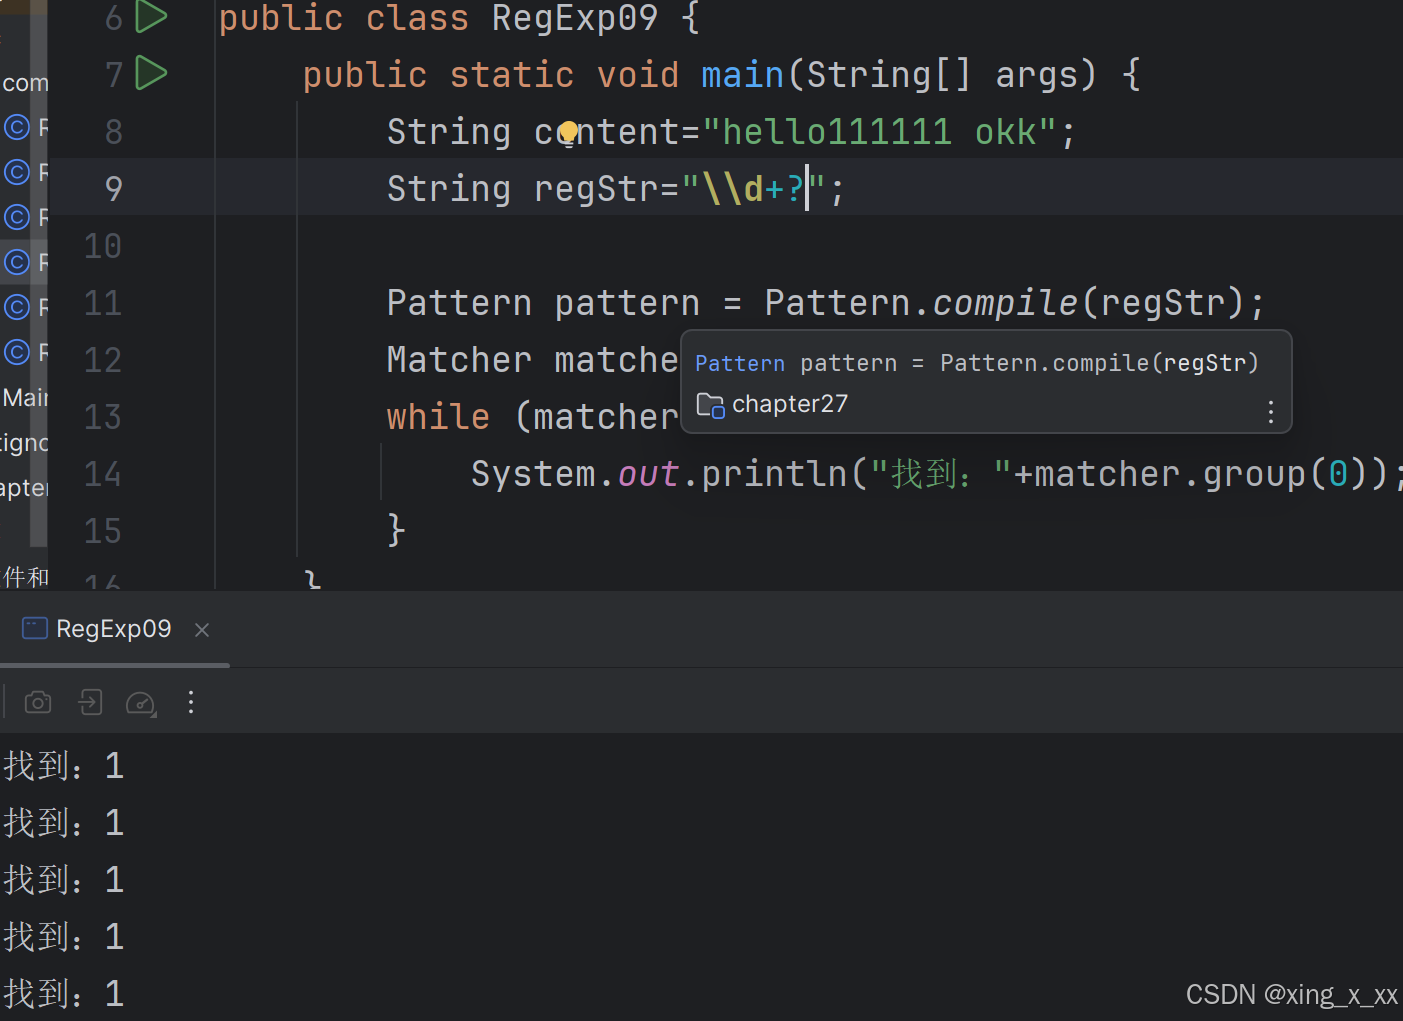
(3)非贪婪匹配
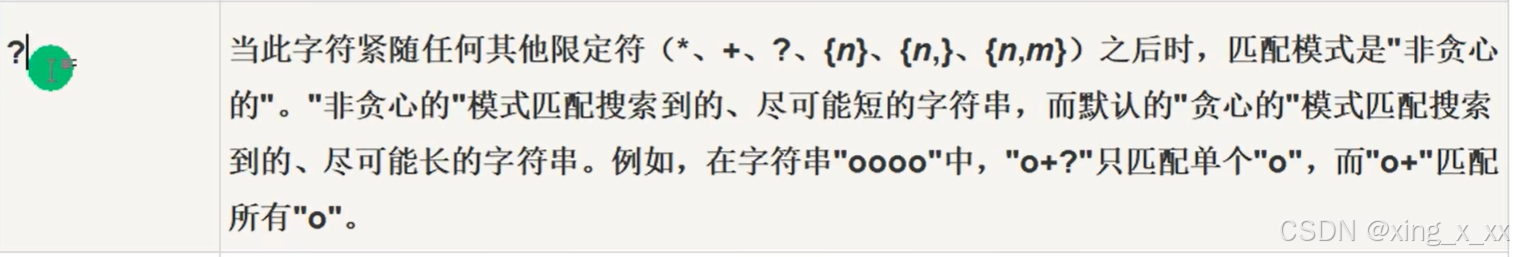
6.应用实例
public class RegExp10 {
    public static void main(String[] args) {
        //1.汉字
//        String content="我爱你中国";
//        String regStr="^[\u0391-\uffe5]+$";
        //2.邮政编码,1-9开头的一个六位数字
//        String content="123980";
//        String regStr="^[1-9]\\d{5}$";
        //3.QQ号码,1-9数字开头的一个(5位数-10位数)
//        String content="123980";
//        String regStr="^[1-9]\\d{5}$";
        //4.手机号码,必须以13、15、18开头的11位数字
        String content="13980666666";
        String regStr="^1[3|5|8]\\d{9}$";
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        if(matcher.find()){
            System.out.println("格式正确");
        }else{
            System.out.println("格式错误");
        }
    }
}
url验证
public class RegExp11 {
    public static void main(String[] args) {
       String content="https://www.bilibili.com/?spm_id_from=333.1007.0.0";
       /*
            1.开头为https:// |http://
            2.然后通过([\w-]+\.)+[\w-]来匹配www.bilibili.com
            3.?spm_id_from=333.1007.0.0匹配(\/[\w-?=&/%.#]*)?

        */            //  hhtps          www.bilibili. com/cn
       String regStr="^((http|https)://)([\\w-]+\\.)+[\\w-]+(\\/[\\w-?=&/%.#]*)?$";
       Pattern pattern = Pattern.compile(regStr);
       Matcher matcher = pattern.matcher(content);

       if(matcher.find()){
           System.out.println("格式正确");
       }else{
           System.out.println("格式错误");
       }
    }
}
三、正则表达式三个常用类
1.Pattern类
pattern 对象是一个正则表达式对象。Pattern 类没有公共构造方法。要创建一个 Pattern 对象,调用其公共静态方法,它返回一个 Pattern 对象。该方法接受一个正则表达式作为它的第一个参数,比如:Patternr=Pattern.compile(pattern);
Pattern类的方法matches,用来做整体匹配,常用于验证一个字符串是否满足某一个要求。方法返回boolean类型。
public class PatternMethod {
    public static void main(String[] args) {
        String content="hello abc hello,小趴菜";
        String regStr="hello.*";
        boolean matches= Pattern.matches(regStr,content);
        System.out.println("整体匹配="+matches);//返回:整体匹配=true
    }
}
2.Matcher类
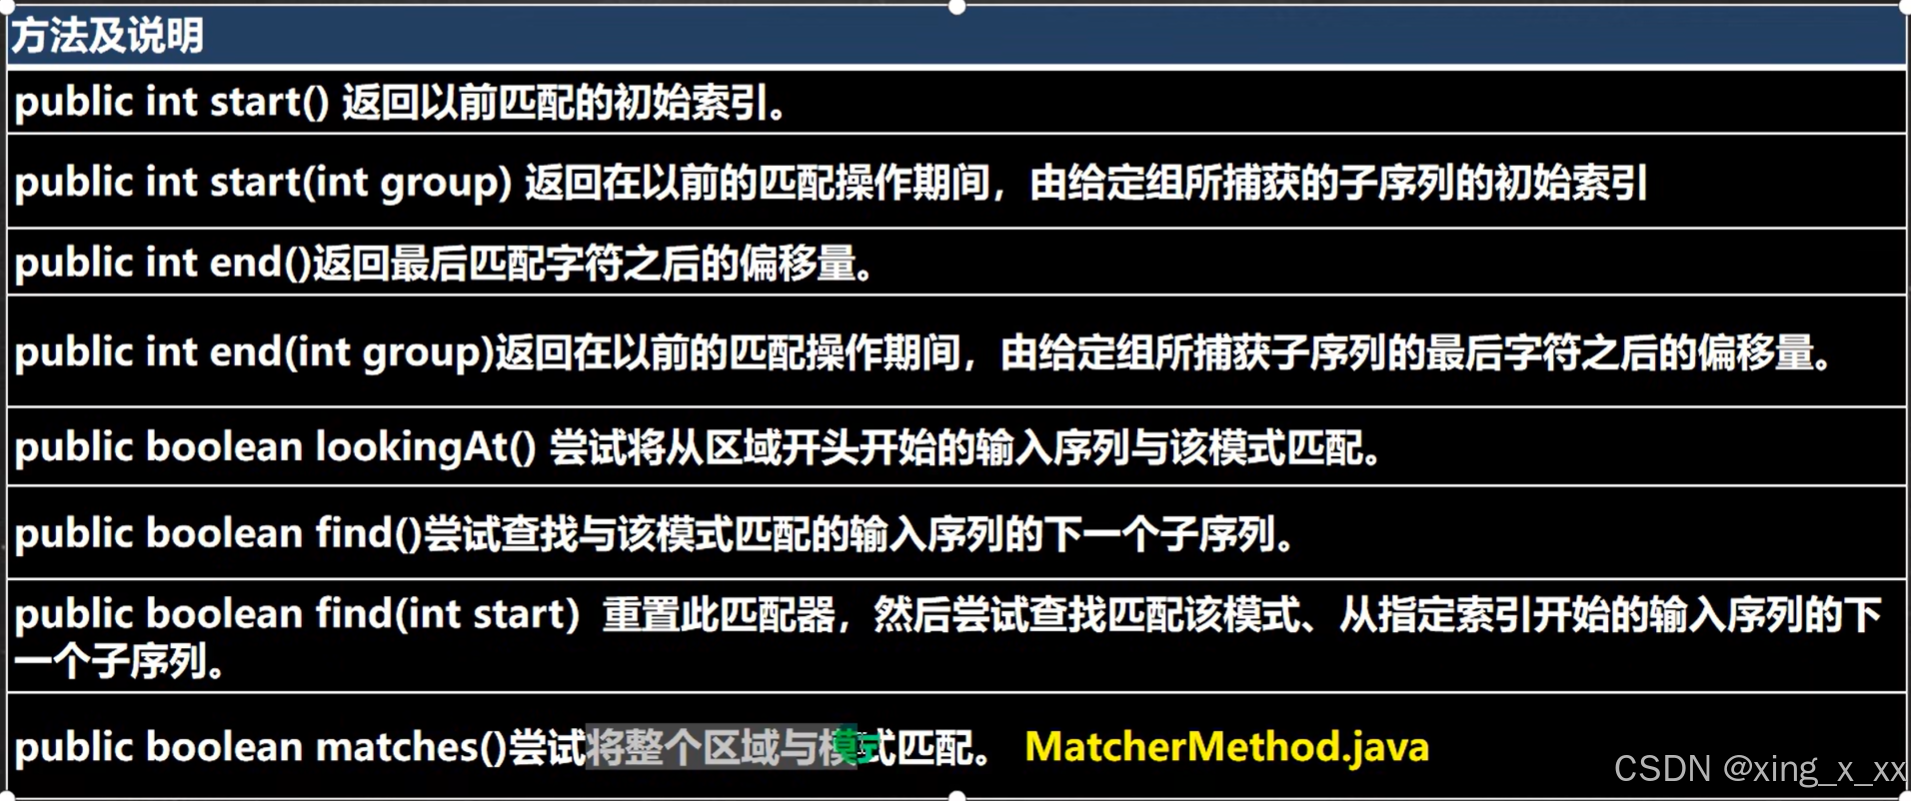
Matcher 对象是对输入字符串进行解释和匹配的引擎。与Pattern 类一样,Matcher 也没有公共构造方法。你需要调用 Pattern 对象的 matcher 方法来获得一个 Matcher 对象
方法:
public class MatcherMethod {
    public static void main(String[] args) {
       String content="hello world hello marry jack tom smith";
       String regStr="hello";
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while(matcher.find()){
            System.out.println("=============");
            System.out.println(matcher.start());
            System.out.println(matcher.end());
            System.out.println("找到:"+content.substring(matcher.start(), matcher.end()));
        }
        //如果content中有hello就替换成你好
        regStr="hello";
        pattern=Pattern.compile(regStr);
        matcher=pattern.matcher(content);
        //返回的字符串是替换以后的结果,原字符串不发生变化
        String newContent = matcher.replaceAll("你好");
        System.out.println(newContent);
        System.out.println(content);
    }
}
3.PatternSyntaxExption
PatternSyntaxException 是一个非强制异常类,它表示一个正则表达式模式中的语法错误。
四、分组、捕获、反向引用
1.分组我们可以用圆括号组成一个比较复杂的匹配模式,那么一个圆括号的部分我们可以看作是一个子表达式/一个分组。
2. 捕获把正则表达式中子表达式/分组匹配的内容,保存到内存中以数字编号或显式命名的组里,方便后面引用,从左向右,以分组的左括号为标志,第一个出现的分组的组号为1,第二个为2,以此类推。组0代表的是整个正则式
3.反向引用圆括号的内容被捕获后,可以在这个括号后被使用,从而写出一个比较实用的匹配模式,这个我们称为反向引用,这种引用既可以是在正则表达式内部,也可以是在正则表达式外部,内部反向引用\\分组号,外部反向引用$分组号
(1)匹配两个连续相同的数字:(\\d)\\1
(2)匹配五个连续相同数字:(\\d)\\1{4}
(3)匹配个位与千位相同,十位与百位相同的数5225,1551 (\\d)(\\d)\\2\\1
结巴去重案例
public class RegExp13 {
    public static void main(String[] args) {
        String content = "我....我要....学学学学....编程java!";

        //1. 去掉所有的.

        Pattern pattern = Pattern.compile("\\.");
        Matcher matcher = pattern.matcher(content);
        content = matcher.replaceAll("");

        //System.out.println("content=" + content);

        //2. 去掉重复的字  我我要学学学学编程java!
        // 思路
        //(1) 使用 (.)\\1+,用来匹配所有重复的子字符串
        //(2) 使用 反向引用$1 来替换匹配到的内容
        // 注意:因为正则表达式变化,所以需要重置 matcher
        pattern = Pattern.compile("(.)\\1+");//分组的捕获内容记录到$1
        matcher = pattern.matcher(content);
//        while (matcher.find()) {
//            System.out.println("找到=" + matcher.group(0));
//        }
        //使用 反向引用$1 来替换匹配到的内容
        //例如捕获到我我我,用我代替我我我
        content = matcher.replaceAll("$1");
        System.out.println("content=" + content);

        //3. 使用一条语句 去掉重复的字  我我要学学学学编程java!
        //content = Pattern.compile("(.)\\1+").matcher(content).replaceAll("$1");

        //System.out.println("content=" + content);

    }
}
五、String类中使用正则表达式
1.替换:String类public String replaceAll(String regex,String replacement)
2.匹配:String类public boolean matches(String regex){}
3.分割:String类public String[] split(String regex)
public class StringReg {
    public static void main(String[] args) {
        String content="2000年5月,JDK1.3、JDK1.4和J2SE1.3相继发布,几周后其获得了Apple公司Mac OS X的工业标准的支持。"
                +"2001年9月24日,J2EE1.3发布。2002年2月26日,J2SE1.4发布。" +
                "自此Java的计算能力有了大幅提升,与J2SE1.3相比,其多了近62%的类和接口。";
        //使用正则表达式,将JDK1.3和JDK1.4替换成JDK
        content = content.replaceAll("JDK1.3|JDK1.4", "JDK");
        System.out.println(content);
        //验证一个手机号,要求必须是138或者139开头的
        content="12345678978";
        if(content.matches("1(38|39)\\d{8}")){
            System.out.println("验证成功");
        }else{
            System.out.println("验证失败");
        }

        //按照#或者-或者~或者数字来分割
        content="hello#abc-jack~smith1marry";
        String[] split = content.split("#|-|~|\\d");
        for(String s:split){
            System.out.println(s);
        }
    }
}
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)