
第4关:采用除留余数法加线性探测法建立哈希表
任务描述
本关任务:采用除留余数法加线性探测法建立哈希表。
相关知识
为了完成本关任务,你需要掌握: 1.哈希表结构; 2.根据处理冲突的不同方法,设计不同的哈希表结构并进行初始化。
哈希表的基本概念
顺序表、树表的缺点: 查找所需时间与比较次数有关,能不能不比较,一次存取就能得到所查元素?
哈希表(Hash Table)又称散列表,是除顺序存储结构、链式存储结构和索引表存储结构之外的又一种存储结构。
散列表的基本思想:根据记录选择一个关键字key,同时为每个key计算一个散列码Hash(key),将记录存储位置与散列码关联起来。
需要解决两个问题:
- 如何构造散列函数?对给定的一组关键字,使其计算简单,并且分布均匀,即减少冲突。
- 如何处理冲突?因为不可避免。
构造哈希函数的方法
构造哈希函数的目标:使得到的哈希地址尽可能均匀地分布在m个连续内存单元地址上,同时使计算过程尽可能简单以达到尽可能高的时间效率。 根据关键字的结构和分布的不同,有多种构造哈希函数的方法,例如除留余数法。
除留余数法
思想: 以关键字被某个数p除后所得余数作为散列地址 公式: H(key) = key % p 关键:p 如何选取? 一般选择小于表长的最大质数
举例:给定存储单元地址为1,000,000至1,000,027,即表长度为28,如何计算关键字172,148的散列地址?
H(key)= 172148 % 23 + 1,000,000 = 16+1,000,000 = 1,000,016
哈希冲突解决方法
开放地址法 思想: 当冲突发生时,形成一个探查序列;沿此序列逐个地址探查,直到找到一个空位置(开放的地址),将发生冲突的记录放到该地址中 公式: Hi=(H(key)+di)%m,i=1,2,……k(k<=m-1)
其中:m是散列表表长,di是增量序列 线性探测法:di=1,2,3,……m-1 二次探测法:di=1²,-1²,2²,-2²,3²,……±k²(k<=m/2) 伪随机探测法:di=伪随机数序列
【例】假设哈希表长度m=13,采用除留余数法加线性探测法建立如下关键字集合的哈希表:(16,74,60,43,54,90,46,31,29,88,77),除留余数法的哈希函数为:h(k)=k mod 13,散列表的存储空间是一个下标从0开始的一维数组。
构造的哈希表如下:
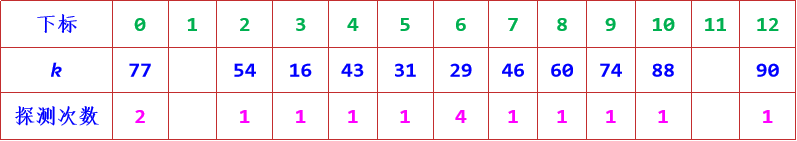
h(16)=3 ha[3]=16,共1次探测 h(74)=9 ha[9]=74,共1次探测 h(60)=8 ha[8]=60,共1次探测 h(43)=4 ha[4]=43,共1次探测 h(54)=2 ha[2]=54,共1次探测 h(90)=12 ha[12]=90,共1次探测 h(46)=7 ha[7]=46,共1次探测 h(31)=5 ha[5]=31,共1次探测 h(29)=3 有冲突 d0=3,d1=(3+1) % 13=4 仍有冲突 d2=(3+2) % 13=5 仍有冲突 d3=(3+3) % 13=6 ha[6]=29,共4次探测 h(88)=10 ha[10]=88,共1次探测 h(77)=12 有冲突 d0=12,d1=(12+1) % 13=0 ha[0]=77,共2次探测
查找成功时: ASL=(1×9+2×1+4×1) /11 = 15/11 查找失败时: ASL=(2+1+10+9+8+7+6+5+4+3+2+1+3) /13 = 61/13
开放定址哈希表的存储结构
#define NULL_KEY -1 // ,初始化的哈希表中元素均为-1,-1为无记录标志typedef int KeyType; // 设关键字域为整型struct ElemType // 数据元素类型{KeyType key;};int m=0; // 全局变量struct HashTable{ElemType *elem; // 数据元素存储基址,动态分配数组int count; // 当前数据元素个数int sizeindex; // sizeindex为哈希表表长};
哈希函数的基本操作函数
// 哈希函数的基本操作函数void InitHashTable(HashTable &H); // 构造一个空的哈希表void DestroyHashTable(HashTable &H); // 销毁哈希表Hunsigned Hash(KeyType K); // 哈希函数void collision(int &p,int d); // 线性探测再散列int SearchHash(HashTable H,KeyType K,int &p,int &c); // 在开放定址哈希表H中查找关键码为K的元素int InsertHash(HashTable &H,ElemType e); // 查找不成功时插入数据元素e到开放定址哈希表H中void TraverseHash(HashTable H,void(*Vi)(int));// 遍历哈希表
编程要求
根据提示,在右侧编辑器补充代码,采用除留余数法加线性探测法建立哈希表,编写函数实现哈希表的部分基本运算:
unsigned Hash(KeyType K); // 哈希函数void collision(int &p,int d); // 线性探测再散列int SearchHash(HashTable H,KeyType K,int &p,int &c); // 在开放定址哈希表H中查找关键码为K的元素int InsertHash(HashTable &H,ElemType e); // 查找不成功时插入数据元素e到开放定址哈希表H中
测试说明
平台会对你编写的代码进行测试:
测试输入: 13 13 11 16 74 60 43 54 90 46 31 29 88 77
输入说明: 第一行输入13,表示输入哈希表的表长; 第二行输入13,表示除留余数法的模; 第三行输入11,表示输入数据的个数; 第四行输入11个整数,表示输入具体的数据。
预期输出: 哈希地址0~12 0 1 2 3 4 5 6 7 8 9 10 11 1277 -1 54 16 43 31 29 46 60 74 88 -1 90
输出说明: 第一行输出哈希表的地址范围 第二行输出哈希表的下标 第三行输出哈希表中的数据
#include"stdio.h"
#include"stdlib.h"
#define NULL_KEY -1 // -1为无记录标志
#define SUCCESS 1
#define UNSUCCESS 0
#define DUPLICATE -1
#define N 100  // 数据元素个数
typedef int KeyType; // 设关键字域为整型
struct ElemType // 数据元素类型
{
   KeyType key;
};
struct HashTable
{
   ElemType *elem; // 数据元素存储基址,动态分配数组
   int count; // 当前数据元素个数
   int sizeindex; // sizeindex为哈希表表长
};
// 哈希函数的基本操作函数
void InitHashTable(HashTable &H);    // 构造一个空的哈希表
void DestroyHashTable(HashTable &H);  // 哈希表H存在。操作结果:销毁哈希表H
unsigned Hash(KeyType K);    // 哈希函数
void collision(int &p,int d); // 线性探测再散列
int SearchHash(HashTable H,KeyType K,int &p,int &c);  // 在开放定址哈希表H中查找关键码为K的元素
int InsertHash(HashTable &H,ElemType e); // 查找不成功时插入数据元素e到开放定址哈希表H中
void TraverseHash(HashTable H,void(*Vi)(int));
void print(int p);

 int m=0;   // 全局变量, H(key) = key % m
 int main()
 {
   ElemType r[N]={0};
   HashTable h;
   int i,p,n;
   int j;
   KeyType k;
   InitHashTable(h);
   scanf("%d",&m); // H(key) = key % m
   scanf("%d",&n); // 数据的个数
   for(i=0;i<n;i++)
   {
       scanf("%d",&r[i].key);
   }
   for(i=0;i<n;i++)
   { // 插入前N-1个记录
     j=InsertHash(h,r[i]);
   }
   //printf("按哈希地址的顺序遍历哈希表:\n");
   TraverseHash(h,print);
   DestroyHashTable(h);
 }
 // 哈希函数的基本操作函数
void InitHashTable(HashTable &H)
 { // 操作结果:构造一个空的哈希表
  int i;
  H.count=0; // 当前元素个数为0
  scanf("%d",&H.sizeindex ); // 哈希表存储容量
  H.elem=(ElemType*)malloc(H.sizeindex*sizeof(ElemType));
  for(i=0;i<H.sizeindex;i++)
    H.elem[i].key=NULL_KEY; // 未填记录的标志
 }
void DestroyHashTable(HashTable &H)
{ // 初始条件:哈希表H存在。操作结果:销毁哈希表H
   free(H.elem);
   H.elem=NULL;
   H.count=0;
   H.sizeindex=0;
 }
unsigned Hash(KeyType K)
{ // 一个简单的哈希函数(m为全局变量)
  /********** Begin **********/
    return K % m;
  /********** End **********/
}
void collision(int &p,int d) // 线性探测再散列
{ // 开放定址法处理冲突
  /********** Begin **********/
  p=(p+1)%m;
  /********** End **********/
 }
int SearchHash(HashTable H,KeyType K,int &p,int &c)
{  // 在开放定址哈希表H中查找关键码为K的元素,若查找成功,以p指示待查数据
   // 元素在表中位置,并返回SUCCESS;否则,以p指示插入位置,并返回UNSUCCESS
   // c用以计冲突次数,其初值置零,供建表插入时参考。
   /********** Begin **********/
  p = Hash(K);
  while(H.elem[p].key!=NULL_KEY && K!=H.elem[p].key){
     c++;
     if(c<H.sizeindex)
         collision(p,c);
      else
      break;
  }
  if(K==H.elem[p].key)
   return SUCCESS;
   else
   return UNSUCCESS;
   /********** End **********/
 }
int InsertHash(HashTable &H,ElemType e)
{ // 查找不成功时插入数据元素e到开放定址哈希表H中,并返回OK;
  // 若冲突次数过大,则重建哈希表,算法9.18
  /********** Begin **********/
  int c,p;
  c=0;
  if(SearchHash(H,e.key,p,c))
      return DUPLICATE;
   else if (c<H.sizeindex){
      H.elem[p]=e;
      ++H.count;
      return SUCCESS;
   }
   else return UNSUCCESS;
  /********** End **********/
 }
 void TraverseHash(HashTable H,void(*Vi)(int))
 { // 按哈希地址的顺序遍历哈希表
    printf("哈希地址0~%d\n",H.sizeindex-1);
    for(int i=0;i<H.sizeindex;i++)
    // if(H.elem[i].key!=NULL_KEY) // 有数据
    Vi(i);
    printf("\n");
    for(int i=0;i<H.sizeindex;i++)
    // if(H.elem[i].key!=NULL_KEY) // 有数据
       Vi(H.elem[i].key);
    printf("\n");
 }
void print(int p)
{
   printf("%d\t",p);
}更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)