
ES(elasticsearch)本地安装+整合Spring Boot 基本操作
·
一 本地安装elasticsearch-7.6.2 + kibana-7.6.2
1.elasticsearch 本地启动
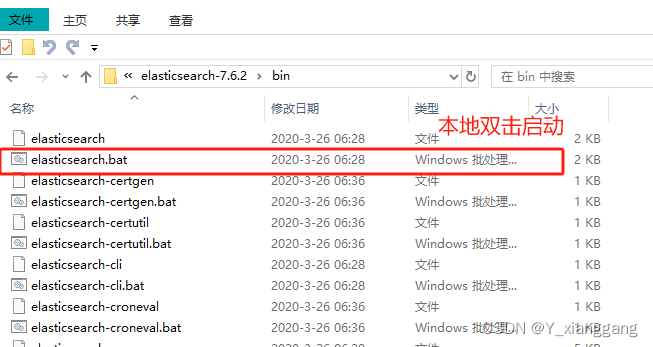
2.elasticsearch 本地访问 http://localhost:9200/

3.kibana 本地启动

4.kibana 本地访问 http://localhost:5601/app/kibana#/home

二 Spring Boot整合ES(elasticsearch)+ 基础操作
1.Spring Boot 和 ES(elasticsearch) 对应版本关系
参考官网:
Spring Data Elasticsearch :: Spring Data Elasticsearch

2. 在pom 引入相关jar包
        <dependency>
            <groupId>org.elasticsearch.client</groupId>
            <artifactId>elasticsearch-rest-high-level-client</artifactId>
            <version>7.6.2</version>
        </dependency>
        <dependency>
            <groupId>org.elasticsearch</groupId>
            <artifactId>elasticsearch</artifactId>
            <version>7.6.2</version>
        </dependency>
        <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-connector-elasticsearch6_2.11</artifactId>
            <version>1.9.2</version>
        </dependency>
3.编写ES基本操作config
package com.example.xuxi2.config;

import org.apache.http.HttpHost;
import org.apache.http.client.config.RequestConfig;
import org.apache.http.params.HttpParams;
import org.elasticsearch.action.bulk.BulkRequest;
import org.elasticsearch.action.bulk.BulkResponse;
import org.elasticsearch.action.delete.DeleteRequest;
import org.elasticsearch.action.delete.DeleteResponse;
import org.elasticsearch.action.get.GetRequest;
import org.elasticsearch.action.index.IndexRequest;
import org.elasticsearch.action.index.IndexResponse;
import org.elasticsearch.action.search.ClearScrollRequest;
import org.elasticsearch.action.search.SearchRequest;
import org.elasticsearch.action.search.SearchResponse;
import org.elasticsearch.action.search.SearchScrollRequest;
import org.elasticsearch.action.update.UpdateRequest;
import org.elasticsearch.action.update.UpdateResponse;
import org.elasticsearch.client.RequestOptions;
import org.elasticsearch.client.RestClient;
import org.elasticsearch.client.RestHighLevelClient;
import org.elasticsearch.index.reindex.BulkByScrollResponse;
import org.elasticsearch.index.reindex.UpdateByQueryRequest;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.beans.factory.DisposableBean;
import org.springframework.beans.factory.InitializingBean;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import javax.annotation.Resource;
import java.io.IOException;

@Configuration
public class ElasticsearchConfig implements InitializingBean, DisposableBean {

    private final static Logger logger = LoggerFactory.getLogger(ElasticsearchConfig.class);


    @Resource
    private RestHighLevelClient restHighLevelClient;

    /**
     * ben 销毁时 关闭ES连接
     *
     * @throws Exception
     */
    @Override
    public void destroy() throws Exception {
        // 关闭Elasticsearch连接
        logger.info("...........................................关闭Elasticsearch连接.......");

        try {
            this.restHighLevelClient.close();
        } catch (IOException e) {
            e.printStackTrace();
        }
    }


    /**
     * bean 创建时 初始化 ES连接
     *
     * @throws Exception
     */
    @Override
    public void afterPropertiesSet() throws Exception {
        logger.info("............................................初始化Elasticsearch连接.......");
        restHighLevelClient = new RestHighLevelClient(
                RestClient.builder(new HttpHost("localhost", 9200, "http")));

    }


    /**
     * 批量创建文档
     * @param bulkRequest
     * @return
     * @throws IOException
     */
    public BulkResponse  bulk(BulkRequest bulkRequest) throws IOException{
        BulkResponse bulk = restHighLevelClient.bulk(bulkRequest, RequestOptions.DEFAULT);
        return bulk;

    }

    /**
     * scroll 滚动查询
     * @param scrollRequest
     * @return
     * @throws IOException
     */
    public SearchResponse  scroll(SearchScrollRequest  scrollRequest)throws  IOException{
        SearchResponse scroll = restHighLevelClient.scroll(scrollRequest, RequestOptions.DEFAULT);
         return scroll;

    }


    /**
     * 关闭Scroll链接
     */
    public void clearScroll(String scrollId) throws IOException {
        // 清除 Scroll 连接
        ClearScrollRequest clearScrollRequest = new ClearScrollRequest();
        clearScrollRequest.addScrollId(scrollId);

            restHighLevelClient.clearScroll(clearScrollRequest, RequestOptions.DEFAULT);

    }

    /**
     * 保存
     *
     * @param indexRequest
     * @throws IOException
     */

    public IndexResponse save(IndexRequest indexRequest) throws IOException {
        IndexResponse index = restHighLevelClient.index(indexRequest, RequestOptions.DEFAULT);
        return index;
    }

    /**
     * 查询
     *
     * @param request
     * @throws IOException
     */
    public SearchResponse query(SearchRequest request) throws IOException {
        SearchResponse search = restHighLevelClient.search(request, RequestOptions.DEFAULT);
        return search;
    }


    /**
     * 判断是否存在
     *
     * @param getRequest
     * @return
     * @throws IOException
     */
    public Boolean exists(GetRequest getRequest) throws IOException {
        boolean exists = restHighLevelClient.exists(getRequest, RequestOptions.DEFAULT);
        return exists;
    }


    /**
     * 修改
     *
     * @param updateRequest
     * @return
     * @throws IOException
     */
    public UpdateResponse update(UpdateRequest updateRequest) throws IOException {
        UpdateResponse update = restHighLevelClient.update(updateRequest, RequestOptions.DEFAULT);
        return update;
    }


    /**
     * 修改
     *
     * @param updateRequest
     * @return
     * @throws IOException
     */
    public BulkByScrollResponse updateQuery(UpdateByQueryRequest updateRequest) throws IOException {
        BulkByScrollResponse update = restHighLevelClient.updateByQuery(updateRequest, RequestOptions.DEFAULT);
        return update;
    }

    /**
     * 删除
     *
     * @param deleteRequest
     * @return
     * @throws IOException
     */
    public DeleteResponse dal(DeleteRequest deleteRequest) throws IOException {
        DeleteResponse delete = restHighLevelClient.delete(deleteRequest, RequestOptions.DEFAULT);
        return delete;
    }

}
三.ES基本操作 java 实现
1.查询(精确,范围,in 模糊)
    public void query() {
        try {
            SearchRequest request = new SearchRequest(INDICESLIST);
            SearchSourceBuilder builder = new SearchSourceBuilder();

            //多个条件 构建SearchSourceBuilder 查询参数 构建一个精确匹配查询,即查找指定字段(field)等于指定值(value)的文档。
            //builder.query(QueryBuilders.boolQuery().must(QueryBuilders.termQuery("user","张三12")).must(QueryBuilders.termQuery("name","java 实现23更新")));

            //rangeQuery(String field): 构建一个范围查询,可以指定字段的值在一个范围内   gt 大于 gte 大于等于 lt 小于 lte 小于等于
            // builder.query(QueryBuilders.boolQuery().must(QueryBuilders.rangeQuery("age").gt("40").lt("50")));

            //前缀模糊匹配  对应mysql 中的 %
            //  builder.query(QueryBuilders.matchPhrasePrefixQuery("user","张858"));

            //多个值查询  对应mysql 中的in
         //   builder.query(QueryBuilders.termsQuery("age", queryInt));
            //默认从0开始
            builder.from(0);
            //分页的大小,默认为10,当查询数量超过1万的时候 会进行深分页
            builder.size(23);

            request.source(builder);
            SearchResponse query = elasticsearchConfig.query(request);
            for (SearchHit hit : query.getHits().getHits()) {
                logger.info("查询ES 结果{}", JSONObject.toJSONString(hit.getSourceAsMap()));
            }

        } catch (IOException e) {
            e.printStackTrace();
        }

    }
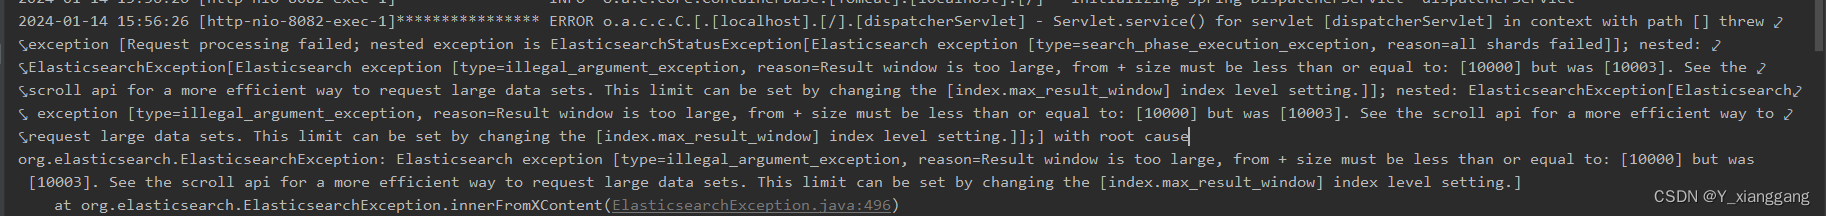
2.分页的情况(在ES查询的时候 size 的值大于1W的时候就会出现异常,这个时候就会用的scroll进行深分页)
大于1W数据的查询结果
大于1W数据的查询-优化
 public void pageQuery() {
        try {
            List<UserVo> list = new ArrayList<>();
            SearchResponse searchResponse = null;
            SearchRequest request = new SearchRequest(INDICESLIST);
            SearchSourceBuilder builder = new SearchSourceBuilder();
            //默认从0开始
            builder.from(0);
            //分页的大小,默认为10,当查询数量超过1万的时候 会进行深分页
            builder.size(1000);
            request.source(builder);

            // 设置滚动查询过期时间 5分钟
            Scroll scroll = new Scroll(TimeValue.timeValueMinutes(5));
            request.scroll(scroll);

            searchResponse = elasticsearchConfig.query(request);
            logger.info("查询ES 条数为 = " + searchResponse.getHits().getHits().length);

            //放入第一批数据
            if (searchResponseIsNotNull(searchResponse)) {
                this.buildResponse(searchResponse, list);
            }

            // scrollId循环获取结果
            while (searchResponseIsNotNull(searchResponse)) {
                // 设置滚动查询参数
                SearchScrollRequest scrollRequest = new SearchScrollRequest(searchResponse.getScrollId());
                scrollRequest.scroll(scroll);
                // 通过ScrollId进行滚动查询
                searchResponse = elasticsearchConfig.scroll(scrollRequest);
                //放入往后批次的数据
                this.buildResponse(searchResponse, list);
            }
            elasticsearchConfig.clearScroll(searchResponse.getScrollId());
            logger.info("ES scroll 查询数据结果 ==" + list.size());

        } catch (IOException e) {
            e.printStackTrace();
        }
    }


    /**
     * 处理信息
     */
    private List<UserVo> buildResponse(SearchResponse searchResponse, List<UserVo> list) {
        if (searchResponseIsNotNull(searchResponse)) {
            SearchHit[] hits = searchResponse.getHits().getHits();
            // 实体转换
            List<UserVo> collect = Arrays.stream(hits)
                    .map(hit -> JSON.parseObject(hit.getSourceRef().utf8ToString(), UserVo.class))
                    .collect(Collectors.toList());
            list.addAll(collect);
        }
        return null;
    }


    /**
     * 判断返回内容是否为空
     */
    private boolean searchResponseIsNotNull(SearchResponse searchResponse) {
        return !Objects.isNull(searchResponse)
                && !Objects.isNull(searchResponse.getHits())
                && !Objects.isNull(searchResponse.getHits().getHits())
                && searchResponse.getHits().getHits().length > 0;
    }
3.修改
java 实现
 public void update() {
        try {
            Map<String, Object> alMap = Maps.newHashMap();
            alMap.put("user", "java 实现更新");
            alMap.put("message", "java 实现更新");
            User user = new User();
            user.setName("java 实现更新");
            user.setMessage("java 实现更新");
            UpdateRequest updateRequest = new UpdateRequest();
            //指定索引name、type和id
            updateRequest.index(INDICES).id("02g9_owBJ5blg2GrL6qG");
            //指定更新的字段,map格式
            // updateRequest.doc(alMap);
            //或者指定更新的字段,json格式传递,同局部更新代码V1版,加上XContentType.JSON即可
            updateRequest.doc(JSON.toJSONString(user), XContentType.JSON);
            //如果要更新的文档在更新操作的get和索引阶段之间被另一个操作更改,那么要重试多少次更新操作
            updateRequest.retryOnConflict(3);
            updateRequest.fetchSource(true);
            UpdateResponse update = elasticsearchConfig.update(updateRequest);
            logger.info("修改返回状态= ", update.status());

            SearchRequest searchRequest = new SearchRequest(INDICES);
            SearchSourceBuilder builder9 = new SearchSourceBuilder();
            builder9.query(QueryBuilders.matchQuery("id", "1848bf28-34a8-4c16-bd0e-a6b5b850d369"));
            searchRequest.source(builder9);
            SearchResponse query1 = elasticsearchConfig.query(searchRequest);
            for (SearchHit hit : query1.getHits().getHits()) {
                logger.info("修改后结果为 {} ", JSONObject.toJSONString(hit.getSourceAsMap()));
            }
        } catch (IOException e) {
            e.printStackTrace();
        }

    }
执行结果

ES查询结果

3.删除,这里时根据es生成的id 进行删除
 public void dal() {
        try {
            DeleteRequest deleteRequest = new DeleteRequest(INDICES, "UIn144wBvDNhEK-gn-YT");
            DeleteResponse dal = elasticsearchConfig.dal(deleteRequest);
            logger.info("删除结果 = ", dal.status());
        } catch (IOException e) {
            e.printStackTrace();
        }

    }
4.ES 基本查询语法
#查询
GET /kibana_query_index/_search?q=name:京


#单字段查询,查询语句中开始和结束中不能有注释 否则会有问题
GET kibana_query_index/_search
{
  "query": {
    "match": {
      "name": "北京"

  }
}


#查询,展示特定的字段信息
GET kibana_query_index/_search
{
  "query": {
    "match": {
      "name": "北京"
    }
  },
  "_source": ["name","desc"]
}


#查询 排序  分页(from 页码  size 每页的条数)

GET kibana_query_index/_search
{
  "query": {
    "match": {
      "name": "北京"
    }
  },
  "sort": [
    {
      "age": {
        "order": "asc"
      }
    }
  ],
  "from": 0,
  "size": 12
}


#多条件bool 值查询 ,must 命令 查询条件都要满足 并的关系,相当于mysql 中的and
GET kibana_query_index/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
           "name": "北京"
          }
        },
        {
          "match": {
            "age":12
          }
        }
      ]
    }
  }
}

#多条件bool 值查询 ,should 命令 查询条件满足一个即可,相当于mysql 中的or
GET kibana_query_index/_search
{
  "query": {
    "bool": {
      "should": [
        {
          "match": {
           "name": "北京"
          }
        },
        {
          "match": {
            "age":12
          }
        }
      ]
    }
  }
}

# must_not 不等于查询条件的数据
GET kibana_query_index/_search
{
  "query": {
    "bool": {
      "must_not": [
        {
          "match": {
            "age":12
          }
        }
      ]
    }
  }
}


#范围查询 gt 大于 gte 大于等于 lt 小于 lte 小于等于
GET kibana_query_index/_search
{
  "query": {
    "bool": {
      "should": [
        {
          "match": {
           "name": "北京"
          }
        }
      ],
      "filter": [
        {"range": {
          "age": {
            "gte": 1,
            "lte": 90
          }
        }}
      ]
    }
  }
}


#单字段查询 文档 关键字查询,多个条件使用空格隔开,只要满足其中一个结果就可以被查出,这个时候可以通过分值进行基本判断
GET kibana_query_index/_search
{
  "query": {
    "match": {
      "tags": "儿 门"
    }
  }
}


#创建索引库
PUT testdb
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text"
      },
      "desc": {
        "type": "keyword"
      }
    }
  }
}
#插入数据1
PUT testdb/_doc/1
{
  "name": "李四在学java name",
  "desc": "李四在学java desc"
}

#插入数据2
PUT testdb/_doc/2
{
  "name": "李四在学java name2",
  "desc": "李四在学java desc2"
}


#查询  keyword 字段类型不会被分词器解析  没有被分析

GET _analyze
{
  "analyzer": "keyword",
  "text": "李四在学java name"
}

#查询  standard字段类型会被分词器解析 拆分后的数据 被分析了

GET _analyze
{
  "analyzer": "standard",
  "text": "李四在学java name"
}


GET testdb/_search
{
  "query": {
    "term": {

        "name": "李"

    }
  }
}

GET testdb/_search
{
  "query": {
    "term": {

        "desc": "李四在学java desc2"

    }
  }
}


#高亮显示highlight 默认 em 标签

GET kibana_query_index/_search
{
  "query": {
    "match": {
      "name": "北京"
    }
  },
  "highlight": {
    "fields": {
      "name": {}
    }
  }
}


#高亮显示highlight  自定义标签 pre_tags 标签前缀  post_tags  标签后缀
GET kibana_query_index/_search
{
  "query": {
    "match": {
      "name": "北京"
    }
  },
  "highlight": {
    "pre_tags": "<p sdfsdf>",
    "post_tags": "</p>",
    "fields": {
      "name": {}
    }
  }
}
更多推荐



 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)