
mysql 、mongodb、nacos、zookeeper安装及简单使用
Mysql
安装Mysql
下载mysql。
安装
配置环境变量
使用Mysql
-
登录终端
net start mysql 启动mysql 服务
mysql -u root -p 登录root用户 -
创建数据库
create DATABASE user;
创建user数据库 -
删除数据库
drop database user; -
选择数据库
use user; -
显示所有数据库
show databases; -
创建表
CREATE TABLE table_name (column_name column_type);
CREATE TABLE IF NOT EXISTS `runoob_tbl`(
   `runoob_id` INT UNSIGNED AUTO_INCREMENT,
   `runoob_title` VARCHAR(100) NOT NULL,
   `runoob_author` VARCHAR(40) NOT NULL,
   `submission_date` DATE,
   PRIMARY KEY ( `runoob_id` )
)ENGINE=InnoDB DEFAULT CHARSET=utf8;
如果你不想字段为 NULL 可以设置字段的属性为 NOT NULL, 在操作数据库时如果输入该字段的数据为NULL ,就会报错。
AUTO_INCREMENT定义列为自增的属性,一般用于主键,数值会自动加1。
PRIMARY KEY关键字用于定义列为主键。 您可以使用多列来定义主键,列间以逗号分隔。
ENGINE 设置存储引擎,CHARSET 设置编码。
-
删除表
DROP TABLE table_name ; -
显示当前数据库下的所有表
show tables; -
显示表结构
SHOW COLUMNS FROM user; -
修改表结构(alter 删除,增加,修改列)
- 删除列
ALTER TABLE user DROP field; - 添加列
ALTER TABLE user add filed;
如果需要指定增加列的位置,可以使用first 或者after
ALTER TABLE user ADD age INT AFTER address;增加到address的后面
ALTER TABLE user ADD age INT first;增加到首列 - 修改字段
可以使用modify或者change。
ALTER TABLE testalter_tbl MODIFY c CHAR(10); 将c字段 类型改为char(10);
ALTER TABLE testalter_tbl CHANGE oldName newName char(20);
change后面跟旧的字段名,紧接着新的字段名。 主要用于修改字段名。 - alter的其他用法
alter table tableName engine=myisam; 修改引擎
alter table tableName drop foreign key keyName; 删除外键约束
alter table testalter_tbl ADD PRIMARY KEY (i); 注意:主键只有一个
- 删除列
-
修改表名(alter xx rename)
ALTER TABLE oldTable RENAME TO newTable; -
插入数据
这是自增的列可以不用设置。
INSERT INTO table_name ( field1, field2,...fieldN )
                       VALUES
                       ( value1, value2,...valueN );
INSERT INTO runoob_tbl (runoob_title, runoob_author, submission_date)
     VALUES ("学习 PHP", "菜鸟教程", NOW());
插入多行数据
INSERT INTO table_name (field1, field2,...fieldN) VALUES (valueA1,valueA2,...valueAN),(valueB1,valueB2,...valueBN),(valueC1,valueC2,...valueCN)......;
- 插入数据
SELECT column_name,column_name
FROM table_name
[WHERE Clause]
[LIMIT N][ OFFSET M]
- 查询语句中你可以使用一个或者多个表,表之间使用逗号(,)分割,并使用WHERE语句来设定查询条件。
- SELECT 命令可以读取一条或者多条记录。
- 你可以使用星号(*)来代替其他字段,SELECT语句会返回表的所有字段数据
- 你可以使用 WHERE 语句来包含任何条件。
- 你可以使用 LIMIT 属性来设定返回的记录数。
- 你可以通过OFFSET指定SELECT语句开始查询的数据偏移量。默认情况下偏移量为0。
- 更新数据
UPDATE table_name SET field1=new-value1, field2=new-value2
[WHERE Clause]
UPDATE runoob_tbl SET runoob_title='学习 C++' WHERE runoob_id=3;
- 删除数据
DELETE FROM table_name [WHERE Clause]
DELETE FROM runoob_tbl WHERE runoob_id=3;
- 事务
数据库中包装一些列操作,这些操作要么全执行,要不全不执行,这个就叫做事务。
- 在 MySQL 中只有使用了 Innodb 数据库引擎的数据库或表才支持事务。
- 事务处理可以用来维护数据库的完整性,保证成批的 SQL 语句要么全部执行,要么全部不执行。
- 事务用来管理 insert,update,delete 语句
- 事务是必须满足4个条件(ACID)::原子性(Atomicity,或称不可分割性)、一致性(Consistency)、隔离性(Isolation,又称独立性)、持久性(Durability)。
-
事务控制语句
- BEGIN 或 START TRANSACTION 显式地开启一个事务;
- COMMIT 会提交事务,并使已对数据库进行的所有修改成为永久性的;
- ROLLBACK 回滚会结束用户的事务,并撤销正在进行的所有未提交的修改;
- SAVEPOINT identifier,SAVEPOINT 允许在事务中创建一个保存点,一个事务中可以有多个 SAVEPOINT;
- RELEASE SAVEPOINT identifier 删除一个事务的保存点,当没有指定的保存点时,执行该语句会抛出一个异常;
- ROLLBACK TO identifier 把事务回滚到标记点;
- SET TRANSACTION 用来设置事务的隔离级别。InnoDB 存储引擎提供事务的隔离级别有READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ 和 SERIALIZABLE。
-
修改表结构
当我们需要修改数据表名或者修改数据表字段时,就需要使用到MySQL ALTER命令。 -
索引
索引是为了提高查询速度。
索引类似于书本的目录,本质上也是一张表,该表保存了主键与索引字段,并指向实体表的记录。
优点: 提高查询速度;
缺点:更新表数据时由于也需要更新索引表,所以效率会低一些。另外,索引也会占用磁盘空间。 -
创建索引
- 基本方式
CREATE INDEX indexName ON table_name (column_name) - 修改表结构创建索引
ALTER table tableName ADD INDEX indexName(columnName) - 创建表时直接指定索引
CREATE TABLE mytable(
ID INT NOT NULL,
username VARCHAR(16) NOT NULL,
INDEX [indexName] (username(length))
);
- 基本方式
-
删除索引
DROP INDEX [indexName] ON mytable; -
显示索引
SHOW INDEX FROM table_name
MongoDb
MongoDB 旨在为WEB应用提供可扩展的高性能数据存储解决方案。
MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。
安装mongodb
下载,安装,配置环境变量。
下载mongodb shell, 方便终端命令行访问mongodb。
使用mongodb
- start mongodb 服务
打开powerShell 终端,输入
net start mongodb
就可以打开mongodb 数据库服务了
- 进入交互环境
mongosh
- 创建数据库/切换数据库
use dbname - 插入数据
db.COLLECTION_NAME.insertOne(document) 或
db.COLLECTION_NAME.save(document)
来插入数据,所有存储在集合中的数据都是 BSON 格式。
BSON 是一种类似 JSON 的二进制形式的存储格式,是 Binary JSON 的简称。
db.col.insert({title: 'MongoDB 教程',
    description: 'MongoDB 是一个 Nosql 数据库',
    by: '菜鸟教程',
    url: 'http://www.runoob.com',
    tags: ['mongodb', 'database', 'NoSQL'],
    likes: 100
})
也可以定义变量,
> document=({title: 'MongoDB 教程',
    description: 'MongoDB 是一个 Nosql 数据库',
    by: '菜鸟教程',
    url: 'http://www.runoob.com',
    tags: ['mongodb', 'database', 'NoSQL'],
    likes: 100
});
> db.col.insert(document)
- 删除文档
接下来我们移除 title 为 ‘MongoDB 教程’ 的文档:
>db.col.remove({'title':'MongoDB 教程'})
如果要删除所有的文档,则db.col.remove({})
- 更新数据
db.COLLECTION_NAME.update(document)
user> db.user.update({'name':'zhuyk'},{$set:{'name':'lisi','address':'yunnan'}},{multi:true})
DeprecationWarning: Collection.update() is deprecated. Use updateOne, updateMany, or bulkWrite.
{
  acknowledged: true,
  insertedId: null,
  matchedCount: 2,
  modifiedCount: 2,
  upsertedCount: 0
}
user> db.user.find()
[
  {
    _id: ObjectId("643587dbf584360416417058"),
    name: 'lisi',
    address: 'yunnan'
  },
  {
    _id: ObjectId("643587eff584360416417059"),
    name: 'lisi',
    address: 'yunnan'
  },
  {
    _id: ObjectId("64358af0f58436041641705a"),
    id: 122,
    name: 'zhangsan',
    address: 'shanghai'
  }
]
- 查询
- and 关系
db.col.find({key1:value1, key2:value2}).pretty() - or关系
db.col.find( { $or: [ {key1: value1}, {key2:value2} ] }).pretty() - or 和and组合
db.col.find({"likes": {$gt:50}, $or: [{"by": "菜鸟教程"},{"title": "MongoDB 教程"}]}).pretty()
- and 关系
NACOS
阿里巴巴开源的一款用于服务发现、配置和管理的软件。
官方介绍
是 Dynamic Naming and Configuration Service的首字母简称,一个更易于构建云原生应用的动态服务发现、配置管理和服务管理平台。
Nacos 致力于帮助您发现、配置和管理微服务。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据及流量管理。
Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。 Nacos 是构建以“服务”为中心的现代应用架构 (例如微服务范式、云原生范式) 的服务基础设施。
下载配置
官方地址:https://nacos.io/zh-cn/docs/quick-start-spring-boot.html
直接下载下来,简单配置一些就可以使用了。
- mysql中创建数据库,名为nacos, 并将nacos-mysql.sql中的语句导入mysql
导入的方式可以是:- 直接执行里面的sql语句(主要是创建各种表)
- 或者通过可视化mysql 软件导入
- application.properties
改一下这个地方,适合自己的mysql
### Connect URL of DB:
# db.url.0=jdbc:mysql://127.0.0.1:3306/nacos?characterEncoding=utf8&connectTimeout=1000&socketTimeout=3000&autoReconnect=true&useUnicode=true&useSSL=false&serverTimezone=UTC
# db.user.0=root
# db.password.0=root
- bin/startup.cmd 修改启动模式为单机
set MODE=“standalone”
启动
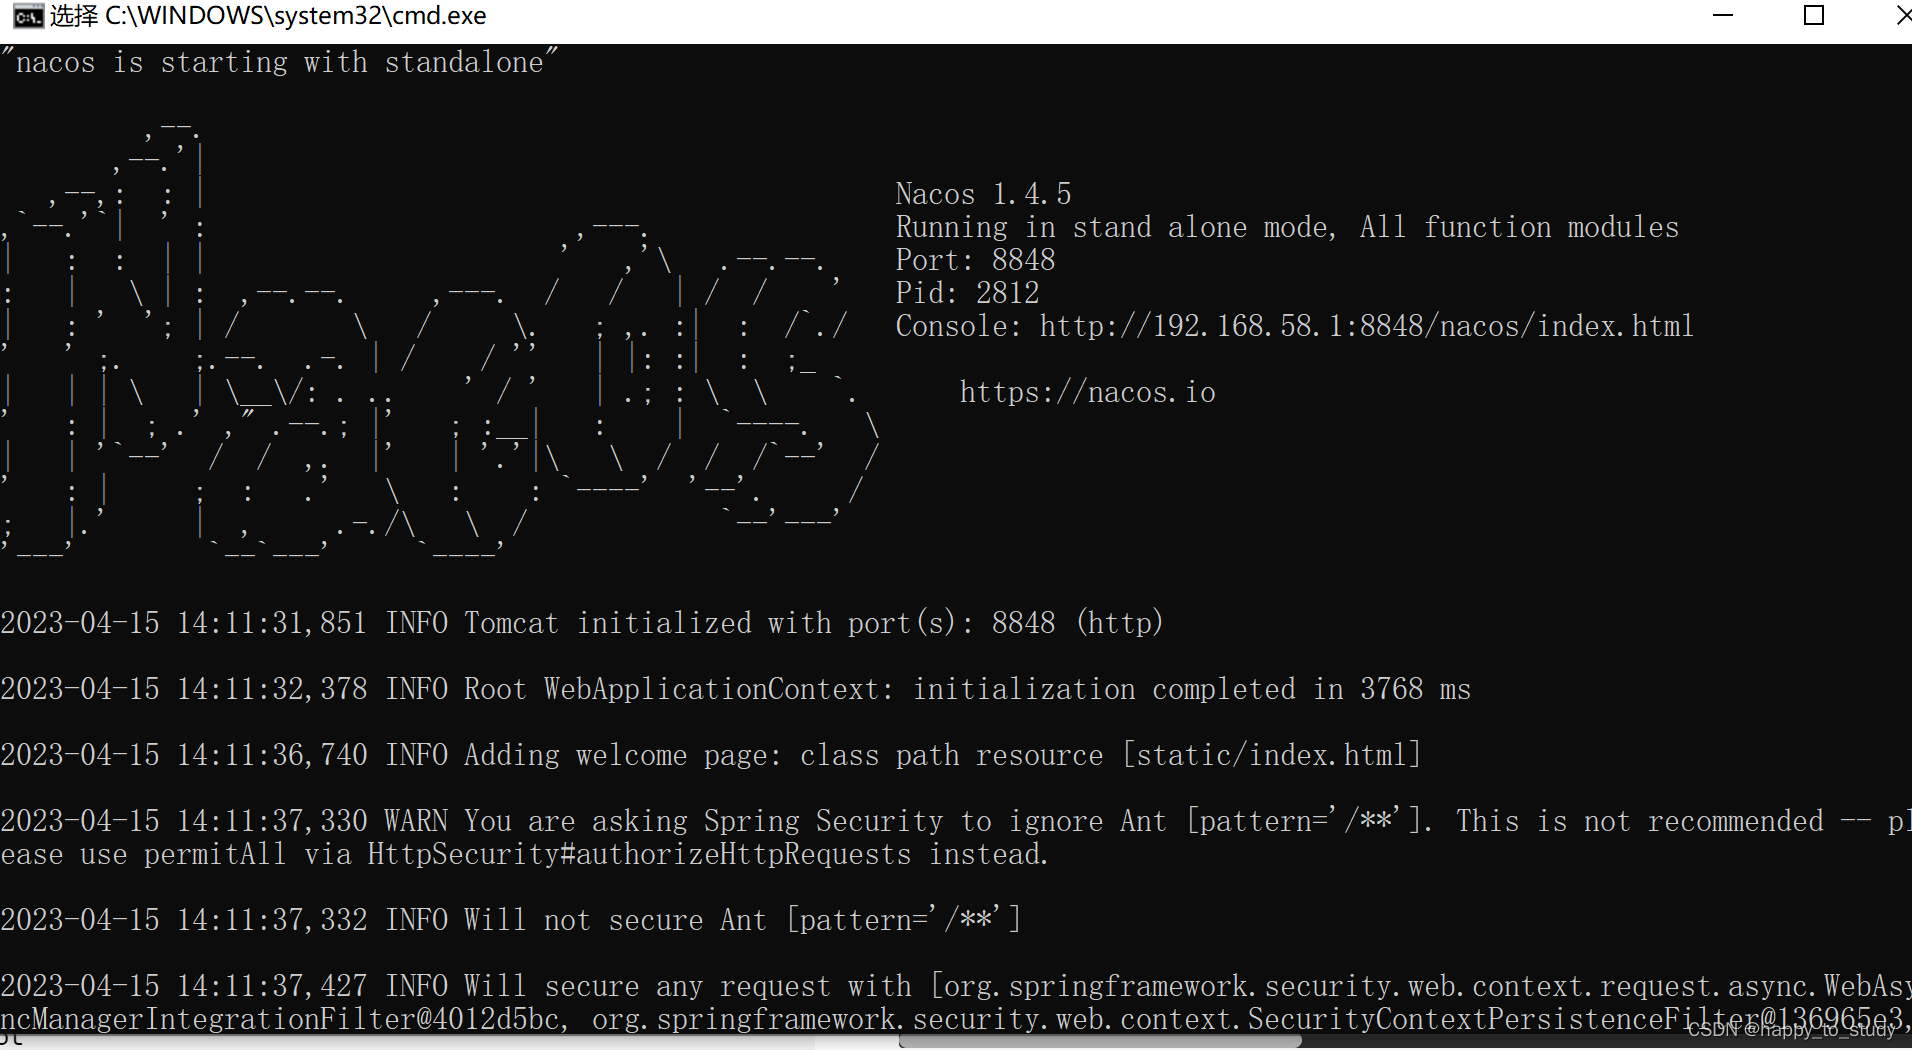
- 双击startup.cmd 就可以启动nacos了
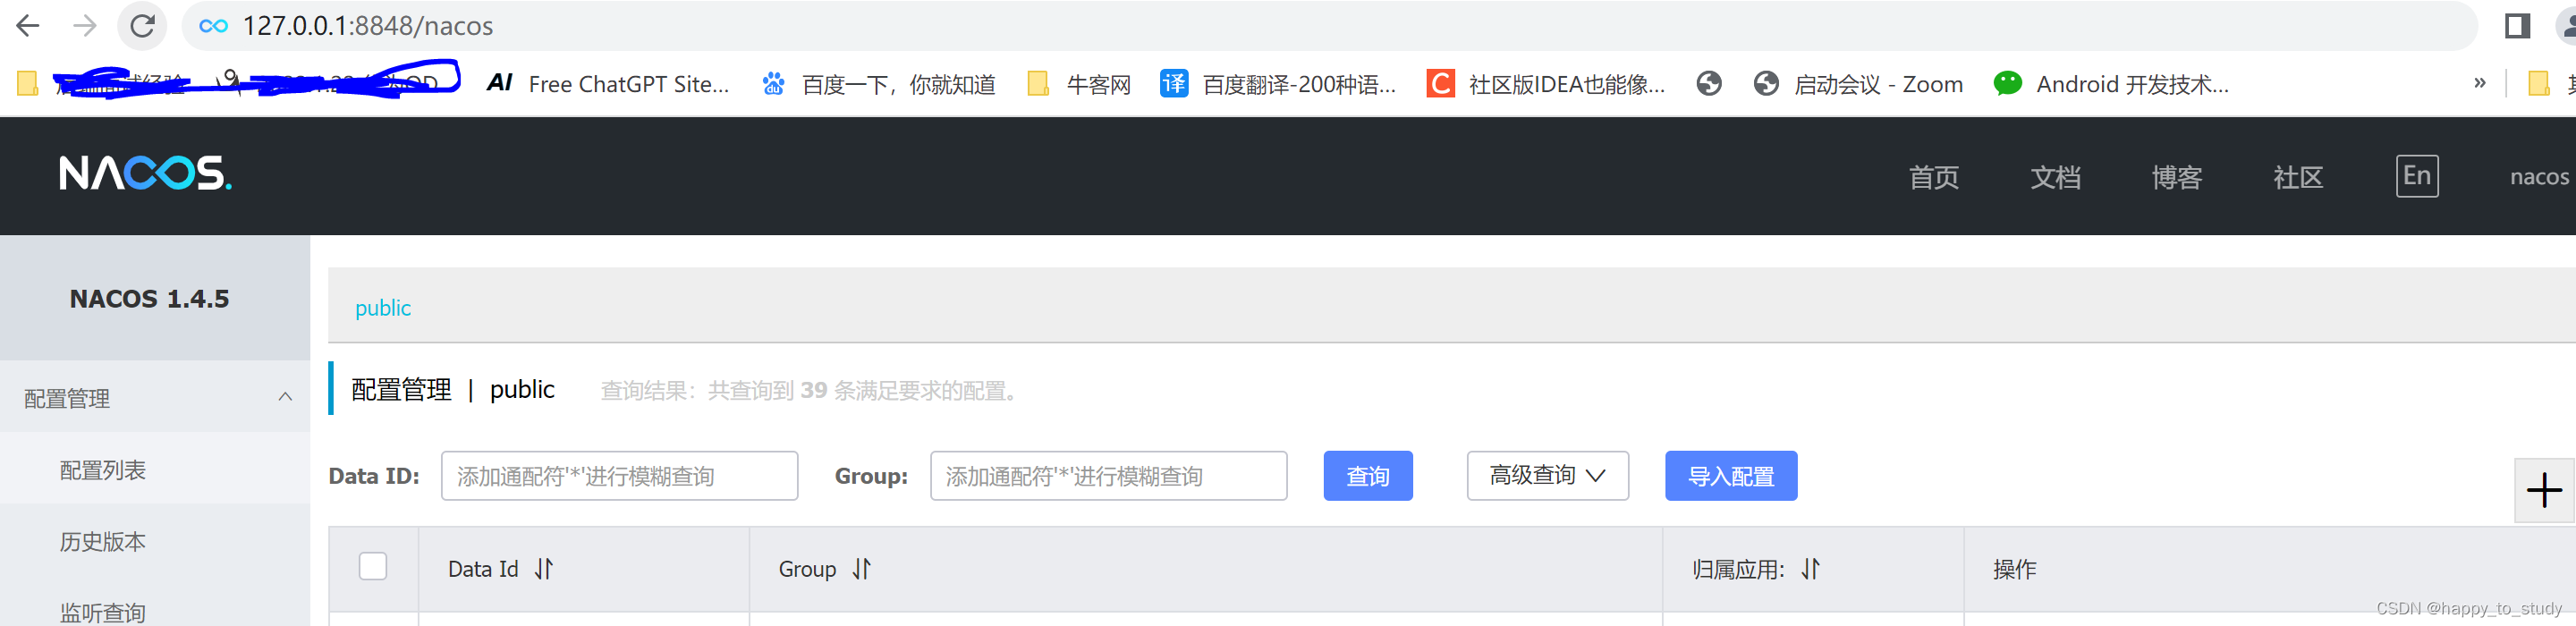
- 浏览器访问http://127.0.0.1:8848/nacos 地址就可以看到管理页面了
zookeeper
ZooKeeper 是 Apache 软件基金会的一个软件项目,它为大型分布式计算提供开源的分布式配置服务、同步服务和命名注册。
一个典型的分布式数据一致性的解决方案,分布式应用程序可以基于它实现诸如数据发布/订阅、负载均衡、命名服务、分布式协调/通知、集群管理、Master 选举、分布式锁和分布式队列等功能。
本质来说就是: 文件系统+ 变更通知。
下载安装
官方地址: https://www.apache.org/dyn/closer.lua/zookeeper/zookeeper-3.8.0/apache-zookeeper-3.8.0-bin.tar.gz
单机集群部署
- 创建目录zookeeper-cluster,将上面下载的压缩包解压到该目录,并命名为zookeeper-3.8.0-1
- 在zookeeper-3.8.0-1目录中,创建data, log两个文件夹
- 在data文件夹下创建文件名为 ‘myid’的文件,内容为1
- 进入conf文件夹,拷贝zoo_sample.cfg 副本,命名为zoo.cfg, 并配置内容为
tickTime=2000
initLimit=10
syncLimit=5
dataDir=data
dataLogDir=log
clientPort=3181
#设置集群信息,单机集群得情况下修改端口
server.1=127.0.0.1:2887:3887
server.2=127.0.0.1:2888:3888
server.3=127.0.0.1:2889:3889
-在 zookeeper-cluster目录整体拷贝两份zookeeper-3.8.0-1 ,命名为zookeeper-3.8.0-2,zookeeper-3.8.0-3
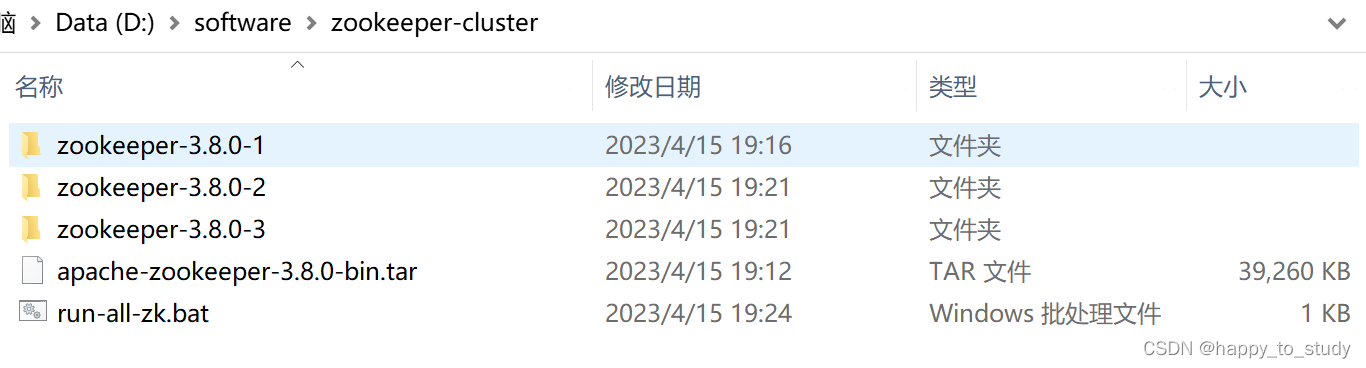
修改zookeeper-3.8.0-2中的myid文件内容为2,zoo.cfg 中clientPort=3182;
修改zookeeper-3.8.0-3中的myid文件内容为3,zoo.cfg 中clientPort=3183;
- 在zookeeper-cluster目录创建run-all-zk.bat 文件,作为启动集群的命令
内容为
cd zookeeper-3.8.0-1
start /MIN "zk1" "bin\zkServer.cmd"
cd ..
cd zookeeper-3.8.0-2
start /MIN "zk2" "bin\zkServer.cmd"
cd ..
cd zookeeper-3.8.0-3
start /MIN "zk3" "bin\zkServer.cmd"
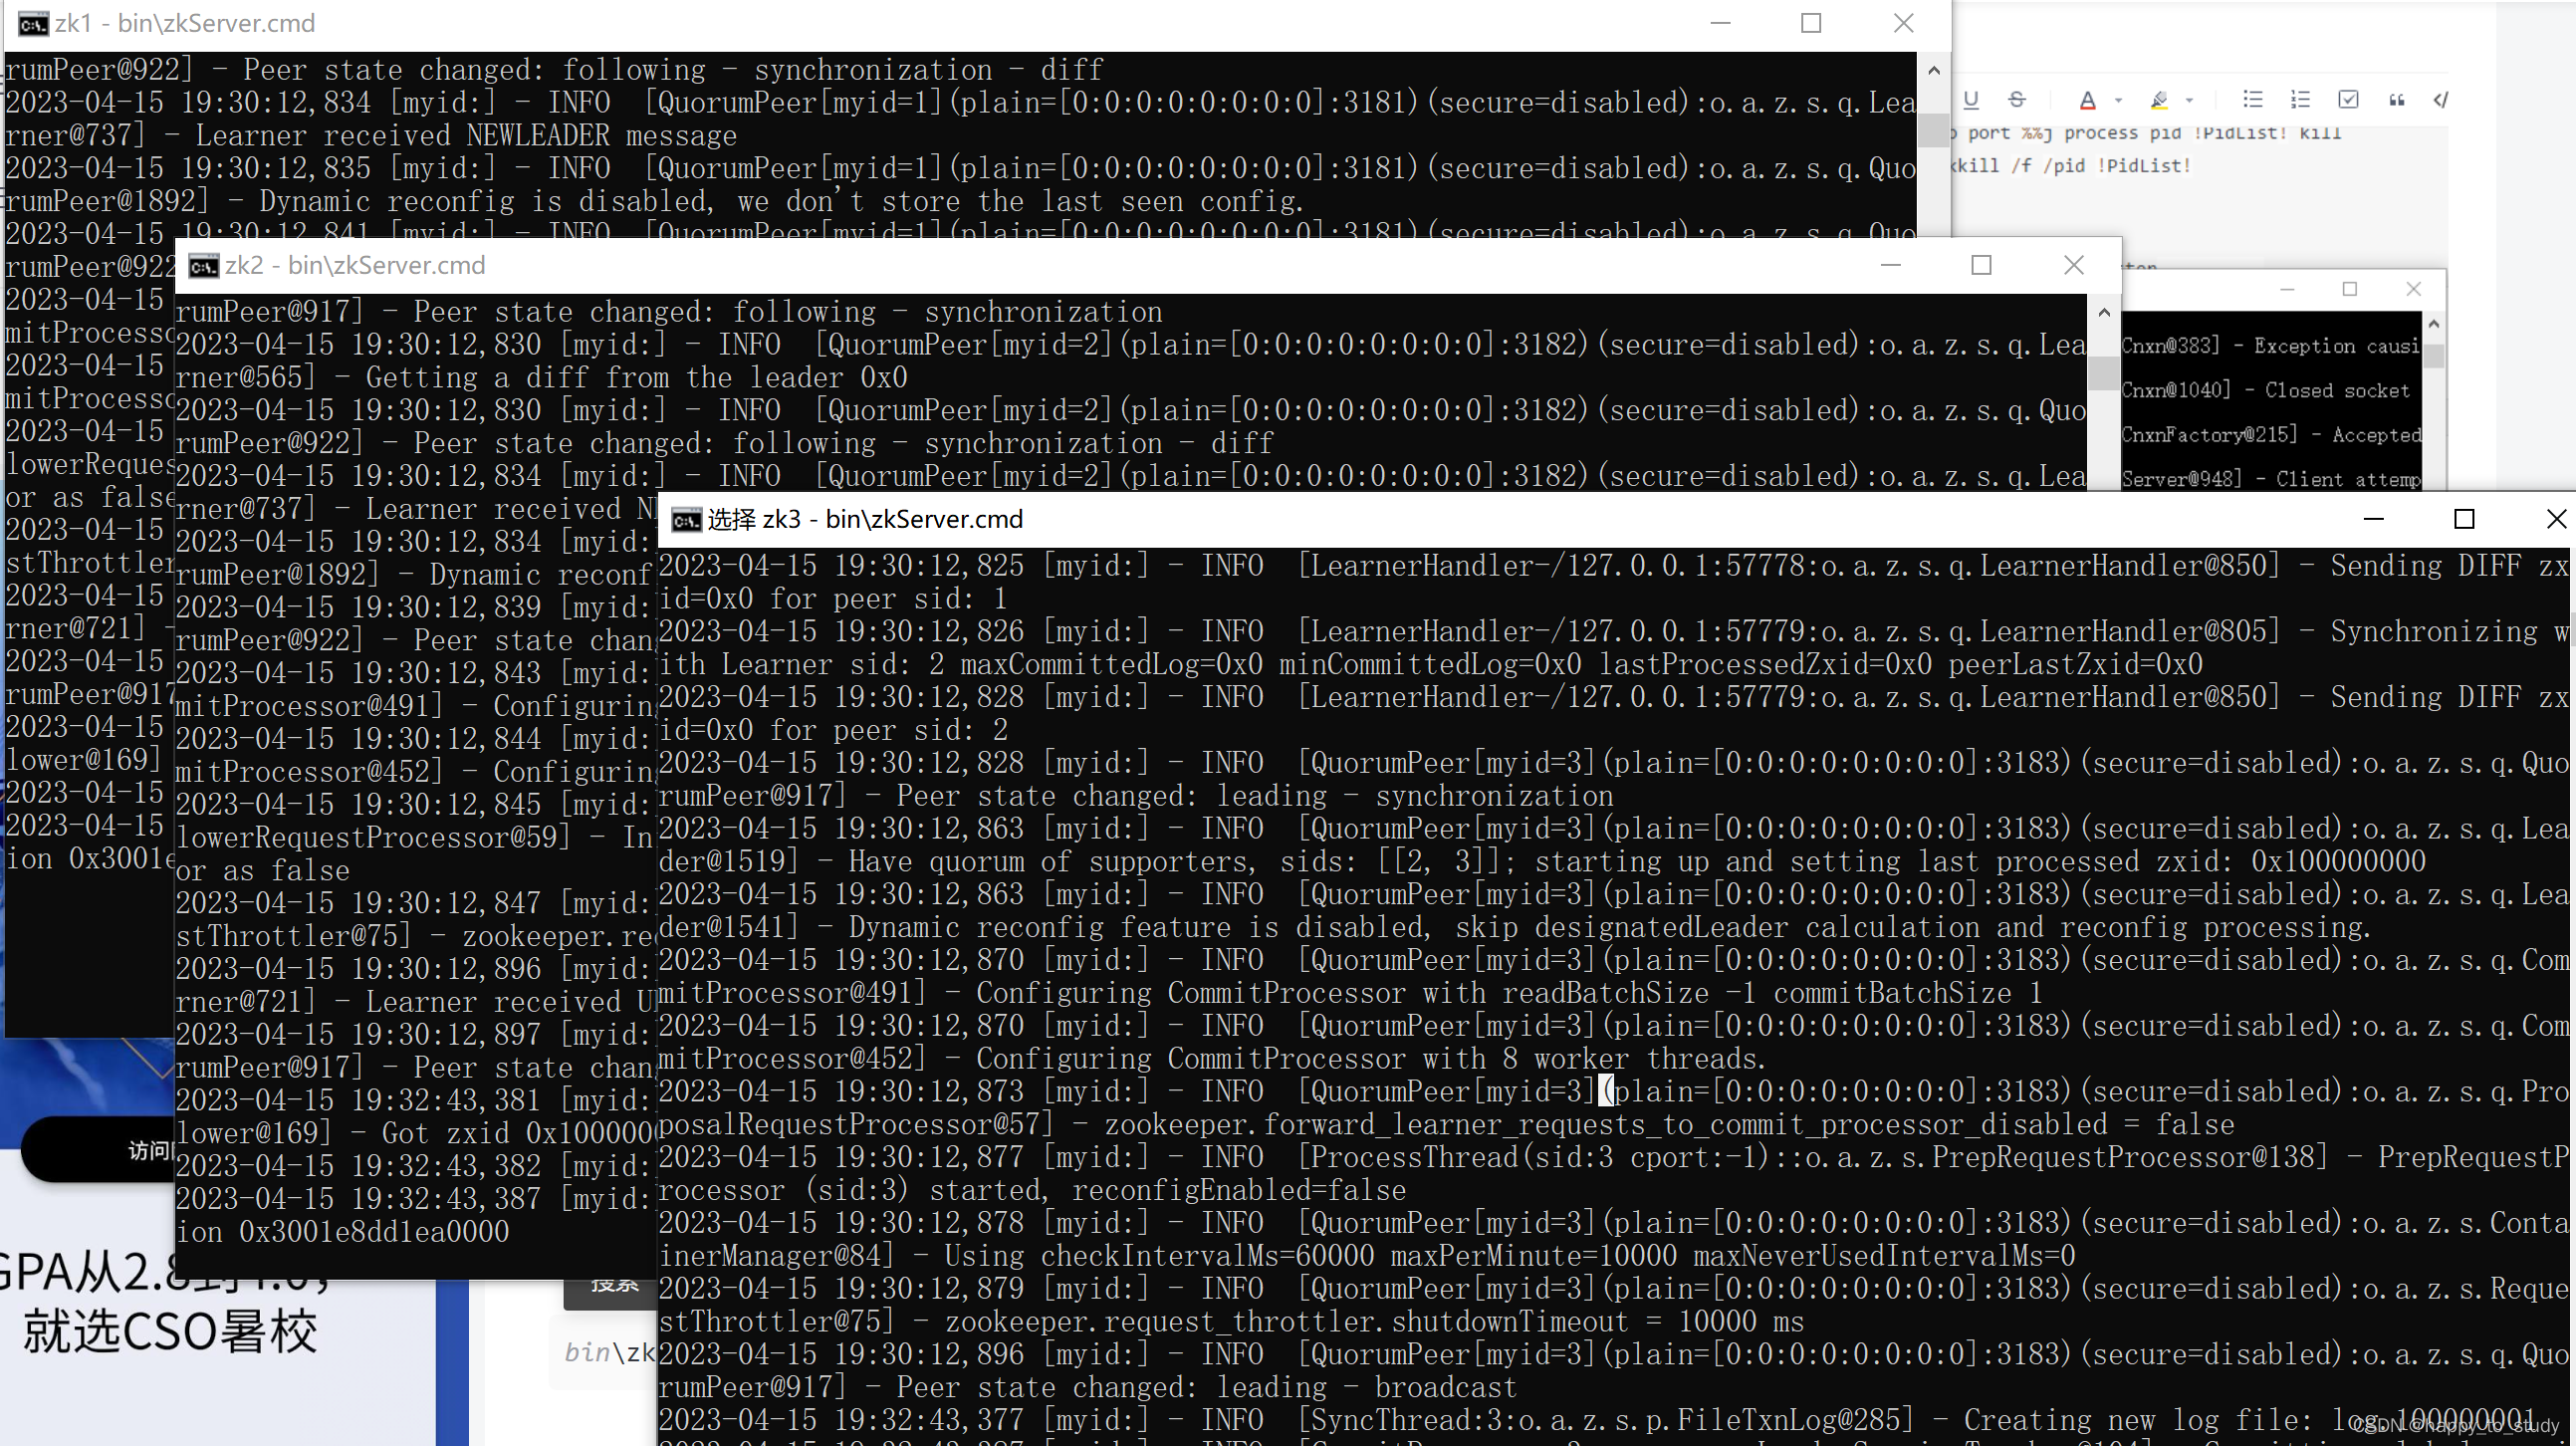
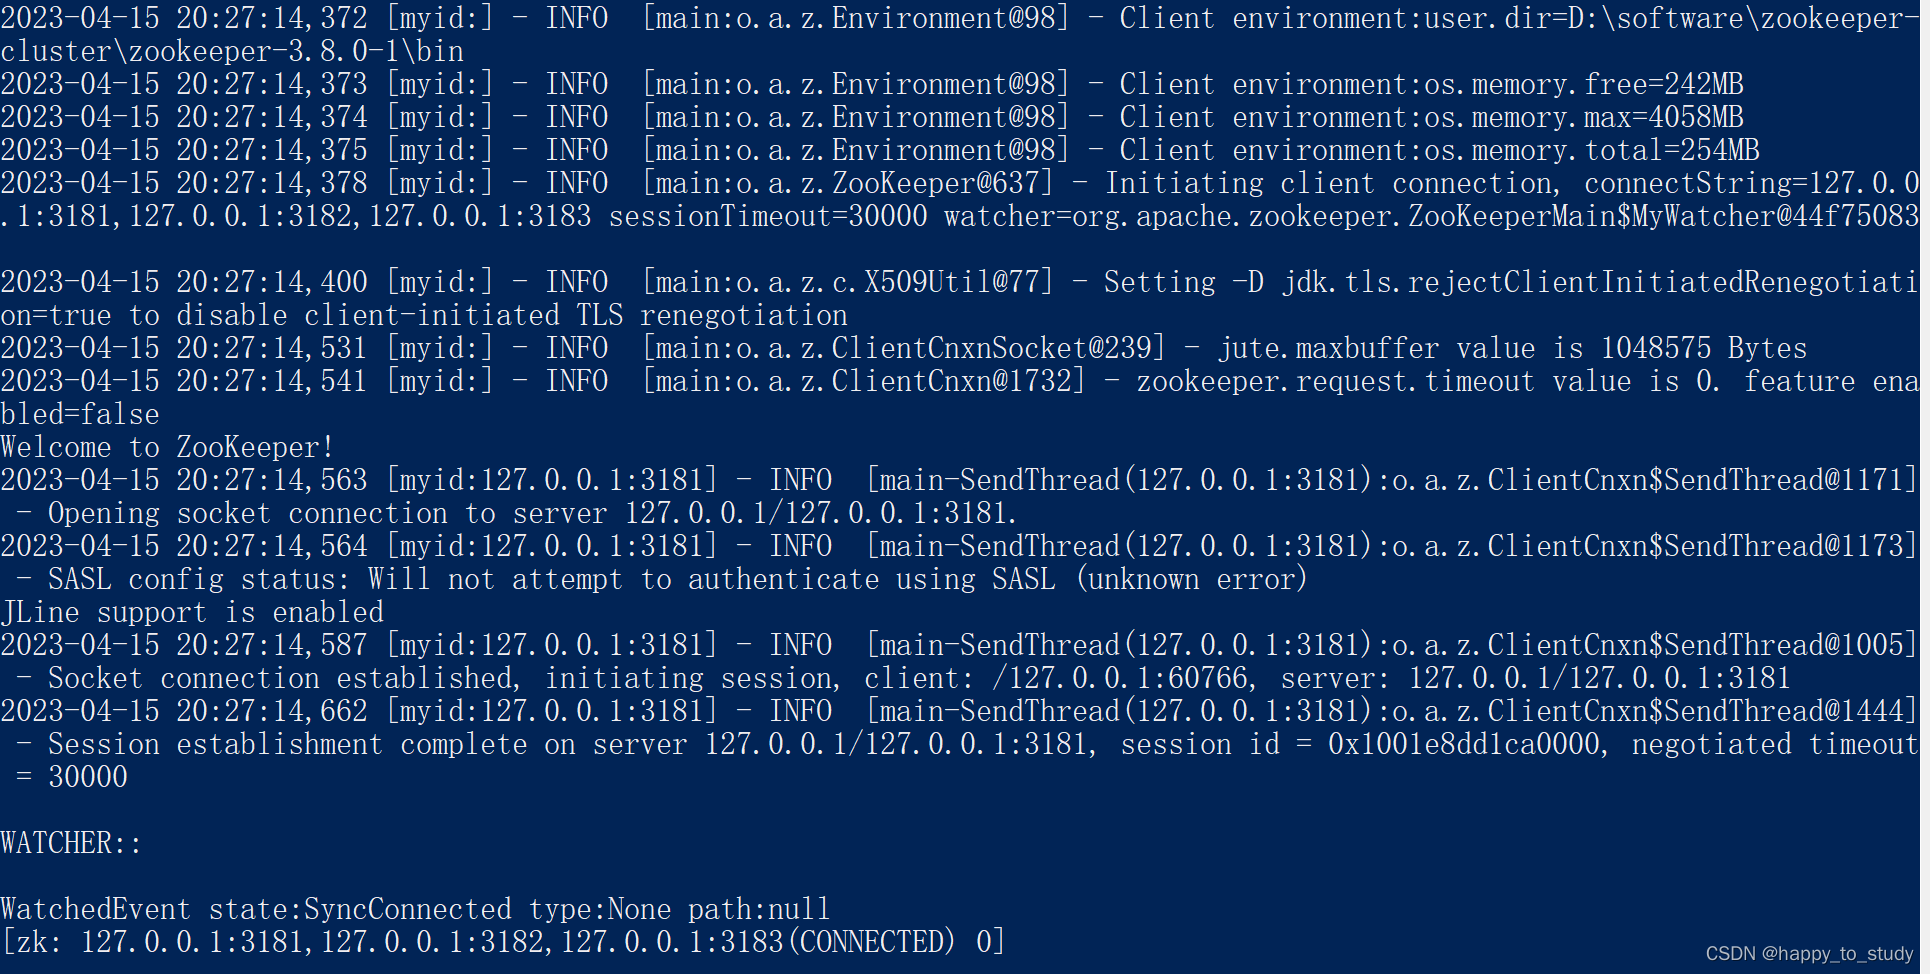
- 链接集群测试,打开zookeeper1的链接
进入zookeeper-3.8.0-1/bin/目录,按住shift 并鼠标右键,在当前目录打开一个shell 终端,执行下面的命令
./zkCli.cmd -server 127.0.0.1:3181,127.0.0.1:3182,127.0.0.1:3183
zookeeper的核心逻辑
它的用途:
它是一个为分布式应用提供一致性服务的软件,提供的功能包括:配置维护、域名服务、分布式同步、组服务等。
- 节点, 一般不建议存大量数据,理论不能超过1M,实际最好不要超过1KB。
- 修改节点,其他的观察者可以收到通知。
- 监听节点能力
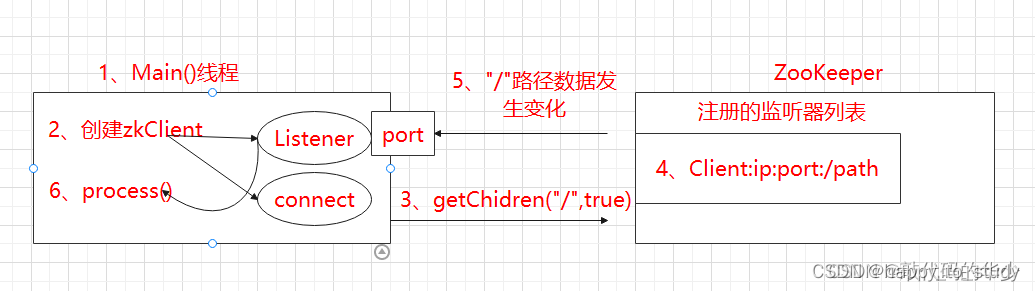
- 监听流程:
- 首先要有一个 main() 线程
- 在 main 线程中创建 Zookeeper 客户端,这时就会创建两个线程,一个负责网络连接通信(connet),一个负责监听(listener)
- 通过 connect 线程将注册的监听事件发送给 Zookeeper
- 在 Zookeeper 的注册监听器列表中将注册的监听事件添加到列表中
- Zookeeper 监听到有数据或路径变化,就会将这个消息发送给 listener 线程
- listener 线程内部调用了process()方法
下面这就是客户端监听zookeeper(“127.0.0.1:3181”) 节点(“/zookeeper”)变化的demo。
 static ZooKeeper zooKeeper = null;
    public static void main(String[] args) {
        try {
            final CountDownLatch countDownLatch = new CountDownLatch(1);
            zooKeeper = new ZooKeeper("127.0.0.1:3181", 15000, new Watcher() {
                @Override
                public void process(WatchedEvent event) {
                    try {
                        System.out.println("kai-output: " + event.getPath() + ", " + event.getState() + ", " + event);
                    } catch (Exception e) {

                    }

                }
            });
            zooKeeper.getChildren("/zookeeper", true);
            Thread.sleep(Long.MAX_VALUE);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
刚链接上时输出
kai-output: null, SyncConnected, WatchedEvent state:SyncConnected type:None path:null
当在/zookeeper 底下通过create /zookeeper/node 添加节点时,监听者会收到通知
kai-output: /zookeeper, SyncConnected, WatchedEvent state:SyncConnected type:NodeChildrenChanged path:/zookeeper
- 如果要监听节点内容变化
可以zooKeeper.getData(path, true, stat).
函数原型为:
public byte[] getData( String path, boolean watch,
org.apache.zookeeper.data.Stat stat )
典型应用
统一配置管理
如果服务部署在多个机器上,怎么做到统一的配置修改呢? 总不能一个个地去修改吧。所以就可以使用zookeeper的强一致性。
各个服务作为客户端连接上zookeeper,监听某个节点。 当要修改配置信息时,就修改节点的内容,从而各个监听者都可以收到通知,并做响应更新。
统一命名服务
分布式系统下,由于一个服务同时运行在多个机器上,对应了多个ip地址,我们记ip地址很困难。所以可以通过统一的某个节点,存入ip地址,表示这个服务的ip地址。
还可以用来做全局唯一性的uuid 等。
集群管理(文件系统+通知机制)
- 监控集群服务器状态
所有服务器约定在父目录下创建临时目录节点,然后监听父目录节点的子节点变化消息。一旦有机器挂掉,该机器与 zookeeper的连接断开,其所创建的临时目录节点被删除,所有其他机器都收到通知;添加机器类似。
这样通过看父目录有多少子节点,就知道有多少服务在线。
- 对集群进行管理
- 负载均衡:所有机器在zookeeper中创建自己的目录节点,zookeeper根据负载均衡算法将任务分发到各个机器节点中处理
- 集群master选举:多个客户端请求创建同一个临时节点,那么最终一定只有一个客户端请求能够创建成功,利用这个特性,就能很容易的在分布式环境中进行master选举了。
- 分布式锁:保证同一时刻只有一个应用程序对共享资源的访问,应用程序在zookeeper中创建临时顺序节点,每次只有序号最小的获得锁。
分布式锁
ZooKeeper 实现分布式锁一般有两种方式。一种是保持独占,一种是控制时序。
第一种方式:我们将 ZooKeeper 上的一个znode看作是一把锁,通过createznode的方式来实现。所有客户端都去创建 /distribute_lock 节点,最终成功创建的那个客户端也即拥有了这把锁。用完删除掉自己创建的 distribute_lock 节点就释放出锁。
第二种方式:/distribute_lock 已经预先存在,所有客户端在它下面创建临时顺序编号目录节点,编号最小的获得锁,没有获得锁的客户端监听编号比自己小的前一个节点,因为节点是顺序的,很容易找到自己的前一个节点,当监听到前一个节点删除节点释放锁,该客户端就会获得锁。这种方式避免了所有客户端需要监听一个节点和节点删除需要通知所有客户端的情况。
注意:第一种方式不适用于客户端数量很大的情况,当一个客户端拥有第一把锁之后,所有的客户端都要去监听节点,节点的释放也会通知所有的客户端,这样会出现羊群效应。
三种典型角色
-
leader
处理所有的事务(写请求),也可以处理读请求,集群中只能有一个leader。
集群中唯一处理事务的角色。
接受所有follower的提案请求,并发起投票,与follower进行data通信 -
follower
可以处理读请求,有投票权。leader 的候选人。 如果leader宕机,则参与新的leader选举,可能被选中成为新的leader。 -
观察者observer
只能处理读请求, 无投票权。 3.3 才新增的角色。
更多推荐



 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)