
哈希表的简单理解
一、哈希表简介
哈希(散列)表可以看成一个数组,在存入数值或元素的时候通过映射关系,找到数组对应的位置就可以将元素存入数组中,这样在不存在哈希冲突情况下,查找该元素的效率为O(1)。
二、哈希表的映射方式
1、直接定值法
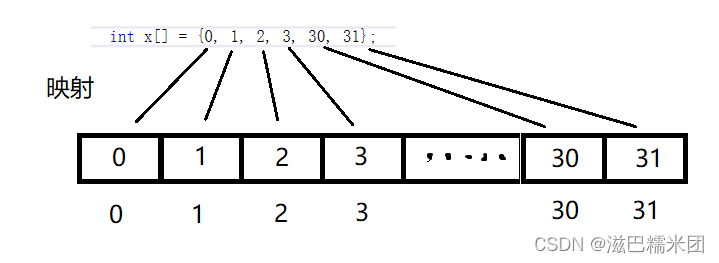
如上图所示,直接定值法通过需要存入的数值,作为数组的下标,直接存入对应位置。 缺点 是存入表中的元素必须是整形,不然找到对应的映射位置,而且如果最大值和最小数值差值较大,就可能浪费很多空间,如上图,3~30之间就是空置着的位置,所以直接定值法的应用场景较为局限。
2、除留余数法
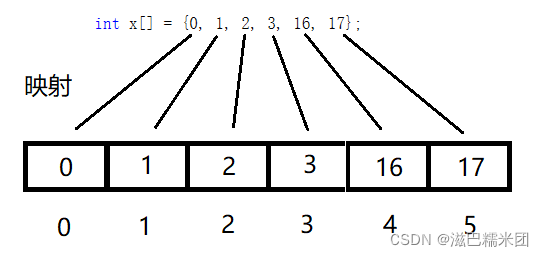
除留余数法,就是先开出一个数组,数组大小为数组x的集合大小,然后通过x中的每个数值 % 数组大小,就可以找到映射的位置,如上图,16 % 6 = 4,故存入数组下标4的位置。上图是在负载因子为1的情况下的映射结果。
2.1、负载因子a
负载因子a就是控制数组扩容的临界值,当当前数组已经存入的数值个数 _n 除于 数组大小 的值大于负载因子a时,数组就需要扩容,保证下次存入数组有多余的空位。负载因子越小,效率越高,哈希冲突越少,但同时数组中空闲的位置越多,空间浪费的也越多,反之,效率低,空间利用率高。
2.2、哈希冲突
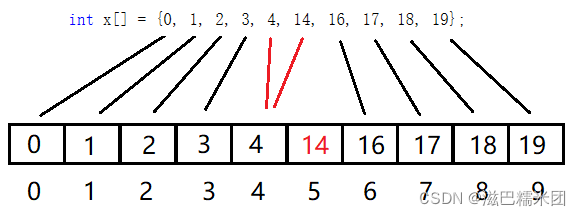
哈希冲突就是在除留余数的过程中余数相同,如上图 4 % 10 = 4 ,14 % 10的结果也是4,这样两个数就映射到同一个位置,就造成了冲突,而应对哈希冲突的办法,根据哈希表的种类是闭散列还是开散列有不同的应对办法。
三、哈希表种类及部分功能代码模拟实现
1、闭散列
闭散列遇到哈希冲突时,通过 线性探测 的方法,如上图所示,就是向后移一位,直到找到空位就把数值存入表中;还有一种是 二次探测 ,就是第一次后移1的平方位查找空位,没找到,就平移2的平方位查找,类推后面就是 i 的平方位。
1.1、闭散列部分代码实现
1.1.1、闭散列中的节点以及状态
写哈希表的时候,我们首先该想想怎么确定哈希表每个节点是否已经存入数值,防止某个节点已近存入数值又被我们覆盖了,而如果我们简单的用0来表示某个节点的没有值的话,那当我们存入0的时候就会有冲突,我这边通过给每个节点设置3个状态,来区分节点位置是否存入元素,具体代码如下:
enum state//确定每个点状态
	{
		EMPTY,//表示当前节点没有值,可存入数据
		EXIT,//已经存入数值,节点被占用
		DELET//节点数值被删除,假删除
	};
    //哈希节点
	template<class k,class v>
	struct hashdata
	{
		pair<k, v> _kv;//每个节点的数据
		int _state = EMPTY;//每个节点默认设置为空
	};
1.1.2、闭散列中的仿函数
当需要存入字符串类型时,我们不能向存整形一样直接求出映射位置,这时我们就需要一个仿函数,把字符串变成特定的整形数字,然后再求出映射位置,仿函数代码如下:
//仿函数,用于数据转换
	template<class k>
	struct hashfnc//默认整形
	{
		size_t operator()(const k& key)
		{
			return key;
		}
	};

	template<>
	struct hashfnc<string>//上面函数模板的特化,string类型特化
	{
		size_t operator()(const string& key)
		{
			size_t out = 0;
			for (auto& ch : key)
			{
				out += ch;//取出string的每个字符,用字符的ASCII码相加
				out *= 131;//然后乘以特定的数值,使其转化成一个整形
			}
			return out;
		}
	};
其中hashfnc就是我们要用的仿函数,第一个函数模板,默认为整形值返回,而第二个hashfnc< string>则是函数模板的特化,在输入参数为string类型时,仿函数自动用特化的string类型的函数,通过string中的每一个字符ASCII码相加,并乘以一个特定的数值,转化为特定的数值。值得一提的是,当需要其他类型的转化时,也可以根据不同的类型写不同的特化函数。
仿函数使用方法:在每次计算位置之前,实例话一个仿函数,如:
hashfnc h;//实例化
size_t index = h(key) % 10;//计算位置
其中key就是要存的元素,通过实例化的仿函数h,得出对应值,最后求出映射位置index。
1.1.3、闭散列查找函数
查找函数通过需要查找的元素的映射关系,计算出元素存储的位置,对比于需要查找的元素是否相等且不是DELEET状态,不相等可能时遇到哈希冲突后移了,就后移查找,如果遇到空,说明没有这个元素,返回空,找到返回节点指针,具体代码如下:
hashdata<k, v>* FIND(const k& key)
		{
			if (_n == 0)//如果没有数据,查找肯定为空
			{
				return nullptr;
			}
			Hashfnc h;//仿函数实例化,用以后面计算位置
			size_t index = h(key) % _table.size();//h(key)通过仿函数,得具体数值
			while (index < _table.size() && _table[index]._state != EMPTY)//找到空说明没有这个值
			{
				if (_table[index]._state != DELET && _table[index]._kv.first == key)
				{
					return &_table[index];
				}
				index += 1;
			}
			return nullptr;
		}
1.1.4、闭散列插入函数
插入元素的三种情况:(1)待插入元素以存在,我们先查找元素是否已经存在于哈希表中,如果存在,则返回false。(2)容量超过负载因子了,需要扩容,开一个新的哈希表,resize()两倍当前容量,然后复用insert函数把旧的哈希表的内容,在新哈希表中拷贝一份,最后新旧哈希表交换。(3)通过除留余数法,计算待存入元素的映射位置,找到位置查看该位置状态是否已经存入数据,如果已经存入数据,就使用线性探测或二次探测等等的方法向后查找empty的位置,存入元素,具体代码如下:
//插入
		bool insert(const pair<k,v>& kv)
		{
			hashdata<k, v>* kdata = FIND(kv.first);
			if (kdata)//去重
			{
				return false;
			}

			if (_table.size() == 0)//开始没有空间,先开辟10个空间
			{
				_table.resize(10);
			}
			else if ((float)_n / (float)_table.size() > 0.7)//负载因子设置为0.7,确保每次插入有地方可放,至少有30%的空间时空的
			{
				hash<k, v> newhash;
				newhash._table.resize(_table.size() * 2);
				for (auto& ch : _table)//把旧的数据存入新的哈希表,并使用自己的insert插入,减少代码量
				{
					if (ch._state == EXIT)
					{
						newhash.insert(ch._kv);
					}
				}
				_table.swap(newhash._table);//旧地址和新地址交换
			}
			Hashfnc h;
			size_t index = h(kv.first) % _table.size();//确定位置
			while (_table[index]._state == EXIT)
			{
				index += 1;
				index %= _table.size();//防止超出size()范围
			}
			_table[index]._kv = kv;
			_table[index]._state = EXIT;
			_n++;
		}
1、开散列
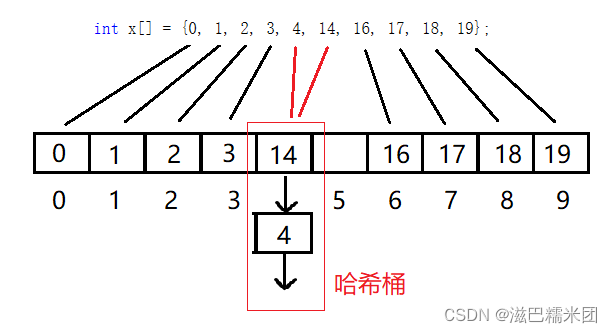
开散列在数组中的每个位置都存的是一个链表节点,当遇到冲突时,把冲突的值都放入哈希桶内,就是通过链表的 _next 把冲突为链接到数组的同一个位。值得注意的是,如果哈希冲突过多的情况,在哈希桶里面存的节点过多,可能会影响查找效率,所以一般在哈希桶里节点数超过8时,我们可以在桶的下面用红黑树的结构,优化这种极端情况。
1.2、开散列部分代码实现
1.2.1、开散列中的节点
开散列的每个位置存的一个节点都有_next指针,用于遇到哈希冲突时,往_next下面链接节点,具体代码如下:
	//开散列存下一个节点指针和数据
	template<class t>
	struct Node
	{
		Node(const t& kv)//构造函数
		:_next(nullptr), _kv(kv)
		{}
		Node<t>* _next;
		t _kv;//节点数据
	};
1.2.2、koft仿函数
koft仿函数主要是用来获取映射位置的参考元素,当我们的存入的元素是只有一个值时,我们可直接使用,但是如果存入的元素时pair值,那我们旧不然直接通过pair计算位置,而是通过pair中的某个参数作为参考值计算位置,而koft仿函数,就是用来取出这参考值的函数,具体代码如下:
struct koft//第一种,存入的是一个元素
		{
			const k& operator()(const k& kv)
			{
				return kv;
			}
		};
struct koft//第二种存入的是两个元素,是一个pair
		{
			const k& operator()(const pair<k,v>& kv)
			{
				return kv.first;
			}
		};
koft的使用方法:
fnc h;
koft kot;//实例化一个koft仿函数
size_t index = h(kot(_nodei->_kv)) % _ht->_table.size();
//把_nodei->_kv中的参考元素取出,再用h仿函数,得到具体值
1.2.3、开散列的迭代器
迭代器是一个很好用的东西,我们哈希表肯定也有,其中最主要的是++函数,++函数的实现,有两种情况,情况一:迭代器的当前节点的_next有值(桶内有值,哈希冲突的值),则++的结果是_next的节点。情况二:_next没有值,那我们就找哈希表下一个有值的位置,通过当前节点元素,计算当前元素在哈希表中的位置index,然后index + 1就是下一个节点的位置,如过下一个节点没有值,就++index,如果找到把节点赋值给当前节点,返回*this,如果超过哈希表的容量大小还没找到就直接赋值nullptr,具体代码如下:
	//迭代器
	template<class k,class t,class koft,class fnc = hashfnc<k>>
	struct hashiterator
	{
		typedef Node<t> node;
		typedef Hash<k,t,koft,fnc> hashi;
		typedef hashiterator<k,t,koft,fnc> self;

		hashi* _ht;//需要前置声明
		node* _nodei;

		hashiterator(node* data, hashi* ht)//构造函数名不能用typedef的名字如:self()
			:_nodei(data), _ht(ht)
		{}
		self& operator++()
		{
			if (_nodei->_next)//_next存在说明桶里还有,++就是next
			{
				_nodei = _nodei->_next;
			}
			else//next没有就说明得下一个index,计算node所在位置++
			{
				fnc h;
				koft kot;
				size_t index = h(kot(_nodei->_kv)) % _ht->_table.size();
				++index;
				while (index < _ht->_table.size())
				{
					if (_ht->_table[index])
					{
						_nodei = _ht->_table[index];
						return *this;
					}
					else
					{
						++index;
					}
				}
				_nodei = nullptr;
			}
			return *this;
		}

		t& operator*()
		{
			return _nodei->_kv;
		}
		t* operator->()
		{
			return &_nodei->_kv;
		}
		bool operator!=(const self& it) const
		{
			return _nodei != it._nodei;
		}
		bool operator==(const self& it) const
		{
			return _nodei == it._nodei;
		}
	};
1.2.3、开散列的查找函数
查找元素,首先通过元素计算哈希表中的对应位置,如果位置上的元素为空,则查找的元素不存在,如果位置上的元素不为空,但是不是要找的元素,就往_next下面找,找到返回当前节点的迭代器,没找到返回end(),居然代码如下:
iterator FIND(const k& key)
		{
			if (_n == 0)
			{
				return end();
			}
			fnc h;
			size_t index = h(key) % _table.size();
			node* cur = _table[index];
			while (cur)
			{
				if (kot(cur->_kv) == key)
				{
					return iterator(cur, this);
				}
				cur = cur->_next;
			}
			return end();
		}
1.2.4、开散列的插入函数
insert()函数的返回值是pair<iterator,bool>类型,开散列的插入和闭散列的插入类似,都有三种情况:(1)查找需要存入的元素,如果找到不存储,返回一个pair类型的元素,其中包含找到元素的迭代器和false。(2)需要扩容,和闭散列不同的是,开散列的扩容不再复用insert()函数,因为,如果复用insert会重新开辟好多空间,效率较低,直接使用已有的节点存入新哈希表比较好。首先还是开新的哈希表resize()扩容两倍,用for循环把旧哈希表的每个节点头插到新的哈希表中,最后替换新旧哈希表的_table。(3)直接插入,开一个新节点,计算位置,头插到映射位置。
		pair<iterator,bool> insert(const t& kv)//查重->是否扩容->插入
		{
			koft kot;
			auto kdata = FIND(kot(kv));//查重,重了不插入返回false
			if (kdata != end())
			{
				return make_pair(iterator(kdata,this),false);
			}
			fnc h;
			if (_n == _table.size())//没空间或空间满了扩容
			{
				Hash newhash;//开新hash
				size_t sz = _table.size() == 0 ? 10 : _table.size() * 2;//0阔到8,满了阔2倍
				newhash._table.resize(sz);
				for (size_t i = 0; i < _table.size(); i++)//把旧空间的内容放到新空间
				{
					if (_table[i])
					{
						Node<t>* cur = _table[i];
					    while (cur)//while把一个位置上的所以next的node取出放新hash里
					   {
						   size_t index = h(kot(cur->_kv)) % newhash._table.size();//扩容重新计算位置,之前冲突可能没了
						   Node<t>* next = cur->_next;
						   //头插
						   cur->_next = newhash._table[index];//next指针指向新地址空间
						   newhash._table[index] = cur;//把新指针变量换成旧指针变量
						   cur = next;
				     	}
					}

				}
				_table.swap(newhash._table);
			}
			node* newnode = new node(kv);
			size_t index = h(kot(kv)) % _table.size();
			node* next = newnode->_next;
			newnode->_next = _table[index];
			_table[index] = newnode;
			_n++;
			return make_pair(iterator(newnode,this),true);
		}
四、封装unordered_set和unordered_map
1、封装unordered_set
unordered_set里通过一个哈希表实现,内部函数都使用哈希表的函数实现,具体代码如下:
#pragma once
#include "hash_me.h"

namespace ljw1
{
	template<class k>
	class underset
	{
		struct koft
		{
			const k& operator()(const k& kv)
			{
				return kv;
			}
		};
	public:
		typedef typename openhash::Hash<k, k, koft>::iterator iterator;
		iterator begin()
		{
			return _ht.begin();
		}

		iterator end()
		{
			return _ht.end();
		}

		pair<iterator, bool> insert(const k kv)
		{
			return _ht.insert(kv);
		}

	private:
		openhash::Hash<k, k, koft> _ht;
	};
2、封装unordered_map
unordered_map里也是通过一个哈希表实现,内部函数都使用哈希表的函数实现,和unordered_set不同的是它存的是pair元素,具体代码如下:
#pragma once
#include "hash_me.h"

namespace ljw
{

	template<class k,class v>
	class underMap
	{
	public:
		struct koft
		{
			const k& operator()(const pair<k,v>& kv)
			{
				return kv.first;
			}
		};

		typedef typename openhash::Hash<k, pair<k, v>, koft>::iterator iterator;
		iterator begin()
		{
			return _ht.begin();
		}
		iterator end()
		{
			return _ht.end();
		}
		pair<iterator, bool> insert(const pair<k, v>& kv)
		{
			return _ht.insert(kv);
		}
		v& operator[](const k& key)
		{
			auto& ret = _ht.insert(make_pair(key,v()));
			return ret.first->second;
		}

	private:
		openhash::Hash<k, pair<k, v>, koft> _ht;
	};
五、哈希表代码已上传自行下载
更多推荐



 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)