
二叉查找树/AVL树/红黑树/B树/B+树概念扫盲大法-数据结构与算法小结3(升级版)
本期来一期对各类树的概念扫盲,建立对主流的几种树的基本的认识;
本篇的核心主线为:如何更快的操作(增删改查)一条数据?能不能更快?再快,如何最快?看到最后,你如果理解了为什么下面的各类树结构会越来越快的话,基本就掌握到窍门了,可以投身实战了;(本篇阅读需要耐心慢慢看)
本期脑图:

在没有了解这些数据结构之前,我们想要查找一个数据通过什么方式?
遍历:就是一个一个找,想不想更快?二叉查找树满足你!

1.二叉查找树:
二叉查找树(Binary Search Tree),有序二叉树(ordered binary tree),排序二叉树(sorted binary tree),都是一个东西,是指一棵空树或者具有下列性质的二叉树:
1.在节点不为空的基础上,左子树上所有结点的值均小于它的根结点的值;右子树上所有结点的值均大于它的根结点的值;
2. 任意节点的左、右子树也分别为二叉查找树。
说人话:右边的数据比左边数据大;
No图No BB,如图:

在以上保证有序的基础上,查找操作就不需要一个一个的遍历,每次都可以经过判断过滤掉一半的数据,速度会更快!

但是各位伙计看一下上图的插入操作,如果刚好不幸,连续插入5个数字:9,10,11,12 ,13 会变成什么样子?

会变成“大长腿”,那假如查找的数据刚好是13,在大长腿的最后位置,和链表遍历就没差别了,怎么解决这个问题呢?
AVL树满足你:(不能去掉 L哈)


2.AVL树(平衡二叉查找树)
AVL树本质上还是一棵二叉搜索树,它的特点是:
1.本身首先是一棵二叉搜索树。
2.带有平衡条件:每个结点的左右子树的高度之差的绝对值(平衡因子)最 多为1。
说人话:AVL树,本质上是带了平衡功能的二叉查找树(二叉排序树,二叉搜索树)。在插入或删除节点操作后,AVL树会根据自身规则适当左旋或者右旋来保持左右子树的高度之差的绝对值(平衡因子)最多为1的平衡;
如图:

关于插入或删除操作相关的左旋以及右旋操作,会相对复杂:
如果在AVL树中进行插入或删除节点,可能导致AVL树失去平衡,这种失去平衡的二叉树可以概括为四种姿态:LL(左左)、RR(右右)、LR(左右)、RL(右左)。它们的示意图如下:

--------------------------------------------
友好提示:接下来关于AVL树的左旋右旋会有一点晦涩难懂,可以选择直接跳到红黑树环节,不影响建立整体概念;
--------------------------------------------
这四种失去平衡的姿态都有各自的定义:
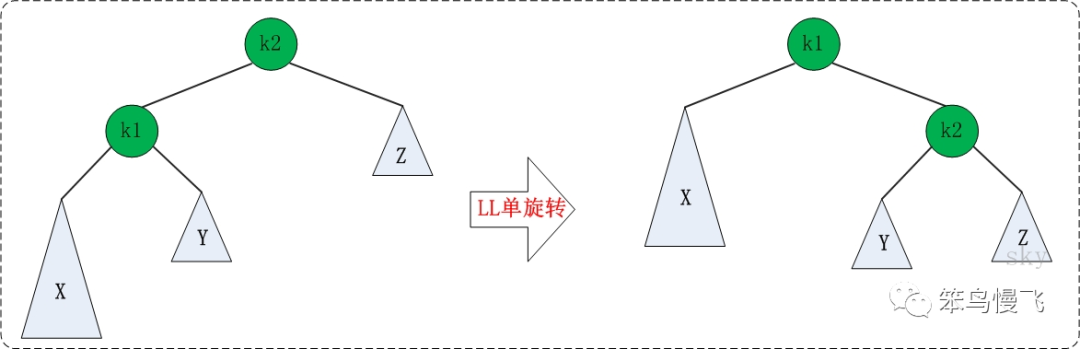
LL:LeftLeft,也称“左左”。插入或删除一个节点后,根节点的左孩子(Left Child)的左孩子(Left Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。

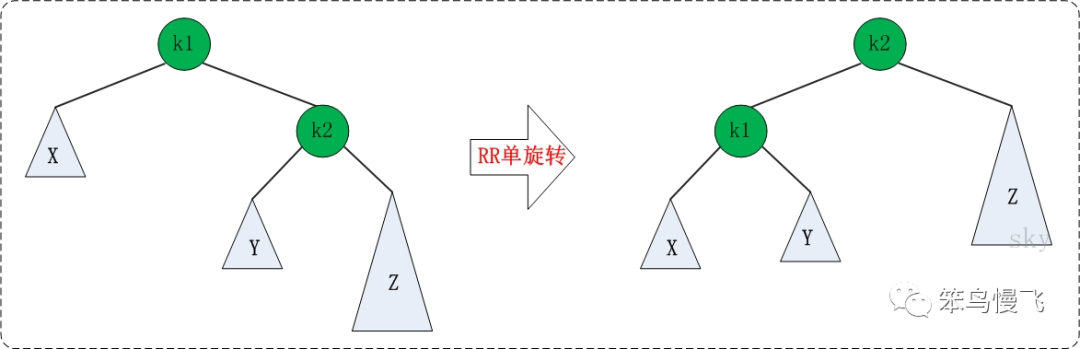
RR:RightRight,也称“右右”。插入或删除一个节点后,根节点的右孩子(Right Child)的右孩子(Right Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。

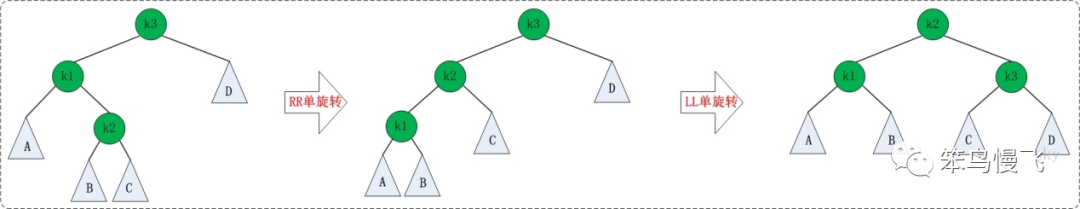
LR:LeftRight,也称“左右”。插入或删除一个节点后,根节点的左孩子(Left Child)的右孩子(Right Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。

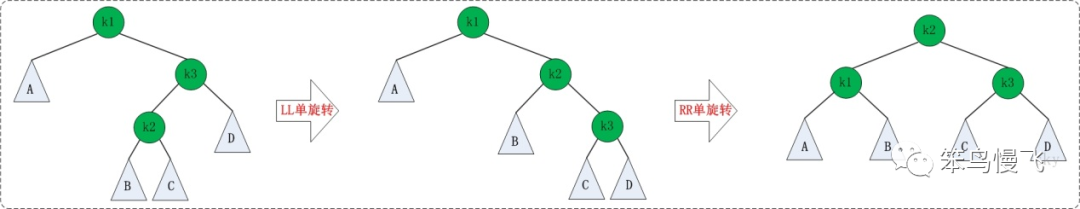
RL:RightLeft,也称“右左”。插入或删除一个节点后,根节点的右孩子(Right Child)的左孩子(Left Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。

AVL树失去平衡之后,可以通过旋转使其恢复平衡。下面分别介绍四种失去平衡的情况下对应的旋转方法。
LL的旋转。LL失去平衡的情况下,可以通过一次旋转让AVL树恢复平衡。步骤如下:
-
将根节点的左孩子作为新根节点。
-
将新根节点的右孩子作为原根节点的左孩子。
-
将原根节点作为新根节点的右孩子。
LL旋转示意图如下:

RR的旋转:RR失去平衡的情况下,旋转方法与LL旋转对称,步骤如下:
-
将根节点的右孩子作为新根节点。
-
将新根节点的左孩子作为原根节点的右孩子。
-
将原根节点作为新根节点的左孩子。
RR旋转示意图如下:

LR的旋转:LR失去平衡的情况下,需要进行两次旋转,步骤如下:
-
围绕根节点的左孩子进行RR旋转。
-
围绕根节点进行LL旋转。
LR的旋转示意图如下:

RL的旋转:RL失去平衡的情况下也需要进行两次旋转,旋转方法与LR旋转对称,步骤如下:
-
围绕根节点的右孩子进行LL旋转。
-
围绕根节点进行RR旋转。
RL的旋转示意图如下:
更重要的是代码实现,后面跟上;

--------------------------------------------
友好提示:红黑树环节在这里:
--------------------------------------------
3.红黑树(一种特殊的AVL树):
红黑树是AVL树的一个变种,它也是在二叉查找树的基础上添加平衡条件,只是它对平衡条件的描述不像AVL树那样直接,而是转化成对节点颜色规则的描述。
颜色规则:
-
对于任意节点,要么是红色,要么是黑色;
-
根节点是黑色的;
-
如果一个节点是红色的,那么它的子节点必须是黑色的(即不能有两个连续的红色节点);
-
任意节点到其下面各个空结点(后面称为nil节点,并约定其颜色为黑色)的路径上都包含相同数目的黑色节点(称为黑高);
通过对任何一条从根到空节点的路径上各个结点的颜色进行约束,红黑树可以确保没有一条路径会比其他路径长出2倍,因而红黑树是近似平衡的。
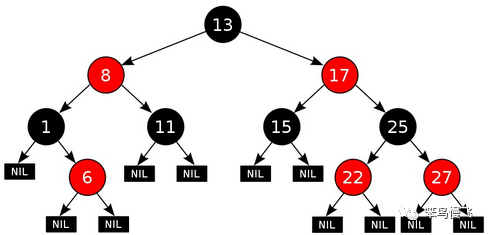
红黑树代码实现相对复杂,需要考虑多种情况,大佬实现过的链接如下:
https://www.cnblogs.com/minikobe/p/12105991.html
友情提示:看懂需要较多时间!
接着上一个查询的“大长腿”短板的话题,AVL树和红黑树的自平衡机制,可以保证不会出现“一腿长一腿短”的情况,可以每一次查询都是采用二分法进行相关操作,效率更高,速度更快!jdk1.8以后HashMap的底层数据结构就使用了数组+链表+红黑树;
那这有没有问题呢?有的,如果数据量只有几十个问题不明显,但是假如有上千万数据,想一下这个树结构的层高是多少?我没算过,很高就对了!那二分查找也需要几百次,效率明显不够,怎么办呢?
B树,B+树满足你!

4.1 磁盘基础相关知识补充(这个不懂接下来没法看):
数据库每一次查询都需要先加载到内存然后再进行查找的,系统从磁盘读取数据到内存是以磁盘块(block)为基本单位的,位于同一个磁盘块中的数据都会被一次性读取出来,而不是需要什么取什么。
Mysql存储引擎:InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位,InnoDB存储引擎中默认每个页大小为16KB,可以通过参数innodb_page_size将页大小设置为4K,8K,16K;
而系统一个磁盘块的存储空间往往没有那么大,因此InnoDB每次申请磁盘空间时,都会是若干地址连续磁盘块来达到页的大小16KB。InnoDB会把磁盘数据读入到内存时会以页为基本单位,在查询数据时如果一个页的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率;B树结构的数据可以让系统高效的找到数据所在的磁盘块。

4.2 B树 (B-树:多叉树)
B树,即B-树,即平衡多路查找树,可以理解为是一种升级后的多叉查找树,这种树结构是为磁盘等外存储设备设计的一种树。
为了描述B树,首先定义一个记录为二元组{key,data},key为记录的键值,对应表中的主键值,data为一行记录中除主键外的数据。对于不同的记录,key值互不相同。
(以下定义建议一边看图,一边对照定义来看:)
B树定义,一个m阶的B树特性有:
-
每个节点最多有m个孩子。(图中m=3)
-
除了根节点和叶子节点外,其它每个节点至少有Ceil(m/2)个孩子。
-
若根节点不是叶子节点,则至少有2个孩子
-
所有叶子节点都在同一层,且不包含其它关键字信息
-
每个非终端节点包含n个关键字信息(P0,P1,…Pn, k1,…kn)
-
关键字的个数n满足:ceil(m/2)-1 <= n <= m-1
-
ki(i=1,…n)为关键字,且关键字升序排序。(示意图中紫色方块)
-
Pi(i=1,…n)为指向子树根节点的指针。P(i-1)指向的子树的所有节点关键字均小于ki,但都大于k(i-1) ;(示意图中蓝色方块)
说人话:看图!!!以下示意图为3阶的B-tree:()
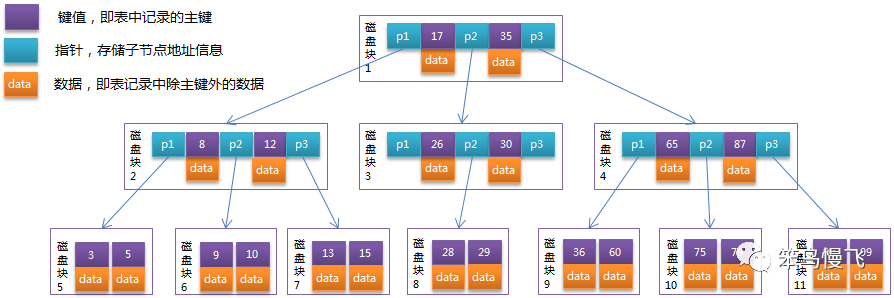
每个节点占用一个盘块的磁盘空间,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为17和35,P1指针指向的子树的数据范围为小于17,P2指针指向的子树的数据范围为17~35,P3指针指向的子树的数据范围为大于35。(觉得有点绕就对着图多看几次,然后看Demo图解)
4.3 Demo图解:(图文结合慢慢看,别急!助于理解IO过程)
目标:找到关键字29对应的data经历的过程是怎么样的?
1.根据根节点找到磁盘块1,读入内存(磁盘IO第一次操作)
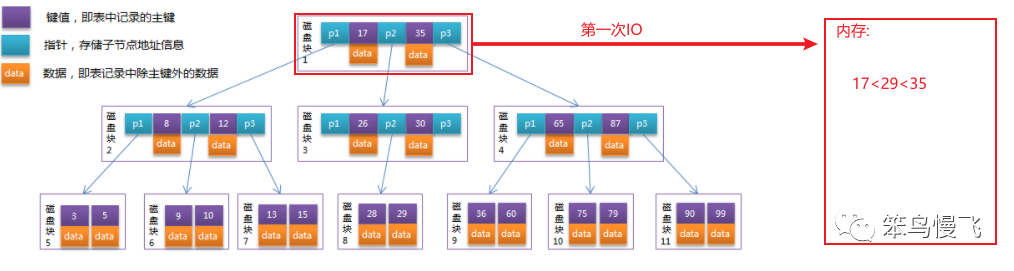
2.比较关键字29在区间 17-35,发现17<29<35,找到磁盘块1的指针p2;
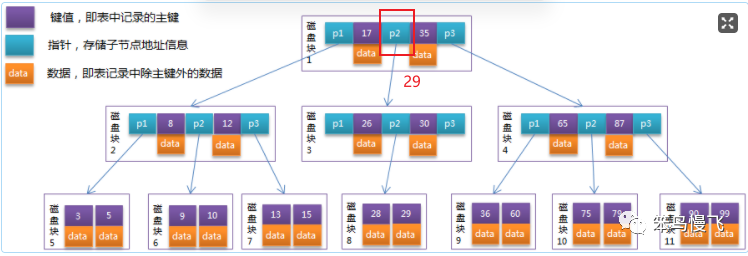
3.根据p2指针找到磁盘块3,读入内存。(磁盘IO第二次操作)
4.比较关键字29在区间 26-30,发现 26<29<30,找到磁盘块3的中间指针p2;
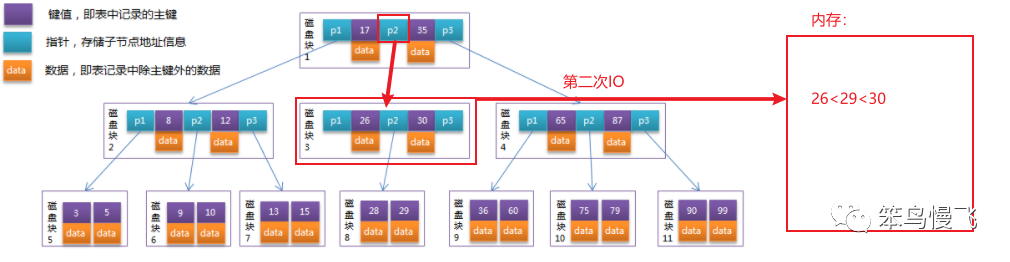
5.根据磁盘块3的p2指针找到磁盘块8,读入内存(第三次IO操作)
6.在内存中比较关键字29在 28-29,最终找到29配对成功,返回data结果;
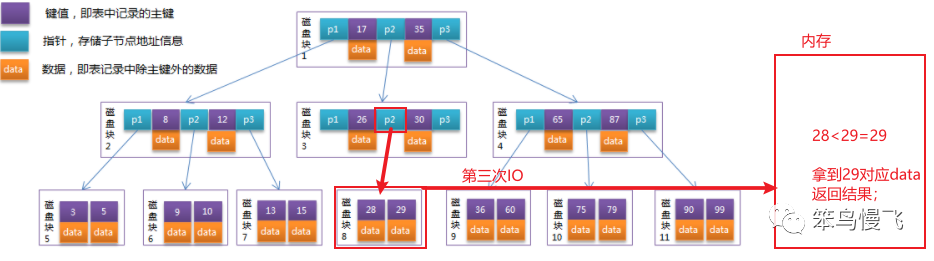
完毕!!!!!!!!!!!!
上面的过程只需要三次磁盘IO操作,和3次内存查找操作(其实是4次,次,和根节点本身的机制有关系,后面有详解)。但是内存的读取速度是非常非常快的,相对整体花的时间所占比例很小,可以忽略不记。而三次磁盘IO操作是影响整个B树查找效率的决定因素。所以相对于AVL树,B树缩减了树的高度,减少了IO次数,并且使每一次加载到内存的索引数据都发挥了作用,从而提高了查询效率;

感觉问题已经解决了,但是又没有完全解决,比如这时候数据量增加到2000万条再来两种需求:
1.全部查询
2.范围查询
这时候就会发现,就算是范围查询,B树也会按照套路一条一条的进行,效率有点低下,而且就算是B树储存2000万条数据,树的高度依旧很高;那怎么可以更快呢?
mysql索引的数据结构 B+树 登场!!!
5. B+树(InnoDB存储引擎):
是在原有B树的基础上进行优化,特征有以下几点不同:
1.非叶子节点只存储键值信息,不存储data文件;
2.叶子节点包含所有索引字段,并且叶子节点用指针相连,提高区间访问的性能;
3.叶子节点包含所有的data文件,即数据全部存储在叶子节点中;
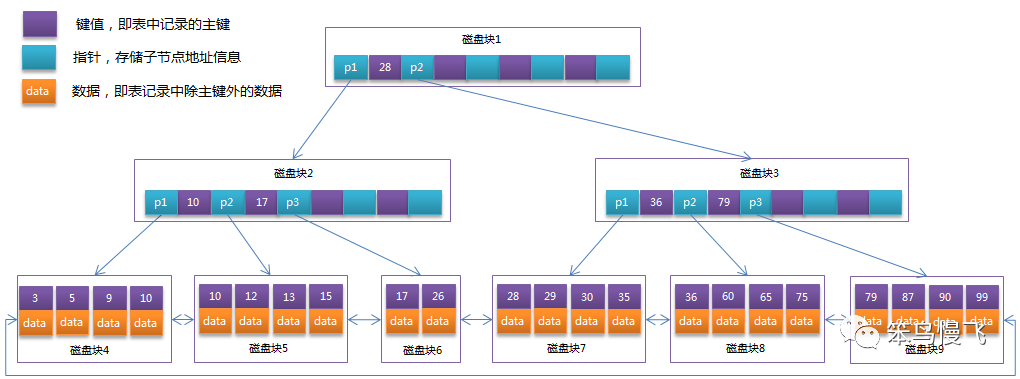
此设计的好处:通过降低树高度的方式,根本上提高了大型数据量场景下的查询的速度,上一个B树介绍中提到,一个B树的节点包含:
| 元素 | 占存储大小 |
| 1.数据的key值 | 一般4-8B |
| 2.指针 | 一般4-8B |
| 3.data值 |
一般1KB=1024B |
前面提到一个页大小最大为16KB,也就是一个页的存储空间最多也就是能容下16个键值信息。从IO角度分析就是,一次最多加载16个键值信息到内存,那假如数据量达到千万级的话,树的高度仍然是很高的;

5.1 那么B+树是如何大量降低树的高度的呢?
B+树的非叶子节点只存储key值信息以及指针,这两者占空间大小非常小,一个页存储空间可以容下上千个key信息,从IO角度分析,一次最多可以加载1000多个key信息到内存,就算是千万级别的数据量,基本上可以把树的高度控制在3以内;

5.2 层数推导过程:
| 元素 | 占存储大小 |
| 1.数据的key值(主键) |
一般INT=4B;BIGINT:8B (这里取最大) |
| 2.指针 | 一般4-8B(这里取最大) |
| 3.InnoDB存储引擎中页的大小 |
16KB = 16384 B |
SO 一页(B+Tree中的一个节点)可以存储的键值数量:
16384B/16B = 1000(约等)
也就是说一个深度为3的B+Tree索引可以维护10^3 * 10^3 * 10^3 = 10亿 条记录。一次查询,最多也就经过3次IO,实际情况中每个节点可能不会填充满,因此在数据库中,B+Tree的高度一般都在2~4层(一般3层足够啦)。
Mysql 的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要1~3次磁盘I/O操作。

六 总结:
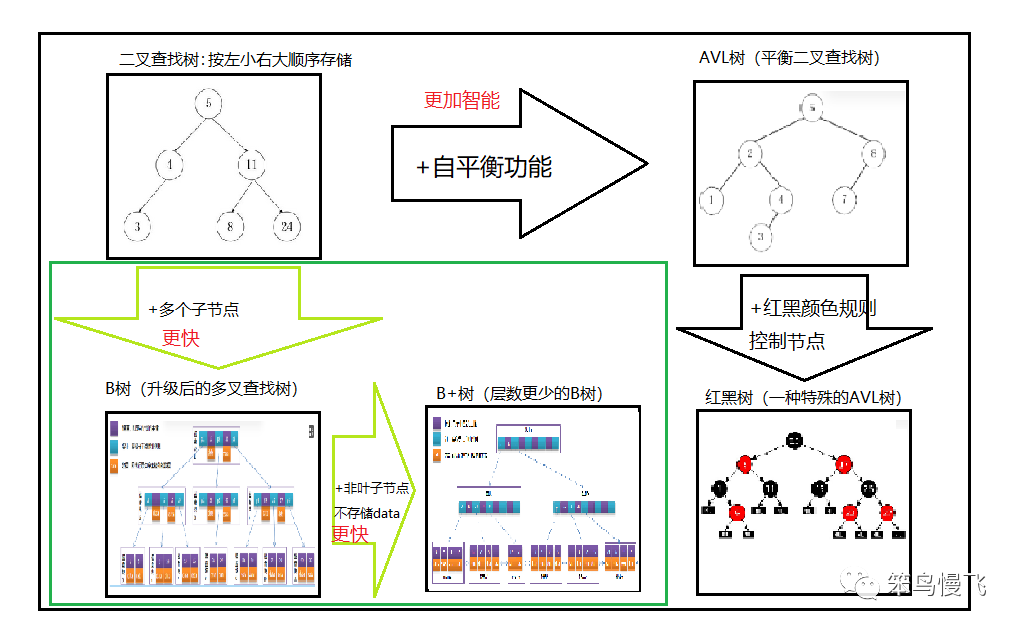
1.关于树:经过上面的梳理,我们发现在大数据量的业务场景下,B+树结构查询的速度是非常快的,这也是为什么一提到mysql数据库优化,马上就会想到索引,关于索引优化数据库等板块,以后有机会再更;最后用一个简略的各个树结构之间的“进化”关系图收尾!
2.关于学习:我慢慢发现,学习是一件慢慢探索的过程,最有效的方式之一就是:
带着目的性去学习,看视频入门,看博文深入,看专业书籍系统补齐漏洞知识;
这种方式不会太无聊!适合像我这种一开始看书找不到重点的人去践行!最后强烈建议大家看完以上的数据结构的总结之后再抽时间阅读<大话数据结构><小灰的算法之旅>这两本书来补充学习,因为我发现:
再牛的博文也赶不上一本书讲得系统和深入,只不过在今天这个快消的社会,大家更沉迷于快速看到效果的东西!
笨鸟慢飞,慢就是快!加油!今天又是有进步的一天呢!
 最近持续恶补编程基础的码农~
博文参考:
https://blog.csdn.net/cafucwxy/article/details/79499987
https://www.cnblogs.com/minikobe/p/12105991.html
更多推荐



 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)