
pyspark 入门
文章目录
- 为什么用
- 怎么用
- 初始化类 class pyspark.sql.SparkSession 类
- 函数说明
- 利用DataFrame API查询
- 利用sql查询
- DataFrame函数说明
- 创建DataFrame
- agecol=people.age 选择其中的列
- agg(*exps)
- alias(alias)
- approxQuantile(col,pro probabilities, relativeError)
- cache()
- checkpoint([eager])
- coalesce(numPartitions)
- colRegex(colName)
- collect()
- corr(col1, col2[, method])
- count()
- cov(col1, col2)
- createGlobalTempView(name)
- createOrReplaceGlobalTempView(name)
- createOrReplaceTempView(name)
- createTempView(name)
- crossJoin(other)
- crosstab(col1, col2)
- cube(*cols)
- describe(*cols)
- distinct()
- drop(*cols)
- dropDuplicates([subset])
- drop_duplicates([subset])
- dropna([how, thresh, subset])
- exceptAll(other)
- explain([extended, mode])
- fillna(value[, subset])
- filter(condition)
- first()
- foreach(f)
- foreachPartition(f)
- freqItems(cols[, support])
- groupBy(*cols)=group_by
- head([n]) 返回前n行
- hint(name, *parameters)
- inputFiles()
- intersect(other)
- intersectAll(other)
- isLocal()
- join(other, on, how)
- limit(num)
- localCheckpoint([eager])
- mapInPandas(func, schema)
- orderBy(*cols, **kwargs)
- persist([storageLevel])
- printSchema()
- randomSplit(weights[, seed])
- registerTempTable(name)
- repartition(numPartitions, *cols)
- repartitionByRange(numPartitions, *cols)
- replace(to_replace, value, subset)
- rollup(*cols)
- sameSemantics(other)
- sample([withReplacement, fraction, seed])
- sampleBy(col, fractions[, seed])
- select(*cols)
- selectExpr(*expr)
- semanticHash()
- show([n, truncate, vertical])
- sort(*cols, **kwargs)
- sortWithinPartitions(*cols, **kwargs)
- subtract(other)
- summary(*statistics)
- tail(num)
- take(num)
- toDF(*cols)
- toJSON([use_unicode])
- toLocalIterator([prefetchPartitions])
- toPandas()
- transform(func)
- union(other)
- unionAll(other)
- unionByName(other[, allowMissingColumns])
- unpersist([blocking])
- where(condition)
- withColumn(colName, col)
- withColumnRenamed(existing, new)
- withWatermark(eventTime, delayThreshold)
- writeTo(table)
- DataFrame属性
- pyspark 自定义函数
- spark 调优思路
为什么用
python中pandas是数据分析的利器,具有并行的特兹那个,而且函数和数据计算的方法非常方便,是数据分析中的瑞士军刀。但是受限于单个机器性能和配置的限制,当大规模数据,比如100G-10TB规模的数据时,pandas就显得局限了,就像瑞士军刀杀牛,难以下手。这时就需要基于分布式计算的大数据工具spark,是基于分布式计算,可以基于hadoop和hive,进行分布式的数据计算,同时spark具有python API,可以通过类似python的语法,无门槛的过渡。
怎么用
pyspark支持RDD和DataFrame的数据类型,但是RDD在python中相比于scala和R语言,是非常慢的,而DataFrame使性能在各种语言中都保持稳定。所以我们可以试用pyspark的DataFrame对大规模数据进行数据清理,然后转为pandas.dataframe,进行数据可视化。
初始化类 class pyspark.sql.SparkSession 类
spark = SparkSession.builder \
...     .master("local") \
...     .appName("Word Count") \
...     .config("spark.some.config.option", "some-value") \
...     .getOrCreate
Builder for SparkSession 这个就是生成一个 sparksession 实例。他下面有一些支持的函数
master: 设置 spark master 的 url 。由于我们集群使用的是 spark on yarn 的模式,所以可以用选择不设置这个参数。
appName: 在程序运行的时候看到的应用名称。
config: 其实其他参数也是调用 .config 设置相应的 config 参数,例如 .master 就是调用了 .config(“spark.master”, master)。
enableHiveSupport: 启动对 hive 的支持。例如支持 hivesql 以及 hive udf 等。
getOrCreate: 得到一个现成的 SparkSession ,如果没有就生成一个。
- SparkSession.catalog:
提供一个接口来操作 create drop alter query 库或者表,比如:
catalog.listTables().select($"name").show(2,false)
- SparkSession.createDataFrame:
可以获得从 rdd python list 和 pandas df 创建 df 的能力。下面贴一下官方的例子:
l = [('Alice', 1)]
>>> spark.createDataFrame(l).collect()
[Row(_1=u'Alice', _2=1)]
>>> spark.createDataFrame(l, ['name', 'age']).collect()
[Row(name=u'Alice', age=1)]


>>> d = [{'name': 'Alice', 'age': 1}]
>>> spark.createDataFrame(d).collect()
[Row(age=1, name=u'Alice')]


>>> rdd = sc.parallelize(l)
>>> spark.createDataFrame(rdd).collect()
[Row(_1=u'Alice', _2=1)]
>>> df = spark.createDataFrame(rdd, ['name', 'age'])
>>> df.collect()
[Row(name=u'Alice', age=1)]
- SparkSession.sql:
使用sql方法返回的是df,例如:
>>> df.createOrReplaceTempView("table1")
>>> df2 = spark.sql("SELECT field1 AS f1, field2 as f2 from table1")
>>> df2.collect()
[Row(f1=1, f2=u'row1'), Row(f1=2, f2=u'row2'), Row(f1=3, f2=u'row3')]
- SparkSession.table
这个可以返回指定表的 df ,将表复制成df
函数说明
注意查看官方文档中函数说明的返回数据类型
- 查询
1,.show(n),方法默认显示前10行
2,spark.sql("select * from ").collect()
利用DataFrame API查询
- swimmers.count() 返回dataframe 的行数
- swimmers.select().filter().show() 返回筛选后数据
利用sql查询
- spark.sql(“select count(1) from swimmers”).show()
sql语句和sql语言一致,也可以试用where 筛选
DataFrame函数说明
创建DataFrame
1.使用RDD来创建
rdd = sc.parallelize([("Sam", 28, 88), ("Flora", 28, 90), ("Run", 1, 60)])
df = rdd.toDF(["name", "age", "score"])
df.show()
df.printSchema()

# +-----+---+-----+
# | name|age|score|
# +-----+---+-----+
# |  Sam| 28|   88|
# |Flora| 28|   90|
# |  Run|  1|   60|
# +-----+---+-----+
# root
#  |-- name: string (nullable = true)
#  |-- age: long (nullable = true)
#  |-- score: long (nullable = true)
2. 使用python的DataFrame来创建
df = pd.DataFrame([['Sam', 28, 88], ['Flora', 28, 90], ['Run', 1, 60]],
                  columns=['name', 'age', 'score'])
print(">> 打印DataFrame:")
print(df)
print("\n")
Spark_df = spark.createDataFrame(df)
print(">> 打印SparkDataFrame:")
Spark_df.show()
# >> 打印DataFrame:
#     name  age  score
# 0    Sam   28     88
# 1  Flora   28     90
# 2    Run    1     60
# >> 打印SparkDataFrame:
# +-----+---+-----+
# | name|age|score|
# +-----+---+-----+
# |  Sam| 28|   88|
# |Flora| 28|   90|
# |  Run|  1|   60|
# +-----+---+-----+
3. 使用List来创建
list_values = [['Sam', 28, 88], ['Flora', 28, 90], ['Run', 1, 60]]
Spark_df = spark.createDataFrame(list_values, ['name', 'age', 'score'])
Spark_df.show()
# +-----+---+-----+
# | name|age|score|
# +-----+---+-----+
# |  Sam| 28|   88|
# |Flora| 28|   90|
# |  Run|  1|   60|
# +-----+---+-----+
4. 读取数据文件来创建
# 4.1 CSV文件
df = spark.read.option("header", "true")\
    .option("inferSchema", "true")\
    .option("delimiter", ",")\
    .csv("./test/data/titanic/train.csv")
df.show(5)
df.printSchema()

# 4.2 json文件
df = spark.read.json("./test/data/hello_samshare.json")
df.show(5)
df.printSchema()
5. 通过读取数据库来创建
# 5.1 读取hive数据
spark.sql("CREATE TABLE IF NOT EXISTS src (key INT, value STRING) USING hive")
spark.sql("LOAD DATA LOCAL INPATH 'data/kv1.txt' INTO TABLE src")
df = spark.sql("SELECT key, value FROM src WHERE key < 10 ORDER BY key")
df.show(5)

# 5.2 读取mysql数据
url = "jdbc:mysql://localhost:3306/test"
df = spark.read.format("jdbc") \
 .option("url", url) \
 .option("dbtable", "runoob_tbl") \
 .option("user", "root") \
 .option("password", "8888") \
 .load()\
df.show()
agecol=people.age 选择其中的列
agg(*exps)
应用到整个没有分组的dataframe上,全称是df.groupby().agg()
alias(alias)
返回一个设置了别名alias的dataframe,具有重命名的功能
df_as1 = df.alias("df_as1")
approxQuantile(col,pro probabilities, relativeError)
返回一个列的中值列表
cache()
返回dataframed的存贮水平
checkpoint([eager])
返回这个数据集的检查点版本,检查点可以用来截断这个DataFrame的逻辑计划,这在计划可能呈指数增长的迭代算法中特别有用。它将保存到SparkContext.setCheckpointDir()设置的检查点目录中的文件中。
coalesce(numPartitions)
colRegex(colName)
正则化选择匹配的多列
df = spark.createDataFrame([("a", 1), ("b", 2), ("c",  3)], ["Col1", "Col2"])
df.select(df.colRegex("`(Col1)?+.+`")).show()
+----+
|Col2|
+----+
|   1|
|   2|
|   3|
+----+
collect()
以列表的形式返回所有的数据记录
corr(col1, col2[, method])
计算指定两列的相关系数,DataFrame.corr(col1, col2, method=None),目前method只支持Pearson相关系数
count()
返回dataframe的行数
cov(col1, col2)
计算给定列的样本协方差
createGlobalTempView(name)
通过 df 创建一个全局的临时表。他的生命周期跟 spark 应用的生命周期相关联。如果视图中已经存在这个名字了会抛出 TempTableAlreadyExistsException 的错误。
createOrReplaceGlobalTempView(name)
这个对比 createGlobalTempView 不同的点是不会抛出 TempTableAlreadyExistsException 的错误,会直接替换。
createOrReplaceTempView(name)
使用现成的df创建临时视图,可以使用sql语句获取数据
createTempView(name)
crossJoin(other)
和另外一个 df 取笛卡尔积例如
>>> df.select("age", "name").collect()
[Row(age=2, name=u'Alice'), Row(age=5, name=u'Bob')]
>>> df2.select("name", "height").collect()
[Row(name=u'Tom', height=80), Row(name=u'Bob', height=85)]
>>> df.crossJoin(df2.select("height")).select("age", "name", "height").collect()
[Row(age=2, name=u'Alice', height=80), Row(age=2, name=u'Alice', height=85),
 Row(age=5, name=u'Bob', height=80), Row(age=5, name=u'Bob', height=85)]
crosstab(col1, col2)
cube(*cols)
使用指定的列为当前 DataFrame 创建一个多维立方体,以便我们可以对它们运行聚合。
df.cube("name", df.age).count().orderBy("name", "age").show()
+-----+----+-----+
| name| age|count|
+-----+----+-----+
| null|null|    2|
| null|   2|    1|
| null|   5|    1|
|Alice|null|    1|
|Alice|   2|    1|
|  Bob|null|    1|
|  Bob|   5|    1|
+-----+----+-----+
describe(*cols)
计算数字和字符串列的基本统计信息
>>> df.describe(['age']).show()
+-------+------------------+
|summary|               age|
+-------+------------------+
|  count|                 2|
|   mean|               3.5|
| stddev|2.1213203435596424|
|    min|                 2|
|    max|                 5|
+-------+------------------+
>>> df.describe().show()
+-------+------------------+-----+
|summary|               age| name|
+-------+------------------+-----+
|  count|                 2|    2|
|   mean|               3.5| null|
| stddev|2.1213203435596424| null|
|    min|                 2|Alice|
|    max|                 5|  Bob|
+-------+------------------+-----+
distinct()
返回一个不包含重复值的新的dataframe
drop(*cols)
返回删除指定列的dataframe
dropDuplicates([subset])
返回一个新的 df ,这个 df 里面不再有重复的记录。可选参数可以让我们选择关心的字段进行去重。
>>> from pyspark.sql import Row
>>> df = sc.parallelize([ \
...     Row(name='Alice', age=5, height=80), \
...     Row(name='Alice', age=5, height=80), \
...     Row(name='Alice', age=10, height=80)]).toDF()
>>> df.dropDuplicates().show()
+---+------+-----+
|age|height| name|
+---+------+-----+
|  5|    80|Alice|
| 10|    80|Alice|
+---+------+-----+
>>> df.dropDuplicates(['name', 'height']).show()
+---+------+-----+
|age|height| name|
+---+------+-----+
|  5|    80|Alice|
+---+------+-----+
drop_duplicates([subset])
dropna([how, thresh, subset])
返回了删除某列含有空值的行的dataframe
exceptAll(other)
explain([extended, mode])
fillna(value[, subset])
填充缺失值,subset指定需要填充的列
>>> df4.na.fill(50).show()
+---+------+-----+
|age|height| name|
+---+------+-----+
| 10|    80|Alice|
|  5|    50|  Bob|
| 50|    50|  Tom|
| 50|    50| null|
+---+------+-----+
>>> df4.na.fill({'age': 50, 'name': 'unknown'}).show()
+---+------+-------+
|age|height|   name|
+---+------+-------+
| 10|    80|  Alice|
|  5|  null|    Bob|
| 50|  null|    Tom|
| 50|  null|unknown|
+---+------+-------+
filter(condition)
给定特定条件过滤,和where是同名函数
>>> df.filter(df.age > 3).collect()
[Row(age=5, name=u'Bob')]

>>> df.where(df.age == 2).collect()
[Row(age=2, name=u'Alice')]

>>> df.filter("age > 3").collect()
[Row(age=5, name=u'Bob')]

>>> df.where("age = 2").collect()
[Row(age=2, name=u'Alice')]
first()
返回第一条 df
foreach(f)
定义一个函数,会让每个 df 都执行该函数
>>> def f(person):
...     print(person.name)
>>> df.foreach(f)
foreachPartition(f)
定义一个函数,会让每个 partitions 都执行这个函数
>>> def f(people):
...     for person in people:
...         print(person.name)
>>> df.foreachPartition(f)
freqItems(cols[, support])
groupBy(*cols)=group_by
可以使用 agg 方法对其进行各种各样的聚合, spark sql 专门有个类为其提供了非常多的处理函数。See GroupedData for all the available aggregate functions.
>>> df.groupBy().avg().collect()
[Row(avg(age)=3.5)]
>>> sorted(df.groupBy('name').agg({'age': 'mean'}).collect())
[Row(name=u'Alice', avg(age)=2.0), Row(name=u'Bob', avg(age)=5.0)]
>>> sorted(df.groupBy(df.name).avg().collect())
[Row(name=u'Alice', avg(age)=2.0), Row(name=u'Bob', avg(age)=5.0)]
>>> sorted(df.groupBy(['name', df.age]).count().collect())
[Row(name=u'Alice', age=2, count=1), Row(name=u'Bob', age=5, count=1)]
head([n]) 返回前n行
没有指定n时,默认是一行
hint(name, *parameters)
inputFiles()
intersect(other)
intersectAll(other)
isLocal()
join(other, on, how)
使用给定的条件和其他 df 进行 join。
other:另外一个df.
on:条件,join的位置 列名
how:默认是inner
limit(num)
限制拿多少条
localCheckpoint([eager])
mapInPandas(func, schema)
orderBy(*cols, **kwargs)
返回一个被指定 col 排序好的 df
>>> df.sort(df.age.desc()).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]

>>> df.sort("age", ascending=False).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]

>>> df.orderBy(df.age.desc()).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]

>>> from pyspark.sql.functions import *
>>> df.sort(asc("age")).collect()
[Row(age=2, name=u'Alice'), Row(age=5, name=u'Bob')]

>>> df.orderBy(desc("age"), "name").collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]

>>> df.orderBy(["age", "name"], ascending=[0, 1]).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
persist([storageLevel])
printSchema()
打印出该 df 的 schema
randomSplit(weights[, seed])
registerTempTable(name)
将 df 注册成一个临时生命周期是 SparkSession 的周期,这个跟上面 createOrReplaceTempView 互为同名函数,就是调用该函数生成的。
repartition(numPartitions, *cols)
返回一个新的 df,这个新的 df 被给定的 numPartitions 数量进行 hash 重分区。numPartitions可以是指定分区或列的目标数量的int。如果它是一个列,它将被用作第一个分区列。如果没有指定,则使用默认分区数。
repartitionByRange(numPartitions, *cols)
replace(to_replace, value, subset)
返回一个 df 用参数位置2的值替换掉参数位置是1的值。DataFrame.replace() and DataFrameNaFunctions.replace()互为同名函数
>>> df4.na.replace(10, 20).show()
+----+------+-----+
| age|height| name|
+----+------+-----+
|  20|    80|Alice|
|   5|  null|  Bob|
|null|  null|  Tom|
|null|  null| null|
+----+------+-----+

>>> df4.na.replace(['Alice', 'Bob'], ['A', 'B'], 'name').show()
+----+------+----+
| age|height|name|
+----+------+----+
|  10|    80|   A|
|   5|  null|   B|
|null|  null| Tom|
|null|  null|null|
+----+------+----+
rollup(*cols)
sameSemantics(other)
sample([withReplacement, fraction, seed])
sampleBy(col, fractions[, seed])
select(*cols)
返回 select 能找到的数据
selectExpr(*expr)
semanticHash()
show([n, truncate, vertical])
打印前n行数据带控制台
sort(*cols, **kwargs)
根据给定的 cols 进行排序之后返回新的 df
>>> df.sort(df.age.desc()).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
>>> df.sort("age", ascending=False).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
>>> df.orderBy(df.age.desc()).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
>>> from pyspark.sql.functions import *
>>> df.sort(asc("age")).collect()
[Row(age=2, name=u'Alice'), Row(age=5, name=u'Bob')]
>>> df.orderBy(desc("age"), "name").collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
>>> df.orderBy(["age", "name"], ascending=[0, 1]).collect()
[Row(age=5, name=u'Bob'), Row(age=2, name=u'Alice')]
sortWithinPartitions(*cols, **kwargs)
subtract(other)
取目标 df ohter 和 df 的补集。
summary(*statistics)
tail(num)
take(num)
返回df前num条数据
toDF(*cols)
返回新的df,新的列名对应list顺序
toJSON([use_unicode])
将dataframe 数据格式转成rdd格式
toLocalIterator([prefetchPartitions])
返回一个迭代器,包含了dataframe的所有列
toPandas()
将数据转换为pandas.dataframe数据类型
transform(func)
返回一个新的dataframe
union(other)
交集
unionAll(other)
并集
unionByName(other[, allowMissingColumns])
返回包含这个和其他dataframe中独一无二的列的,交集dataframe
unpersist([blocking])
where(condition)
功能与filter一样
withColumn(colName, col)
返回一个通过添加或替换列名的新的dataframe
withColumnRenamed(existing, new)
返回一个重命名列名的dataframe
withWatermark(eventTime, delayThreshold)
writeTo(table)
DataFrame属性
columns
以列表形式返回所有列名。
dtypes
以列表形式返回所有列名及其数据类型。
isStreaming
na
rdd
schema
返回dataframe的架构
stat
storageLevel
write
非流接口向外部存储写入数据
writeStream
流接口向外部存储写入数据
pyspark 自定义函数
apply(udf)
官方说明:https://spark.apache.org/docs/latest/api/python/reference/api/pyspark.sql.GroupedData.apply.html
它的全称应该是pyspark.sql.GroupedData.applyInPandas(),它传入一个pandas_udf类的函数,实现pyhton的一个自定义的函数应用到dataframe和分组后的dataframe。
其中自定义的函数为pyspark.sql.functions.pandas_udf(f=None, returnType=None, functionType=None)。参考文章:https://blog.csdn.net/qq_34615112/article/details/107187704
,由Spark使用Arrow来传输数据,并使用Pandas来处理数据,从而实现矢量化操作。使用pandas_udf,可以方便的在PySpark和Pandas之间进行互操作,并且保证性能;
参数介绍:
- df 用户定义的函数 ,注意传入数据类型使用python的函数
- returnType
用户自定义函数的返回值类型,该值可以是pyspark.sql.types.DataType对象或DDL格式的类型字符串 - functionType
pyspark.sql.functions.PandasUDFType中的枚举值。 默认值:SCALAR.存在此参数是为了兼容性。 鼓励使用Python类型。
PandasUDF类型不同,对应的函数的输入输出的类型也不相同:
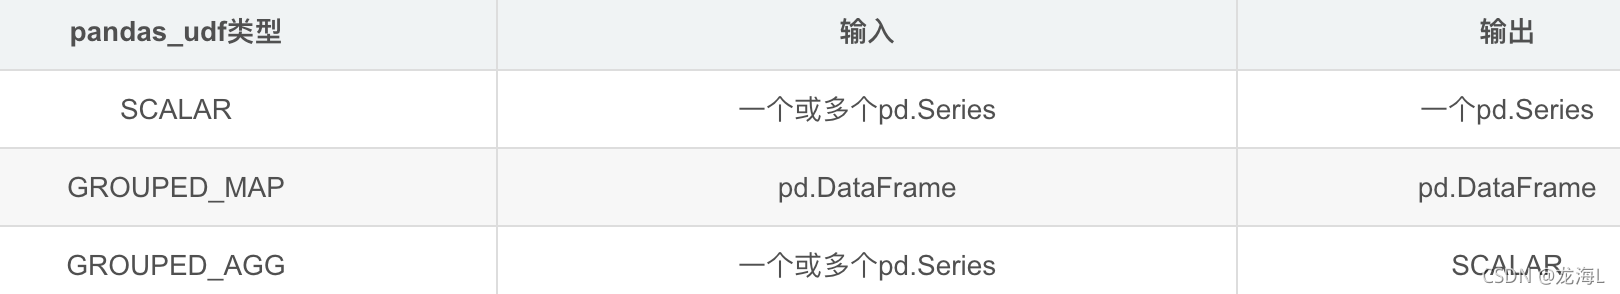
我一般会使用Grouped Map类型,函数传入pd.dataframe类型数据,可以采用pandas中灵活的函数处理数据,这也是pydataframe与pd.dataframe相互贯通的方式之一。
使用方式: 使用pandas_udf作为装饰器来定义Pandas UDF
1.Scalar
函数输入一个或多个pd.Series,输出一个pd.Series,函数的输出和输入有相同的长度
,是对列的操作,所以经常与select,withColumn等函数一起使用
from pyspark.sql.functions import PandasUDFType

@pandas_udf(returnType=IntegerType(), functionType=PandasUDFType.SCALAR)
def total_shoot(x, y):
    return x + y

df.withColumn("篮板+助攻", total_shoot("篮板", "助攻")).show(2)
2.Grouped Map
pd.DataFrame -> pd.DataFrame,returnType使用StructType描述返回值的pd.DataFrame的模式。
该模式下,panda_udf与groupBy().apply()一起使用,后者实现了“split-apply-combine”模式
要使用groupBy().apply(),需要定义以下内容:
定义每个分组的Python计算函数,这里可以使用pandas包或者Python自带方法。
一个StructType对象或字符串,它定义输出DataFrame的格式,包括输出特征以及特征类型。
需要注意的是:
1.StructType对象中的Dataframe特征顺序需要与分组中的Python计算函数返回特征顺序保持一致。
2.在应用该函数之前,分组中的所有数据都会加载到内存,这可能导致内存不足抛出异常。
from pyspark.sql import functions as F

@pandas_udf('win_flag int, score double', functionType=PandasUDFType.GROUPED_MAP)
def normalize(pdf):
    v = pdf['score']
    return pdf.assign(score=(v - v.mean() / v.std()))

# 实验中中文列名会报错,所以尝试英文列名
df = df.withColumn('win_flag', F.when(df['胜负'] == '胜', 1).otherwise(0))
df = df.withColumn('score', df['得分'])
df.select('win_flag', 'score').groupby('win_flag').apply(normalize).show(3)
3.GROUPED_AGG
spark 调优思路
开发习惯
资源参数
首先了解Spark运行机制和流程:
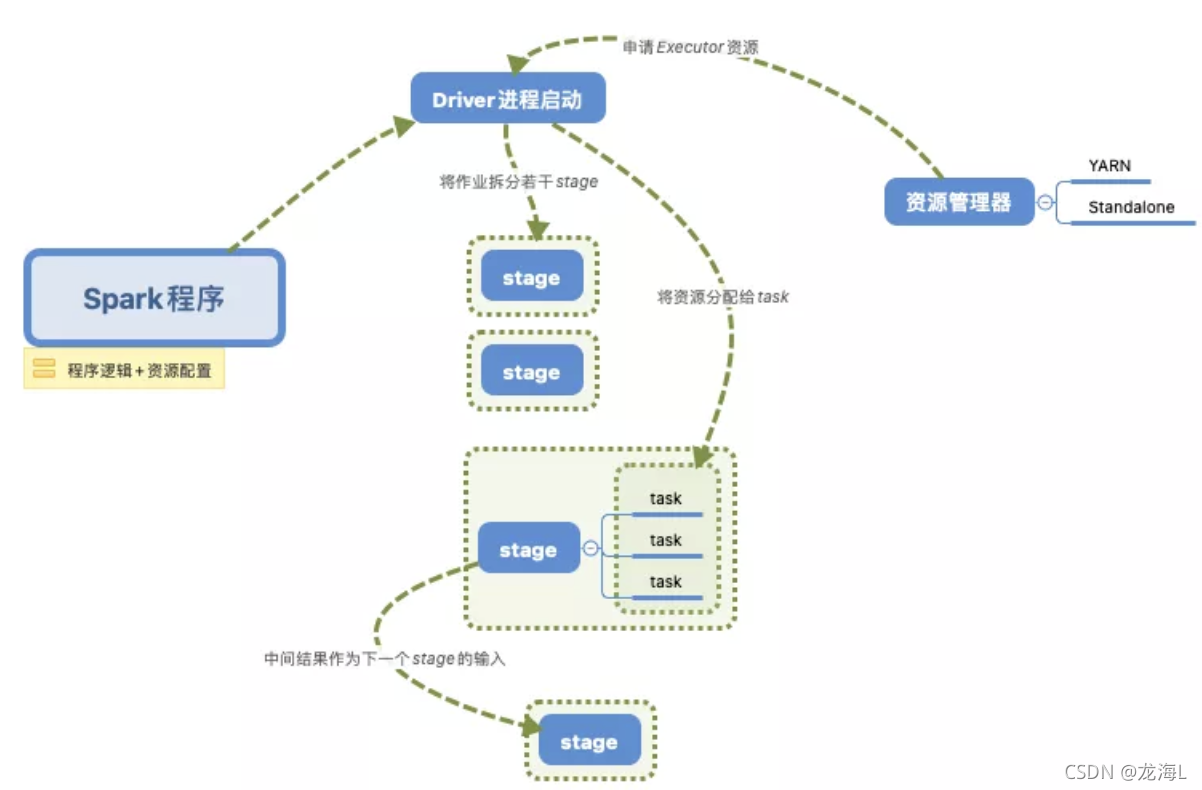
资源参数的配置:
-
num-executors
指的是执行器的数量,数量的多少代表了并行的stage数量(假如executor是单核的话),但也并不是越多越快,受你集群资源的限制,所以一般设置50-100左右吧。 #### 数据倾斜问题调优 -
executor-memory
这里指的是每一个执行器的内存大小,内存越大当然对于程序运行是很好的了,但是也不是无节制地大下去,同样受我们集群资源的限制。假设我们集群资源为500core,一般1core配置4G内存,所以集群最大的内存资源只有2000G左右。num-executors x executor-memory 是不能超过2000G的,但是也不要太接近这个值,不然的话集群其他同事就没法正常跑数据了,一般我们设置4G-8G。 -
executor-cores
这里设置的是executor的CPU core数量,决定了executor进程并行处理task的能力。 -
driver-memory
设置driver的内存,一般设置2G就好了。但如果想要做一些Python的DataFrame操作可以适当地把这个值设大一些。 -
driver-cores
与executor-cores类似的功能。 -
spark.default.parallelism
设置每个stage的task数量。一般Spark任务我们设置task数量在500-1000左右比较合适,如果不去设置的话,Spark会根据底层HDFS的block数量来自行设置task数量。有的时候会设置得偏少,这样子程序就会跑得很慢,即便你设置了很多的executor,但也没有用。
shuffle调优
参考文章:
https://www.cnblogs.com/piperck/p/10446720.html
https://spark.apache.org/docs/latest/api/python/reference/api/pyspark.sql.DataFrame.html
学习平台:和鲸社区,在线运行大数据指令
https://www.heywhale.com/mw/project/6165309d1e11c300178b939e
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)