
hbase-phoenix的视图,二级索引--重要
·
Phoenix的视图
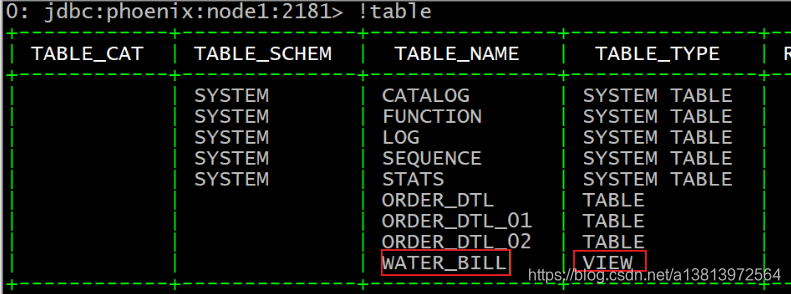
说明: 发现在Phoenix的只有在Phoenix自定义的表以及Phoenix的系统表, 如果我们在hbase上自定义的表, 在Phoenix中无法找到的, 那么也就意味着无法通过Phoenix对hbase自建的表进行相关的操作
如何解决这种问题呢? 采用Phoenix提供的视图
视图主要的目的:  对hbase自建表进行映射关系匹配, 这个过程类似于 hive表和hdfs上数据进行映射
	映射成功后, 我们就可以通过Phoenix对hbase中自建表进行相关的查询操作
- 如何构建视图呢?
格式:
	create view 名称空间."hbase映射表名" (
	   key 类型 primary key,
	   列族1.列名1 类型,
	   列族1.列名2 类型,
	   列族2.列名1 类型,
	   ....
	)

注意事项:
	1) 视图的名称必须与对应要映射hbase表名保持一致的
	2) 视图的中主键的名称可以任意定义, 但是必须加上主键约束, 同时必须放置表的第一个
	3) 视图中列族名称 以及对应的列名 必须和要映射的hbase表名中列族列名一致
- 如何删除视图呢
drop view 视图名称;
-
案例:
-
目前在hbase中有一张 WATER_BILL 表, 请在Phoenix中构建一个视图与之映射, 并完成以下的查询需求:
根据查表的日期, 查询6月份总计有多少条查表记录
-
1) 创建视图
create view "WATER_BILL" (
id varchar primary key,
c1.address varchar,
c1.latest_date varchar,
c1.name varchar,
c1.num_current unsigned_double,
c1.num_previous unsigned_double,
c1.num_usage  unsigned_double,
c1.pay_date varchar,
c1.record_date varchar,
c1.sex varchar,
c1.total_money unsigned_double
);


2) 查询需求:

select count(1)  from WATER_BILL where record_date >= '2020-06-01 00:00:00' and record_date< '2020-07-01 00:00:00';
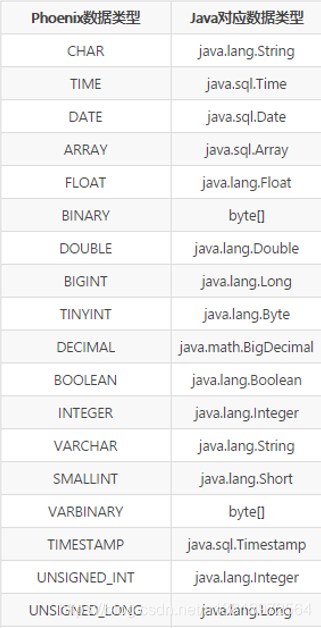
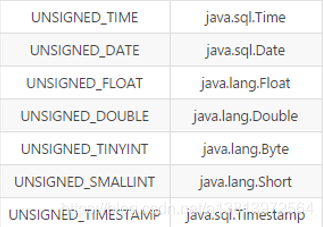
Phoenix支持的相关的数据类型
Phoenix的二级索引
索引作用: 提升检索的效率
为什么说索引可以提升查询的效率呢?
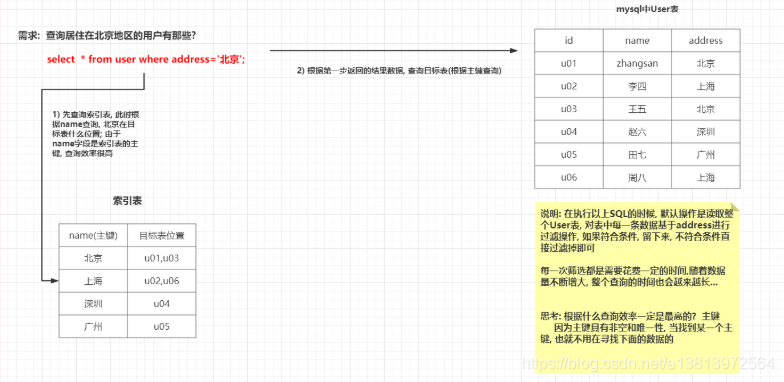
发现点:
在整个的索引查询过程中, 需要先查询一个位置, 得到结果后, 再去查询另一个位置, 这种查询称为二级索引
对于Phoenix, 主要基于hbase提供了四种索引的方案
-
- 全局索引
-
- 本地索引
-
- 覆盖索引
-
- 函数索引
Phoenix索引的分类
=全局索引
	全局索引指的可以针对表中某一个字段或者某几个字段构建索引, 构建索引后, 全局索引会单独形成一张索引表,
	此索引表和目标表保持相同的region的数量,  当执行查询的时候, 先查询索引表, 然后查询目标表操作.
	当对目标表的数据进行修改的时候, 需要同时对索引表也要进行修改, 这就导致了, 本来需要修改一个表,
	结果需要多个表, 导致写入效率下降

	适用于: 读多 写少 场景 同时需要构建索引的字段不是特别的多的情况下

	注意:
		在使用全局索引的时候, 如果SQL语句中有非索引的列, 默认情况下是不走索引的

	所以说 一般在开发中, 会让全局索引 和 覆盖索引同时使用, 以提升效率

如何构建全局索引:
	create index 索引名称 on 表名(列名1, 列名2,列名3...);

如何删除索引:
	drop index 索引名称 on 表名;
本地索引
本地索引指的针对表中某一个字段或者某几个字段构建索引, 构建索引后, 索引数据和目标表数据放置在一起,
不会单独的形成一张索引表,  这样在写入数据的时候, 只需要写入一个表即可, 对写入效率影响不是特别的大,
在执行SQL查询时候, 即使有非索引列存在, 本地索引也是依然可用的, 但是如果表采用hash加盐的预分区方案,
本地索引支持的不是特别的好

	适用于: 写多 读相对较少  适用于需要对多个字段构建索引

	注意事项:
		1) 本地索引在执行查询的时候, 即使有非索引列, 本地索引依然可用
		2) 本地索引对采用Phoenix的hash加盐预分区方案, 支持不是特别良好


如何构建本地索引:
	create local index 索引名称 on 表名(列名1, 列名2,列名3...);

如何删除索引:
 	drop index 索引名称 on 表名;
覆盖索引
覆盖索引无法单独使用, 必须结合全局索引或者本地索引来使用, 当然一般都是结合全局索引 , 主要目的将那些不参与过滤
但是会参与展示的字段构建为覆盖索引, 构建后, 会将覆盖索引的字段数据放置索引表中, 这样查询完数据后,
就不需要在去检索目标表, 直接在索引表就可以把相关的字段都获取到了

	优点: 更好为全局索引, 提升查询的效率
	弊端: 增大冗余性
	典型的以空间换时间操作

如何构建覆盖索引呢?
	create [local] index  索引的名称 on 表名 (列名1,列名2....) include(列名3,列名4...)
函数索引
函数索引 可以针对某一个函数执行结果 进行构建索引, 一旦构建好一个, 当使用到这个相同的函数的时候,
就不需要在进行处理, 直接使用这个函数的结果即可

	注意事项:
		一旦对某一个函数的结果构建了索引后, 在使用这个索引的时候, 必须保证函数以及函数中字段都需要完全一致

	适用于: 经常性需要使用固定的函数以及固定字段进行操作

如何构建函数索引呢?
	create [local]  index  索引名称 on 表名 (列名1,列名2,函数()...)
3.2 案例一: 创建全局索引+覆盖索引
需求: 根据用户id 来查询订单id以及对应的支付金额: 查询以付款的订单id和支付金额
SQL:
	explain select ID,MONEY,STATUS from  order_dtl_02 where STATUS = '已付款';
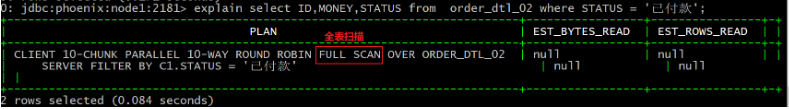
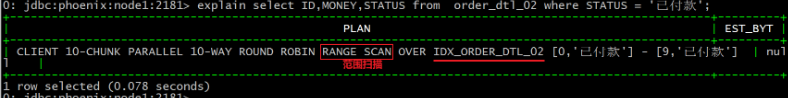
- 进行索引优化
create index idx_order_dtl_02 on order_dtl_02(STATUS) include(ID,MONEY);
- 测试: 如果SQL中出现非索引的列
explain select ID,MONEY,STATUS,PAY_WAY from order_dtl_02 where STATUS = '已付款';
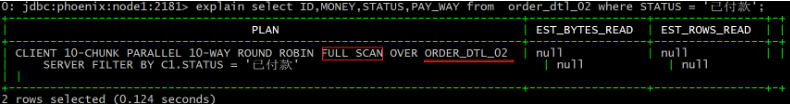
在全局索引中, 如果出现了非索引列, 那么默认情况下全局索引是无法生效的
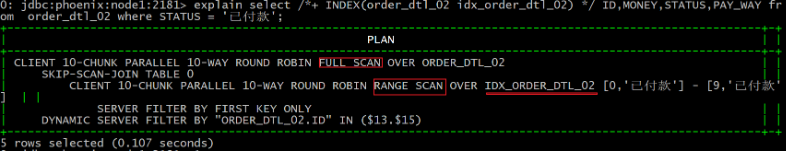
- 可以通过强制使用索引方案
explain select /*+ INDEX(order_dtl_02 idx_order_dtl_02) */ ID,MONEY,STATUS,PAY_WAY from order_dtl_02 where STATUS = '已付款';
- 删除索引
drop index idx_order_dtl_02 on order_dtl_02;
3.3 案例二: 本地索引
需求: 查询数据的时候, 可能会根据订单的ID, 订单状态, 支付金额 支付的方式, 用户ID 来查询数据
-
- 针对这些字段构建本地索引
create local index idx_local_order_dtl_02 on order_dtl_02(id,status,money,pay_way,user_id);
-
- 执行查询操作
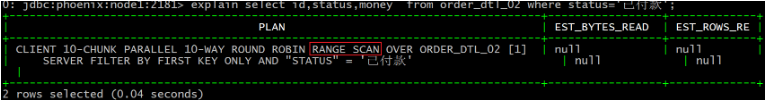
-- 让所有的参与字段都是索引的字段
explain select id,status,money  from order_dtl_02 where status='已付款';
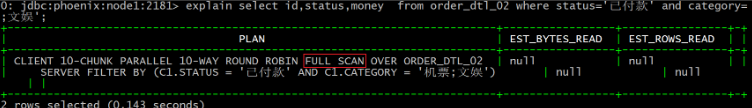
-- 让过滤字段中出现非索引列
explain select id,status,money  from order_dtl_02 where status='已付款' and category='机票;文娱';
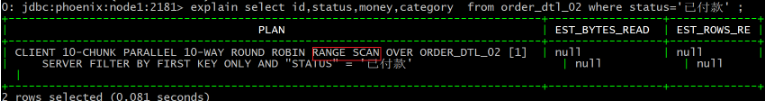
-- 让展示字段中出现非索引列
explain select id,status,money,category  from order_dtl_02 where status='已付款' ;
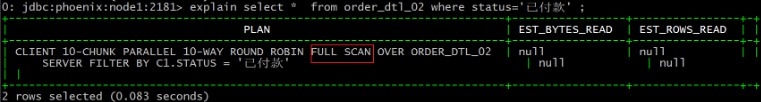
-- 查询所有的字段
explain select *  from order_dtl_02 where status='已付款' ;
总结:
	当使用本地索引的时候, 同时表是采用hash加盐, 如果触发执行的展示全表字段的数据时候, 可能无法使用本地索引
	当过滤条件中出现非索引的字段, 不管是否采用hash加盐预分区 都无法使用本地索引
	一旦使用本地索引, 对hbase表数据产生影响, 此时无法使用原生API操作这个表,只能使用Phoenix进行操作
注意:
	虽然本地索引对加盐预分区的表支持比较好, 但是依然不建议在hash加盐预分区中采用本地索引
3.4 案例三: 实现WATER_BILL查询操作
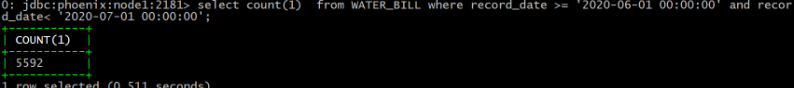
需求: 根据查表的日期, 查询6月份总计有多少条查表记录
select count(1)  from WATER_BILL where record_date >= '2020-06-01 00:00:00'
and record_date< '2020-07-01 00:00:00';

多次执行之后, 平均下, 也需要0.5s才能执行完成
- 采用索引优化:
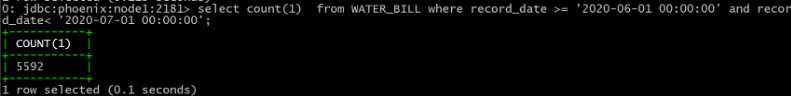
create local index idx_local_water_bill on water_bill(record_date);
- 执行查询的SQL:
索引使用总结
	1) 一般会将经常使用的字段构建为索引,如果后期这个字段不使用, 还需要将其索引信息进行删除
	2) 当需要构建索引的字段比较多的时候, 建议采用本地索引  或者说 需要展示的字段比较多 同时满足 写多读少
	3) 需要构建索引的字段比较少的时候, 建议使用全局索引, 同时展示字段也并不多 同时满足 读多写少
	4) 如果发现经常的使用某个函数的结果, 此时可以对其构建函数索引
更多推荐



 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)