
hive 修改表的存储格式_Hive基础之DDL操作
DML(Data Manipulation Language) 数据操纵语言 :主要用来对数据库的数据进行一些操作,常用的就是INSERT、UPDATE、DELETE。
DDL (Data Define Language) 数据定义语言:常用的有CREATE和DROP,用于在数据库中创建新表或删除表,以及为表加入索引等
DCL(Data Control Language) 数据控制语言:通过GRANT和REVOKE,确定单个用户或用户组对数据库对象的访问权限
hiveDDL操作
- hive数据类型
- hive数据编码
- hive数据类型转换
- hive创建数据库
- hive创建表(三种方式)
- hive表修改
- hive内部表和外部表
- hive表压缩格式
hiveDDL操作
- hive数据类型
基本数据类型包括:整型、浮点型、时间类型、字符串类型、布尔类型、二进制
复杂数据类型:array数组类型、Maps类型、Structs结构类型
数值类型
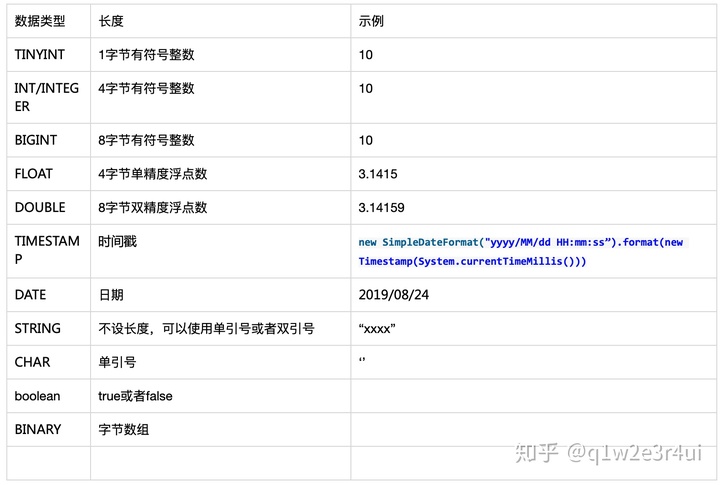
复合类型
Array数组类型:
一组有序的且字段类型相同的内容 比如:ARRAY<data_type>
array(“a”,“b”,“c”,“d”)Maps类型:
一组无序的键/值对,键的类型必须是原子的,值可以是任意类型,同一键映射的值得类型必须相同
Structs:一组由任意数据类型组成的结构,一组命名的字段,字段类型可以不同
hive数据编码
(hive默认的编码格式)
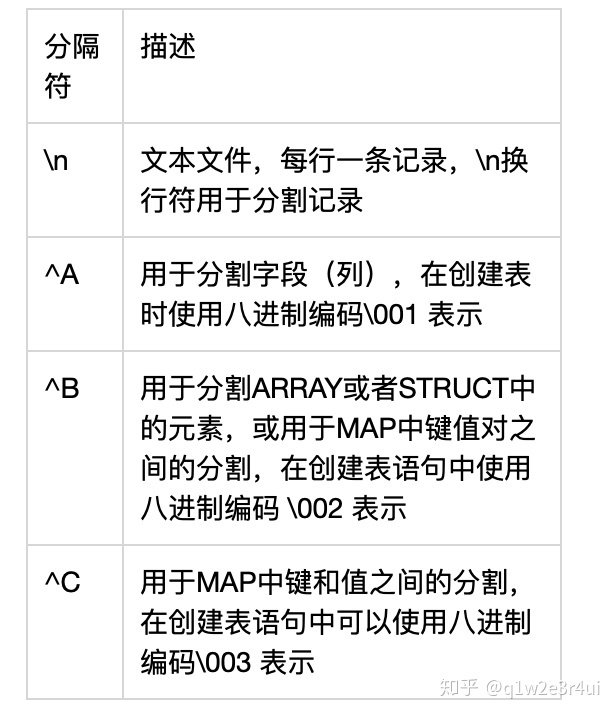
create table test_tbl (
col1 ARRAY<INT>
col2 MAP<STRING,INT>,
col3 STRUCT<a:STRING,b:INT,c:DOUBLE>);
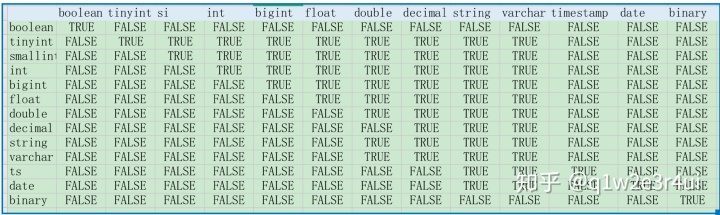
hive数据类型转换
和java一样,hive也支持隐事类型转换和显式类型转换;
hive中类型转换通过cast函数来完成,比如 select cast(name as String) from tbl ;
hive创建数据库
hive中最简单的创建数据库的语法和mysql一样
create database db_test; // 当数据库不存在时创建
create database if not exists db_test; // 创建库时,添加库的说明
create database if not exists db_test comment ’this is test db'// 指定HDFS中的目录位置
create database db_test location ‘/hive/db/db_test’; // 查看已经创建的数据库
show databases // 通过通配符查看db开头的数据库
show databases like 'db.*’; // 查看创建数据库的语句
show create database db_test ; // 显示数据库中文件目录位置路径
describe database db_test ;// 切换到指定数据库
use db_test注意:
默认情况下是不允许直接删除一个有表的数据库的:
删除一个有表的数据库有两种办法
1、 先把表删干净,再删库
2、删库时在后面加上cascade,表示级联删除此数据库下的所有表
drop database if exists foo cascade; Hive创建表(三种方式)
方式一:直接创建
Hive中最简单的创建数据表语法和mysql一样
create table test_tbl (col_name data_type);创建表时需要指定数据切分格式,会用到ROW FORMAT关键字。下面是Hive官网关于ROW FORMAT的用法:
row_format
  : DELIMITED [FIELDS TERMINATED BY char [ESCAPED BY char]] [COLLECTION ITEMS TERMINATED BY char]
        [MAP KEYS TERMINATED BY char] [LINES TERMINATED BY char]
        [NULL DEFINED AS char]   -- (Note: Available in Hive 0.13 and later)
  | SERDE serde_name [WITH SERDEPROPERTIES (property_name=property_value, property_name=property_value, …)]
[xx] 表示可选 ,| 表示二选一
FIELDS TERMINATED BY char 指定HDFS文件中以指定的符号为分割列,默认是001
,COLLECTION ITEMS TERMINATED BY ‘x’ 该属性用于分割数组形式的数据,比如[1-2-3]
MAP KEYS TERMINATED BY ‘xx’ 用于分割map键值之间的分割 比如<1:3>
LINES TERMINATED BY ‘x’ 用于区分不同行的数据,默认是换行符n
SERDE 用于指定hive的文本格式,默认是TextFile
SERDE 内置的一个类型:Avro,ORC,RegEx,Thrift,Parquet,CSV,JsonSerDe
LOCATION '/usr/hive/text/‘ 指定表数据存储在HDFS上的目录地址
方式二:复制表结构
create table tbl_test like select * from tbl_test1;方式三:直接复制表结构以及数据
create table tbl_test as select * from tbl_test1;hive修改表
// 查询重命名表
ALTER TABLE test1 RENAME TO test2;修改表字段命名
// ALTER TABLE employee CHANGE name ename String; // 修改表字段类型
ALTER TABLE employee CHANGE salary salary double ; // 添加列语句
ALTER TABLE employee ADD COLUMNS (dept STRING COMMENT 'Department name’); //加分区表字段
ALTER TABLE table_name add columns( dept string COMMENT '') CASCADE;hive内部表和外部表
何为内部表和外部表:
创建表时:创建内部表时,会将数据移动到数据仓库指向的路径;若创建外部表,仅记录数据所在的路径, 不对数据的位置做任何改变。
删除表时:在删除表的时候,内部表的元数据和数据会被一起删除, 而外部表只删除元数据,不删除数据。
hive中默认创建的是内部表;
如果需要创建外部表需要使用external关键字
create external table fz_external_table(id int,name string,age int,tel string);hive表存储格式
hive中常用的存储格式:
textFile : hive默认的存储格式 ,默认为行存储
ORCFile :ORC数据压缩率比较高,通过采用数据按照行分块,每个块按照列存储,其中每个存储都一个索引
Parquet :Parquet具有很好的压缩性能,可以减少大量的表扫描和反序列化的时间
创建表时通过stored as 关键字指定表的存储格式,默认为textFile
通过对比这三种磁盘占用:orc<parquet<textfile
通过对比这三种格式查询时间:orc<parquet<textfile
希望本文对你有帮助!
感谢关注“码农星球”。本文版权属于“码农星球”。我们提供咨询和培训服务,关于本文有任何困惑,请关注并联系我们。
更多推荐



 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)