
python爬虫之cookie与URLErroe异常处理
一、cookie
Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密).
比如说有些网站需要登录后才能访问某个页面,在登录之前,你想抓取某个页面内容是不允许的。那么我们可以利用Urllib库保存我们登录的Cookie,然后再抓取其他页面就达到目的了。
Opener
当你获取一个URL你使用一个opener(一个urlib.OpenerDirector的实例)。在前面,我们都是使用的默认的opener,也就是urlopen。它是一个特殊的opener,可以理解成opener的一个特殊实例,传入的参数仅仅是url, data,timeout.
如果我们需要用到Cookie,只用这个opener是不能达到目的的,所以我们需要创建更一般的opener来实现对Cookie的设置
Cookielib
cookielib模块的主要作用是提供可存储cookie的对象,以便于与urllib模块配合使用来访问Internet资源。Cookielib模块非常强大,我们可以利用本模块的CookieJar类的对像来捕获cookie并在后续连接请求时重新发送,比如可以实现模拟登录功能。该模块主要的对象有CookieJar、FileCookieJar、MozillaCookieJar、LwPCookieJar。
案例:
使用账号密码登录到指定页面。
from urllib.request import Request,build_opener,urlopen,HTTPCookieProcessor
from urllib.parse import urlencode
from fake_useragent import UserAgent
#登录
login_url = "https://movie.douban.com/"
headers = {"User-Agent":UserAgent().random}
form_data = {
    "user":"17703181473",
    "password":"123456"
}

f_data = urlencode(form_data).encode()  #转码
request = Request(login_url,headers=headers,data=f_data)
handler = HTTPCookieProcessor()
opener = build_opener(handler)
response = opener.open(request)

#访问页面
info_url = "https://movie.douban.com/"
request = Request(info_url,headers=headers)
response = opener.open(request)
info = response.read()
info.decode()
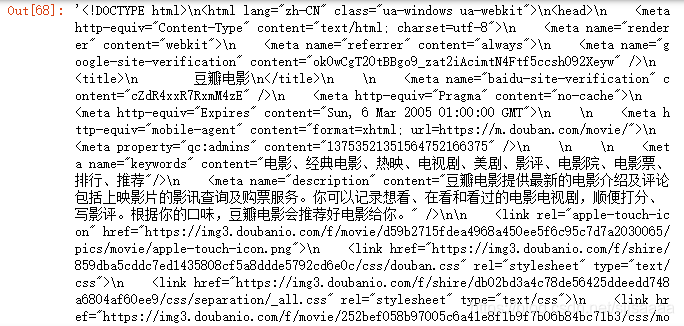
我用的网站不是所指定的,只是一个例子而已,当真正用到时候,你要找到那个页面。
将我们的cookie保存到文件中
#保存cookir 到文件中
def get_cookie():
    login_url = "https://movie.douban.com/"
    headers = {"User-Agent":UserAgent().random}


    form_data = {
    "user":"17703181473",
    "password":"123456"
    }

    f_data = urlencode(form_data).encode()  #转码

    cookie_jar = MozillaCookieJar()  ######
    request = Request(login_url,headers=headers,data=f_data)
    handler = HTTPCookieProcessor(cookie_jar)
    opener = build_opener(handler)
    response = opener.open(request)

    cookie_jar.save("cookie.txt",ignore_expires = True,ignore_discard = True)#保存

#访问页面
if __name__ == "__main__":
    get_cookie()
这个就是我们保存的cookie

解下来从文件中获取cookie
#获取cookie从文件中
def use_cookie():

    login_url = "https://movie.douban.com/"
    headers = {"User-Agent":UserAgent().random}
    cookie_jar = MozillaCookieJar()  ######
    cookie_jar.load("cookie.txt",ignore_expires = True,ignore_discard = True)#提取
    request = Request(login_url,headers=headers)
    handler = HTTPCookieProcessor(cookie_jar)
    opener = build_opener(handler)
    response = opener.open(request)
    info = response.read()
    return info.decode()


#访问页面
if __name__ == "__main__":
    info = use_cookie()
二、URLErroe异常处理
正常情况下:
from urllib.request import Request,urlopen
from urllib.error import URLError
url = "https://movie.douban.com/"
headers = {"User-Agent":UserAgent().random}

try:
    request = Request(url,headers=headers)
    response = urlopen(request)
    info = response.read()
    print(info.decode())
except URLError as e :
    print(e)

print("访问完成")
状态码为404情况下:
from urllib.request import Request,urlopen
from urllib.error import URLError
url = "https://movie.douban.com/222"
headers = {"User-Agent":UserAgent().random}

try:
    request = Request(url,headers=headers)
    response = urlopen(request)
    info = response.read()
    print(info.decode())
except URLError as e :
    print(e)

print("访问完成")
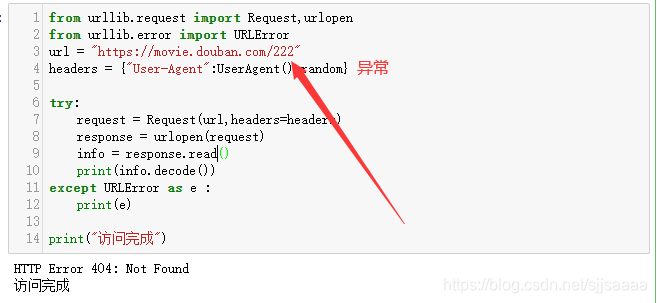
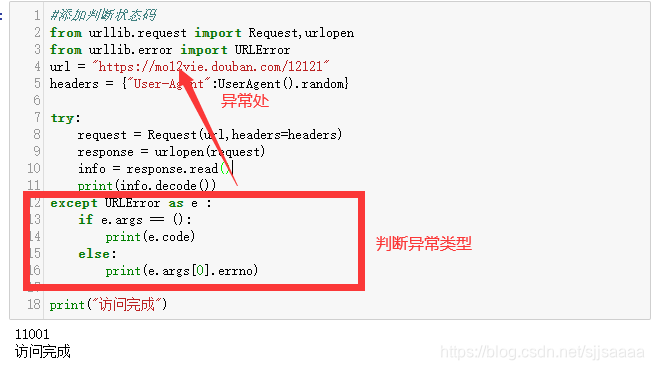
状态为11001境况下(添加判断形式,判断其状态码):
#添加判断状态码
from urllib.request import Request,urlopen
from urllib.error import URLError
url = "https://mo12vie.douban.com/12121"
headers = {"User-Agent":UserAgent().random}

try:
    request = Request(url,headers=headers)
    response = urlopen(request)
    info = response.read()
    print(info.decode())
except URLError as e :
    if e.args == ():
        print(e.code)
    else:
        print(e.args[0].errno)

print("访问完成")
当你多次访问某个网站时,系统就会检测到你的地址异常,会封你的ip
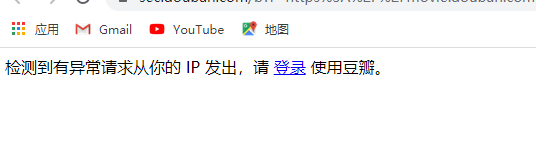
这个时候就要选择代理IP去解决这个问题。
更多推荐



 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)