
全网最细最全OLAP之clickhouse笔记|clickhouse文档|clickhouse揭秘文档(二)--clickhouse核心概念
免费视频教程视频链接 或者联系博主微信 17710299606
1 简介
1.1 什么是clickhosue
ClickHouse是俄罗斯的Yandex于2016年开源的一个用于联机分析(OLAP:Online Analytical Processing)的列式数据库管理系统(DBMS:Database Management System) , 主要用于在线分析处理查询(OLAP),能够使用SQL查询实时生成分析数据报告。
ClickHouse的全称是Click Stream,Data WareHouse,简称ClickHouse
*ClickHouse是一个完全的列式**分布式**数据库管理系统*,允许在运行时创建表和数据库,加载数据和运行查询,而无需重新配置和重新启动服务器,支持线性扩展,简单方便,高可靠性,容错。它在大数据领域没有走 Hadoop 生态,而是采用 Local attached storage 作为存储,这样整个 IO 可能就没有 Hadoop 那一套的局限。它的系统在生产环境中可以应用到比较大的规模,因为它的线性扩展能力和可靠性保障能够原生支持 shard + replication 这种解决方案。它还提供了一些 SQL 直接接口,有比较丰富的原生 client。*另外就是它比较快。*
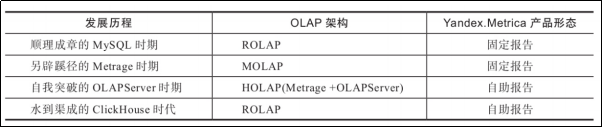
1.2 *天下武功为快不破*
其具有ROLAP、在线实时查询、完整的DBMS、列式存储、不需要任何数据预处理、支持批量更新、拥有非常完善的SQL支持和函数、支持高可用、不依赖Hadoop复杂生态、开箱即用等许多特点。特别是它那夸张的查询性能,我想大多数刚接触ClickHouse的人也一定会因为它的性能指标而动容。在一系列官方公布的基准测试对比中,ClickHouse都遥遥领先对手!
官方压测
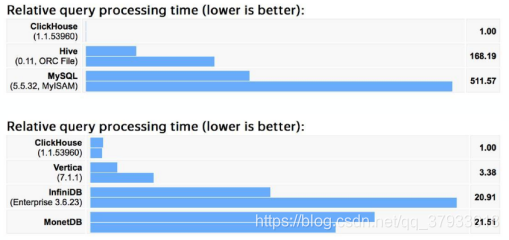
下面是100M数据集的跑分结果:ClickHouse比Vertia快约5倍,比Hive快279倍,比My SQL 快801倍;虽然对不同的SQL查询,结果不完全一样,但是基本趋势是一致的。ClickHouse跑分有多块?举个例子:ClickHouse 1秒,Vertica 5.42秒,Hive 279秒;
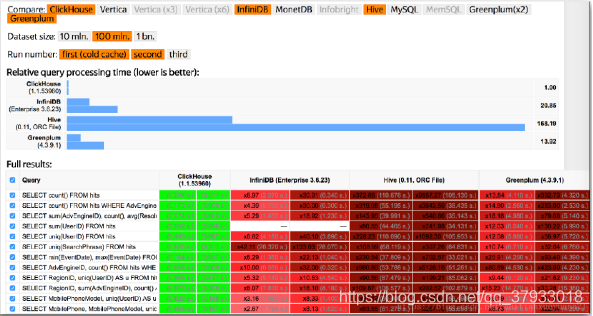
大家再看下面的一些数据图表,足以证明clickhouse在性能上的强大优势
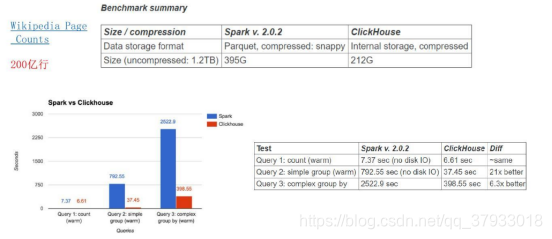
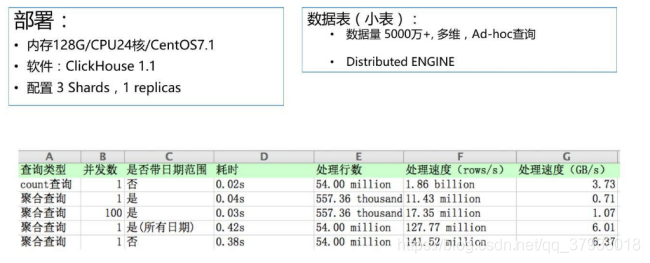
1.3 *社区如此活跃*
ClickHouse是一款开源软件,遵循Apache License 2.0协议,所 以它可以被免费使用。同时它的开源社区也非常跃度,
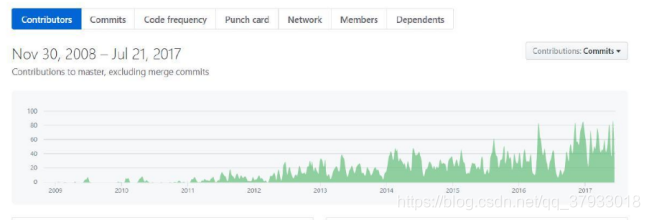
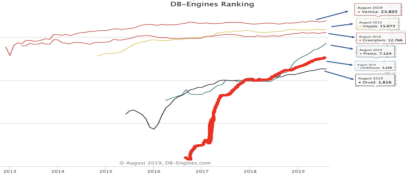
在社区方面,github star数目增速惊人。
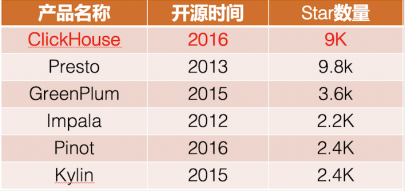
在DB-engines排名上,如下图中红色曲线所示。ClickHouse开源时间虽短,但是增势迅猛。
2 什么是OLAP
联机分析处理OLAP是一种软件技术,它使分析人员能够迅速、一致、交互地从各个方面观察信息,以达到深入理解数据的目的。BI工程师: 它具有FASMI(Fast Analysis of Shared Multidimensional Information),即共享多维信息的快速分析的特征。其中F是快速性(Fast),指系统能在数秒内对用户的多数分析要求做出反应;A是可分析性(Analysis),指用户无需编程就可以定义新的专门计算,将其作为分析的一部 分,并以用户所希望的方式给出报告;M是多维性(Multi—dimensional),指提供对数据分析的多维视图和分析;是信息性(Information),指能及时获得信息,并且管理大容量信息!
- OLAP展现在用户面前的是一幅幅多维视图。维(Dimension):是人们观察数据的特定角度,是考虑问题时的一类属性,属性集合构成一个维(时间维、地理维等)。
- 维的层次(Level):人们观察数据的某个特定角度(即某个维)还可以存在细节程度不同的各个描述方面(时间维:日期、月份、季度、年)。
- 维的成员(Member):维的一个取值,是数据项在某维中位置的描述。(“某年某月某日”是在时间维上位置的描述)。
- 度量(Measure):多维数组的取值。(2000年1月,上海,笔记本电脑,0000)。
- OLAP的基本多维分析操作有钻取(Drill-up和Drill-down)、切片(Slice)和切块(Dice)、以及旋转(Pivot)等。
- 钻取:是改变维的层次,变换分析的粒度。它包括向下钻取(Drill-down)和向上钻取(Drill-up)/上卷(Roll-up)。Drill-up是在某一维上将低层次的细节数据概括到高层次的汇总数据,或者减少维数;而Drill-down则相反,它从汇总数据深入到细节数据进行观察或增加新维。
- 切片和切块:是在一部分维上选定值后,关心度量数据在剩余维上的分布。如果剩余的维只有两个,则是切片;如果有三个或以上,则是切块。
- 旋转:是变换维的方向,即在表格中重新安排维的放置(例如行列互换)。
3 应用场景
因为ClickHouse在诞生之初是为了服务Yandex自家的Web流量分析 产品Yandex.Metrica,所以在存储数据超过20万亿行的情况下,ClickHouse做到了90%的查询都能够在1秒内返回的惊人之举。随后,
ClickHouse进一步被应用到Yandex内部大大小小数十个其他的分析场景中。可以说ClickHouse具备了人们对一款高性能OLAP数据库的美好向往,所以它基本能够胜任各种数据分析类的场景,并且随着数据体量的增大,它的优势也会变得越为明显。ClickHouse非常适用于商业智能领域(也就是我们所说的BI领域),除此之外,它也能够被广泛应用于广告流量、Web、App流量、电信、金融、电子商务、信息安全、网络游戏、物联网等众多其他领域 ... ...
今日头条 内部用ClickHouse来做用户行为分析,内部一共几千个ClickHouse节点,单集群最大1200节点,总数据量几十PB,日增原始数据300TB左右。
腾讯内部用ClickHouse做游戏数据分析,并且为之建立了一整套监控运维体系。
携程内部从18年7月份开始接入试用,目前80%的业务都跑在ClickHouse上。每天数据增量十多亿,近百万次查询请求。
快手内部也在使用ClickHouse,存储总量大约10PB, 每天新增200TB, 90%查询小于3S。
3.1 适合的场景
1.绝大多数请求都是用于读访问的
2.数据需要以大批次(大于1000行)进行更新,而不是单行更新;或者根本没有更新操作
3.数据只是添加到数据库,没有必要修改
4.读取数据时,会从数据库中提取出大量的行,但只用到一小部分列 列式存储
5.表很“宽”,即表中包含大量的列
6.查询频率相对较低(通常每台服务器每秒查询数百次或更少)
7.对于简单查询,允许大约50毫秒的延迟
8.列的值是比较小的数值和短字符串(例如,每个URL只有60个字节)
9.在处理单个查询时需要高吞吐量(每台服务器每秒高达数十亿行)
10.不需要事务
11.数据一致性要求较低
12.每次查询中只会查询一个大表。除了一个大表,其余都是小表
13.查询结果显著小于数据源。即数据有过滤或聚合。返回结果不超过单个服务器内存大小
3.2 不适合的场景
ClickHouse作为一款高性能OLAP数据库,虽然足够优秀,但也不是万能的。我们不应该把它用于任何OLTP事务性操作的场景,因为它
有以下几点不足。
·不支持事务。
·不擅长根据主键按行粒度进行查询(虽然支持),故不应该把ClickHouse当作Key-Value数据库使用。
·不擅长按行删除数据(虽然支持)。
这些弱点并不能视为ClickHouse的缺点,事实上其他同类高性能的OLAP数据库同样也不擅长上述的这些方面。因为对于一款OLAP数据库而言,上述这些能力并不是重点,只能说这是为了极致查询性能所做的权衡
'4 基本架构
4.1 单节点架构
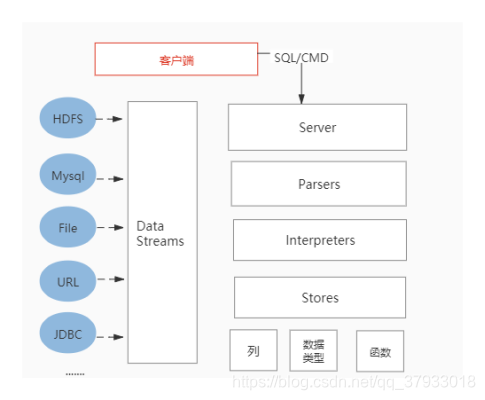
在单节点上安装好CH以后,启动CH的服务以后,可以使用CH提供的客户端交互窗口进行操作,可以操作数据库,表 , 表中的数据....
同时CH也支持和其他数据源的对接!CH可以将整个表中的数据缓存在内存中,方便快速查询,分析计算结果,也可将数据存储在本地磁盘的执行目录中, 不同引擎的表存储的位置和结构不同!!
4.2 集群架构
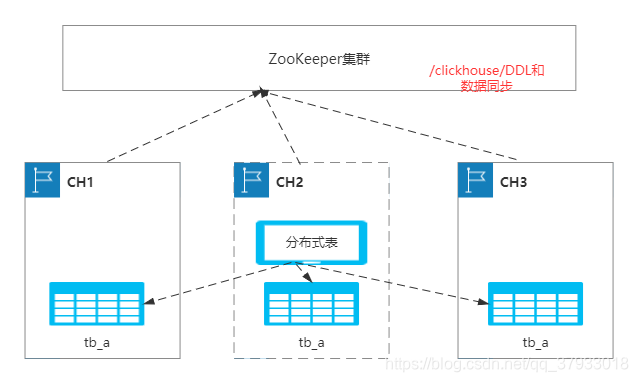
ClickHouse集群模式中依赖ZooKeeper工作 ,ZK的作用主要分为两大类:分布式DDL执行、ReplicatedMergeTree表主备节点之间的状态同步。
5 特征
5.1 完备的DBMS系统
ClickHouse拥有完备的管理功能,所以它称得上是一个DBMS(Database Management System,数据库管理系统),而不仅是一个数据库。作为一个DBMS,它具备了一些基本功能,如下所示。
·DDL(数据定义语言):可以动态地创建、修改或删除数据库、表和视图,而无须重启服务。
·DML(数据操作语言):可以动态查询、插入、修改或删除数据。
·权限控制:可以按照用户粒度设置数据库或者表的操作权限,保障数据的安全性。
·数据备份与恢复:提供了数据备份导出与导入恢复机制,满足生产环境的要求。
·分布式管理:提供集群模式,能够自动管理多个数据库节点。这里只列举了一些最具代表性的功能,但已然足以表明为什么Click House称得上是DBMS了。
5.2 真正的列式数据库管理系统
在一个真正的列式数据库管理系统中,除了数据本身外不应该存在其他额外的数据。这意味着为了避免在值旁边存储它们的长度«number»,你必须支持固定长度数值类型。例如,10亿个UInt8类型的数据在未压缩的情况下大约消耗1GB左右的空间,如果不是这样的话,这将对CPU的使用产生强烈影响。即使是在未压缩的情况下,紧凑的存储数据也是非常重要的,因为解压缩的速度主要取决于未压缩数据的大小。
这是非常值得注意的,因为在一些其他系统中也可以将不同的列分别进行存储,但由于对其他场景进行的优化,使其无法有效的处理分析查询。例如: HBase,BigTable,Cassandra,HyperTable。在这些系统中,你可以得到每秒数十万的吞吐能力,但是无法得到每秒几亿行的吞吐能力。
需要说明的是,ClickHouse不单单是一个数据库, 它是一个数据库管理系统。因为它允许在运行时创建表和数据库、加载数据和运行查询,而无需重新配置或重启服务。
5.3 据压缩 ck自己管理和维护数据
在一些列式数据库管理系统中(例如:InfiniDB CE 和 MonetDB) 并没有使用数据压缩。但是, 若想达到比较优异的性能,数据压缩确实起到了至关重要的作用,那么CK底层数据的存储使用的是列式数据存储,所有方便实时压缩算法,并且压缩比例和读取性能都比较理想
5.4 数据的磁盘存储
许多的列式数据库(如 SAP HANA, Google PowerDrill)只能在内存中工作,这种方式会造成比实际更多的设备预算。ClickHouse被设计用于工作在传统磁盘上的系统,它提供每GB更低的存储成本,但如果有可以使用SSD和内存,它也会合理的利用这些资源。
5.5 多核心并行处理
ClickHouse会使用服务器上一切可用的资源,从而以最自然的方式并行处理大型查询。
5.6 多服务器分布式处理
上面提到的列式数据库管理系统中,几乎没有一个支持分布式的查询处理。
在ClickHouse中,数据可以保存在不同的shard上,每一个shard都由一组用于容错的replica组成,查询可以并行地在所有shard上进行处理。这些对用户来说是透明的
5.7支持SQL (函数丰富 , 灵活) 高阶函数
ClickHouse支持基于SQL的声明式查询语言,该语言大部分情况下是与SQL标准兼容的。
支持的查询包括 GROUP BY,ORDER BY,IN,JOIN以及非相关子查询。
不支持窗口函数和相关子查询。
5.8 向量引擎 (并行)
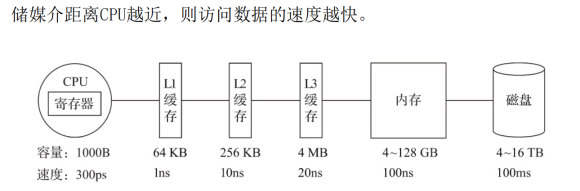
为了高效的使用CPU,数据不仅仅按列存储,同时还按向量(列的一部分)进行处理,这样可以更加高效地使用CPU。利用CPU的SIMD指令。SIMD的全称是 Single Instruction Multiple Data,即用单条指 机系统概念中,它是通过数据并行以提高性能的一种实现方式 (其他的还有指令级并行和线程级并行),它的原理是在CPU寄存器层 面实现数据的并行操作!处理使用多线程处理数据意外CK也使用CPU的寄存器,单指令并行处理数据,将数据的处理效率做到极致!
5.9 实时的数据更新
ClickHouse支持在表中定义主键。为了使查询能够快速在主键中进行范围查找,数据总是以增量的方式有序的存储在MergeTree中。因此,数据可以持续不断地高效的写入到表中,并且写入的过程中不会存在任何加锁的行为。
5.10 索引
按照主键对数据进行排序,这将帮助ClickHouse在几十毫秒以内完成对数据特定值或范围的查找。
5.11 适合在线查询
在线查询意味着在没有对数据做任何预处理的情况下以极低的延迟处理查询并将结果加载到用户的页面中。
5.12 支持近似计算
ClickHouse提供各种各样在允许牺牲数据精度的情况下对查询进行加速的方法:
- 用于近似计算的各类聚合函数,如:distinct values, medians, quantiles
- 基于数据的部分样本进行近似查询。这时,仅会从磁盘检索少部分比例的数据。
- 不使用全部的聚合条件,通过随机选择有限个数据聚合条件进行聚合。这在数据聚合条件满足某些分布条件下,在提供相当准确的聚合结果的同时降低了计算资源的使用
5.13 支持数据复制和数据完整性
ClickHouse使用异步的多主复制技术。当数据被写入任何一个可用副本后,系统会在后台将数据分发给其他副本,以保证系统在不同副本上保持相同的数据。在大多数情况下ClickHouse能在故障后自动恢复,在一些少数的复杂情况下需要手动恢复。
5.14 多主架构
HDFS、Spark、HBase和Elasticsearch这类分布式系统,都采用了Master-Slave主从架构,由一个管控节点作为Leader统筹全局。而ClickHouse则采用Multi-Master多主架构,集群中的每个节点角色对
等,客户端访问任意一个节点都能得到相同的效果。这种多主的架构有许多优势,例如对等的角色使系统架构变得更加简单,不用再区分主控节点、数据节点和计算节点,集群中的所有节点功能相同。所以它天然规避了单点故障的问题,非常适合用于多数据中心、异地多活的场景
6 基本概念
6.1 数据分片与分布式查询
数据分片是将数据进行横向切分,这是一种在面对海量数据的场 景下,解决存储和查询瓶颈的有效手段,是一种分治思想的体现。 ClickHouse支持分片,而分片则依赖集群。每个集群由1到多个分片组成,而每个分片则对应了ClickHouse的1个服务节点。分片的数量上限 取决于节点数量(1个分片只能对应1个服务节点)。ClickHouse并不像其他分布式系统那样,拥有高度自动化的分片
功能。ClickHouse提供了本地表(Local Table)与分布式表(Distributed Table)的概念。一张本地表等同于一份数据的分片。而分布式表本身不存储任何数据,它是本地表的访问代理,其作用类似分库中间件。借助分布式表,能够代理访问多个数据分片,从而实现分布式查询。这种设计类似数据库的分库和分表,十分灵活。例如在业务系统上线的初期,数据体量并不高,此时数据表并不需要多个分片。所以使用单个节点的本地表(单个数据分片)即可满足业务需求,待到业务增长、数据量增大的时候,再通过新增数据分片的方式分流数据,并通过分布式表实现分布式查询。这就好比一辆手动挡赛车,它将所有的选择权都交到了使用者的手中!
6.2 列式存储
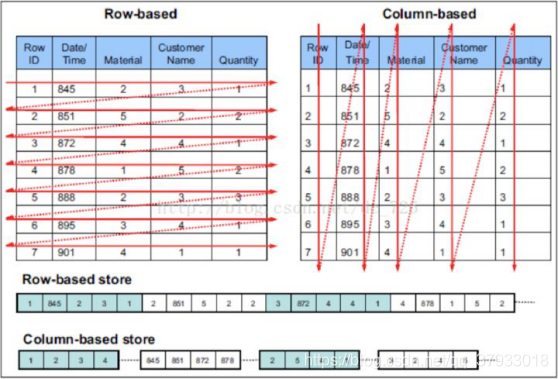
相比于行式存储,列式存储在分析场景下有着许多优良的特性。
1)如前所述,分析场景中往往需要读大量行但是少数几个列。在行存模式下,数据按行连续存储,所有列的数据都存储在一个bloCK中,不参与计算的列在IO时也要全部读出,读取操作被严重放大。而列存模式下,只需要读取参与计算的列即可,极大的减低了IO cost,加速了查询。
2)同一列中的数据属于同一类型,压缩效果显著。列存往往有着高达十倍甚至更高的压缩比,节省了大量的存储空间,降低了存储成本。
3)更高的压缩比意味着更小的data size,从磁盘中读取相应数据耗时更短。
4)自由的压缩算法选择。不同列的数据具有不同的数据类型,适用的压缩算法也就不尽相同。可以针对不同列类型,选择最合适的压缩算法。
5)高压缩比,意味着同等大小的内存能够存放更多数据,系统cache效果更好。
官方数据显示,通过使用列存,在某些分析场景下,能够获得100倍甚至更高的加速效应。
6.3 向量化(算法)
ClickHouse不仅将数据按列存储,而且按列进行计算。传统OLTP数据库通常采用按行计算,原因是事务处理中以点查为主,SQL计算量小,实现这些技术的收益不够明显。但是在分析场景下,单个SQL所涉及计算量可能极大,将每行作为一个基本单元进行处理会带来严重的性能损耗:
1)对每一行数据都要调用相应的函数,函数调用开销占比高;
2)存储层按列存储数据,在内存中也按列组织,但是计算层按行处理,无法充分利用CPU cache的预读能力,造成CPU Cache miss严重;
3)按行处理,无法利用高效的SIMD指令;
ClickHouse实现了向量执行引擎(Vectorized execution engine),对内存中的列式数据,一个batch调用一次SIMD指令(而非每一行调用一次),不仅减少了函数调用次数、降低了cache miss,而且可以充分发挥SIMD指令的并行能力,大幅缩短了计算耗时。向量执行引擎,通常能够带来数倍的性能提升。
(SIMD全称Single Instruction Multiple Data,单指令多数据流,能够复制多个操作数,并把它们打包在大型寄存器的一组指令集。以同步方式,在同一时间内执行同一条指令。)
6.4 表
联想以前学习的表 , 有表名和表结构
6.5 分片
ClickHouse的集群由分片 ( Shard ) 组成,而每个分片又通过副本 ( Replica ) 组成。这种分层的概念,在一些流行的分布式系统中十分普遍。例如,在Elasticsearch的概念中,一个索引由分片和副本组成,副本可以看作一种特殊的分片。如果一个索引由5个分片组成,副本的基数是1,那么这个索引一共会拥有10个分片 ( 每1个分片对应1个副本 )。
如果你用同样的思路来理解ClickHouse的分片,那么很可能会在这里栽个跟头。ClickHouse的某些设计总是显得独树一帜,而集群与分片就是其中之一。这里有几个与众不同的特性。
ClickHouse的1个节点只能拥有1个分片,也就是说如果要实现1分片、1副本,则至少需要部署2个服务节点。
分片只是一个逻辑概念(类似于Hbase中的region的概念,表的范围数据),其物理承载还是由副本承担的。
6.6 分区
ClickHouse支持PARTITION BY子句,在建表时可以指定按照任意合法表达式进行数据分区操作,比如通过toYYYYMM()将数据按月进行分区、toMonday()将数据按照周几进行分区、对Enum类型的列直接每种取值作为一个分区等。
类似于hive中的分区表
6.7 副本
数据存储副本,在集群模式下实现高可用
简单理解就是相同的数据备份,在CK中通过复制集,我们实现保障了数据可靠性外,也通过多副本的方式,增加了CK查询的并发能力。这里一般有2种方式:(1)基于ZooKeeper的表复制方式;(2)基于Cluster的复制方式。由于我们推荐的数据写入方式本地表写入,禁止分布式表写入,所以我们的复制表只考虑ZooKeeper的表复制方案。
6.8 引擎
就是表的类型,不同的表有不同的特点,不同引擎决定表的数据存储位置和数据存储特点!!
不同的引擎决定了表数据的存储特点和表数的操作行为:
- 决定表存储在哪里以及以何种方式存储
- 支持哪些查询以及如何支持
- 并发数据访问
- 索引的使用
- 是否可以执行多线程请求
- 数据复制参数
表引擎决定了数据在文件系统中的存储方式,常用的也是官方推荐的存储引擎是MergeTree系列,如果需要数据副本的话可以使用ReplicatedMergeTree系列,相当于MergeTree的副本版本。读取集群数据需要使用分布式表引擎Distribute。
6.9 Column与Field
Column和Field是ClickHouse数据最基础的映射单元。作为一款百 分之百的列式存储数据库,ClickHouse按列存储数据,内存中的一列数据由一个Column对象表示。Column对象分为接口和实现两个部分,在IColumn接口对象中,定义了对数据进行各种关系运算的方法,例如插入数据的insertRangeFrom和insertFrom方法、用于分页的cut,以及用于过滤的filter方法等。而这些方法的具体实现对象则根据数据类型的不同,由相应的对象实现,例如ColumnString、ColumnArray和 ColumnTuple等。在大多数场合,ClickHouse都会以整列的方式操作数据,但凡事也有例外。如果需要操作单个具体的数值(也就是单列中的一行数据),则需要使用Field对象,Field对象代表一个单值。与Column对象的泛化设计思路不同,Field对象使用了聚合的设计模式。在Field对象内部聚合了Null、UInt64、String和Array等13种数据类型及相应的处理逻辑。
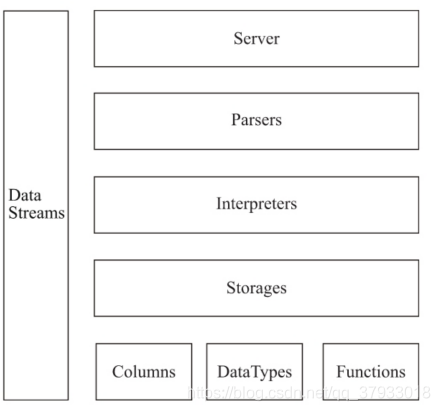
ClickHouse架构设计中的核心模块
6.10 DataType
数据的序列化和反序列化工作由DataType负责。IDataType接口定义了许多正反序列化的方法,它们成对出现,例如serializeBinary和deserializeBinary、serializeTextJSON和deserializeTextJSON等,涵盖了常用的二进制、文本、JSON、XML、CSV和Protobuf等多种格式类型。IDataType也使用了泛化的设计模式,具体方法的实现逻辑由对应数据类型的实例承载,例如DataTypeString、DataTypeArray及
DataTypeTuple等。DataType虽然负责序列化相关工作,但它并不直接负责数据的读取,而是转由从Column或Field对象获取。在DataType的实现类中,聚合了相应数据类型的Column对象和Field对象。例如,DataTypeString会引用字符串类型的ColumnString,而DataTypeArray则会引用数组类型的ColumnArray,以此类推
6.11 Block与Block流
ClickHouse内部的数据操作是面向Block对象进行的,并且采用了流的形式。虽然Column和Filed组成了数据的基本映射单元,但对应到实际操作,它们还缺少了一些必要的信息,比如数据的类型及列的名称。于是ClickHouse设计了Block对象,Block对象可以看作数据表的 子集。Block对象的本质是由数据对象、数据类型和列名称组成的三元组,即Column、DataType及列名称字符串。Column提供了数据的读取能力,而DataType知道如何正反序列化,所以Block在这些对象的基础之上实现了进一步的抽象和封装,从而简化了整个使用的过程,仅通过Block对象就能完成一系列的数据操作。在具体的实现过程中,Block并没有直接聚合Column和DataType对象,而是通过ColumnWithTypeAndName对象进行间接引用。
有了Block对象这一层封装之后,对Block流的设计就是水到渠成的事情了。流操作有两组顶层接口:IBlockInputStream负责数据的读取和关系运算,IBlockOutputStream负责将数据输出到下一环节。 Block流也使用了泛化的设计模式,对数据的各种操作最终都会转换成其中一种流的实现。IBlockInputStream接口定义了读取数据的若干个read虚方法,而具体的实现逻辑则交由它的实现类来填充。
IBlockInputStream接口总共有60多个实现类,它们涵盖了ClickHouse数据摄取的方方面面。这些实现类大致可以分为三类:第一类用于处理数据定义的DDL操作,例如DDLQueryStatusInputStream
等;第二类用于处理关系运算的相关操作,例如LimitBlockInputStream、JoinBlockInputStream及AggregatingBlockInputStream等;第三类则是与表引擎呼应,每一种表引擎都拥有与之对应的
BlockInputStream实现,例如MergeTreeBaseSelectBlockInputStream(MergeTree表引擎)TinyLogBlockInputStream(TinyLog表引擎)及KafkaBlockInputStream(Kafka表引擎)等。
IBlockOutputStream的设计与IBlockInputStream如出一辙。IBlockOutputStream接口同样也定义了若干写入数据的write虚方法。它的实现类比IBlockInputStream要少许多,一共只有20多种。这些实
现类基本用于表引擎的相关处理,负责将数据写入下一环节或者最终目的地,例如MergeTreeBlockOutputStream、TinyLogBlockOutputStream及StorageFile
6.12 Parser与Interpreter
Parser和Interpreter是非常重要的两组接口:Parser分析器负责 创建AST对象;而Interpreter解释器则负责解释AST,并进一步创建查询的执行管道。它们与IStorage一起,串联起了整个数据查询的过
程。Parser分析器可以将一条SQL语句以递归下降的方法解析成AST语法树的形式。不同的SQL语句,会经由不同的Parser实现类解析。例如,有负责解析DDL查询语句的ParserRenameQuery、ParserDropQuery和ParserAlterQuery解析器,也有负责解析INSERT语句的ParserInsertQuery解析器,还有负责SELECT语句的ParserSelectQuery等。
Interpreter解释器的作用就像Service服务层一样,起到串联整个查询过程的作用,它会根据解释器的类型,聚合它所需要的资源。首先它会解析AST对象;然后执行“业务逻辑”(例如分支判断、设置
参数、调用接口等);最终返回IBlock对象,以线程的形式建立起一个查询执行管道!
6.13 Cluster与Replication
ClickHouse的集群由分片(Shard)组成,而每个分片又通过副本(Replica)组成。这种分层的概念,在一些流行的分布式系统中十分普遍。例如,在Elasticsearch的概念中,一个索引由分片和副本组成,副本可以看作一种特殊的分片。如果一个索引由5个分片组成,副本的基数是1,那么这个索引一共会拥有10个分片(每1个分片对应1个副本)。
如果你用同样的思路来理解ClickHouse的分片,那么很可能会在这里栽个跟头。ClickHouse的某些设计总是显得独树一帜,而集群与分片就是其中之一。这里有几个与众不同的特性。
(1)ClickHouse的1个节点只能拥有1个分片,也就是说如果要实
现1分片、1副本,则至少需要部署2个服务节点。
- 分片只是一个逻辑概念,其物理承载还是由副本承担的。
代码清单是ClickHouse的一份集群配置示例,从字面含义可以理解为自定义集群ch_cluster拥有1个
shard(分片)和1个replica(副本),且该副本由10.37.129.6服务节点承载
<ch_cluster>
<shard>
<replica>
<host>10.37.129.6</host>
<port>9000</port>
</replica>
</shard>
</ch_cluster>
<ch_cluster>
<shard>
<replica>
<host>10.37.129.6</host>
<port>9000</port>
</replica>
<replica>
<host>10.37.129.7</host>
<port>9000</port>
</replica>
</shard>
</ch_cluster>
上面的代码配置理解成集群中表只有一个切片,但是存储一个数据副本 ,也就值在集群中存储两份一样的数据 ,从而保证表数据的安全性 , 因为数据在集群的不同的机器上存储!
更多推荐


 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)