
客户信用风险预测——基于logit模型
线性回归是最基本的统计模型之一,通常用于衡量数值型变量间的线性关系,当解释变量或者被解释变量为分类型变量时,就不再适用,需要考虑设置虚拟变量或是选择其它分类模型。
下面介绍一个二元选择模型,此时被解释变量是分类变量,取值为0(不发生)或者1(发生)。
数据来源于《R数据分析:方法与案例详解》,借助logit模型测算客户违约概率,完成信用风险评估。具体分为5个步骤:数据预处理——变量筛选——建模——结果分析——参数优化。
- 数据预处理
案例数据来源于台湾某大型商业银行信用卡部的数据库,包含16000条信息 ,29 个变量,即客户基本信息(性别*、年龄*、城镇或农村*、学历*、职业*、婚姻*、家庭人数*、 户籍所在地、宗教、血型、星座) ,经济状况(家庭月收入*、家庭经济等级*、个人月收入*、个人月开 销*),信用卡使用状况(信用卡张数*、使用频率*、月刷卡金额*),信用记录(逾期超过 30 天*、呆账记 录*、借款余额大于 800 万元*、退票记录、拒往记录、强制停卡记录)。
缺失值处理(因为含NA的样本数量很少,直接删去)
变量重编码(连续数据离散化、字符型变量数值化)

-
数据探索
模型因变量为default,其它28个都是潜在的解释变量,如果全部引入,且不说给建模带来麻烦,也不便于实际应用,所以要有一个变量筛选过程。常用的方法有:A.经验筛选,即以历史经验过滤掉不相干变量;B.变量删除,用逐步回归等方法删除若干变量使模型变得更加显著;C.变量规约,用因子分析、主成分分析等方法将多个变量合成少数几个聚合因子。
这里选择方法A与B,分别筛去变量10个、4个,保留的变量有14个,建立logit模型。
另外,为了获得更好的模型外预测效果,我们将131068条数据分为traindata与testdata两部分,比例7:3,用traindata建模,testdata验证。 -
建模与估计
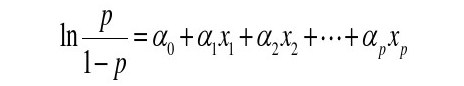
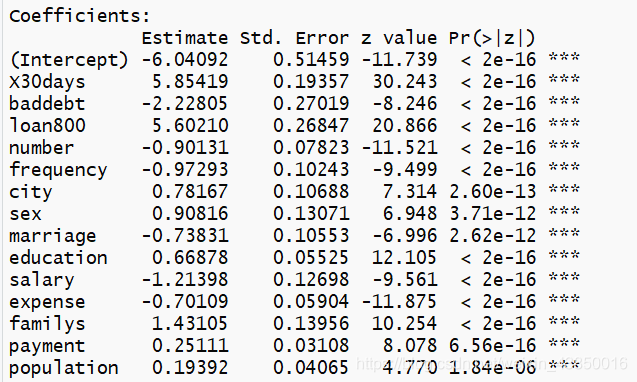
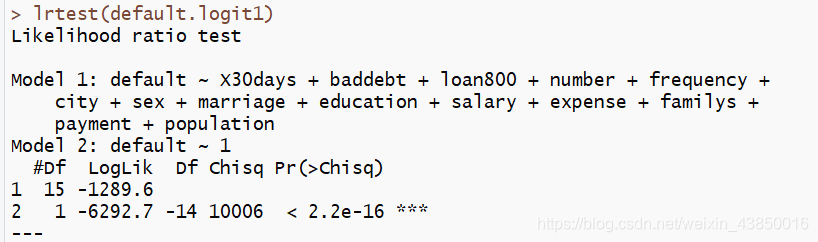
P值是logit模型的响应概率,放到这里就是客户违约的概率,R的输出结果就是P值,而不是ln(P/(1-P)),更方便使用。对照前面的多元回归,这里也要关注两个统计检验,即估计参数的显著性检验(t检验)和模型的整体显著性检验(似然比检验),具体结果见下,应数通过,模型可靠。
-
结果分析
以下是几个参考角度:系数符号
模型系数不好解释,但符号的正负可以说明因素影响的效应方向,比如30天内违约的客户再次违约的概率更大,薪水越高的客户发生违约的概率越小;预测
混淆矩阵和ROC曲线可以帮助我们更好地刻画预测准确率,用上面的模型对testdata进行验证。
因为输出结果是一个概率P值,需要转化为相应的二元选择,假设模临界概率为0.5,混淆矩阵如下,预测正确率为96.6%,比较理想。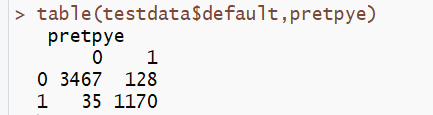
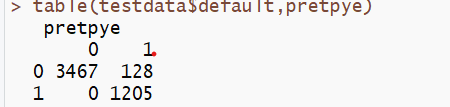
其实临界概率可以稍稍修正,以提高预测精度。当临界概率为0.43时,总体预测精度达97.3%,而且其中实际发生违约的全部预测正确。 -
参数优化
logit模型得到的是取值为1(即违约)的概率,有时候需要转化为具体的违约情况(即违约与不违约),通常我们以0.5为临界概率,即≥0.5的定义为违约,<0.5的定义为不违约,这个阈值其实是有待商榷的,有进一步优化的空间。
下面通过优化这个参数,错判样本相比原来降低了35例。
   ss<-seq(0.1,1,0.01)
   pp<-c()
   for (i in 1:length(ss)) {
     pretpye<-ifelse(predata>ss[i],1,0)
     kk<-data.frame(traindata$default,pretpye)
     pp[i]<-sum(kk[,1]==kk[,2])/nrow(kk)
   }
   ss[which.max(pp)]
logit模型相比线性回归模型,不再局限于数值型被解释变量,适用范围变得更广,相较很多分类模型的“黑箱子”算法,模型表达式明确、可得到具体概率值,在实务中还是比较好用的。
更多推荐


 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)