
数据结构(C++)KMP算法
周一学了KMP算法,这几天一直都搞不懂为什么,所以准备好好整理一下KMP的门道。KMP算法就是两个字符串在匹配过程中,子串在主串中第一次出现的位置,之前的BF算法是i、j每次都在两个字符串中遍历,若发生错误,i每次回溯到i+1的位置,j回溯到0,这样理解是非常简单的,时间复杂度是O(M*N),为了对字符串匹配问题进行优化,所以出现了KMP算法,KMP算法的时间复杂度是O(M+N),节省了很多的时间。
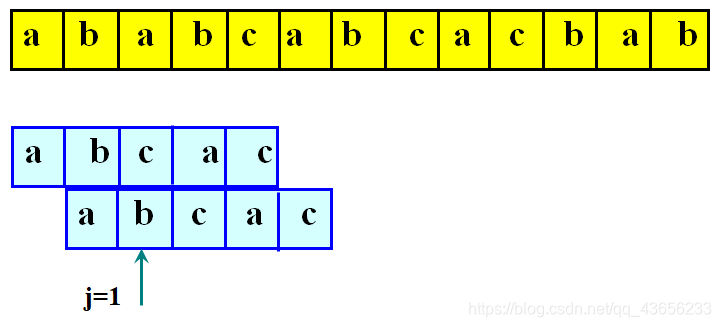
1、为什么待匹配串要向后移动
a b a b c a b c a c b a b
a b c a c
在上式中,在两条字符串的匹配过程,主串中的b与待匹配串中的c没有匹配上,按照BF的算法是,把待匹配串的a与主串中的b再次匹配,
如下图:
a b a b c a b c a c b a b
a b c a c
然而这样是没有必要的,因为回退后的主串和待匹配串匹配的字符一定不同。(a、b不同)
所以我们需要的是把我们的待匹配串的j指向新的位置与主串进行下一次的匹配(待匹配串的向右滑动),主串的i位置不变,j=next[]j],next[j]的确定是下一个问题。
2、next[j]的确定
next[j]的含义是指,在主串和待匹配串已经匹配成功的这部分中,主串中后缀中与待匹配串前缀中相同的部分的最大长度,就是待匹配串要向后移动的最大距离。
但是虽然说是主串和待匹配串的最大重合部分的长度,但是主串的前缀不就是待匹配串的前部分么,因为这一部分是已经匹配成功的,所以我们就可以大胆的抛开主串不看,直接对待匹配串进行next值的计算,从而可以应用到任意的主串当中。
首先是next[j]值的一个公式:
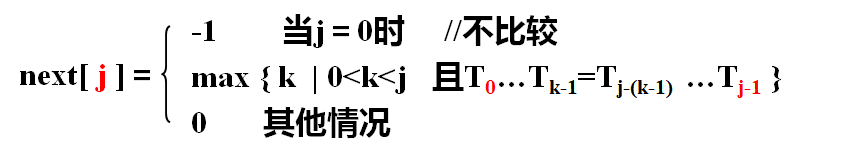
在j位置前的部分中,前缀与后缀的最大重合部分,自己在纸上画一画也就可以算出来。
这里借鉴一个博主的博客,他写的非常有用:
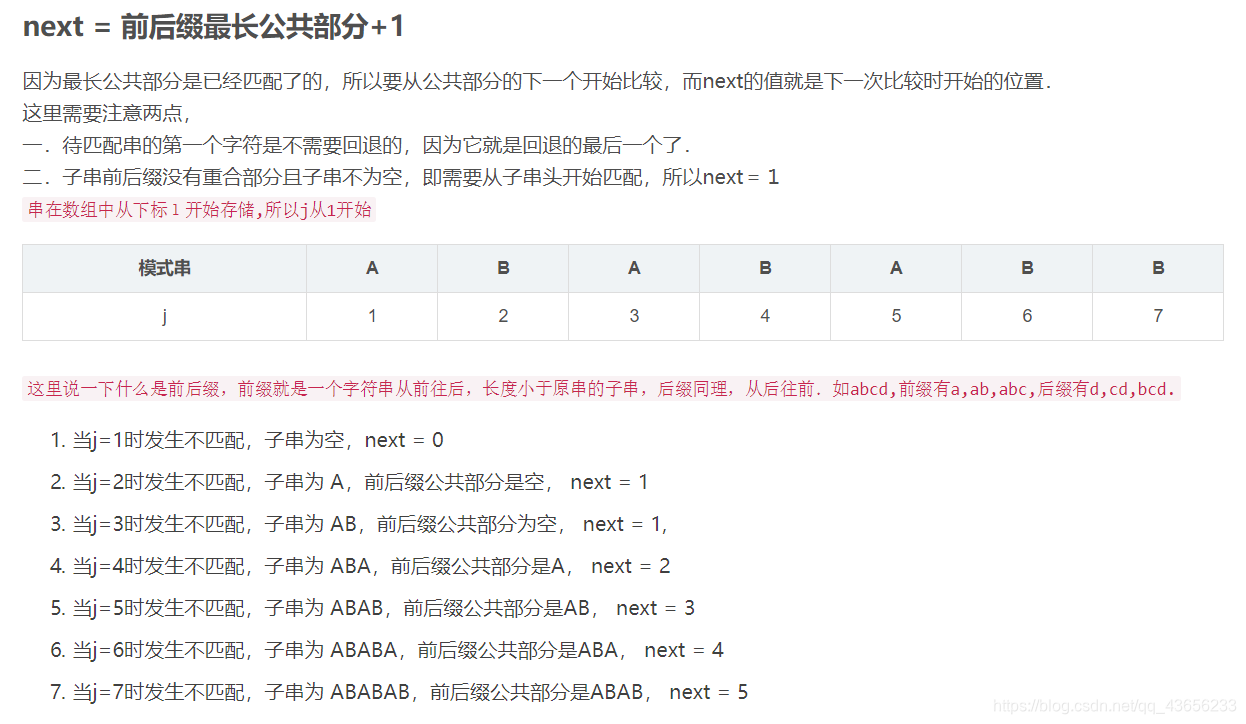
他这里对于如何算出前后缀最大重合部分,写的特别好,(我是赶不上了。。。)
next[j]的代码实现1:
其实手写出来还写,但是如果使用代码实现的话也是一个比较困的的地方,所以我们可以借助一个变量k作为辅助,进行代码的书写。
void setNext(string T, int next[])
{
	int tlen = T.length();
	next[0] = -1;
	int j = 0, k = -1;
	while (j < tlen)
	{
		if (k == -1 || T[k] == T[j])
		{
			k++;
			j++;
			next[j] = k;
		}
		else
		{
			k = next[k];
		}
	}
}
- 当k=-1,代表前面匹配失败,重新开始匹配。
- 当T[k] == T[j],代表匹配成功,进行下一次的匹配。
- 如果两个条件都不满足,让k=next[k],去next的位置,重新开始。
next[j]的代码实现2:
void set_Next(string T, int next[])
{
	next[0] = -1;
	int j = 1, k;
	while (j < T.length())
	{
		k = next[j - 1];
		while (k != -1 && T[k] != T[j - 1])
		{
			k = next[k];
		}
		k++;
		next[j] = k;
		j++;
	}
}
确定位置的代码:
int getLocate(string S, string T, int next[])
{
	setNext(T, next);
	int slen = S.length();
	int tlen = T.length();
	int i = 0, j = 0;
	while (i < slen && j < tlen)
	{
		if (j == -1 || S[i] == T[j])
		{
			i++;
			j++;
		}
		else
		{
			j = next[j];
		}
	}
	if (j == tlen)
	{
		return i - tlen + 1; // 这里个人比较喜欢直接确定位置,所以+1
	}
	return -1;
}
KMP所有的代码实现:
#include<iostream>
#include<cstring>
using namespace std;
void setNext(string T, int next[])
{
	int tlen = T.length();
	next[0] = -1;
	int j = 0, k = -1;
	while (j < tlen)
	{
		if (k == -1 || T[k] == T[j])
		{
			k++;
			j++;
			next[j] = k;
		}
		else
		{
			k = next[k];
		}
	}
}
int getLocate(string S, string T, int next[])
{
	setNext(T, next);
	int slen = S.length();
	int tlen = T.length();
	int i = 0, j = 0;
	while (i < slen && j < tlen)
	{
		if (j == -1 || S[i] == T[j])
		{
			i++;
			j++;
		}
		else
		{
			j = next[j];
		}
	}
	if (j == tlen)
	{
		return i - tlen + 1;
	}
	return -1;
}
int main()
{
	int next[20];
	string s, t;
	cin >> s;
	cin >> t;
	cout << getLocate(s, t, next);
	return 0;
}
最后补充一下BF算法:
是不是感觉特别的简单呢,所以一般用这个暴力就好。
int BF(string S, string T)
{
	int i = 0;
	int j = 0;
	while (i < S.length() && j < T.length())
	{
		if (S[i] == T[j])
		{
			i++;
			j++;
		}
		else
		{
			i = i - j + 1;
			j = 0;
		}
	}
	if (j >= T.length())
	{
		return (i - j);
	}
	else
	{
		return -1;
	}
}
更多推荐



 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)