
spark阿里云集群搭建
因为现阶段使用到了spark,所以就想搭建spark集群平台在阿里云上,网上找了很多资料,发现每一个人写的都不太一样,试过几次发现搭建不成功,于是自己慢慢琢磨,总结他们的经验,最后自己成功搭建,写下此篇博客,防止以后再次需要搭建时遇到问题,以下为搭建步骤。
hadoop、scala集群安装成功
下载安装
官网下载地址:http://spark.apache.org/downloads.html
下载与hadoop对应版本的安装包,我的hadoop是2.7.6的所以下载 spark-2.4.3-bin-hadoop2.7.tgz
下载好后解压
tar -zxvf spark-2.4.3-bin-hadoop2.7.tgz
重命名
mv spark-2.4.3-bin-hadoop2.7 spark
配置环境变量
vi /etc/profile
export SPARK_HOME=/usr/spark
export PATH=$PATH:$SPARK_HOME/bin
使环境变量生效
source /etc/profile
进入到spark的conf文件下
cd spark/conf
mv spark-env.template spark-env.sh
mv log4j.properties.template log4j.properties
mv slaves.template slaves
修改spark-env.sh文件
vi spark-env.sh
加入以下配置
export SCALA_HOME=/usr/scala
export JAVA_HOME=/usr/jdk1.8.0_65
export HADOOP_CONF_DIR=/usr/hadoop/etc/hadoop
修改slaves文件
vi slaves
将localhost改为hadoop集群主机节点名
master
server1
server2
在集群其它节点上做同样操作或复制过去
scp -r spark/ server1:/usr/
scp -r spark/ server2:/usr/
应为与hadoop启动进程是同样命令,所以进到sbin文件下启动
cd spark/sbin
start-all.sh
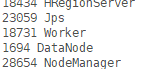
jps查看master上是否有 Master和Worker

从节点上是否有Worker

阿里云开放端口8081、7077

阿里云spark集群搭建成功
更多推荐



 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)