
矩阵分解(MF,SVD)和协同过滤(CF)
协同过滤Collaborative Filtering
使用用户历史的行为来做未来的推荐。忽略了关于用户或item的先验信息。
- CF使用与我相似的用户的评分来预测我的评分
- CF是领域无关的,不需要知道现在在对什么评分,谁在评分,评分是多少
一种CF方法称为基于邻域的方法。例如
- 定义一个相似度评分,基于用户之间评分的重叠度
- 基于相似度评分,使用邻域内的评分来为我喜欢的item打分
过滤方法并不是互斥的。内容信息可以被添加到协同过滤系统来提升性能。
矩阵分解MF

SVD
我们知道矩阵的特征分解可以将矩阵分解成一组特征向量和特征值。
现在介绍另一种矩阵分解的方法,称为奇异值分解,将矩阵分解为奇异向量和奇异值。
每个实数矩阵都有一个奇异值分解,但不一定都有特征分解。例如,非方阵的矩阵没有特征分解,这时只能用奇异值分解。
在特征分解中,我们可以将矩阵M写作
M
=
V
d
i
a
g
(
λ
)
V
−
1
M=Vdiag(\lambda)V^{-1}
M=Vdiag(λ)V−1。
奇异值分解中,将矩阵M分解成
M
=
U
S
V
T
M=USV^T
M=USVT,这里U和V都是正交矩阵,S是对角矩阵(S不一定是方阵)。
矩阵S对角线上的元素被称为矩阵M的奇异值。
矩阵U的列向量被称为左奇异向量。矩阵V的列向量被称为右奇异向量。
事实上,M的左奇异向量是
M
M
T
MM^T
MMT的特征向量。M的右奇异向量是
M
T
M
M^TM
MTM(协方差矩阵)的特征向量。M的非零奇异值是
M
T
M
M^TM
MTM的特征值的平方根,同时也是
M
M
T
MM^T
MMT的特征值的平方根。
证明
对于正交矩阵有
A
−
1
=
A
T
A^{-1}=A^T
A−1=AT
M
M
T
U
=
U
S
V
T
V
S
T
U
T
=
U
S
2
=
S
2
U
MM^TU=USV^TVS^TU^T=US^2=S^2U
MMTU=USVTVSTUT=US2=S2U,所以U的列向量是
M
M
T
MM^T
MMT的特征向量。
SVD应用
SVD可以用于PCA降维,来做数据压缩和去噪。也可以用于推荐算法,将用户和喜好对应的矩阵做特征分解,进而得到隐含的用户需求来做推荐。同时也可以用于NLP中的算法,比如潜在语义索引(LSI)。下面我们就对SVD用于PCA降维做一个介绍。
SVD用于PCA
PCA中,需要找到样本协方差矩阵
X
T
X
X^TX
XTX的最大的d个特征向量,当样本数和特征数量很多时,计算量很大。
事实上,SVD也可以得到
X
T
X
X^TX
XTX的最大的d个特征向量构成的矩阵,但是一些SVD算法(查查哪些)可以不用先求出协方差矩阵
X
T
X
X^TX
XTX,就可以求出右奇异矩阵
V
V
V。
这样就可以通过SVD分解来完成PCA算法,这个方法在样本量很大的时候很有效。
PCA仅仅使用了SVD的右奇异矩阵,左奇异矩阵可以用于行的压缩。
右奇异矩阵用于列即特征的压缩,即PCA降维。
SVD矩阵分解
根据奇异值分解SVD
M
n
×
d
=
U
n
×
r
S
r
×
r
V
r
×
d
T
M_{n\times d}=U_{n\times r}S_{r\times r}V^T_{r\times d}
Mn×d=Un×rSr×rVr×dT
其中
U
T
U
=
i
,
V
T
V
=
I
,
S
是对角矩阵
,
S
i
i
≥
0
U^TU=i,V^TV=I,S是对角矩阵,S_{ii}\ge0
UTU=i,VTV=I,S是对角矩阵,Sii≥0
r
=
r
a
n
k
(
M
)
r=rank(M)
r=rank(M)
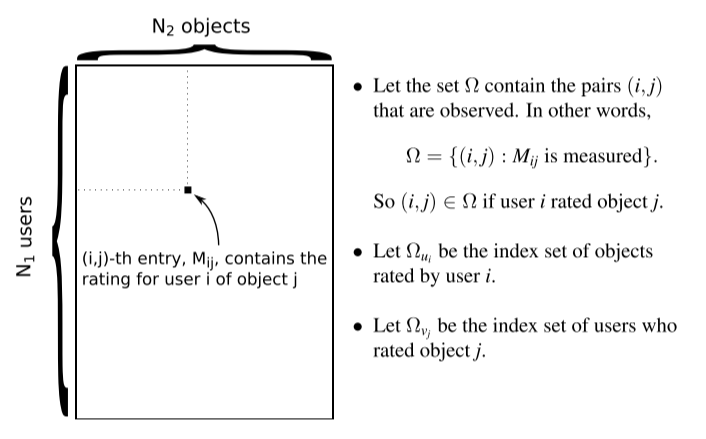
我们将定义模型来学习矩阵M的低秩分解,能够
- 处理M存在大部分缺失值的问题
- 低秩 d < < min ( N 1 , N 2 ) ( e . g . , d ≈ 10 ) d<<\min(N_1,N_2)(e.g.,d\approx10) d<<min(N1,N2)(e.g.,d≈10)
- 学习user i和 item j的向量表示
为什么学习一个低秩矩阵?
- 评分矩阵的许多列是相似的
- 低秩意味着 N 1 N_1 N1维的列并不能填充满整个 N 1 N_1 N1空间
- 由于95%以上的数据可能缺失,低秩的限制让我们有可能根据相关性填充数据
概率矩阵分解PMF
生成模型
对
N
1
N_1
N1个用户和
N
2
N_2
N2个物体,生成向量:
\begin{align*}
\mu_i\sim N(0,\lambda^{-1}I),i=1,…,N_1\
v_j\sim N(0,\lambda^{-1}I),j=1,…,N_2
\end{align*}
根据以上向量评分数据的分布为
M
i
j
∼
N
(
u
i
T
v
j
,
σ
2
)
for each
(
i
,
j
)
∈
Ω
M_{ij}\sim N(u_i^Tv_j,\sigma^2) \text{for each} (i,j)\in \Omega
Mij∼N(uiTvj,σ2)for each(i,j)∈Ω
备注
- 由于 M i j M_{ij} Mij是评分,高斯假设显然是错误的(高斯假设评分取值范围为所有实数,而一般评分为非负整数)
- 但是,高斯是一个方便的假设。算法实现容易,模型也可正常工作
模型推断
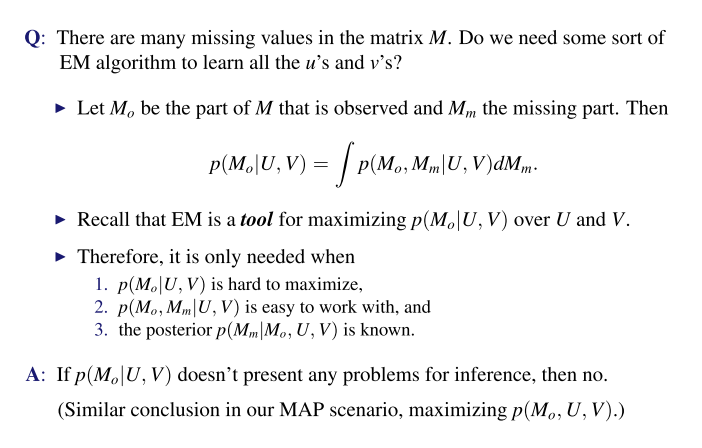
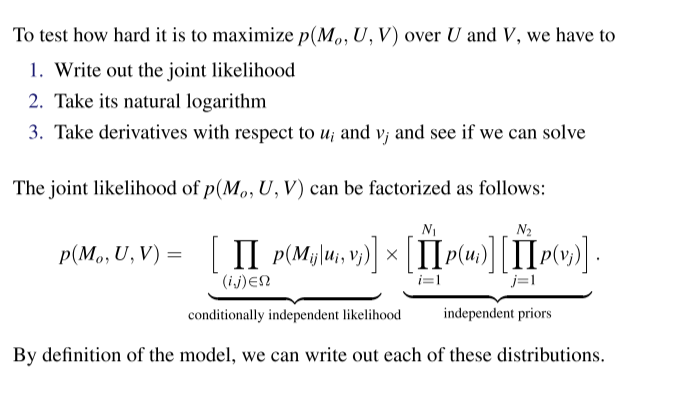
最大后验概率MAP
对数似然函数和MAP
U
M
A
P
,
V
M
A
P
=
arg
max
U
,
V
∑
(
i
,
j
)
∈
Ω
ln
p
(
M
i
j
∣
u
i
,
v
j
)
+
∑
i
=
1
N
1
ln
p
(
u
i
)
+
∑
j
=
1
N
2
ln
p
(
v
j
)
U_{MAP},V_{MAP}=\arg\max\limits_{U,V}\sum\limits_{(i,j)\in\Omega}\ln p(M_{ij}|u_i,v_j)+\sum\limits_{i=1}^{N_1}\ln p(u_i)+\sum\limits_{j=1}^{N_2}\ln p(v_j)
UMAP,VMAP=argU,Vmax(i,j)∈Ω∑lnp(Mij∣ui,vj)+i=1∑N1lnp(ui)+j=1∑N2lnp(vj)
记MAP的目标函数为L,我们希望最大化:
L
=
−
∑
(
i
,
j
)
∈
Ω
1
2
σ
2
∣
∣
M
i
j
−
u
i
T
v
j
∣
∣
2
−
∑
i
=
1
N
1
λ
2
∣
∣
u
i
∣
∣
2
−
∑
j
=
1
N
2
λ
2
∣
∣
v
j
∣
∣
2
+
constant
L=-\sum\limits_{(i,j)\in\Omega}\frac{1}{2\sigma^2}||M_{ij}-u_i^Tv_j||^2-\sum\limits_{i=1}^{N_1}\frac{\lambda}{2}||u_i||^2-\sum\limits_{j=1}^{N_2}\frac{\lambda}{2}||v_j||^2+\text{constant}
L=−(i,j)∈Ω∑2σ21∣∣Mij−uiTvj∣∣2−i=1∑N12λ∣∣ui∣∣2−j=1∑N22λ∣∣vj∣∣2+constant
平方项的产生源于参数服从高斯分布。
求L对参数的偏导数,并令其为0
\begin{align*}
\nabla_{u_i}L=\sum_{j\in\Omega_{u_i}}\frac{1}{\sigma2}(M_{ij}-u_iTv_j)v_j-\lambda u_i=0\
\nabla_{v_j}L=\sum_{i\in\Omega_{v_j}}\frac{1}{\sigma2}(M_{ij}-v_jTu_i)u_i-\lambda v_j=0
\end{align*}
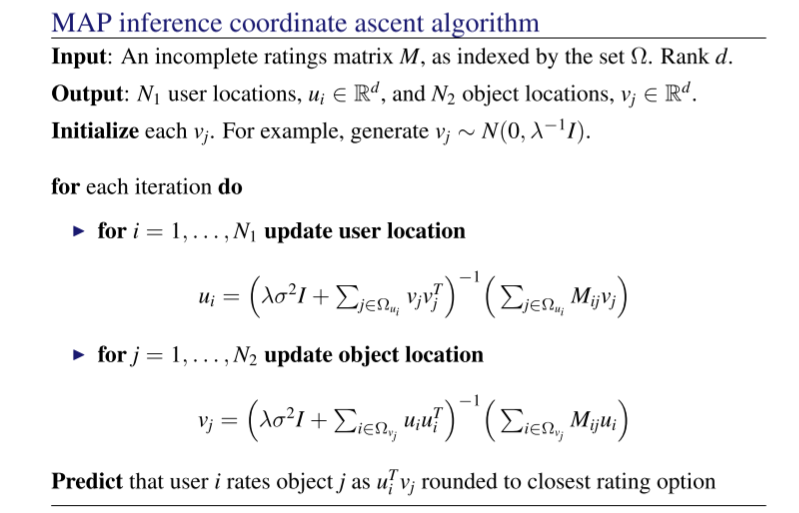
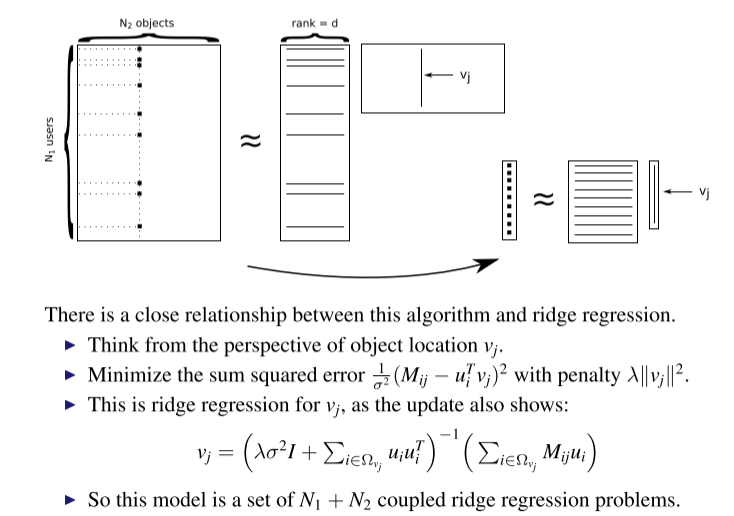
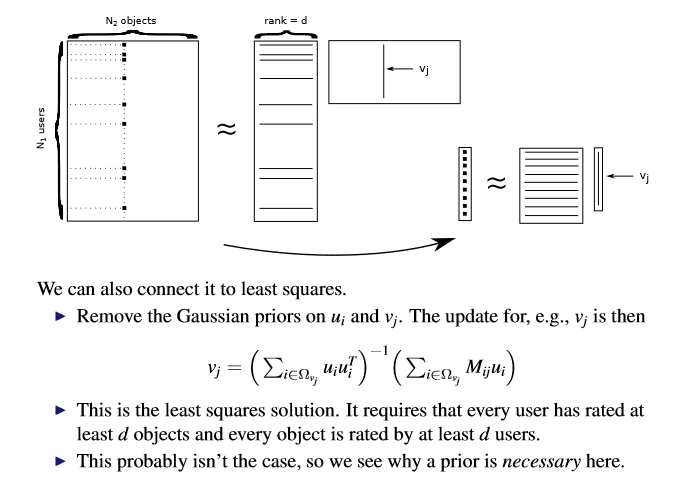
我们可以独立地求解
u
i
u_i
ui和
v
j
v_j
vj(因此不需要EM算法)
\begin{align*}
u_i&=(\lambda\sigma2I+\sum\limits_{j\in\Omega_{u_i}}v_jv_jT)^{-1}(\sum\limits_{j\in\Omega_{u_i}}M_{ij}v_j)\
v_j&=(\lambda\sigma2I+\sum\limits_{j\in\Omega_{v_j}}u_iu_iT)^{-1}(\sum\limits_{j\in\Omega_{v_j}}M_{ij}u_i)
\end{align*}
注意,我们不能一次性将所有的
u
i
u_i
ui和
v
j
v_j
vj求解。
因此,采用类似K-menas和GMM的坐标下降算法。
矩阵分解和Ridge回归
参考资料
更多推荐



 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)