
链表面试题两道:环形链表与随机链表的拷贝
链表面试题两道:判环与随机指针的拷贝
链表的增删查改写熟之后,真正拉开差距的是两类题:让遍历永远走不完的环,和一条"还多了一根线"的链表。
为什么要聊这两道题
单链表的增删查改,本质上只有一根 next 线,代码再绕也有迹可循。面试题却常反着来:
- 环形链表(Linked List Cycle):把链表的尾部接回头部或中间某个结点,
next不再"通向空",遍历变成死循环。考的是在不知道结构的前提下判断"会不会无限"。 - 随机指针(Random Pointer):每个结点多一个可以指向链表中任意位置的
random域。链从"一条线"变成"一张关系网",拷贝时不能再顺着一根next一路复制到底。
两道题的共同点是:线性直觉在这里失效,只能靠指针本身的性质——差速、相对位置——来解题。它们分别对应力扣 141/142 与 138 号原题,是从"链表基础"跨到"链表面试"的必经题。
第一题:判断链表是否有环
题目(课件第九题,力扣 141):给定一个链表的头指针,判断链表中是否存在环。直觉做法是遍历 + 标记:每经过一个结点就留记号,再遇到记号即有环。但那是 O(n) 的额外空间。把空间压到 O(1),就要动用两个指针。
思路:快慢指针(Slow-Fast Pointers)
慢指针一次走一步,快指针一次走两步,两个指针从链表头同时出发:
- 链表无环:快指针率先走到
NULL,游戏结束; - 链表有环:两指针最终会在环内相遇。
课件打了个比方:像陪女朋友在操场跑步,一个快一个慢,快的那位总会从后面套圈追上来——前提是两人一直跑、不退出。
#include <stdbool.h>

struct ListNode {
    int val;
    struct ListNode* next;
};

bool hasCycle(struct ListNode* head) {
    struct ListNode* slow = head;
    struct ListNode* fast = head;

    while (fast != NULL && fast->next != NULL) {
        slow = slow->next;          // 慢指针每次走一步
        fast = fast->next->next;    // 快指针每次走两步
        if (slow == fast) {
            return true;            // 相遇 => 带环
        }
    }
    return false;                   // 快指针先到末尾 => 无环
}
为什么"快两步、慢一步"一定能追上
判环成立的关键不是"快",而是"快慢差速为 1"。设环长为 L:
- 快指针先进环,慢指针后进环。慢指针进环那一刻,最坏情况两者相距正好一整圈 L;
- 此后每次移动,快指针都比慢指针多走一步,即两者距离单调减 1;
- 距离从 ≤ L 缩到 0,至多需要 L 次移动。结论:慢指针还没走完一圈,快指针必然追上。
反过来想更清楚:如果快慢同速,两人的距离永远不变,追上就无从谈起。"差速 = 1"才是保证相遇的那个常数。
追问:快指针走 3 步、4 步行不行
课件在判环之后抛出了这个问题。答案是不行,原因藏在"互质"里。
设快指针每次走 s 步,相对速度就是 s−1。要在任意环长、任意初始距离下都保证相遇,s−1 必须与环长 L 互质;而 L 事先未知,唯一与所有正整数都互质的数只有 1,也就是 s = 2。
| 快指针步数 s | 相对速度 s−1 | 反例 | 能否保证追上 |
|---|---|---|---|
| 1 | 0 | 同速则间距永不缩小,判环失效 | 不能 |
| 2 | 1 | 1 与任意环长互质,无反例 | 能 |
| 3 | 2 | 环长 4:差速 2 只在同奇偶位之间跳,永远错开 | 不一定 |
| 4 | 3 | 环长 6:3 与 6 有公因子 3 | 不一定 |
以"环长 4、快走 3 步"为例:慢指针进环时,若快指针在它前方奇数个结点处,两者每次只错开 2 个位置,永远到不了同一点——这就是"不互质"在链表里的物理表现。
顺带一提:返回入环点
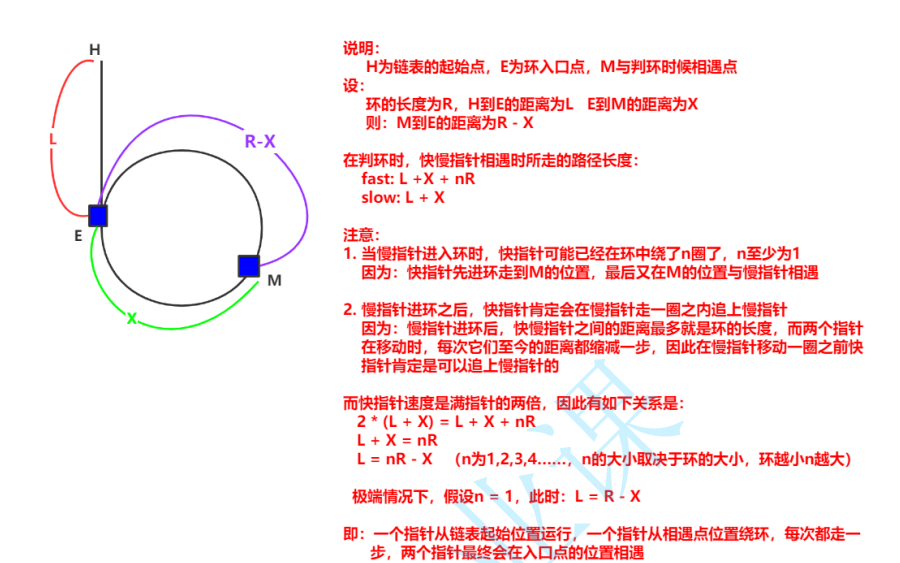
判环只回答"有没有"。课件第十题(力扣 142)进一步问:返回链表开始入环的第一个结点(环入口,Cycle Entry),无环则返回 NULL。
结论:找到相遇点之后,让一个指针从链表头出发、另一个指针从相遇点出发,都每次走一步,再次相逢的位置就是环的入口。
代数证明(示意图见原 PDF 第 8 页):设从头到入环口的距离为 a,入环口沿环到相遇点的距离为 b,环长为 L。慢指针共走 a+b 步;快指针共走 a+b+kL 步(k 为绕的圈数),且快指针总路程是慢指针的 2 倍:
a + b + kL = 2(a + b)
⇒  a + b = kL
⇒  a = kL − b = (k−1)L + (L−b)
(L−b) 正是从相遇点继续绕到入环口的距离。于是从 head 走 a 步、从相遇点绕 (L−b) 步,恰好落在同一个结点——入环口。
struct ListNode* detectCycle(struct ListNode* head) {
    struct ListNode* slow = head;
    struct ListNode* fast = head;

    while (fast != NULL && fast->next != NULL) {
        slow = slow->next;
        fast = fast->next->next;
        if (slow == fast) {               // 先找到相遇点
            struct ListNode* p = head;    // 一个指针从头出发
            struct ListNode* q = slow;    // 一个指针从相遇点出发
            while (p != q) {              // 都走一步,直到相逢
                p = p->next;
                q = q->next;
            }
            return p;                     // 入环口
        }
    }
    return NULL;                          // 无环
}
🔎 需要看图:课件第 7、8 页的"相遇 / 入环"示意均为结构图,PDF 提取器无法转文字。上面的代数关系已经给出定量答案,作图时可照
a = (k−1)L + (L−b)核对。
第二题:复制带随机指针的链表
题目(课件第十一题,力扣 138):给定一个链表,每个结点在 val、next 之外还有一个 random 指针,可以指向链表中任意结点或 NULL。要求返回这个链表的一份深拷贝(Deep Copy)——结构相同、但完全独立的新链表。
难点在哪
如果只有 next,复制是平凡的:边遍历边新建即可。random 打破了这条路:
- 它可能指向后面的结点——顺着
next建到一半,目标拷贝还不存在; - 它可能指向前面的结点——即使存在,也得能找出"它对应的拷贝是谁"。
直觉解法是建一张映射表:第一遍为每个原结点创建值相同的新结点,记录"原结点 → 新结点";第二遍查表,把新结点的 next、random 指向对应的新结点。正确、直观,代价是 O(n) 额外空间。
⚠️ 省事的做法是让新结点的
random直接指回原链的结点。那样两条链共享同一组引用,原链任何改动都会顺着random暴露到拷贝里——这不叫拷贝,叫别名。
不建表的三步法(O(1) 额外空间)
题目真正想让你做到的是不建哈希表、只靠指针穿插。核心在于:先让每个结点的拷贝紧贴在它后面,把"原结点 → 它的拷贝"这条映射直接写进链表结构里。
- 插入拷贝:遍历原链,在每个结点
cur之后插入值相同的拷贝copy,原链变成A → A' → B → B' → …; - 定 random:拷贝的
random指向"cur->random对应的那个拷贝"。既然每个原结点的拷贝就挂在它next上,拷贝的random就是cur->random->next(cur->random为NULL则置NULL); - 拆链:把穿插好的长链一分为二,恢复原链,同时串出新链并返回其头。
| 方案 | 额外空间 | 思路 | 取舍 |
|---|---|---|---|
| 哈希表法 | O(n) | 建表记录原→新,二次扫描设 next/random | 直观、不易错 |
| 三步穿插法 | O(1) | 拷贝插入 → 定 random → 拆链 | 空间最优,步骤多、易错 |
下面是三步法的完整 C 实现(逐行对应上述思路,未改动逻辑):
#include <stdlib.h>

struct Node {
    int val;
    struct Node* next;
    struct Node* random;
};

struct Node* copyRandomList(struct Node* head) {
    if (head == NULL) {
        return NULL;
    }

    // 步骤 1:在每个原结点后插入它的拷贝
    struct Node* cur = head;
    while (cur != NULL) {
        struct Node* copy = (struct Node*)malloc(sizeof(struct Node));
        copy->val = cur->val;
        copy->next = cur->next;   // 拷贝先接上原结点的后继
        cur->next = copy;         // 原结点指向自己的拷贝
        cur = copy->next;         // cur 跨回原链的下一个结点
    }

    // 步骤 2:定 random —— 拷贝的 random 落在"原 random 的拷贝"上
    cur = head;
    while (cur != NULL) {
        struct Node* copy = cur->next;
        if (cur->random == NULL) {
            copy->random = NULL;
        } else {
            copy->random = cur->random->next;
        }
        cur = copy->next;         // 跨过拷贝,回到下一个原结点
    }

    // 步骤 3:拆链 —— 还原原链,同时抽出拷贝链
    cur = head;
    struct Node* copyHead = NULL;
    struct Node* copyTail = NULL;
    while (cur != NULL) {
        struct Node* copy = cur->next;
        struct Node* next = copy->next;   // 先记住原链的后继,别弄丢

        if (copyTail == NULL) {           // 拷贝链的第一个结点
            copyHead = copy;
            copyTail = copy;
        } else {
            copyTail->next = copy;
            copyTail = copyTail->next;
        }

        cur->next = next;                 // 原链跳回它原本的 next
        cur = next;
    }
    copyTail->next = NULL;                // 拷贝链收尾
    return copyHead;
}
三个循环里 cur 都通过"拷贝的 next"(也就是原链的后继)前进,穿插结构因此始终不坏。读懂这条遍历线,就抓住了三步法的命门。
常见误区
- 判环用错速度:快指针走 3、4 步不保证相遇;快慢同速则距离永不缩小。只有"快 2 步、慢 1 步"对任意环长都成立。
random指回原链:写copy->random = cur->random是把拷贝链和原链串成一张网,不是深拷贝。拷完后必须指向"目标结点的拷贝",即cur->random->next。- 拆链顺序错乱:先做了
cur->next = copy又去找下一个原结点,会找不到原链的尾巴。必须先拿临时变量存下copy->next。 - 判空缺失:
while里不检查fast->next是否存在就去解引用fast->next->next,会在无环链表末尾崩溃。刷题代码普遍省略malloc判空,能跑,但进工程前要补上。
本节要点
- 判环的充分条件是差速为 1:间距每步缩 1,慢指针走完一圈前必被追上;对任意环长都能保证的只有"快走 2 步"。
- 找到相遇点后,头指针与相遇指针各走一步,再次相逢处即环入口,定量关系是
a = (k−1)L + (L−b)。 - 带随机指针的深拷贝,三步法用"拷贝紧贴原结点"把映射写进结构、省掉哈希表:插入 → 定
random→ 拆链,额外空间 O(1)。 - 拆链先存后继、链尾置
NULL、解引用先判空——这三条纪律,比"跑通"更值得背下来。
更多推荐



 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)