
2026黄鹤杯网络安全人才创新大赛学生组(Misc部分)
刚刚比完不久,本来想着出个misc全,但是有最后有一道一解的misc还是做不太出,先水一篇好了
所以本文只有潮痕留声和失序货栈,纯水()
Misc
潮痕留声-HHB2026
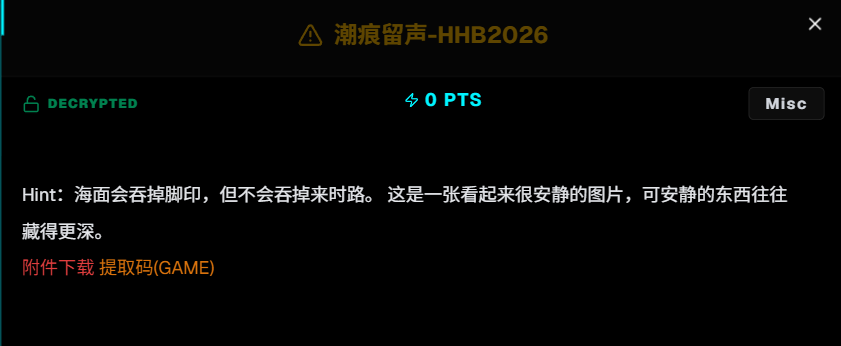
首先是潮痕留声,好久没有手搓了,这一次手搓了一道还是蛮开心的
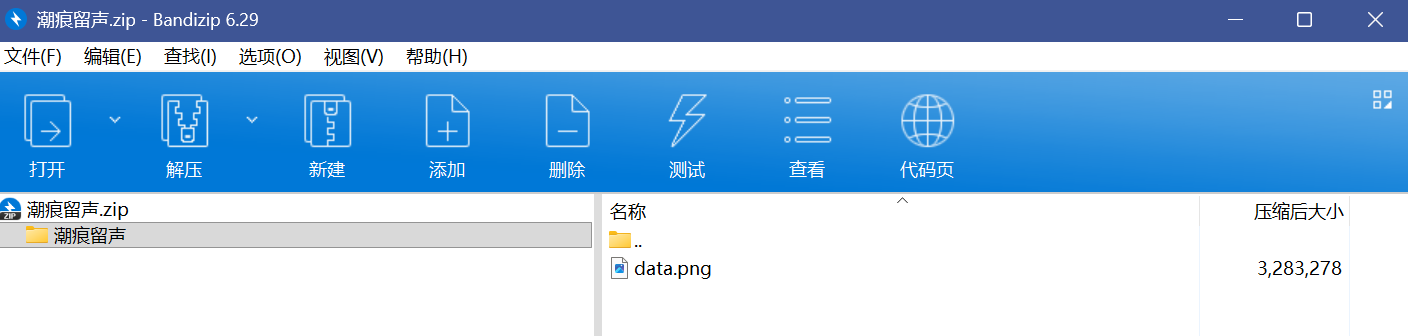
打开附件,发现只有一个data.png
拿到png先看看十六进制
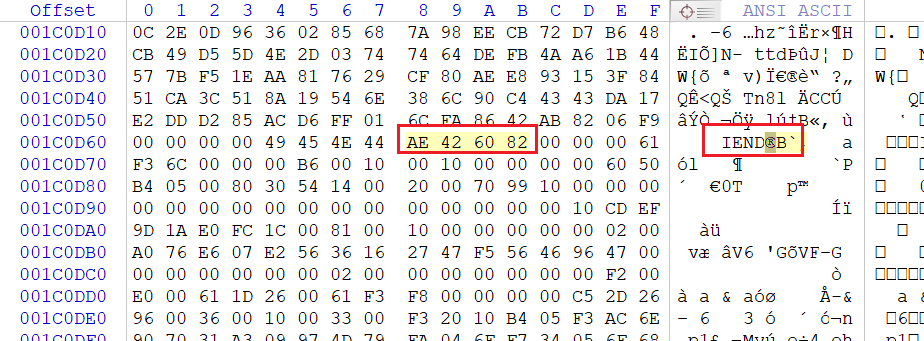
我们追踪png的文件尾AE 42 60 82,发现文件后冗余大量的信息
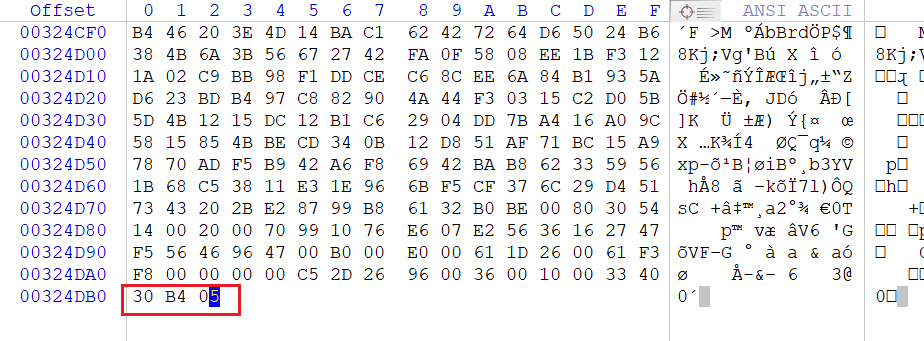
对冗余信息进行信息探查,发现了十六进制末尾写的是4030B405
倒转一下正好就是0x504B0304,即zip压缩包的开始标志
想到题目可能是将压缩包的十六进制倒转后拼接在了png文件之后,我们提取一下,再倒转回去即可
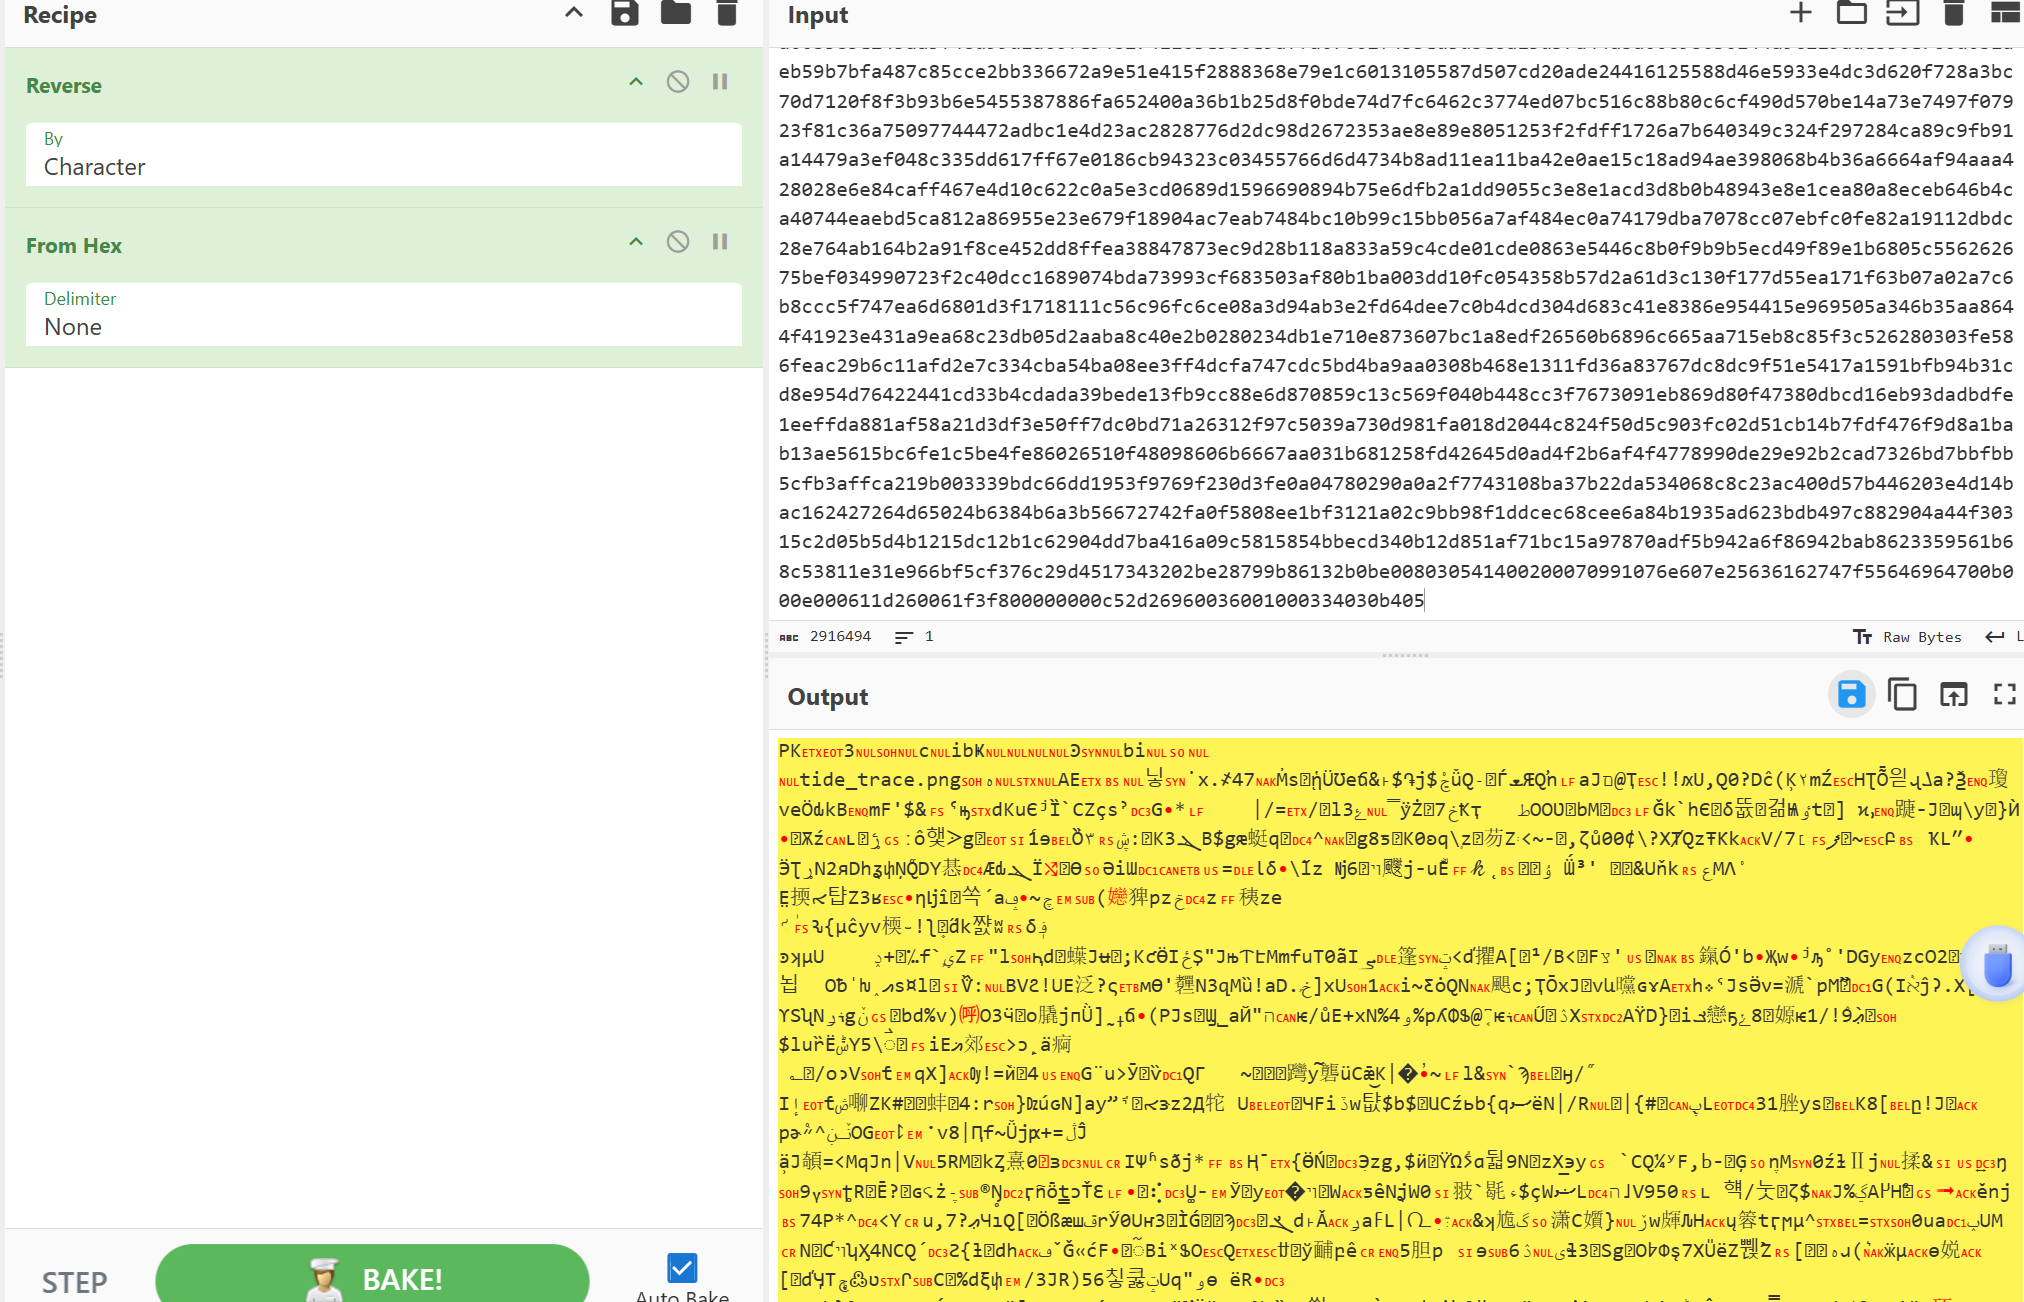
利用cyberchef进行reverse即可
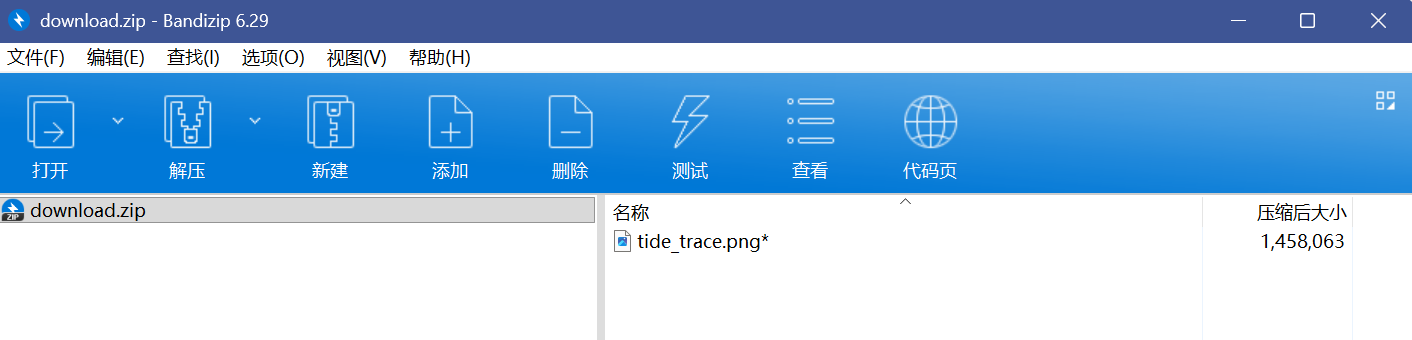
下载后发现是一个加密的压缩包
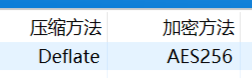
这个加密方法可以排除是明文爆破的可能了,伪加密发现也不是
继续探查信息
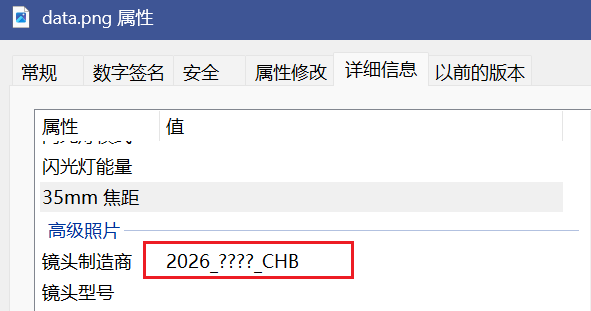
查看属性发现明显提示2026_????_CHB,形似掩码
于是想到本题可能考察我们的是压缩包的掩码爆破
这边可以用工具,也可以用脚本,相对来说还是工具会快一些
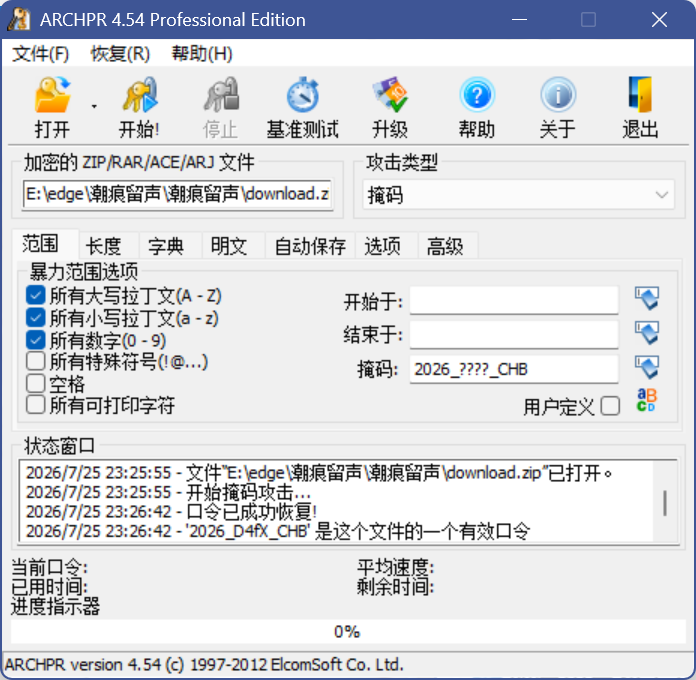
直接选择掩码爆破,写好掩码即可,除了ARCHPR,passware kit等工具,或是python脚本等等均可
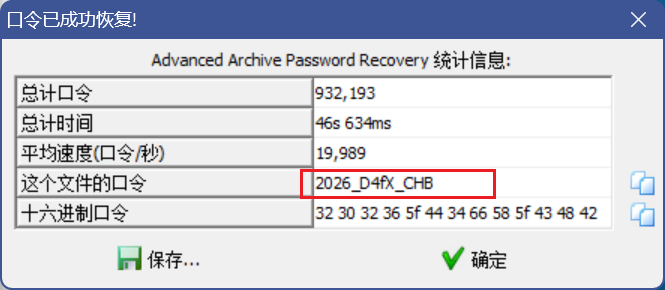
进行爆破,很容易得到压缩包密码为2026_D4fX_CHB
得到新图片tide_trace.png
又是一张png文件,继续查看十六进制
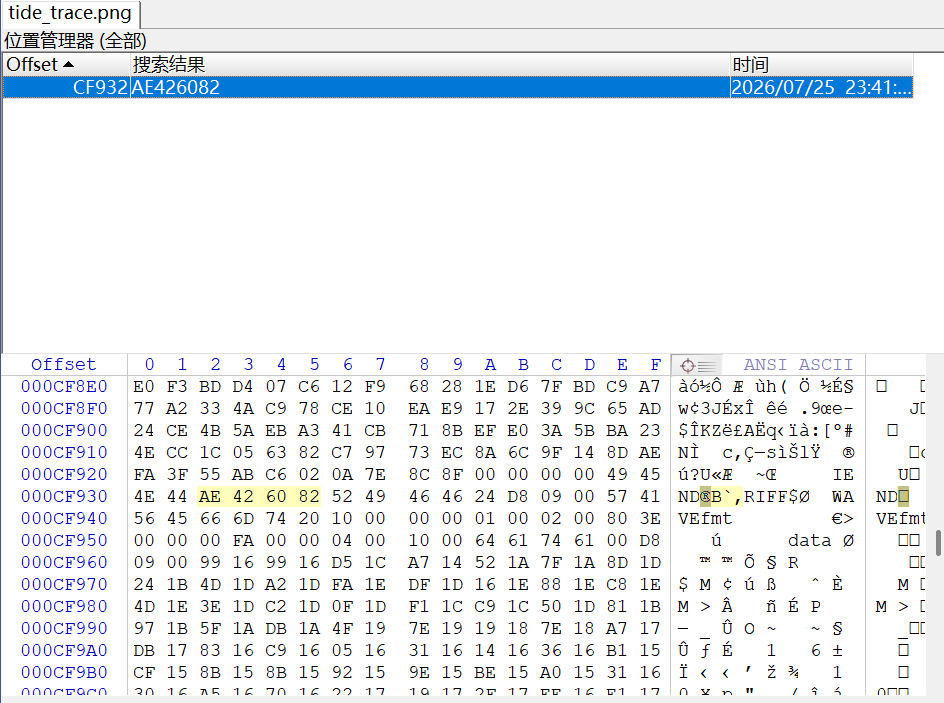
发现在文件尾后依旧藏有信息,且看文件头可以发现是一个多媒体文件
我们直接利用Foremost进行提取,得到了一个音频文件
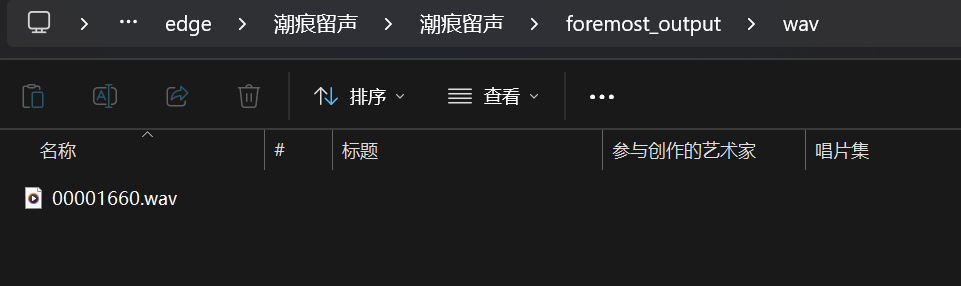
直接听没有什么信息,怀疑音频隐写,放入Audacity进行查看
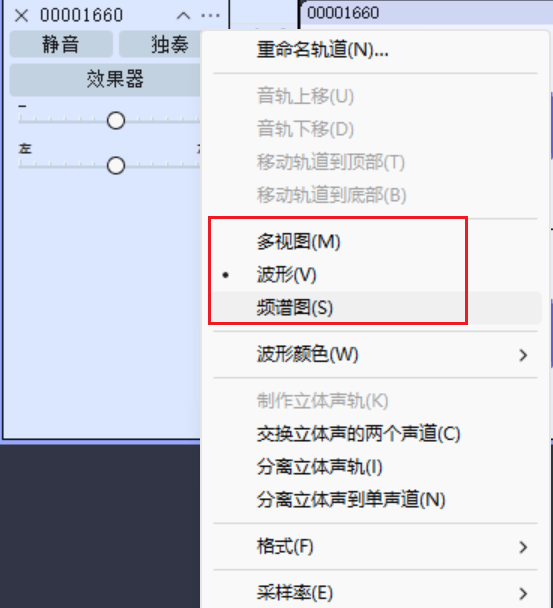
右键选择查看频谱图
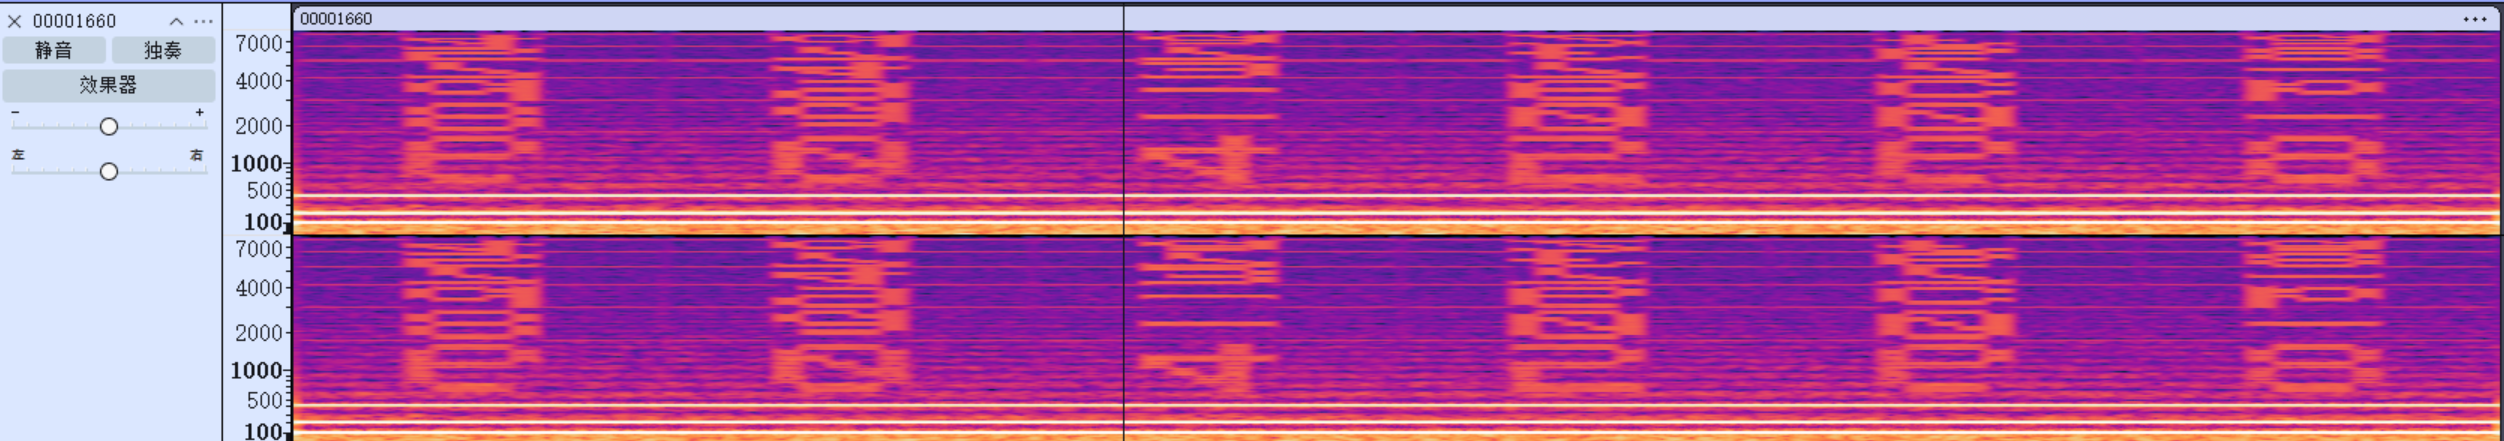
明显藏有明文,进行处理
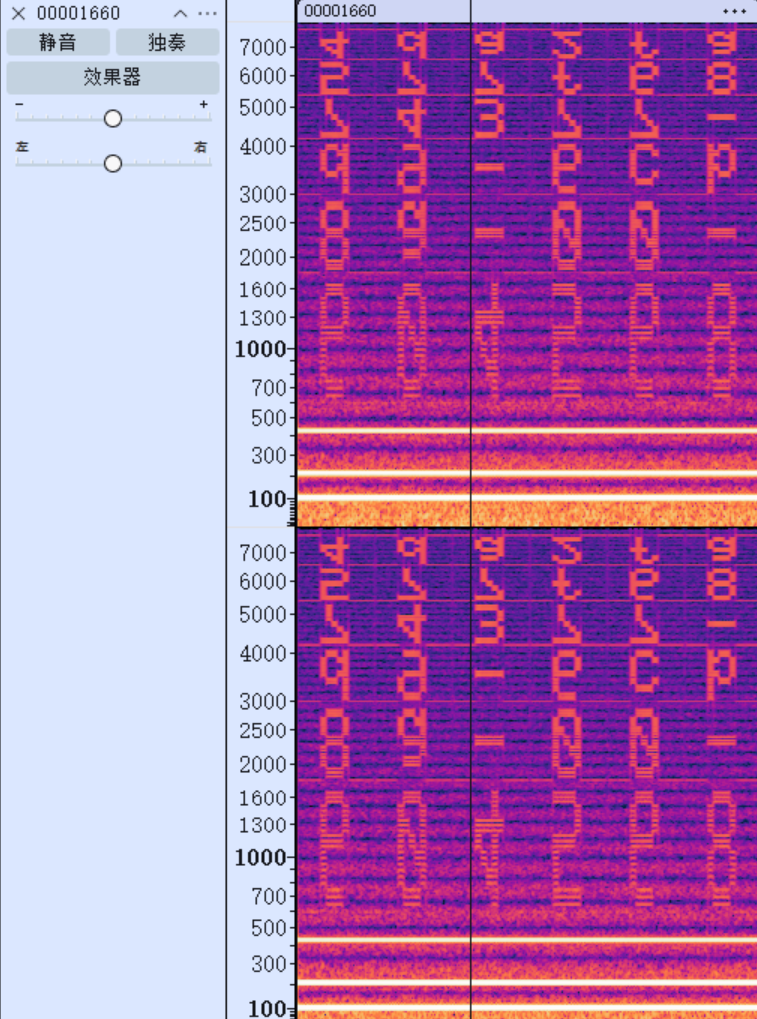
简单拉伸一下,发现是上下、左右都进行了翻转(看这个4最明显),我们手动反转回来
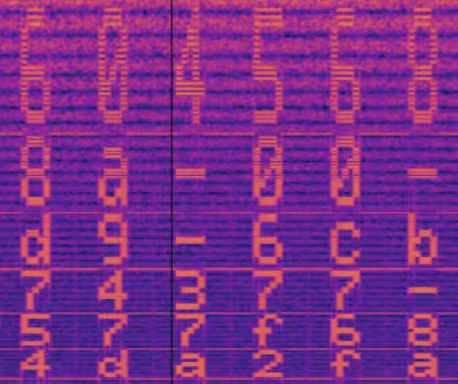
现在我们得到了一个很类似flag的文件,但是不知道这个六乘六的矩阵如何处理,不知道flag是如何阅读的
回到原来解压出的tide_trace.png,题目提示的潮痕还没用到,怀疑可能是宽高被修改过,我们可以利用CRC看看宽高有没有问题,有问题的话就CRC爆破出来正确的
import struct, zlib

d = open("tide_trace.png", "rb").read()
crc = struct.unpack(">I", d[29:33])[0]
rest = d[24:29]

for w in range(1, 2001):
    c = zlib.crc32(b"IHDR" + struct.pack(">I", w))
    for h in range(1, 2001):
        if zlib.crc32(struct.pack(">I", h) + rest, c) & 0xffffffff == crc:
            print("width =", w, "height =", h)
            quit()
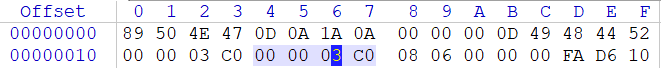
发现图片高度有问题,应该是 960 × 960才对
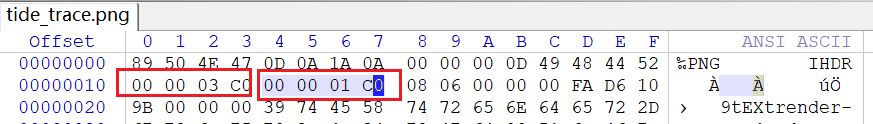
我们知道,在PNG文件签名之后就是IHDR,内容固定13字节
4 字节:宽度
4 字节:高度
1 字节:位深
1 字节:颜色类型
1 字节:压缩方式
1 字节:过滤方式
1 字节:隔行方式
所以我们宽度确实是0x3C0,即960,但是高度不是,改成0x3C0即可
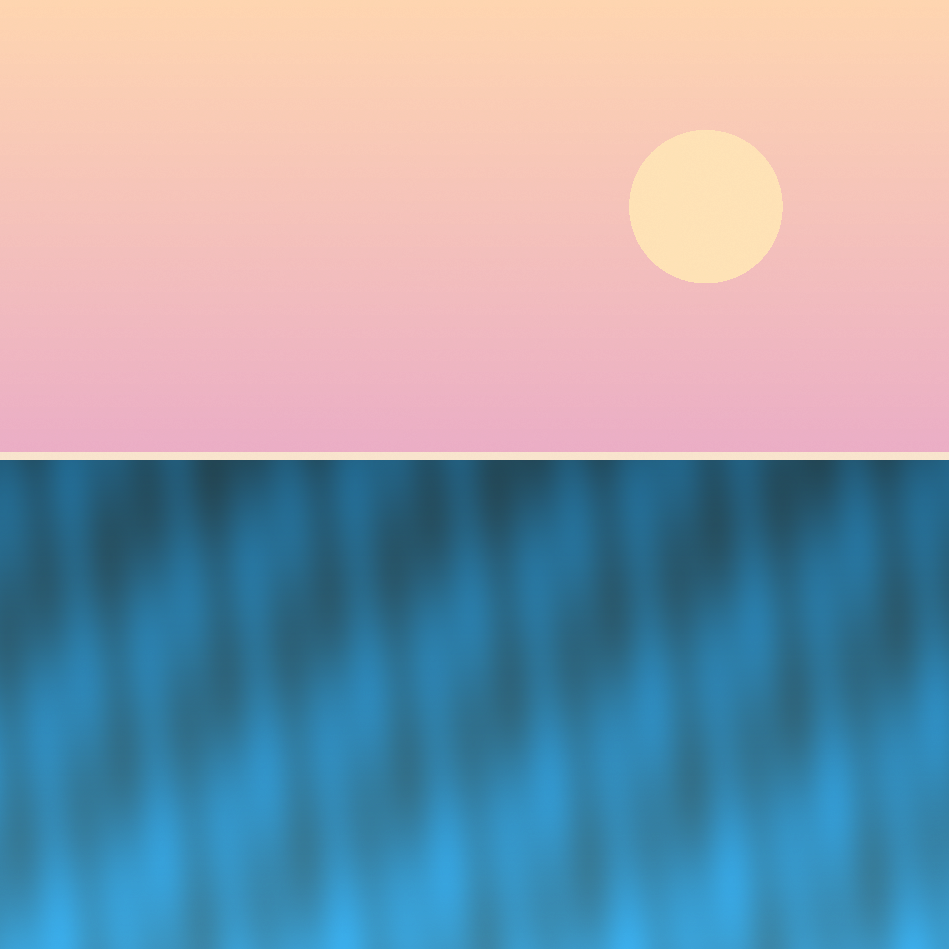
即可得到上图
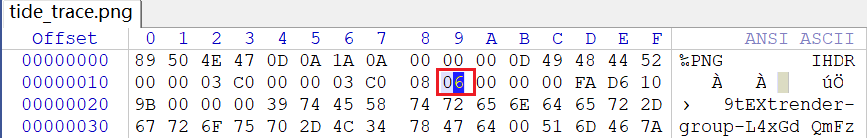
接着又发现这图的颜色类型为6
0:灰度
2:RGB 真彩色
3:索引颜色
4:灰度 + Alpha
6:RGB + Alpha
所以本题是RGBA图片,出题人多放个Alpha肯定不会瞎放,我们查一下
from PIL import Image
import numpy as np

a = np.array(Image.open("tide_trace.png").convert("RGBA"))[:, :, 3]
v, n = np.unique(a, return_counts=True)

for x, y in zip(v, n):
    print(x, y)
发现确实不干净,alpha通道有255和254两种,只有最低像素位不一样,一个是1一个是0,明显存在LSB隐写
但是是对半分的,检查一下RGB的最低位好像都是差不多对半分的
说明不是直接存的,是某种关系,最常见的就是异或了,我们可以试一下,一共也没几种
channels = {
    "R": rgba[:, :, 0] & 1,
    "G": rgba[:, :, 1] & 1,
    "B": rgba[:, :, 2] & 1,
    "A": rgba[:, :, 3] & 1,
}
names = list(channels)
for i in range(len(names)):
    for j in range(i + 1, len(names)):
        name1 = names[i]
        name2 = names[j]

        result = channels[name1] ^ channels[name2]
        print(
            name1,
            name2,
            result.mean()
        )
发现只有green通道和alpha通道异或存在明显的异常值,只有7.11%的位置不同,很不自然
想到直接异或生图看看
from PIL import Image
import numpy as np

p = np.array(Image.open("tide_trace.png").convert("RGBA"))
x = ((p[:, :, 3] & 1) ^ (p[:, :, 1] & 1)) * 255
Image.fromarray(x.astype("uint8")).save("xor.png")
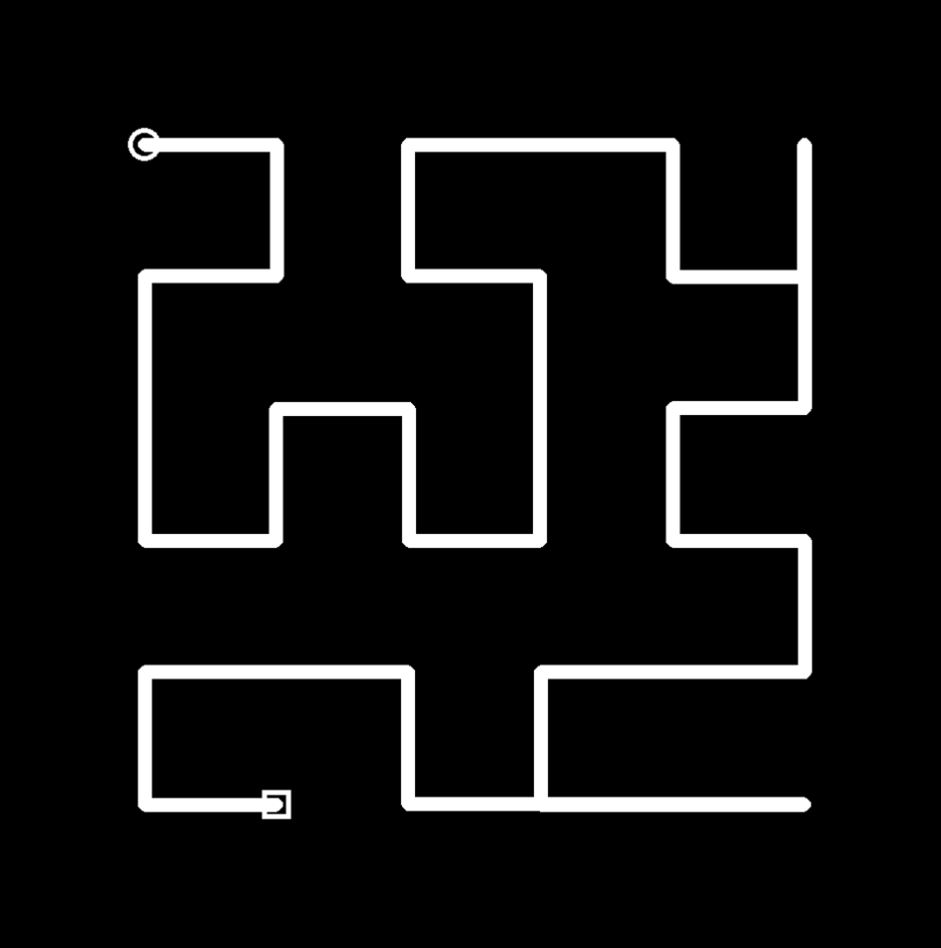
明显是一张路线图,还有起点终点
我们按这个路线,走一遍刚刚拿到的6乘6字符表即可得到flag
flag{60a8d749-3760-4560-8bc7-86f2faa7754d}
失序货栈-HHB2026
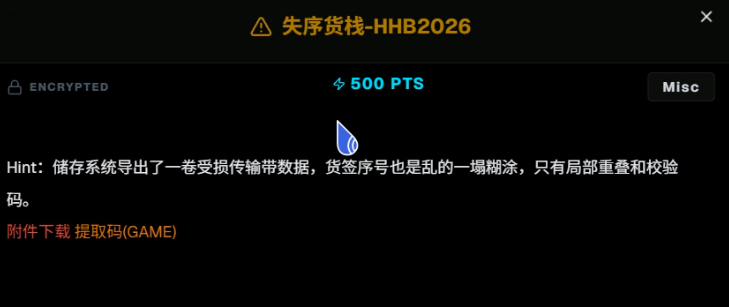
题目说是序号乱的一塌糊涂,但是说有局部重叠,还有校验码,猜测确实是提示
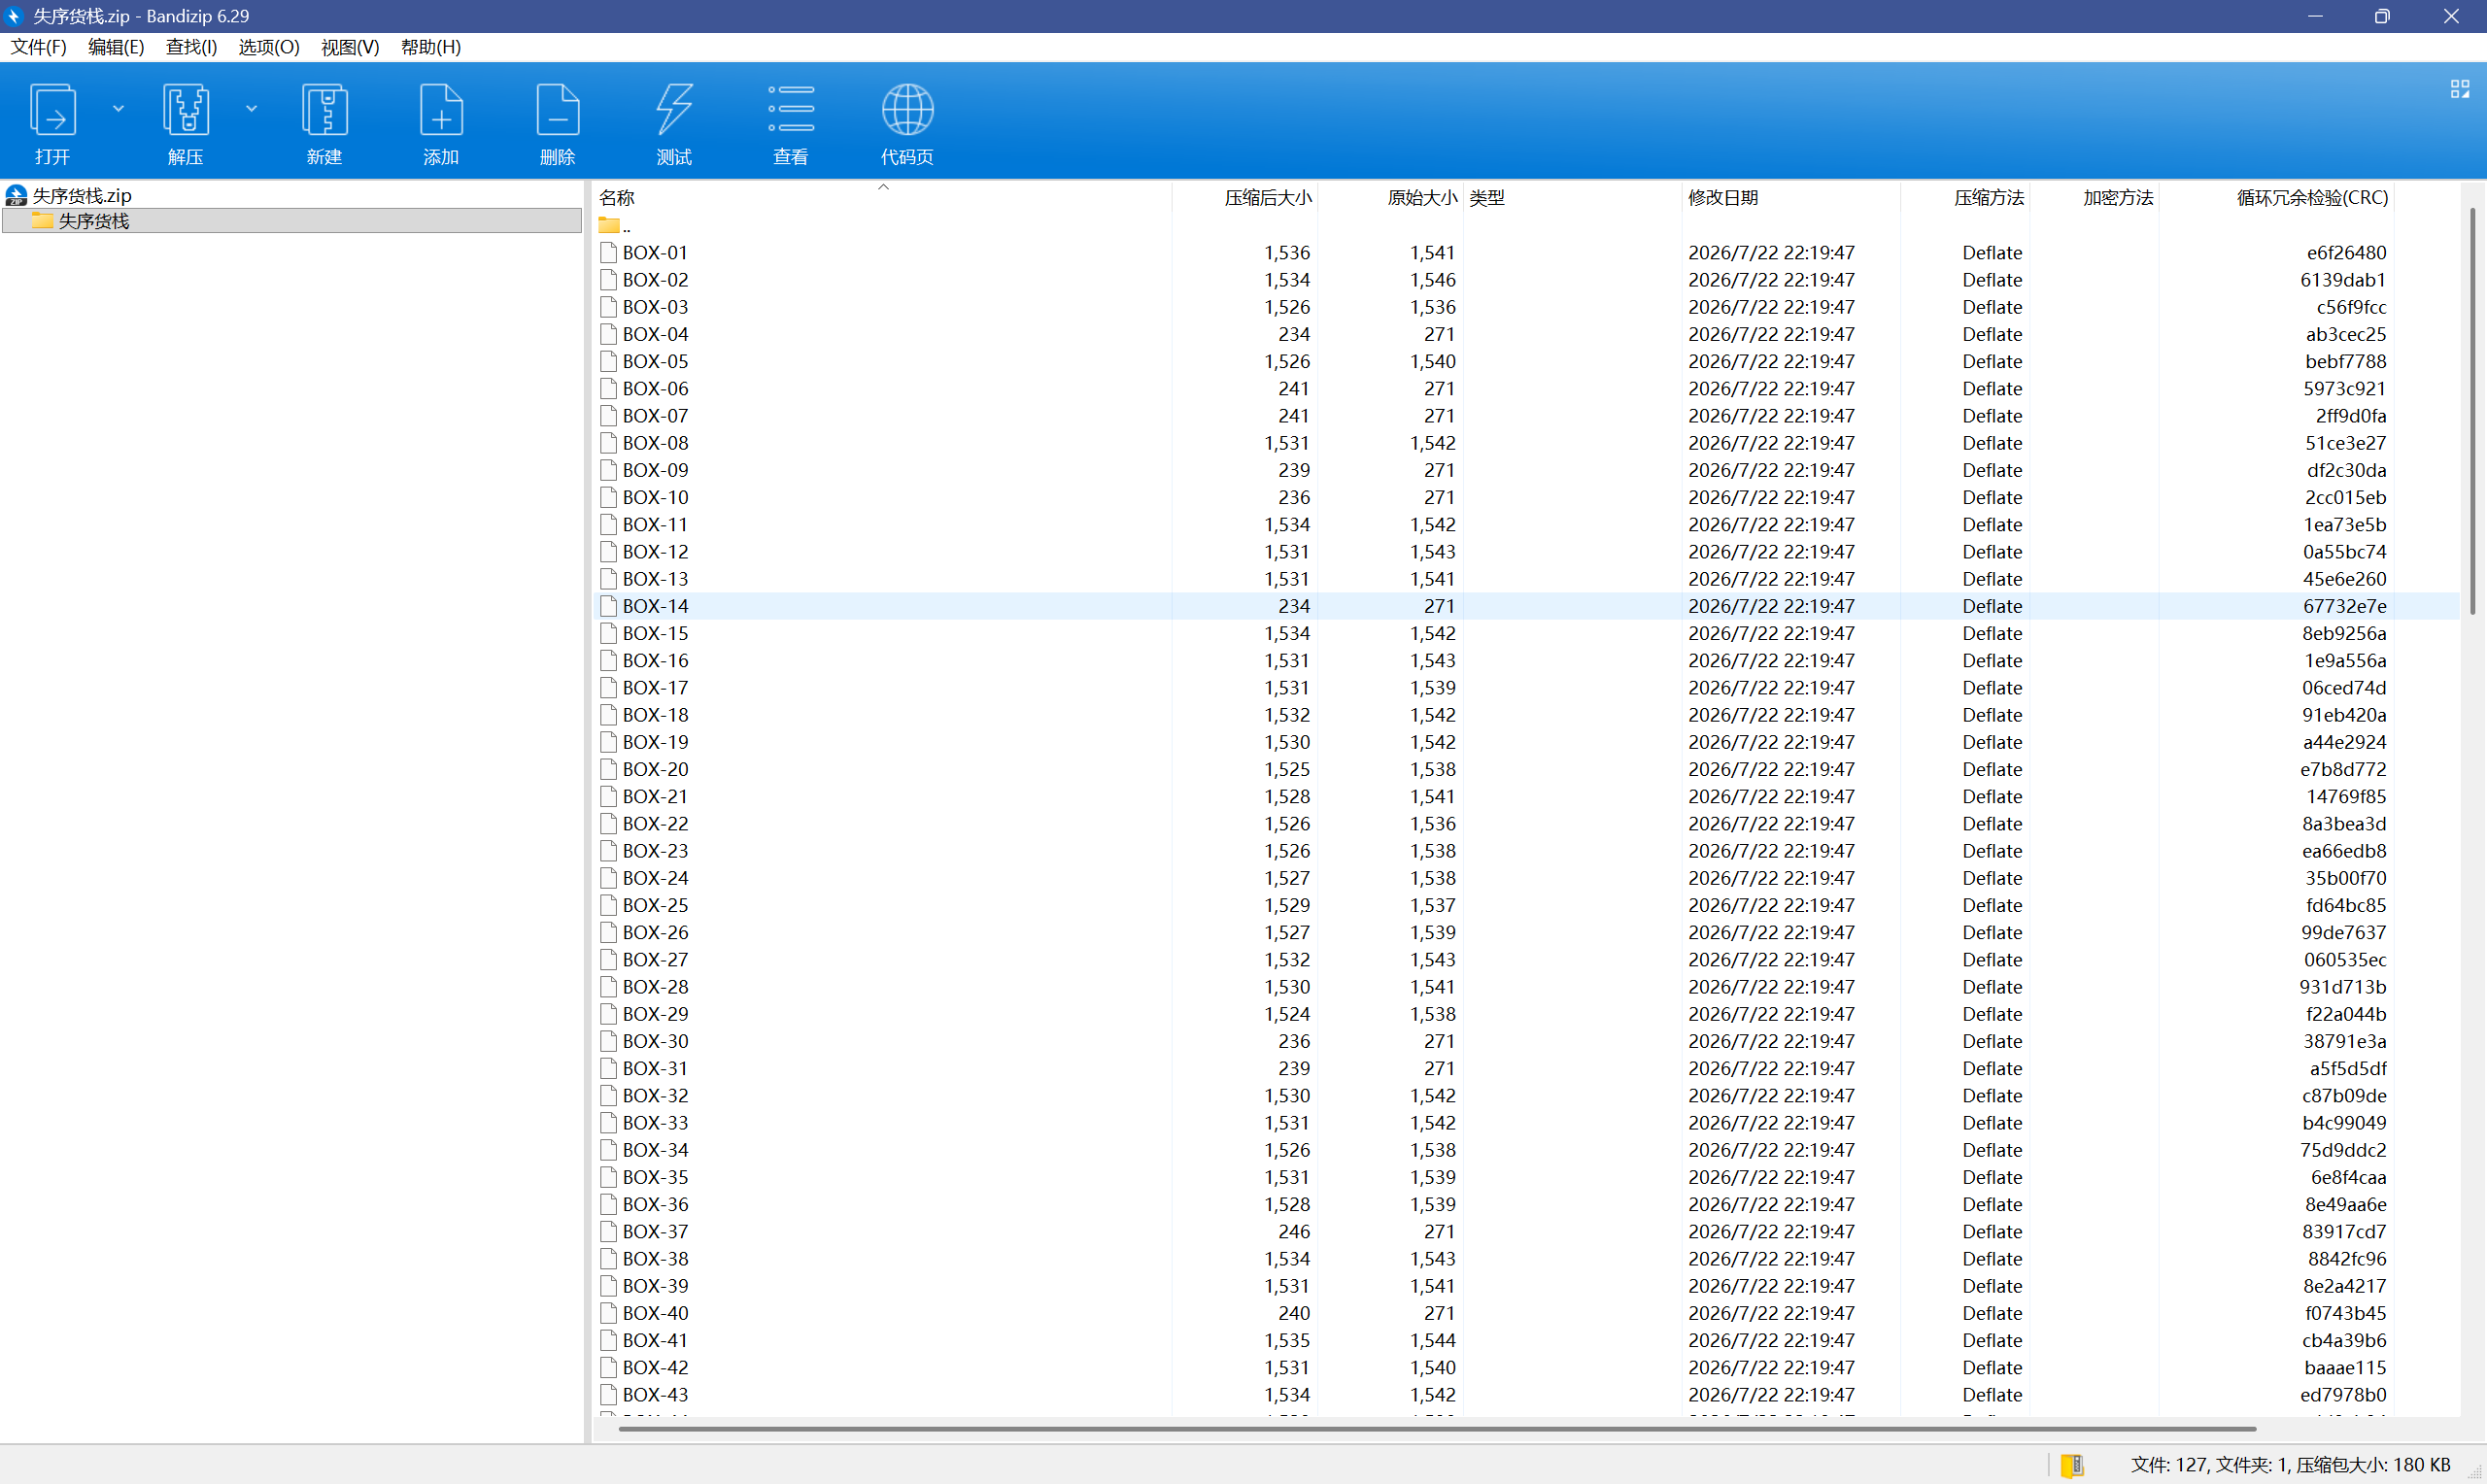
打开附件发现是一大堆的BOX,从BOX-01 到 BOX-127
但是发现题目里边的大小差的很多,有部分大小为271的文件,还有更多是大小在1540左右的文件
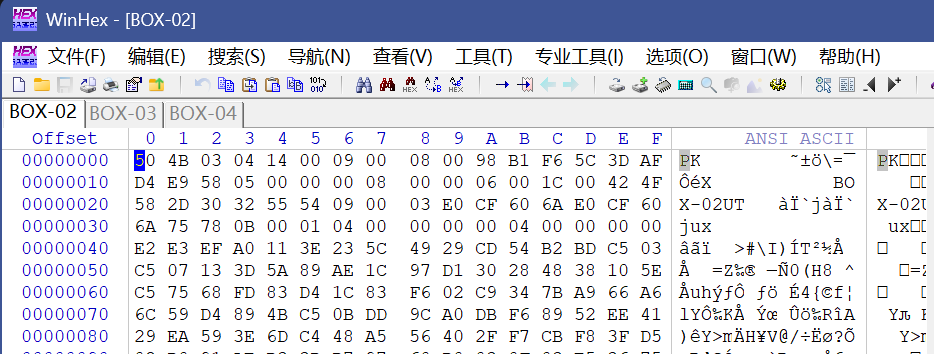
看了看,或者直接用file检查
file BOX-* | head -20
发现所有的文件本身都是Zip压缩包
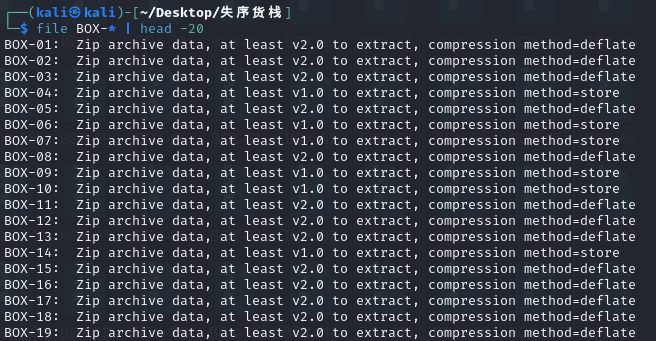
但是那些小的的存储方式不一样
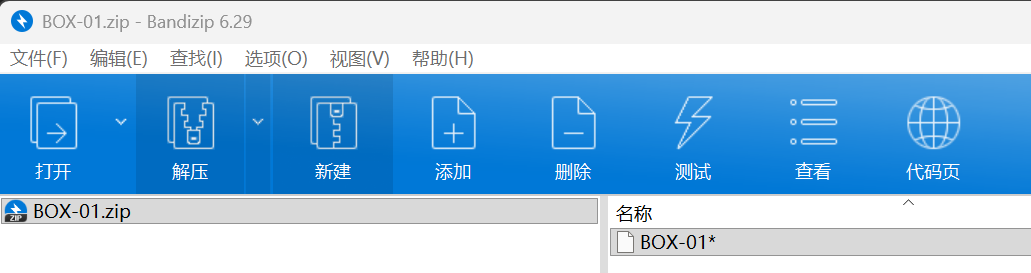
改后缀看看,发现所有这些附件里边都是一个同名的文件,不过加密了
尝试用编号可以轻松解密
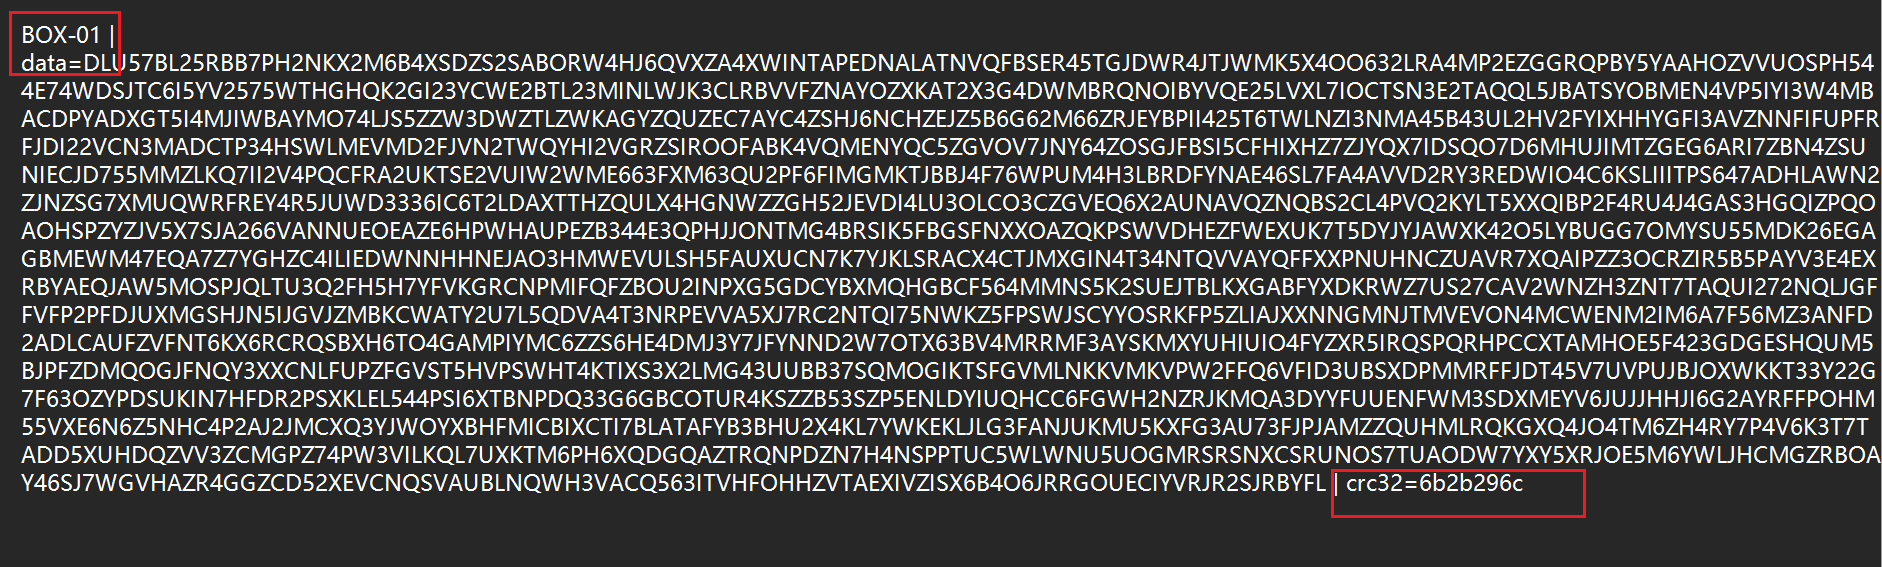
继续测试其他文件,可以确定密码都是编号
我们观察这个解密后的记录,不难发现里边就是三部分构成的
第一个是标签BOX-01
第二个是data,看这个样子像是Base32编码的内容
最后是crc32,但是01不行,我们继续尝试看看有没有能校验成功的

发现04的是对的上的,是对base32解码后内容的CRC32校验值
这个应该是重点,因为题目里强调了校验
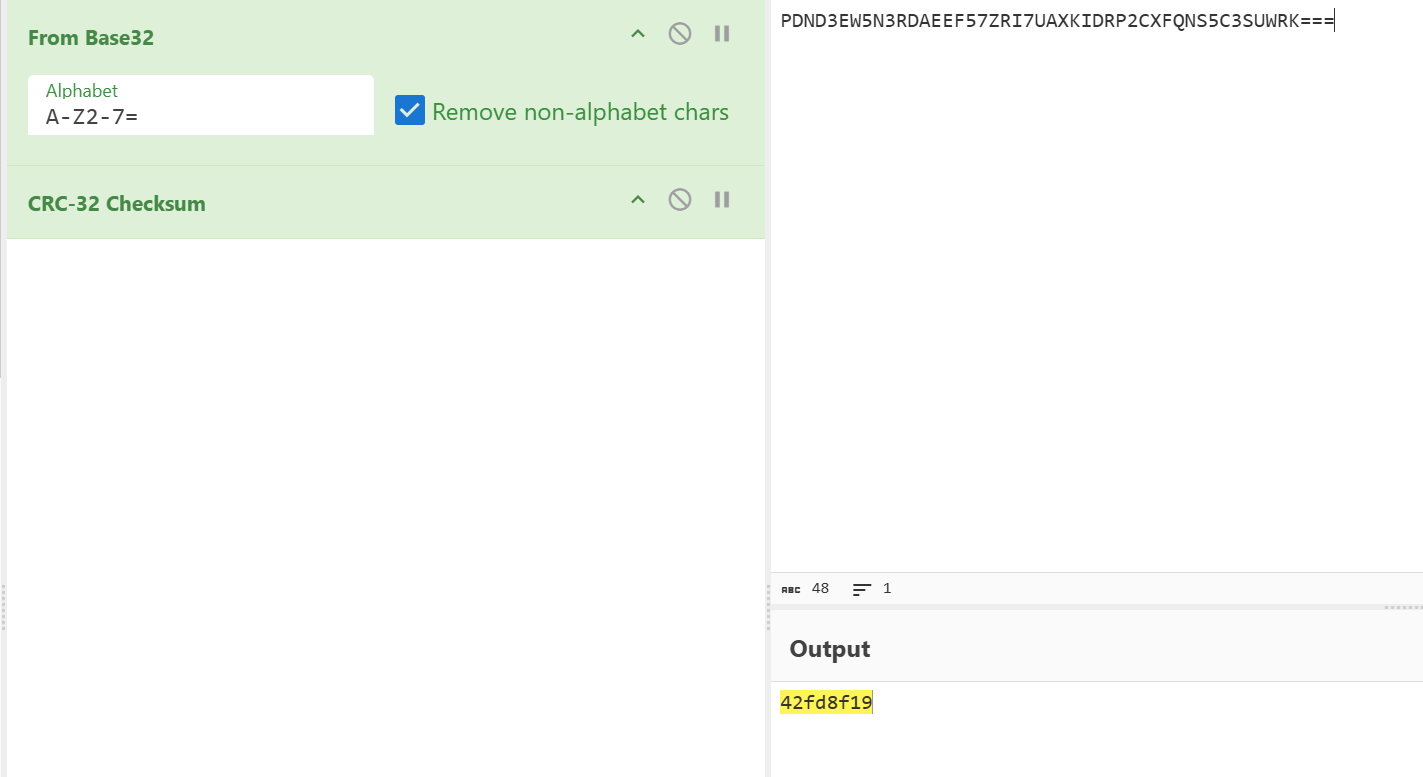
所以我们现在要对这些内容进行审查,看看哪些可以base 32解码,哪些可以crc校验正确
import base64
import binascii
import io
import re
import zipfile
import zlib
from pathlib import Path


# 匹配内层记录:
# BOX-04 | data=xxxx | crc32=12345678
pattern = re.compile(
    rb"^(BOX-\d+) "
    rb"\| data=([A-Z2-7=]+) "
    rb"\| crc32=([0-9a-fA-F]{8})"
    rb"(?:\r?\n)?$"
)


def box_number(filename: str) -> int | None:
    """
    从 BOX-04 中提取数字 4,
    用于按照编号排序。
    """
    match = re.fullmatch(r"BOX-(\d+)", filename)
    if not match:
        return None
    return int(match.group(1))


outer_path = Path("失序货栈.zip")

# 记录统计结果
total = 0
crc_ok_count = 0
crc_bad_count = 0
base32_error_count = 0
format_error_count = 0
decrypt_error_count = 0

crc_ok_boxes = []
crc_bad_boxes = []
base32_error_boxes = []

with zipfile.ZipFile(outer_path, "r") as outer_zip:
    # 取出所有 BOX-* 文件
    box_files = []
    for info in outer_zip.infolist():
        filename = Path(info.filename).name
        if info.is_dir():
            continue
        num = box_number(filename)
        if num is None:
            continue
        box_files.append((num, filename, info))

    # 按货箱编号排序,仅为了输出更规整
    box_files.sort(key=lambda item: item[0])

    for _, filename, info in box_files:
        total += 1

        # BOX-04 的内层 ZIP 密码为 04
        password = filename.split("-", 1)[1].encode("ascii")

        try:
            # 从外层 ZIP 中读取 BOX 文件
            inner_zip_data = outer_zip.read(info)

            # BOX 文件本身又是一个 ZIP
            with zipfile.ZipFile(io.BytesIO(inner_zip_data), "r") as inner_zip:
                # 内层通常只有一个文件
                members = [
                    member
                    for member in inner_zip.infolist()
                    if not member.is_dir()
                ]
                if not members:
                    print(f"[FORMAT ERROR] {filename}: 内层 ZIP 为空")
                    format_error_count += 1
                    continue

                member = members[0]
                # 使用货箱编号作为密码解密
                raw = inner_zip.read(member, pwd=password)

        except Exception as error:
            print(f"[DECRYPT ERROR] {filename}: {error}")
            decrypt_error_count += 1
            continue

        # 解析内层文本记录
        match = pattern.fullmatch(raw)
        if not match:
            print(f"[FORMAT ERROR] {filename}: 记录格式无法匹配")
            format_error_count += 1
            continue

        label, encoded, crc_hex = match.groups()
        label = label.decode("ascii")

        # 将文本形式的十六进制 CRC 转换成整数
        expected_crc = int(crc_hex, 16)

        try:
            # Base32 解码,得到真正参与 CRC 计算的原始字节
            decoded_data = base64.b32decode(encoded)
        except binascii.Error as error:
            print(
                f"[BASE32 ERROR] {filename:<7} "
                f"encoded_len={len(encoded):4d} "
                f"error={error}"
            )
            base32_error_count += 1
            base32_error_boxes.append(filename)
            continue

        # 计算解码后原始字节的 CRC32
        actual_crc = zlib.crc32(decoded_data) & 0xFFFFFFFF

        # 对比实际 CRC 和记录中给出的 CRC
        if actual_crc == expected_crc:
            status = "CRC OK"
            crc_ok_count += 1
            crc_ok_boxes.append(filename)
        else:
            status = "CRC BAD"
            crc_bad_count += 1
            crc_bad_boxes.append(filename)

        print(
            f"[{status:<7}] "
            f"{filename:<7} "
            f"encoded_len={len(encoded):4d} "
            f"data_len={len(decoded_data):4d} "
            f"expected={expected_crc:08x} "
            f"actual={actual_crc:08x}"
        )


# ==============================
# 汇总输出(按编号排序后展示)
# ==============================
crc_bad_boxes.sort(key=box_number)
base32_error_boxes.sort(key=box_number)

print()
print("=" * 70)
print("全部货箱校验完成")
print("=" * 70)
print(f"BOX 文件总数:   {total}")
print(f"CRC 校验正确:   {crc_ok_count}")
print(f"CRC 校验错误:   {crc_bad_count}")
print(f"Base32 解码失败: {base32_error_count}")
print(f"记录格式错误:   {format_error_count}")
print(f"内层解密失败:   {decrypt_error_count}")

if crc_bad_boxes:
    print()
    print("CRC 校验错误的货箱:")
    for filename in crc_bad_boxes:
        print(f"  {filename}")

if base32_error_boxes:
    print()
    print("Base32 解码失败的货箱:")
    for filename in base32_error_boxes:
        print(f"  {filename}")
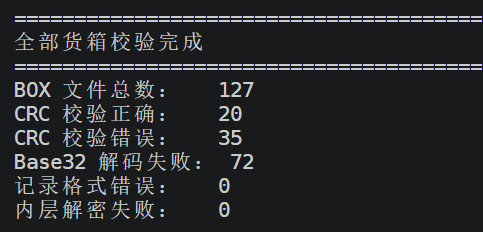
校验发现了有72条连Base32都过不了
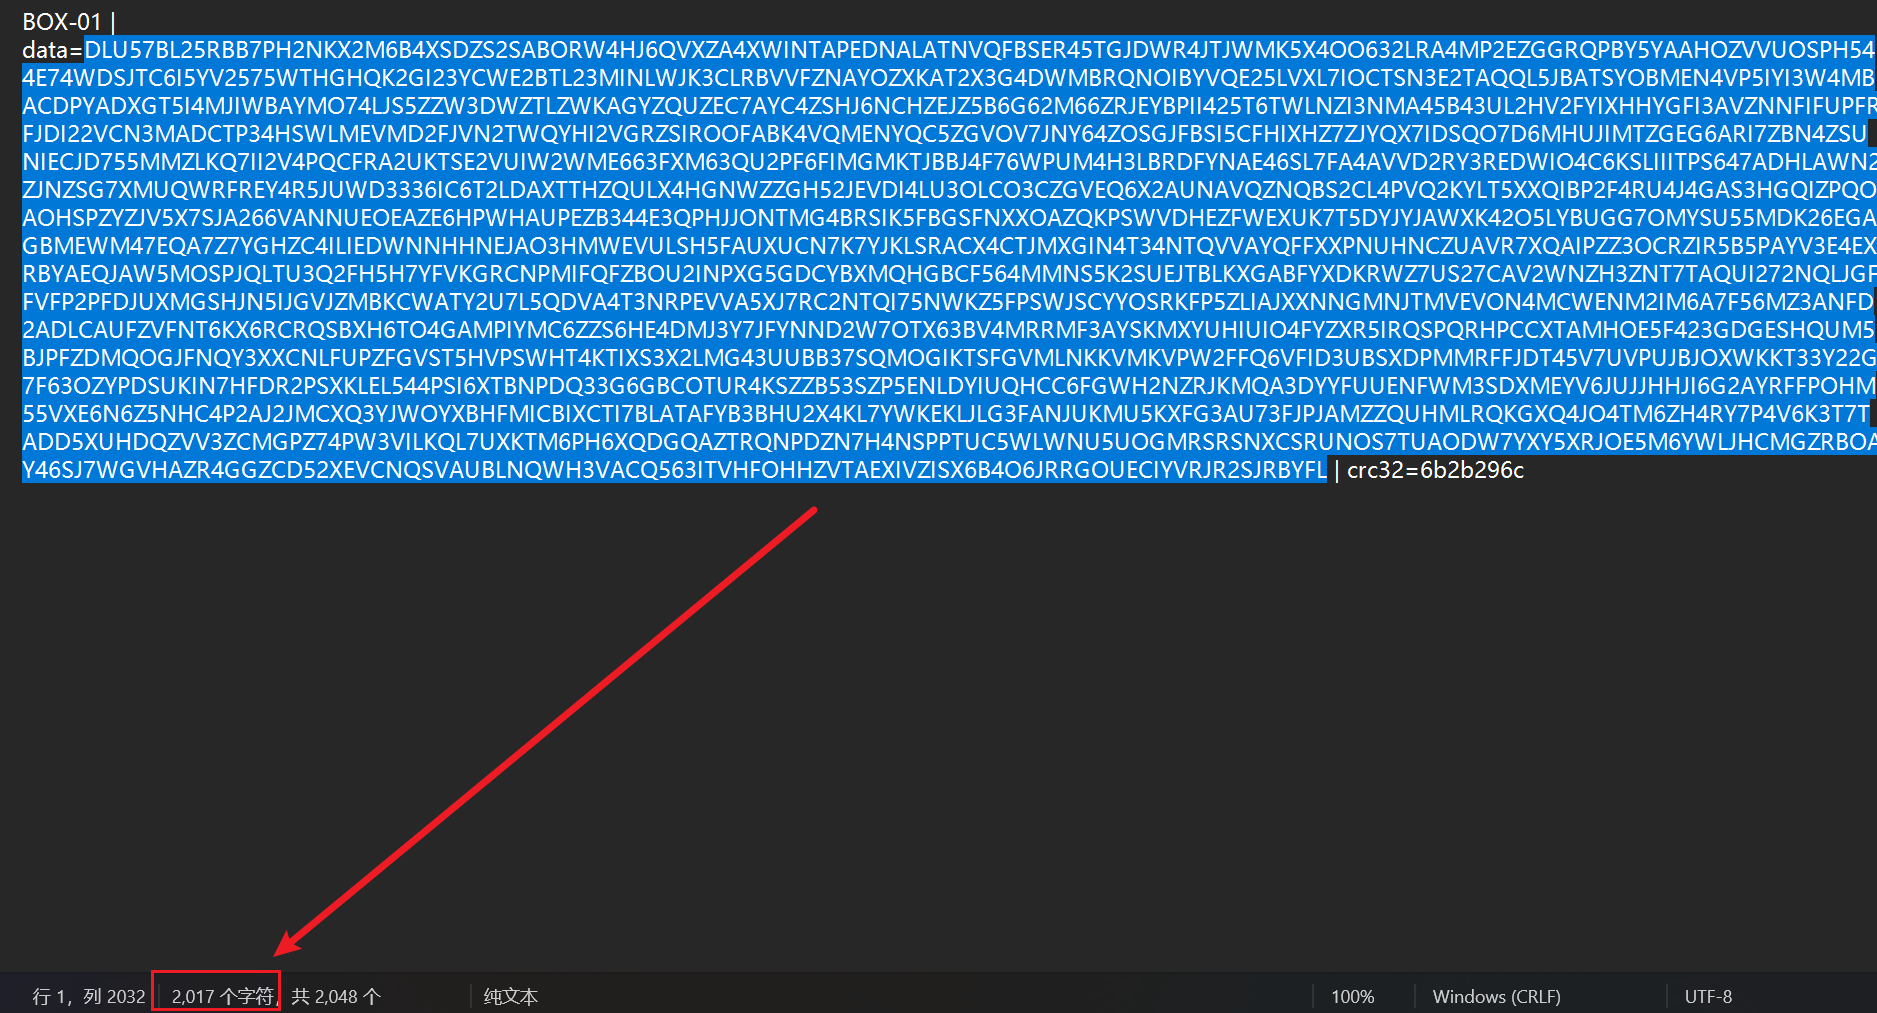
仔细看看,发现他们是Base32长度都是2017
我们知道Base32是每8个字符表示的一组编码数据
所以被8取余是1,3,6的无法被合法Base32解码,因此这72条不行,而且值得注意的是这些都是长的,记得我们刚开始就发现有五分之一在271左右,另外五分之四明显大,现在这明显大的要么crc检验过不了,要么干脆Base 32都失败
很有可能是干扰项啊,我们先将他们排除,看看剩下的
剩下了27条短数据,有7个crc32错误的
BOX-10
BOX-14
BOX-30
BOX-72
BOX-77
BOX-88
BOX-93
由于题目说我们有正确的crc32,所以我们其实可以尝试crc32来修复
说是修复,其实算爆破才是
我们知道CRC32是这样子得到的
import zlib

crc = zlib.crc32(data) & 0xFFFFFFFF
print(f"{crc:08x}")
所以我们可以对原来的进行爆破看看能不能改后和crc32一样,一样就是改对了,从而修复
那注意这边我们单字节修复和多字节修复的代价是完全不一样的,因为本质是爆破
所以如果是单字节修复,那么每个位置每个字节有256个值,也就×255种而已,但是如果是两个字节就要指数级上升了,几千万几亿次这样子,所以我们这边只考虑先拿crc32去爆破修复单字节
import base64
import re
import zipfile
import zlib
from pathlib import Path


BAD_BOXES = [
    "BOX-10",
    "BOX-14",
    "BOX-30",
    "BOX-72",
    "BOX-77",
    "BOX-88",
    "BOX-93",
]

PATTERN = re.compile(
    rb"^(BOX-\d+) \| data=([A-Z2-7=]+) \| crc32=([0-9a-f]{8})\r?\n?$"
)

OUTPUT = Path("repaired_records")
OUTPUT.mkdir(exist_ok=True)


def read_box(name):
    """解密 BOX 文件,并返回解码后的数据和目标 CRC。"""
    password = name.split("-")[1].encode()

    with zipfile.ZipFile(name) as z:
        member = z.namelist()[0]
        raw = z.read(member, pwd=password)

    label, encoded, crc_hex = PATTERN.fullmatch(raw).groups()

    return {
        "name": label.decode(),
        "data": bytearray(base64.b32decode(encoded)),
        "crc": int(crc_hex, 16),
    }


def crc_ok(box):
    return (
        zlib.crc32(box["data"]) & 0xFFFFFFFF
    ) == box["crc"]


def repair_one_byte(box):
    """穷举修复一个错误字节。"""
    data = box["data"]

    for pos in range(len(data)):
        old = data[pos]

        for new in range(256):
            if new == old:
                continue

            data[pos] = new

            if crc_ok(box):
                print(
                    f"[修复] {box['name']}: "
                    f"offset={pos}, {old:02x} -> {new:02x}"
                )
                return True

        data[pos] = old

    return False


def save_box(box):
    encoded = base64.b32encode(box["data"])

    record = (
        f"{box['name']} | data=".encode()
        + encoded
        + f" | crc32={box['crc']:08x}\n".encode()
    )

    path = OUTPUT / f"{box['name']}.txt"
    path.write_bytes(record)

    print(f"[保存] {path}")

boxes = {
    name: read_box(name)
    for name in BAD_BOXES
}

for name in BAD_BOXES:

    box = boxes[name]

    if not repair_one_byte(box):
        print(f"[失败] {name} 没有找到单字节修复方案")

for box in boxes.values():
    if crc_ok(box):
        save_box(box)
    else:
        print(f"[未保存] {box['name']} CRC 错误")
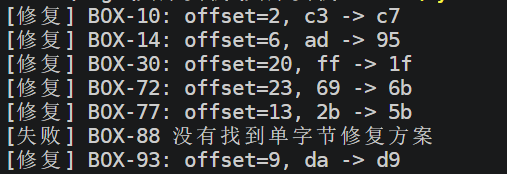
得到了6个BOX的修复方案,但是88没有,说明88至少也是坏了2个字节
试试看爆破2字节修复
import base64
import re
import zipfile
import zlib


PATTERN = re.compile(
    rb"^(BOX-\d+) \| data=([A-Z2-7=]+) "
    rb"\| crc32=([0-9a-fA-F]{8})\r?\n?$"
)


def read_box(name):
    password = name.split("-")[1].encode()

    with zipfile.ZipFile(name) as z:
        member = z.namelist()[0]
        raw = z.read(member, pwd=password)

    label, encoded, crc_hex = PATTERN.fullmatch(raw).groups()

    return (
        label.decode(),
        bytearray(base64.b32decode(encoded)),
        int(crc_hex, 16),
    )


name, data, expected_crc = read_box("BOX-88")

print(f"数据长度:{len(data)}")
print(f"目标 CRC:{expected_crc:08x}")
print(
    f"当前 CRC:"
    f"{zlib.crc32(data) & 0xffffffff:08x}"
)

found = None

for pos1 in range(len(data)):
    old1 = data[pos1]

    for pos2 in range(pos1 + 1, len(data)):
        old2 = data[pos2]

        for new1 in range(256):
            if new1 == old1:
                continue

            data[pos1] = new1

            for new2 in range(256):
                if new2 == old2:
                    continue

                data[pos2] = new2

                actual_crc = (
                    zlib.crc32(data)
                    & 0xffffffff
                )

                if actual_crc == expected_crc:
                    found = (
                        pos1, old1, new1,
                        pos2, old2, new2,
                    )
                    break

            if found:
                break

            # 当前第二个位置测试完后恢复
            data[pos2] = old2

        if found:
            break

        data[pos1] = old1
        data[pos2] = old2

    if found:
        break


if found:
    pos1, old1, new1, pos2, old2, new2 = found

    print("\n找到双字节修复方案:")
    print(
        f"位置 {pos1}: "
        f"{old1:02x} -> {new1:02x}"
    )
    print(
        f"位置 {pos2}: "
        f"{old2:02x} -> {new2:02x}"
    )
    print(
        f"修复后 CRC:"
        f"{zlib.crc32(data) & 0xffffffff:08x}"
    )

    encoded = base64.b32encode(data)

    repaired = (
        f"{name} | data=".encode()
        + encoded
        + f" | crc32={expected_crc:08x}\n".encode()
    )

    with open("BOX-88-repaired.txt", "wb") as f:
        f.write(repaired)

    print("已保存:BOX-88-repaired.txt")

else:
    print("没有找到双字节修复方案")
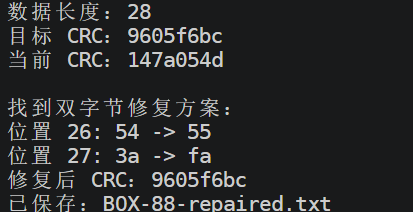
成功修复,于是我们修好了27个BOX
之后就是找顺序了,我们修好了肯定是要合起来的,题目这边给了提示
说是有局部重叠的,我们就看看有多少重叠的,对所有片段两两比较,测试不同的重叠长度
import base64
import re
import zlib
from pathlib import Path


# 脚本所在目录
SCRIPT_DIR = Path(__file__).resolve().parent

# 27 个片段所在目录
FRAGMENT_DIR = SCRIPT_DIR / "repaired_records"

# 测试 1~20 字节重叠
MIN_OVERLAP = 1
MAX_OVERLAP = 20

# 内层记录格式:
# BOX-04 | data=XXXX | crc32=12345678
PATTERN = re.compile(
    rb"^(BOX-\d+) "
    rb"\| data=([A-Z2-7=]+) "
    rb"\| crc32=([0-9a-fA-F]{8})"
    rb"(?:\r?\n)?$"
)


def box_number(name):
    """用于按照 BOX 编号排序。"""
    return int(name.split("-")[1])


def load_fragments():
    """读取并 Base32 解码所有短片段。"""
    fragments = {}

    if not FRAGMENT_DIR.exists():
        print(f"[错误] 找不到目录:{FRAGMENT_DIR}")
        print("请把 27 个片段放入 repaired_records 目录。")
        return fragments

    paths = sorted(
        FRAGMENT_DIR.glob("BOX-*"),
        key=lambda path: box_number(path.stem)
    )

    for path in paths:
        if not path.is_file():
            continue

        raw = path.read_bytes()
        match = PATTERN.fullmatch(raw)

        if not match:
            print(f"[跳过] {path.name}: 记录格式不正确")
            continue

        label, encoded, crc_hex = match.groups()
        name = label.decode("ascii")
        expected_crc = int(crc_hex, 16)

        # 真正的短片段 Base32 长度为 48
        if len(encoded) != 48:
            print(
                f"[跳过] {name}: "
                f"Base32 长度为 {len(encoded)},不是短片段"
            )
            continue

        try:
            data = base64.b32decode(encoded)
        except Exception as error:
            print(f"[跳过] {name}: Base32 解码失败:{error}")
            continue

        # 真正的片段解码后为 28 或 29 字节
        if len(data) not in (28, 29):
            print(
                f"[跳过] {name}: "
                f"解码后长度为 {len(data)}"
            )
            continue

        actual_crc = zlib.crc32(data) & 0xFFFFFFFF
        crc_status = actual_crc == expected_crc

        fragments[name] = {
            "data": data,
            "expected_crc": expected_crc,
            "actual_crc": actual_crc,
            "crc_ok": crc_status
        }

        status = "CRC OK" if crc_status else "CRC BAD"

        print(
            f"[读取] {name:<7} "
            f"长度={len(data):2d} "
            f"{status:<7} "
            f"expected={expected_crc:08x} "
            f"actual={actual_crc:08x}"
        )

    return fragments


def find_exact_matches(fragments, overlap):
    """
    两两比较全部片段。

    如果 left 的最后 overlap 字节等于
    right 的前 overlap 字节,则记录 left -> right。
    """
    matches = []

    for left_name, left in fragments.items():
        for right_name, right in fragments.items():
            if left_name == right_name:
                continue

            left_tail = left["data"][-overlap:]
            right_head = right["data"][:overlap]

            if left_tail == right_head:
                matches.append((left_name, right_name))

    return matches


def build_chain(fragments, matches):
    """
    根据匹配关系尝试构建唯一完整链。

    完整的 27 个片段应该有:
    - 26 条连接;
    - 1 个起点;
    - 1 个终点;
    - 每个中间片段只有一个前驱和一个后继。
    """
    names = set(fragments)

    successor = {}
    predecessor = {}

    for left, right in matches:
        # 一个片段有多个后继,不能唯一排序
        if left in successor and successor[left] != right:
            return None

        # 一个片段有多个前驱,不能唯一排序
        if right in predecessor and predecessor[right] != left:
            return None

        successor[left] = right
        predecessor[right] = left

    # 找到没有前驱的片段
    starts = [
        name
        for name in names
        if name not in predecessor
    ]

    if len(starts) != 1:
        return None

    chain = []
    visited = set()
    current = starts[0]

    while True:
        if current in visited:
            # 出现环
            return None

        chain.append(current)
        visited.add(current)

        if current not in successor:
            break

        current = successor[current]

    # 必须刚好包含所有片段
    if len(chain) != len(names):
        return None

    return chain


def print_matches(matches):
    """打印具体匹配关系。"""
    for left, right in sorted(
        matches,
        key=lambda item: box_number(item[0])
    ):
        print(f"  {left} -> {right}")


def main():
    fragments = load_fragments()

    print()
    print("=" * 70)
    print(f"共读取到 {len(fragments)} 个短片段")
    print("=" * 70)

    if not fragments:
        return

    if len(fragments) != 27:
        print(
            f"[警告] 正常情况下应有 27 个片段,"
            f"当前只有 {len(fragments)} 个。"
        )

    bad_crc = [
        name
        for name, fragment in fragments.items()
        if not fragment["crc_ok"]
    ]

    if bad_crc:
        print()
        print("CRC32 未通过的片段:")
        print("、".join(sorted(bad_crc, key=box_number)))
    else:
        print()
        print("全部片段 CRC32 校验通过。")

    print()
    print("开始测试不同的重叠长度:")
    print()

    valid_results = []
    all_results = []

    max_possible = min(
        MAX_OVERLAP,
        min(len(item["data"]) for item in fragments.values())
    )

    for overlap in range(MIN_OVERLAP, max_possible + 1):
        matches = find_exact_matches(fragments, overlap)
        chain = build_chain(fragments, matches)

        all_results.append(
            {
                "overlap": overlap,
                "matches": matches,
                "chain": chain
            }
        )

        if chain:
            status = "可以组成完整链"
            valid_results.append(
                (overlap, matches, chain)
            )
        else:
            status = "不能组成完整链"

        print(
            f"重叠长度 {overlap:2d} 字节:"
            f"{len(matches):2d} 条精确匹配,"
            f"{status}"
        )

    print()
    print("=" * 70)

    if valid_results:
        # 选择能够组成完整链的最大重叠长度
        best_overlap, best_matches, best_chain = max(
            valid_results,
            key=lambda item: item[0]
        )

        print(f"确定重叠长度:{best_overlap} 字节")
        print(f"匹配关系数量:{len(best_matches)}")

        print()
        print("具体匹配关系:")
        print_matches(best_matches)

        print()
        print("恢复出的完整顺序:")
        print(" -> ".join(best_chain))

    else:
        print("没有任何重叠长度能够组成完整链。")

        # 没有完整链时,显示匹配数量最多的结果
        best = max(
            all_results,
            key=lambda item: (
                len(item["matches"]),
                item["overlap"]
            )
        )

        print()
        print(
            f"匹配数量最多的是 {best['overlap']} 字节,"
            f"共有 {len(best['matches'])} 条匹配。"
        )

        print()
        print("具体匹配关系:")
        print_matches(best["matches"])

    print("=" * 70)


if __name__ == "__main__":
    main()
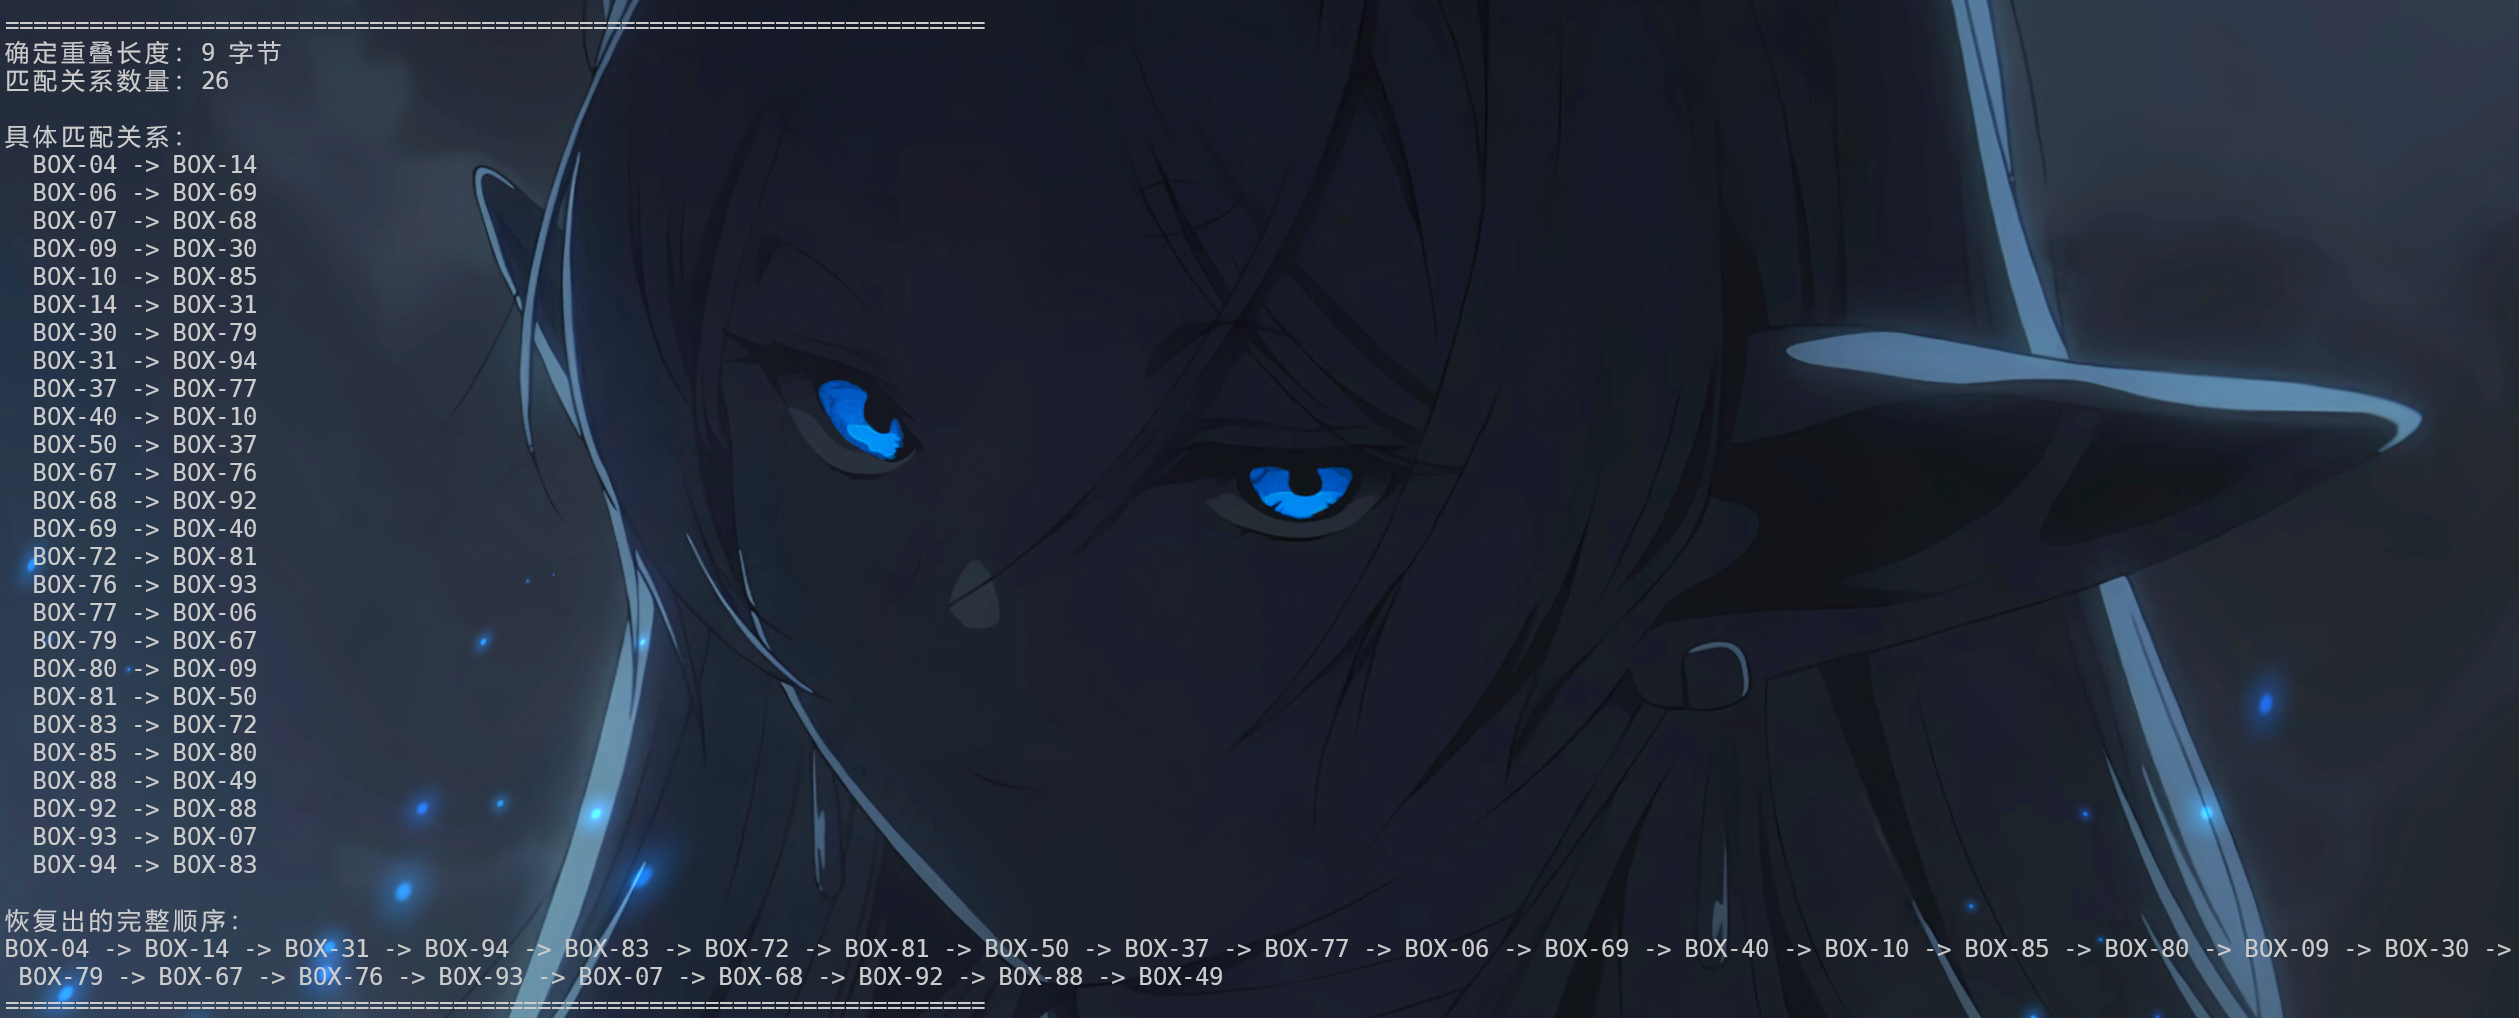
得到了最长重叠长度是9字节
所以其实我们前边的BOX-88如果是多字节crc损坏也不要紧,爆破不出的情况下也可以尝试直接利用重叠关系进行覆盖,只要大部分能和前边的对应上就能覆盖
left.data[-9:] == right.data[:9]
所以我们成功按照覆盖关系恢复出了BOX顺序
进行拼接即可
import base64
import re
from pathlib import Path

order = [
    "BOX-04", "BOX-14", "BOX-31", "BOX-94", "BOX-83", "BOX-72",
    "BOX-81", "BOX-50", "BOX-37", "BOX-77", "BOX-06", "BOX-69",
    "BOX-40", "BOX-10", "BOX-85", "BOX-80", "BOX-09", "BOX-30",
    "BOX-79", "BOX-67", "BOX-76", "BOX-93", "BOX-07", "BOX-68",
    "BOX-92", "BOX-88", "BOX-49"
]

folder = Path("repaired_records")
parts = []

for name in order:
    raw = (folder / f"{name}.txt").read_bytes()
    encoded = re.search(rb"data=([A-Z2-7=]+)", raw).group(1)
    parts.append(base64.b32decode(encoded))

stream = parts[0]

for left, right in zip(parts, parts[1:]):
    assert left[-9:] == right[:9], "重叠不匹配"
    stream += right[9:]

Path("stream.bin").write_bytes(stream)

print("拼接完成")
print("长度:", len(stream))
print("文件:stream.bin")
最终我们得到了一个长度为 523 字节的数据
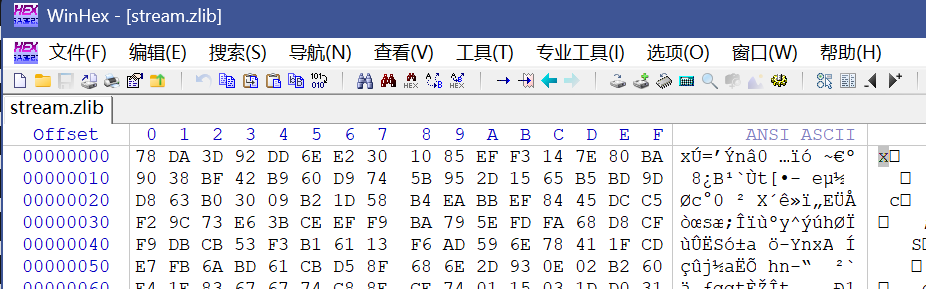
看看文件十六进制,发现文件头是78 da
这是常见的 zlib 压缩流头部
所以我们直接使用 zlib.decompress() 解压即可:
from pathlib import Path
import zlib

content = zlib.decompress(
    Path("stream.bin").read_bytes()
).decode()

print(content)
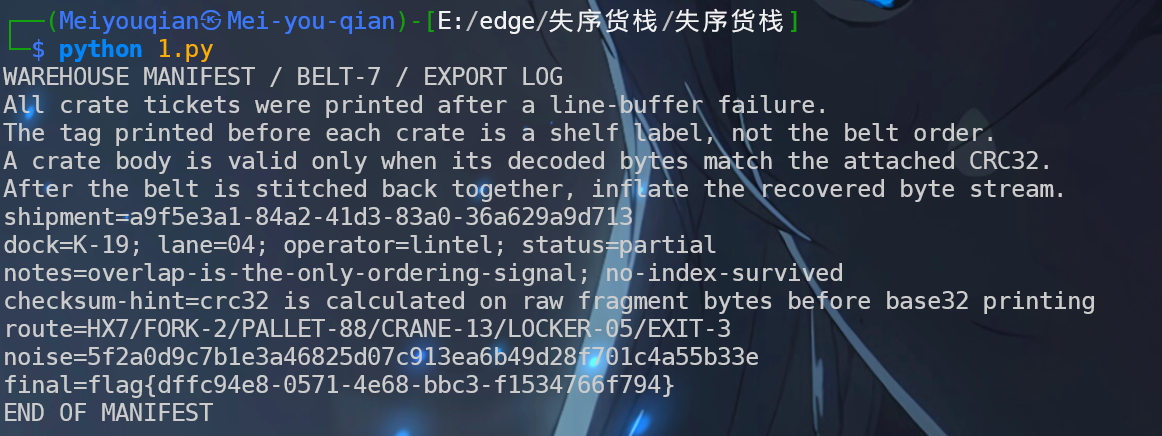
成功得到了这份传送带日志,备注也再一次重复了重叠内容是唯一能确定顺序的信号,原始索引已经全丢完了
同时得到了本题的flag
flag{dffc94e8-0571-4e68-bbc3-f1534766f794}
Frame by Frame-HHB2026
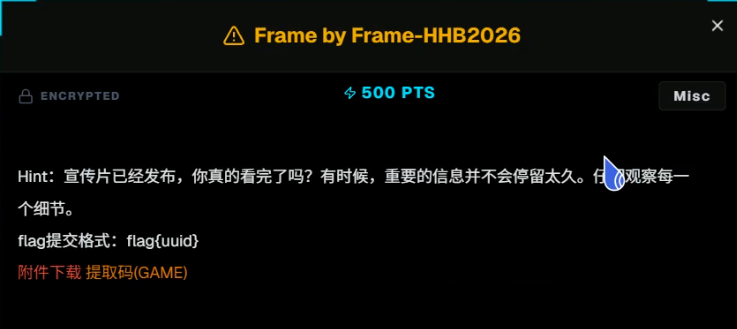
有想过是找原视频比对得到,但是找到了没比对出来
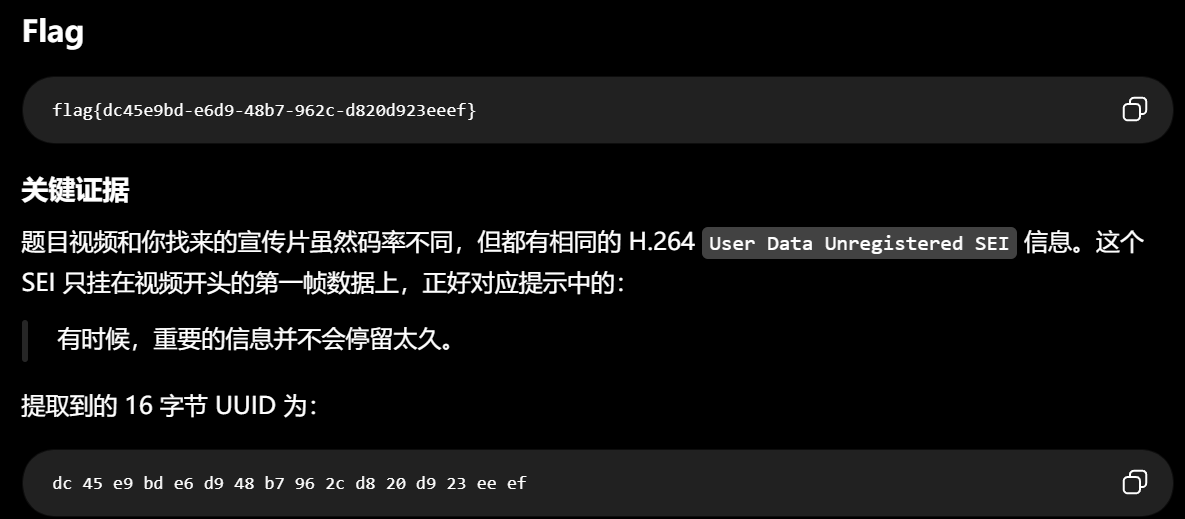
这个好像是错的
期待有做出来的师傅在评论区分享一下
问卷
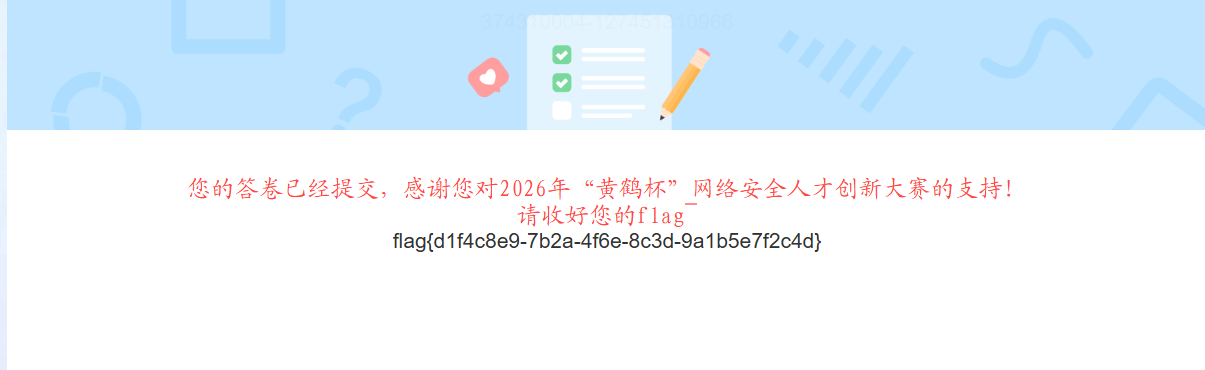
黄鹤杯初赛就到此为止了
flag{d1f4c8e9-7b2a-4f6e-8c3d-9a1b5e7f2c4d}
更多推荐

 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)