
最新面经!腾讯 + 快手数据开发一面真实考察重点有哪些?
最近复盘了一些同学的面试情况,发现很多校招同学都有一个通病:刷题无数,却抓不住大厂面试核心。
平时死记硬背知识点,一到面试现场,遇到实操类、排查类问题直接卡壳,尤其是Spark、Flink线上问题排查、SQL优化、Java底层原理,是大厂必考的拉分重点。
今天给大家整理了腾讯数据、腾讯软件开发-数据开发、快手数据开发一面完整真题,全部是真实校招面试原题,涵盖基础原理、线上问题排查、框架调优、项目深挖、手撕算法、AI工具实操六个核心内容。
1.腾讯数据开发一面
面试官主打考察Spark、Flink实操能力,几乎没有纯背诵送分题,重点考察线上问题排查、原理理解、业务场景落地,是数据开发的核心考核重点。
1.基础问答
-
自我介绍
-
日常工作中使用Hive还是Spark?对哪个更加了解?
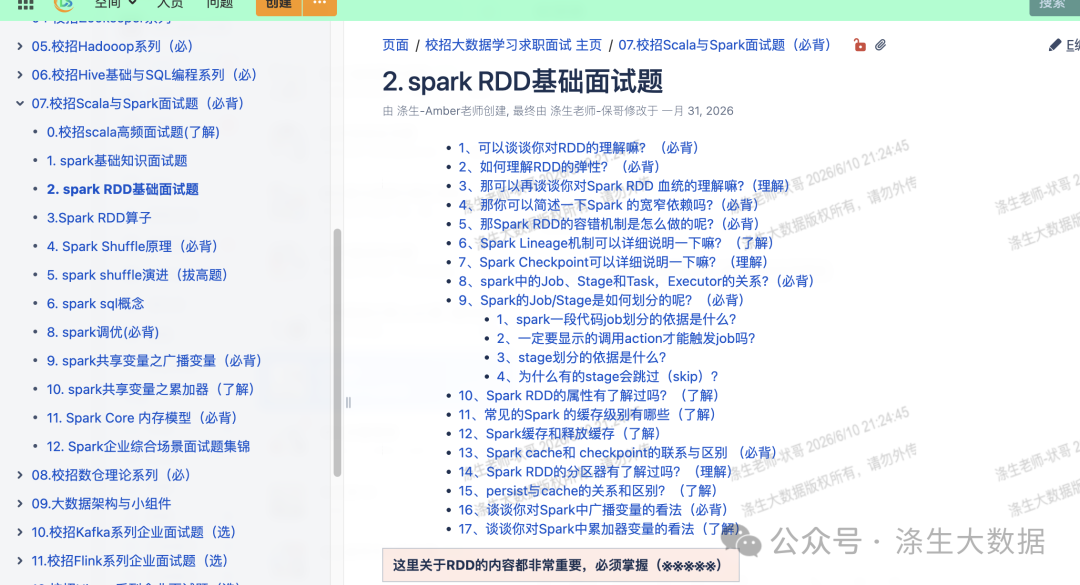
2.Spark 高频核心问题(重中之重)
-
简述Spark问题定位的完整流程,以及常见问题的解决方法
-
线上Spark任务运行很慢,如何一步步定位问题?
-
简述广播和Shuffle的区别,为什么Shuffle执行速度远慢于广播?
-
Shuffle将各节点数据传输到目标节点后,会执行哪些后续操作?
-
小文件导致Spark任务运行缓慢,具体影响Spark的哪个环节?
-
是否用过Hive二级分区?使用Spark写入Hive二级分区时,遇到过哪些问题?
-
常规业务SQL在Spark内部的完整运行流程是什么?
-
针对核心业务SQL,会从哪些维度做优化?
-
过往代码是否存在性能问题?如何优化改写?
3.Flink 场景化真题(业务理解)
-
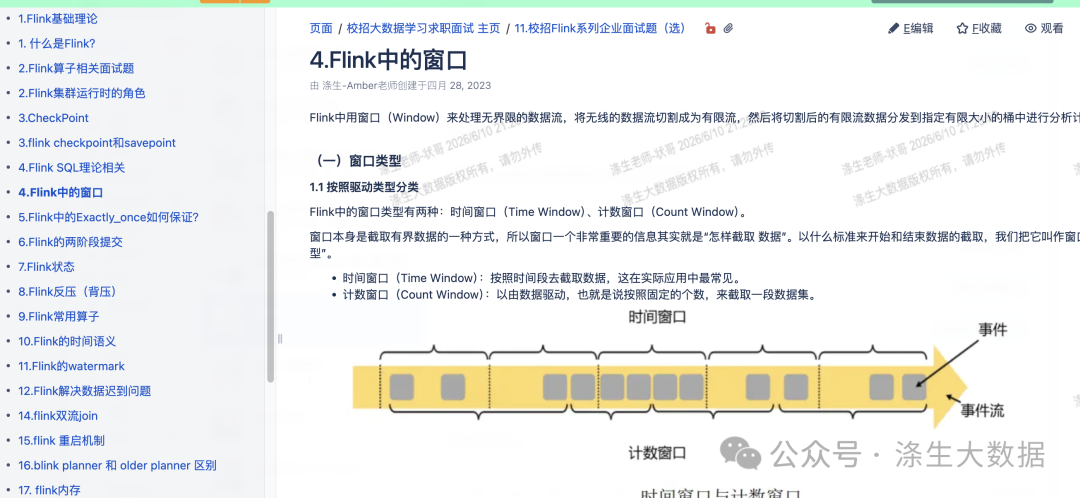
Flink滑动窗口场景:每5分钟统计过去一小时的用户行为流水,数据量100万条/分钟,如何预估窗口计算的输出数据量和整体计算量?
-
Flink任务基于Checkpoint重启,消费Kafka数据时,能否精准回溯到某一秒的时间点消费对应数据?
2.腾讯软件开发-数据开发一面
面试官考察的维度更全面,除了大数据框架,重点加考Java底层、MySQL事务、Zookeeper、Spark高阶调优(AQE),最后搭配手撕算法,是典型的大厂综合面试模式。
1.计算机基础
-
Mysql事务是什么?事务隔离机制有哪些?
-
Java多线程机制怎么实现?
-
线程安全的集合有哪些?用线程安全的集合一定就线程安全吗?
-
线程会跟着main方法一起消亡吗?
-
Zookeeper选举机制有哪些?
2.Spark 高阶调优(深度拷打,被打哭了)
-
Spark stage的划分规则是什么?
-
Spark有哪些调优手段?自身调优机制AQE原理是什么?
-
Spark SQL优化器的核心逻辑是什么?逻辑计划和物理计划之间是什么?
-
count(distinct) 消耗资源过高,精度要求不高的情况下如何优化?
-
增加CPU和内存一定会提高任务效率吗?
-
Spark CPU核数多、计算任务少,如何针对性优化?
-
Spark任务运行缓慢,完整排查思路是什么?
3.项目+业务(细节拷打)
-
深挖过往项目细节、难点、优化点
-
日常对接的企业数据量级是多少?
4.手撕算法&&SQL
-
用两个栈实现队列(简单)
-
连续性问题(简单)
3.快手数据开发实习一面
这次快手的面试偏弱化传统基础八股,重点考察AI代码工具落地、业务方案设计、工程实战能力,非常贴合当下大厂数据开发的智能化转型(当然这也是各大厂正在做的事情,腾讯一面没问不代表后续面试没有)。
1.AI开发工具&平台实操
-
单一skill文档能否完整替代现有引擎,覆盖编排、分析、执行、质检、总结全工作流及工具调用等平台能力?
-
Vibe Coding IDE Agent与自研Agent的本质区别是什么?
-
依托大厂开源IDE Agent搭配skill方案,是否能更灵活适配现有业务场景?
-
是否使用过小龙虾、Vibe Coding等工具?日常使用频次如何?
-
落地各类外部代码生成平台有哪些实操经验?优质平台的核心优势是什么?
-
现阶段代码开发成本是否偏高?如何对比大模型Token成本与人工开发成本?
-
小龙虾产品与各类IDE编程Agent的核心差异是什么?
2.业务方案设计
-
业务场景:产出分析调研报告,需爬虫拉取数据源+大模型数据加工,落地过哪些方案?有没有可灵活拓展、支持用户自主迭代的方案?
3.个人情况问询
-
个人在读年级?大三的话空余时间能否满足全职实习?
-
是否刚开始找实习?意向深耕的技术方向是什么?
-
日常可投入的实习时间是否充裕?
4.手撕算法&&SQL
-
合并两个有序数组
-
SQL 写了两个,都是比较简单的
面试复盘总结
-
腾讯:底层、原理、排查、调优
-
该部门面试重点:深入Spark/Flink底层原理、熟记线上任务慢、数据倾斜、小文件等常见问题的完整排查链路、吃透SQL与集群资源调优的经验,保证基础知识点非常了解。
-
-
快手:落地、工具、业务、创新
-
该部门面试重点:梳理AI编程工具实操经验、需总结业务落地案例与方案迭代思维,贴合智能化开发行业趋势
-
更多推荐
 4
 0
- 0


 已为社区贡献7条内容

所有评论(0)