
树和二叉树
一、树
1、树(Tree)的定义
树是n(n≥0)个结点的有限集合:
若 n=0,称为空树。
若 n>0:
有且仅有一个根结点(Root)。
其余结点可分为 m 个互不相交的有限集合 T₁、T₂…Tₘ,每个集合本身也是一棵树,称为子树。
层次化的非线性数据结构,由节点和边组成,有且仅有一个根节点,子节点互不相交。
2.树的特点
子树个数不限(0、1、2、3… 都可以)。
子树没有左右顺序之分(无序)。
根结点无前驱,其他结点有且仅有一个父结点。
无环、无交叉。
二、二叉树
1.二叉树的定义
二叉树是 n(n≥0)个结点的有限集合:
或为空树
或由一个根结点 + 左子树 + 右子树组成
左、右子树本身也是二叉树
每个节点最多有两个子节点(左孩子、右孩子),左右有序不可互换。
2.二叉树的特点
每个结点最多有 2 棵子树(0、1、2 个)。
子树严格分左右,次序不能互换(有序树)。
即使只有一棵子树,也要区分是左孩子还是右孩子。
是最简单、最常用的树形结构。
3.树和二叉树的区别
| 项目 | 普通树(Tree) | 二叉树(Binary Tree) |
|---|---|---|
| 子树个数 | 不限,可以任意多 | 最多 2 个(0/1/2) |
| 左右顺序 | 无序,子树不分左右 | 有序,严格分左、右 |
| 空树 | 允许 | 允许 |
| 单结点子树 | 不区分左右 | 必须区分左 / 右 |
| 结构种类 | 随度变化极多 | 固定 5 种基本形态 |
| 存储结构 | 孩子兄弟表示法等 | 二叉链表、顺序存储 |
| 遍历方式 | 先根、后根 | 前、中、后、层序 |
4.二叉树的重要性质
第 i 层最多 2ⁱ⁻¹ 个结点。
深度为 k 的二叉树最多 2ᵏ - 1 个结点。
叶子结点数 n₀ = 度为 2 的结点数 n₂ + 1
n₀ = n₂ + 1
具有 n 个结点的完全二叉树深度:
⌊log₂n⌋ + 1
完全二叉树父子下标关系(从 1 开始):
左孩子:2i
右孩子:2i+1
父结点:⌊i/2⌋
5.总结
树:结点可以有任意多个孩子,不分左右。
二叉树:结点最多两个孩子,严格分左右。
二叉树是有序树,普通树是无序树。
三、三种遍历二叉树的方式
前序:根 → 左 → 右
中序:左 → 根 → 右(BST 升序)
后序:左 → 右 → 根
层序:按层遍历(用队列)
1.二叉树节点结构体:
#include <stdio.h>
#include <stdlib.h>

// 二叉树节点结构
typedef struct TreeNode {
    int data;               // 数据域
    struct TreeNode *left;  // 左孩子
    struct TreeNode *right; // 右孩子
} TreeNode, *BiTree;
2.创建一个新节点
// 创建新节点
TreeNode* createNode(int val) {
    TreeNode* node = (TreeNode*)malloc(sizeof(TreeNode));
    node->data = val;
    node->left = NULL;
    node->right = NULL;
    return node;
}
3.四种遍历(递归版,最易理解)
// 前序遍历:根 → 左 → 右
void preOrder(TreeNode* root) {
    if (root == NULL) return;
    printf("%d ", root->data);
    preOrder(root->left);
    preOrder(root->right);
}

// 中序遍历:左 → 根 → 右
void inOrder(TreeNode* root) {
    if (root == NULL) return;
    inOrder(root->left);
    printf("%d ", root->data);
    inOrder(root->right);
}

// 后序遍历:左 → 右 → 根
void postOrder(TreeNode* root) {
    if (root == NULL) return;
    postOrder(root->left);
    postOrder(root->right);
    printf("%d ", root->data);
}

// 层序遍历(用队列)
void levelOrder(TreeNode* root) {
    if (root == NULL) return;

    TreeNode* queue[100]; // 简单队列
    int front = 0, rear = 0;

    queue[rear++] = root;

    while (front < rear) {
        TreeNode* cur = queue[front++];
        printf("%d ", cur->data);

        if (cur->left)  queue[rear++] = cur->left;
        if (cur->right) queue[rear++] = cur->right;
    }
}
4.完整 main 测试
int main() {
    // 构建一棵二叉树
    //        1
    //       / \
    //      2   3
    //     / \
    //    4   5
    TreeNode* root = createNode(1);
    root->left = createNode(2);
    root->right = createNode(3);
    root->left->left = createNode(4);
    root->left->right = createNode(5);

    printf("前序: "); preOrder(root); printf("\n");
    printf("中序: "); inOrder(root); printf("\n");
    printf("后序: "); postOrder(root); printf("\n");
    printf("层序: "); levelOrder(root); printf("\n");

    return 0;
}
四、满二叉树与完全二叉树与平衡二叉树的区别
1.时间复杂度对比
| 操作 | 完全二叉树 | 满二叉树 | 平衡二叉树(AVL) |
|---|---|---|---|
| 查找(最坏) | O(n)(退化为链表时),平均 O(logn) | O(logn)(树高固定为 log2(n+1)) | 稳定 O(logn)(自平衡保证) |
| 插入(最坏) | O(n)(链表形态),平均 O(logn) | O(logn) | O(logn)(含旋转操作) |
| 删除(最坏) | O(n)(链表形态),平均 O(logn) | O(logn) | O(logn)(含旋转操作) |
| 遍历 | O(n)(所有二叉树遍历时间复杂度均为 O(n)) | O(n) | O(n) |
2.核心定义和结构对比
| 对比维度 | 完全二叉树 (Complete Binary Tree) | 满二叉树 (Full Binary Tree) | 平衡二叉树 (AVL 树,Balanced Binary Tree) |
|---|---|---|---|
| 标准定义 | 除最后一层外,其余所有层节点完全填满;最后一层节点严格靠左对齐,无中间空缺 | 二叉树中所有层的节点都完全填满,无任何空缺,所有叶子节点都在同一层(最底层) | 任意节点的左右子树高度差(平衡因子)的绝对值 ≤ 1,且左右子树均为平衡二叉树 |
| 节点数与深度关系 | 深度为 h 时,节点数 n 满足:2h−1≤n≤2h−1 | 深度为 h 时,节点数固定为 n=2h−1 | 深度 h≈1.44log2(n+2),节点数无固定公式,仅受平衡因子约束 |
| 叶子节点位置 | 仅出现在最后两层,最后一层节点靠左排列 | 所有叶子节点都在同一层(最底层) | 可出现在任意层,无位置限制 |
| 非叶节点结构 | 最多只有最后一层的父节点可能只有左孩子,其余非叶节点都有两个孩子 | 所有非叶节点都有且仅有两个孩子,无度为 1 的节点 | 非叶节点可拥有 0、1、2 个孩子,仅需满足平衡因子约束 |
| 包含关系 | 满二叉树一定是完全二叉树;完全二叉树不一定是满二叉树 | 是完全二叉树的特例 | 与前两者无包含关系:完全 / 满二叉树一定是平衡二叉树,但平衡二叉树不一定是完全 / 满二叉树 |
| 存储方式 | 支持数组顺序存储(层序编号连续,空间利用率高,堆的核心结构),也支持链式存储 | 支持数组顺序存储(无空间浪费),也支持链式存储 | 仅支持链式存储(结构不连续,无法用数组高效存储) |
1. 完全二叉树
✅ 编号连续性:按层序(从上到下、从左到右)编号后,节点编号连续无跳跃,因此可直接用数组存储,父子节点下标关系固定:
1 基编号:节点 i的左孩子 2i,右孩子 2i+1,父节点 ⌊i/2⌋
0 基编号:节点 i的左孩子 2i+1,右孩子 2i+2,父节点 ⌊(i−1)/2⌋
✅ 深度计算:已知节点数 n,深度 h=⌊log 2n⌋+1
✅ 应用场景:堆排序、优先队列、完全二叉树的层序遍历 / 数组构建
2.满二叉树
✅ 节点数严格对应深度:深度 h的满二叉树,节点数固定为 2 (h−1),叶子节点数为 2 (h−1
),非叶节点数为 2 (h−1)−1。 ( )中的内容为幂
✅ 叶子节点性质:叶子节点数 = 非叶节点数 + 1
✅ WPL 特性:是哈夫曼树的特例,带权路径长度(WPL)最优
✅ 应用场景:哈夫曼编码、满二叉树的遍历、完全二叉树的基准参考
3. 平衡二叉树(AVL 树)
✅ 平衡因子定义:节点的平衡因子 = 左子树高度 - 右子树高度,要求 ∣BF∣≤1
✅ 自平衡特性:插入 / 删除节点后,若破坏平衡,通过旋转操作(左旋、右旋、左右旋、右左旋) 恢复平衡
✅ 查找效率:查找时间复杂度稳定为 O(logn),不会退化为链表的 O(n)
✅ 应用场景:高效查找、有序集合存储(如 C++ 的set/map底层早期实现)
3.应用场景总结
| 树类型 | 核心应用场景 | 优势 |
|---|---|---|
| 完全二叉树 | 堆排序、优先队列、完全二叉树数组存储 | 数组存储高效,父子关系固定,实现简单 |
| 满二叉树 | 哈夫曼编码、满二叉树遍历、完全二叉树基准 | 结构规整,WPL 最优,遍历效率高 |
| 平衡二叉树(AVL) | 高效查找、有序集合存储、数据库索引 | 查找时间复杂度稳定 O(logn),无链表退化风险 |
4.易错点
易错点与核心区分
1. 完全二叉树 vs 满二叉树
❌ 误区:“所有非叶节点都有两个孩子就是满二叉树” → 错误,完全二叉树也满足该条件(除最后一层父节点),但满二叉树要求所有层全满
✅ 核心区分:满二叉树是完全二叉树的 “极限状态”,完全二叉树是满二叉树的 “不完全版本”
2. 完全二叉树 vs 平衡二叉树
❌ 误区:“完全二叉树一定是平衡二叉树” → 正确!完全二叉树的左右子树高度差最多为 1,天然满足 AVL 树的平衡条件
✅ 反向不成立:平衡二叉树不一定是完全二叉树(如上述示例)
3. 满二叉树 vs 平衡二叉树
✅ 满二叉树一定是平衡二叉树(所有节点平衡因子为 0)
❌ 平衡二叉树不一定是满二叉树(结构可任意,仅需平衡因子约束)
五、哈夫曼树
1.定义
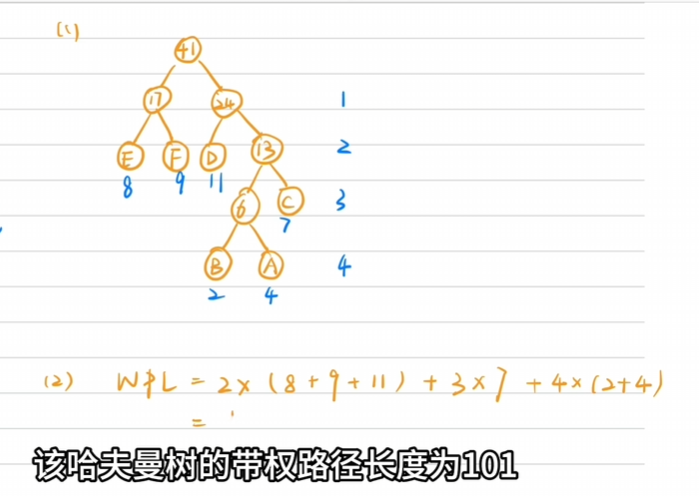
哈夫曼树 = 最优二叉树 = 带权路径长度 WPL 最小的二叉树
关键概念
权值:节点的数值(频率、概率、代价)
路径长度:从根到该节点经过的边数
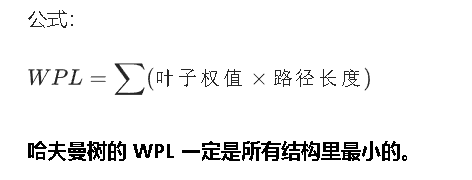
带权路径长度 WPL:所有叶子节点的
权值 × 路径长度 之和
哈夫曼树就是让 WPL 最小 的二叉树。
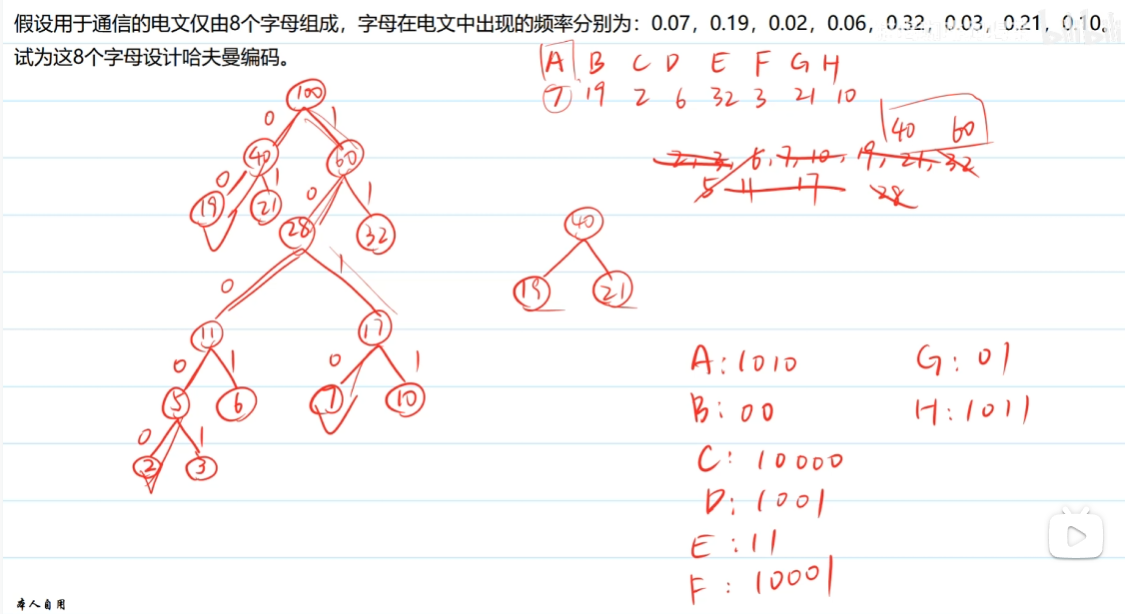
2.构造规则
把所有叶子节点按权值从小到大排列
每次选两个权值最小的节点合并
新节点权值 = 两个子节点权值之和
把新节点放回集合,重新排序
重复直到只剩1 个根节点
3.核心特征
1.哈夫曼树没有度为 1 的节点
所有非叶子节点都有 2 个孩子
2.n 个叶子 → 总节点数 = 2n - 1
3.权值越大 → 离根越近(保证 WPL 最小)
4.哈夫曼树不唯一,但 WPL 一定唯一
5.是二叉树,但不一定是完全二叉树
6.哈夫曼树是前缀码树,解码无歧义
4.计算公式
5.哈夫曼树 vs 普通二叉树 vs 完全二叉树
| 特点 | 哈夫曼树 | 普通二叉树 | 完全二叉树 |
|---|---|---|---|
| 度为 1 节点 | 无 | 可有 | 最多 1 个 |
| 叶子数 n | 总节点 = 2n-1 | 任意 | 任意 |
| WPL | 最小 | 不一定 | 不一定 |
| 结构 | 由权值决定 | 任意 | 严格层序靠左 |
| 用途 | 压缩编码 | 通用 | 堆、排序 |
6.易错点
1.哈夫曼树不是完全二叉树
2.哈夫曼树没有度为 1 的节点
3.哈夫曼编码是前缀码,不是等长码
3.结构不唯一,但 WPL 一定唯一
4.哈夫曼树是二叉树,不是普通树
7.哈夫曼树实现编码
1.哈夫曼树节点结构
权值 weight
左右孩子 lchild /rchild
字符(用于编码)c
2.最小堆(优先队列):用于每次取两个最小权值节点
3.构造哈夫曼树:合并两个最小节点,循环到根
4.计算 WPL:递归遍历叶子求和
5.生成哈夫曼编码:递归遍历,左 0 右 1
6.主函数测试:输入权值 → 建树 → WPL → 编码输出
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

// ===================== 1. 哈夫曼树节点定义 =====================
typedef struct HuffmanNode {
    char ch;          // 字符(叶子才有)
    int weight;       // 权值(频率)
    int parent;       // 父节点下标(数组实现方便)
    int lchild, rchild;
} HuffmanNode;

// ===================== 2. 哈夫曼编码结构体 =====================
typedef struct HuffmanCode {
    char ch;          // 字符
    char code[100];   // 编码串(01串)
} HuffmanCode;

// ===================== 3. 选两个权值最小的节点(核心) =====================
// 在 0~n-1 中找 parent=-1 的两个最小节点
void selectMin(HuffmanNode* HT, int n, int* s1, int* s2) {
    int i;
    // 找第一个最小 s1
    *s1 = -1;
    for (i = 0; i < n; i++) {
        if (HT[i].parent == -1) {
            if (*s1 == -1 || HT[i].weight < HT[*s1].weight)
                *s1 = i;
        }
    }
    // 找第二个最小 s2
    *s2 = -1;
    for (i = 0; i < n; i++) {
        if (HT[i].parent == -1 && i != *s1) {
            if (*s2 == -1 || HT[i].weight < HT[*s2].weight)
                *s2 = i;
        }
    }
}

// ===================== 4. 构造哈夫曼树 =====================
// n: 叶子数
void createHuffmanTree(HuffmanNode* HT, int n, int* weights, char* chars) {
    if (n <= 1) return;

    int totalNodes = 2 * n - 1;  // 总节点数固定:叶子n → 2n-1

    // 初始化所有节点
    for (int i = 0; i < totalNodes; i++) {
        HT[i].parent = HT[i].lchild = HT[i].rchild = -1;
        HT[i].weight = 0;
        HT[i].ch = 0;
    }

    // 初始化叶子节点(前n个)
    for (int i = 0; i < n; i++) {
        HT[i].weight = weights[i];
        HT[i].ch = chars[i];
    }

    // 开始合并 n-1 次
    for (int i = n; i < totalNodes; i++) {
        int s1, s2;
        selectMin(HT, i, &s1, &s2);  // 选两个最小

        // 建立父子关系
        HT[s1].parent = i;
        HT[s2].parent = i;
        HT[i].lchild = s1;
        HT[i].rchild = s2;
        HT[i].weight = HT[s1].weight + HT[s2].weight;
    }
}

// ===================== 5. 计算 WPL(递归) =====================
// index: 当前节点下标
// depth: 当前深度(路径长度)
int calcWPL(HuffmanNode* HT, int index, int depth) {
    // 叶子节点:weight * depth
    if (HT[index].lchild == -1 && HT[index].rchild == -1)
        return HT[index].weight * depth;

    // 非叶子:递归左右
    int leftWPL = calcWPL(HT, HT[index].lchild, depth + 1);
    int rightWPL = calcWPL(HT, HT[index].rchild, depth + 1);

    return leftWPL + rightWPL;
}

// ===================== 6. 生成哈夫曼编码(递归) =====================
void createHuffmanCode(HuffmanNode* HT, HuffmanCode* HC, int n) {
    char temp[100];  // 临时存编码
    temp[0] = '\0';

    // 对每个叶子生成编码
    for (int i = 0; i < n; i++) {
        int cur = i;
        int len = 0;
        int p = HT[cur].parent;

        // 从叶子回溯到根
        while (p != -1) {
            if (HT[p].lchild == cur)
                temp[len++] = '0';
            else
                temp[len++] = '1';
            cur = p;
            p = HT[cur].parent;
        }
        temp[len] = '\0';

        // 反转(因为回溯是逆序)
        strrev(temp);

        // 存入编码表
        HC[i].ch = HT[i].ch;
        strcpy(HC[i].code, temp);
    }
}

// ===================== 7. 打印编码 =====================
void printHuffmanCode(HuffmanCode* HC, int n) {
    printf("\n=== 哈夫曼编码表 ===\n");
    for (int i = 0; i < n; i++) {
        printf("%c : %s\n", HC[i].ch, HC[i].code);
    }
}

// ===================== 主函数测试 =====================
int main() {
    // 测试数据:5 个字符 + 权值
    int n = 5;
    char chars[] = {'a', 'b', 'c', 'd', 'e'};
    int weights[] = {1, 2, 3, 4, 5};  // 权值

    // 开辟哈夫曼树空间:2n-1 个节点
    HuffmanNode* HT = (HuffmanNode*)malloc(sizeof(HuffmanNode) * (2 * n - 1));
    // 编码表
    HuffmanCode* HC = (HuffmanCode*)malloc(sizeof(HuffmanCode) * n);

    // 建树
    createHuffmanTree(HT, n, weights, chars);

    // 计算 WPL(根是最后一个节点:2n-2)
    int wpl = calcWPL(HT, 2 * n - 2, 0);
    printf("WPL = %d\n", wpl);

    // 生成编码
    createHuffmanCode(HT, HC, n);
    printHuffmanCode(HC, n);

    free(HT);
    free(HC);
    return 0;
}
更多推荐

 14
 0
- 0


 已为社区贡献1条内容

所有评论(0)