
数据结构:散列表
散列表查找效率主要取决于三个因素:散列函数、冲突处理方式、和装填因子。
一、散列表构造方法
构造散列函数需要注意的:
- 散列函数定义域必须包含所有关键字,值域范围取决于散列表的大小
- 散列函数计算出来的地址尽可能地均匀分布在整个地址空间,可以有效减少冲突
- 散列函数尽可能简单,能在短时间内计算出任意关键字对应的散列地址
1.直接定址法
或
a,b为常数。最简单,不容易起冲突。适用于关键字分布基本连续的情形。若关键字稀疏,则会导致空位较多,而且会造成空间浪费。
2.除留余数法
设散列表长度为m,选取一个不超过m且尽可能接近m的质数p。这个方法的关键就在于合理选择p,使得不同关键字经该函数映射后能近似等概率的落在散列空间的各个位置,从而减少冲突。
3.数字分析法
设关键字是r进制数,其各个位置的数码(共r种)出现的频率可能不同。分析关键字集合中各位数字的分布规律,选择分布均匀、随机性强的若干位(或组合)作为散列地址,尽量避免冲突。
| 优点 | 缺点 |
|---|---|
| 如果关键字分布已知,可构造出几乎无冲突的完美散列函数 | 必须预先知道全部关键字,不适合动态变化的关键字集合 |
| 计算简单,速度快 | 对关键字的格式和分布有较强依赖,换一组关键字可能需要重新分析 |
| 可结合其他方法(如除留余数)灵活调整 | 适用于数字类型,非数字需先转换为数字(如ASCII码) |
适用场景:
-
静态关键字集合(例如词典中的单词代码、固定员工工号、已知的历史数据)。
-
关键字位数较多,且各位分布不均匀,容易挑出均匀的位。
-
希望避免冲突,且不介意预先做一次统计分析的场合。
4.平方取中法
取关键字平方值的中间几位作为散列地址。
| 优点 | 缺点 |
|---|---|
| 不需事先知道关键字的分布情况,通用性强 | 需要执行乘法运算,计算速度比直接取模稍慢 |
| 平方运算能使关键字的每一位都影响中间几位,随机性好,冲突相对较少 | 平方结果可能位数较多,需处理大数(编程时需注意溢出) |
| 对于连续递增的关键字(如1,2,3...)也能得到较均匀的地址,避免“一次聚集” | 表长若不为2的幂,地址提取和进制转换略麻烦 |
| 可实现性好,在二进制下可用位运算快速提取中间位 | 若表长较大,需取的位数较多,平方后的中间位可能仍存在一定不均匀性 |
| 是一种经典的哈希函数构造方法,适用于静态或动态关键字集合 | 相比于数字分析法,无法做到“完美哈希”(完全无冲突) |
适用场景:
-
关键字数值范围不确定或分布未知(关键字的各位取值分布不均或本身位数比较少的情况)。
-
希望快速得到一个相对均匀的哈希地址,且不介意一次乘法。
-
常用于哈希表初学时演示,以及一些老的哈希算法(如早期编译器的符号表)。
二、处理冲突方法
1.开放定址法
但冲突发生的时候,不增加额外存储空间,而是在散列表本身的数组中寻找下一个空闲位置,将元素存入。
为发生第i次冲突时的散列地址,
为散列函数,
为第i次探测的增量
,m为散列表表长。
线性探测法
特点:容易产生一次聚集,连续位置被占,导致后续插入/查找效率严重下降。
平方探测法(二次探测法)
冲突后按平方补偿跳跃探查,不是线性步长。
特点:
-
能有效避免 一次聚集,但仍可能产生 二次聚集(多个关键字映射到同一基址后,后续探查路径相同)。
-
必须保证表长 m 是 4k+3 形式的质数,才能探查到整个表的一半左右位置(不保证全覆盖,但实践够用)。
双散列法
冲突后,探查的步长不是固定的,而是由第二个哈希函数动态计算。
特点:
-
是开放定址法中最均匀的方法,能有效避免聚集(一次和二次聚集均几乎消除)。
-
探查序列覆盖整个表(如果 H2H2 与 mm 互质,且 mm 为质数)。
伪随机序列法
是一个伪随机数序列,由某个随机数生成器产生,且序列对所有 key 相同或与 key 相关)。
冲突后,按预先生成的伪随机数作为步长进行探查。
特点:
-
若随机数序列是固定的(与 key 无关),则多个不同 key 若基址相同,探查序列也相同,仍可能产生二次聚集。
-
改进版:让伪随机数生成器的种子与 key 相关(如 ri=rand(key,i)ri=rand(key,i)),则不同 key 的探查序列不同,效果接近双散列。
| 方法 | 探查序列公式 | 聚集程度 | 表长要求 | 计算开销 |
|---|---|---|---|---|
| 线性探测 | 严重一次聚集 | 无特殊要求 | 最低 | |
| 平方探测 | 轻微二次聚集 | 最好为 4k+3 质数 | 低 | |
| 双散列 | 几乎无聚集 | 中等(两次哈希) | ||
| 伪随机序列 | 取决于随机性 | 无特殊要求 | 中等(生成随机数) |
2.拉链法
将散列表每个槽位设置为一个链表,所有哈希地址相同的元素都存入同一个链表。散列表就相当于存放头指针的顺序表。
处理冲突就是把所有同义词组织成一个链表。
三、散列查找和性能分析
1.如何计算散列表ASL
探查成功
n散列表中已存在元素的个数(目前散列表中已经存入的数据个数)
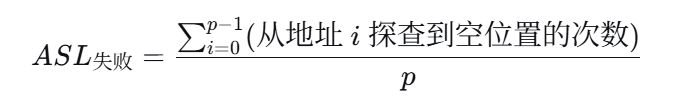
探查失败
r散列函数取值个数(散列函数的p值)
2.装填因子
-
α :装填因子(load factor)
-
n :散列表中已存入的关键字个数
-
m :散列表的总长度(即槽位数,数组大小)
性能影响:
-
α 越大:冲突概率越高,查找、插入的平均探查次数(或链表长度)越大,性能下降。
-
α 越小:空间浪费越多,但性能越好。
写的我力竭了,本来打算加一道综合题,等下次吧,我一定会再写一篇的习题。
更多推荐



 23
 0
- 0


 已为社区贡献1条内容

所有评论(0)