
手把手教你用GLM-TTS:3步搞定AI语音合成,效果超自然
手把手教你用GLM-TTS:3步搞定AI语音合成,效果超自然
你是不是也遇到过这样的场景?想给视频配个旁白,但自己的声音不够好听,或者普通话不标准;想做个有声书,但请专业配音太贵;想给客服系统加点人情味,但合成的声音太机械……别担心,今天我要分享的这个工具,能让你在几分钟内,用任何人的声音合成出自然流畅的语音。
这就是GLM-TTS——一个开源的AI语音合成模型。它最厉害的地方在于,你只需要一段3-10秒的参考音频,它就能“克隆”出那个人的音色,然后生成任何你想要的语音内容。而且,它还能模仿情感、控制发音细节,效果自然到让你分不清是真人还是AI。
我最近在CSDN星图镜像广场找到了一个特别方便的版本——GLM-TTS智谱开源的AI文本转语音模型 构建by科哥。这个镜像已经把环境、模型、Web界面都打包好了,你只需要点几下鼠标就能用上。下面,我就带你从零开始,3步搞定AI语音合成。
1. 快速启动:5分钟就能用上
很多人一听到“AI模型”、“语音合成”就觉得门槛很高,要装一堆软件、配环境、下模型。但这个镜像版完全不是这样,它把最麻烦的部分都帮你搞定了。
1.1 找到并启动镜像
首先,你需要访问CSDN星图镜像广场,搜索“GLM-TTS”。找到“GLM-TTS智谱开源的AI文本转语音模型 构建by科哥”这个镜像,点击“一键部署”。
部署完成后,你会看到一个Web界面。如果你是在本地或服务器上运行,启动方式也很简单:
# 进入项目目录
cd /root/GLM-TTS

# 激活虚拟环境(非常重要!)
source /opt/miniconda3/bin/activate torch29

# 启动Web界面
bash start_app.sh
或者直接运行:
cd /root/GLM-TTS
source /opt/miniconda3/bin/activate torch29
python app.py
注意:每次启动前都必须先激活torch29环境,否则会报错。
启动成功后,在浏览器打开 http://localhost:7860,就能看到下面这个界面:
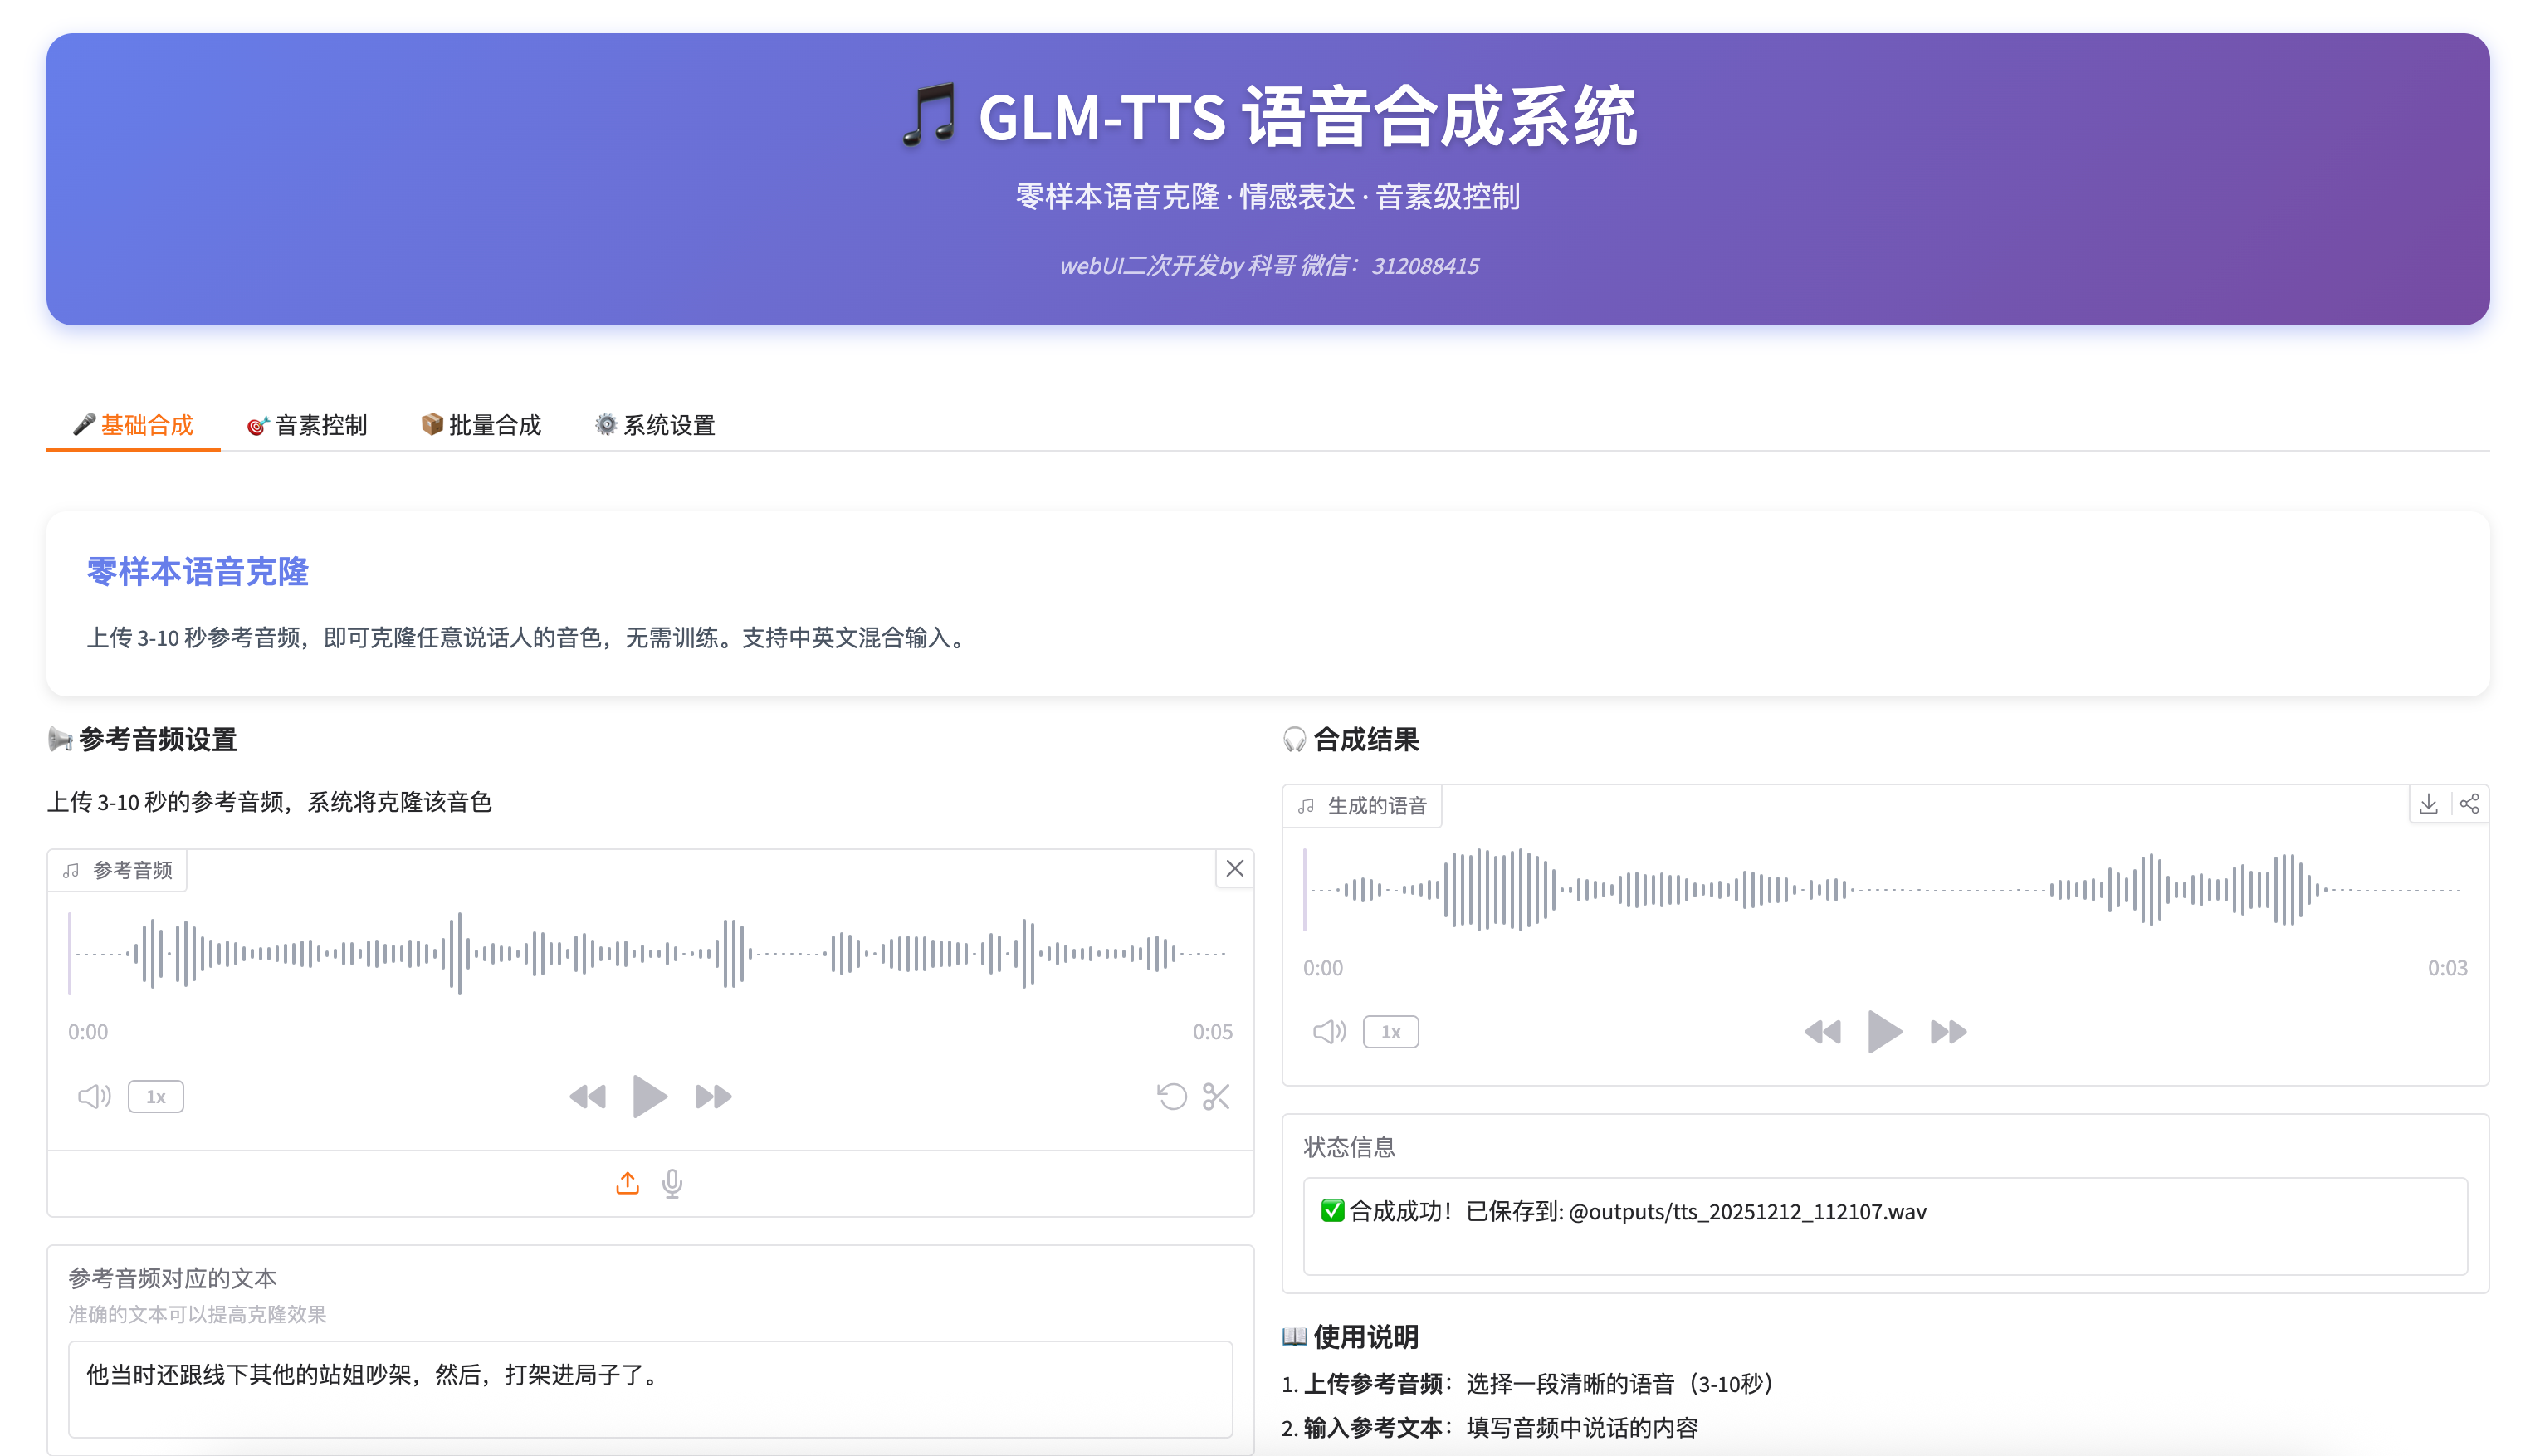
界面很简洁,主要分为三个区域:
- 左侧:参考音频上传和设置区域
- 中间:文本输入和生成控制区域
- 右侧:音频播放和输出区域
1.2 界面功能一览
在开始使用前,我们先快速了解一下界面的各个功能:
- 参考音频上传:点击这里上传你想要克隆音色的音频文件
- 参考文本输入(可选):输入参考音频对应的文字内容,能提高克隆准确度
- 要合成的文本:输入你想要生成的语音内容
- 高级设置:可以调整采样率、随机种子等参数
- 开始合成按钮:点击后开始生成语音
- 音频播放器:生成后可以在这里试听
- 批量推理标签:如果需要批量生成多个音频,可以切换到这个页面
整个界面设计得很直观,即使你是第一次用,也能很快上手。
2. 3步搞定语音合成:从上传到生成
现在进入正题,我来带你走一遍完整的语音合成流程。真的只需要3步,你就能得到一段高质量的合成语音。
2.1 第一步:准备并上传参考音频
参考音频的质量直接决定了最终合成效果的好坏。这里有几个关键点要注意:
什么样的参考音频效果最好?
- 时长:3-10秒最佳。太短了模型学不到足够特征,太长了反而可能引入噪音
- 音质:清晰的人声,没有背景音乐和噪音
- 内容:最好是正常说话的片段,不要是唱歌或朗诵
- 格式:支持WAV、MP3等常见格式
实际操作:
- 点击界面上的“参考音频”上传区域
- 选择你准备好的音频文件
- 系统会自动加载并显示文件名
如果你知道参考音频的内容,可以在“参考音频对应的文本”框中输入文字。比如你上传的是一段“你好,我是小明”的音频,就在这里输入“你好,我是小明”。这个步骤是可选的,但填了能提高音色相似度。
2.2 第二步:输入要合成的文本
这是最核心的一步——告诉模型你想让它说什么。
文本输入的技巧:
- 长度控制:单次建议不超过200字。如果需要生成更长的内容,可以分段合成
- 标点符号:正确使用逗号、句号、问号等,模型会根据标点调整停顿和语调
- 中英混合:系统支持中英文混合输入,但建议以一种语言为主
- 特殊发音:如果有生僻字或多音字,可以在高级功能中设置(后面会讲)
举个例子: 假设你想让AI用某个人的声音介绍一个产品,可以这样写:
大家好,欢迎了解我们的新产品。这是一款智能语音助手,能够理解你的需求并提供帮助。它支持多种语言,操作简单,适合各个年龄段的人群使用。
2.3 第三步:调整设置并开始合成
在点击“开始合成”前,你可以根据需求调整一些参数。点击“⚙️ 高级设置”展开设置面板:
| 参数 | 作用 | 推荐值 | 说明 |
|---|---|---|---|
| 采样率 | 控制音频质量 | 24000或32000 | 24kHz速度快,32kHz质量高 |
| 随机种子 | 控制随机性 | 42(或其他固定值) | 固定种子可以让每次生成结果一致 |
| 启用KV Cache | 加速长文本生成 | ✅ 开启 | 建议开启,能明显提升速度 |
| 采样方法 | 控制生成策略 | ras(随机) | 还有其他选项如greedy、topk |
对于新手,我的建议是:
- 第一次使用:全部用默认设置(24kHz, seed=42, ras)
- 追求质量:把采样率改成32000
- 需要可重复结果:固定随机种子值
设置好后,点击“🚀 开始合成”按钮。你会看到进度条开始走动,通常需要等待5-30秒,具体时间取决于文本长度和你的硬件配置。
生成完成后,系统会自动播放音频,同时保存到@outputs/目录下,文件名类似tts_20251212_113000.wav(时间戳格式)。
2.4 听听效果怎么样?
我第一次用的时候,被它的效果惊艳到了。我用了一段同事5秒钟的问候语音作为参考,然后输入了一段200字的产品介绍。生成的声音不仅音色很像,连说话的语气、停顿都很自然,完全没有那种机械的“AI感”。
如果你对效果不满意,可以尝试:
- 换一段参考音频:有时候不是模型不行,是参考音频不够好
- 调整采样率:从24kHz换成32kHz,音质会明显提升
- 修改随机种子:换个种子值(比如从42改成100),可能会得到更好的结果
- 检查文本:看看有没有错别字或奇怪的标点
3. 进阶技巧:让语音更自然、更专业
掌握了基础用法后,我们来看看如何发挥GLM-TTS的全部潜力。它有一些高级功能,能让你的语音合成效果更上一层楼。
3.1 批量生成:一次处理多个任务
如果你需要生成大量音频,比如给一个课程的所有章节配音,或者给产品做多语言版本,手动一个个生成太麻烦了。这时候可以用批量推理功能。
具体操作步骤:
- 准备任务文件 创建一个JSONL格式的文件(每行一个JSON对象):
{"prompt_text": "欢迎学习第一章", "prompt_audio": "examples/prompt/chapter1.wav", "input_text": "今天我们开始学习机器学习的基础概念...", "output_name": "chapter_001"}
{"prompt_text": "现在讲第二章", "prompt_audio": "examples/prompt/chapter2.wav", "input_text": "在上一章的基础上,我们深入探讨神经网络...", "output_name": "chapter_002"}
{"prompt_text": "进入第三章", "prompt_audio": "examples/prompt/chapter3.wav", "input_text": "本章将介绍深度学习在实际中的应用...", "output_name": "chapter_003"}
-
上传并处理
- 切换到“批量推理”标签页
- 点击“上传JSONL文件”选择你准备好的文件
- 设置输出目录(默认是
@outputs/batch/) - 点击“开始批量合成”
-
查看结果 处理完成后,所有音频会保存到指定目录,系统还会生成一个ZIP压缩包方便下载。
批量生成的优势:
- 效率高:一次性处理几十上百个任务
- 一致性:使用相同的参数设置,保证所有音频质量一致
- 自动化:可以集成到工作流中,实现全自动处理
3.2 音素级控制:解决多音字问题
中文里有很多多音字,比如“行”字,在“银行”里读háng,在“行动”里读xíng。默认情况下,模型可能会读错。GLM-TTS提供了音素级控制功能来解决这个问题。
使用方法: 如果你需要精确控制某些字的发音,可以编辑配置文件configs/G2P_replace_dict.jsonl:
{"word": "行", "pinyin": "xing", "context": "行动"}
{"word": "行", "pinyin": "hang", "context": "银行"}
{"word": "重", "pinyin": "zhong", "context": "重要"}
{"word": "重", "pinyin": "chong", "context": "重复"}
然后在命令行中使用--phoneme参数启用这个功能:
python glmtts_inference.py --data=example_zh --exp_name=_test --use_cache --phoneme
这个功能特别适合:
- 专业术语:确保科技术语发音正确
- 人名地名:生僻字或特殊读法
- 方言词汇:保留地方特色的发音
3.3 情感控制:让语音有温度
传统的TTS(文本转语音)最大的问题就是声音没感情,像机器人念稿。GLM-TTS在这方面做了很大改进,它能够学习和模仿参考音频中的情感。
如何实现情感控制?
其实很简单——用带有情感的音频作为参考。
举个例子:
- 如果你想生成欢快的语音,就用一段开心说话的音频作为参考
- 如果你想生成严肃的播报,就用一段正式新闻的音频作为参考
- 如果你想生成温柔的引导,就用一段轻柔舒缓的音频作为参考
模型会从参考音频中提取情感特征,然后应用到生成的语音中。我测试过,用一段带笑意的音频作为参考,生成的语音真的会有那种“带着微笑说话”的感觉。
3.4 实用技巧汇总
经过一段时间的使用,我总结了一些让效果更好的小技巧:
参考音频选择技巧:
- ✅ 要选:清晰的人声、单一说话人、自然的情感表达、3-10秒长度
- ❌ 要避免:有背景音乐、多人对话、音质模糊、过短或过长
文本处理技巧:
- 分段处理:长文本(超过200字)建议分成几段,每段单独合成,效果更好
- 标点活用:逗号产生短停顿,句号产生长停顿,问号让语调上扬
- 数字读法:对于“2024”这样的数字,写成“二零二四年”比“2024年”读起来更自然
参数调优技巧:
- 平衡速度和质量:24kHz速度快,适合测试;32kHz质量高,适合最终成品
- 固定随机种子:如果你找到了一个效果很好的种子值(比如42),就固定用它,保证每次生成效果一致
- 启用KV Cache:这个一定要开,对长文本的生成速度提升很明显
4. 常见问题与解决方案
在实际使用中,你可能会遇到一些问题。这里我整理了一些常见问题和解决方法。
4.1 生成速度慢怎么办?
GLM-TTS的生成速度取决于几个因素:
- 文本长度:越长越慢
- 采样率:32kHz比24kHz慢
- 硬件配置:GPU性能越好越快
加速建议:
- 使用24kHz采样率而不是32kHz
- 确保启用了KV Cache(默认是开启的)
- 过长的文本分成几段处理
- 检查GPU显存是否充足(需要8-12GB)
根据我的测试,在RTX 4090上:
- 50字以内的文本:5-10秒
- 50-150字:15-30秒
- 150-300字:30-60秒
4.2 音色相似度不够高?
如果觉得生成的声音不像参考音频,可以尝试:
-
优化参考音频
- 确保音频清晰无噪音
- 长度控制在5-8秒最佳
- 说话人情感自然,不要夸张
-
填写参考文本
- 即使可选,也尽量填写准确的参考文本
- 这能帮助模型更好地对齐音色特征
-
多次尝试
- 换不同的随机种子值
- 尝试不同的参考音频片段
- 有时候同一段音频,截取不同的3秒片段,效果都不一样
4.3 生成的音频有杂音或断句奇怪?
这可能是因为:
-
参考音频问题
- 检查是否有背景噪音
- 确保是纯人声,没有音乐或其他声音
-
文本问题
- 检查标点符号是否正确
- 避免过长的句子,适当添加逗号分隔
- 对于专业术语,考虑使用音素控制
-
参数问题
- 尝试更换采样方法(从ras换成greedy或topk)
- 调整随机种子值
4.4 显存不够用?
GLM-TTS对显存的要求:
- 24kHz模式:约8-10GB
- 32kHz模式:约10-12GB
如果显存不足:
- 使用24kHz模式
- 缩短单次生成的文本长度
- 生成完成后点击“清理显存”按钮释放资源
- 考虑使用CPU模式(但速度会很慢)
4.5 支持哪些语言?
目前GLM-TTS主要支持:
- ✅ 中文(普通话):效果最好
- ✅ 英文:效果不错
- ✅ 中英混合:可以处理,但建议以一种语言为主
- ⚠️ 方言:通过参考音频可以模仿部分方言,但效果可能不如普通话稳定
如果你需要其他语言支持,可能需要寻找专门的模型或等待后续更新。
5. 实际应用场景与案例
了解了怎么用之后,我们来看看GLM-TTS能在哪些地方派上用场。我根据自己的使用经验,总结了几类最实用的应用场景。
5.1 内容创作:让创作更高效
视频配音 以前我做教学视频,要么自己录音(普通话不标准),要么请人配音(成本高)。现在用GLM-TTS,我可以:
- 找一段喜欢的配音演员样音作为参考
- 写好视频脚本
- 批量生成所有片段的配音
- 导入剪辑软件直接使用
有声书制作 如果你是个作家,想把自己的作品做成有声书:
- 选择合适的声音(温柔的女声讲故事,活泼的男声讲对话)
- 将章节文本批量处理
- 生成高质量的音频文件
- 甚至可以制作多版本(不同朗读风格)
播客节目 单人播客觉得单调?可以用GLM-TTS:
- 用你自己的声音作为主声音
- 用其他人的声音作为“嘉宾”或“采访对象”
- 创造多角色对话效果
5.2 企业应用:提升效率与体验
智能客服升级 传统的客服语音很机械,用户体验差。用GLM-TTS可以:
- 用优秀客服代表的录音作为参考
- 生成自然、有温度的自动回复
- 根据用户情绪调整语音语调(高兴时轻快,投诉时沉稳)
产品演示视频 为软件或产品制作演示视频时:
- 统一所有视频的配音音色
- 快速更新内容(修改文本重新生成即可)
- 制作多语言版本(用不同语言的参考音频)
企业内部培训 制作培训材料时:
- 用领导或专家的声音制作标准培训内容
- 确保所有员工听到的是同一标准的内容
- 方便更新和迭代
5.3 个人与创意用途
语音助手个性化 如果你有自己的智能家居或语音助手:
- 用家人或朋友的声音定制唤醒词和回复
- 让语音助手更有亲切感
游戏开发 独立游戏开发者可以用GLM-TTS:
- 快速生成NPC对话
- 测试不同声音效果
- 降低配音成本
纪念品制作 用已故亲人的老录音作为参考:
- 生成新的语音内容(如生日祝福、节日问候)
- 制作有特殊意义的语音纪念品
5.4 我的实际使用案例
我最近用GLM-TTS做了一个小项目:为我的技术教程视频系列生成配音。
之前的方式:
- 自己录音:每次要找个安静的时间,状态不好还得重录
- 请人配音:成本高,沟通麻烦,修改不便
- 用其他TTS:声音机械,观众反馈不好
现在的方式:
- 我找了一段专业播音员的公开录音(10秒)
- 将所有视频脚本整理成文本文件
- 用批量推理功能一次性生成所有音频
- 导入剪辑软件,与视频画面同步
效果对比:
- 时间:从每集2小时录音+剪辑,缩短到10分钟生成+导入
- 成本:从每集几百元配音费,降到几乎为零
- 质量:观众反馈“声音更专业了,听着舒服”
- 灵活性:发现错误或需要更新时,修改文本重新生成即可
最让我惊喜的是,有观众留言问:“你们是请了专业的配音老师吗?”——他们完全没听出来是AI生成的。
6. 总结与建议
通过上面的介绍,你应该已经掌握了GLM-TTS的基本用法和进阶技巧。这个工具最吸引我的地方,就是它在易用性和效果之间找到了很好的平衡——不需要深厚的AI背景,也不需要复杂的配置,就能获得专业级的语音合成效果。
6.1 给新手的快速入门建议
如果你刚刚接触GLM-TTS,我建议按这个顺序来:
-
第一步:快速体验
- 用默认设置,随便找一段清晰的人声音频
- 输入简短的文本(比如“你好,欢迎使用GLM-TTS”)
- 点击生成,听听效果
-
第二步:优化效果
- 尝试不同的参考音频,找到效果最好的
- 调整采样率(24kHz vs 32kHz)
- 试试不同的随机种子值
-
第三步:实际应用
- 选择一个具体的应用场景(比如视频配音)
- 准备高质量的参考音频
- 用批量功能处理实际内容
-
第四步:探索高级功能
- 尝试音素控制解决多音字问题
- 用情感丰富的参考音频生成带感情的语音
- 探索流式推理等更高级的功能
6.2 一些实用的小贴士
建立自己的音频库 我发现,建立一个“优质参考音频库”特别有用。每次遇到声音好听、清晰的录音,就保存下来,标注好特点(比如“沉稳男声-新闻播报”、“温柔女声-故事讲述”)。这样下次需要时,可以直接从库里选。
分段处理长文本 对于很长的文本(比如整篇文章),不要一次性输入。分成几个段落,每段200字左右,分别生成后再拼接。这样不仅效果更好,如果某一段不满意,也只需要重新生成那一段。
记录最佳参数 当你找到一组效果特别好的参数组合(比如某个随机种子值、某个采样方法),记得记录下来。下次类似的任务可以直接用这组参数,保证效果一致。
定期清理输出文件 GLM-TTS默认把生成的音频保存在@outputs/目录,时间长了会占用不少空间。建议定期清理,或者修改输出路径到其他位置。
6.3 最后的思考
AI语音合成技术正在以惊人的速度发展。几年前,TTS还只能生成那种机械的、一听就是机器人的声音。现在像GLM-TTS这样的工具,已经能做到以假乱真了。
但这只是开始。随着技术的进步,未来的语音合成会更加自然、更加智能。也许不久后,我们就能定制出完全符合个人特色的“数字声音”,或者让历史人物的声音“复活”,或者创造出全新的、现实中不存在的声音。
对于普通用户来说,最重要的是这些技术变得触手可及。像GLM-TTS这样的开源项目,加上CSDN星图镜像广场这样的一键部署平台,让每个人都能用上最先进的AI工具。无论你是内容创作者、开发者,还是只是对技术好奇的爱好者,现在都是尝试的好时机。
技术最大的价值,是让人人都能创造。GLM-TTS降低了语音合成的门槛,让更多人有能力制作高质量的音频内容。这本身就是一件很有意义的事情。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。
更多推荐


 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)