
实战指南:在快马平台构建基于openclaw的完整图像分类项目配置
最近在做一个图像分类的项目,选用了OpenCLIP家族中一个轻量高效的变体——openclaw模型。说实话,模型本身很强大,但要把它的潜力完全发挥出来,配置是关键。网上的教程要么太理论,要么配置散乱,很难直接套用到自己的数据和任务上。这次我决定在InsCode(快马)平台上,从零开始构建一个针对CIFAR-10数据集的完整实战项目,把配置、训练、评估都串起来,形成一个清晰可复用的模板。
-
项目规划与结构设计。我的核心目标是“配置与代码分离”,让项目结构清晰,方便后续调整超参数或更换数据集。因此,我规划了以下几个核心模块:一个独立的配置文件,专门存放所有可调整的参数;一个数据加载模块,负责数据的预处理和增强流水线;一个训练脚本,负责读取配置、初始化模型并执行训练循环;一个评估脚本,用于模型性能的定量和定性分析。这样的结构避免了参数硬编码在代码里,修改实验设置时只需要动配置文件,大大提升了效率。
-
核心:针对CIFAR-10的配置文件精调。OpenCLIP类模型通常在大规模图像-文本对(如LAION)上预训练,直接迁移到CIFAR-10这样的小尺寸(32x32)、类别少的数据集上,需要做针对性调整。在配置文件中,我主要聚焦几个方面。首先是数据增强,CIFAR-10图像小,过度裁剪或大角度旋转可能丢失关键信息,我采用了适度的随机水平翻转、小幅度的随机裁剪和颜色抖动,在增强数据多样性的同时避免破坏原有特征。其次是模型适配,虽然openclaw本身结构高效,但针对CIFAR-10,我调整了模型输入通道以适应RGB图像,并微调了分类头的输出维度为10类。最后是优化策略,我选择了带权重衰减的AdamW优化器,并设置了分阶段学习率衰减计划,在训练初期用较高学习率快速收敛,后期降低学习率精细调优,同时设置了合适的批次大小以平衡训练速度和GPU内存占用。
-
构建稳健的数据预处理流水线。数据是模型训练的基石。我编写的数据加载代码严格遵循配置文件的设定。流程上,先对训练集图像应用配置中定义的一系列增强操作(如翻转、裁剪、颜色扰动),然后进行标准化处理(减去均值、除以标准差,这里使用了CIFAR-10数据集的通用统计值)。对于验证集和测试集,则只进行中心裁剪和相同的标准化,不应用随机增强,以确保评估的公平性。这个流水线通过PyTorch的
Dataset和DataLoader封装,实现了高效的数据加载和批处理,并且完全由配置文件驱动,更换数据集时只需修改配置中的路径和预处理参数即可。 -
训练脚本:集成配置读取与完整训练循环。训练脚本是这个项目的“发动机”。它首先解析我们写好的配置文件,将所有超参数加载进来。接着,根据配置初始化openclaw模型,并加载预训练权重(如果配置指定),这能加速收敛。然后,脚本构建数据加载器、定义损失函数(交叉熵损失)和优化器。训练循环部分包含了标准的迭代过程:前向传播计算预测和损失,反向传播计算梯度,优化器更新模型参数。关键的是,我在每个训练周期(epoch)结束后,都在独立的验证集上评估模型性能,并保存验证准确率最高的模型检查点。脚本还会记录训练损失和验证准确率的变化,方便后续分析。
-
模型评估与结果可视化。训练完成后,不能只看最终的准确率数字。我专门写了一个评估脚本。它的核心功能是加载训练阶段保存的最佳模型,在完全未参与训练的测试集上进行最终评估。除了计算整体的分类准确率,我还计算了每个类别的精确率、召回率和F1分数,生成详细的分类报告,这能帮助我们发现模型在哪些类别上表现好或差。更进一步,我使用
matplotlib库将评估结果可视化:绘制了训练损失和验证准确率随epoch变化的曲线图,直观展示模型的学习过程;生成了混淆矩阵的热力图,清晰揭示模型主要的错误分类发生在哪些类别之间。这些图表对于分析和诊断模型行为至关重要。 -
项目整合与可扩展性思考。将以上所有模块整合在一起,就形成了一个端到端的图像分类项目。它的优势在于高度模块化。如果你想尝试不同的数据增强组合,或者调整模型的学习率、权重衰减等超参数,只需修改配置文件中的几行,重新运行训练脚本即可,无需触碰核心代码。未来,如果要将此项目应用于自己的花卉分类、车辆识别等任务,主要工作就是准备新数据集,并相应调整配置文件中的数据路径、类别数和可能的图像尺寸,整个训练和评估框架可以完全复用。
整个项目从构思到跑通,最深的体会是,一个清晰、配置驱动的项目结构能极大提升实验和迭代的效率。而这次实践,我是在InsCode(快马)平台上完成的。它最让我省心的地方在于,不需要在本地折腾Python环境、PyTorch版本还有CUDA驱动那些繁琐的配置。平台提供了一个开箱即用的编码环境,我直接就能开始写配置和代码。
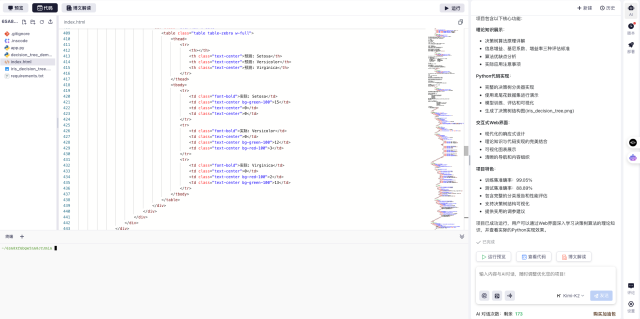
更棒的是,由于我这个项目最终会生成一个可以持续运行的训练和评估程序(而不是一次性脚本),平台提供的“一键部署”功能就派上了用场。这意味着,我不光能在开发环境里测试,还能把这个完整的项目快速部署成一个可随时访问和运行的实例,方便分享给同事查看效果,或者作为一个小型演示服务。
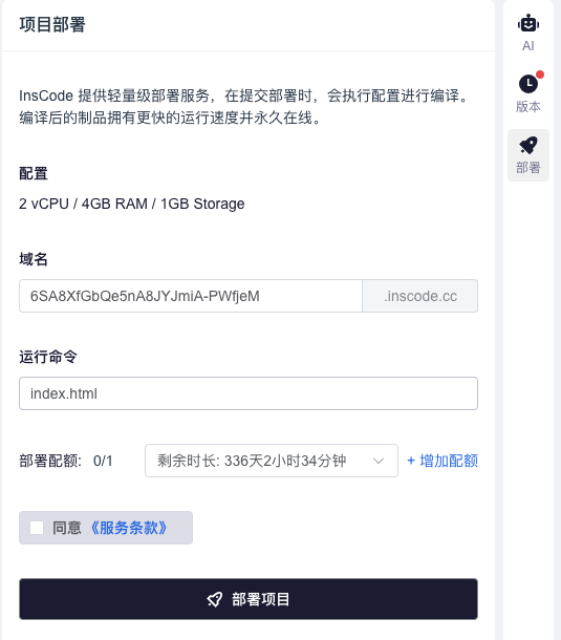
对于想快速验证模型配置方案或者学习机器学习项目搭建的朋友来说,这种从编码到部署的流畅体验,确实能让人更专注于算法和逻辑本身,而不是环境配置这些“脏活累活”。如果你也对基于openclaw或类似模型构建应用感兴趣,不妨试试用这个思路来组织你的下一个项目。
更多推荐


 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)