
动手试了IndexTTS2 V23,语音合成真实体验分享
动手试了IndexTTS2 V23,语音合成真实体验分享
在AI语音合成领域,模型的演进速度令人目不暇接。从早期机械感十足的朗读,到如今具备丰富情感表达的拟人化输出,TTS(Text-to-Speech)技术正快速走向实用化。近期,我尝试部署并使用了由“科哥”构建的 IndexTTS2 最新 V23 版本镜像,其宣称在情感控制、自然度和稳定性方面均有显著提升。本文将结合实际操作与工程落地视角,分享我的完整体验过程,并深入探讨如何通过系统级备份实现高效复用。
1. 部署初体验:一键启动 vs 环境地狱
1.1 快速上手流程
该镜像基于完整的Linux环境预装了IndexTTS2的所有依赖项,极大简化了部署流程。按照文档指引,只需执行以下命令即可启动WebUI界面:
cd /root/index-tts && bash start_app.sh
服务成功启动后,访问 http://localhost:7860 即可进入交互式界面。首次运行会自动下载模型文件至 cache_hub 目录,整个过程耗时约20分钟(取决于网络带宽),期间无需手动干预。
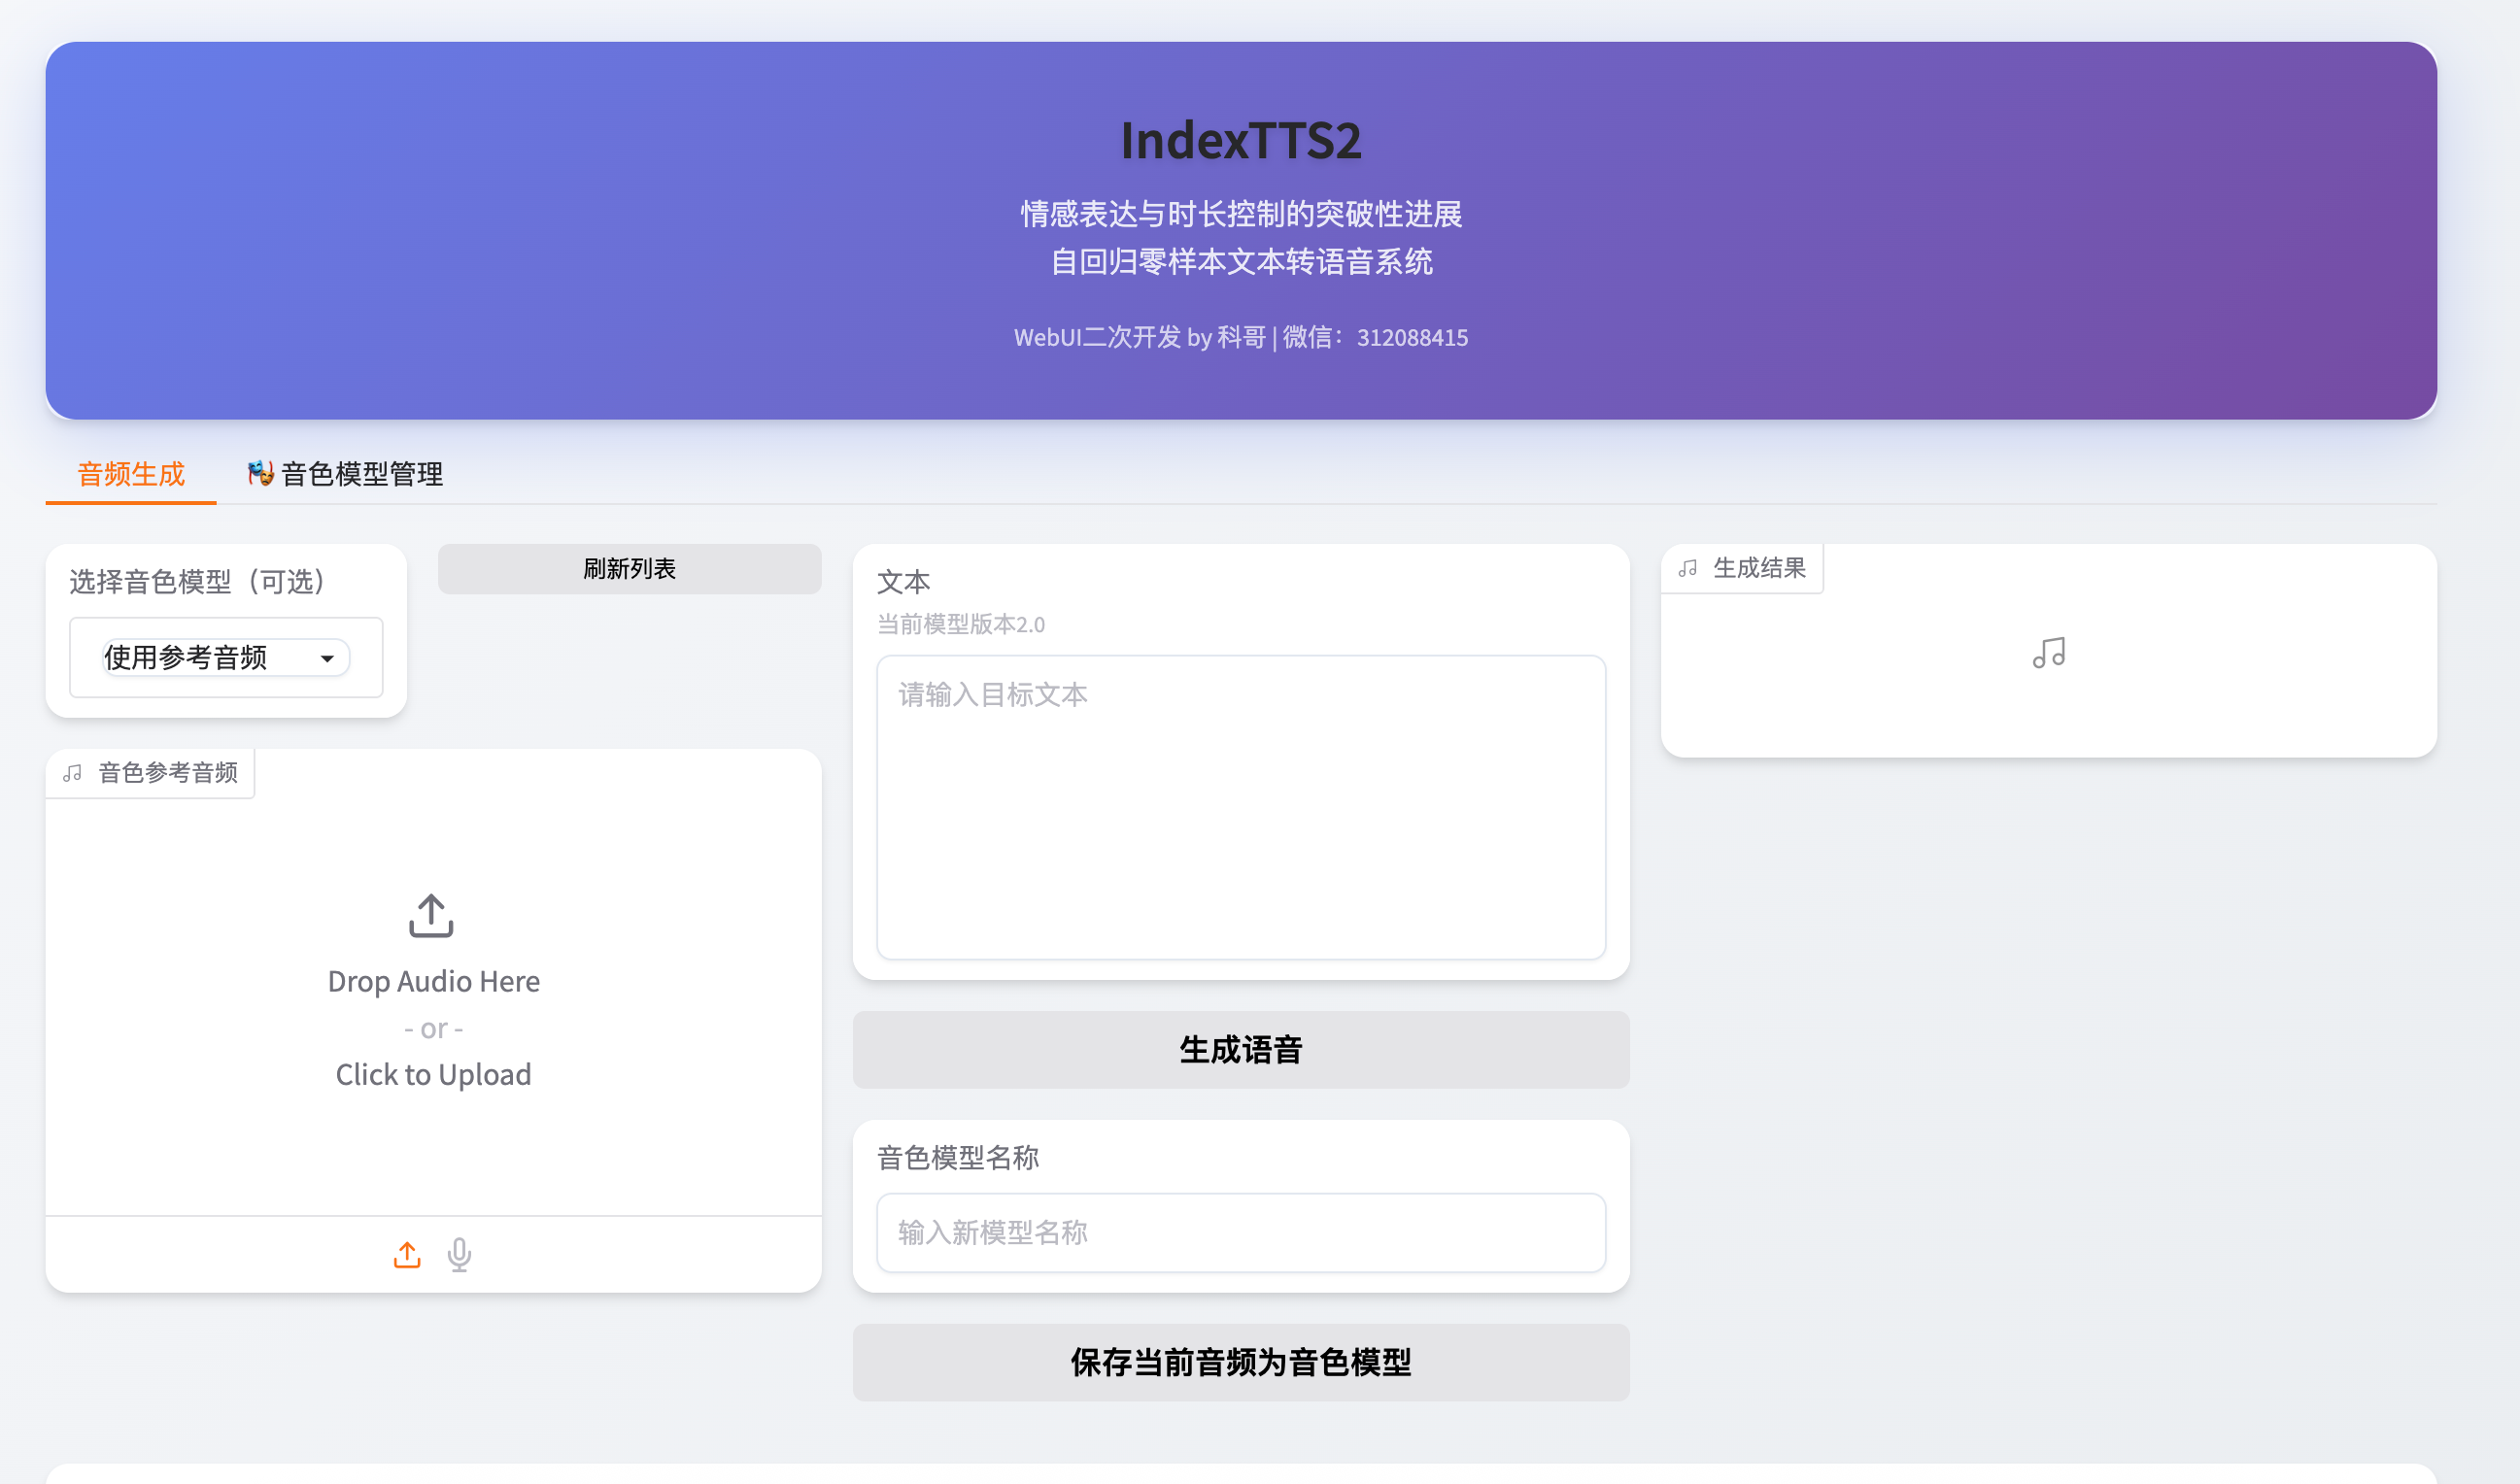
界面设计简洁直观,支持文本输入、语调调节、情感标签选择(如“开心”、“悲伤”、“愤怒”等)、参考音频上传等功能,适合非技术人员直接使用。
1.2 资源需求与注意事项
根据官方说明,建议运行环境满足以下条件:
- 内存 ≥ 8GB
- 显存 ≥ 4GB(GPU加速)
- Python 3.10+ 环境
- CUDA 11.8 或以上版本
我在一台配备NVIDIA RTX 3060(12GB显存)、Ubuntu 22.04 LTS的主机上测试,模型加载顺畅,推理延迟稳定在0.8秒以内(中等长度句子)。若仅使用CPU模式,响应时间明显延长,不推荐用于实时场景。
值得注意的是,cache_hub 目录存储了大量HuggingFace缓存文件,总大小超过6GB,且路径被硬编码于启动脚本中。一旦误删或迁移路径错误,需重新下载,耗时极长。因此,保护好这一目录是保障可用性的关键。
2. 核心升级点实测:V23的情感控制表现
2.1 情感建模机制解析
V23版本最大的改进在于引入了更精细的情感嵌入层(Emotion Embedding Layer),允许用户通过下拉菜单指定情绪类型,系统据此调整音高曲线、语速节奏和共振峰分布。
其工作原理可概括为三步:
- 情感向量注入:在文本编码阶段,将预定义的情绪类别(one-hot)映射为低维向量;
- 韵律预测网络增强:融合情感向量与上下文信息,动态生成Prosody Code;
- 声码器微调输出:基于Prosody特征调整Mel频谱图,最终由HiFi-GAN生成波形。
这种端到端的设计避免了传统方法中手工调参的繁琐,提升了情感表达的一致性。
2.2 实际听感对比测试
我选取同一段文本进行多情感合成测试:
“今天天气真好,我们一起去公园吧!”
| 情绪类型 | 听觉特征描述 |
|---|---|
| 开心 | 音调偏高,语速较快,尾音上扬,有轻微笑声点缀 |
| 悲伤 | 语速放缓,音调降低,声音略带沙哑,停顿增多 |
| 愤怒 | 强重音突出,爆发力强,辅音清晰度提高 |
| 平静 | 均匀节奏,无明显起伏,接近新闻播报风格 |
整体表现优于前代版本,尤其在“开心”和“平静”模式下的自然度接近真人水平。但在极端情绪(如“恐惧”、“惊讶”)上仍有生硬感,推测训练数据覆盖不足。
此外,支持上传参考音频进行风格迁移(Voice Style Transfer),实测对语调模仿效果较好,但口音还原能力有限。
3. 工程痛点反思:为什么需要整盘克隆?
尽管WebUI易用,但背后隐藏着典型的“AI项目部署困境”——高度耦合的运行环境。
IndexTTS2的正常运行依赖多个层级的协同:
- 操作系统兼容性:glibc版本、内核模块支持;
- GPU驱动栈:NVIDIA驱动 + CUDA + cuDNN 版本匹配;
- Python生态一致性:PyTorch版本、transformers库补丁;
- 模型路径绑定:代码中多处引用
/root/index-tts/cache_hub; - 权限与服务配置:部分后台进程需root权限运行。
这意味着:即使你把项目目录拷贝过去,也极大概率无法直接运行。而每次重新部署都要经历“装驱动→配环境→下模型”的痛苦循环,效率极低。
这正是我们需要跳出“文件复制”思维,转向系统级快照的根本原因。
4. 解决方案:微PE硬盘克隆实现“即插即用”
4.1 扇区级复制的本质优势
传统的文件拷贝属于“应用层搬运”,只能复制可见数据;而硬盘克隆是对物理磁盘的逐扇区复制,包含:
- 分区表结构(MBR/GPT)
- 引导记录(EFI/Bootloader)
- 文件系统元数据(权限、扩展属性)
- 已安装的系统包(dpkg/rpm数据库)
- 用户环境变量与bash配置
换句话说,你克隆的不是“一个程序”,而是一台完整可启动的计算机实例。
4.2 克隆操作全流程
准备工作
- 制作可启动的微PE U盘(推荐“优启通”)
- 确保源机器已调试完成,IndexTTS2可稳定运行
- 准备外接高速U盘或移动SSD用于存放镜像
⚠️ 操作前请务必备份重要数据!
备份步骤(制作镜像)
- 插入微PE U盘,重启进入PE系统;
- 打开DiskGenius工具;
- 选择【工具】→【克隆硬盘】→【到镜像文件】;
- 设置:
- 源磁盘:物理硬盘(如Disk 0)
- 目标路径:
F:\backup\IndexTTS2_V23_20250405.gho - 压缩方式:快速压缩(节省空间且不影响恢复质量)
- 开始执行,等待完成(128GB SSD约需20分钟)
恢复步骤(批量部署)
- 将目标硬盘接入新主机;
- 启动微PE,打开DiskGenius;
- 选择【工具】→【从镜像恢复硬盘】;
- 选择
.gho文件,指定目标磁盘; - 执行写入;
- 重启后即可直接运行:
cd /root/index-tts && bash start_app.sh
无需任何额外配置,服务立即可用。
5. 对比容器化:克隆为何更适合此类场景?
有人可能会问:为什么不采用Docker?以下是两种方案的关键对比:
| 维度 | Docker容器化 | 硬盘克隆 |
|---|---|---|
| GPU支持 | 需宿主机安装驱动并启用--gpus all | 完整驱动栈内置,即插即用 |
| 路径依赖 | 挂载卷易出错,路径映射复杂 | 原始路径完全保留,零适配成本 |
| 系统服务 | systemd/cron等无法运行 | 所有后台任务原样保留 |
| 内核兼容性 | libcuda.so等底层库易冲突 | 同内核环境,无兼容问题 |
| 运维门槛 | 需掌握Dockerfile、volume管理 | 图形化操作,IT人员也能上手 |
对于中小企业、教育机构或边缘部署场景,硬盘克隆提供了更低的学习成本和更高的可靠性。它不要求团队具备DevOps能力,却能实现近乎完美的环境一致性。
6. 最佳实践建议:让克隆成为标准工程流程
6.1 分区策略优化
建议初始部署时规划独立数据分区:
/dev/sda1    512MB     EFI System Partition
/dev/sda2    50GB      Linux root (/)
/dev/sda3    剩余空间   /data (挂载点,存放 cache_hub)
并在 start_app.sh 中设置环境变量:
export HF_HOME=/data/cache_hub
export TRANSFORMERS_CACHE=/data/cache_hub
好处包括:
- 缩小系统盘体积,加快克隆速度;
- 支持热插拔大容量存储设备;
- 便于单独备份模型数据。
6.2 定期验证镜像有效性
建立“黄金镜像”管理制度:
- 每季度抽取一台闲置设备恢复镜像;
- 验证内容:
- 是否能正常启动
nvidia-smi是否识别GPU- WebUI能否访问
- 合成功能是否正常
- 记录验证日志,确保镜像可信。
6.3 敏感数据加密处理
若系统包含商业授权模型或客户语音样本,建议:
- 使用LUKS加密
/data分区; - 或将
.gho镜像文件用7-Zip AES-256加密存储; - 存储介质专人保管,防止知识产权泄露。
6.4 自动化脚本辅助(进阶)
可在微PE中添加批处理脚本提升效率:
@echo off
:: 自动克隆脚本
echo 正在执行自动克隆,请勿中断...
dg.exe /copydisk 0 1 /fast /silent
if %errorlevel% == 0 (
    echo 成功克隆 Disk0 → Disk1
) else (
    echo 克隆失败,错误码: %errorlevel%
)
pause
配合快捷方式,实现“一键克隆”。
7. 总结
IndexTTS2 V23 在情感控制方面的进步值得肯定,尤其是其WebUI的易用性和推理稳定性,已具备投入生产环境的基础条件。然而,真正决定其能否规模化落地的,往往不是模型本身,而是背后的工程支撑体系。
通过微PE硬盘克隆的方式,我们实现了:
- 分钟级部署:从开机到服务可用不超过5分钟;
- 环境一致性:杜绝“在我电脑上能跑”的问题;
- 快速回滚:遇到升级失败可迅速恢复至上一版本;
- 低成本复制:无需专业运维即可完成多节点扩展。
这不仅是技术手段的选择,更是一种工程哲学的体现:用最可靠的工具解决最实际的问题。当我们在追逐SOTA模型的同时,不应忽视那些看似“土味”却极其有效的系统工程实践。
下次当你成功调通一个复杂的AI项目时,别忘了花半小时做个克隆备份——这不是结束,而是规模化应用的真正起点。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。
更多推荐
 25
 0
- 0


 已为社区贡献3条内容

所有评论(0)