
【力扣】反转链表题解:5种方法深度解析
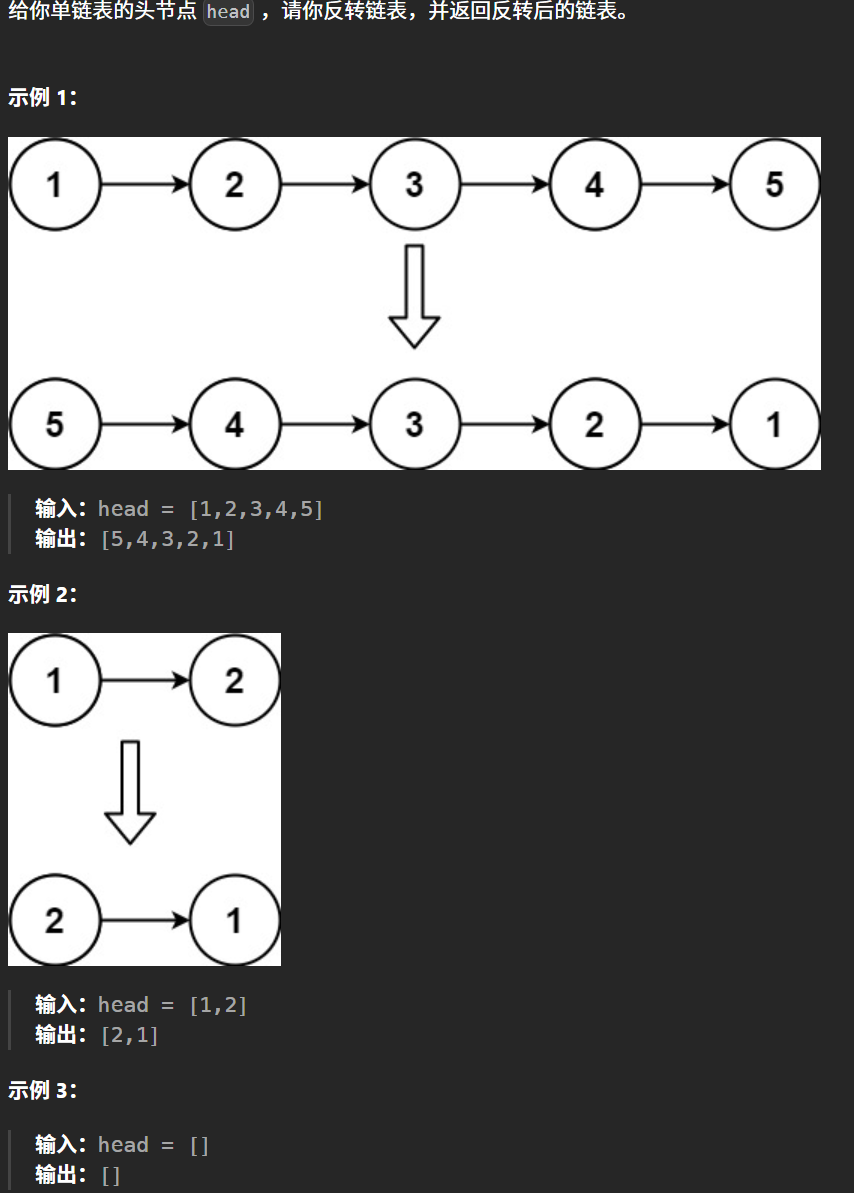
代码
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     struct ListNode *next;
 * };
 */
struct ListNode* reverseList(struct ListNode* head) {

}
解法一:迭代法
什么是迭代?
迭代是通过循环进行“重复”的过程,每次重复都基于上一次的结果,逐步推进,直到达到我们的目标。
而这道题的反转链表从图上看,就是对箭头方向调转操作的一个重复,就像1->2到2->1,2->3到3->2 ……
即将当前节点的next指针指向前一个节点,翻转后,为了能找到当前节点的下一个节点,我们需要一个指针保存它,所以
指针:prev,curr,next
-
初始化prev为NULL,curr为head
-
遍历链表,直到curr为NULL
next=curr->next保存下一个节点curr->next=prev当前节点指针prev=curr移动prev到当前节点curr=next移动curr到下一个节点 -
返回prev,即新的头节点
struct ListNode* reverseList(struct ListNode* head) {
    //这是个人习惯:写不惯struct,所以习惯性重命名为Node
    typedef struct ListNode Node;

    //可写可不写,后面代码的判断包括它
    if(head==NULL||head->next==NULL) return head;

    Node*prev=NULL;
    Node*curr=head;
    Node*next;
    while(curr!=NULL){
        //保存下一个节点
        next=curr->next;
        //反转指针
        curr->next=prev;
        //移动指针
        prev=curr;
        curr=next;
    }
    return prev;
}
记录:
我原来的代码是最初让
prev=head,但最后需要将head->next置为空其实就等价于现在的
prev=NULL
以上就是我们最常见的迭代三指针法,但是我们总会听到“简化迭代法,使用双指针”,是什么意思呢?
其实就是把next指针放进while循环内部声明,所以在循环外部我们只声明了prev和curr两个指针,所以是双指针
但本质上都是双指针反转prev、curr,一指针保存next
解法二:头插法
什么是头插?
顾名思义,向链表头部插入元素
由于每次都插入在链表头部,所以如果以1 2 3 的顺序插进去,就会以3 2 1的顺序排列,从而实现链表反转
所以这道题的原理为:创建新链表,将原链表每个节点依次插入新链表头部
1.不使用虚拟头节点
步骤:
- 保存原链表的下一个节点
next - 将当前节点
curr插入到新链表头部prev - 更新 新链表头指针
- 移动到原链表的下一个节点
代码实现:
struct ListNode* reverseList(struct ListNode* head) {
    typedef struct ListNode Node;
    Node*curr=head;//要插入的节点
    Node*prev=NULL;//新链表头部
    Node*next;//下一次要插入的节点
    while(curr){
        next=curr->next;//1.
        curr->next=prev;//2.
        prev=curr;//3.
        curr=next;//4.
    }
    return prev;
}
重大发现!!!
这段代码和我们上方写的迭代法一模一样!!
这是为什么呢?
两种算法的本质是相同的:
- 都是逐个节点处理
- 都是将节点从原链表“移动”到反转后的链表
- 只是概念框架和解释角度不同
这体现算法理解的深度:算法的分类更多是基于概念的理解而非具体实现
同一段代码,既可以理解为“三指针迭代法”,也可以被理解为“头插法”,这取决于我们用什么角度去解释它
当我们能从一个算法中看到多种模式,说明我们真正理解了它的本质
2.使用虚拟头节点
既然是头插法,那一定可以使用虚拟头节点:将节点插入在虚拟头节点后面
但这道题虚拟头节点没有简化什么,如果你仔细看的话,就是把所有的prev都替换为dhead->next
struct ListNode*reverseList(st0ruct ListNode* head){
    typedef struct ListNode Node;
    Node*dhead=(Node*)malloc(sizeof(Node));
    Node*curr=head;
    Node*next;
    while(curr){
        next=curr->next;
        curr->next=dhead->next;
        dhead->next=curr;
        curr=next;
    }
    Node*newhead=dhead->next;
    free(dhead);
    return newhead;
}
解法三:递归法1
什么是递归?
一个函数通过“自己调用自己”(递归步骤)
将一个大问题分解成一个个相同的小问题,不断**“递”下去(即将原问题分解为一个更小的同类子问题**)
直到遇到一个最简单、不需要再分解的情况(基准情况)
然后带着答案再一层层**“归”**回来,最终解决原始问题的方法
回到这道题:
-
递归步骤:
将链表分为两部分:第一个节点和剩余的链表
然后递归的反转剩余的链表,并将第一个节点连接到反转后链表的末尾
-
基准情况:链表为空或只有一个节点,返回头节点
-
总结:
递:我们将大问题“反转链表”,分解为子问题“反转一个更短的链表”,直到基准情况“链表只剩一个节点或为空”‘**
归:连接反转的短的链表
struct ListNode*reverseList(struct ListNode*head){
    if(head==NULL||head->next==NULL) return head;
    Node*newhead=reverseList(head->next);
    head->next->next=head;
    head->next=NULL;
    return newhead;//返回结果:新头节点一直传递上去
}
我们会发现,递归解法的代码是非常简洁的,但感觉自己读不懂。
那是因为函数(自己)里面还调用了函数(自己),我们不能向普通代码一样,从头到尾逐行进行阅读分析。
它涉及到递归的调用栈:每一次的reverseList(head->next),都是一次递归调用函数
用1->2->3->NULL的例子来理解:
第一步:递
reverseList(1)调用
↓ 进入reverseList(2)
↓ 进入reverseList(3)
(基准情况)返回 33次函数调用,按照1 2 3的顺序进入栈
函数调用栈中表现为
栈顶:
reverseList(3)- 马上返回 3
中间:reverseList(2)
底层:reverseList(1)
根据栈“先进后出”的特点,接下来会按栈顶->中间->底层的顺序跳出
第二步:归
1.reverseList(3)
// 输入: 3 -> NULL
if(head==NULL||head->next==NULL) return head;//条件满足,直接返回
结果:链表为3->NULL,返回3
2.reverseList(2)
// 输入: 2 -> 3 -> NULL
if(head==NULL||head->next==NULL) return head;//条件不满足,继续

//关键:我们已经知道reverseList(3)返回3了
Node*newhead=reverseList(head->next);//newhead=3

//此时链表状态:2->3 (3的next在递归中已被设为NULL)

head->next->next=head;//3->2
head->next=NULL;//3->2->NULL

return newhead;//返回3
结果:链表为3->2->NULL,返回头节点3
3.reverseList(1)
// 输入: 1 -> 2 -> 3 -> NULL
if(head==NULL||head->next==NULL) return head;//条件不满足,继续

//关键:我们已经知道reverseList(2)返回3了
Node*newhead=reverseList(head->next);//newhead=3

//此时链表状态:1->2 (2的next在递归中已被设为NULL)
//			3->2->NULL (已反转好的部分)

head->next->next=head;//3->2->1
head->next=NULL;//断开1->2,使得3->2->1->NULL

return newhead;//返回3
结果:链表为3->2->1->NULL
但是当我们想写出递归代码时,不要试图在大脑中模拟整个递归的调用栈,而是:
- 理解基准情况
- 相信递归调用能解决子问题
- 只关注当前层需要做什么来处理递归调用结果
举例:
1.基准情况:最小问题,直接解决
if(head==NULL||head->next==NULL) return head;
2.相信递归:它能反转剩余的部分,返回新头节点
Node*newhead=reverseList(head->next);
3.当前任务:把当前节点接到已反转链表的尾部
 head->next->next=head;
 head->next=NULL;
这个最难理解,我再详细解析下:
在递归调用中,我们假设递归调用
reverseList(head->next)已经成功返转了从head->next开始的子链表,并返回了反转后的头节点。然后我们只需要将当前节点head接在已反转子链表的尾部(原来head->next这个节点在反转后变成子链表的尾节点,所以我们通过head->next->next=head来将head接上去),然后断开head原来的next指针(防止形成环)
OK,我们来总结下:
1.递归是什么
2.递归的底层逻辑是什么或本质上递归代码的阅读顺序(即从函数调用栈的角度)
3.平时我们怎样读懂别人写的递归代码或怎样自己写出递归代码(即上方3点)
解法四:递归法2—尾递归
什么是尾递归?
看名字就知道,它和递归的区别在于尾字,尾表示递归调用是函数的最后一步操作
尾递归的核心思想本质上是迭代,但以递归的形式表达
对于这道题:
本质是迭代:我们上方说迭代就是对箭头方向调转操作的一个重复,这里我们也是一个一个箭头反转
以递归的形式表达:函数里面套函数,函数的返回值之前的反转结果
以1->2->3为例:
1.第一次调用:reverse(NULL,1)
保存temp=2
使得1->NULL
返回/调用reverse(1,2)
2.第二次调用:reverse(1,2)
保存temp=3
使得2->1
返回/调用reverse(2,3)
3.第三次调用:reverse(2,3)
保存temp=NULL
使得3->2
返回/调用reverse(3,NULL)
4.第四次调用:reverse(3,NULL)
返回prev=3
typedef struct ListNode Node;

Node*reverse(Node*prev,Node*curr){
    if(curr==NULL) return prev;
    Node*temp=curr->next;
    curr->next=prev;
    return reverse(curr,temp);
}

Node*reverseList(Node*head){
    return reverse(NULL,head);
}
解法五:辅助栈
什么是栈?
栈是一种数据结构,满足先进后出的特性
如果按照1 2 3的顺序进入栈,那他们出栈的顺序就是3 2 1,刚好实现了反转
对于这道题,我们让节点依次进栈,然后在依次弹出栈中的节点,并连接它们
- 步骤:
- 如果链表为空或只有一个节点,直接返回原链表头
- 创建一个栈
- 遍历链表,将每个节点的指针压入栈
- 从栈中弹出的第一个节点为新链表头节点
- 依次弹出后续节点,并连接
- 将最后一个节点的next赋为NULL,避免形成环
- 代码实现:
#define MAXSIZE 5002
typedef struct ListNode Node;
typedef struct Stack{
    Node*data[MAXSIZE];
    int top;
}Stack;
struct ListNode*reverseList(struct ListNode*head){
    if(head==NULL) return head;
    Stack s;
    s.top=-1;

    //进栈
    Node*curr=head;
    while(curr!=NULL){
        s.data[++s.top]=curr;
        curr=curr->next;
    }

    //新链表头节点
    Node*newhead=s.data[s.top--];
    curr=newhead;

    //出栈并连接
    while(s.top>=0){
        curr->next=s.data[s.top--];
        curr=curr->next;
    }

    //将最后一个节点的next赋空,避免形成环
    curr->next=NULL;

    return newhead;
}
总结
本文详细介绍了反转链表的五种经典解法
- 迭代法:最直观易懂,使用双/三指针逐步反转,时间复杂度O(n),空间复杂度O(1)
- 头插法:概念上创建新链表,实际实现与迭代法相同,体现了算法理解的深度
- 递归法:代码简洁但理解困难,需要理解递归调用栈,空间复杂度O(n)
- 尾递归法:迭代思想的递归表达
- 辅助栈法:利用栈的先进后出特性,思路直观但需要额外空间
通过同一问题的多种解法,不仅掌握了反转链表的具体实现,更重要的是培养了从不同角度理解算法本质的能力,这种思维方式对于解决更复杂的算法问题具有重要意义。
更多推荐


 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)