
数据库基础之深入SQL查询函数and正则表达式(二)
本篇文章主讲mysql相关的查询函数以及正则表达式,如果需要看其他的数据库相关请查看我往期帖子
只用数据库对数据库(mysql)以及表进行操作https://mp.csdn.net/mp_blog/creation/editor/154543591
数据库基础之深入SQL查询语句(一)
https://mp.csdn.net/mp_blog/creation/editor/154543591
1.带你们从头开始演示一遍
连接一下数据库
mysql -u root -p接着输入密码
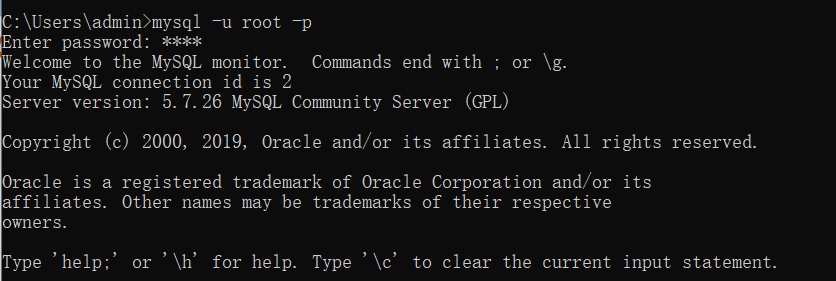
查询当前有哪些数据库
show databases;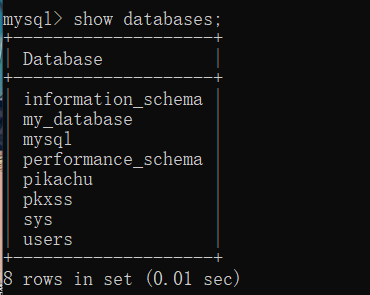
我这边有一个users数据库,直接进入就可以,不知道如何创建数据库等操作的请看文章开头连接,移至往期文章。
进入users数据库
use users;
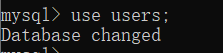
这样表示进入成功了
然后查询一下这个数据库有哪些表
SHOW TABLES;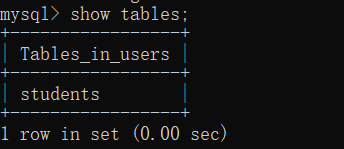
我这里只有一个students表,查看一下表的内容看看
SELECT * FROM students;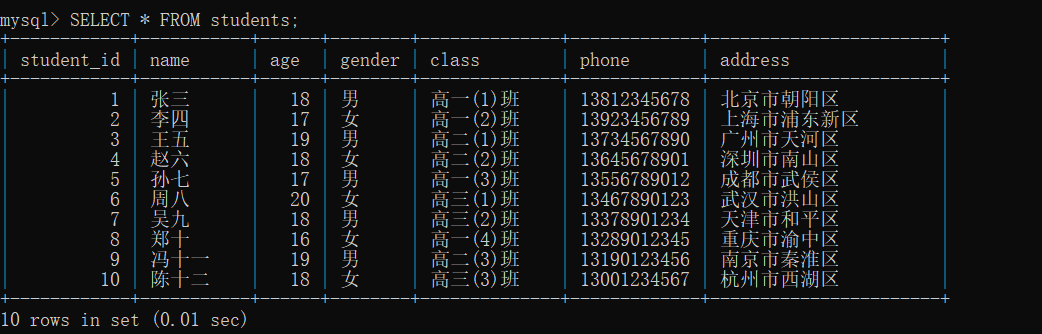
再查看一下表的结构
DESCRIBE students;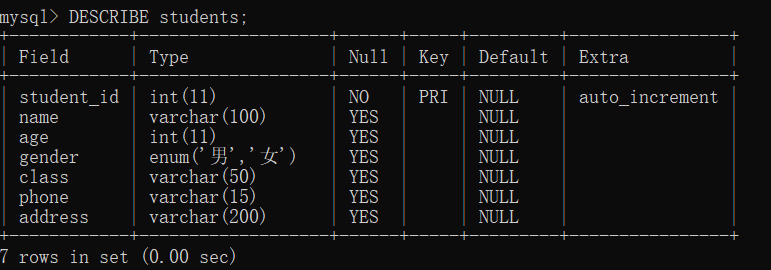
ok,接下来就可以进行函数查询的操作了
2.集合函数
包括COUNT()、SUM()、AVG()、MAX()和MIN()。当需要对表中的记录求和、求平均值、查询最大值和查询最小值等操作时,可以使用集合函数。GROUP BY关键字通常需要与集合函数起使用。
COUNT()用来统计记录的条数;
SUM()用来计算字段的值的总和;
AVG()用来计算字段的值的平均值:
MAX() 用来查询字段的最大值;
MIN()用来查询字段的最小值。
2.1.COUNT()
用来统计记录的条数;
查询所有数据条数
select count(*) from students;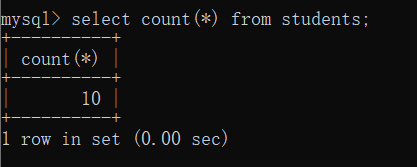
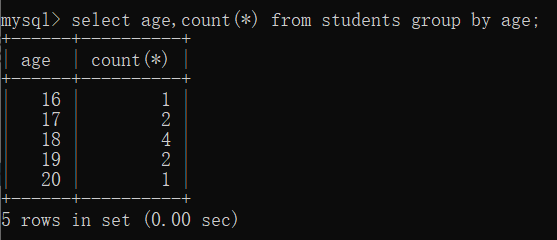
联合group by进行分组统计
select age,count(*) from students group by age;
2.2.SUM()
用来计算字段的值的总和;
例如对age进行分组,然后对studenyt_id进行求和
select age,sum(student_id) from students group by age;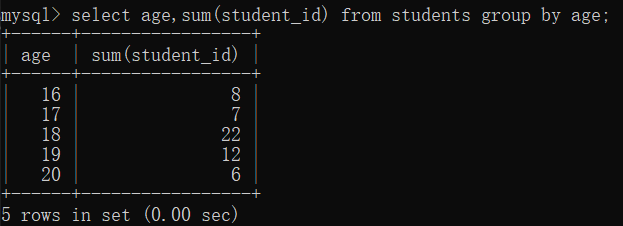
2.3AVG()
用来计算字段的值的平均值:
例如计算age的平均值是多少
select avg(age) from students;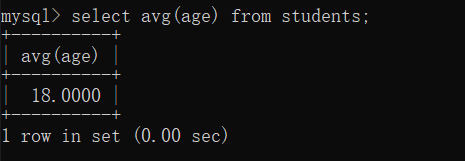
例如group by对age进行分组,然后计算每个年龄段的人的student_id的平均值
select age,avg(student_id) from students group by age;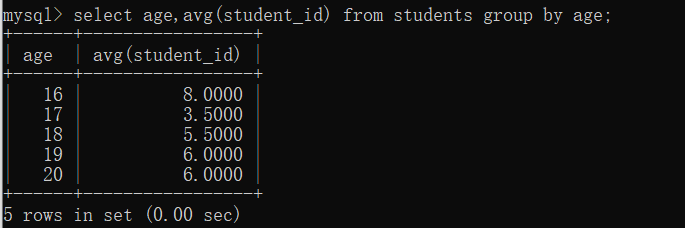
2.4.MAX()
用来查询字段的最大值
例如查询最大的年龄age的值
select max(age) from students;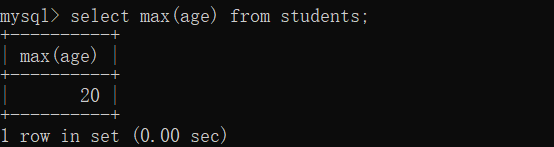
联合group by 使用,对年龄age进行分组,然后计算每个年龄段student_id的最大值
select age,max(student_id) from students group by age;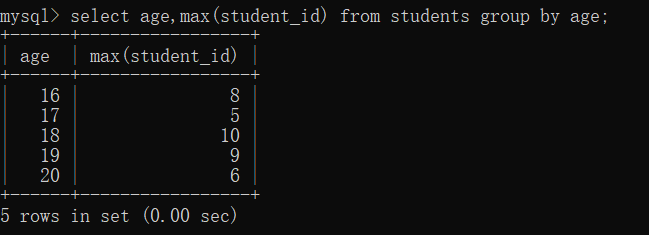
2.5.MIN()
用来查询字段的最小值。
例如查询年龄age的最小值
select min(age) from students;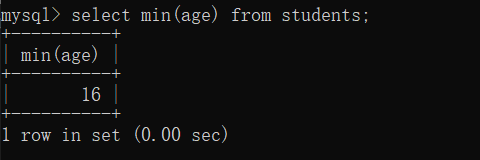
结合group by对age进行分组,查询每个年龄段最小的student_id值
select age,min(student_id) from students group by age;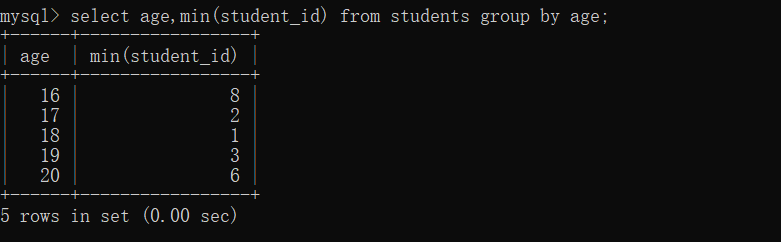
3.正则表达式
3.1 “.”和“_”的区别
两个都可以代替任意一个字符进行查询。
“.”只能用于regexp关键字进行匹配
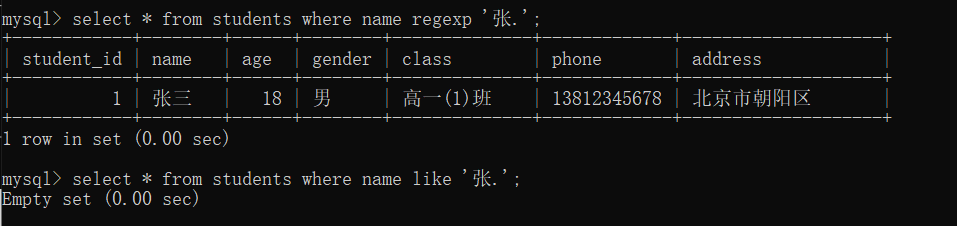
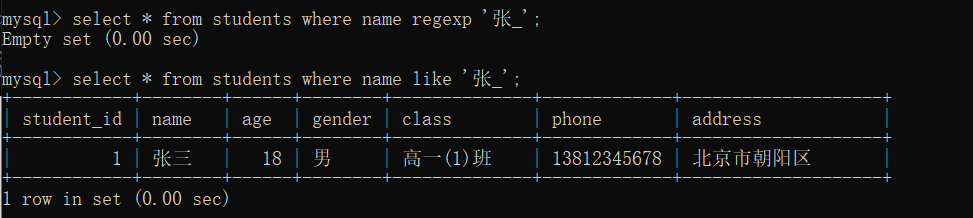
所以‘.’只能用于regexp
'_'也无法用于regexp
3.2‘[]’
[..]字符集合。匹配所包含的任意一个字符。
select * from students where phone regexp '[8-9]';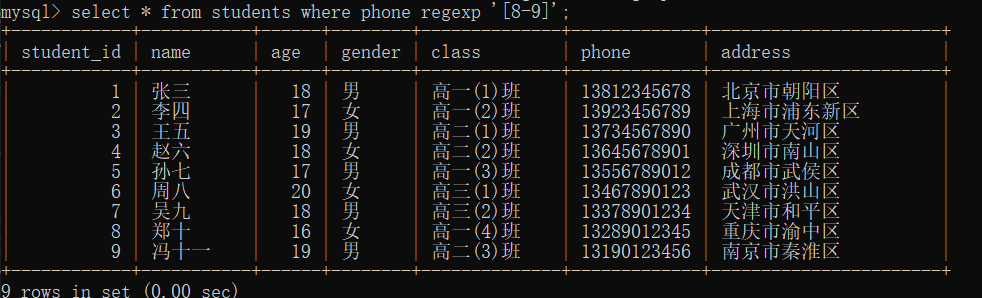
[]可以指定集合的区间。
如:[a-z],[1-9]
3.3.“[^字符集合]”
匹配指定字符以外的字符
select * from students where phone regexp '[^0-9]';select * from students where phone regexp '[^1-9]';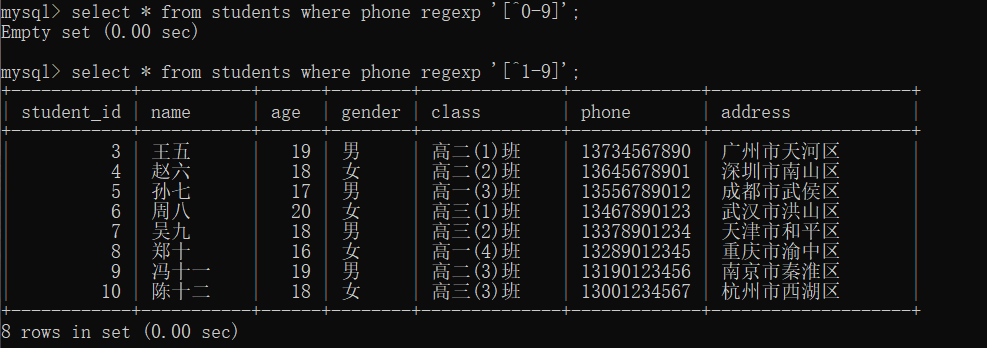
3.4 ‘|’匹配指定字符串
正则表达式可以匹配字符串。当表中的记录包含这个字符串时,就可以将该记录查询出来。如果指定多个字符串时,需要用符号“|”隔开。只要匹配这些字符串中的任意一个即可
例如查询name中带有“张”或者带有“十”的名字
select * from students where name regexp '张|十';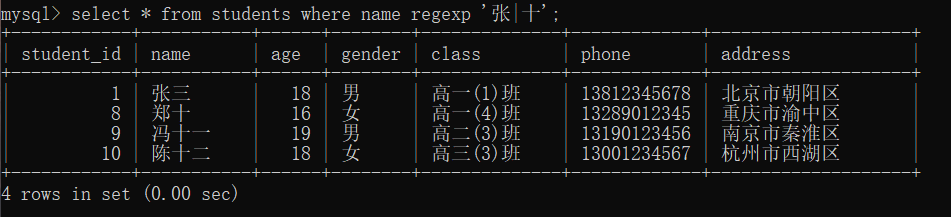
3.4 “*”和“+”
匹配多个字符,*和+都可以匹配多个该符号之前的字符。
“+”:至少表示一个字符
“*”:可以表示0个字符
比如‘a*b’就可以匹配
"b"
"ab"
"aab"
"aaab"等
“a+b”就只能匹配
“ab”
"aab"
"aaab"等
如果是“a*”就匹配
“ ”
“a”
"aa"
“aaa”
等
如果是“a+”就匹配
“a”
“aa”等
也就是说,"*"前面的字母数量可以从0个一直到无数个,都可以进行匹配
而“+”前面的字母数量可以从1个一直到无数个,不能为0个。
还是举个例子
select * from students where phone regexp '3*7'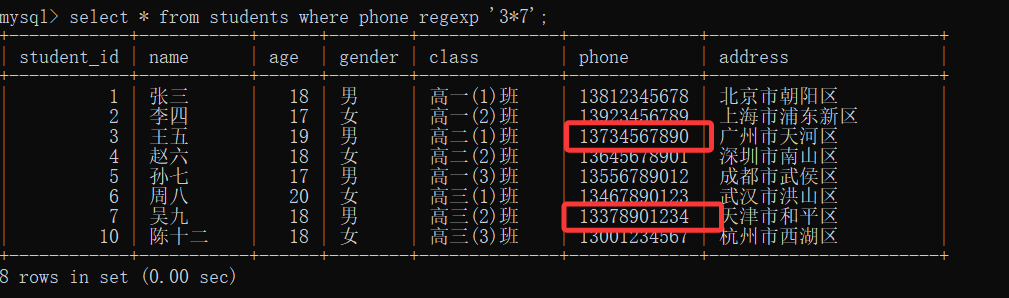
“3*7”可以匹配“7” “37” “337” “3337等”
select * from students where phone regexp '3+7';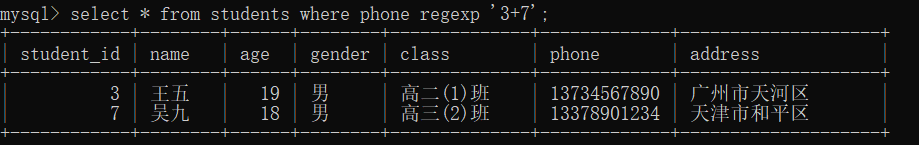
“3+7”可以匹配 “37” “337” “3337”等
3.4 {m}’或者’{m,n}’来指定字符串连续出现的次数
{m}:m是一个非负整数。匹配确定的 m 次。
{m,n}:m 和 n 均为非负整数,其中m <= n。
例如查找0连续出现一次的,两个0挨在一起也符合0连续出现1次的条件
select * from students where phone regexp '0{1}';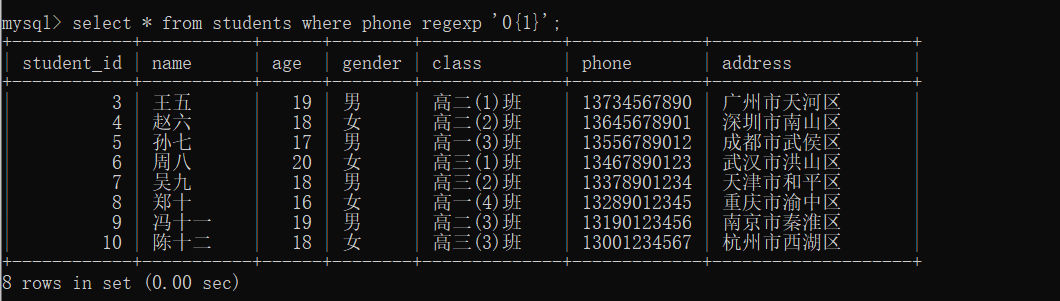
看一下0连续出现两次
select * from students where phone regexp '0{2}';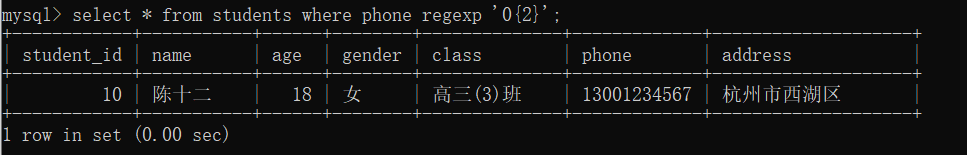
就只有一个符合条件了,但是如果有3个0,四个0等等同时连续出现的话,也是符合条件的,是包含关系
‘0{2,5}’表示0连续出现2次或者5次的。但是由于连续出现3次,4次都符合连续出现2次的条件,所以,可以理解为0连续出现2-5次
select * from students where phone regexp '0{2,5}';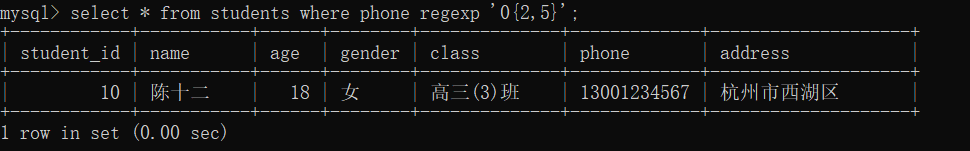
4.联合查询 : UNION
并操作 union、交操作 intersect、差操作 except
UNION用于合并具有相同字段结构的两个表的内容,主要用在一个结果中集中显示不同表的内容
select * from venus1
union
select * from venus2
union查询默认不返回重复记录
union查询的表的字段必须一样
unio n查询的数据类型必须能兼容
#union查询结果只增加了行数而列数不变
数据字段不一样的情况
select 1 union select 2;
select 1,2 union select 2;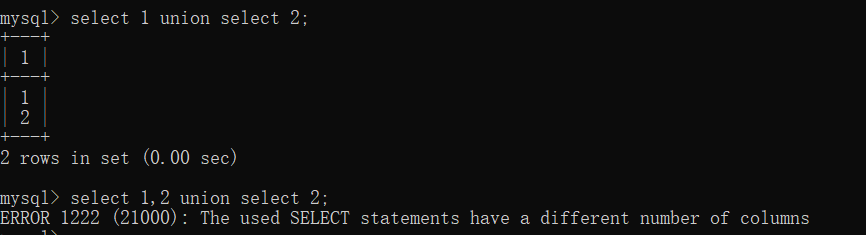
第二个由于字段数不一样,所以会报错
举个详细的例子吧
select * from students union select 1,2,3,4,5,6,7;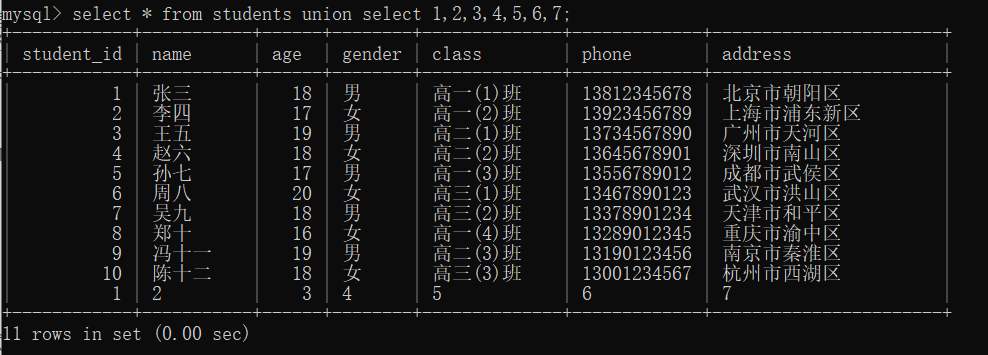
如果我只写6个数字或者8个数捏
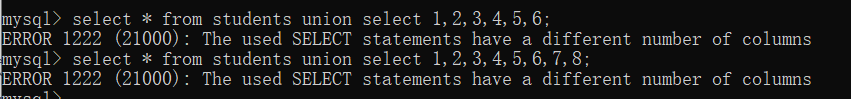
很显然,列的数量不一样肯定会报错
5.数据库相关信息查询
5.1 当前用户名
select current_user();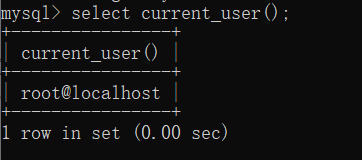
5.2 连接数据库用户名
select session_user();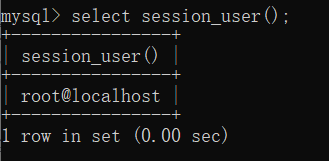
5.3 数据库名
select database();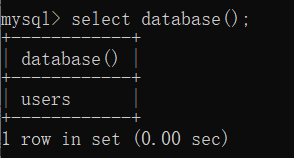
5.4 数据库版本
select version();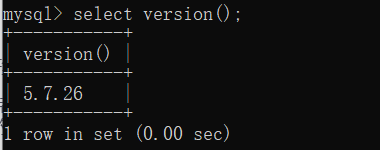
5.5 数据库读取路径
show variables like '%basedir%';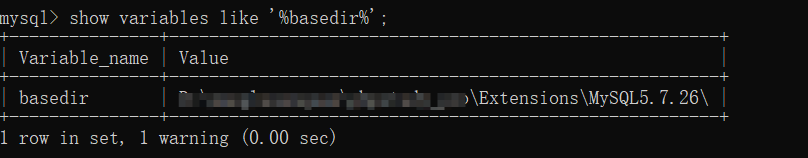
5.6 MYSQL安装路径
show variables like"%char%";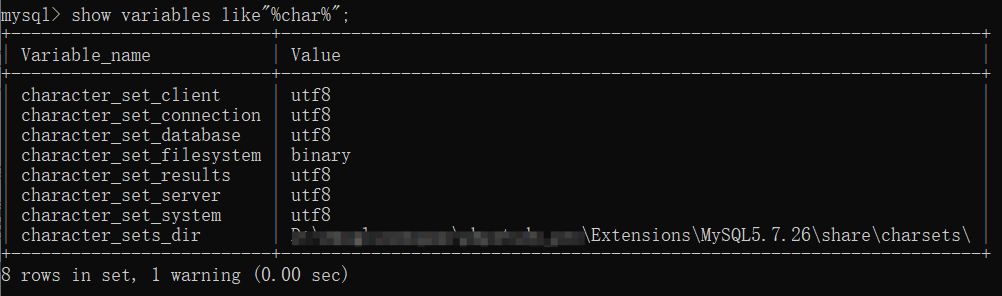
5.6 查看当前系统版本
select @@version_compile_os;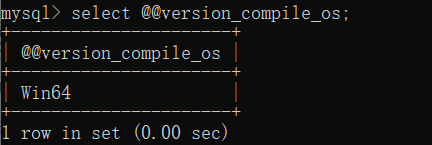
更多推荐



 44
 0
- 0


 已为社区贡献5条内容

所有评论(0)