
ParkingE2E文章阅读及模型搭建学习---代码阅读lss_bev_model
在阅读完文章,从网上下载完对应的代码工程后,开始了代码工程的学习。
Step1:
类: LssBevModel(了解原理有助于理解代码)
纯视觉 BEV 特征生成的核心是 “通过 3D 空间作为中介,完成 2D→3D→BEV 的视角转换”。
LSS 算法的流程可概括为三步:
Lift(升维):
先用 CNN(如 EfficientNet)提取图像的 2D 特征(C×H×W),再为每个像素估计深度分布(D×H×W,D 为深度 bins 数量),将 2D 像素特征 “升维” 为带深度信息的 3D 特征(C×D×H×W)—— 即每个像素对应不同深度下的特征表示。
Splat(投影):
根据相机内参(焦距、畸变系数)和外参(相机相对于车辆的位置 / 姿态),将每个 3D 特征点(含深度)投影到车辆坐标系下的 BEV 体素网格(如 X∈[-10m,10m]、Y∈[-10m,10m]、Z∈[0,3m]),并将同一 BEV 体素内的多相机特征进行聚合(如求和、均值池化)。
Shoot(生成 BEV 特征):
将聚合后的 3D 体素特征(C×H_bev×W_bev×D_bev)沿高度维度(D_bev)进行压缩(如最大池化、注意力加权),得到 2D BEV 特征图(C×H_bev×W_bev),后续可直接用于 3D 检测、分割等任务。
该过程的关键是 “通过深度估计间接建模 3D 信息”,避免直接依赖 LiDAR,仅用相机即可生成 BEV 特征。
def init(self, cfg: Configuration)
初始化参数
1️⃣ create_frustum() - 创建视锥体
def create_frustum(self):
    # 输入: 无 (使用配置参数)
    # 输出: torch.Tensor [D, H, W, 3]
    #       D=深度切片数, H=下采样后高度, W=下采样后宽度
    #       最后一维是(x_pixel, y_pixel, depth)
功能: 在图像平面上创建3D网格,每个像素对应多个深度值
设计原因:
- LSS方法需要将2D像素扩展到3D空间
- 通过离散化深度建立从图像到3D的映射关系
2️⃣ get_geometry() - 几何变换
def get_geometry(self, intrinsics, extrinsics):
    # 输入:
    #   intrinsics: [B, N, 3, 3] - 相机内参矩阵
    #   extrinsics: [B, N, 4, 4] - 相机外参矩阵 (车体坐标系到相机坐标系)
    # 输出:
    #   points: [B, N, D, H, W, 3] - 3D空间中的点云坐标(车体坐标系)
功能: 将图像像素+深度转换为3D空间坐标
设计原因: 实现从图像空间到车体坐标系的投影
变换流程:
像素坐标(x,y) + 深度d
  → 相机坐标系3D点 (使用内参K^-1)
  → 车体坐标系3D点 (使用外参R,t)
数学公式:
P_camera = K^(-1) * [x*d, y*d, d]^T
P_vehicle = R * P_camera + t
3️⃣ proj_bev_feature() - 投影到BEV
def proj_bev_feature(self, geom, image_feature):
    # 输入:
    #   geom: [B, N, D, H, W, 3] - 3D点云坐标
    #   image_feature: [B, N, D, H, W, C] - 图像特征(带深度维度)
    # 输出:
    #   output: [B, C, BEV_H, BEV_W] - BEV特征图
功能: 将3D空间特征投影并累加到BEV网格
设计原因:
- 多视角信息融合到统一的鸟瞰图表示
- 通过空间聚合处理遮挡和重叠
- 关键步骤:
# 1. 将3D坐标量化到BEV网格索引
geom_b = ((geom_b - (self.bev_start_pos - self.bev_res / 2.0)) / self.bev_res)

# 2. 过滤超出BEV范围的点
mask = ((geom_b[:, 0] >= 0) & (geom_b[:, 0] < self.bev_dim[0]) & ...)

# 3. 排序并累加同一网格的特征 (VoxelsSumming)
x_b, geom_b = VoxelsSumming.apply(x_b, geom_b, ranks)
4️⃣ encoder_forward() - 图像编码前向传播
def encoder_forward(self, images):
    # 输入:
    #   images: [B, N, C, H, W] - 多视角图像
    #           B=batch_size, N=相机数(4), C=通道数(3), H=W=256
    # 输出:
    #   x: [B, N, C, D, H/8, W/8] - 带深度维度的图像特征
    #   depth_prob: [B*N, D, H/8, W/8] - 深度概率分布(可选)
功能: 提取图像特征并扩展到深度维度
设计原因: LSS方法需要为每个像素的每个深度层分配特征
详细流程:
# 1. 重塑图像 - 将batch和相机维度合并
b, n, c, h, w = images.shape  # [1, 4, 3, 256, 256]
images = images.view(b * n, c, h, w)  # [4, 3, 256, 256]

# 2. EfficientNet特征提取
x, depth = self.cam_encoder(images)
# x: [4, 64, 32, 32] - 图像特征 (下采样8倍)
# depth: [4, 49, 32, 32] - 深度预测 (49个深度层)

# 3. 处理深度维度
if self.cfg.use_depth_distribution:
    # 方法A: 使用深度概率加权特征
    depth_prob = depth.softmax(dim=1)  # [4, 49, 32, 32]
    x = depth_prob.unsqueeze(1) * x.unsqueeze(2)
    # x: [4, 64, 49, 32, 32] - 每个深度层的特征由深度概率加权
else:
    # 方法B: 直接复制特征到所有深度层
    x = x.unsqueeze(2).repeat(1, 1, self.depth_channel, 1, 1)
    # x: [4, 64, 49, 32, 32] - 所有深度层共享相同特征

# 4. 重塑回多相机格式并调整维度顺序
x = x.view(b, n, *x.shape[1:])  # [1, 4, 64, 49, 32, 32]
x = x.permute(0, 1, 3, 4, 5, 2)  # [1, 4, 49, 32, 32, 64]
# 调整为 [B, N, D, H, W, C] 格式,便于后续处理
深度处理的两种策略:
-
use_depth_distribution=True (推荐):
- 网络预测深度概率分布
- 特征按深度概率加权
- 更准确但计算量稍大
-
use_depth_distribution=False:
- 不预测深度,所有深度层特征相同
- 计算简单但精度较低
- 适合快速原型开发
5️⃣ calc_bev_feature() - 计算BEV特征
def calc_bev_feature(self, images, intrinsics, extrinsics):
    # 输入:
    #   images: [B, N, C, H, W] - 多视角图像
    #   intrinsics: [B, N, 3, 3] - 相机内参
    #   extrinsics: [B, N, 4, 4] - 相机外参
    # 输出:
    #   bev_feature: [B, C, BEV_H, BEV_W] - BEV特征图
    #   pred_depth: [B*N, D, H/8, W/8] - 深度预测
功能: LSS的完整流程,将图像转换为BEV特征
设计原因: 整合几何变换、特征提取和BEV投影三个步骤
完整LSS流程:
# Step 1: 几何变换 - 计算每个像素在3D空间的位置
geom = self.get_geometry(intrinsics, extrinsics)
# geom: [B, N, D, H/8, W/8, 3] - 每个像素在每个深度的3D坐标

# Step 2: 图像特征提取 - 提取带深度维度的特征
x, pred_depth = self.encoder_forward(images)
# x: [B, N, D, H/8, W/8, C] - 图像特征
# pred_depth: [B*N, D, H/8, W/8] - 深度预测

# Step 3: BEV投影 - 将3D特征投影到BEV平面
bev_feature = self.proj_bev_feature(geom, x)
# bev_feature: [B, C, BEV_H, BEV_W] - 最终BEV特征
三步骤详解:
[图像] ─────→ [特征提取] ─────→ [图像特征+深度]
   ↓              ↓                    ↓
[内外参] ──→ [几何变换] ──→ [3D点云坐标] ──→ [BEV投影] ──→ [BEV特征]
数据维度变化:
输入: [1, 4, 3, 256, 256]
  ↓ encoder_forward
特征: [1, 4, 49, 32, 32, 64]
  ↓ get_geometry
几何: [1, 4, 49, 32, 32, 3]
  ↓ proj_bev_feature
BEV: [1, 64, 200, 200]
6️⃣ forward() - 模型前向传播
def forward(self, images, intrinsics, extrinsics):
    # 输入:
    #   images: [B, N, C, H, W] - 多视角图像
    #   intrinsics: [B, N, 3, 3] - 相机内参
    #   extrinsics: [B, N, 4, 4] - 相机外参
    # 输出:
    #   bev_feature: [B, C, BEV_H, BEV_W] - BEV特征 (squeeze后)
    #   pred_depth: [B*N, D, H/8, W/8] - 深度预测
功能: LssBevModel的主入口,调用calc_bev_feature并后处理
设计原因: 提供简洁的外部接口,隐藏内部实现细节
代码解析:
# 调用完整LSS流程
bev_feature, pred_depth = self.calc_bev_feature(images, intrinsics, extrinsics)

# 后处理: 移除多余的维度
# bev_feature可能是 [B, 1, C, H, W] 或 [B, C, H, W]
return bev_feature.squeeze(1), pred_depth
使用示例:
# 创建模型
lss_model = LssBevModel(cfg)

# 准备输入
images = torch.randn(1, 4, 3, 256, 256).cuda()      # 4视角图像
intrinsics = torch.randn(1, 4, 3, 3).cuda()         # 相机内参
extrinsics = torch.randn(1, 4, 4, 4).cuda()         # 相机外参

# 前向传播
bev_feature, depth = lss_model(images, intrinsics, extrinsics)
# bev_feature: [1, 64, 200, 200] - 可以送入后续网络
# depth: [4, 49, 32, 32] - 可用于深度监督(可选)
调参建议:
bev_x_bound/bev_y_bound: 根据停车场景大小调整,范围太大会降低分辨率d_bound: 深度范围要覆盖停车场景的主要障碍物bev_down_sample: 增大可提升速度但降低精度use_depth_distribution: True可提升精度,False可提升速度
类: CamEncoder
CamEncoder基于EfficientNet的图像特征提取器
初始化参数:
def __init__(self, cfg, D):
    # D: 深度通道数 (由d_bound决定)
    # cfg.backbone: "efficientnet-b4" 或 "efficientnet-b0"
    # cfg.bev_encoder_in_channel: 输出特征通道数,默认64
核心设计:
- 使用预训练的EfficientNet作为backbone
- 删除分类头,仅保留特征提取层
- 添加深度预测分支(可选)和特征上采样
关键方法:
delete_unused_layers() - 删除多余层
def delete_unused_layers(self):
    # 删除EfficientNet的后续层,减少计算量
    # b4保留前21个block,b0保留前10个block
设计原因: BEV任务不需要ImageNet分类的深层特征
get_features_depth() - 多尺度特征提取
def get_features_depth(self, x):
    # 输入: [B*N, C, H, W] - 批量图像
    # 输出:
    #   feature: [B*N, C, H/8, W/8] - 图像特征
    #   depth: [B*N, D, H/8, W/8] - 深度预测(可选)
特征提取流程:
输入图像
  → EfficientNet Blocks
  → 多尺度特征提取 (reduction_3, reduction_4)
  → DeepLabHead (ASPP特征增强)
  → UpsamplingConcat (特征上采样和拼接)
  → 特征输出 + 深度输出
调参建议:
backbone:efficientnet-b0: 速度快,精度较低efficientnet-b4: 精度高,计算量大
bev_encoder_in_channel: 增大可提升表达能力,但增加计算量
def forward(self, x)
和上述差不多
forward() 函数的核心作用是显式定义这个函数的计算步骤。
训练模型的核心是通过反向传播优化参数(减少预测误差),而反向传播的前提是明确前向传播的计算路径(即 “计算图”)。
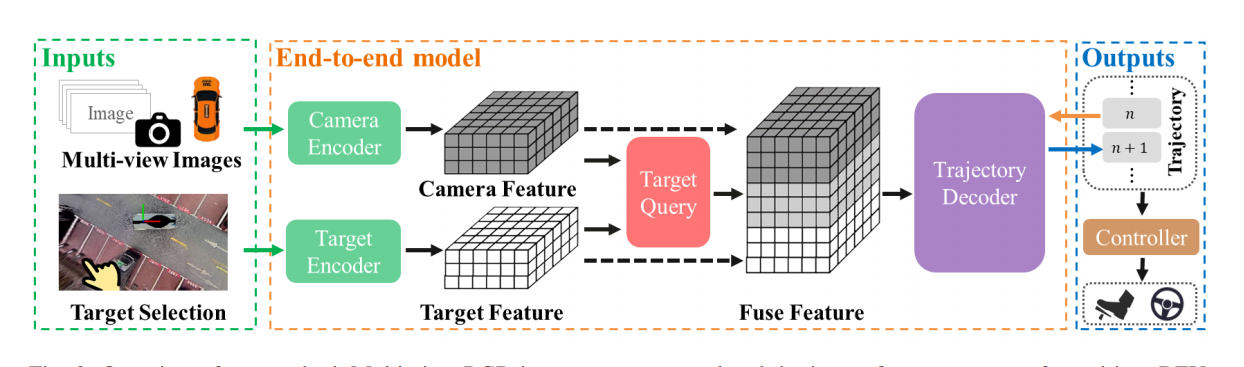
ParkingModelReal - 主停车模型
核心功能:整合多个组件,完成从图像到轨迹的端到端预测。
模型的流程框架如下:
class ParkingModelReal(nn.Module):
    def __init__(self, cfg):
        # 1. 相机图像编码器
        self.lss_bev_model = LssBevModel(cfg)          # 图像 → BEV
        self.image_res_encoder = BevEncoder(in_channel=64)  # BEV特征编码
        # 2. 目标点编码器
        self.target_res_encoder = BevEncoder(in_channel=1)  # 目标BEV编码
        # 3. 特征融合
        self.bev_query = BevQuery(cfg)                 # Query-based融合
        # 4. 轨迹解码器
        self.trajectory_decoder = get_trajectory_decoder()  # Transformer/GRU
更多推荐


 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)