
《重生之霸道总裁爱上学数据结构的我(二)》之没人比我更懂链表
个人主页-爱因斯晨
文章专栏-霸道总裁爱上学数据结构的我
一、前言
在上篇文章中我们讲到顺序表,顺序表是线性表的一个分支,用于存储线性的数据结构。但顺序表在存储时要求需要先开辟一块空间再存储数据,而且还要连续。但是,链表解决了这一个痛点,不要求大片连续的空间。
二、单链表:
与顺序表不同的是,不仅要存储数据元素,还要存储指向下一个节点的指针
2.1创建一个单链表
struct LNode {//单链表节点结构体
    int data; //数据域
    struct LNode *next;//指针域
};
创建一个骨架之后,我们要往里面填元素,那肯定要开辟新的内存空间,就像我们顺序表中的动态分配,需要开辟空间。
struct LNode*p=(struct LNode*)malloc (sizeof(struct LNode));
这时我们就会出现一个问题,每次都写struct LNode太麻烦了,于是我们就要使用重命名的东西。
typedef 数据类型 重命名
typedef structLNode LNode
所以,我们的开辟空间的代码可以变成:
struct LNode*p=(struct LNode*)malloc (sizeof(struct LNode));
LNode*p=(LNode*)malloc (sizeof(LNode));
所以我们的创建单链表的代码可以写为:
typedef struct LNode{ //重命名的结构体
    int data;//数据域
    struct LNode *next;//指针指向下一个节点
}LNode,*LinkList;//我们起的两个别名,为了以后方便使用
这里我们对他两个命名是因为,虽然意思都是声明指向下一个的指针,但是侧重不一样。
LNode是强调头结点,*LinkList是强调单链表。
不带头节点的单链表
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h> //引入布尔类型定义
//不带头结点的单链表
typedef struct LNode {
    struct LNode *next;
    int data;
}LNode,*LinkList;

//初始化一个单链表
bool InitList(LinkList *L) {
   L=NULL; //将头指针设为NULL
   return true;
}
void test() {
    LinkList L;
    InitList(&L);
}
我一开始学的时候就有疑问,什么时候用&什么时候用*
- 想让函数修改某个变量,就用
&把变量的地址传给函数。 - 函数里收到地址后,用
*地址来操作这个变量本身。
比如一开始我们初始化空链表的时候,就是把链表地址传入地址(测试函数),然后用*来操作变量本身。
带头结点
和不带头结点不同的是,我们要先分配一个头结点,然后判断一下是不是空的,有没有分配成功,然后,头结点之后指向的指针为空。
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h> //引入布尔类型定义
//带头结点的单链表
typedef struct LNode {
    struct LNode *next;
    int data;
}LNode,*LinkList;

//初始化一个单链表
bool InitList(LinkList *L) {
    *L = (LinkList)malloc(sizeof(LNode));//分配一个头结点
    if (*L == NULL) { //判断是否分配成功
        return false;
    }
    (*L)->next = NULL; //将头结点的next设为NULL
    return true;
}
void test() {
    LinkList L;
    InitList(&L);//传入地址
}
我们在传统开发时还是习惯使用带头结点的,因为bug更少。
2.2单链表操作
2.2.1插入(按位序插入)带头结点
//
// Created by Lenovo on 2025/10/28.
//
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h> //引入布尔类型定义
//定义一个单链表
typedef struct LNode {
    struct LNode *next;
    int data;
}LNode,*LinkList;
//初始化一个单链表,不带头结点
bool InitList(LinkList* L) {
    *L = (LinkList)malloc(sizeof(LNode));
    if (*L == NULL) {
        return false;
    }
    (*L)->next = NULL; //将头指针设为NULL
    return true;
}
bool ListInsert(LinkList* L, int i,int e) {
    //判断位置是否合法
    if (i<1) //判断插入位置是否合法
        return false;
    LNode *p=*L; //p指向头结点
    int j=0; //j用来记录当前位置
    while (j<i-1 && p!=NULL) { //查找第i-1个结点
        p = p->next;//指向下一个结点
        j++;
    }
    if (p == NULL) { //判断i是否大于表长
        return false;
    }
    //在i-1后插入新的元素
    LNode *s = (LNode *)malloc(sizeof(LNode)); //分配一个新结点
    if (s == NULL) { //判断是否分配成功
        return false;
    }
    s->data = e; //将新结点的数据域设为e
    //将新结点插入到第i-1个结点后
    s->next = p->next; //将新结点的next设为p的next
    p->next = s; //将p的next设为新结点
    return true;
}
void test() {
    LinkList L;
    InitList(&L);
    ListInsert(&L, 1, 10); //在第1个位置插入10
    ListInsert(&L, 2, 20); //在第2个位置插入20
    ListInsert(&L, 1, 5);  //在第1个位置插入5

}
我们的带头结点的插入思路就是:
定义一个单链表
初始化
插入函数
在插入函数中,我们要判断插入位置的合法问题,将节点指向头结点,开始循环找到节点,找到之后我们改开辟一个新位置来插入,插入前判断新位置弄好了不,插入时,数据先传入,然后将原来这个元素后的指针也让新元素指向,然后,前面的元素,指向新元素,就行了。
2.2.2不带头结点插入
对于不带头结点的,我们没有头元素,所以无法一开始指向头元素,所以不存在“第0个元素”,因此i=1时需要特殊处理。所以他和带头结点不同的就是,多了特殊处理部分。
bool ListInsert(LinkList* L, int i,int e) {
    //判断位置是否合法
    if (i<1) //判断插入位置是否合法
        return false;
    if (i==1){
        LNode *s = (LNode *)malloc(sizeof(LNode));
        s->data = e; //将新结点的数据域设为e
        s->next=*L;
        *L=s;
        return true;
    }
    LNode *p=*L; //p指向头结点
    int j=1; //j用来记录当前位置,注意这里是1
    while (j<i-1 && p!=NULL) { //查找第i-1个结点
        p = p->next;//指向下一个结点
        j++;
    }
    if (p == NULL) { //判断i是否大于表长
        return false;
    }
    //在i-1后插入新的元素
    LNode *s = (LNode *)malloc(sizeof(LNode)); //分配一个新结点
    if (s == NULL) { //判断是否分配成功
        return false;
    }
    s->data = e; //将新结点的数据域设为e
    //将新结点插入到第i-1个结点后
    s->next = p->next; //将新结点的next设为p的next
    p->next = s; //将p的next设为新结点
    return true;
}
2.2.3指定结点的后插操作
这个就是以上我们讲的按位序插入的简化版,按位序插入还要循环匹配位序,这个可以直接在指定节点后面直接插入,思路一样,先判断插入的值合不合法,是不是存在这个节点。然后开辟一个新的空间来存储数据,判断失效不,然后存数据,改指针就行了。很简单,我们做个代码实现。
bool InsertNextNode (LNode *p, int e){
    if (p==NULL) //判断是否合法
        return false;
    LNode *s=(LNode *)malloc(sizeof (LNode));//开辟空间
    if (s==NULL)
        return false;//看看是否成功开辟
    s->data=e;//数据保存
    s->next=p->next;//前面这个元素的后继指针等于现在要插入的元素的后继指针
    p->next=s;//将节点s连到p之后
}
2.2.4指定结点的前插操作:
在p之前插入元素e,众所周知我们前面的空间是未知的所以不能直接前插,所以要迂回一些。一下是两种方法:
第一:循环找到他的前驱结点,再对前驱结点后插,但这样的时间复杂度为O(n)
// 在节点p的前面插入元素e(需要链表的头指针L辅助查找p的前驱)
bool InsertPriorNode(LinkList *L, LNode *p, int e) {
    if (L == NULL || p == NULL) return false;  // 参数无效

    // 特殊情况:p是第一个节点(前插后成为新的第一个节点)
    if (*L == p) {
        LNode *s = (LNode*)malloc(sizeof(LNode));
        if (s == NULL) return false;
        s->data = e;
        s->next = p;  // 新节点指向p
        *L = s;       // 头指针指向新节点(成为新的第一个节点)
        return true;
    }

    // 一般情况:找p的前驱节点pre
    LNode *pre = *L;
    while (pre != NULL && pre->next != p) {
        pre = pre->next;  // 直到pre的next是p,pre就是前驱
    }

    if (pre == NULL) return false;  // p不在链表中,无法前插

    // 在pre后面插入新节点(即p的前面)
    LNode *s = (LNode*)malloc(sizeof(LNode));
    if (s == NULL) return false;
    s->data = e;
    s->next = p;  // 新节点指向p
    pre->next = s;  // pre指向新节点
    return true;
}
第二:找中介~先对这个元素进行后插,然后交换元素的数据
// 技巧:在p后面插入s,再交换数据,实现“逻辑前插”
bool InsertPriorNode(LNode *p, int e) {
    if (p == NULL) return false;  // p无效

    // 1. 在p后面插入新节点s
    LNode *s = (LNode*)malloc(sizeof(LNode));
    if (s == NULL) return false;
    s->next = p->next;
    p->next = s;

    // 2. 交换p和s的数据(关键:让s的数据变成e,p的数据变成原来的s的数据)
    s->data = p->data;  // s先存p原来的数据
    p->data = e;        // p存新数据e

    return true;
}
2.2.5按位序删除(带头结点)
bool ListDelete(LinkList L, int i, int *e) {
    if (i < 1) return false; // 位置不合法

    LNode *p = L; // p从头结点开始(头结点对应位置0)
    int j = 0;    // 记录当前p的位置(头结点是0)

    // 找到第i-1个节点(要删除节点的前驱)
    while (j < i-1 && p != NULL) {
        p = p->next;
        j++;
    }

    // 两种失败情况:i超过链表长度 或 前驱节点不存在
    if (p == NULL || p->next == NULL) {
        return false;
    }

    // 执行删除
    LNode *q = p->next; // q指向要删除的节点(第i个节点)
    *e = q->data;       // 保存被删除的值
    p->next = q->next;  // 前驱节点跳过q,指向q的下一个节点
    free(q);            // 释放q的内存(避免内存泄漏)
    return true;
}
写这段代码的时候,我们已经得心应手了,和按位序插入差不多意思,先判断删除合法问题,然后循环找位序,找到后判断i值合法问题还要确定i-1之后没有其他结点,最后修改指针指向,释放空间。
最坏、平均的时间复杂度为O(n),最好的时间复杂度为O(1)
2.2.6指定结点的删除
删除结点P,需要修改前驱结点的next指针。
法一:植入头指针,循环寻找p的前驱结点
利用头指针从头遍历链表,找到 p 的前驱节点 pre,然后通过 pre->next = p->next 跳过 p,最后释放 p。
// 方法一:通过头指针找前驱删除节点p
bool DeleteNode(LinkList L, LNode *p) {
    if (L == NULL || p == NULL) return false; // 头指针或p无效

    LNode *pre = L; // 从化市头结点开始找前驱
    // 循环找到p的前驱(pre的next是p)
    while (pre->next != NULL && pre->next != p) {
        pre = pre->next;
    }

    // 若pre的next不是p,说明p不在链表中
    if (pre->next != p) {
        return false;
    }

    // 执行删除:pre跳过p,指向p的下一个
    pre->next = p->next;
    free(p); // 释放p的内存
    return true;
}
流程:
初始:头结点 → ... → pre → p → q → ... → NULL
步骤1:找到pre(pre->next = p)
步骤2:pre->next = p->next → 头结点 → ... → pre → q → ... → NULL
步骤3:free(p),完成删除
法二:类似与结点前插的实现,偷天换日:
不直接删除 p,而是将 p 的后继节点 q 的数据复制到 p,然后删除 q(等价于删除 p 的逻辑效果)。
// 方法二:偷天换日(p不是尾节点时使用)
bool DeleteNode(LNode *p) {
    if (p == NULL) return false; // p无效

    // 若p是尾节点(无后继),此方法失效
    if (p->next == NULL) {
        return false;
    }

    LNode *q = p->next; // q是p的后继节点
    // 1. 将q的数据复制到p(p变成q的“替身”)
    p->data = q->data;
    // 2. p跳过q,指向q的下一个节点
    p->next = q->next;
    // 3. 删除q(相当于删除了原来的p)
    free(q);
    return true;
}
2.2.7单链表按位查找
// 按位查找,返回第 i 个节点(i 从 1 开始)
LNode* GetElem(LinkList L, int i) {
    if (i < 1) {
        return NULL;  // 位置无效
    }
    LNode *p = L->next;  // p 指向第 1 个节点(假设 L 是头节点)
    int j = 1;           // 当前 p 指向的节点位置
    while (p != NULL && j < i) {
        p = p->next;     // 移动到下一个节点
        j++;
    }
    return p;  // 若 i 超出链表长度,p 为 NULL
}
这段代码其实我们在按位序插入时使用过,首先判断位置是否合法,然后循环直到找到那个位序的元素返回。
2.2.8按值查找
//按值查找
LNode* LocateElem(LinkList L, int e) {
    LNode *p = L->next; //p指向第一个结点
    while (p!=NULL) { //遍历链表
        if (p->data == e) { //判断当前结点的数据是否等于e
            return p; //返回当前结点
        }
        p = p->next; //指向下一个结点
    }
    return NULL; //遍历完链表后仍未找到,返回NULL
}
从头开始,指向第一个结点,然后遍历链表看看值是不是我们想要的,是的话返回就行。
2.2.10求表的长度
int Length(LinkList L) {
    int len = 0;        // 定义变量 len 用于记录链表长度,初始化为 0
    LNode *p = L;   // 定义遍历指针 p,初始指向头节点(头节点不存数据)

    // 循环条件:当前节点的后继节点不为空(即存在下一个有效节点)
    // 当 p->next 为 NULL 时,说明已到达链表末尾的最后一个节点
    while (p->next != NULL) {
        p = p->next;    // 将指针 p 移动到下一个节点(有效数据节点)
        len++;         // 每移动一次,长度加 1(统计有效节点)
    }
    return len;      // 返回统计得到的链表长度
}
3.单链表的建立
3.3.1尾插法
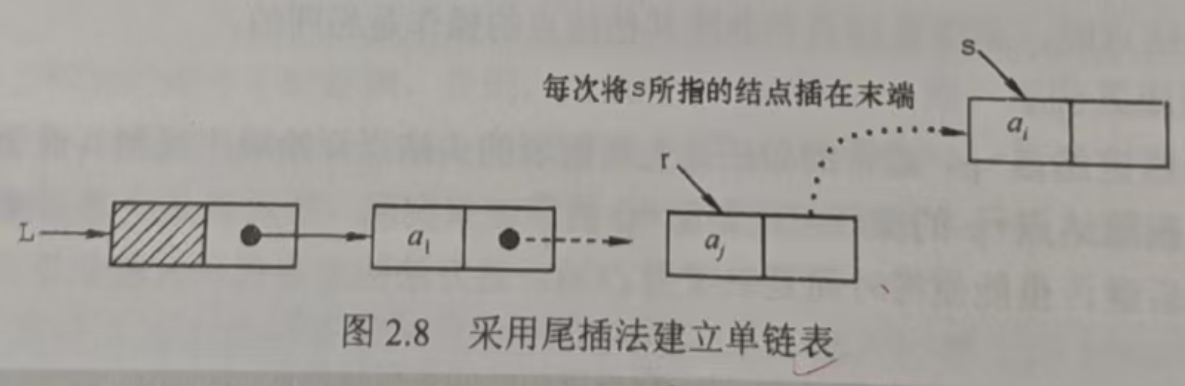
初始化链表
设置变量length记录链表的长度
while 循环{
    每次取一个数据元素e
    插到尾部;
    length++;
}
这和我们上文讲的按位序插入很相似,几乎一样,都是按位序向后插入,但是他每次都是从右开始遍历,O(n**2),这里就不再过多赘述,直接上代码
bool ListInsert(LinkList *L, int i,int e) {
    //判断插入位置是否合法
    if (i<1) //判断插入位置是否合法
        return false;
    LNode *p; //p指向头结点
    int j=0; //j用来记录当前位置
    p = *L; //p指向头结点
    while (j<i-1 && p!=NULL) { //查找第i-1个结点
        p = p->next;//指向下一个结点
        j++;
    }
    if (p == NULL) { //判断i是否大于表长
        return false;
    }
    //在第i-1个结点后插入新结点
    LNode *s = (LNode *)malloc(sizeof(LNode)); //分配一个新结点
    if (s == NULL) { //判断是否分配成功
        return false;
    }
    s->data = e; //将新结点的数据域设为e
    //将新结点插入到第i-1个结点后
    s->next = p->next; //将新结点的next设为p的next
    p->next = s; //将p的next设为新结点
    return true;
}
我们的另一种方式就是使用正向插入,他的时间复杂度更低一点,只是O(n)
LinkList List_TailInsert(LinkList *L) { // 正向建立单链表
    int x;
    *L = (LNode*)malloc(sizeof(LNode)); // 创建头结点
    LNode *r = *L;             // r为表尾指针,初始指向头节点
    LNode *s;                  // 临时指针,指向新创建的节点
    scanf("%d", &x);                   // 输入结点的值
    while (x != 9999) {                // 输入9999表示结束
        s = (LNode*)malloc(sizeof(LNode)); // 创建新结点
        s->data = x;
        r->next = s;
        r = s;                         // r指向新的表尾结点
        scanf("%d", &x);
    }
    r->next = NULL;                    // 尾结点指针置空
    return *L;
}
这就是先初始化一个空链表,然后先把指针指到头,此时开始插元素,都是从最后一个开始插,一开始头指针就是尾指针。然后你输入数字开始放在尾指针的后面。这样就不用像上个代码一样从头开始找了,因为这个每次都是插到最后面。
他的时间复杂度就低很多就是O(n)
3.3.2头插法
和尾插法一个道理,核心就是初始化操作,指定结点的后插操作,一般用于链表的逆置
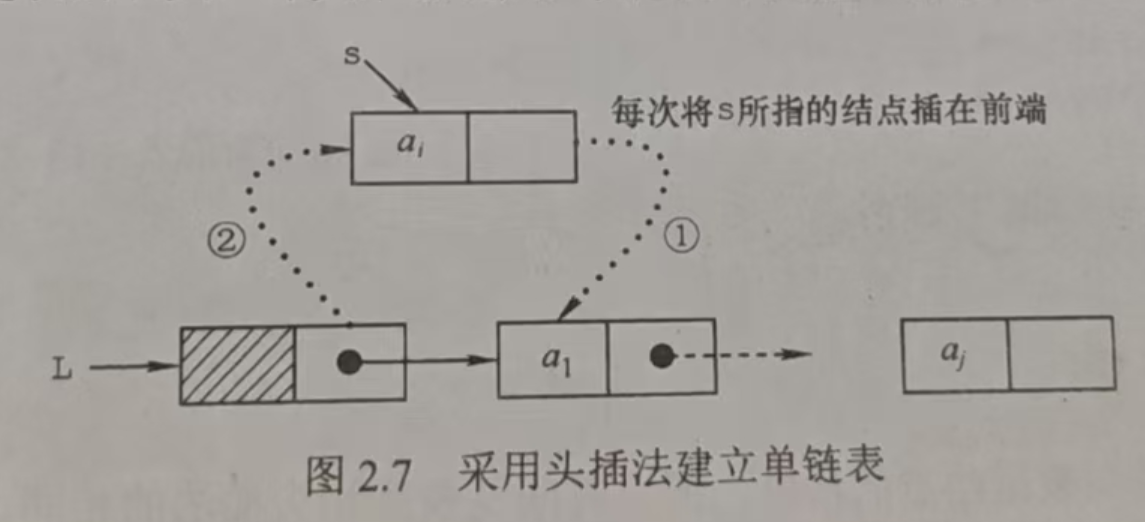
LinkList List_HeadInsert(LinkList *L) { // 逆向建立单链表
    LNode *s; int x;
    *L = (LNode*)malloc(sizeof(LNode));
    // 创建头结点(通过二级指针修改外部头指针)
    (*L)->next = NULL;                  // 初始为空链表
    scanf("%d", &x);                    // 输入结点的值
    while (x != 9999) {                 // 输入9999表示结束
        s = (LNode*)malloc(sizeof(LNode)); // 创建新结点
        s->data = x;
        s->next = (*L)->next;        // 新节点指向原头节点后的节点
        (*L)->next = s;            // 头节点指向新节点(完成插入)
        scanf("%d", &x);
    }
    return *L;                      // 返回头指针
}
写到这里的时候,我很疑惑,王道书上给的代码都是伪代码!经常c和C++复用,混在一起,我很难辨别,通常地址指针这种经常出错,为了区分,我们要记住!!
- C语言改外部变量:分函数参数用指针(加星号*),主函数传变量地址(加&);仅读不改则直接传值,参数不用星号*。
- 王道伪代码区分:遇参数带&(C++引用),C中替换为星号*(指针),主函数传参补&。*
- 分函数用时机:仅访问指针指向的值时加,操作指针地址(如->)不加*。
三、双链表
相较于单链表,双链表可以你想检索可进可退
3.1初始化双链表
和单链表很像,但双链表的初始化时有两个指针,一个前驱结点一个后继结点,定义结构体的时候要记住。然后初始化时,先给头结点开辟一个空间,然后看看头结点是不是空结点。然后将前驱和后继结点设为空。
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>
typedef struct DNode {
    int data; //数据域
    struct DNode *prior, *next; //前驱指针和后继指针
}DNode,*DuLinkList;

//初始化一个双链表
bool InitDuLinkList(DuLinkList *L) {
    *L = (DuLinkList)malloc(sizeof(DNode));//给头结点开辟一个空间
    if (*L == NULL) { //看看头结点是不是
        return false;
    }
    (*L)->prior = NULL;//将头指针设为NULL
    (*L)->next = NULL;//将头指针设为NULL
    return true;
}
//判断单链表是否为空
bool EmptyDuLinkList(DuLinkList *L) {
    if (*L == NULL)
        return true;
    else
        return false;
}
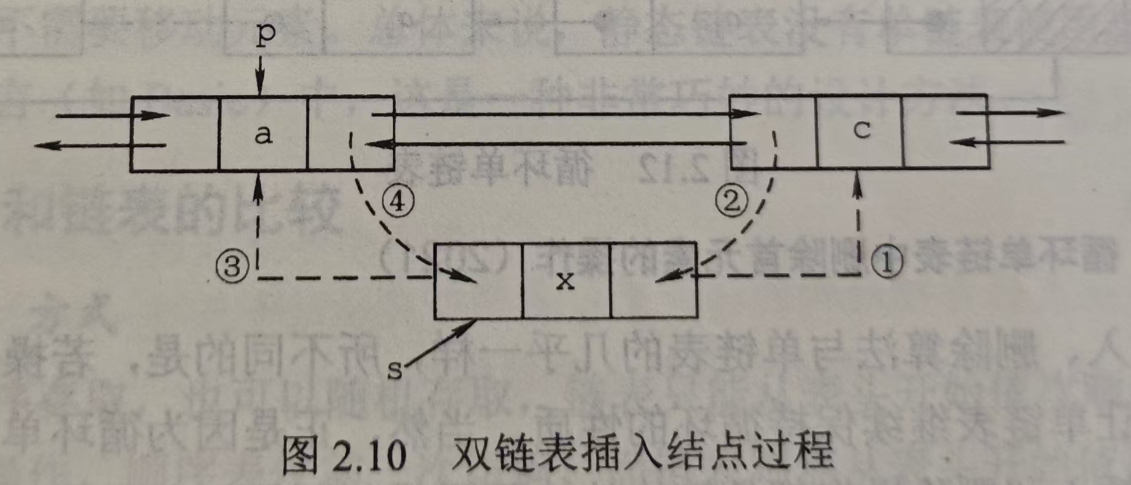
3.2双链表的插入
bool InsertNextDNode(DNode *p, DNode *s) {
    if (p == NULL || s == NULL) {
        return false;
    }
    s->next = p->next;       // 步骤1:接后
    if (p->next != NULL) {   // 若p不是尾节点,才处理原后继的前驱
        p->next->prior = s;
    }
    s->prior = p;            // 步骤3:接前
    p->next = s;             // 步骤4:完成插入
    return true;             // 补充返回true(原代码漏了)
}
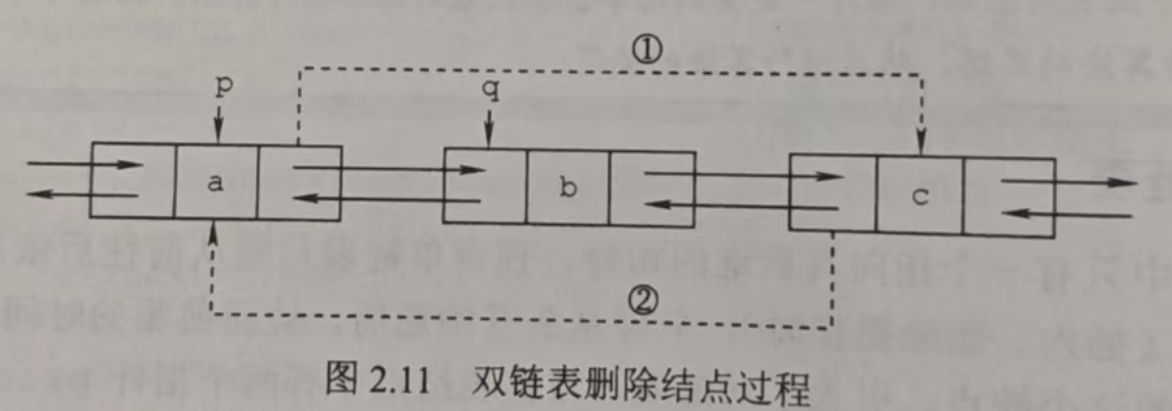
在一个节点后插入另一个,修改指针就好了。如下图
3.3双链表的删除
就是改变指针的指向,然后释放空间。
//删除p结点的后继结点
bool DeleteDNode(DNode *p) {
    if (p == NULL ) {
        return false;//参数非法
    }
    //1.找到p的后继结点
    DNode *q = p->next;
    if (q == NULL) {
        return false;//p没有后继结点
    }
    //将p的后继指针指向q的后继指针
    p->next = q->next;
    //2.将q的后继指针的前驱指针指向p
    if (q->next != NULL) {
        q->next->prior = p;
    }
    //释放q的空间
    free(q);
    return true;
}
我们综上可以看到对链表中的元素操作时,要先判断是不是非法,然后修改指针进行操作,最难的就是对指针的理解。
四、循环链表
表尾结点的next指针指向头结点。
他相较于单链表的好处就是,单链表不能倒着走,只能找到后面的元素,循环链表可以倒着走,可以找到任何一个元素
初始化
循环链表的初始化就和单链表的差不多,都是看看合不合法,然后给头结点分配内存进行初始化。
#include <stdlib.h>

// 定义节点结构
typedef struct LNode {
    int data;               // 数据域
    struct LNode *next;     // 指针域
} LNode, *LinkList;

// 初始化循环单链表(带头节点)
bool InitCycleList(LinkList *L) {
    // 1. 创建头节点并分配内存
    *L = (LNode*)malloc(sizeof(LNode));
    if (*L == NULL) {       // 内存分配失败
        return false;
    }
    // 2. 头节点的next指向自身(空表时,头节点自己形成循环)
    (*L)->next = *L;
    return true;
}
五、循环双链表
初始化
他的初始化操作和双链表的初始化操作差不多,都是两个指针。
#include <stdlib.h>
#include <stdbool.h>

// 定义循环双链表节点结构
typedef struct DNode {
    int data;               // 数据域
    struct DNode *prior;    // 前驱指针
    struct DNode *next;     // 后继指针
} DNode, *DLinkList;

// 初始化循环双链表
bool InitDLinkList(DLinkList *L) {
    // 1. 创建头节点(带头节点,简化操作)
    *L = (DNode*)malloc(sizeof(DNode));
    if (*L == NULL) {       // 内存分配失败(如内存不足)
        return false;
    }
    // 2. 空表时,头节点的prior和next都指向自身(形成双向循环)
    (*L)->prior = *L;
    (*L)->next = *L;
    return true;
}
六、静态链表
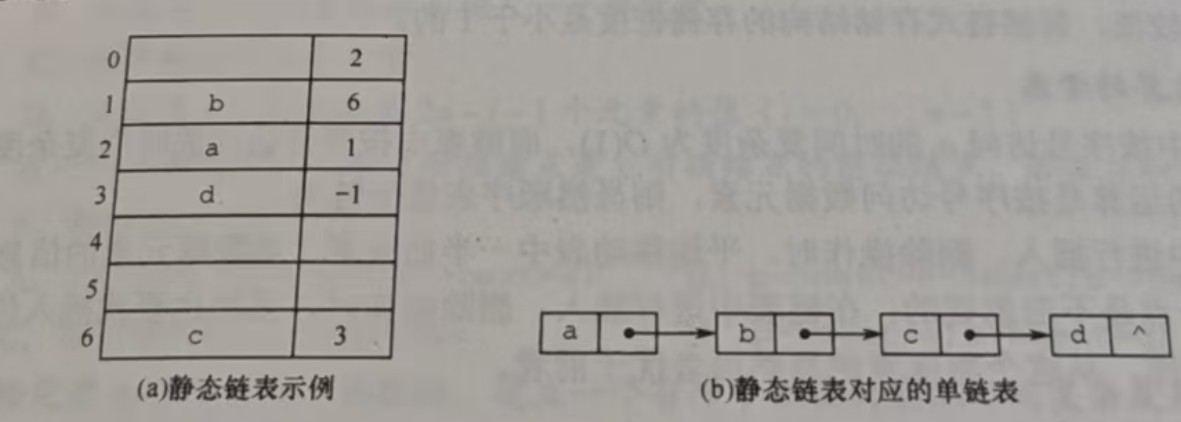
别的链表的分配很散乱,静态链表就是在一块内存中集中分布。
静态链表就是用数组来模拟链表的结构,数组里每个元素(节点)既存实际数据,又存一个“游标”(下一个节点在数组中的下标,代替指针),还会用“备用链表”管理没用到的数组位置,能像链表一样做插入删除(改游标就行,不用挪数据),但数组长度一开始就定死,没法随便扩,适合没法用动态内存或指针的场景。
结构设计
#define MAXSIZE 100  // 静态链表的最大长度(预先定义)
// 静态链表节点结构
typedef struct {
    int data;       // 数据域
    int next;       // 游标(代替指针,存储下一个节点的数组下标)
} SLinkList[MaxSize];
初始化:
// 初始化静态链表
void InitSLinkList(SLinkList &L) {  // L是数组,传引用(C++)或地址(C用*L)
    // 1. 初始化所有节点为“备用空闲节点”,形成空闲链表
    // 第0到MAXSIZE-2个节点:next指向后一个节点(i+1)
    for (int i = 0; i < MAXSIZE - 1; i++) {
        L[i].next = i + 1;
    }
    // 最后一个节点(MAXSIZE-1)的next设为0,表示空闲链表结束
    L[MAXSIZE - 1].next = 0;

    // 2. 初始化“数据链表”为空:用第0个节点作为头节点,next=0表示无数据节点
    L[0].next = 0;  // 头节点的next为0,代表数据链表为空
}
总结
我们针对链表的代码讲解就到此位置哦~下个博客我们一起走进栈和队列的世界!
组长度一开始就定死,没法随便扩,适合没法用动态内存或指针的场景。
[外链图片转存中…(img-FLAf4T7w-1761918401659)]
结构设计
#define MAXSIZE 100  // 静态链表的最大长度(预先定义)
// 静态链表节点结构
typedef struct {
    int data;       // 数据域
    int next;       // 游标(代替指针,存储下一个节点的数组下标)
} SLinkList[MaxSize];
初始化:
// 初始化静态链表
void InitSLinkList(SLinkList &L) {  // L是数组,传引用(C++)或地址(C用*L)
    // 1. 初始化所有节点为“备用空闲节点”,形成空闲链表
    // 第0到MAXSIZE-2个节点:next指向后一个节点(i+1)
    for (int i = 0; i < MAXSIZE - 1; i++) {
        L[i].next = i + 1;
    }
    // 最后一个节点(MAXSIZE-1)的next设为0,表示空闲链表结束
    L[MAXSIZE - 1].next = 0;

    // 2. 初始化“数据链表”为空:用第0个节点作为头节点,next=0表示无数据节点
    L[0].next = 0;  // 头节点的next为0,代表数据链表为空
}
总结
我们针对链表的代码讲解就到此位置哦~下个博客我们一起走进栈和队列的世界!
更多推荐



 69
 0
- 0


 已为社区贡献1条内容

所有评论(0)