
小样本表面缺陷检测毕业论文【附知识蒸馏代码】

✅ 博主简介:擅长数据搜集与处理、建模仿真、程序设计、仿真代码、论文写作与指导,毕业论文、期刊论文经验交流。
✅ 具体问题可以私信或扫描文章底部二维码。
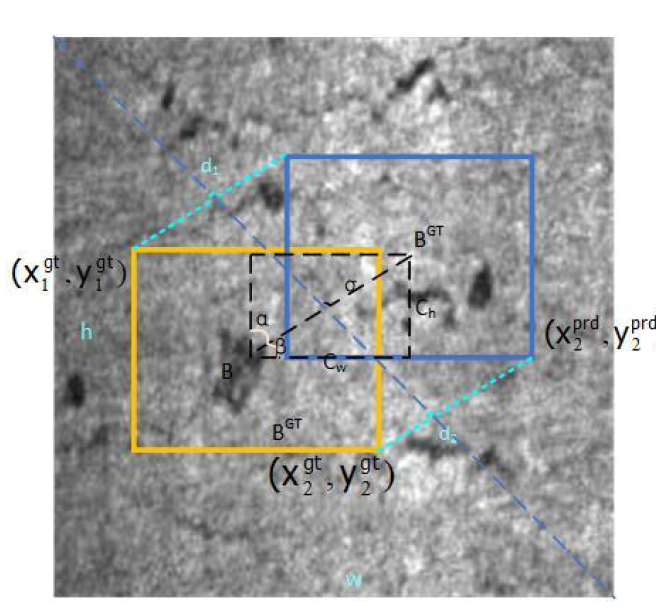
(1)针对小样本缺陷数据中普遍存在的尺度信息缺失问题,本文提出了一种多尺度前景增强的小样本缺陷检测算法。该算法的核心在于通过改进基础检测框架并引入多尺度信息增强机制,来有效缓解因训练样本过少而导致的模型泛化能力不足问题。在基础模型构建方面,算法摒弃了传统的基于全连接层的分类器,采用了基于余弦距离的分类网络。该网络将特征向量与类别原型之间的余弦相似度作为分类依据,使得模型在少量样本上能够更快地收敛,并且对特征幅度的变化不敏感,从而提升了小样本条件下的分类鲁棒性。在定位分支,算法设计了一种基于几何信息度量的定位损失函数,该函数不仅考虑边界框坐标的差异,还融入了宽高比、重叠面积等几何一致性约束,使得模型在样本稀缺的情况下仍能生成更为精确的目标边界框。
为了应对缺陷目标尺度多变且训练数据无法覆盖全部尺度分布的挑战,算法重点设计了多尺度目标金字塔和前景增强模块。多尺度目标金字塔通过对骨干网络提取的多层特征图进行融合与重构,构建出包含从低层细节到高层语义的丰富尺度信息的特征金字塔。该金字塔结构使得模型无论面对大尺度还是小尺度的缺陷目标,都能在相应的特征层级上获得具有强判别性的特征表示。前景增强模块则作用于特征金字塔之上,其核心思想是突出缺陷目标区域的特征响应,同时抑制复杂背景的干扰。该模块通过注意力机制或特征调制技术,对特征图上的每个位置进行重加权,使得缺陷前景区域的特征得到增强,而背景区域的特征被削弱。这种操作相当于在特征空间进行了数据增强,有效扩充了缺陷目标的尺度分布和表观变化,为模型提供了更丰富的空间上下文信息补充。在NEU-DET、Magnetic Tile等多个公开工业缺陷数据集上的大量实验结果表明,在不同比例的小样本设置下(如1-shot, 5-shot, 10-shot),所提出的算法在准确率、召回率等关键指标上均显著优于基线方法,特别是在检测微小缺陷和尺度极端缺陷时优势更加明显,充分证明了多尺度信息增强对于解决小样本缺陷检测尺度信息缺失问题的有效性。
(2)在真实的工业连续制造过程中,产线可能会不断引入新的产品类型或缺陷模式,这就要求检测系统能够在不遗忘已有知识的前提下,持续学习新增类别的小样本数据。针对这一类别增量的小样本缺陷检测场景,本文提出了一种基于知识蒸馏的增量学习网络。该算法的主要目标是克服深度神经网络在增量学习过程中面临的灾难性遗忘问题,即模型在学习新类别知识时,会严重破坏或覆盖掉之前已学习到的旧类别知识。为了实现这一目标,算法采用了知识蒸馏技术,通过约束新旧模型在特征空间和输出空间的分布一致性来保留历史知识。
具体而言,算法在引入新增类别的缺陷数据时,会保存一个在旧类别数据上训练好的模型作为教师模型,而当前需要更新的模型作为学生模型。知识蒸馏损失函数由两部分构成:特征对齐损失和输出对齐损失。特征对齐损失要求学生模型中间层的特征图与教师模型相应层的特征图保持相似,这意味着学生模型在学习新特征的同时,需要维持其网络对旧类别数据特征的表征能力。输出对齐损失则作用于模型的预测输出端,通常采用KL散度来衡量学生模型与教师模型对于旧类别预测概率分布的差异,迫使学生模型在对新类别进行正确分类的同时,对旧类别的输出概率分布与教师模型尽可能接近,从而“记住”旧类别的决策边界。此外,算法还设计了一个增量分类与回归网络结构。该结构在标准的检测头基础上进行了扩展,能够动态地增加用于预测新增类别的分类器输出节点,而回归分支则通常共享以预测边界框,从而实现端到端的类别增量检测,无需像某些方法那样需要复杂的模型重组或数据回放。
在模拟工业增量学习场景的实验设置中,算法被要求依次学习多批小样本缺陷数据,每批数据包含少量新增缺陷类别。实验结果表明,与不采用蒸馏技术的基线方法相比,所提出的算法在学完所有增量阶段后,对各个阶段引入的旧类别缺陷的检测精度下降非常有限,而对于新增类别也能达到较高的检测性能。同时,与需要存储部分历史数据的数据回放方法相比,该算法在完全不接触历史原始数据的情况下,仅通过蒸馏损失就实现了可比的抗遗忘性能,更符合工业应用中对数据隐私和存储限制的严格要求。这些结果充分验证了所提知识蒸馏网络在解决小样本增量缺陷检测问题上的优越性和实用性。
(3)工业检测的另一个常见挑战是模型在一个场景(源域)下训练后,需要快速适应到另一个具有分布差异的新场景(目标域),且目标域仅有极少量标注样本。这种跨场景域适应的小样本问题对模型的泛化能力提出了极高要求。为此,本文提出了一个基于对抗互学习的教师-学生网络框架,旨在利用目标域少量标注样本和大量无标注样本,实现高效的域自适应缺陷检测。
该框架包含一个学生网络和一个教师网络,二者具有相同的网络结构。教师网络的参数通过学生网络参数的指数移动平均来动态更新,这种更新方式使得教师网络的参数变化更为平滑稳定,能够产生相对可靠的伪标签。整个学习过程是一个互学习循环:学生网络利用带标签的源域数据和少量带标签的目标域数据,以及由教师网络在目标域无标注数据上生成的伪标签数据进行训练,从而学习跨域知识;随后,教师网络根据学生网络的最新参数进行平滑更新,并以更新后更精确的模型为下一轮训练生成质量更高的伪标签。
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader
import torch.optim as optim
from torchvision.models import resnet50
import numpy as np

class CosineClassifier(nn.Module):
    def __init__(self, in_features, num_classes):
        super(CosineClassifier, self).__init__()
        self.weight = nn.Parameter(torch.Tensor(num_classes, in_features))
        nn.init.kaiming_uniform_(self.weight, a=np.sqrt(5))

    def forward(self, x):
        x = F.normalize(x, p=2, dim=1)
        w = F.normalize(self.weight, p=2, dim=1)
        return F.linear(x, w)

class MultiScaleFeaturePyramid(nn.Module):
    def __init__(self, backbone_out_channels, feat_channels=256):
        super(MultiScaleFeaturePyramid, self).__init__()
        self.fpn_lateral = nn.ModuleList()
        self.fpn_output = nn.ModuleList()
        for _ in backbone_out_channels:
            self.fpn_lateral.append(nn.Conv2d(_, feat_channels, 1))
            self.fpn_output.append(nn.Conv2d(feat_channels, feat_channels, 3, padding=1))

    def forward(self, backbone_features):
        laterals = [lateral_conv(feat) for lateral_conv, feat in zip(self.fpn_lateral, backbone_features)]
        for i in range(len(laterals) - 1, 0, -1):
            laterals[i - 1] += F.interpolate(laterals[i], size=laterals[i-1].shape[-2:], mode='nearest')
        fpn_outputs = [output_conv(lateral) for output_conv, lateral in zip(self.fpn_output, laterals)]
        return fpn_outputs

class ForegroundEnhancementModule(nn.Module):
    def __init__(self, in_channels, reduction=16):
        super(ForegroundEnhancementModule, self).__init__()
        self.squeeze = nn.AdaptiveAvgPool2d(1)
        self.excitation = nn.Sequential(
            nn.Linear(in_channels, in_channels // reduction, bias=False),
            nn.ReLU(inplace=True),
            nn.Linear(in_channels // reduction, in_channels, bias=False),
            nn.Sigmoid()
        )

    def forward(self, x):
        b, c, _, _ = x.size()
        y = self.squeeze(x).view(b, c)
        y = self.excitation(y).view(b, c, 1, 1)
        return x * y.expand_as(x)

class GeometricAwareLoss(nn.Module):
    def __init__(self):
        super(GeometricAwareLoss, self).__init__()

    def forward(self, pred_boxes, target_boxes):
        pred_x1, pred_y1, pred_x2, pred_y2 = pred_boxes.unbind(dim=-1)
        target_x1, target_y1, target_x2, target_y2 = target_boxes.unbind(dim=-1)
        pred_area = (pred_x2 - pred_x1) * (pred_y2 - pred_y1)
        target_area = (target_x2 - target_x1) * (target_y2 - target_y1)
        inter_x1 = torch.max(pred_x1, target_x1)
        inter_y1 = torch.max(pred_y1, target_y1)
        inter_x2 = torch.min(pred_x2, target_x2)
        inter_y2 = torch.min(pred_y2, target_y2)
        inter_area = torch.clamp(inter_x2 - inter_x1, min=0) * torch.clamp(inter_y2 - inter_y1, min=0)
        union_area = pred_area + target_area - inter_area
        iou = inter_area / union_area
        loss_iou = 1 - iou
        pred_wh = torch.stack([pred_x2 - pred_x1, pred_y2 - pred_y1], dim=-1)
        target_wh = torch.stack([target_x2 - target_x1, target_y2 - target_y1], dim=-1)
        aspect_loss = F.smooth_l1_loss(pred_wh, target_wh, reduction='none').mean(dim=-1)
        total_loss = loss_iou + 0.5 * aspect_loss
        return total_loss.mean()

class FewShotDefectDetector(nn.Module):
    def __init__(self, num_classes):
        super(FewShotDefectDetector, self).__init__()
        self.backbone = resnet50(pretrained=True)
        self.fpn = MultiScaleFeaturePyramid([512, 1024, 2048])
        self.enhance_modules = nn.ModuleList([ForegroundEnhancementModule(256) for _ in range(3)])
        self.classifier = CosineClassifier(256, num_classes)
        self.regressor = nn.Sequential(
            nn.Conv2d(256, 256, 3, padding=1),
            nn.ReLU(),
            nn.Conv2d(256, 4, 1)
        )
        self.geometric_loss = GeometricAwareLoss()

    def forward(self, x):
        with torch.no_grad():
            c3 = self.backbone.layer2(x)
            c4 = self.backbone.layer3(c3)
            c5 = self.backbone.layer4(c4)
        features = [c3, c4, c5]
        fpn_outs = self.fpn(features)
        enhanced_features = [enhance(feat) for enhance, feat in zip(self.enhance_modules, fpn_outs)]
        cls_logits = []
        bbox_preds = []
        for feat in enhanced_features:
            feat_flat = feat.view(feat.size(0), feat.size(1), -1).permute(0, 2, 1)
            cls_logits.append(self.classifier(feat_flat))
            bbox_preds.append(self.regressor(feat).permute(0, 2, 3, 1).contiguous().view(feat.size(0), -1, 4))
        cls_logits = torch.cat(cls_logits, dim=1)
        bbox_preds = torch.cat(bbox_preds, dim=1)
        return cls_logits, bbox_preds

class IncrementalDetectionModel(nn.Module):
    def __init__(self, old_model, new_num_classes):
        super(IncrementalDetectionModel, self).__init__()
        self.old_model = old_model
        self.new_classifier = CosineClassifier(256, new_num_classes)
        self.teacher_model = None

    def set_teacher(self, teacher):
        self.teacher_model = teacher

    def forward(self, x):
        with torch.no_grad():
            c3 = self.old_model.backbone.layer2(x)
            c4 = self.old_model.backbone.layer3(c3)
            c5 = self.old_model.backbone.layer4(c5)
        features = [c3, c4, c5]
        fpn_outs = self.old_model.fpn(features)
        enhanced_features = [enhance(feat) for enhance, feat in zip(self.old_model.enhance_modules, fpn_outs)]
        cls_logits = []
        bbox_preds = []
        for feat in enhanced_features:
            feat_flat = feat.view(feat.size(0), feat.size(1), -1).permute(0, 2, 1)
            old_cls = self.old_model.classifier(feat_flat)
            new_cls = self.new_classifier(feat_flat)
            combined_cls = torch.cat([old_cls, new_cls], dim=-1)
            cls_logits.append(combined_cls)
            bbox_preds.append(self.old_model.regressor(feat).permute(0, 2, 3, 1).contiguous().view(feat.size(0), -1, 4))
        cls_logits = torch.cat(cls_logits, dim=1)
        bbox_preds = torch.cat(bbox_preds, dim=1)
        return cls_logits, bbox_preds

class DomainAdversarialNetwork(nn.Module):
    def __init__(self, in_features):
        super(DomainAdversarialNetwork, self).__init__()
        self.domain_classifier = nn.Sequential(
            nn.Linear(in_features, 512),
            nn.ReLU(),
            nn.Dropout(0.5),
            nn.Linear(512, 1)
        )

    def forward(self, x, gradient_reverse=True):
        if gradient_reverse:
            x = GradientReversal.apply(x)
        return self.domain_classifier(x)

class GradientReversal(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x):
        return x

    @staticmethod
    def backward(ctx, grad_output):
        return -grad_output

class MutualLearningFramework:
    def __init__(self, student_model, teacher_model, domain_adv_net):
        self.student_model = student_model
        self.teacher_model = teacher_model
        self.domain_adv_net = domain_adv_net
        self.optimizer = optim.Adam(student_model.parameters(), lr=0.001)
        self.domain_optimizer = optim.Adam(domain_adv_net.parameters(), lr=0.001)

    def update_teacher(self, alpha=0.99):
        for teacher_param, student_param in zip(self.teacher_model.parameters(), self.student_model.parameters()):
            teacher_param.data = alpha * teacher_param.data + (1 - alpha) * student_param.data

    def train_step(self, source_data, target_labeled_data, target_unlabeled_data):
        self.optimizer.zero_grad()
        self.domain_optimizer.zero_grad()
        src_imgs, src_cls, src_bbox = source_data
        tar_l_imgs, tar_l_cls, tar_l_bbox = target_labeled_data
        tar_u_imgs, _, _ = target_unlabeled_data

        student_src_cls_logits, student_src_bbox_preds = self.student_model(src_imgs)
        detection_loss = self.compute_detection_loss(student_src_cls_logits, student_src_bbox_preds, src_cls, src_bbox)

        student_tar_l_cls_logits, student_tar_l_bbox_preds = self.student_model(tar_l_imgs)
        target_supervised_loss = self.compute_detection_loss(student_tar_l_cls_logits, student_tar_l_bbox_preds, tar_l_cls, tar_l_bbox)

        with torch.no_grad():
            teacher_tar_u_cls_logits, teacher_tar_u_bbox_preds = self.teacher_model(tar_u_imgs)
            pseudo_cls = torch.softmax(teacher_tar_u_cls_logits, dim=-1)
            pseudo_cls_label = torch.argmax(pseudo_cls, dim=-1)
            pseudo_bbox = teacher_tar_u_bbox_preds

        student_tar_u_cls_logits, student_tar_u_bbox_preds = self.student_model(tar_u_imgs)
        pseudo_label_loss = self.compute_detection_loss(student_tar_u_cls_logits, student_tar_u_bbox_preds, pseudo_cls_label, pseudo_bbox)

        src_feat_flat = student_src_cls_logits.mean(dim=1)
        tar_feat_flat = student_tar_u_cls_logits.mean(dim=1)
        domain_src_pred = self.domain_adv_net(src_feat_flat)
        domain_tar_pred = self.domain_adv_net(tar_feat_flat)
        domain_src_label = torch.zeros(domain_src_pred.size(0), 1).to(domain_src_pred.device)
        domain_tar_label = torch.ones(domain_tar_pred.size(0), 1).to(domain_tar_pred.device)
        domain_loss = F.binary_cross_entropy_with_logits(domain_src_pred, domain_src_label) + F.binary_cross_entropy_with_logits(domain_tar_pred, domain_tar_label)

        total_loss = detection_loss + target_supervised_loss + 0.5 * pseudo_label_loss - 0.1 * domain_loss
        total_loss.backward()
        self.optimizer.step()
        self.domain_optimizer.step()

        self.update_teacher()

    def compute_detection_loss(self, cls_logits, bbox_preds, cls_targets, bbox_targets):
        cls_loss = F.cross_entropy(cls_logits.view(-1, cls_logits.size(-1)), cls_targets.view(-1))
        bbox_loss = self.student_model.geometric_loss(bbox_preds.view(-1, 4), bbox_targets.view(-1, 4))
        return cls_loss + bbox_loss

def main():
    num_base_classes = 10
    base_model = FewShotDefectDetector(num_base_classes)
    incremental_model = IncrementalDetectionModel(base_model, 5)
    domain_adv_net = DomainAdversarialNetwork(256)
    teacher_model = FewShotDefectDetector(num_base_classes + 5)
    ml_framework = MutualLearningFramework(incremental_model, teacher_model, domain_adv_net)

    for epoch in range(100):
        for batch_idx, (src_batch, tar_l_batch, tar_u_batch) in enumerate(dataloader):
            ml_framework.train_step(src_batch, tar_l_batch, tar_u_batch)

if __name__ == '__main__':
    main()
如有问题,可以直接沟通
👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇👇
更多推荐



 11
 0
- 0


 已为社区贡献26条内容

所有评论(0)